Hai un'immagine di un personaggio adulto e una battuta registrata, e vuoi un breve video che mantenga sia il personaggio sia l'atmosfera desiderata. Wan 2.7 Spicy sembra promettente perché offre la generazione NSFW da immagine a video e un ingresso audio.
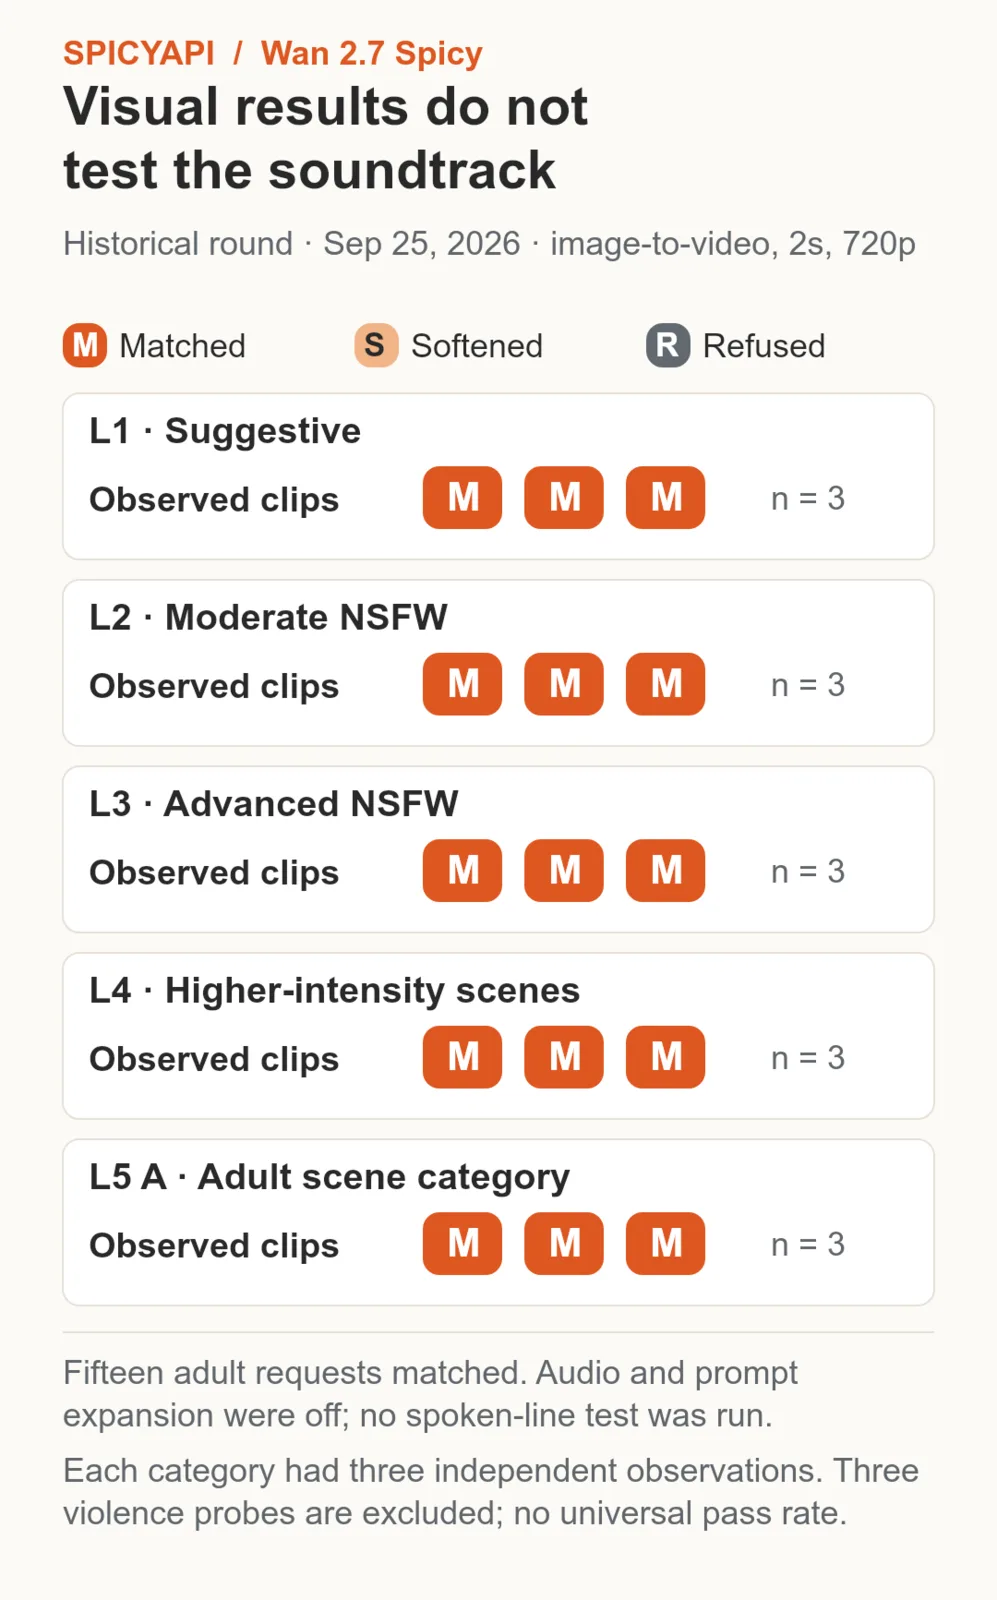
Wan 2.7 Spicy è un'opzione da immagine a video senza censura su SpicyAPI. Nei nostri test di settembre 2026, tutte le richieste di contenuti per adulti sono state consegnate, senza attenuazioni né rifiuti.
L'attività attuale produce 2–15 secondi a 720p o 1080p. Accetta un'immagine iniziale, un prompt di movimento obbligatorio, suono generato facoltativo e una traccia audio facoltativa. Cinque secondi costano $0.6175 a 720p o $0.95 a 1080p. Non è indicata una fascia di prezzo aggiuntiva per l'audio.
Cosa significa «senza censura» in questo test
SpicyAPI non aggiunge filtri di contenuto della piattaforma a Wan 2.7 Spicy; il risultato effettivo va comunque valutato.
Le richieste di maggiore intensità sono state consegnate anziché completate con versioni più moderate. Per una ripresa diversa, scegli un nuovo seed; mantieni lo stesso seed quando confronti due impostazioni. Consulta il rapporto di test di Wan 2.7 Spicy.
È la versione video, non il generatore di immagini Wan 2.7
Wan 2.7 Spicy ha una sola attività pubblicata: da immagine a video. Sono necessari sia un'immagine iniziale sia un prompt non vuoto. Non crea immagini fisse da testo, non accetta un fotogramma finale separato né una serie di immagini di riferimento del personaggio e non estende un video caricato.
Wan 2.7 e Wan 2.7 Pro su SpicyAPI sono modelli di immagine separati. Se hai solo una descrizione del personaggio, crea prima l'immagine fissa iniziale. Usa un editor video per sostituire la colonna sonora di un clip finito; questa attività genera un nuovo clip.
Tre modi diversi di gestire il suono
In un catalogo di personaggi adulti, il suono fa parte del personaggio: una voce calma, un'atmosfera ricorrente della stanza o un motivo musicale coerente. Wan 2.7 Spicy mette a disposizione due controlli, generate_audio e audio_url, che svolgono funzioni diverse.
| Risultato desiderato | Configura l'audio così | Uso pratico |
|---|---|---|
| Un clip muto da sonorizzare in seguito | Imposta generate_audio su false; lascia audio_url vuoto | Aggiungi la colonna sonora approvata nel tuo editor. |
| Nuovo suono creato insieme all'immagine | Mantieni generate_audio su true; descrivi l'atmosfera desiderata nel prompt | Genera voce e suoni ambientali insieme all'immagine. |
| Un clip guidato dalla tua traccia registrata | Fornisci audio_url e mantieni generate_audio su true | Guida sincronizzazione labiale e ritmo con la traccia fornita. |
Quando generate_audio è false, anche l'audio fornito non viene utilizzato. Caricare una registrazione e poi disattivare l'audio è quindi la configurazione sbagliata per un clip guidato dalla voce. Usa WAV o MP3 e, come obiettivo prudente di preparazione, mantieni la sorgente sotto i 15 MB. Il video generato resta limitato a quindici secondi. Caricare trenta secondi non permette di ottenere un video di trenta secondi.
Adatta la registrazione alla durata prevista della ripresa prima dell'invio. Se la registrazione esatta deve rimanere invariata, conserva il master, inseriscilo sotto il video scelto nell'editor e verifica a orecchio che le parole restino chiare.
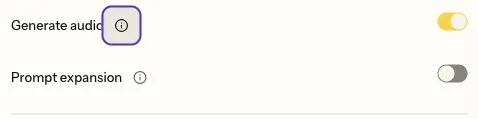
Mantieni Generate audio attivato quando fornisci una traccia registrata. La configurazione mostrata lascia Prompt expansion disattivato, preservando le indicazioni scritte.
Un clip pratico di personaggio guidato dalla voce
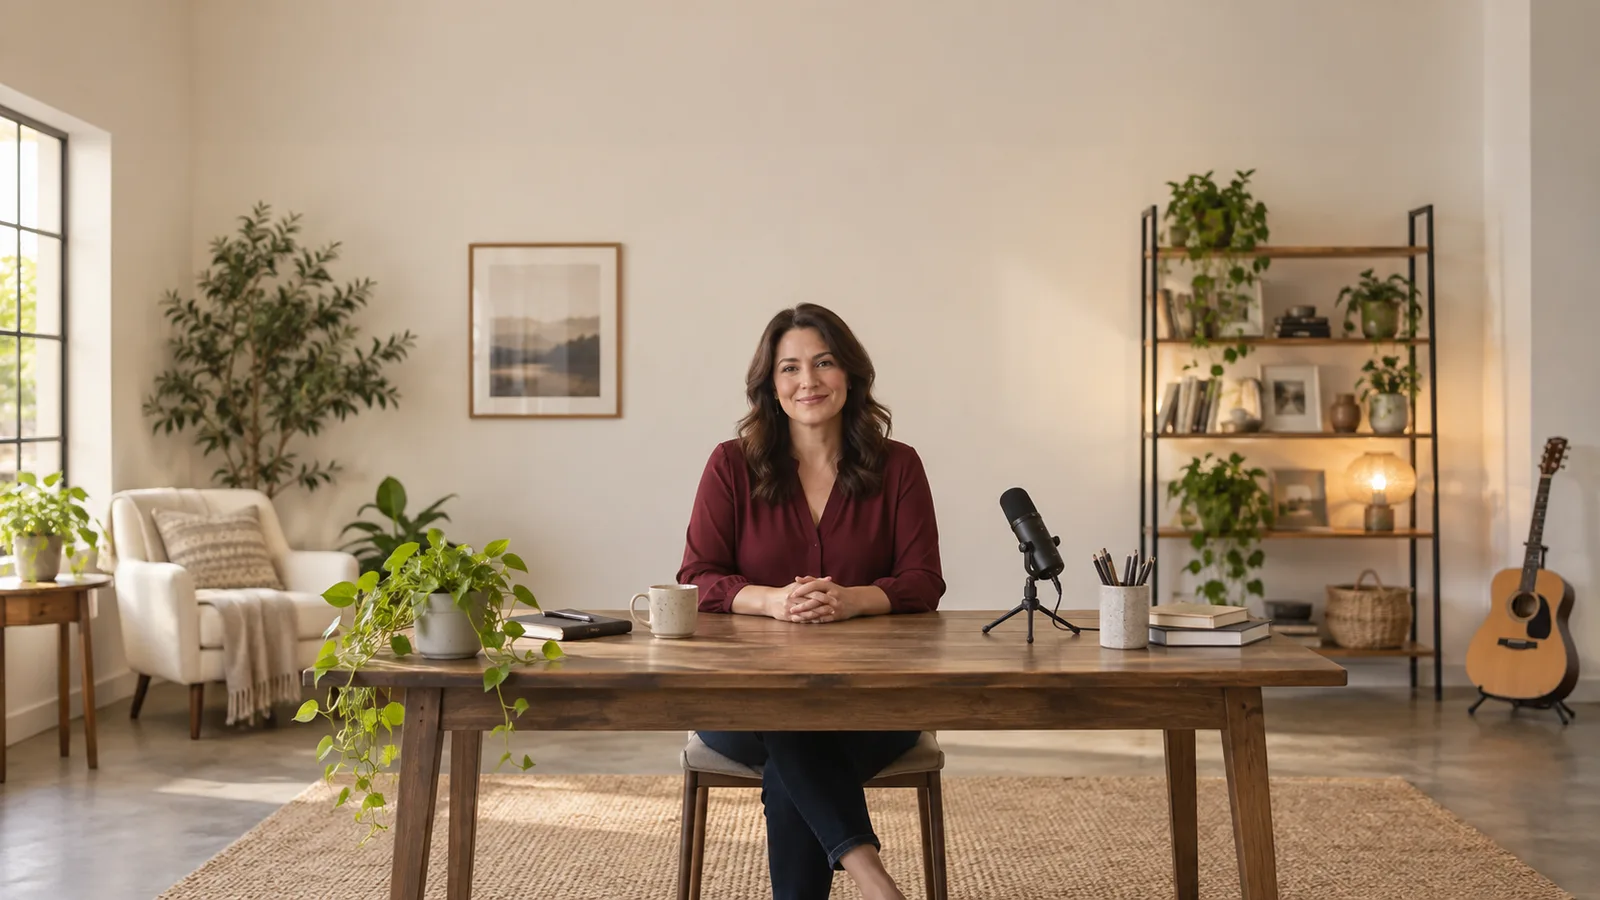
Per una configurazione iniziale completa, usa una donna adulta immaginaria di 38 anni, seduta di fronte alla camera con una blusa bordeaux opaca. Inquadra da appena sotto la vita fino a sopra la testa. Mantieni la bocca visibile ed entrambe le mani appoggiate lontano dal viso. Usa una luce morbida e una stanza semplice. Un'immagine di profilo con la bocca nascosta dai capelli è un cattivo punto di partenza per valutare il parlato.
Registra una battuta breve e originale, ad esempio “Stay a little longer. I saved this moment for you.” È un teaser con un personaggio adulto, senza una scena adulta dettagliata. Usa una voce che sei autorizzato a elaborare e riduci la registrazione a cinque secondi, con un breve inizio e una fine tranquilli. Evita la musica sopra le parole nel primo tentativo: se la voce si sente male, non saprai se il problema è la generazione o il mixaggio.
Nel Playground di Wan 2.7 Spicy:
- Carica l'immagine iniziale approvata come Input image e la traccia registrata come Input audio.
- Scegli cinque secondi a 720p, mantieni Generate audio attivato e disattiva Prompt expansion.
- Incolla le indicazioni di movimento e genera la ripresa guidata dalla voce.
Esempio di indicazioni:
One continuous medium shot of the fictional adult woman in the opening image. She faces the viewer and speaks the supplied short line, then settles into a restrained smile. Keep the same burgundy blouse, face, chair and lighting. Both hands remain resting beside her waist and clear of her face. Stationary eye-level camera, unchanged framing. No cut, no other speaker and no music added over the voice. End with a quiet hold.
Il movimento limitato lascia visibile l'interpretazione parlata. Una volta ottenute voce e bocca utilizzabili, una seconda ripresa può aggiungere un gesto. Combinare una rotazione della testa, una mano davanti alla bocca e una camera in movimento al primo tentativo rende molto più difficile valutare se l'interpretazione guidata dall'audio funziona.
Riproduci il risultato con il suono. La battuta è riconoscibile? Compare un'altra voce? I movimenti della bocca iniziano e finiscono insieme alle parole? Il sorriso finale deforma il viso? Un clip può essere adatto come teaser muto ma fallire come clip guidato dalla voce; decidi in base a ciò che il tuo pubblico sentirà e vedrà davvero.
Se la registrazione viene troncata, prepara una battuta più breve anziché chiedere a un clip di cinque secondi di contenere un'interpretazione lunga. Se il viso cambia durante il parlato, torna a un'immagine fissa frontale ed elimina il movimento della testa. Se il parlato preciso continua a non riuscire, conserva una ripresa muta utile e aggiungi la registrazione in postproduzione solo quando non serve una sincronizzazione labiale visibile.
Mantieni il modello vicino alla scena desiderata
Wan 2.7 Spicy può aggiungere più azione di quanto richieda il prompt. Se il lavoro commissionato è un teaser contenuto, un personaggio extra, un cambio d'abito o una scena adulta imprevista possono rendere inutilizzabile un video tecnicamente completato. Specifica l'interpretazione che vuoi prima di spendere per le variazioni.
Per una ripresa controllata, descrivi l'unica azione desiderata e il suo punto di arresto. Specifica l'immagine iniziale, l'abbigliamento e la stanza quando devono restare gli stessi. Disattiva Prompt expansion quando le indicazioni dell'interpretazione sono già complete; l'espansione è attivata per impostazione predefinita e riscrive il prompt prima della generazione. Disattivarla protegge la descrizione inviata da quel passaggio di espansione, così la generazione riceve le tue parole.
Il campo del prompt negativo accetta fino a 500 caratteri. Per l'esempio della donna seduta, usa:
additional person, outfit change, scene change, zoom, camera cut, hand across face, subtitles, watermark
Se il movimento della camera persiste, rivedi anche le indicazioni positive: “stationary eye-level camera, same waist-up framing from beginning to end.” Se il movimento previsto continua a trasformarsi in una scena diversa, cambia la progettazione della ripresa o valuta un altro modello. Non c'è motivo di continuare a comprare copie della stessa interpretazione indesiderata.
Quale budget dovresti prevedere?
Le tariffe pubbliche sono $0.1235 per secondo di video prodotto a 720p e $0.19 a 1080p. La matrice dei prezzi indicata non aggiunge un costo separato per l'audio generato o fornito.
| Durata del clip | 720p | 1080p |
|---|---|---|
| 2 secondi | $0.247 | $0.38 |
| 5 secondi | $0.6175 | $0.95 |
| 10 secondi | $1.235 | $1.90 |
| 15 secondi | $1.8525 | $2.85 |
Due secondi permettono di verificare se un fotogramma iniziale si anima, ma sono troppo pochi per la battuta di cinque secondi sopra. Tre riprese di cinque secondi a 720p costano $1.8525. Un'ulteriore generazione di cinque secondi a 1080p porta il totale a $2.8025, esclusi l'immagine iniziale e la registrazione. Dieci personaggi con questo flusso di quattro tentativi costano $28.025 in generazione video.
La nuova generazione a 1080p è una nuova ripresa, non un aumento di risoluzione del clip a 720p scelto. Può cambiare l'espressione, i tempi e l'articolazione. Non è indicato alcuno sconto per l'audio disattivato.
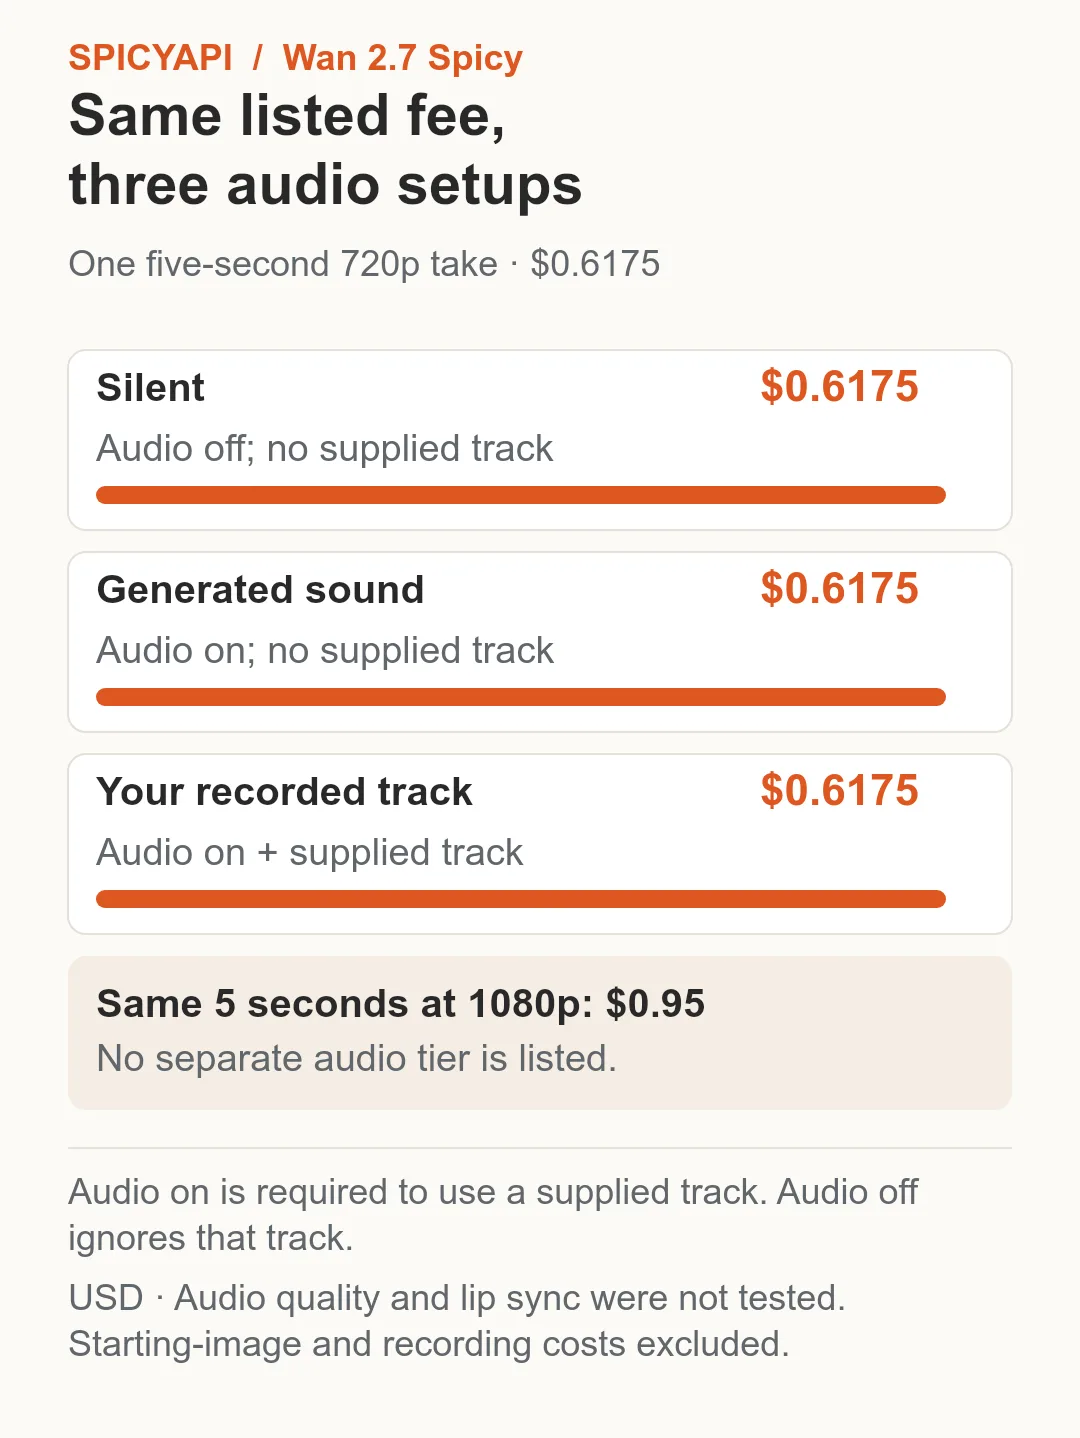
Wan 2.7 Spicy indica la stessa tariffa di $0.6175 per cinque secondi a 720p nelle configurazioni mute, con suono generato e con traccia fornita. Una traccia fornita richiede l'audio attivato.
Quando un'altra attività è più adatta
Usa Wan 2.7 Spicy quando hai un'immagine iniziale finita e vuoi un breve clip per adulti con un ingresso audio registrato facoltativo. L'intervallo di 2–15 secondi permette di adattare un breve momento specifico senza acquistare la durata massima.
- Clip più economici con una traccia registrata: Wan 2.6 Spicy accetta
audio_urle costa $0.475 per cinque secondi a 720p. Offre durate fisse di 5/10/15 secondi e nessun interruttore per attivare o disattivare l'audio. - Un fotogramma finale o più di 15 secondi: Wan 3.0 Spicy offre un ingresso per l'immagine finale e clip di 2–30 secondi, da $0.057/s a 480p. Genera audio ma non accetta il tuo file audio. Consulta la guida alle durate di Wan 3.0.
- Audio registrato e durata breve precisa: scegli Wan 2.7 Spicy per durate in secondi interi da 2 a 15 a 720p o 1080p.
Per il comportamento con i contenuti per adulti nella famiglia, confronta le versioni Wan senza censura.
Apri Wan 2.7 Spicy da immagine a video, carica un'immagine fissa approvata di un personaggio adulto e inizia dal clip più breve che contenga l'interpretazione. Scegli consapevolmente tra silenzio, suono generato e la tua registrazione. Valuta il video e la colonna sonora effettivi prima di estendere l'idea a un lotto.
Usa la configurazione guidata dalla voce tramite API
Imposta SPICY_API_KEY nel tuo ambiente e SPICY_IMAGE_URI sull'URL accessibile della tua immagine iniziale o sull'URI spicy:// caricata. Imposta SPICY_AUDIO_URI sull'URL accessibile della traccia registrata o sull'URI caricata. Questo esempio Python 3 invia una nuova ripresa dopo che ne hai confermato il prezzo.
import json
import os
import urllib.request
import uuid

base = "https://api.spicyapi.ai/api/v1"
headers = {"Authorization": "Bearer " + os.environ["SPICY_API_KEY"],
           "Content-Type": "application/json", "User-Agent": "SpicyAPI-Blog/1.0"}
settings = {
    "duration_seconds": 5,
    "resolution": "720p",
    "generate_audio": True,
    "enable_prompt_expansion": False
}
settings["prompt"] = 'The adult speaker talks in one continuous stationary shot.'
settings["image_url"] = os.environ["SPICY_IMAGE_URI"]
settings["audio_url"] = os.environ["SPICY_AUDIO_URI"]
payload = {"model": "alibaba/wan-2.7-spicy/image-to-video", "input": settings}

def post(path, body):
    request = urllib.request.Request(base + path, json.dumps(body).encode(), headers)
    with urllib.request.urlopen(request, timeout=60) as response:
        result = json.load(response)
    if result.get("code") != 200:
        raise RuntimeError(result)
    return result["data"]

quote = post("/jobs/quote", payload)
if input(f"Maximum charge ${quote['maxCharge']}. Type yes to generate: ") != "yes":
    raise SystemExit("Stopped before generation")
headers["Idempotency-Key"] = str(uuid.uuid4())
print("Request key:", headers["Idempotency-Key"], flush=True)
task = post("/jobs/createTask", {**payload, "quoteId": quote["quoteId"],
                              "expectedCost": quote["estimatedCost"]})
print("Task ID:", task["taskId"])
Conserva la chiave di richiesta stampata per recuperare quella stessa richiesta; una nuova ripresa riceve una nuova chiave. La documentazione dell'API delle attività spiega la consegna e il recupero dei risultati.
Per riprese ripetute, lascia che un Agent usi un file di input approvato: CLI spicyapi tasks create --model alibaba/wan-2.7-spicy/image-to-video --input-file input.json --wait; MCP chiedigli di chiamare spicyapi_task_create con quel modello e quell'input; Skill chiedi “Use the spicyapi Skill to generate this approved shot and return the result.” CLI e MCP mostrano il prezzo prima della creazione. Consulta la documentazione sull'integrazione con Agent.