Masz obraz dorosłej postaci i nagraną kwestię, a chcesz stworzyć krótki film, który zachowa zarówno postać, jak i zamierzony nastrój. Wan 2.7 Spicy wygląda obiecująco, ponieważ oferuje generowanie NSFW z obrazu na wideo oraz wejście audio.
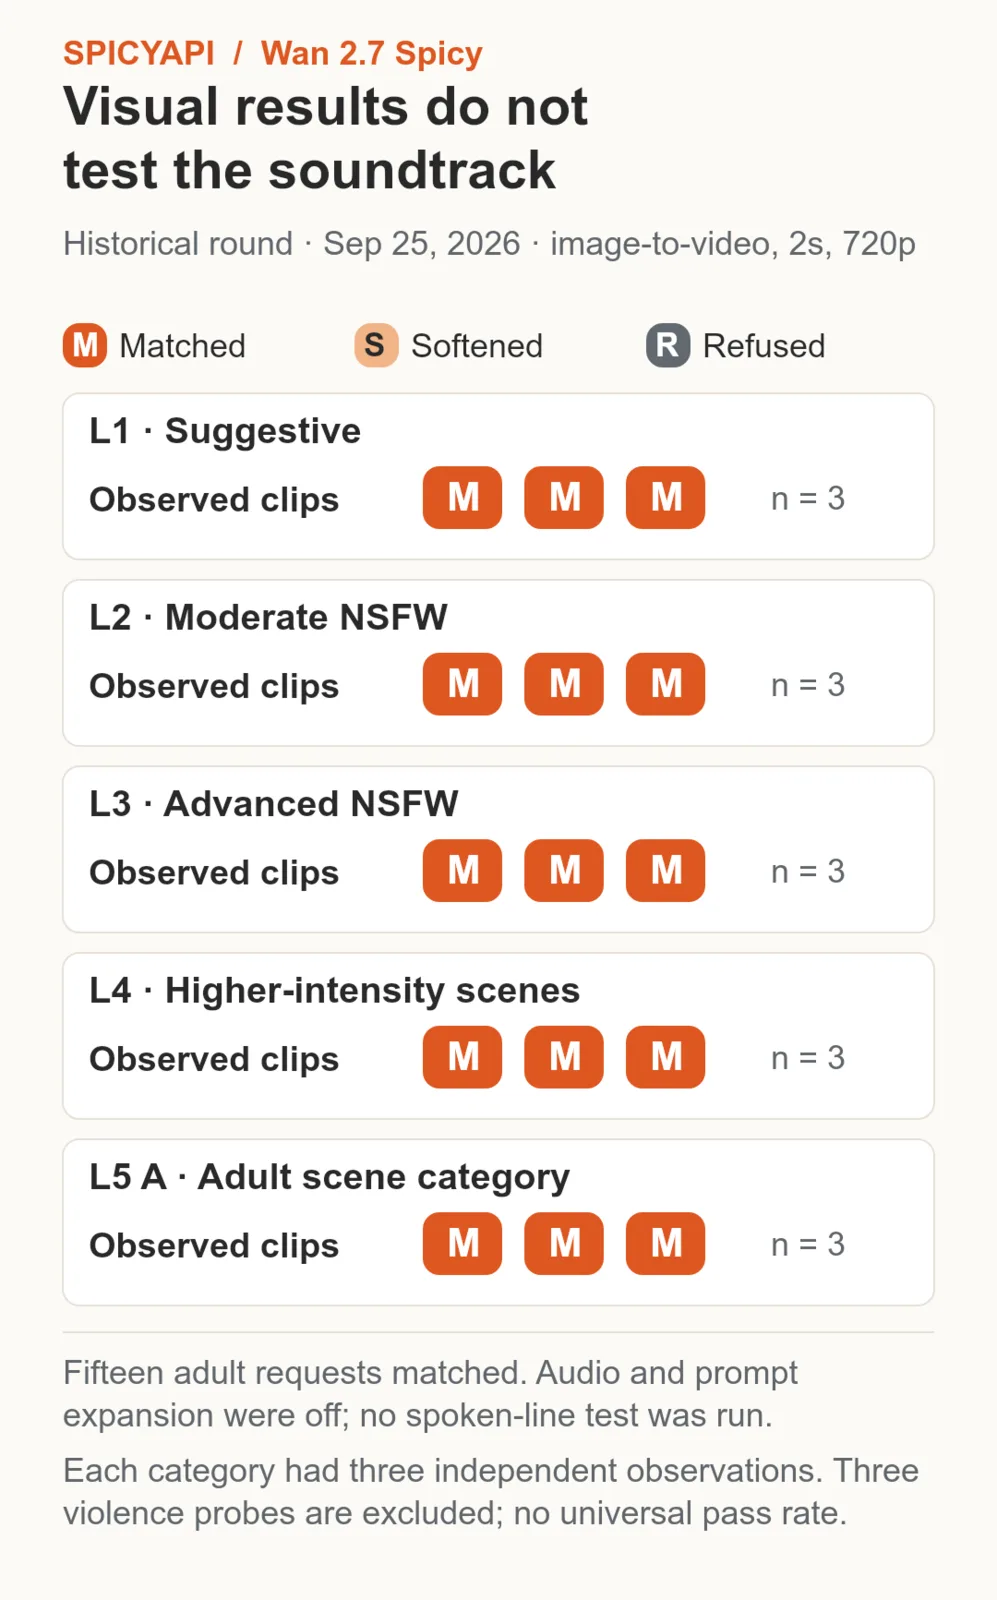
Wan 2.7 Spicy to opcja generowania z obrazu na wideo bez cenzury w SpicyAPI. W naszych testach z września 2026 roku wszystkie żądania dotyczące treści dla dorosłych dostarczyły wynik, bez łagodzenia ani odmowy.
Obecne zadanie tworzy 2–15 sekund w 720p lub 1080p. Przyjmuje obraz początkowy, wymagany prompt ruchu, opcjonalny generowany dźwięk i opcjonalną ścieżkę audio. Pięć sekund kosztuje 0,6175 $ w 720p lub 0,95 $ w 1080p. Nie podano dodatkowego progu cenowego dla audio.
Co oznacza „bez cenzury” w tym teście
SpicyAPI nie dodaje do Wan 2.7 Spicy filtra treści na poziomie platformy; nadal trzeba ocenić rzeczywisty wynik.
Żądania o większej intensywności dostarczyły wynik zamiast łagodniejszych zamienników. Aby uzyskać inne ujęcie, wybierz nowy seed; przy porównywaniu dwóch ustawień zachowaj ten sam seed. Zobacz raport z testów Wan 2.7 Spicy.
To wersja wideo, a nie generator obrazów Wan 2.7
Wan 2.7 Spicy ma jedno opublikowane zadanie: obraz na wideo. Wymaga zarówno obrazu początkowego, jak i niepustego promptu. Nie tworzy nieruchomego obrazu z tekstu, nie przyjmuje osobnej klatki końcowej ani zestawu obrazów referencyjnych postaci i nie wydłuża przesłanego filmu.
Wan 2.7 i Wan 2.7 Pro w SpicyAPI są oddzielnymi modelami obrazu. Jeśli masz tylko opis postaci, najpierw utwórz obraz początkowy. Do zastąpienia ścieżki dźwiękowej gotowego klipu użyj edytora wideo; to zadanie generuje nowy klip.
Trzy różne sposoby obsługi dźwięku
W katalogu dorosłych postaci dźwięk jest częścią postaci: spokojny głos, powracające odgłosy pomieszczenia lub spójny motyw muzyczny. Wan 2.7 Spicy udostępnia dwa ustawienia, generate_audio i audio_url, ale służą one różnym celom.
| Zamierzony wynik | Tak ustaw audio | Praktyczne zastosowanie |
|---|---|---|
| Niemy klip do późniejszego udźwiękowienia | Ustaw generate_audio na false; pozostaw audio_url puste | Dodaj zatwierdzoną ścieżkę dźwiękową w edytorze. |
| Nowy dźwięk tworzony wraz z obrazem | Pozostaw generate_audio na true; opisz pożądane odgłosy otoczenia w prompcie | Wygeneruj głos i odgłosy otoczenia wraz z obrazem. |
| Klip sterowany nagraną ścieżką | Podaj audio_url i pozostaw generate_audio na true | Steruj synchronizacją ust i tempem za pomocą dostarczonej ścieżki. |
Gdy generate_audio ma wartość false, dostarczone audio również nie jest używane. Przesłanie nagrania, a następnie wyłączenie audio jest więc niewłaściwą konfiguracją dla klipu opartego na głosie. Użyj WAV lub MP3 i jako ostrożny cel przygotowania utrzymuj plik źródłowy poniżej 15 MB. Wygenerowany film nadal ma limit piętnastu sekund. Przesłanie trzydziestu sekund nie pozwala uzyskać trzydziestosekundowego filmu.
Przed wysłaniem dopasuj nagranie do planowanej długości ujęcia. Jeśli dokładne nagranie musi pozostać bez zmian, zachowaj plik wzorcowy, umieść go pod wybranym filmem w edytorze i sprawdź słuchem, czy słowa nadal są wyraźne.
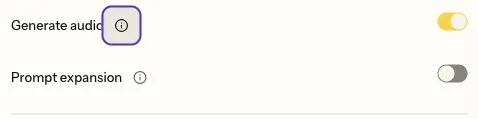
Gdy dostarczasz nagraną ścieżkę, pozostaw Generate audio włączone. Pokazana konfiguracja pozostawia Prompt expansion wyłączone, aby zachować napisane wytyczne.
Praktyczny klip postaci oparty na głosie
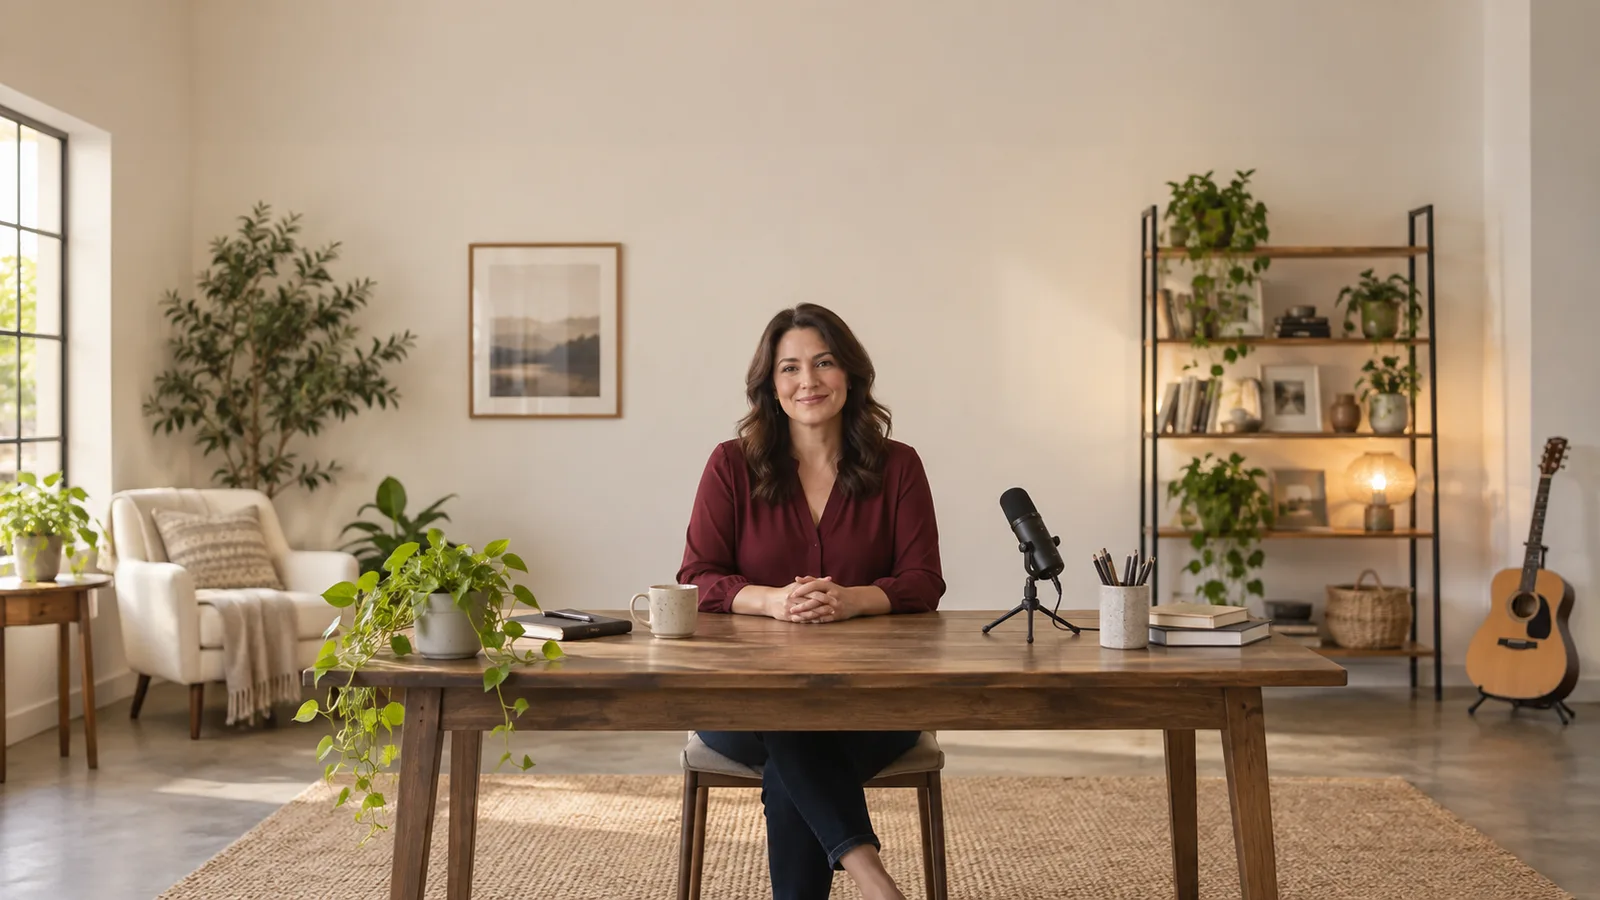
Jako kompletną konfigurację początkową wykorzystaj fikcyjną dorosłą kobietę w wieku 38 lat, siedzącą twarzą do kamery w nieprześwitującej bordowej bluzce. Kadruj od miejsca tuż poniżej talii do ponad głowę. Usta powinny być widoczne, a obie dłonie spoczywać z dala od twarzy. Użyj jednego miękkiego światła i prostego pokoju. Obraz z profilu, na którym włosy zasłaniają usta, to słaby punkt wyjścia do oceny mowy.
Nagraj krótką, oryginalną kwestię, na przykład “Stay a little longer. I saved this moment for you.” To zapowiedź z dorosłą postacią bez szczegółowej sceny dla dorosłych. Użyj głosu, który masz prawo przetwarzać, i przytnij nagranie do pięciu sekund, z krótkim spokojnym początkiem i zakończeniem. Przy pierwszej próbie unikaj muzyki nakładanej na słowa: jeśli głos jest słabo słyszalny, nie dowiesz się, czy problemem jest generowanie, czy miks.
- Prześlij zatwierdzony obraz początkowy jako Input image i nagraną ścieżkę jako Input audio.
- Wybierz pięć sekund w 720p, pozostaw Generate audio włączone i wyłącz Prompt expansion.
- Wklej opis ruchu i wygeneruj ujęcie oparte na głosie.
Przykładowe wytyczne:
One continuous medium shot of the fictional adult woman in the opening image. She faces the viewer and speaks the supplied short line, then settles into a restrained smile. Keep the same burgundy blouse, face, chair and lighting. Both hands remain resting beside her waist and clear of her face. Stationary eye-level camera, unchanged framing. No cut, no other speaker and no music added over the voice. End with a quiet hold.
Ograniczony ruch pozwala wyraźnie obserwować wykonanie mówionej kwestii. Gdy głos i ruch ust są użyteczne, drugie ujęcie może dodać gest. Połączenie obrotu głowy, dłoni przed ustami i ruchomej kamery przy pierwszej próbie znacznie utrudnia ocenę, czy wykonanie sterowane dźwiękiem działa.
Odtwórz wynik z dźwiękiem. Czy rozpoznajesz kwestię? Czy pojawia się inny głos? Czy ruchy ust zaczynają się i kończą wraz ze słowami? Czy końcowy uśmiech zniekształca twarz? Klip może nadawać się na niemą zapowiedź, a jednocześnie nie sprawdzać się jako klip oparty na głosie; zdecyduj na podstawie tego, co odbiorcy rzeczywiście usłyszą i zobaczą.
Jeśli nagranie zostaje ucięte, przygotuj krótszą kwestię zamiast próbować zmieścić długie wykonanie w pięciosekundowym klipie. Jeśli twarz zmienia się podczas mówienia, wróć do nieruchomego obrazu en face i usuń ruch głowy. Jeśli precyzyjna mowa nadal się nie udaje, zachowaj użyteczne nieme ujęcie i dodaj nagranie w postprodukcji tylko wtedy, gdy widoczna synchronizacja ust nie jest wymagana.
Utrzymaj model blisko zamierzonej sceny
Wan 2.7 Spicy może dodać więcej akcji, niż prosi o to prompt. Jeśli zlecenie dotyczy powściągliwej zapowiedzi, dodatkowa postać, zmiana stroju lub nieplanowana scena dla dorosłych mogą sprawić, że technicznie ukończony film będzie nieprzydatny. Określ oczekiwane wykonanie, zanim wydasz pieniądze na warianty.
Dla kontrolowanego ujęcia opisz jedną pożądaną akcję i moment jej zakończenia. Wyraźnie określ obraz początkowy, ubranie i pokój, jeśli mają pozostać takie same. Przy w pełni napisanych wytycznych wykonania wyłącz Prompt expansion; rozszerzanie jest domyślnie włączone i przepisuje prompt przed generowaniem. Wyłączenie go chroni przesłany opis przed tym etapem rozszerzania, dzięki czemu generowanie otrzymuje Twoje własne sformułowania.
Pole negatywnego promptu przyjmuje do 500 znaków. Dla przykładu z siedzącą kobietą użyj:
additional person, outfit change, scene change, zoom, camera cut, hand across face, subtitles, watermark
Jeśli ruch kamery się utrzymuje, popraw także pozytywne wytyczne: “stationary eye-level camera, same waist-up framing from beginning to end.” Jeśli zamierzony ruch nadal zmienia się w inną scenę, zmień projekt ujęcia lub oceń inny model. Nie ma powodu, by nadal kupować kopie tej samej niepożądanej interpretacji.
Jaki budżet zaplanować?
Publiczne stawki wynoszą 0,1235 $ za sekundę wynikowego filmu w 720p i 0,19 $ w 1080p. Podana tabela cen nie dodaje osobnej opłaty za wygenerowane lub dostarczone audio.
| Długość klipu | 720p | 1080p |
|---|---|---|
| 2 sekundy | 0,247 $ | 0,38 $ |
| 5 sekund | 0,6175 $ | 0,95 $ |
| 10 sekund | 1,235 $ | 1,90 $ |
| 15 sekund | 1,8525 $ | 2,85 $ |
Dwie sekundy pozwalają sprawdzić, czy klatka początkowa się animuje, ale to za mało na powyższą pięciosekundową kwestię. Trzy pięciosekundowe ujęcia w 720p kosztują 1,8525 $. Jedna dodatkowa pięciosekundowa generacja w 1080p zwiększa sumę do 2,8025 $, bez obrazu początkowego i nagrania. Dziesięć postaci z takim przepływem pracy obejmującym cztery próby kosztuje 28,025 $ za generowanie wideo.
Ponowna generacja w 1080p to nowe ujęcie, a nie skalowanie wybranego klipu 720p w górę. Może zmienić wyraz twarzy, rytm i artykulację. Wyłączenie audio nie daje zniżki w podanym cenniku.
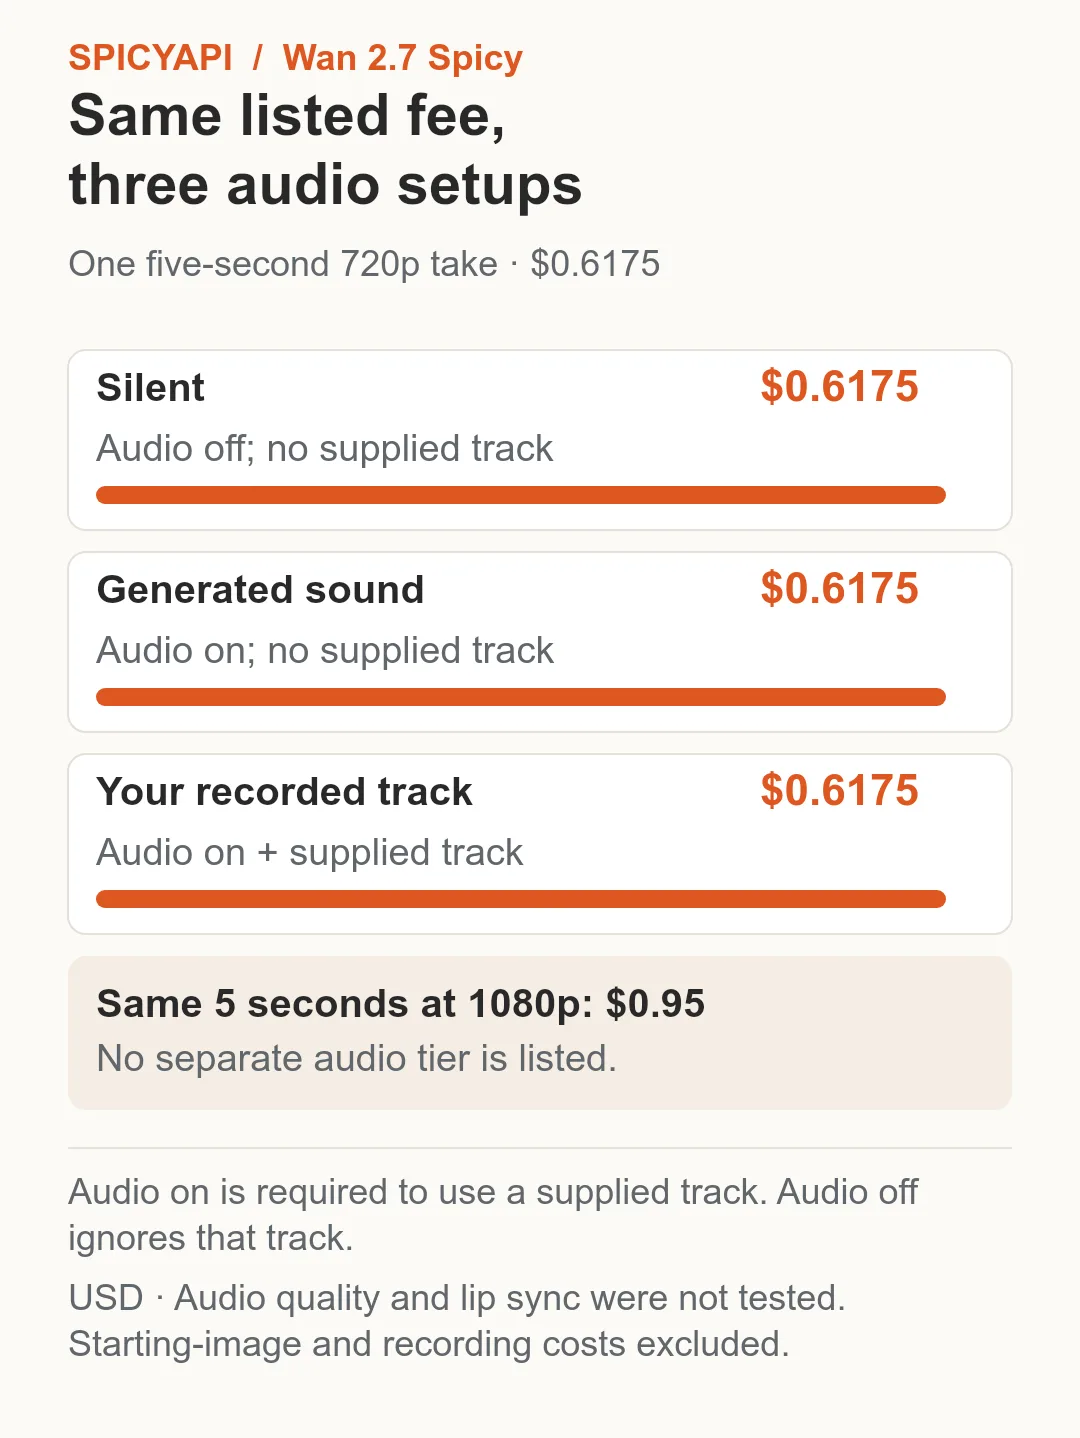
Wan 2.7 Spicy podaje tę samą opłatę 0,6175 $ za pięć sekund w 720p dla konfiguracji bez dźwięku, z dźwiękiem generowanym i z dostarczoną ścieżką. Dostarczona ścieżka wymaga włączonego audio.
Kiedy lepiej pasuje inne zadanie
Używaj Wan 2.7 Spicy, gdy masz gotowy obraz początkowy i chcesz krótki klip dla dorosłych z opcjonalnym wejściem nagranego audio. Zakres 2–15 sekund pozwala dopasować konkretny krótki moment bez kupowania maksymalnej długości.
- Tańsze klipy z nagraną ścieżką: Wan 2.6 Spicy przyjmuje
audio_urli kosztuje 0,475 $ za pięć sekund w 720p. Oferuje stałe długości 5/10/15 sekund i nie ma przełącznika audio. - Klatka końcowa lub więcej niż 15 sekund: Wan 3.0 Spicy oferuje wejście obrazu końcowego i klipy 2–30 sekund, od 0,057 $/s w 480p. Generuje audio, ale nie przyjmuje Twojego pliku audio. Zobacz przewodnik po długościach Wan 3.0.
- Nagrane audio i precyzyjna krótka długość: wybierz Wan 2.7 Spicy dla długości w pełnych sekundach od 2 do 15 w 720p lub 1080p.
Aby porównać zachowanie modeli z tej rodziny wobec treści dla dorosłych, sprawdź wersje Wan bez cenzury.
Otwórz Wan 2.7 Spicy obraz na wideo, prześlij zatwierdzony nieruchomy obraz dorosłej postaci i zacznij od najkrótszego klipu, który pomieści wykonanie. Świadomie wybierz ciszę, generowany dźwięk lub własne nagranie. Oceń rzeczywisty film i ścieżkę dźwiękową, zanim rozszerzysz pomysł na całą serię.
Użyj konfiguracji opartej na głosie przez API
Ustaw SPICY_API_KEY w środowisku, a SPICY_IMAGE_URI na dostępny URL obrazu początkowego lub przesłany URI spicy://. Ustaw SPICY_AUDIO_URI na dostępny URL nagranej ścieżki lub przesłany URI. Ten przykład w Python 3 wysyła jedno nowe ujęcie po potwierdzeniu ceny.
import json
import os
import urllib.request
import uuid

base = "https://api.spicyapi.ai/api/v1"
headers = {"Authorization": "Bearer " + os.environ["SPICY_API_KEY"],
           "Content-Type": "application/json", "User-Agent": "SpicyAPI-Blog/1.0"}
settings = {
    "duration_seconds": 5,
    "resolution": "720p",
    "generate_audio": True,
    "enable_prompt_expansion": False
}
settings["prompt"] = 'The adult speaker talks in one continuous stationary shot.'
settings["image_url"] = os.environ["SPICY_IMAGE_URI"]
settings["audio_url"] = os.environ["SPICY_AUDIO_URI"]
payload = {"model": "alibaba/wan-2.7-spicy/image-to-video", "input": settings}

def post(path, body):
    request = urllib.request.Request(base + path, json.dumps(body).encode(), headers)
    with urllib.request.urlopen(request, timeout=60) as response:
        result = json.load(response)
    if result.get("code") != 200:
        raise RuntimeError(result)
    return result["data"]

quote = post("/jobs/quote", payload)
if input(f"Maximum charge ${quote['maxCharge']}. Type yes to generate: ") != "yes":
    raise SystemExit("Stopped before generation")
headers["Idempotency-Key"] = str(uuid.uuid4())
print("Request key:", headers["Idempotency-Key"], flush=True)
task = post("/jobs/createTask", {**payload, "quoteId": quote["quoteId"],
                              "expectedCost": quote["estimatedCost"]})
print("Task ID:", task["taskId"])
Zachowaj wydrukowany klucz żądania do odzyskania tego samego żądania; nowe ujęcie otrzymuje nowy klucz. Dokumentacja API zadań opisuje dostarczanie i odzyskiwanie wyników.
Przy powtarzanych ujęciach pozwól Agentowi korzystać z zatwierdzonego pliku wejściowego: CLI spicyapi tasks create --model alibaba/wan-2.7-spicy/image-to-video --input-file input.json --wait; MCP poproś o wywołanie spicyapi_task_create z tym modelem i danymi wejściowymi; Skill poproś “Use the spicyapi Skill to generate this approved shot and return the result.” CLI i MCP pokazują cenę przed utworzeniem. Zobacz dokumentację integracji z Agent.