
alibaba/z-image-base-lora/text-to-imageTesto in immagine su Z-Image Base, il modello Z-Image non distillato da 6 miliardi di parametri del team Tongyi-MAI di Alibaba, con fino a tre LoRA tuoi per richiesta. Prompt a frasi, nove proporzioni, JPEG, PNG o WebP e nessun filtro su prompt, pesi o risultati.
Playground
Questi esempi sono stati scritti per questo endpoint. Sostituisci il prompt e gli URL dei media di esempio con input tuoi e raggiungibili, poi controlla il preventivo aggiornato e la disponibilità del modello prima di inviare.
 Output
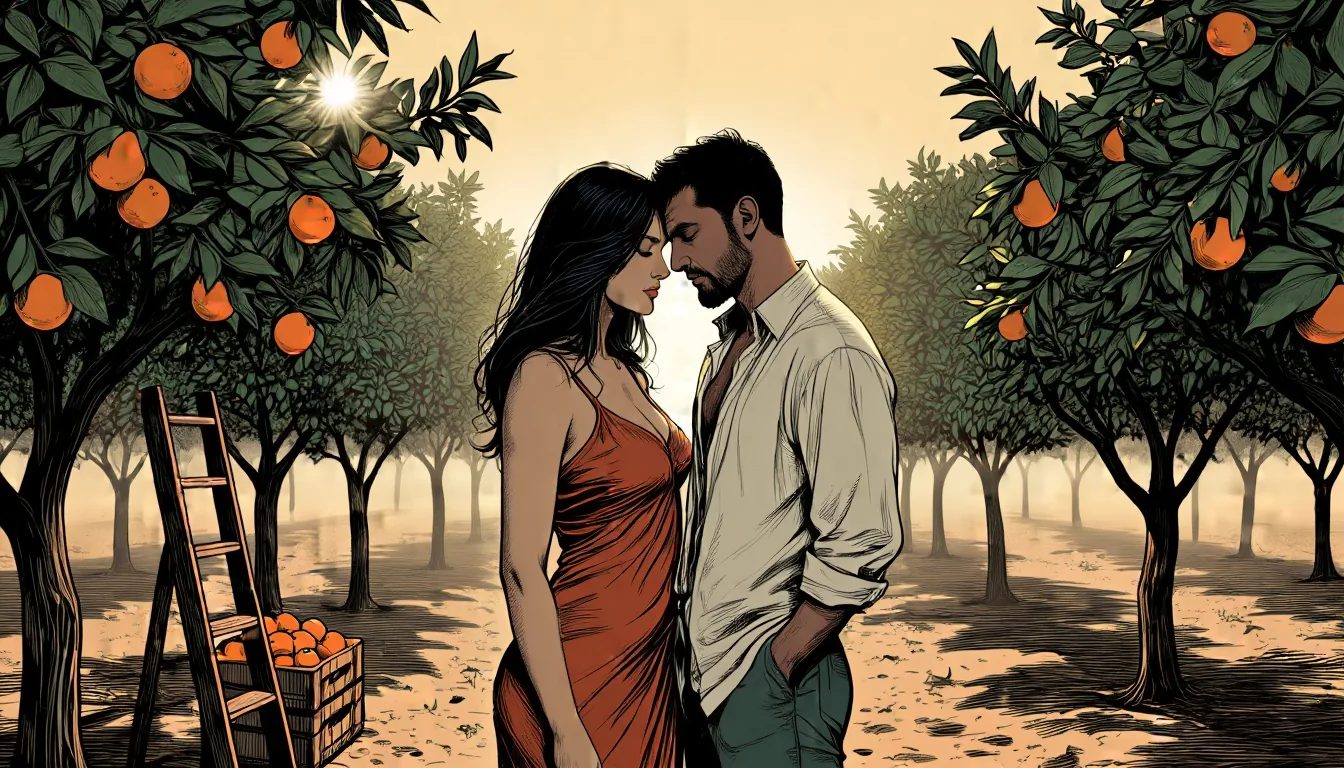
orange-grove-sunrise Un LoRA di illustrazione addestrato su Z-Image Base a 1, con la frase trigger "mature illustration with muted color and complex linework" in testa.
- 321
- 16:9
 Output
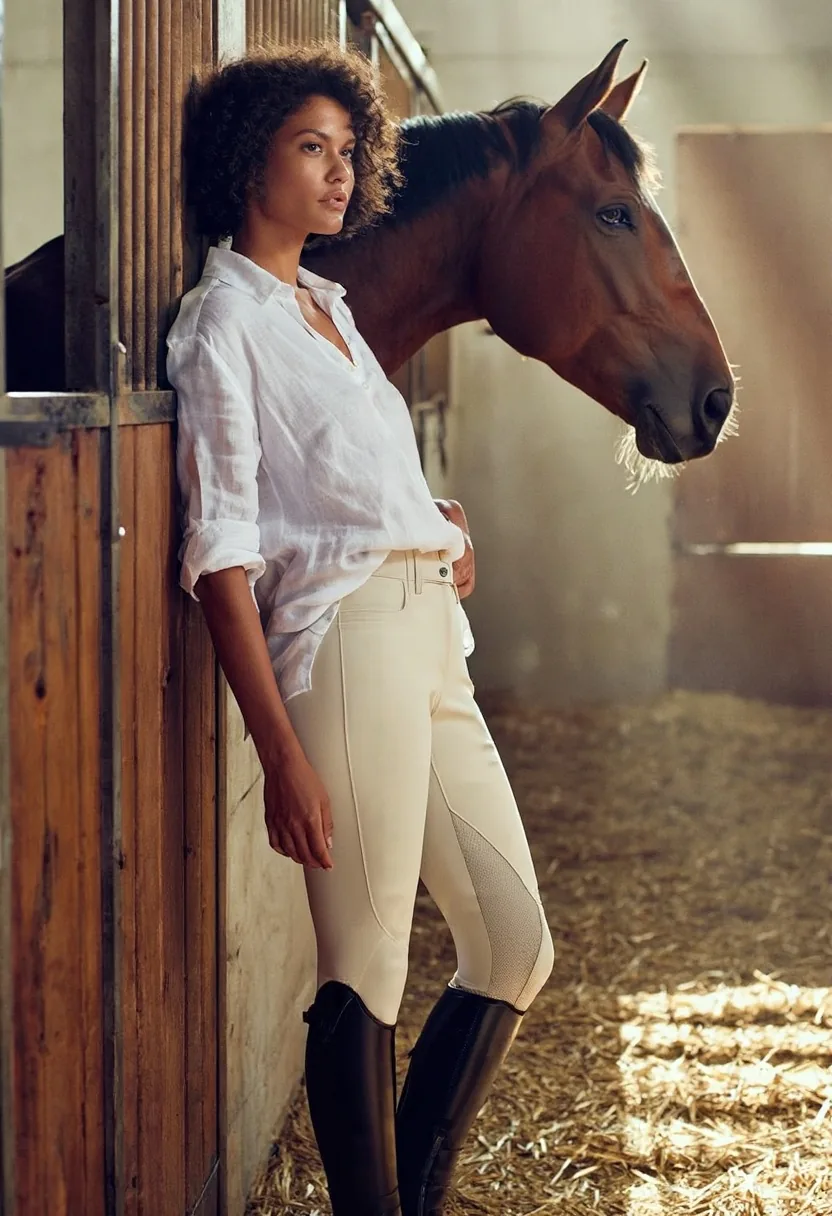
stable-first-light Nessun LoRA: una sola frase lunga su soggetto, abiti, luogo e luce, poi l’obiettivo. L’aspetto fotografico lo gestisce il modello base da solo.
- 302
- 2:3
 Output
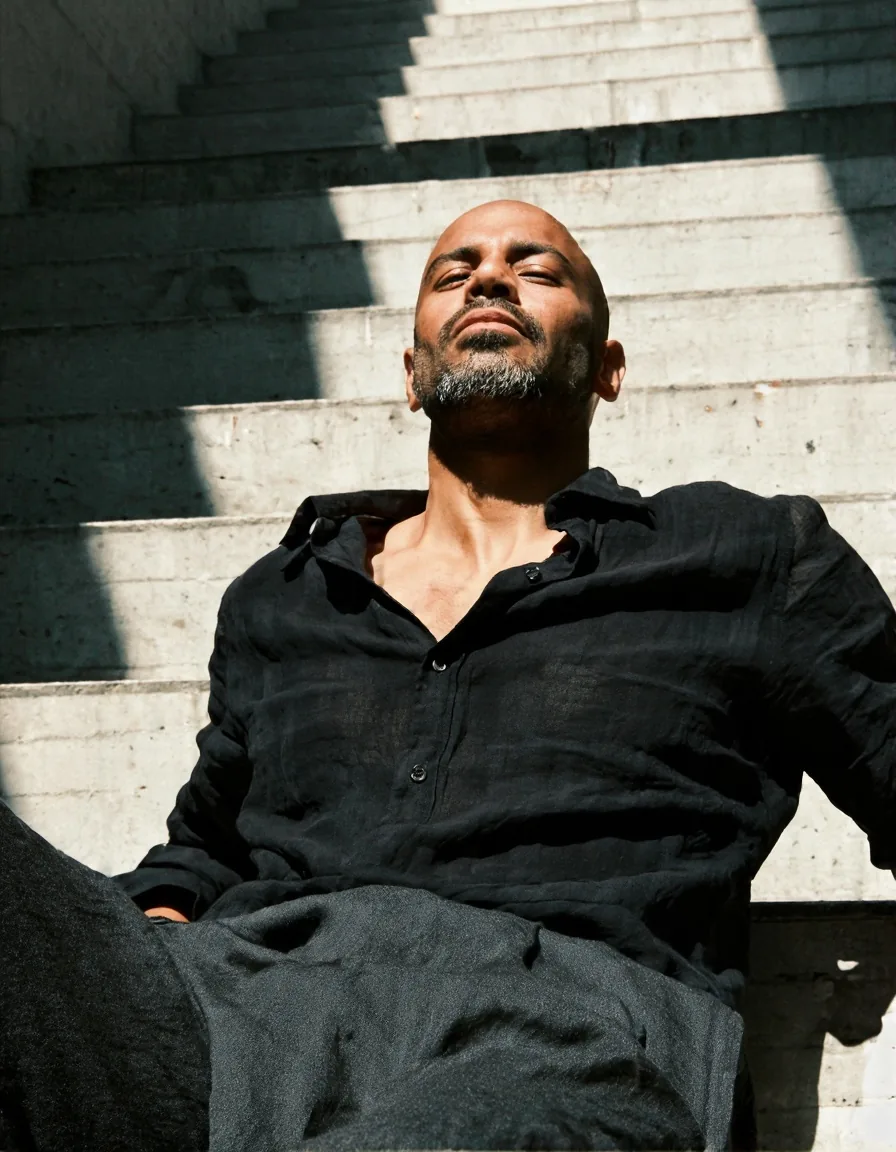
brutalist-stair-noon Nessun LoRA, 3:4. La luce dura e le fasce d’ombra diagonali scritte nel prompt sono ciò che dà forma all’inquadratura.
- 311
- 3:4
 Output
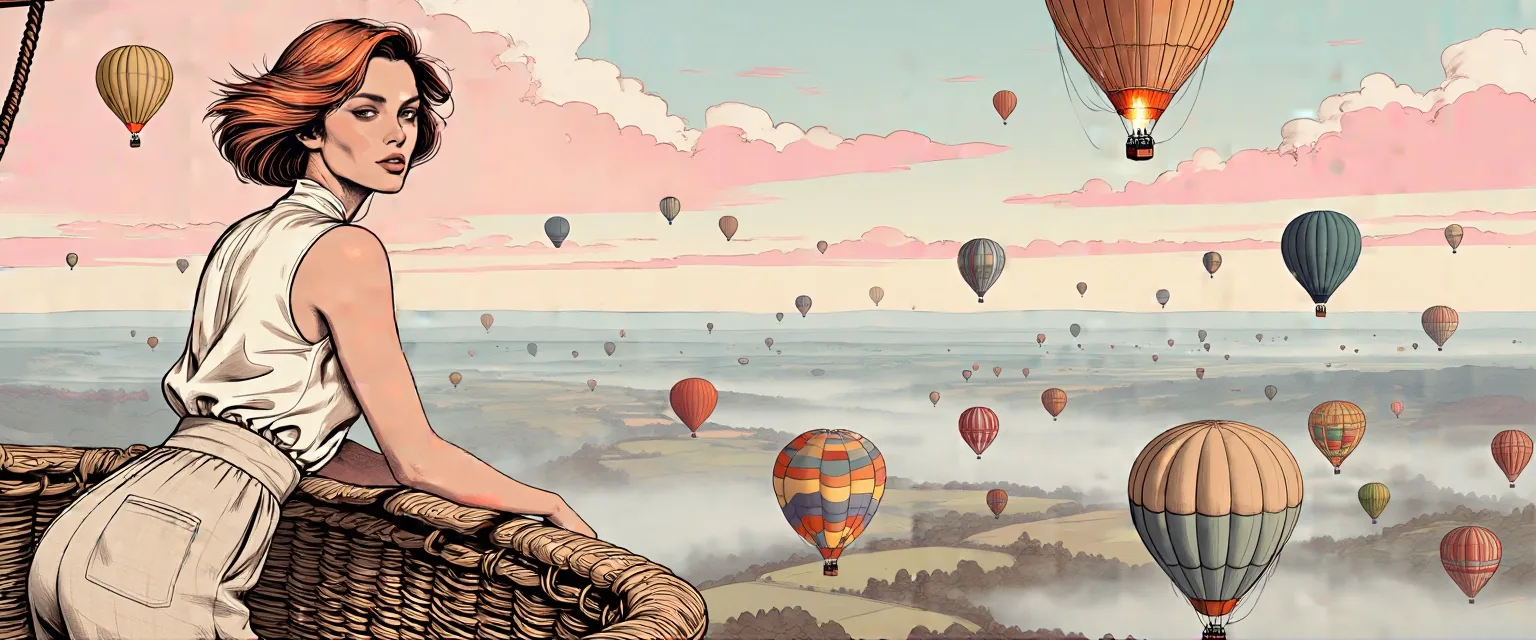
balloon-dawn-21x9 Lo stesso LoRA a 0,8 al formato più largo, 21:9 (1536 x 640): un panorama con una figura in primo piano.
- 337
- 21:9
Questo esempio parte da $0.014 per immagine. Il Playground aggiorna la stima quando cambi le impostazioni.