Vai al contenuto principale

Z-Image del team Tongyi di Alibaba è un modello text-to-image compatto da 6B che restituisce un’immagine fotorealistica in circa un secondo. I prompt arrivano a 1.000 caratteri, in cinque proporzioni, consegnati come PNG lossless.

Da $0.016/immagine

Playground

Input

Da testo a immagine
277/1000
Fino a 1.000 caratteri: un budget piccolo di proposito. Questo endpoint torna abbastanza in fretta da trattare la formulazione come un esperimento: cambia una cosa per esecuzione invece di riscrivere tutto. almeno 1 caratteri · al massimo 1000 caratteri
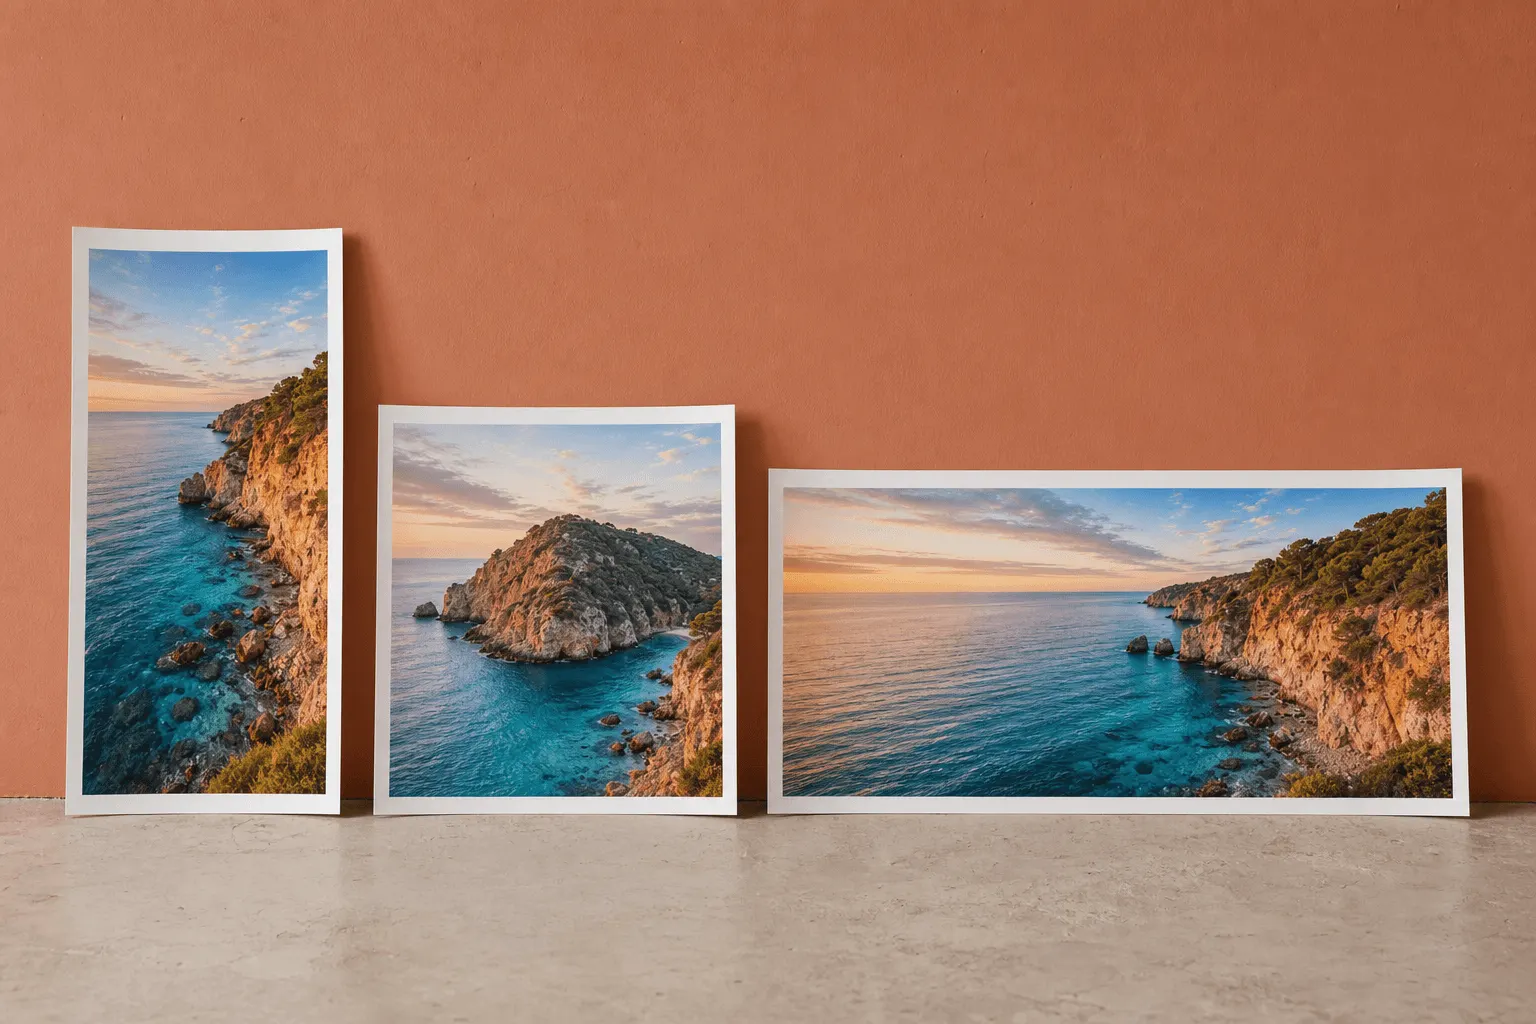
Forma dell'output: cinque valori, quadrato per impostazione predefinita, dal 16:9 orizzontale al 9:16 verticale. Ogni proporzione corrisponde a una dimensione fissa vicina all'intervallo nativo, così la qualità resta uniforme; genera nelle proporzioni in cui pubblicherai.
Espansione del promptincide sul prezzo
Disattivato di default, quindi il prompt viene usato così come l’hai scritto. Se lo attivi, il modello riscrive un prompt breve in una descrizione più completa prima di generare, per risultati migliori. Le richieste con l’espansione attiva si pagano alla tariffa di espansione del prompt, più alta di quella standard; la stima che vedi prima dell’invio ne tiene già conto.
Formato di output
PNG
`png` è l'unico valore, ed è anche quello predefinito. È senza perdita, e questo lo rende il passaggio sicuro verso ulteriori modifiche. Il campo serve a tenere esplicita la richiesta; non cambia né l'immagine né il prezzo.
Seed
Intero da 0 a 2147483647 per la partenza casuale; se lo ometti, ogni esecuzione ne estrae uno proprio. Con lo stesso prompt, lo stesso formato e lo stesso seed il risultato torna molto vicino all’immagine precedente, quindi conserva il seed con ogni immagine che tieni e cambia una frase alla volta a partire da lì. Fissa il rumore di partenza, non il risultato pixel per pixel. Nessun effetto sul prezzo. non meno di 0 · non più di 2147483647
Controllo di sicurezzaDisattivato

SpicyAPI non applica nessun controllo di sicurezza a questo modello. Il tuo prompt e i tuoi media arrivano al modello così come li hai scritti, ed è il modello stesso a decidere che cosa torna indietro.

Controllo del tuo account prima di abilitare invio e prezzi.

Output

Pronto per una nuova esecuzione
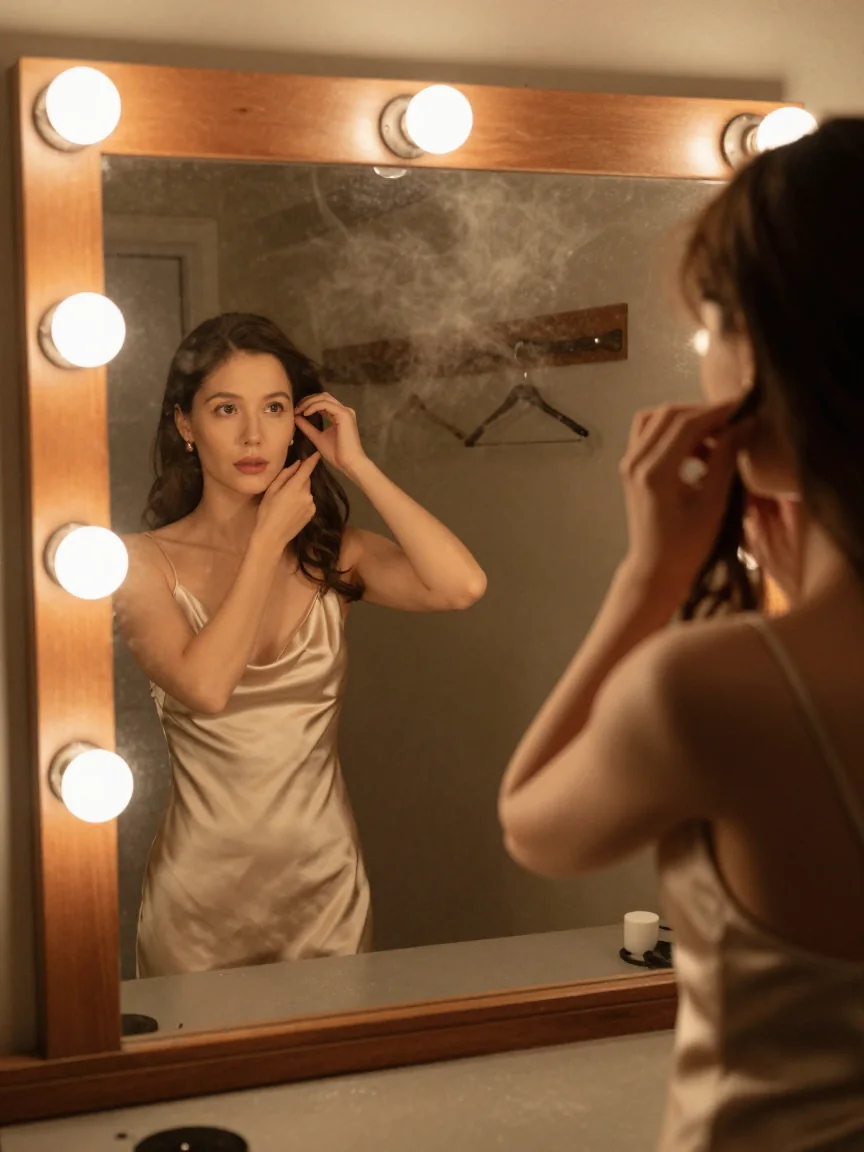
vanity-mirror-before-curtainRisultato di esempio

Modelli correlati e attività successive

Manca il modello che ti serve?

Dicci cosa aggiungere e dove lo useresti. Le richieste arrivano a chi decide quali modelli integrare per primi.

Un PNG fotorealistico per chiamata, in circa un secondo

L'API da testo a immagine di Z-Image Turbo trasforma un prompt scritto in un'immagine fotorealistica, tipicamente in circa un secondo. Accetta un prompt fino a 1.000 caratteri e una delle cinque proporzioni, e restituisce l'immagine come PNG senza perdita. Un seed opzionale permette confronti controllati; aspect_ratio definisce la forma al posto di larghezza o altezza personalizzate.

Apri il Playground
Un PNG fotorealistico per chiamata, in circa un secondo
Modello base
Checkpoint Z-Image-Turbo di Alibaba, licenza Apache-2.0, rilasciato il 26 novembre 2025
Parametri
6B, distillato a circa otto passaggi del modello per immagine
Latenza tipica
Circa un secondo per immagine
Campi accettati
prompt (obbligatorio), aspect_ratio, output_format, seed ed enable_prompt_expansion
Riproducibilità
Seed opzionale: intero da 0 a 2147483647 per confronti controllati
Finestra del task
Asincrono; un task deve raggiungere uno stato finale entro 5 minuti
Iterazione
Un ciclo abbastanza breve da restarci dentroCirca un secondo per immagine significa che una domanda sulla formulazione trova risposta mentre la stai ancora ponendo. Una sessione qui finisce di solito per essere una dozzina di letture della stessa idea, ciascuna una piccola modifica rispetto alla riga precedente.
Inquadratura
La proporzione è una scelta, non un ritaglioIl campo aspect_ratio è l'unico controllo di inquadratura di questo endpoint: cinque valori fissi, nessuna dimensione libera in pixel. Ognuno compone la propria inquadratura, quindi la forma che chiedi è quella intorno a cui il modello costruisce l'immagine, e un'immagine verticale viene generata verticale.
Integrazione
La chiamata restituisce un riferimento al taskInviare un prompt avvia un task asincrono; interrogalo finché non raggiunge uno stato finale, cosa che deve avvenire entro cinque minuti, poi leggi il PNG dallo storage della piattaforma. Conserva il corpo della richiesta insieme a ogni immagine che salvi, perché una chiamata ripetuta ne genera una diversa.

Cosa fa bene l'API di Z-Image

Dettaglio fotografico alla velocità

Dettaglio fotografico alla velocità

Alibaba descrive il checkpoint Turbo come capace di una forte generazione fotorealistica mantenendo la qualità estetica, e i prompt che nominano materiali e luce sono quelli che ci arrivano. Scrivi la trama del tessuto, l'usura del metallo e la direzione da cui viene la luce, e il dettaglio di superficie segue di conseguenza. Gli aggettivi sulla qualità fanno molto meno lavoro qui rispetto a una fonte di luce nominata.

Qualità costante su tutte le proporzioni

Qualità costante su tutte le proporzioni

Ogni proporzione si risolve in una propria dimensione fissa in pixel, vicina all'intervallo nativo in megapixel del modello, così un'immagine 9:16 per le storie viene composta per quella forma fin dal primo passaggio invece di essere ritagliata da un quadrato. I cinque valori coprono il quadrato, entrambi gli orientamenti 4:3 e entrambi gli orientamenti 16:9, e su questo endpoint non c'è una larghezza o un'altezza personalizzabile.

  • Due lingue, nel prompt e nell'immagine

    Alibaba descrive il checkpoint Turbo come capace di rendere con precisione testo complesso in cinese e in inglese, così un'insegna o un'etichetta di prodotto nominata nel prompt tende a tornare come caratteri leggibili. Limitati a poche parole in evidenza, perché un testo fitto e piccolo non è ciò per cui un modello da 6B è costruito. Gli esempi pubblicati dalla stessa Alibaba sono scritti in entrambe le lingue, e il prompt raggiunge il modello esattamente come digitato.

  • Mantieni fisso il seed per confrontare meglio

    Usa gli stessi prompt, aspect_ratio e seed, cambiando una sola parte della frase alla volta. Quando una formulazione funziona meglio, prova più seed per vedere se il miglioramento si mantiene su immagini diverse.

  • Bordi senza perdita per il compositing

    L'output è PNG, l'unico valore accettato da output_format, quindi nulla lungo un contorno è passato per una compressione con perdita prima di raggiungerti. L'immagine entra direttamente in un compositing, in una maschera o in un'ulteriore modifica senza gli artefatti che una sorgente compressa aggiungerebbe prima, e l'unica codifica di cui una consegna ha bisogno avviene alla fine di quella catena.

  • Un'immagine, un prezzo

    Una chiamata restituisce un'immagine, e le cinque proporzioni costano tutte uguale: su questo endpoint non ci sono un numero di step, una modalità di qualità o un moltiplicatore di risoluzione, e output_format ha un solo valore. L'addebito è per immagine prodotta, secondo una stima in tempo reale mostrata prima dell'invio, quindi un budget per chiamata regge senza bisogno di una tabella di varianti.

Per chi è Z-Image

  • Trovare la direzione prima di impegnare il budget

    Concept art

    Trovare la direzione prima di impegnare il budget

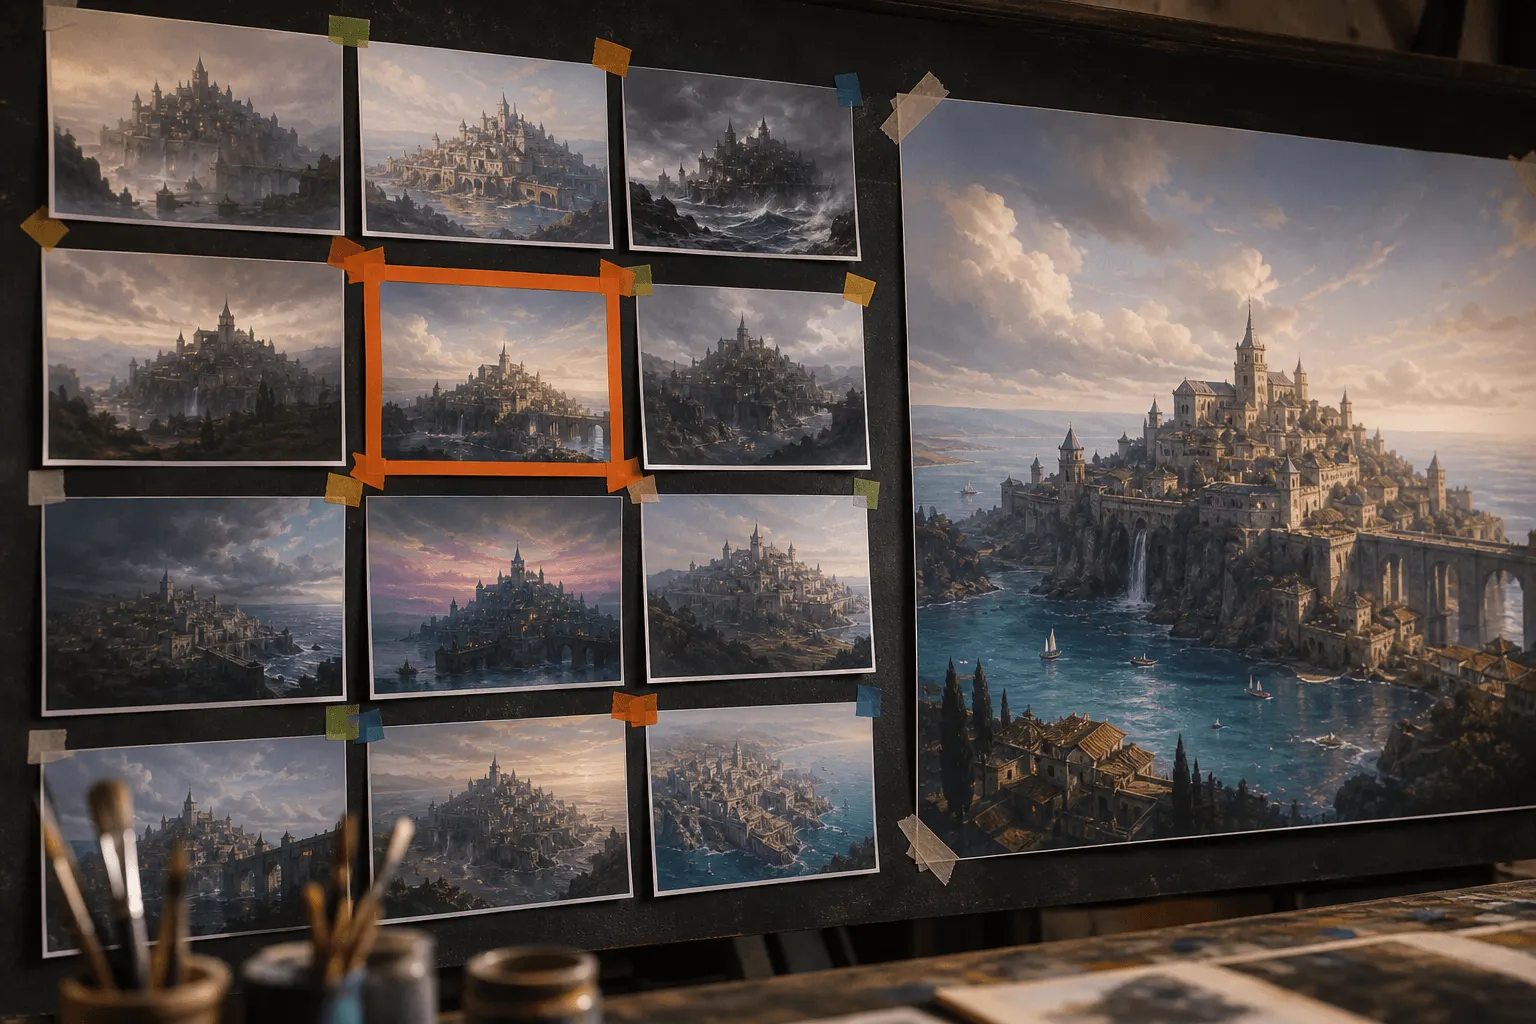
    Esplora un personaggio o un ambiente attraverso una dozzina di letture nel tempo che un modello più lento impiega per una sola, cambiando illuminazione, posa o ambientazione a ogni passaggio. Porta la lettura che funziona a un modello più pesante per la tavola finale, una volta che la direzione non è più la domanda aperta.

  • Inquadrare lo stesso oggetto in più modi

    Marketing di prodotto

    Inquadrare lo stesso oggetto in più modi

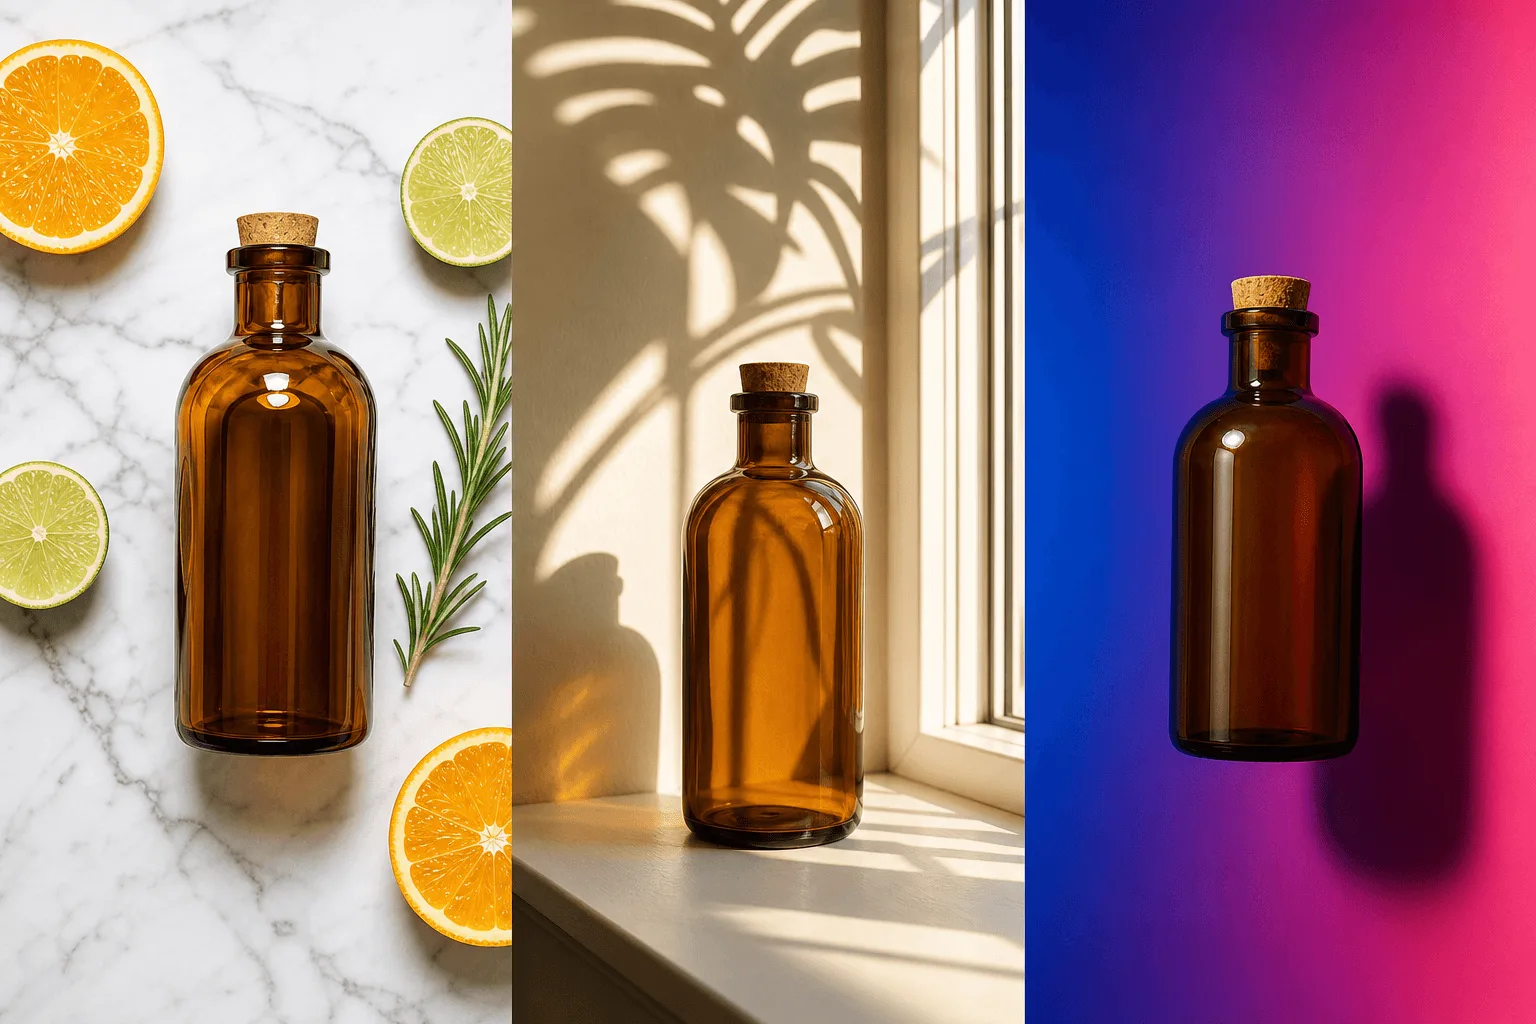
    Genera la stessa inquadratura in 1:1, 3:4 e 16:9 prima che il layout sia definitivo, così la discussione sul ritaglio in una revisione avviene su immagini reali invece che su un unico mockup quadrato allungato per indovinare le altre.

  • Costruire una mood board che sostiene una posizione

    Editoriale e direzione artistica

    Costruire una mood board che sostiene una posizione

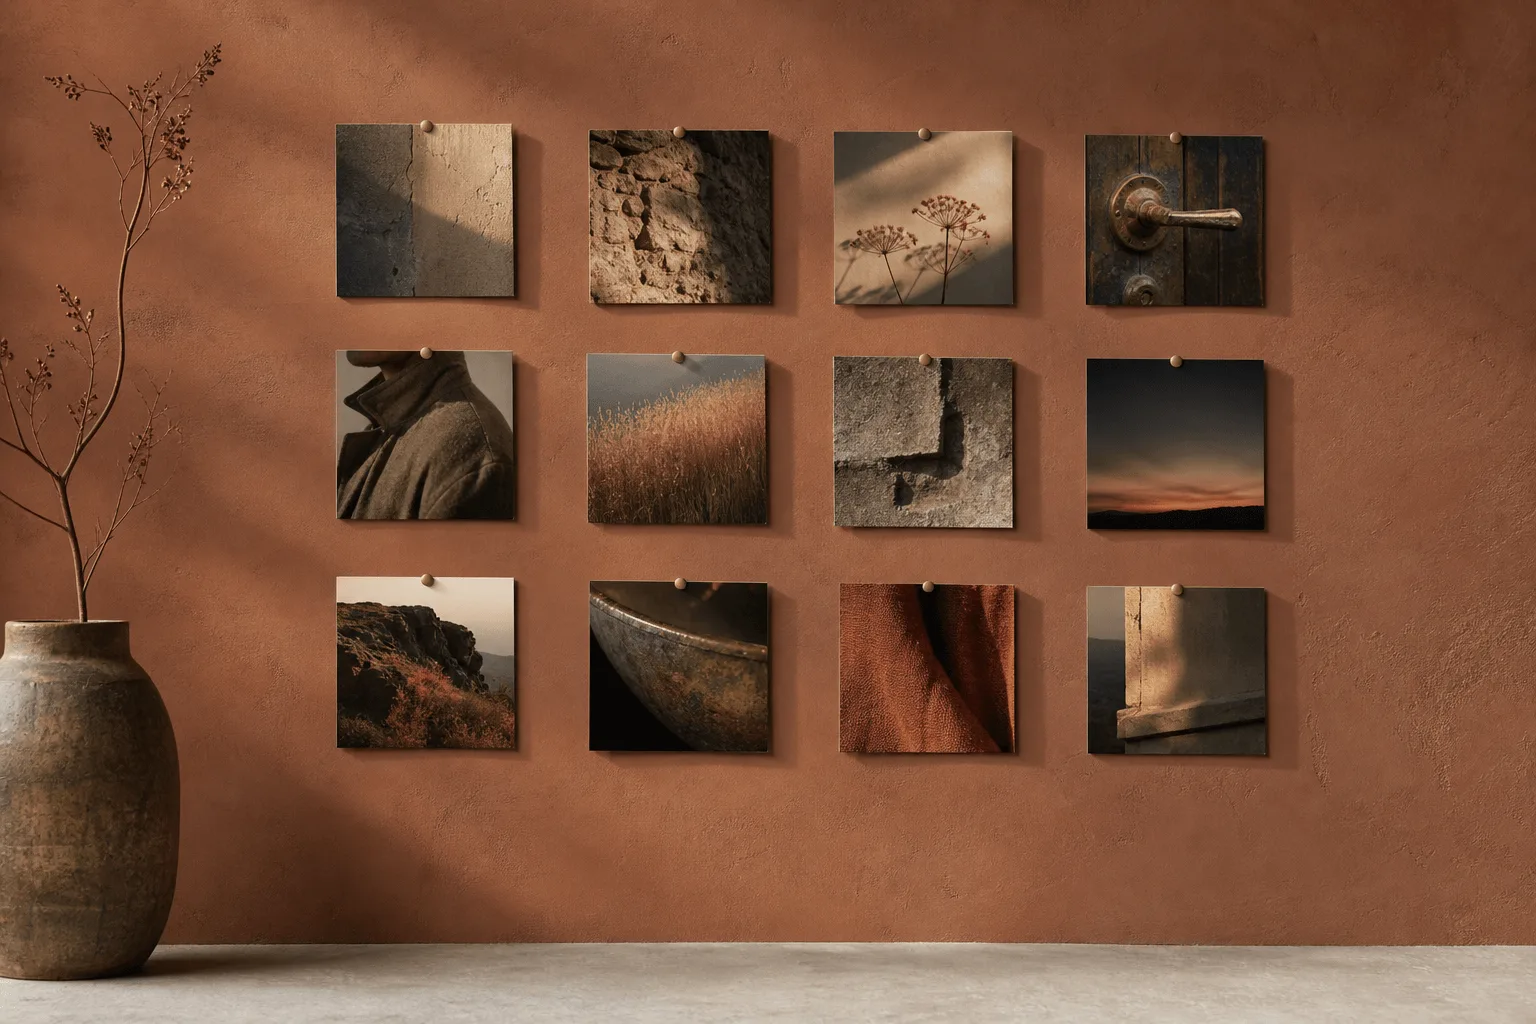
    Una dozzina di immagini che condividono luce e palette costruiscono un argomento che un paragrafo di descrizione non può reggere. Poiché ognuna costa poco e torna in circa un secondo, un'intera board può essere costruita e rimescolata in un'unica sessione invece che pianificata come un compito a parte.

  • Mantenere un cast visivamente coerente

    Lavoro sui personaggi e role play

    Mantenere un cast visivamente coerente

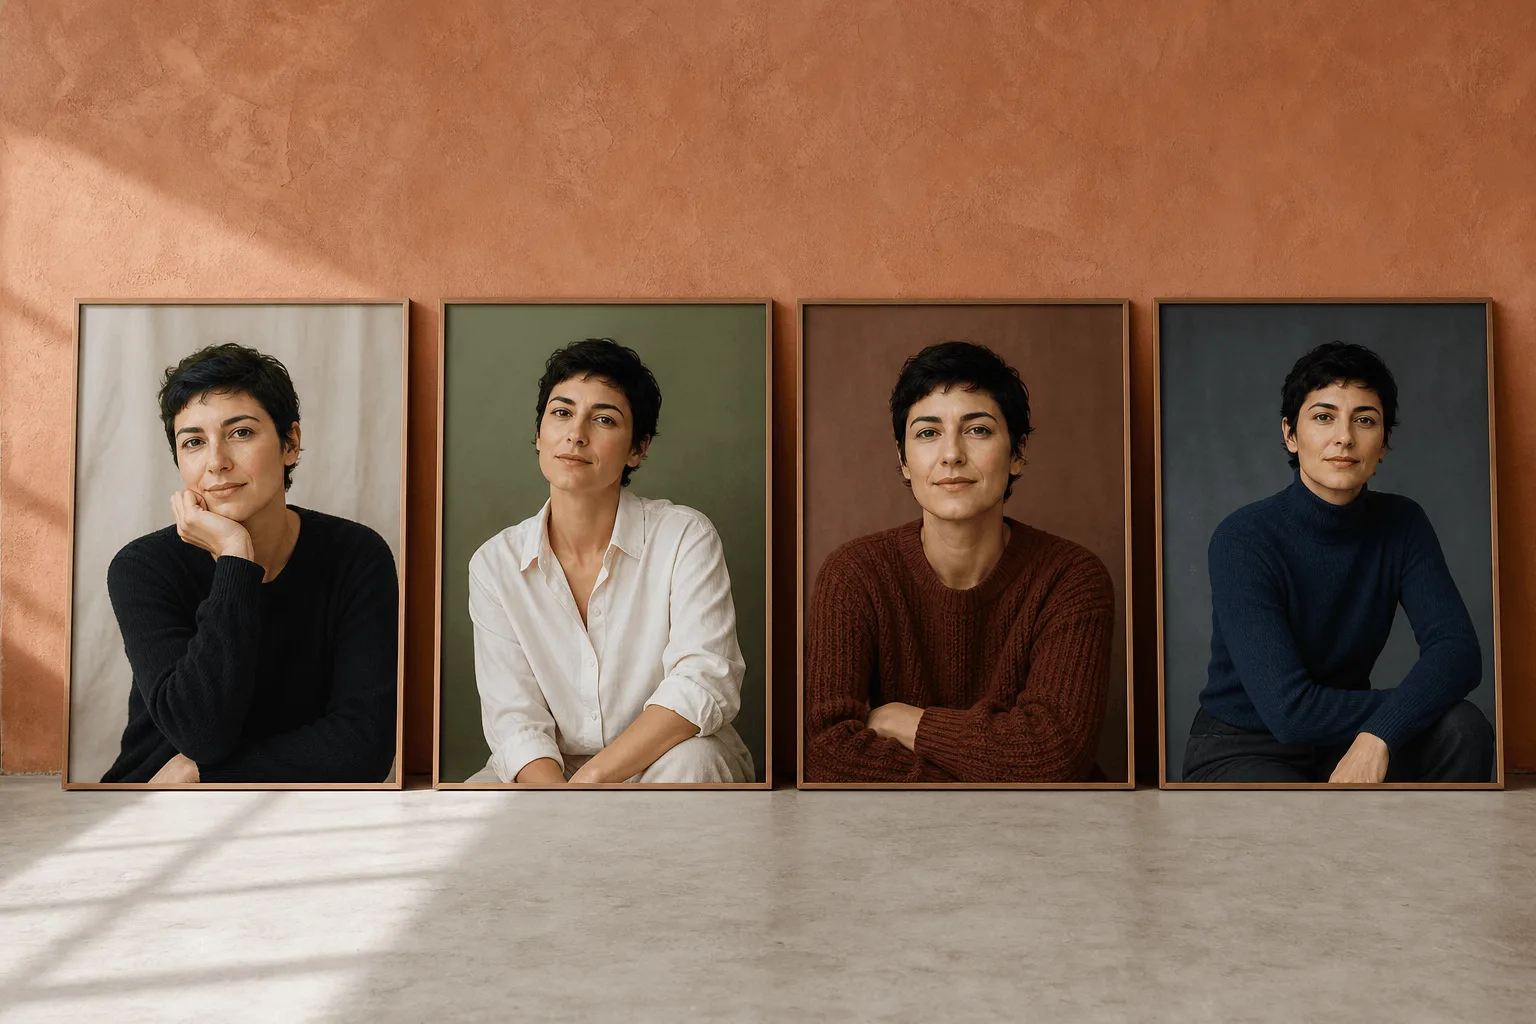
    Scrivi l'aspetto di ogni personaggio come un unico blocco di testo fisso che copre età, capelli, corporatura e un segno distintivo, e incolla quel blocco invariato in ogni scena, con guardaroba e ambientazione in una clausola separata. Mantieni stabile quella descrizione del personaggio e fissa il seed per confrontare abiti o ambientazioni.

Come si chiama l'API di Z-Image

  1. Separare il soggetto dal trattamento

    prompt è l'unico campo obbligatorio, quindi dagli una struttura: nomina prima ciò che è in inquadratura, poi come deve apparire. Scritto come un'unica clausola confusa, il modello bilancia l'una contro l'altra e non puoi sapere quale istruzione ha perso.

  2. Imposta aspect_ratio prima di scrivere il prompt

    Il campo ha come valore predefinito 1:1, e la stessa descrizione a figura intera si compone in modo diverso a 9:16 rispetto a 16:9. Decidere prima la forma tiene il testo mirato all'inquadratura che verrà effettivamente renderizzata, e risparmia un secondo passaggio per correggere l'inquadratura.

  3. Scegli tra varietà e confronto controllato

    Ometti seed per esplorare nuove varianti oppure imposta un intero da 0 a 2147483647 per confrontarle. Salva il seed insieme al prompt e alle impostazioni, così il confronto successivo parte dalla stessa richiesta.

  4. Cambia una clausola per chiamata

    Quando un risultato è vicino, modifica una singola clausola e invia tutto il resto esattamente com'era, poi registra entrambi i corpi della richiesta. Quel confronto è l'unica traccia di cosa è cambiato tra due immagini, perché la risposta porta l'immagine e nulla sul testo che c'è dietro.

  5. Rilancia la versione scelta nelle proporzioni che ti servono

    Le consegne raramente condividono un'unica forma. Poiché ogni proporzione compone la propria inquadratura, la versione verticale di un'immagine scelta si ottiene rilanciando lo stesso prompt a 9:16, il che costa una chiamata in più e un secondo di attesa e restituisce un'immagine costruita per quella forma.

Esempi svolti con Z-Image

  • Uno scatto di prodotto che sopravvive al ritaglio

    Invia lo stesso prompt due volte, una a 4:3 per lo slot principale e una a 9:16 per l'immagine delle storie. Entrambe tornano composte per la propria forma, così la revisione del layout confronta due immagini finite.

    A weathered brass diving helmet on a workbench, single window light from the left, shallow depth of field, fine scratches catching the highlight
  • Una scheda personaggio costruita attorno a un solo volto

    Porta una singola frase d'identità (età, capelli, la cicatrice) parola per parola in ogni chiamata, e cambia solo la clausola su guardaroba e sfondo. Il testo ripetuto è ciò che tiene insieme la scheda, e la clausola che varia è dove ogni voce guadagna il proprio posto.

    Portrait of the same woman, mid-thirties, short dark hair, small scar above the left eyebrow, three-quarter view, overcast daylight, muted olive coat
  • Un'insegna di negozio che deve restare leggibile

    Alibaba descrive questo checkpoint come capace di rendere il testo con precisione, quindi vale la pena testare poche parole di un'insegna prima di pianificare un layout intorno ad esse. Metti le parole tra virgolette, tienile brevi, e indica dove si trovano nell'inquadratura.

    A small corner bookshop at dusk, hand-painted sign above the door reading "NIGHT SHIFT BOOKS", warm window light, wet pavement reflecting the letters, 35mm street photograph

Domande sull'API di Z-Image

Scrivi l'inquadratura come la briefererebbe un fotografo: il soggetto, poi l'obiettivo e la distanza, poi la luce e la sua direzione, poi il dettaglio di superficie che vuoi far sopravvivere. Nomina una sola fonte di luce invece di sovrapporne due, perché descrizioni in competizione tendono ad annullarsi a vicenda. Mantieni aspect_ratio fisso mentre testi il testo, così solo una cosa cambia tra un'esecuzione e l'altra. Nessun filtro della piattaforma è davanti a questo endpoint, quindi l'unico confine su un prompt è quello del modello stesso.