Własną LoRA warto wczytywać tylko wtedy, gdy wytrzyma potrzebne ujęcie: postać, ruch i dźwięk jednocześnie. MiniMax H3 LoRA w SpicyAPI (spicyapi.ai) to model wideo H3 z otwartymi wagami i polem loras: do trzech własnych plików .safetensors w jednym żądaniu, każdy z siłą od 0 do 4.
Wybierz zadanie według materiału wyjściowego i podlinkuj bezpośredni plik wytrenowany pod H3. Zacznij od skali 1 dla LoRA stylu i od 0.6 do 0.8 dla LoRA konceptu, a szkic długości 3 sekund w 480p ($0.15) porównaj z tym samym żądaniem z pustym loras. Na podstawie naszych testów z września 2026 wszystkie trzy zadania obsłużyły żądania dla dorosłych, a SpicyAPI nie dokłada do wczytywanych wag żadnego dodatkowego filtra treści.
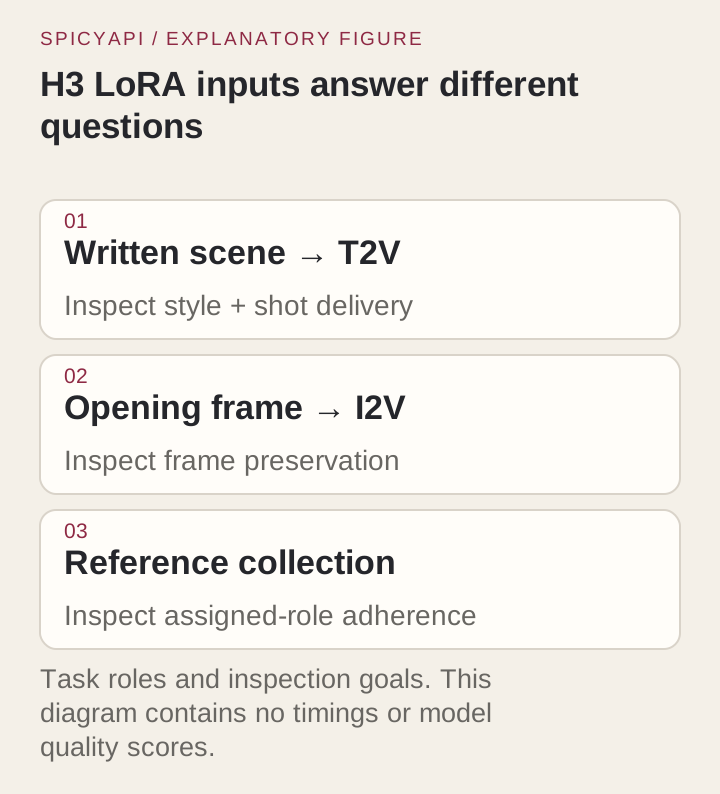
Wybierz zadanie według materiału wyjściowego
| Materiał wyjściowy | Zadanie | Co robi tu LoRA |
|---|---|---|
| Napisana scena | Tekst na wideo | Wyznacza wygląd, więc to najjaśniejszy pierwszy test dla każdego pliku. Siedem proporcji. |
| Zatwierdzona klatka | Obraz na wideo | Klip otwiera się na twojej klatce i zachowuje jej kształt (nie ma pola proporcji). Opcjonalne last_image_url ustawia klatkę końcową. Silna LoRA może odciągnąć klip od klatki, a LoRA stylu blednieje na zdjęciu. |
| Obrazy, klipy i audio | Referencja na wideo | Do 9 obrazów, 3 klipy i 3 klipy audio, każdy z jednym zadaniem w prompcie. LoRA postaci wraz ze stillami tej samej osoby najlepiej utrzymuje tożsamość. |
Wszystkie trzy zwracają plik MP4 od 3 do 15 sekund z dźwiękiem stereofonicznym z tego samego przebiegu, w 480p, 540p, 768p lub 1080p, a wczytywanie LoRA nic nie dopłaca. Gdy nie ma żadnej LoRA do wczytania, podstawowy H3 jest tańszy. Żeby ustalić postać lub wygląd przed opłaceniem sekund wideo, najpierw zrób stille w H3 Image LoRA; ta sama tablica loras przenosi się dalej (stille a wideo).
Wybierz LoRA pasującą do H3
Plik musi być wytrenowany pod MiniMax H3. LoRA dla innego modelu bazowego nie jest zgodna; nawet adaptery H3 wymagają zadania i układu wag, które obsługuje wczytywacz. LoRA dla H3 są nowe, a jakość bywa różna, więc szukaj karty modelu, która podaje bazę, słowo wyzwalające i działającą siłę. Oto dwa pliki, które to robią i wczytują się w tym API:
| LoRA | Efekt | Zadania | Wyzwalacz | Siła od autora | Rozmiar |
|---|---|---|---|---|---|
| vh5tape | Zniszczony wygląd VHS z lat 80.: szum taśmy, przelanie barw, przygaszony dźwięk | Tekst, obraz | vh5tape, pierwszy w prompcie | 1.0 dla pełnego wyglądu, od 0.7 do 0.9 dla łagodniejszego zużycia | 131 MB |
| H3 Realism People | Realistyczna skóra i twarze oraz lekkie wrażenie kamery w ręku | Jeden plik dla tekstu, obrazu i referencji | r34l1sm | 1.0 zamierzona, od 0.6 do 0.8 dla lżejszego działania | 131 MB |
Oba używają H3 Community License, która ma ograniczenia terytorialne i użytkowe; przeczytaj ją przed pracą komercyjną.
Z karty modelu bierz tylko wyzwalacz i siłę. Recepty pisane pod lokalny ComfyUI lub inne hosty zawierają ustawienia, których to zadanie nie ma (prompt_expansion_mode, liczby kroków, samplery, weight_name, nazwę repozytorium zamiast odnośnika), a LoRA z destylacją prędkości (Turbo) istnieją po to, by skrócić lokalne kroki próbkowania, więc je pomiń.
Podlinkuj plik
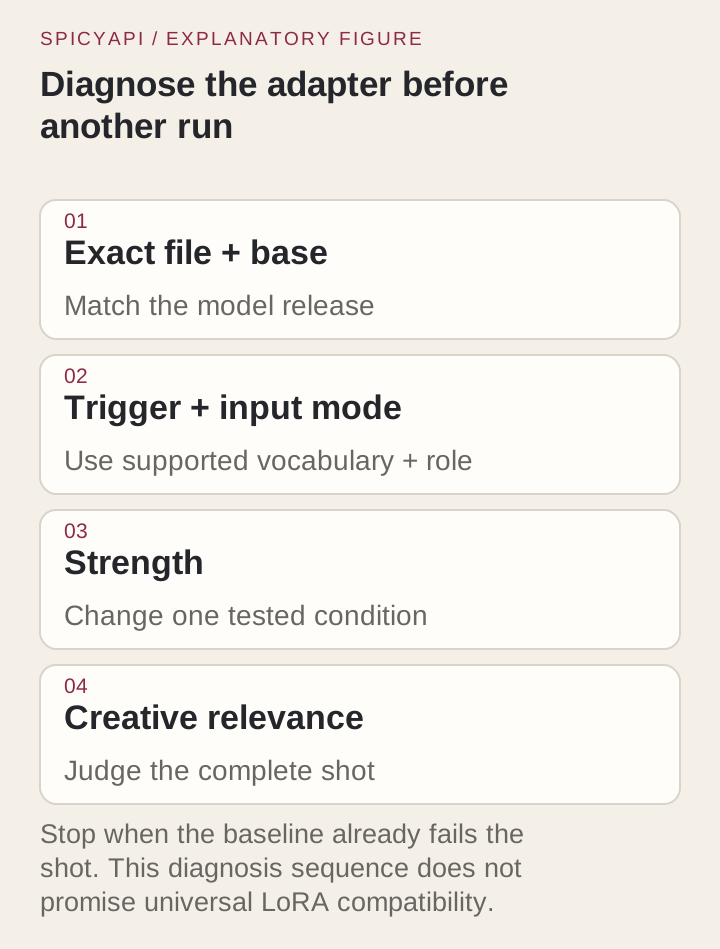
path musi być bezpośrednim odnośnikiem HTTPS, który zwraca plik .safetensors bez logowania. W Hugging Face to odnośnik /resolve/, a nie strona /blob/ z paska adresu. Żądanie nie ma pola z danymi logowania, więc plik prywatny wymaga odnośnika z podpisem wstępnym, który pozostaje ważny do czasu wykonania zadania. Zamień main na hash commita, aby to samo żądanie w przyszłym miesiącu wczytało ten sam plik. Strona /blob/, brak pliku albo prywatne repozytorium zostają odrzucone z 400, zanim jakiekolwiek zadanie powstanie. Jeśli zadanie padnie po przyjęciu, wyślij identyczne żądanie z "loras": []: jeśli przejdzie, problemem jest plik (dostęp, zgodność albo jego działanie); jeśli też padnie, zajrzyj do promptu lub danych wejściowych.
Najpierw wypróbuj w Playground
- Otwórz stronę tekst na wideo, zostań na karcie Playground w widoku Form i zaloguj się zasilonym kontem, aby uruchomić. Obraz na wideo i referencja na wideo mają własne strony (odnośniki w tabeli powyżej).
- Umieść słowo wyzwalające na początku Prompt, a potem opisz ujęcie jako krótką oś czasu (kto występuje, co robi, jak porusza się kamera), a dźwięk umieść w osobnej linii
Audio:. Rozbudowywanie opisu tego, co LoRA już robi, zwykle kłóci się z wagami. - W sekcji Style LoRAs wklej bezpośredni odnośnik do pliku w LoRA file i ustaw Strength. Add item pozwala na trzy pliki.
- Wybierz 480p w Resolution i 3 w Duration na tani pierwszy rzut oka, ustaw Seed i uruchom.
- Naciśnij Remove item, uruchom ponownie z tym samym promptem i seedem i porównaj oba klipy. Jeśli wyglądają podobnie, LoRA nic nie zrobiła (patrz tabela błędów poniżej).
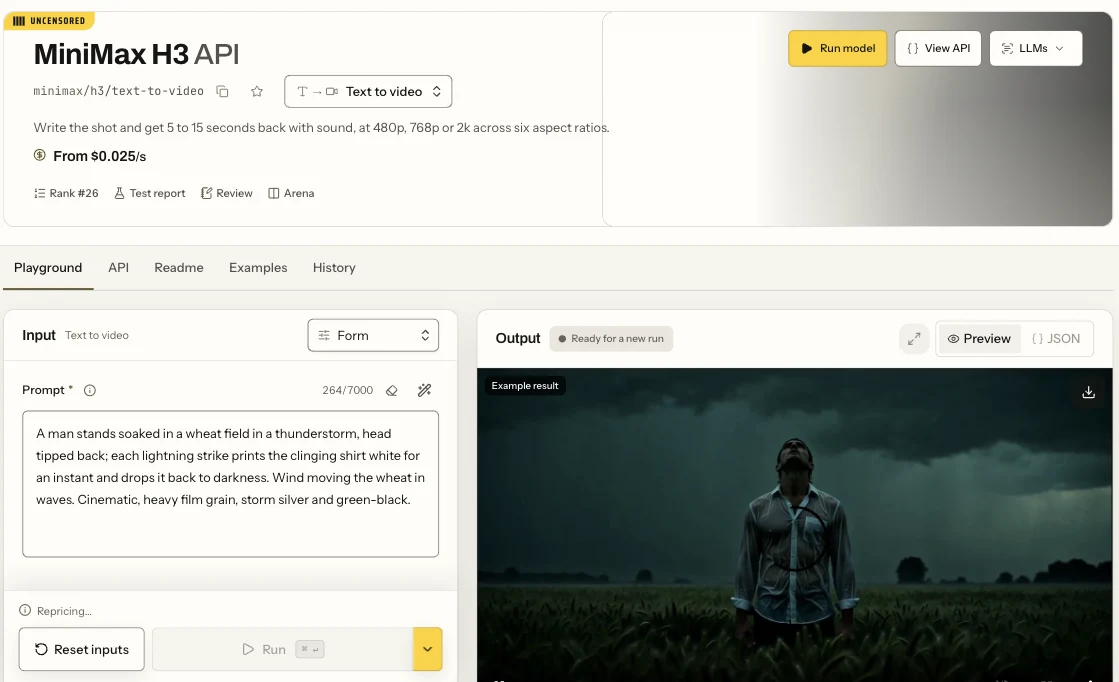
Playground tekst na wideo MiniMax H3 w widoku Form, z polem Prompt i przyciskiem Run. Strona LoRA dodaje do tego samego formularza sekcję Style LoRAs.
Treść żądania w Playgroundzie to ten sam JSON, który przyjmuje API, więc ustawienie działające tutaj można wkleić wprost do kodu. Pozostałe dwa zadania mają własne dane wejściowe:
- Obraz na wideo dodaje Input image (klatkę otwierającą) i opcjonalny Closing frame. Opisz, co dzieje się dalej wewnątrz kadru, a nie nową scenę: przy LoRA konceptu na 1 prompt przenoszący postać do innego pokoju zastępował klatkę otwierającą, a ta sama klatka utrzymywała się, gdy prompt opisywał ruch wewnątrz niej. Nie ma pola proporcji, więc najpierw przytnij klatkę do pożądanego kształtu i zostaw miejsce na ruch.
- Referencja na wideo dodaje Reference images (do 9), Reference videos (do 3) i Reference audio (do 3). Otwórz prompt jednym krótkim zdaniem na każde wejście, każde z jednym zadaniem: Picture 1 is the woman, Picture 2 is the room, Video 1 is the camera move, Audio 1 is her voice. Gdy bierzesz ruch z klipu, powiedz wprost, że postać pochodzi z obrazu, a tylko ruch z klipu; bez tego zdania tancerka z klipu przyszła razem z ruchem. Trzy dobre stille utrzymują tożsamość lepiej niż dziewięć nałożonych.
Playground każdej strony modelu otwiera się na gotowym przykładzie, a jego panel Request body pokazuje dokładny JSON. Trzy przebiegi tych przykładów:
Klipy referencyjne są rozliczane za swoje sekundy dodatkowo do sekund wyjściowych, łącznie do 15 sekund klipu, więc trzymaj je krótkie.
Potem uruchom to z kodu
Zainstaluj SDK Pythona (pip install spicyapi), ustaw SPICY_API_KEY w środowisku serwera i wykonaj poniższe żądanie tekst na wideo. Dla pozostałych zadań: w obraz na wideo zmień model, usuń aspect_ratio i dodaj image_url; dla referencja na wideo zmień model i dodaj reference_image_urls (aspect_ratio zostaje).
import uuid
from spicyapi import SpicyClient, output_assets

client = SpicyClient()  # reads SPICY_API_KEY from the environment

task = client.create_task(
    model="minimax/h3-lora/text-to-video",
    input_data={
        "prompt": "vh5tape, worn VHS tape with light tracking noise. A woman in a red satin dress sits alone in a late-night diner booth, turns toward the camera and slowly smiles, neon light flickering in the rain-streaked window behind her. Slow push-in. Audio: rain on glass, a jukebox ballad muffled through the tape, quiet room hum.",
        "aspect_ratio": "4:3",
        "resolution": "480p",
        "duration_seconds": 5,
        "seed": 42,
        "loras": [{
            "path": "https://huggingface.co/KennethFal/vh5tape-vhs-lora-minimax-h3/resolve/d25a4ab75aba899aa508220321525c8465ac11af/vh5tape.safetensors",
            "scale": 1.0,
        }],
    },
    idempotency_key=str(uuid.uuid4()),
)

final = client.wait_for_terminal(task["taskId"])
if final["state"] != "succeeded":
    raise RuntimeError(f"{task['taskId']} ended as {final['state']}: {final.get('errorCode')}")
print(output_assets(final)[0]["url"])  # copy the video to your own storage now
Tworzenie, oczekiwanie, pobieranie, ponowienia i kody błędów opisuje przewodnik po zadaniach oraz referencja SDK Pythona. Wygenerowane pliki są przechowywane maksymalnie 14 dni, więc zajrzyj do przechowywania i dostarczania, zanim oprzesz system na zwróconym odnośniku; w produkcji porównanie odpytywania z webhookami pomoże ci wybrać.
Albo niech uruchomi to Agent
Gdy to asystent ma wykonywać generowania, wszystkie trzy oficjalne narzędzia pokazują cenę i pytają o zgodę przed płatnym wywołaniem.
- CLI. Umieść ten sam obiekt
inputwt2v.json, a potem:
``bash spicyapi tasks create --model minimax/h3-lora/text-to-video --input-file t2v.json --wait ``
Zobacz dokumentację CLI; npx @spicyapi/cli działa bez instalowania.
- Serwer MCP. Dodaj serwer MCP do asystenta, a potem zapytaj: "Run MiniMax H3 LoRA text-to-video with this prompt and this weights link at strength 1, 480p, 3 seconds." Wywołuje
spicyapi_task_create, które zatrzymuje się w oczekiwaniu na potwierdzenie ceny, a następniespicyapi_task_wait. - Skill.
npx skills add spicyapi-ai/spicy-skillinstaluje Agent Skill, dzięki czemu asystent programistyczny czyta aktualny schemat modelu, zamiast zgadywać nazwy pól.
Ustaw siłę
scale działa od 0 do 4, a 1 to wartość neutralna. LoRA stylu zaczynaj od 1, a LoRA konceptu od 0.6 do 0.8. Potem przejdź drabinkę: ten sam prompt i seed w 480p i 3 sekund, ze skalą 0.5, 0.8 i 1.1, plus jeden przebieg z pustym loras. Zmieniaj jedną rzecz na przebieg. Stały seed sprawia, że przebiegi są porównywalne, a nie identyczne, więc oceniaj wygląd i akcję, a nie piksele.
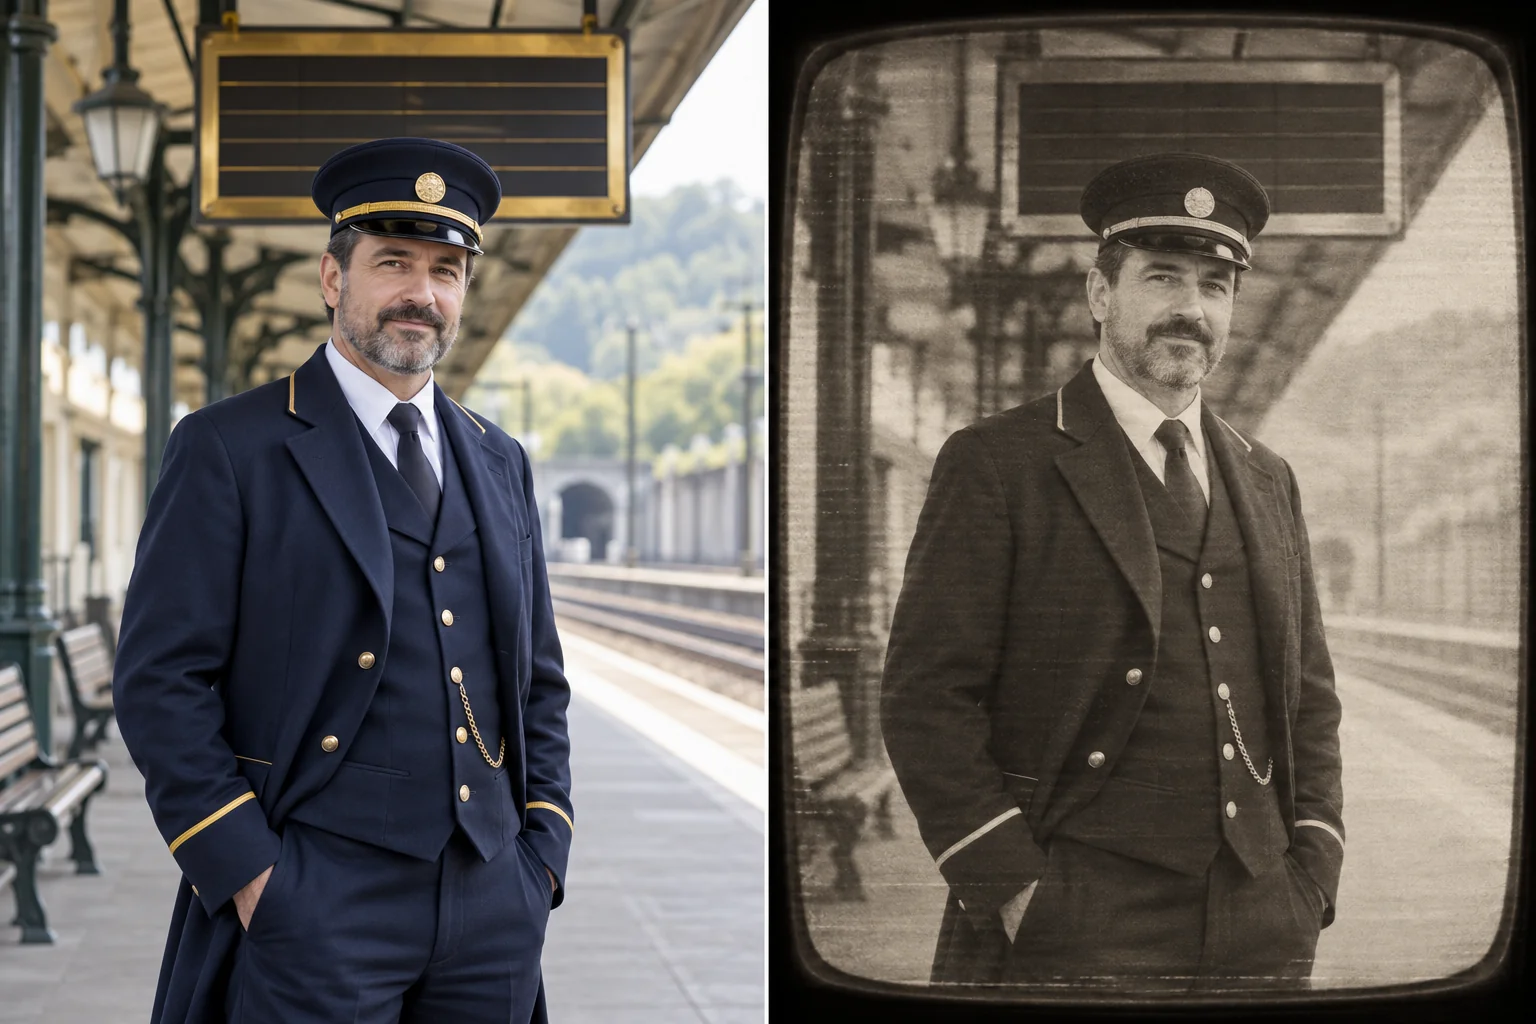
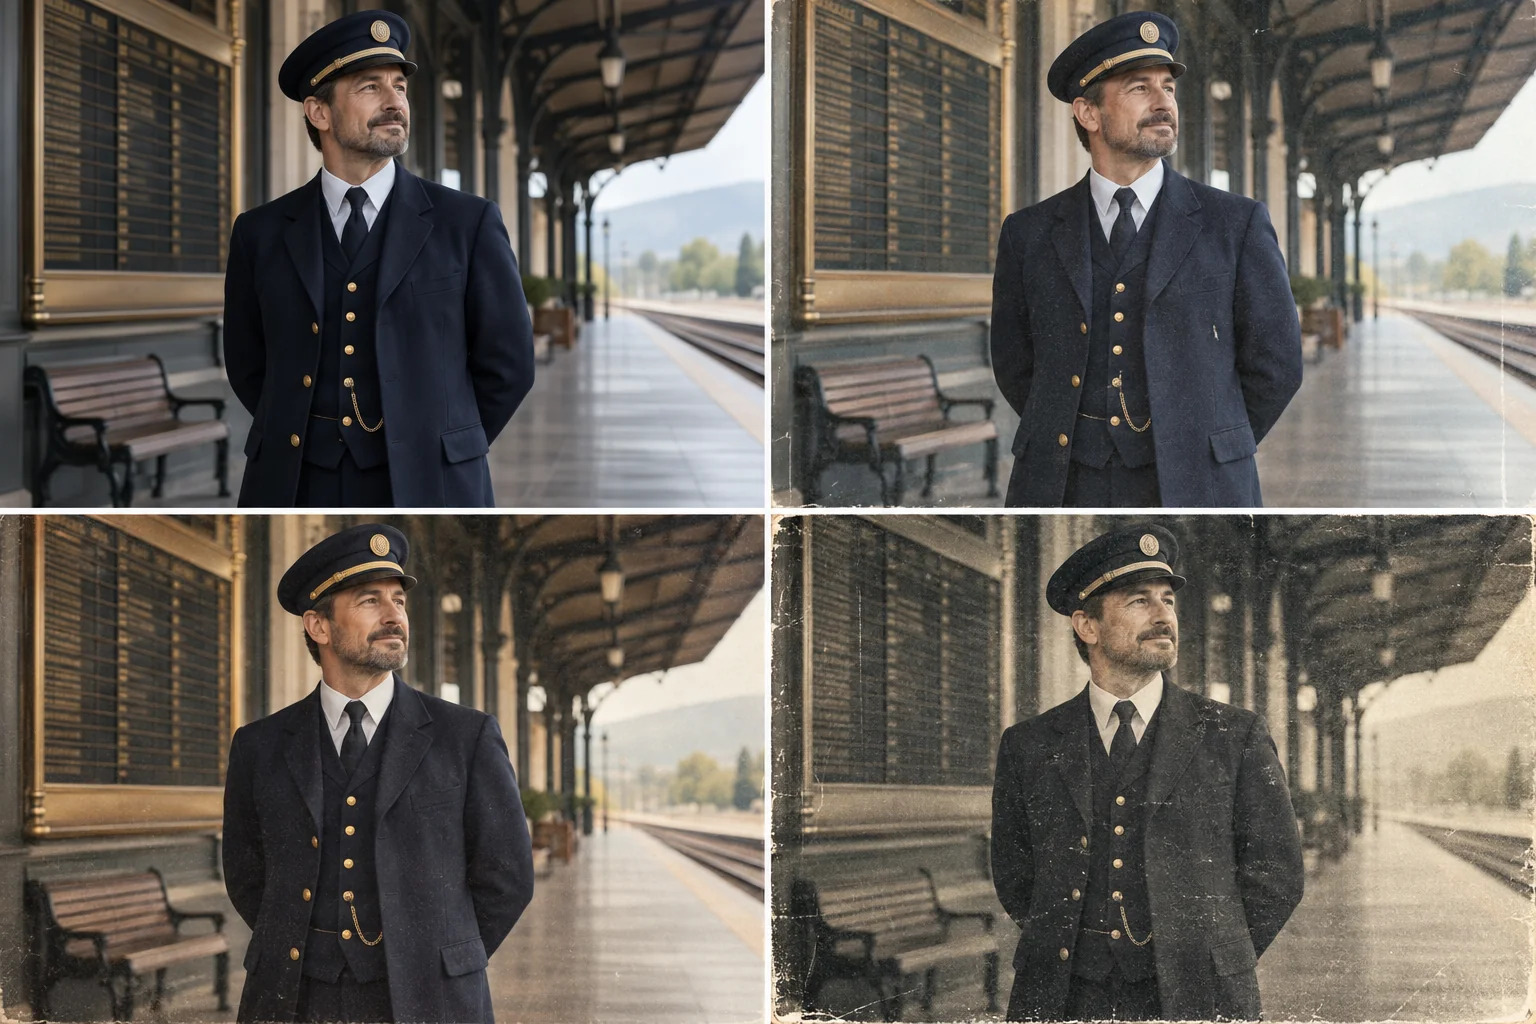
Zachowaj szczebel, który czyta się dobrze, albo wybierz wartość pośrednią między dwoma. Przestań zwiększać siłę, gdy postać, akcja albo dźwięk zaczynają się psuć; jeśli sama baza nie daje potrzebnego ujęcia, żadna skala tego nie naprawi. Oglądaj cały klip, a nie pierwszą klatkę, i słuchaj, bo LoRA może zmienić także dźwięk (vh5tape celowo go przygłusza). Karta vh5tape wymienia też frazy promptu dla lekkiego, średniego i mocnego zużycia; zmień je, zanim podniesiesz skalę powyżej 1.
Łącz do trzech
Przetestuj każdy plik osobno, zanim połączysz. LoRA postaci wytrenowana na błyszczących portretach może kłócić się z ciężkim wyglądem taśmy, a LoRA ruchu może odwrócić postać od kadru. Gdy stos wychodzi źle, utrzymaj seed i prompt oraz usuwaj po jednym wpisie: powrót do normy wskazuje na ten adapter albo na jego interakcję z resztą stosu. Najpierw obniż najsilniejszą wagę. Zdecyduj z góry, które wymaganie wygrywa, gdy dwa są sprzeczne (na przykład tożsamość przed teksturą), i sprawdź ponownie stos, który zadziałał na tekście, zanim użyjesz go na zdjęciu lub referencji.
Ile to kosztuje
| Zadanie | 480p | 540p | 768p | 1080p | Dodatki |
|---|---|---|---|---|---|
| Tekst na wideo i obraz na wideo | $0.05/s | $0.075/s | $0.10/s | $0.20/s | Brak; wczytywanie LoRA jest bezpłatne |
| Referencja na wideo | $0.06/s | $0.09/s | $0.135/s | $0.27/s | $0.02 za obraz referencyjny lub klip audio; sekundy klipu rozlicza się jak sekundy wyjściowe |
- 3 sekundy w 480p: $0.15. 5 sekund w 480p: $0.25. 5 sekund w 1080p: $1.00.
- Trzy powyższe żądania: $0.25 / $0.50 / $0.58.
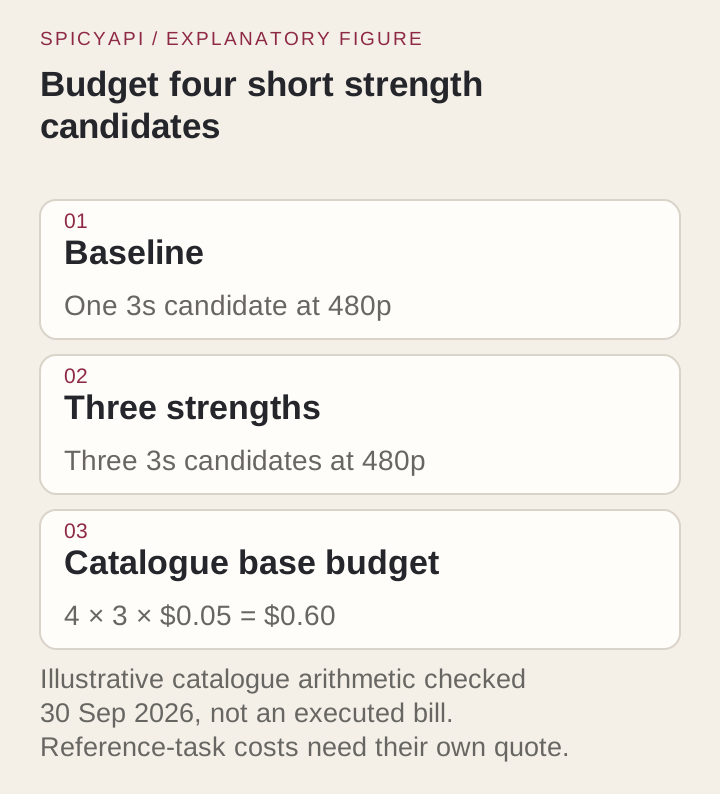
- Baza plus drabinka z trzech szczebli, cztery klipy po 3 sekundy w 480p: $0.60.
- Referencja na wideo, 5 sekund w 480p: $0.32 przy jednym obrazie, $0.34 przy dwóch, $1.37 w 1080p przy jednym obrazie.
- Zadanie, które się nie powiodło lub wygasło, zwykle nie jest rozliczane; gotowy klip, który ci się nie podoba, już jest.
- Wycena zawierająca klip referencyjny rezerwuje pełne 15 sekund klipu: $1.20 za wyjście 5 sekund w 480p. Naliczenie kończy się na rzeczywistej długości klipu.
Rób szkice w 480p i 3 sekund, a potem wyślij zwycięzcę raz jeszcze w 768p lub 1080p z tym samym seedem. Spodziewaj się wariantu zbliżonego, a nie kopii.
Gdy LoRA nic nie robi albo klip wychodzi nie tak
| Objaw | Prawdopodobna przyczyna | Rozwiązanie |
|---|---|---|
| Klip wygląda jak zwykły H3 | Plik wytrenowano pod inną bazę, brakuje słowa wyzwalającego albo zdjęcie czy referencja przejmuje kontrolę nad LoRA stylu | Sprawdź bazę w karcie, umieść wyzwalacz na początku, spróbuj tego samego pliku w tekst na wideo, a potem zwiększ skalę |
| Klip odpływa od klatki otwierającej | LoRA konceptu jest za mocna albo prompt opisuje nową scenę | Zejdź do 0.6 i opisz tylko to, co dzieje się dalej |
| Wygląd zalewa scenę | Najsilniejsza waga jest za wysoka albo stos jest przeładowany | Obniż najsilniejszą wagę, a potem usuwaj wpisy po jednym |
| W kadrze pojawia się wykonawczyni z klipu referencyjnego | Prompt nigdy nie powiedział, po co jest ten klip | Powiedz, że postać pochodzi z obrazu, a tylko ruch z klipu |
| Tożsamość się chwieje | Za dużo nakładających się referencji | Zostaw dwa lub trzy dobre stille |
| Odrzucone z 400 | To nie jest bezpośredni odnośnik do pliku | Użyj odnośnika /resolve/ |
| Zadanie pada po przyjęciu | Odnośnik wygasł albo repozytorium stało się prywatne | Wyślij ponownie z "loras": []; zadbaj, by odnośnik z podpisem wstępnym przetrwał zadanie |
Użycie bez cenzury
SpicyAPI nie dokłada filtra treści do promptu, wag ani wyniku. W tych testach nic nie zostało odrzucone na naszej skali treści, która biegnie od L1 Sugestywny i L2 Tematy dojrzałe i L3 Silny do L4 Intensywny, plus testy L5a unieruchomienia i L5b krwi, i to bez wczytanej LoRA. Jedno słabe miejsce: bez LoRA obraz na wideo złagodził L4 Intensywny (intymna scena między dwojgiem dorosłych) w dwóch przebiegach na trzy, podczas gdy wejście tekstowe i referencyjne wyrenderowało każdy poziom. Po wczytaniu wspólnotowej LoRA dla dorosłych wszystkie trzy zadania wyrenderowały L4. Pełne wyniki znajdziesz w recenzji H3 LoRA.
To, że SpicyAPI nie dokłada dodatkowego filtra treści, nie daje praw do wizerunku: wszyscy widoczni muszą być dorośli, a LoRA prawdziwej osoby wymaga jej zgody i twoich praw do jej wizerunku.
Wypróbuj w playground MiniMax H3 LoRA, który pokazuje aktualne ceny.
FAQ
Czy mogę wkleić nazwę repozytorium Hugging Face albo odnośnik /blob/?
Nie. path przyjmuje bezpośredni odnośnik HTTPS do pliku; strona /blob/ lub sama nazwa owner/repo zostają odrzucone z 400, a pola weight_name, które akceptują niektóre hosty, tutaj nie ma odpowiednika. Użyj odnośnika /resolve/.
Czy mogę wczytać LoRA, którą sam wytrenowałem?
Tak, jeśli była wytrenowana na H3 z otwartymi wagami, zapisana jako .safetensors i dostępna przez HTTPS.