自作の LoRA を読み込む価値があるのは、必要なカットでも通用する場合だけです。人物、動き、音が同時にそろっていなければなりません。SpicyAPI(spicyapi.ai)の MiniMax H3 LoRA は、オープンウェイトの H3 動画モデルに loras フィールドを加えたもので、1回のリクエストにつき自分の .safetensors ファイルを最大3つまで、それぞれ 0 から 4 の強度で読み込めます。
手元にある素材でタスクを選び、H3 向けに学習された直リンクのファイルを指定してください。スタイル LoRA は強度 1、コンセプト LoRA は 0.6 から 0.8 で始め、3秒・480p のドラフト($0.15)を、loras を空にした同じリクエストと見比べて判断します。 2026年9月の私たちのテストでは、3つのタスクすべてがアダルト向けのリクエストを処理し、SpicyAPI は読み込む重みに追加のコンテンツフィルターを設けていません。
手元にある素材でタスクを選ぶ
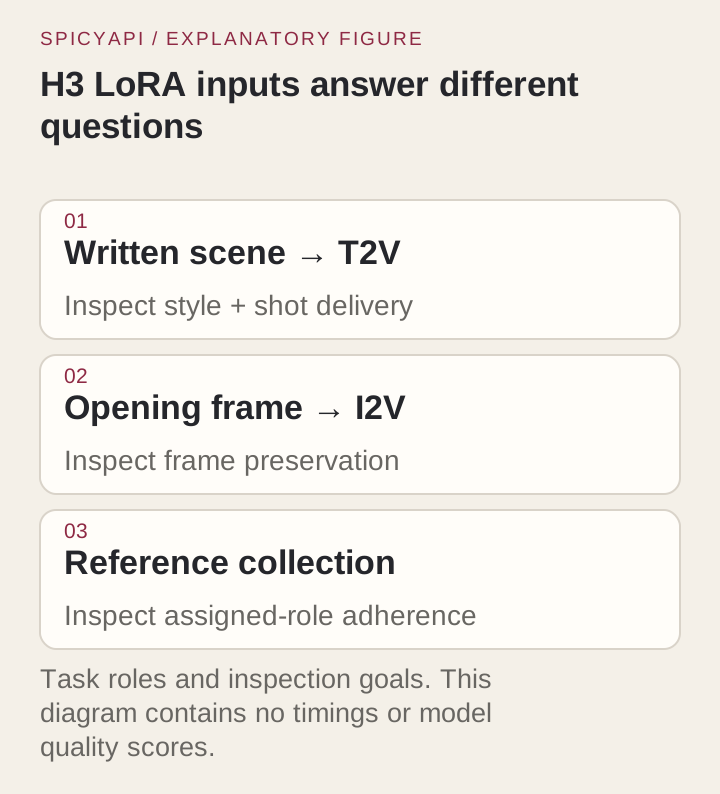
| 手元にあるもの | タスク | そこでの LoRA の役割 |
|---|---|---|
| 文章で書いたシーン | Text-to-video | 見た目を主導するため、どのファイルでも最初のテストに最適です。アスペクト比は7種類。 |
| 承認済みのフレーム | Image-to-video | クリップはそのフレームから始まり、形を保ちます(アスペクト比フィールドはなし)。任意の last_image_url で最後のフレームを指定できます。強い LoRA はクリップをフレームから引き離すことがあり、スタイル LoRA は写真的なフレームでは効きが薄れます。 |
| 画像、クリップ、音声 | Reference-to-video | 画像は最大9枚、クリップは3本、音声は3本まで。それぞれにプロンプトで1つの役割を与えます。キャラクター LoRA と同じ人物の静止画を組み合わせると、同一性がいちばん保たれます。 |
3つとも、同じ処理でステレオ音声つきの3〜15秒の MP4 を返します。解像度は 480p、540p、768p、1080p から選べ、LoRA の読み込みに追加料金はかかりません。読み込む LoRA がないなら、ベースの H3 のほうが安く済みます。動画の秒数に課金される前にキャラクターや見た目を固めたいなら、先に H3 Image LoRA で静止画を作ってください。同じ loras 配列がそのまま使えます(静止画と動画の比較)。
H3 に合う LoRA を選ぶ
ファイルは MiniMax H3 向けに学習されたものでなければなりません。別のベースモデル向けの LoRA は互換性がありません。H3 のアダプターであっても、ローダーが対応するタスクと重みのレイアウトが必要です。H3 の LoRA はまだ新しく品質にばらつきがあるため、ベースモデル、トリガーワード、実際に使える強度が書かれたモデルカードを探してください。それらを備え、この API で読み込める2つのファイルを紹介します。
| LoRA | 効果 | タスク | トリガー | 作者推奨の強度 | サイズ |
|---|---|---|---|---|---|
| vh5tape | 使い込んだ1980年代の VHS 風:テープノイズ、色にじみ、こもった音 | Text、Image | vh5tape、プロンプトの先頭に置く | フルの見た目なら 1.0、軽い劣化感なら 0.7〜0.9 | 131 MB |
| H3 Realism People | リアルな肌と顔、軽い手持ちカメラ感 | Text、image、reference を1つのファイルで | r34l1sm | 1.0 が想定値、控えめにするなら 0.6〜0.8 | 131 MB |
どちらも H3 Community License を採用しており、地域と用途に制限があります。商用利用の前に必ず読んでください。
モデルカードから取り入れるのは、トリガーと強度だけにしてください。ローカルの ComfyUI や他のホスト向けに書かれたレシピには、このタスクにはない設定(prompt_expansion_mode、ステップ数、サンプラー、weight_name、リンクの代わりのリポジトリ名)が含まれています。また、速度蒸留(Turbo)の LoRA はローカルのサンプリングステップを減らすためのものなので、使わないでください。
ファイルをリンクする
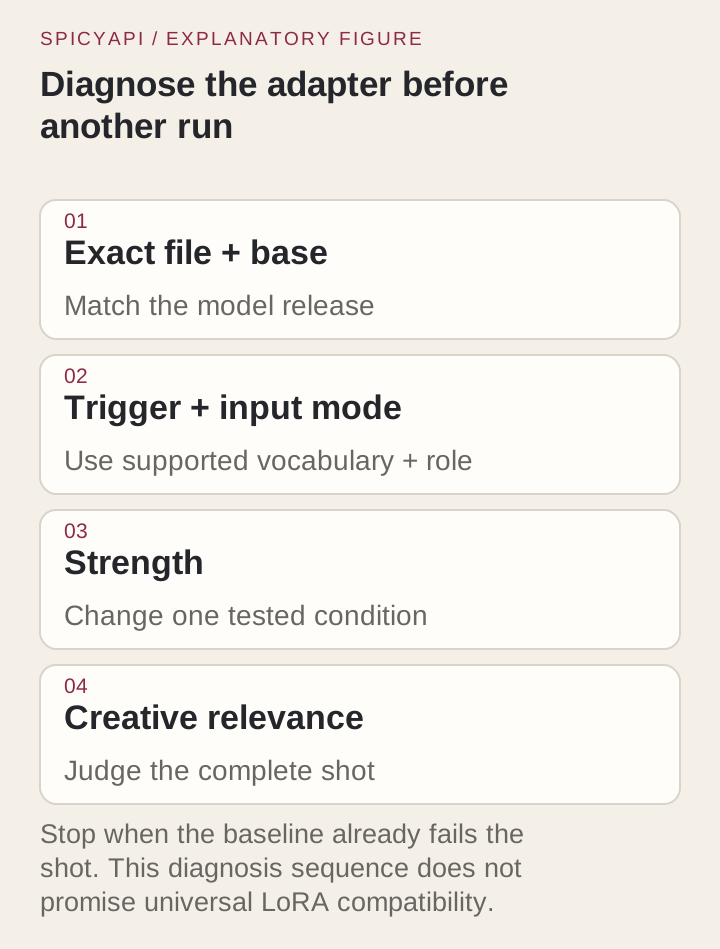
path は、ログインなしで .safetensors ファイルを返す直接の HTTPS リンクでなければなりません。Hugging Face では、アドレスバーに表示される /blob/ ページではなく /resolve/ リンクがそれにあたります。リクエストに認証情報のフィールドはないため、非公開のファイルにはジョブが実行されるまで有効な署名付きリンクが必要です。main をコミットハッシュに置き換えると、来月も同じリクエストで同じファイルが読み込まれます。/blob/ ページ、存在しないファイル、非公開リポジトリは、タスクが作られる前に 400 で拒否されます。受理されたあとでタスクが失敗した場合は、同じリクエストを "loras": [] にして再送してください。成功すれば問題はファイル(アクセス、互換性、効果)にあり、それでも失敗するならプロンプトか入力を見直します。
まず Playground で試す
- text-to-video ページを開き、Playground タブの Form ビューのまま、実行するには残高のあるアカウントでサインインします。image-to-video と reference-to-video にはそれぞれ専用ページがあります(上の表のリンク)。
- Prompt の先頭にトリガーワードを置き、続けてショットを短いタイムラインとして書きます(誰が映り、何をして、カメラがどう動くか)。音は専用の
Audio:行に分けます。LoRA がすでに行うことを長く説明すると、重みと競合しがちです。 - Style LoRAs の LoRA file に直接のファイルリンクを貼り、Strength を設定します。Add item で最大3つまでファイルを追加できます。
- 安く最初の確認をするため、Resolution は 480p、Duration は 3 を選び、Seed を設定して実行します。
- Remove item を押し、同じプロンプトと seed でもう一度実行して、2つのクリップを比べます。似ていれば、その LoRA は何もしていません(下の失敗の表を参照)。
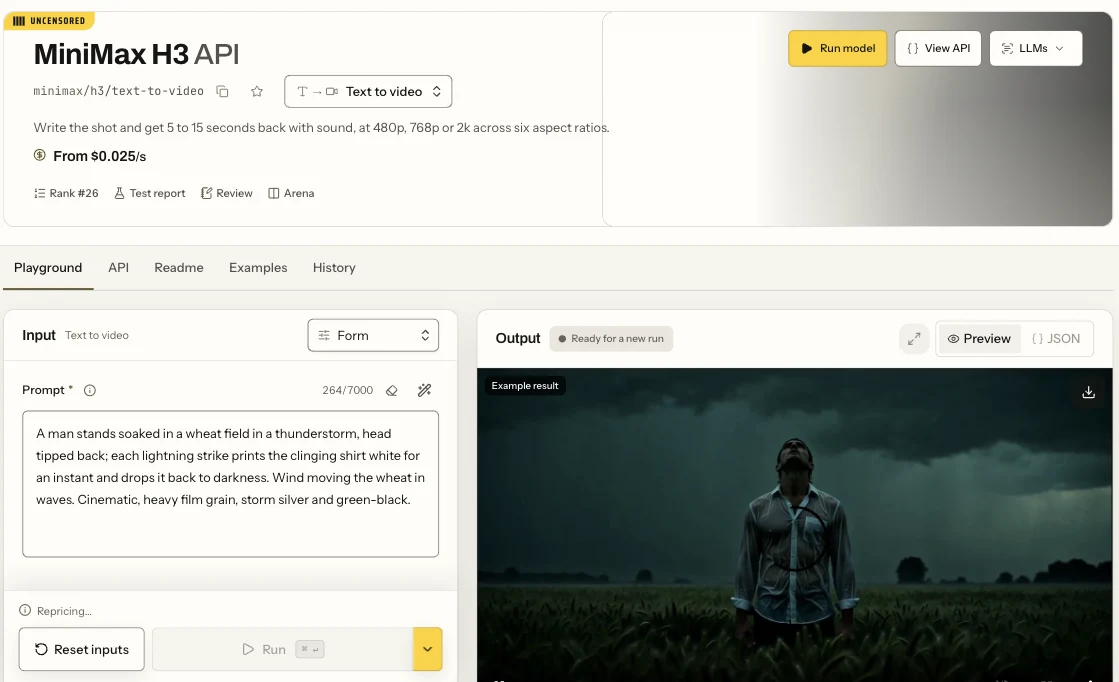
Form ビューの MiniMax H3 text-to-video Playground。Prompt フィールドと Run ボタンが見えます。LoRA ページでは、同じフォームに Style LoRAs セクションが加わります。
Playground のリクエスト本文は API が受け取る JSON と同じなので、ここでうまくいった設定はそのままコードにコピーできます。残り2つのタスクでは、それぞれ専用の入力が加わります。
- Image-to-video では Input image(冒頭のフレーム)と、任意の Closing frame が加わります。新しいシーンではなく、フレームの中でこの先に起こることを書いてください。コンセプト LoRA を 1 にしたとき、被写体を別の部屋に移すプロンプトは冒頭のフレームを置き換えてしまいましたが、フレーム内の動きを書いたプロンプトではフレームが保たれました。アスペクト比フィールドはないため、先にフレームを希望の形にトリミングし、動きの余白を残しておきます。
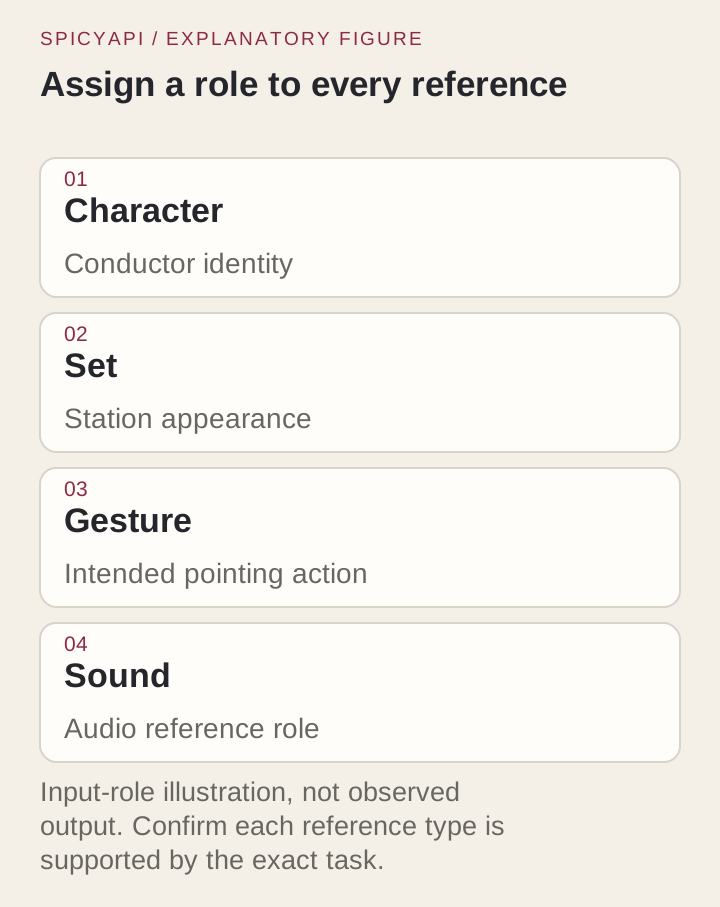
- Reference-to-video では Reference images(最大9枚)、Reference videos(最大3本)、Reference audio(最大3本)が加わります。プロンプトの冒頭に、入力1つにつき短い1文を置き、それぞれに1つの役割を与えます。Picture 1 は女性、Picture 2 は部屋、Video 1 はカメラの動き、Audio 1 は彼女の声、という具合です。クリップから動きを借りるときは、人物は画像から、動きだけをクリップから取ると明言してください。その一文がないと、クリップの中のダンサーまで動きと一緒に入り込みました。質の良い静止画3枚のほうが、重なり合う9枚より同一性をよく保ちます。
各モデルページの Playground には、すぐ使える例が最初から入っており、Request body パネルに正確な JSON が表示されます。それらの例を3回実行した結果です。
参照クリップは、出力の秒数に加えて、そのクリップの秒数でも課金されます(クリップの合計は最大15秒まで)。短くしておいてください。
次にコードから実行する
Python SDK をインストールし(pip install spicyapi)、サーバー環境に SPICY_API_KEY を設定して、下の text-to-video リクエストを実行します。他のタスクでは、image-to-video なら model を変え、aspect_ratio を外して image_url を追加します。reference-to-video なら model を変え、reference_image_urls を追加します(aspect_ratio は残します)。
import uuid
from spicyapi import SpicyClient, output_assets

client = SpicyClient()  # reads SPICY_API_KEY from the environment

task = client.create_task(
    model="minimax/h3-lora/text-to-video",
    input_data={
        "prompt": "vh5tape, worn VHS tape with light tracking noise. A woman in a red satin dress sits alone in a late-night diner booth, turns toward the camera and slowly smiles, neon light flickering in the rain-streaked window behind her. Slow push-in. Audio: rain on glass, a jukebox ballad muffled through the tape, quiet room hum.",
        "aspect_ratio": "4:3",
        "resolution": "480p",
        "duration_seconds": 5,
        "seed": 42,
        "loras": [{
            "path": "https://huggingface.co/KennethFal/vh5tape-vhs-lora-minimax-h3/resolve/d25a4ab75aba899aa508220321525c8465ac11af/vh5tape.safetensors",
            "scale": 1.0,
        }],
    },
    idempotency_key=str(uuid.uuid4()),
)

final = client.wait_for_terminal(task["taskId"])
if final["state"] != "succeeded":
    raise RuntimeError(f"{task['taskId']} ended as {final['state']}: {final.get('errorCode')}")
print(output_assets(final)[0]["url"]) # copy the video to your own storage nowタスクの作成、待機、ダウンロード、リトライ、エラーコードについては、タスクガイドと Python SDK リファレンスで扱っています。生成されたファイルの保持期間は最長14日なので、返されたリンクを前提にシステムを組む前に保持と配信を確認してください。本番運用では、ポーリングと Webhook のどちらを使うかを扱った記事「async-task-api-polling-vs-webhook」(現時点では英語のみ)が選択の助けになります。
エージェントに実行させる
アシスタントに生成を任せる場合、公式の3つのツールはどれも料金を表示し、有料の呼び出しの前に確認を求めます。
- CLI。 同じ
inputオブジェクトをt2v.jsonに入れて、次を実行します。
``bash spicyapi tasks create --model minimax/h3-lora/text-to-video --input-file t2v.json --wait ``
CLI ドキュメントを参照してください。npx @spicyapi/cli ならインストールなしで動きます。
- MCP サーバー。 MCP サーバーをアシスタントに追加し、「このプロンプトとこの重みリンクで、強度 1、480p、3秒の MiniMax H3 LoRA text-to-video を実行して」と頼みます。
spicyapi_task_createが呼ばれて料金確認のために止まり、そのあとspicyapi_task_waitが呼ばれます。 - Skill。
npx skills add spicyapi-ai/spicy-skillでエージェントスキルをインストールすると、コーディングアシスタントがフィールドを推測せずに、最新のモデルスキーマを読むようになります。
強度を決める
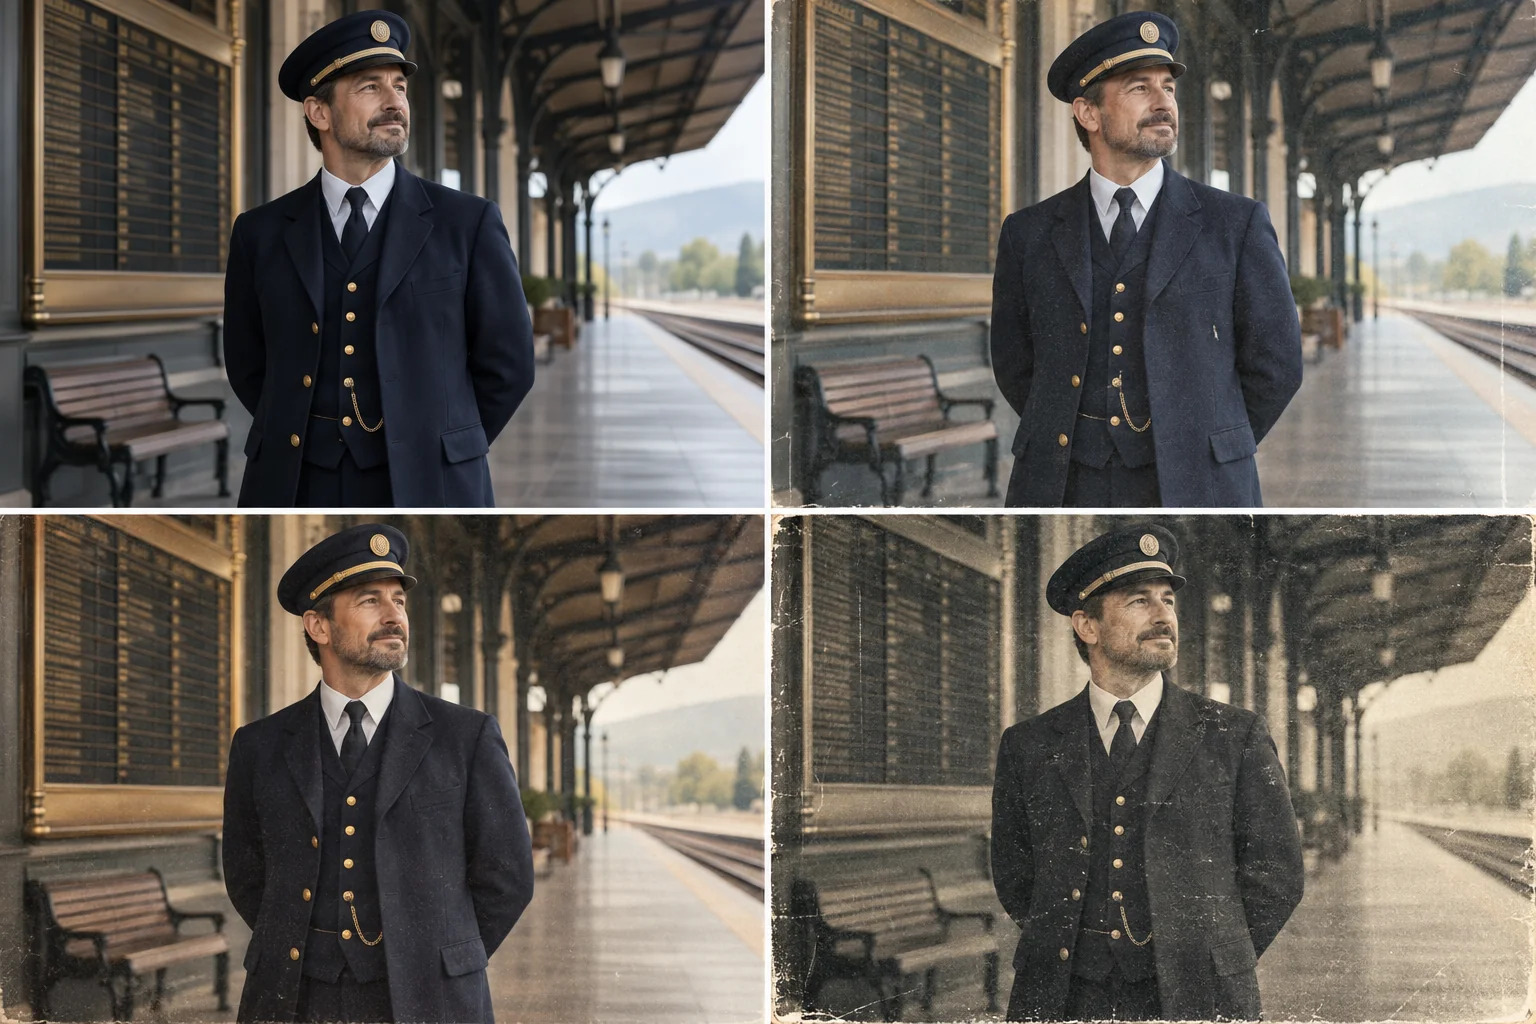
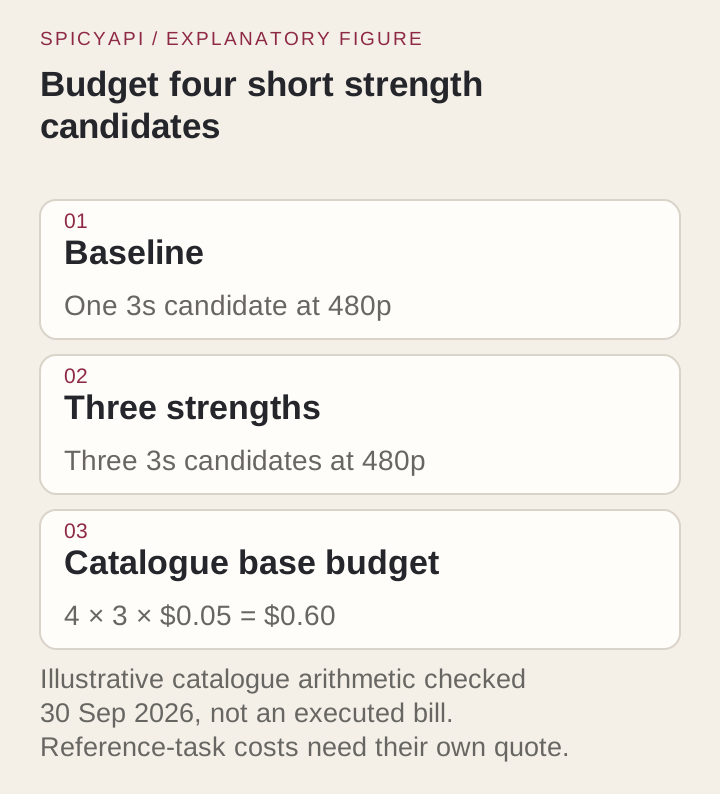
scale は 0 から 4 の範囲で、1 が基準です。スタイル LoRA は 1、コンセプト LoRA は 0.6〜0.8 から始めます。そのうえで、同じプロンプトと seed、480p・3秒で、scale を 0.5、0.8、1.1 にした実行に、loras を空にした実行を1つ加えて、段階的に比べます。1回の実行で変えるのは1つだけです。seed を固定すると実行どうしの比較はしやすくなりますが、結果は同一にはなりません。そのため、ピクセル単位ではなく、見た目と動きで判断してください。
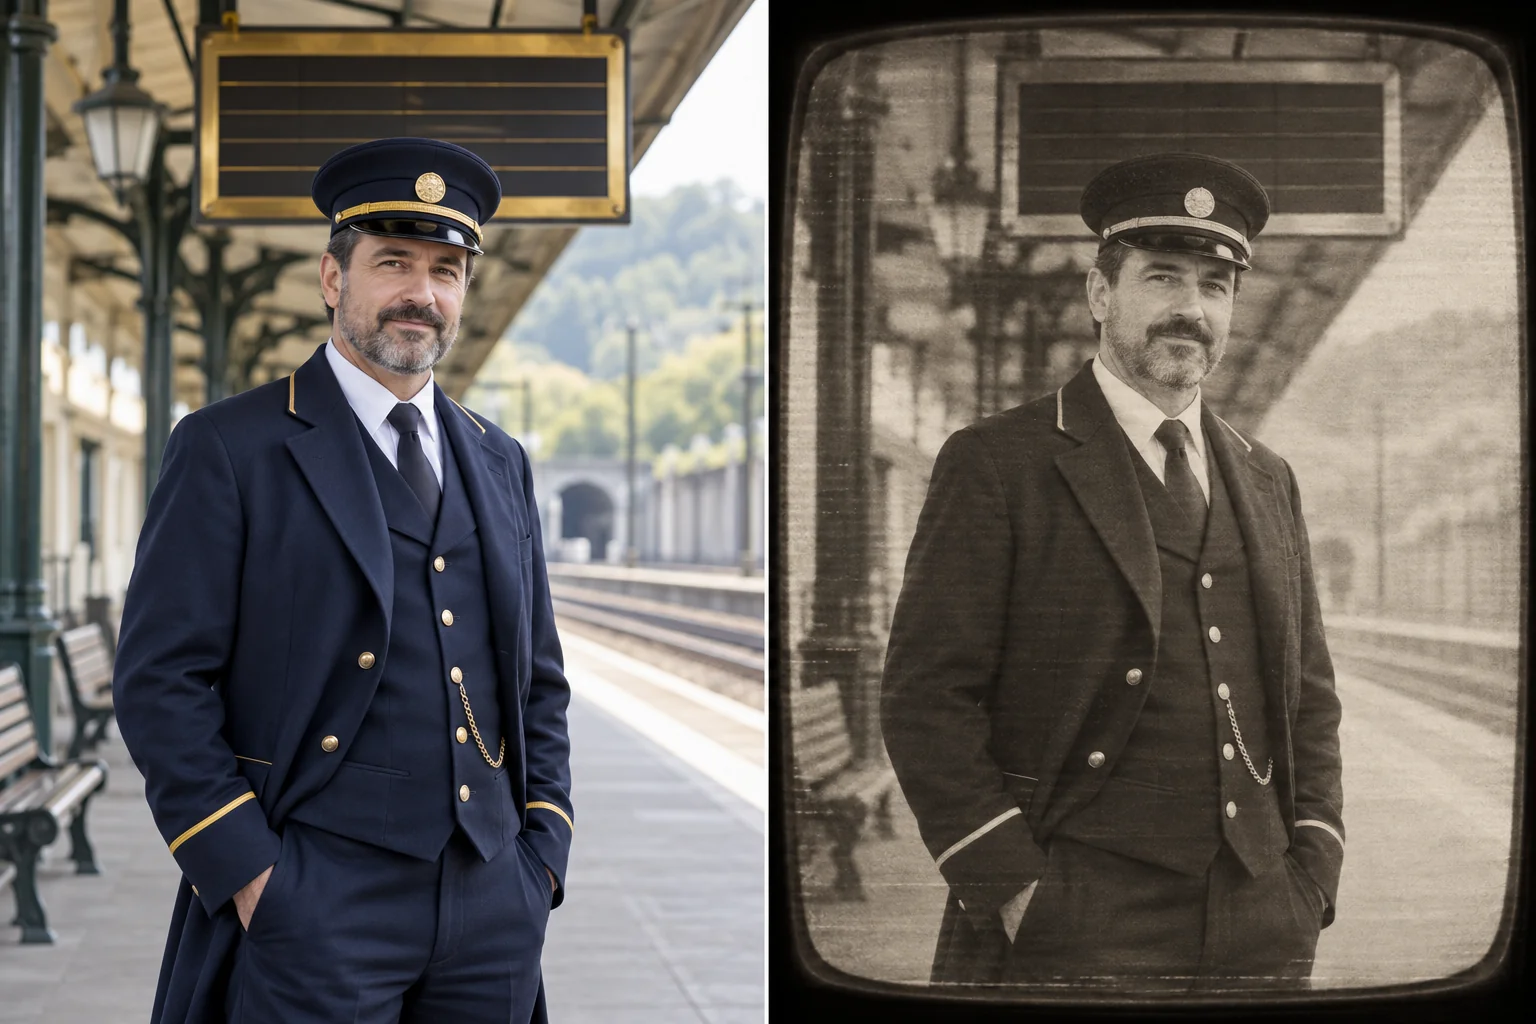
しっくりくる段階を採用するか、2つの段階の中間を取ります。被写体、動き、音が崩れ始めたら強度を上げるのをやめてください。ベースラインの時点でそのカットが成り立っていないなら、どんな scale でも直りません。最初のフレームだけでなくクリップ全体を見て、音も聴いてください。LoRA は音も変えることがあります(vh5tape はわざとこもらせます)。vh5tape のカードには、劣化の軽・中・重に対応するプロンプトの言い回しも載っています。scale を 1 より上げる前に、そちらを変えてください。
最大3つまで重ねる
組み合わせる前に、各ファイルを単独でテストしてください。つややかなポートレートで学習したキャラクター LoRA は、強いテープ風の見た目と衝突することがあり、モーション LoRA は被写体を構図から背けさせることがあります。重ねた構成がうまくいかないときは、seed とプロンプトを固定したまま、エントリーを1つずつ外していきます。外した時点で改善するなら、そのアダプターか、残りの構成との相互作用が原因です。最も強い重みを最初に下げてください。2つの要件がぶつかったときにどちらを優先するか(たとえば質感より同一性)を、あらかじめ決めておきます。テキストでうまくいった構成は、写真的なフレームや参照に使う前に、もう一度テストしてください。
料金
| タスク | 480p | 540p | 768p | 1080p | 追加料金 |
|---|---|---|---|---|---|
| Text-to-video と image-to-video | $0.05/秒 | $0.075/秒 | $0.10/秒 | $0.20/秒 | なし。LoRA の読み込みは無料 |
| Reference-to-video | $0.06/秒 | $0.09/秒 | $0.135/秒 | $0.27/秒 | 参照画像または音声クリップ1件につき $0.02。参照クリップの秒数は出力の秒数と同様に課金 |
- 480p で3秒:$0.15。480p で5秒:$0.25。1080p で5秒:$1.00。
- 上の3つのリクエストは、$0.25、$0.50、$0.58。
- ベースラインに3段階のラダーを加えた、3秒・480p のクリップ4本:$0.60。
- Reference-to-video で480p・5秒:画像1枚なら $0.32、2枚なら $0.34、1080p で画像1枚なら $1.37。
- 失敗した、または期限切れになったタスクには、通常は課金されません。仕上がったクリップが気に入らなくても、課金されます。
- 参照クリップを含む見積もりでは、クリップの15秒分がまるごと確保されます。480p・5秒の出力で $1.20 です。実際の課金は、クリップの実際の長さで確定します。
480p・3秒でドラフトを作り、気に入ったものを同じ seed で768pか1080pに1回だけ送り直してください。コピーではなく、近い別バージョンになると考えてください。
LoRA が効かないとき、クリップがおかしいとき
| 症状 | 考えられる原因 | 対処 |
|---|---|---|
| クリップがふつうの H3 のように見える | ファイルが別のベース向けに学習されている、トリガーがない、または写真的なフレームや参照がスタイル LoRA を押しのけている | カードのベースを確認し、トリガーを先頭に置き、同じファイルを text-to-video で試してから、scale を上げる |
| クリップが冒頭のフレームから離れていく | コンセプト LoRA が強すぎる、またはプロンプトが新しいシーンを描いている | 0.6 まで下げ、次に起こることだけを書く |
| 見た目がシーンを圧倒する | 最も強い重みが高すぎる、または構成が詰め込みすぎ | 最も強い重みを下げ、エントリーを1つずつ外す |
| 参照クリップの出演者が現れる | クリップの用途をプロンプトで伝えていない | 人物は画像から、動きだけをクリップから取ると明記する |
| 同一性がぶれる | 重なり合う参照が多すぎる | 質の良い静止画を2〜3枚にとどめる |
| 400 で拒否される | 直接のファイルリンクではない | /resolve/ のファイルリンクを使う |
| 受理されたあとでタスクが失敗する | リンクの期限切れ、またはリポジトリが非公開になった | "loras": [] で再送する。署名付きリンクは、ジョブが終わるまで有効なものにする |
Uncensored な使い方
SpicyAPI はプロンプト、重み、出力のいずれにもコンテンツフィルターを加えません。これらのテストでは、LoRA を読み込まない状態で、私たちのコンテンツのラダーに沿って試しましたが、拒否されたものはありませんでした。ラダーは L1 Suggestive、L2 Mature themes、L3 Strong、L4 Intense の順に進み、L5a Restraint と L5b Gore のプローブも加えています。1つだけ弱点がありました。LoRA なしの image-to-video では、L4 Intense(成人2人の親密なシーン)が3回中2回で弱められましたが、テキスト入力と参照入力は全レベルを描画しました。コミュニティのアダルト LoRA を読み込むと、3つのタスクすべてが L4 を描画しました。完全な結果は H3 LoRA レビューにあります。
SpicyAPI が追加のコンテンツフィルターを設けていないことは、肖像に対する権利を与えるものではありません。映る人物はすべて成人でなければならず、実在の人物の LoRA には、その人の同意と、その肖像に対するあなたの権利が必要です。
MiniMax H3 LoRA playground で試せます。ライブの料金が表示されます。
FAQ
Hugging Face のリポジトリ名や /blob/ リンクを貼れますか?
いいえ。path にはファイルへの直接の HTTPS リンクを指定します。/blob/ ページや owner/repo だけの名前は 400 で拒否され、他のホストが受け付ける weight_name フィールドに相当するものもここにはありません。/resolve/ リンクを使ってください。
自分で学習した LoRA を読み込めますか?
はい。オープンウェイトの H3 で学習され、.safetensors として保存され、HTTPS で到達できるものであれば読み込めます。