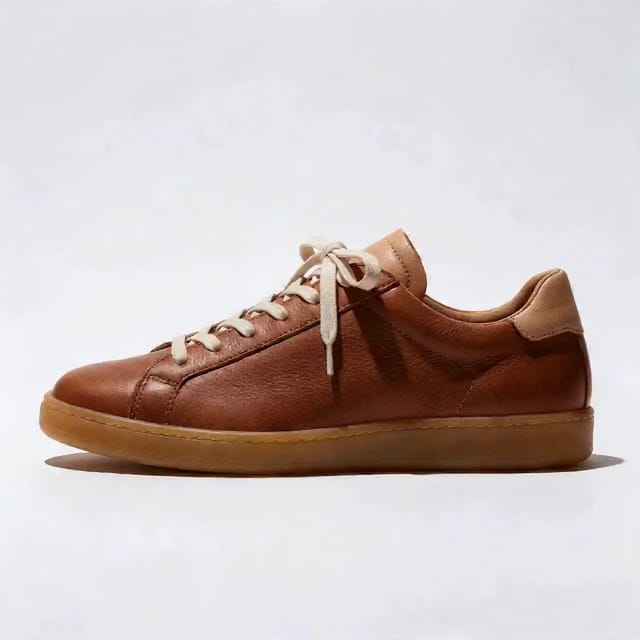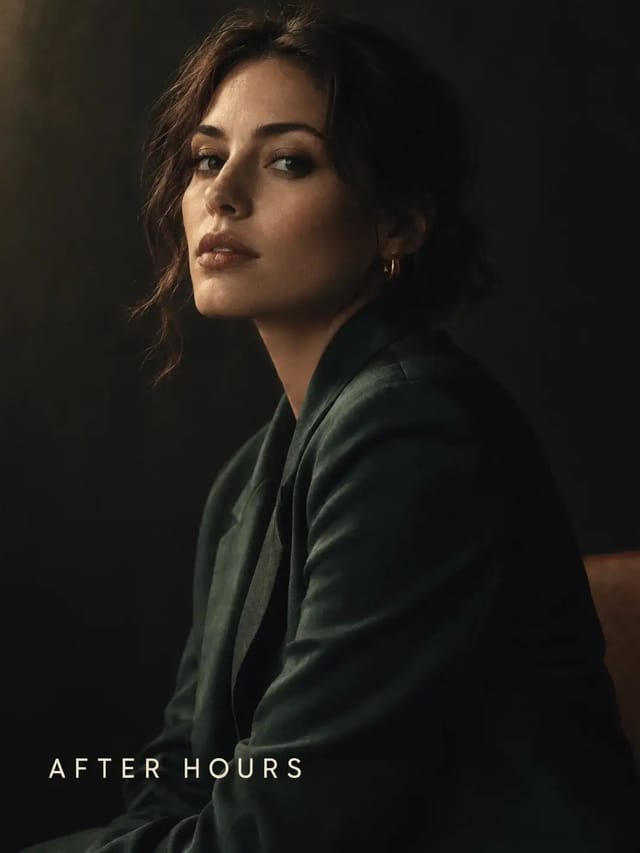
Mesmo modelo, mesmo terno aberto, uma terceira cidade à noite
- Modelo
- Seedance 2.0
- Tarefa
- Referência para vídeo
- Resolução
- 480p
- Duração
- 4 s
- Proporção
- 3:4
Resultado
Esta prévia está desfocada
Esta prévia está marcada como sensível. Confirme sua idade para ver.
Entrada
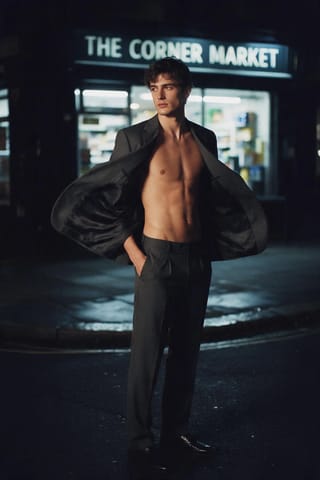
reference_image_urls 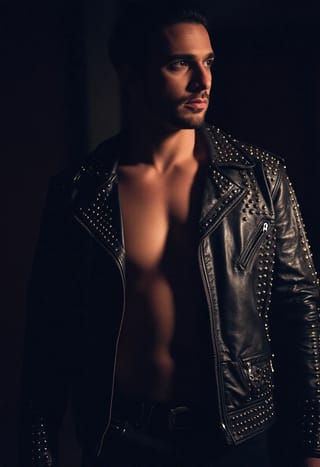
reference_image_urls 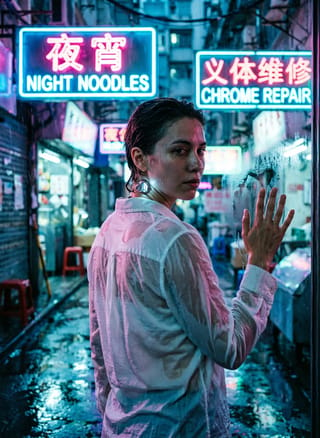
reference_image_urls
Use sua própria entrada ao gerar.
PromptEN376 caracteres
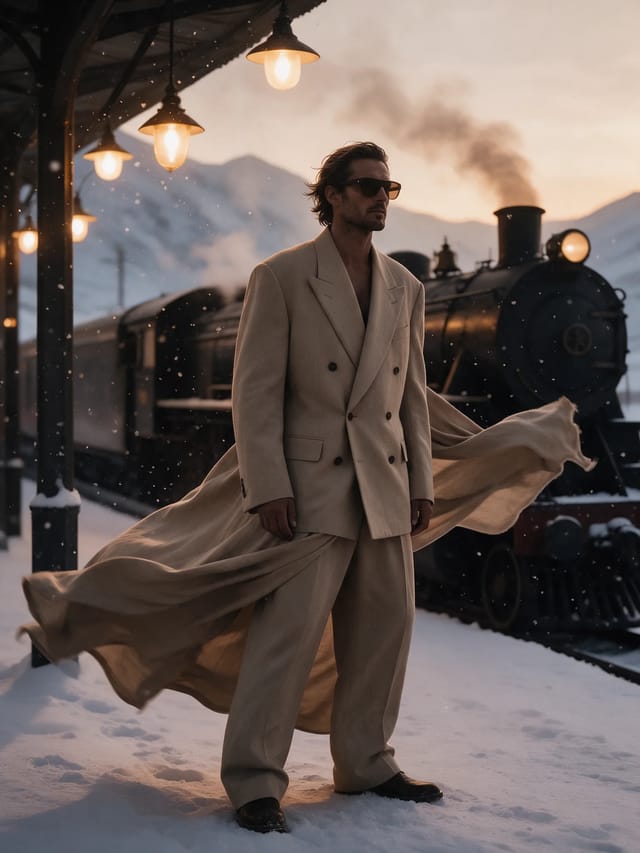
The camera stays on him as the wind takes the jacket fully open. The same model, the same unbuttoned suit, a third city corner at night: the wind takes the jacket open as he walks toward camera, traffic streaking behind. The wind takes the jacket fully open over a bare chest as he walks in; medium close. Cinematic, shallow depth of field, heavy film grain, cold street blue.Escrito em inglês, exatamente como enviamos.
Rodar este exemplo
Consultando o preço…
Abre o Playground com todas as configurações já preenchidas e mostra o preço exato antes de rodar.
Mesmo modelo, partindo deste prompt. As demais configurações ficam no padrão.
Por que este prompt funciona
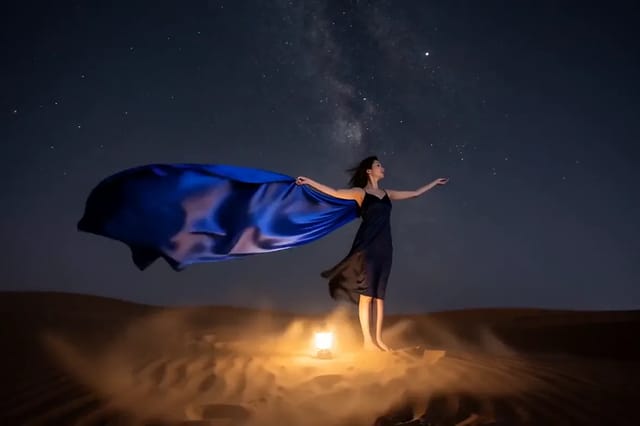
A continuidade do figurino é a metade difícil deste exemplo: a mesma jaqueta aberta precisa se comportar como a mesma peça numa terceira esquina, sob uma luz diferente. As referências carregam o modelo e o terno, deixando para o prompt apenas descrever o que o vento faz e por onde ele caminha. Até nove imagens, três clipes e três faixas de áudio entram juntos, então o elenco viaja entre planos como dado e não como adjetivo.
Configurações usadas
| Configuração | Valor | O que faz |
|---|---|---|
| resolution | 480p | 480p, 720p, 1080p ou 4k, padrão 720p, e alimenta a quantidade cobrada diretamente. Define só a faixa de saída e não vai deixar referências de baixa resolução mais nítidas. Teste se as referências combinam numa faixa baixa e depois suba para o take final. Não existem faixas de upscaling ou realce aqui. |
| aspect_ratio | 3:4 | Vem em `adaptive`: o modelo encontra um enquadramento que acomoda todos os sujeitos referenciados, o que pesa mais quando as referências não compartilham a mesma forma. Fixe uma proporção só por exigência dura de entrega — `9:16` para um feed vertical, por exemplo — e confira se nenhuma pessoa ou produto referenciado ficou cortado. Não afeta a cobrança. |
| generate_audio | false | Ligado por padrão. Produz uma trilha nativa sincronizada com a imagem. Mesmo com `reference_audio_urls` enviado, desligar significa nenhuma trilha renderizada — o áudio de referência molda ritmo e interpretação, ele não é a faixa de saída. Desligue quando a edição for musicada na pós. |
| duration_seconds | 4 | De 4 a 15 segundos, padrão 5; com -1, o modelo escolhe a duração (a estimativa usa o máximo de 15 segundos e a cobrança, a duração entregue). Quinze segundos é o teto desta geração; para um plano único mais longo, mude para o endpoint da 2.5. Repare que isto e a duração dos seus clipes de referência são duas contribuições independentes à quantidade cobrada, então maximizar os dois é onde uma única requisição fica cara. |