Zum Hauptinhalt springen

Wan 2.1 LoRA Video-zu-Video zeichnet einen vorhandenen Clip anhand eines Prompts neu und behält Bewegung und Timing, mit bis zu drei Ihrer eigenen LoRA-Dateien auf Alibabas 14B-Modell. Ausgabe in 480p oder 720p im Format der Vorlage, nichts wird gefiltert.

Ab $0.24/Anfrage

Playground

Eingabe

Videobearbeitung
Pflichtfeld. Beschreiben Sie das ganze Ergebnis (Motiv, Garderobe, Umgebung, Licht, Stil), nicht nur die Änderung. Zuerst die Triggerwörter, falls Ihre LoRA welche hat. mindestens 1 Zeichen
1/1

Video ablegen oder auswählen · 1 Datei · Max. 90 MB · MP4 · WEBM

  • 1
1 / 1 Dateien
Der Quell-Clip. Bewegung und Timing werden übernommen; das Ergebnis behält sein Format und ist nie länger als die Vorlage. Es muss ein Video sein: Ein Bildlink wird nicht abgelehnt und liefert einen Clip aus einem einzigen Bild, der trotzdem berechnet wird. mindestens 1 Zeichen
preisrelevant
480p (Standard) oder 720p. 720p kostet pro Clip mehr und dauert länger; das Format folgt der Vorlage.
Änderungsstärke
Wie weit es sich von der Vorlage entfernt, 0,1 bis 1, Standard 0,9. In unserem Test zeichnete 0,9 den Clip neu, und 0,5 gab ihn fast unverändert zurück. Kein Einfluss auf den Preis. nicht kleiner als 0.1 · nicht größer als 1
Dauerpreisrelevant
510
5 (Standard) oder 10. Das Ergebnis ist nie länger als die Vorlage, doch 10 wird zum 10-Sekunden-Preis berechnet, verwenden Sie es also nur für Vorlagen von 10 Sekunden oder mehr. Andere Längen werden abgelehnt.
Stil-LoRAs0/3
Bis zu drei Einträge {path, scale}, trainiert für Wan 2.1 14B; path ist ein öffentlicher Direktlink auf eine .safetensors-Datei, scale reicht von 0 bis 4 (standardmäßig 1). Das Laden von LoRAs ändert den Preis nicht. höchstens 3 Einträge
SicherheitsfilterAus

SpicyAPI führt bei diesem Modell keinen Sicherheitsfilter aus. Prompt und Material gehen unverändert an das Modell, und das Modell selbst entscheidet über das Ergebnis.

Wir prüfen Ihr Konto, bevor Absenden und Preisberechnung freigeschaltet werden.

Ausgabe

Bereit für einen neuen Lauf
Beispielergebnis

Ihr Modell ist nicht dabei?

Sagen Sie uns, welches Modell fehlt und wofür Sie es brauchen. Ihre Anfrage geht direkt an das Team, das über die nächsten Modelle entscheidet.

LORA-VIDEO-API

Wan 2.1 LoRA-API auf einen Blick

Wan 2.1 mit Ihren eigenen LoRAs: eine Szene schreiben, ein Foto animieren oder einen Clip neu gestalten, 5 oder 10 Sekunden, ohne Content-Filter.

LoRAs pro Aufruf
3
Bis zu drei Gewichtsdateien pro Anfrage, jede mit eigener Stärke von 0 bis 4.
LoRAs, die laden
2.1, 2.2
Wan 2.1 14B LoRAs laden, und in unseren Tests veränderten auch einzelne Wan 2.2 Dateien und Low-Noise-LoRAs das Ergebnis.
Wege hinein
3
Ein Prompt, ein Startfoto oder ein eigener Clip zum Neugestalten.
Clip-Länge
5 / 10 s
Zwei Längen; ein 10-Sekunden-Clip kostet das Anderthalbfache eines 5-Sekunden-Clips.
Höchste Auflösung
720p
480p oder 720p; Text-zu-Video in 16:9 oder 9:16, Fotos und Clips behalten ihr eigenes Format.
Content-Filter
Keiner
Unzensiert: keine Prüfung Ihrer LoRAs und kein Filter auf dem Ergebnis.

Ergebnisse

Was Sie mit Wan 2.1 LoRA erstellen können

  • Kamera-LoRAs

    Die Kamerabewegung kommt aus der LoRA

    Eine 360-Orbit-LoRA, trainiert für Wan 2.1 Bild-zu-Video, mit ihrer Triggerphrase im Prompt. Ohne sie blieb die Kamera bei gleichem Seed ruhig; mit ihr kreist die Einstellung hinter ihren Rücken, Richtung Kanal.

    Bild-zu-Video mit einer 360-Orbit-LoRA bei 1, 720p, fünf Sekunden.

  • Stil-LoRAs

    Realfilm rein, Animation raus

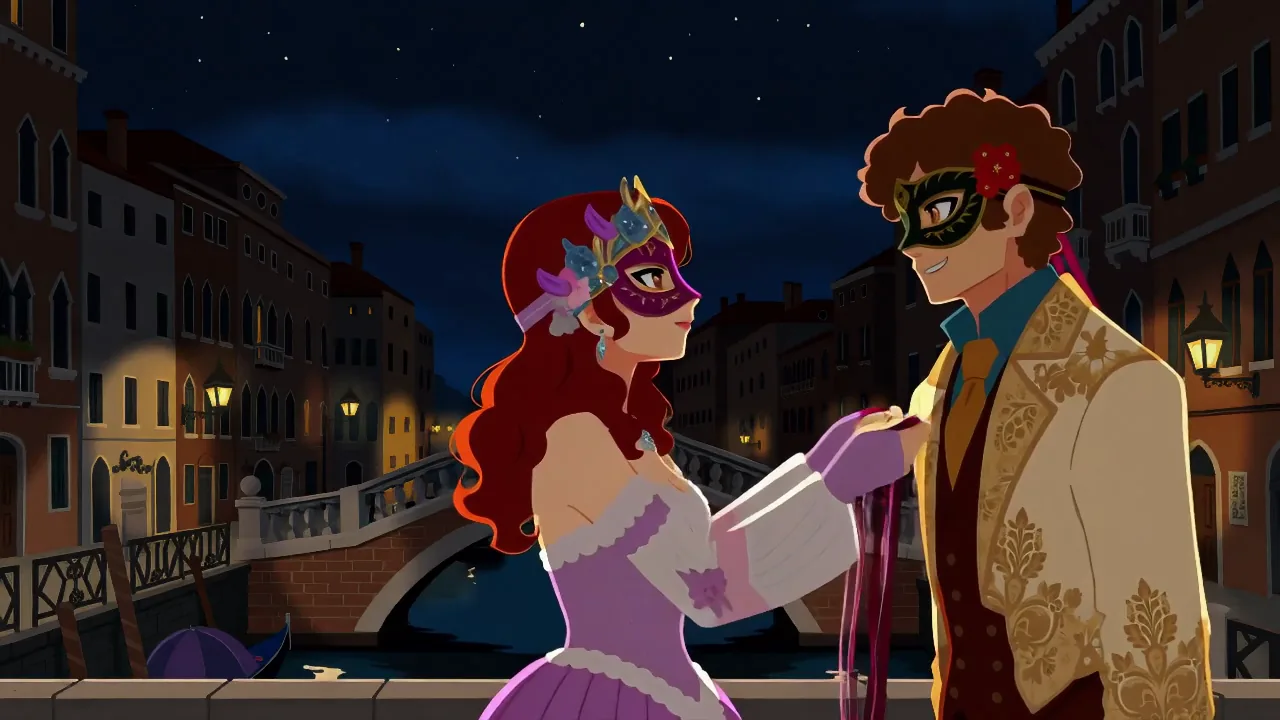
    Gleicher Prompt, gleicher Seed: Ohne die LoRA ein Paar als Realfilm auf der Brücke, mit einer Flat-Color-LoRA bei scale 1 derselbe Moment als Cel-Shading-Animation.

    Text-zu-Video mit einer Flat-Color-Stil-LoRA bei 1, 720p, 16:9.

  • Bild zu Video

    Vertraute Momente aus einem Standbild

    Ohne LoRA: zwei Frauen auf einer laternenbeleuchteten Treppe, eine nimmt der anderen die Maske ab. Licht und Stoffe des Fotos tragen sich durch die langsame Kamerafahrt nach vorn.

    Bild-zu-Video ohne LoRA, 720p, fünf Sekunden.

Weitere Clips aus Wan 2.1 LoRA

  • 5 s
  • Text-zu-Video ohne LoRA, 720p, 16:9, fünf Sekunden.
    5 s
  • Video-zu-Video ohne LoRA, 480p, Stärke 0,9, fünf Sekunden.
    5 s
  • Bild-zu-Video mit einer Dolly-Effekt-LoRA bei 1, 720p, Hochformat-Foto.
    5 s
  • Text-zu-Video ohne LoRA, 480p, 16:9, zehn Sekunden.
    10 s
  • Video-zu-Video mit einer Flat-Colour-LoRA bei 1, 480p, Quelle im Hochformat.
    5 s

Inhaltstest

Ist Wan 2.1 LoRA unzensiert? Das haben wir getestet

Wir haben jede Stufe auf unserem Live-System laufen lassen und jeden Clip Bild für Bild geprüft. Bestanden heißt: Der Inhalt war tatsächlich im Bild – nicht nur, dass die Anfrage durchging.

Getestete Inhaltsstufen für Wan 2.1 LoRA, nach Modus
StufeBild zu VideoText zu VideoVideobearbeitung
MildDie leichtesten Prompts im Test
Wird erzeugtGetestet am 9. Okt. 2026
MittelAb hier beginnen gefilterte Modelle abzulehnen
Wird erzeugtGetestet am 9. Okt. 2026
StarkDie Mitte der Skala
Wird erzeugtGetestet am 9. Okt. 2026
Sehr starkAb hier halten sich die meisten Modelle zurück
Noch nicht getestet
Noch nicht getestet
Noch nicht getestet
MaximalDas obere Ende der Skala
Noch nicht getestet
Noch nicht getestet
Noch nicht getestet

Wird erzeugt: im Bild wie geschrieben. Abgeschwächt: erzeugt, aber schwächer als geschrieben. Abgelehnt: zurückgewiesen. Noch nicht getestet: Diese Stufe haben wir in diesem Modus noch nicht ausprobiert.

So verhält sich jeder Modus

Alle Modi
Nur 5 und 10 Sekunden, und Clips haben keine Tonspur. LoRAs müssen öffentliche direkte Links zu .safetensors-Dateien sein, höchstens drei pro Anfrage; eine geschützte Datei, ein Seitenlink oder eine LoRA für ein fremdes Modell lässt die Anfrage scheitern, die dann nicht berechnet wird. Ohne eine LoRA ohne Inhaltsfilter kommen die stärksten Anfragen abgeschwächt zurück: Inhalte der Stufe Stark werden gezeichnet, die Stufe Sehr stark wird abgeschwächt.
Text zu Video
Nur zwei Formate: 16:9 und 9:16.
Bild zu Video
Der Clip behält das Format Ihres Fotos; ein Seitenverhältnis zur Auswahl gibt es nicht. Das Modell bleibt nah an dem, was das Foto zeigt, deshalb bleibt die Kleidung auf dem Foto meist erhalten, solange der Prompt keine klare Änderung verlangt.
Videobearbeitung
Das Ergebnis ist nie länger als die Vorlage, und die 10-Sekunden-Option wird auch bei kürzerer Vorlage zum 10-Sekunden-Preis berechnet. video_url muss auf ein Video zeigen: Ein Bildlink wird nicht abgelehnt, sondern liefert einen Clip aus einem einzigen Bild, der trotzdem berechnet wird. Unterhalb einer Stärke von etwa 0,6 kommt die Vorlage nahezu unverändert zurück.

Einsatzbereiche

Was Sie mit der Wan 2.1 LoRA-API bauen können

  • Eine Figur, viele Clips

    Laden Sie bei jeder Anfrage dieselbe Figuren- oder Stil-LoRA, und eine Serie behält über alle Szenen ein Gesicht und einen Look.

  • Kamerabewegungen auf einem Standbild

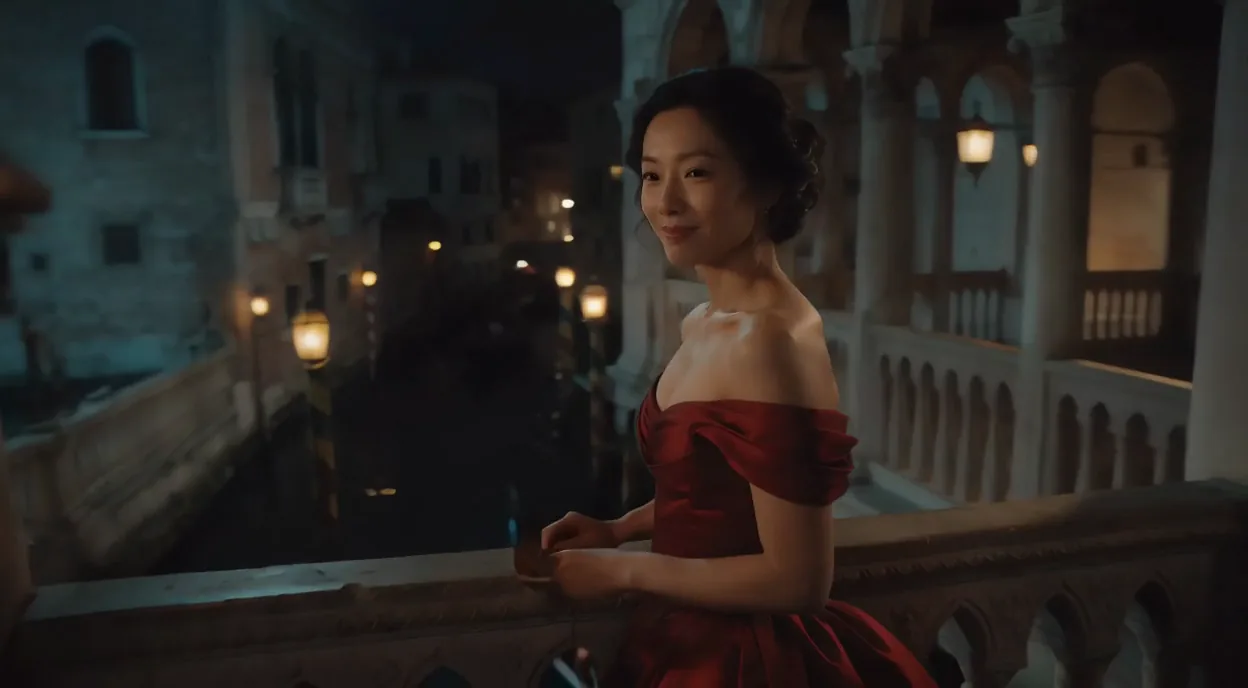
    Kamera-LoRAs, die für Wan 2.1 Bild-zu-Video trainiert wurden, fügen einem Foto die Bewegung hinzu; in unserem Beispiel umkreiste eine Orbit-LoRA eine Frau auf einer Palazzo-Loggia.

  • Vorhandenes Material neu gestalten

    Video-zu-Video behält Bewegung und Timing Ihres Clips und ändert Personen, Garderobe, Umgebung und Licht nach dem Prompt; in unseren Tests blieb das Ergebnis fotografisch.

  • Unzensierte Community-LoRAs

    LoRAs ohne Inhaltsfilter für Figuren und Stile werden wie jede andere Datei geladen: keine Zulassungsliste, keine Prüfung, kein Filter auf dem Ergebnis. Alle Personen im Bild müssen Erwachsene sein.

Prompts

Wan 2.1 LoRA-Prompts zum Kopieren

Fügen Sie einen unverändert in den Playground ein und ändern Sie dann jeweils nur eine Sache.

  • Text zu Video

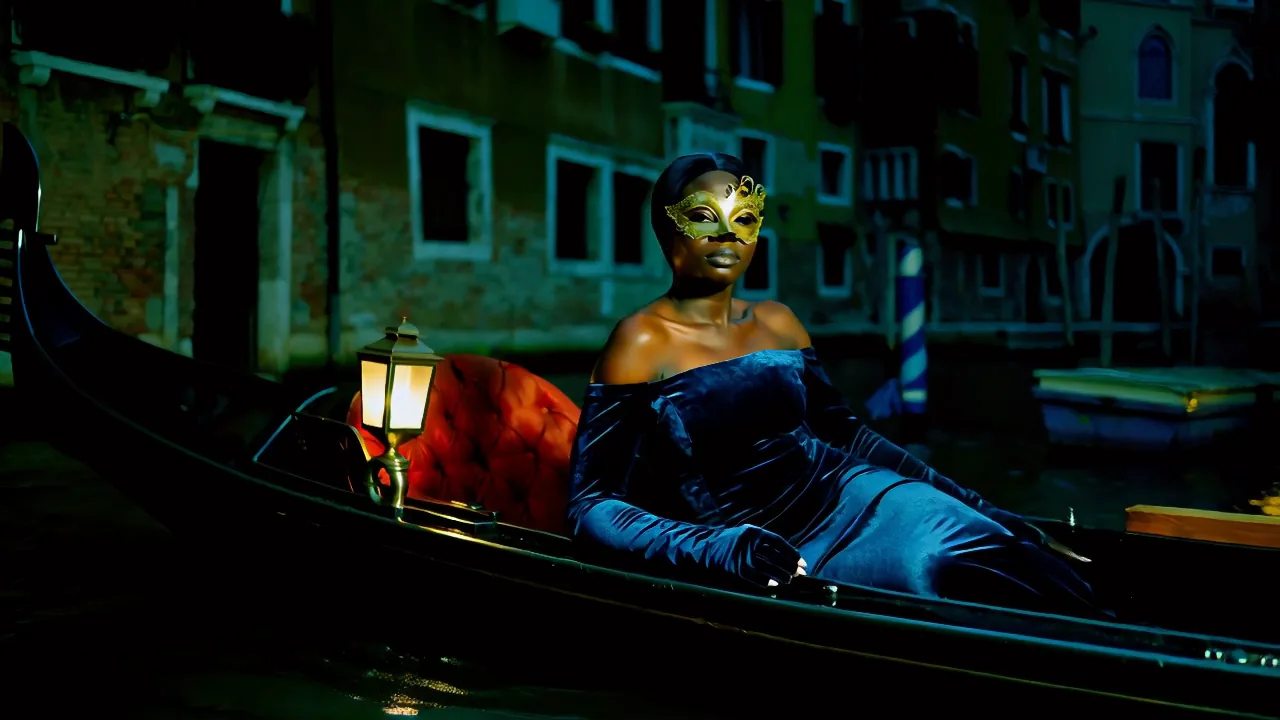
    Samtmaske auf einer Gondel

    Ergebnis dieses Prompts

    Night in Venice during carnival. An adult Black woman in her early thirties in a midnight-blue velvet gown with bare shoulders and a gold filigree half-mask reclines on the cushioned seat of a gondola gliding slowly down a narrow canal. Lanterns on striped mooring poles slide past and their light ripples across the black water and her skin. She lifts the mask away from her face, turns her head toward the camera and holds a slow, smouldering gaze. Slow tracking shot alongside the gondola, 35mm, shallow depth of field, warm amber against deep teal, fine film grain.

    Warum das funktioniert. Keine LoRA, das Basismodell allein in 720p. Eine Kamerafahrt neben der Gondel; sie hält die Kamera mit einem langen Blick, während die Laternen vorbeigleiten. Der Prompt verlangte auch, dass sie die Maske abnimmt, und sie behielt sie auf; nennen Sie also die eine Handlung, die Sie brauchen, zuerst und halten Sie sie einfach.

    Diesen Prompt testen
  • Bild zu Video

    Umkreisen eines maskierten Gastes auf der Loggia

    Ergebnis dieses Prompts

    The woman in the crimson gown slowly lowers the gilded mask from her face and turns toward the canal, then back to the camera with a quiet, alluring smile; a gondola glides by below. The camera performs an 0rb4it 360 degree orbit, circling around her on the loggia with the lanterns and the canal sweeping past behind her. Warm lantern light, cinematic.

    Warum das funktioniert. Eine 360-Orbit-LoRA für Wan 2.1 Bild-zu-Video bei 1, mit ihrer Triggerphrase im Prompt. Ohne die LoRA (gleiches Foto, gleicher Seed) blieb die Kamera stehen und sie drehte nur den Kopf; mit ihr schwenkt die Kamera hinter ihren Rücken, Richtung Kanal.

    Dieser Modus startet mit Ihrem eigenen Bild: Fügen Sie es im Playground hinzu, bevor Sie starten.

    Diesen Prompt testen
  • Text zu Video

    Flächige Bänder auf der Brücke

    Ergebnis dieses Prompts

    flat color, no lineart. Masquerade night in Venice: an adult East Asian woman in a lilac satin gown and an adult white man with curly red hair in a cream brocade coat stand close on a small arched stone bridge over a lantern-lit canal, both wearing ornate half-masks. She reaches up and slowly unties the ribbon of his mask; he smiles and leans in until their foreheads almost touch. Lanterns sway, gentle mist drifts on the water. Slow push-in.

    Warum das funktioniert. Eine Wan 2.1 Flat-Color-LoRA bei 1 mit ihren Triggerwörtern. Derselbe Prompt mit demselben Seed ohne die LoRA kam als Realfilm-Aufnahme des Paares zurück; mit ihr wird der Moment zur Cel-Shading-Animation, und sie löst sein Maskenband, bis sich ihre Stirnen berühren.

    Diesen Prompt testen

Preise

Preise der Wan 2.1 LoRA-API

Ab $0.24 je Anfrage.

Der Playground zeigt vor dem Start den genauen Preis für Ihre Einstellungen. Fehlgeschlagene oder abgelaufene Aufträge werden normalerweise nicht berechnet. Manche Modelle berechnen Inhaltsablehnungen wie auf ihrer Modellseite angegeben; prüfen Sie diese Abrechnungsbedingungen vor dem Absenden.

Alle Preisstufen ansehen

Loslegen

Die Wan 2.1 LoRA-API in drei Schritten nutzen

  1. Schritt 1

    Die Datei verlinken, nicht die Seite

    Verwenden Sie einen öffentlichen Link, der die .safetensors-Datei selbst herunterlädt, etwa einen „resolve/main“-Link von Hugging Face. Eine Repository-Seite, eine Datei hinter einer Anmeldung oder ein Civitai-Link, der zur Anmeldung weiterleitet, lässt die Anfrage scheitern; fehlgeschlagene Anfragen werden nicht berechnet.

  2. Schritt 2

    Zum Basismodell passen

    Wählen Sie LoRAs, die für Wan 2.1 14B trainiert wurden: Text-zu-Video-LoRAs oder LoRAs für die Bild-zu-Video-Checkpoints in 480P und 720P. Auch Wan 2.2 LoRAs wirkten in unseren Tests. Eine LoRA für ein fremdes Modell, etwa ein Bildmodell, lässt die Anfrage scheitern.

  3. Schritt 3

    Eine LoRA mit Bild-zu-Video beurteilen

    Bild-zu-Video lieferte in unserem Test bei gleichem Seed und gleichen Eingaben einen byteidentischen Clip. Ein Lauf mit leerem loras und ein Lauf mit Ihrer LoRA zeigen also genau, was die LoRA tut. In unseren Läufen bewegte 0,5 das Ergebnis bereits, und 1 bewegte es weiter.

Parameterreferenz und Codebeispiele finden Sie oben auf dieser Seite in den Tabs API und Readme.

Warum SpicyAPI

Warum Sie Wan 2.1 LoRA über SpicyAPI nutzen

  • Kein Filter von uns

    Wir fügen keinen eigenen Inhaltsfilter hinzu. Was das Modell erzeugt, bekommen Sie zurück.

  • Getestet statt vermutet

    Inhaltsstufen stammen aus echten Generierungen, die wir ausgeführt und geprüft haben – mit Testdatum auf der Seite.

  • Pro Ergebnis zahlen, in Dollar

    Kein Abo, keine Credits. Fehlgeschlagene oder abgelaufene Aufträge werden normalerweise nicht berechnet. Manche Modelle berechnen Inhaltsablehnungen wie auf ihrer Modellseite angegeben; prüfen Sie diese Abrechnungsbedingungen vor dem Absenden.

  • Ein Schlüssel für alle Modelle

    Ein API-Schlüssel und ein Guthaben gelten für Bild-, Video-, Audio- und Chatmodelle. So können Sie mit demselben Konto weitere Modelle ausprobieren.

FAQ

FAQ zur Wan 2.1 LoRA-API

Über Wan 2.1 LoRA

Wan 2.1 LoRA ist Alibabas offenes 14B-Videomodell mit Platz für Ihre eigenen Gewichte: bis zu drei LoRA-Dateien pro Anfrage, jede mit einer Stärke von 0 bis 4, bei Text-zu-Video, Bild-zu-Video und Video-zu-Video. Die Clips dauern 5 oder 10 Sekunden in 480p oder 720p, mit freien Einstellungen für Schritte, Guidance und Flow Shift. LoRAs werden nicht geprüft, und nichts wird gefiltert.

Alle Wan-Modelle22

Videomodelle18

Verwandte Modelle und nächste Schritte