Zum Hauptinhalt springen

Text-zu-Bild auf Z-Image Base, dem nicht destillierten Z-Image-Modell mit 6 Milliarden Parametern vom Tongyi-MAI-Team von Alibaba, mit bis zu drei eigenen LoRAs pro Anfrage. Prompts in ganzen Sätzen, neun Seitenverhältnisse, JPEG, PNG oder WebP und kein Filter auf Prompts, Gewichte oder Ergebnisse.

Ab $0.014/Bild

Playground

Eingabe

Text zu Bild
406/5000
Ganze Sätze funktionieren am besten: Motiv, Kleidung, Ort, Licht und Objektiv. Die Trigger-Phrase einer LoRA kommt zuerst. Bis zu 5.000 Zeichen; es gibt keinen Negativ-Prompt. mindestens 1 Zeichen · höchstens 5000 Zeichen
Neun Formate mit etwa einem Megapixel, von 21:9 (1536 x 640) bis 9:21; standardmäßig 1:1. Das Format ändert die Form, nicht den Preis.
Stil-LoRAs1/3

Mikkoani

Bis zu drei Einträge {path, scale}, trainiert auf Z-Image Base; scale 0 bis 4, 1 ist neutral. Turbo-LoRAs sind nicht kompatibel. Nutzen Sie einen öffentlichen Direktlink zur .safetensors-Datei. höchstens 3 Einträge
Ausgabeformat
JPEGPNGWebP
Standardmäßig JPEG, bei Bedarf PNG oder WebP. Das Format ändert den Preis nicht.
Seed
Hält eine Bildserie vergleichbar, während Sie jeweils nur eine LoRA oder einen Satz ändern. Er garantiert nicht bei jedem Lauf exakt dieselben Pixel. nicht kleiner als 0 · nicht größer als 2147483647
SicherheitsfilterAus

SpicyAPI führt bei diesem Modell keinen Sicherheitsfilter aus. Prompt und Material gehen unverändert an das Modell, und das Modell selbst entscheidet über das Ergebnis.

Wir prüfen Ihr Konto, bevor Absenden und Preisberechnung freigeschaltet werden.

Ausgabe

Bereit für einen neuen Lauf
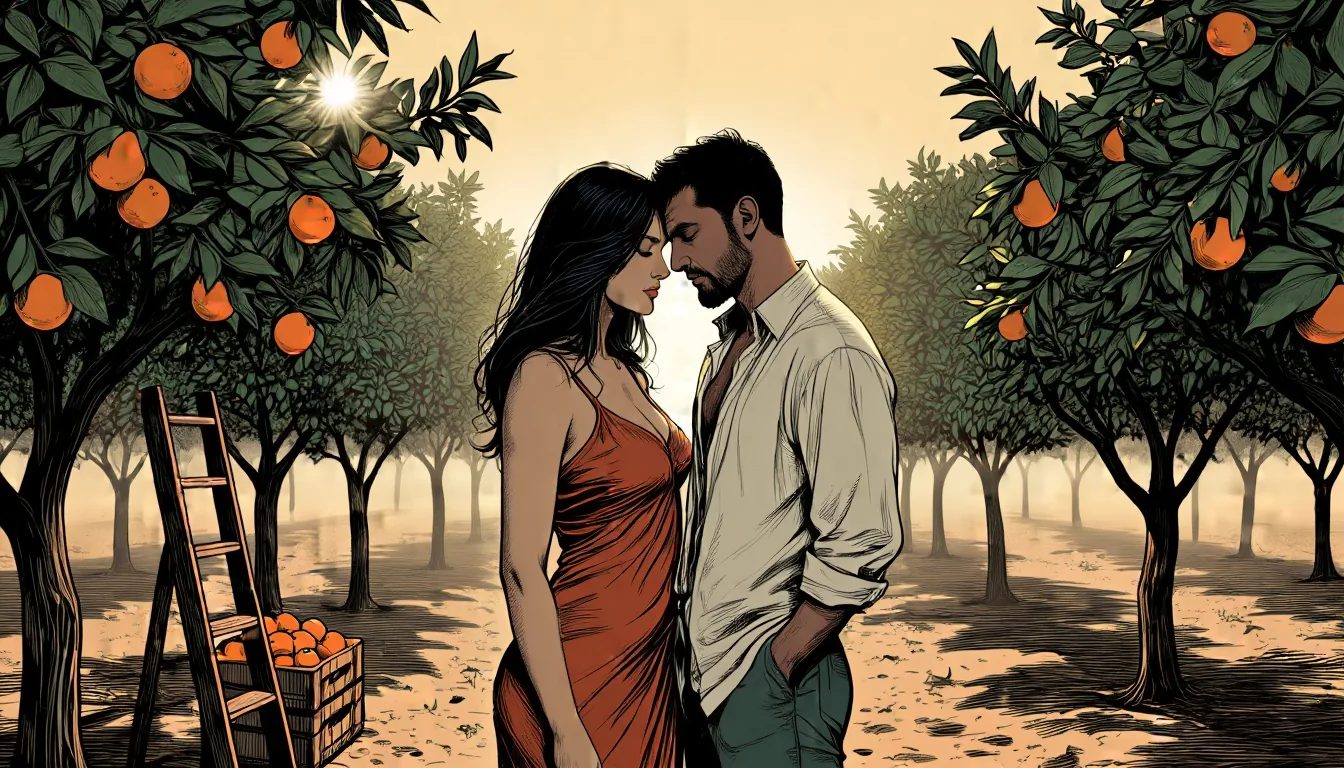
orange-grove-sunriseBeispielergebnis

Verwandte Modelle und nächste Schritte

Ihr Modell ist nicht dabei?

Sagen Sie uns, welches Modell fehlt und wofür Sie es brauchen. Ihre Anfrage geht direkt an das Team, das über die nächsten Modelle entscheidet.

LoRAs für Z-Image Base ausführen und Fotos mit einem Stärkeregler neu stilisieren

Z-Image Base LoRA betreibt Z-Image Base, das Foundation-Modell mit 6 Milliarden Parametern von Tongyi-MAI bei Alibaba, mit bis zu drei LoRAs bei Text-zu-Bild und bei Bild-zu-Bild. Base ist das undestillierte Modell, auf dem die Community trainiert, und daher langsamer als Turbo: Text-zu-Bild brauchte 9,8 bis 56,7 Sekunden mit einem Median von 32,8, Bearbeitungen 4,9 bis 41,7 mit einem Median von 16,8. Nichts filtert Prompt oder Bild, doch das Basismodell allein zeichnet die Stufe Sehr stark schlecht, und dafür gibt es LoRAs.

Playground öffnen
LoRAs für Z-Image Base ausführen und Fotos mit einem Stärkeregler neu stilisieren
LoRAs pro Anfrage
Bis zu 3, jeweils {path, scale}; die Datei muss auf Z-Image Base trainiert sein, nicht auf Turbo
Bearbeitungsstärke
0 bis 1, Standard 0,7; bei etwa 0,6 stilisierte eine LoRA neu, bei 0,75 wurde die Szene neu inszeniert
Größen
9 Seitenverhältnisse bis 1536 pro Seite; Bearbeitungen nehmen 1k oder 1.5k an der langen Seite und behalten das Verhältnis der Vorlage
Tempo
Text-zu-Bild Median 32,8 Sekunden in 36 Läufen; Bearbeitung Median 16,8 Sekunden in 28 Läufen
Preis
Abrechnung pro Bild zu einem Einheitspreis; Größe, Quellbild und LoRA-Anzahl ändern ihn nicht
Nicht verfügbar
Schritte, Guidance und Negativ-Prompt; der Endpunkt hat solche Felder nicht
Richtiges Basismodell
Eine LoRA vom falschen Modell scheitert ohne FehlermeldungEine auf Z-Image Turbo trainierte LoRA, geladen auf Base, zerlegte das Bild in Rauschen und Pseudo-Text. Eine Pony-LoRA und eine als Z-Image gekennzeichnete Datei in einem anderen Schlüsselformat wurden beide geladen und änderten nichts. Verwenden Sie auf Base trainierte Dateien und lassen Sie zuerst ein Paar mit und ohne Datei laufen.
Grenzen der Bearbeitung
Bearbeitungen zeichnen das Bild neu und folgen keinen AnweisungenOhne LoRA blieb die Bitte um Schwarzweiß bei strength 0.65 und 0.8 farbig, und die Bitte um einen Smoking bei 0.7 und 0.8 änderte wenig. Beschreiben Sie das ganze gewünschte Bild und nehmen Sie eine Stil-LoRA dazu, wenn sich der Look ändern soll.
Ehrliche Grenze
Eine Inhaltsstufe kommt abgeschwächt herausVor dem Modell sitzt kein Content-Filter, und an beiden Endpunkten wurde in unserem fünfstufigen Inhaltstest jede Stufe außer Sehr stark gerendert, einschließlich Maximal. Sehr stark kam in drei Versuchen abgeschwächt zurück: Das Basismodell zeichnet sie allein nicht überzeugend, und genau dafür gibt es darauf trainierte LoRAs.

Arbeiten mit Z-Image Base LoRA

Foto-Prompts als einfache Sätze schreiben

Foto-Prompts als einfache Sätze schreiben

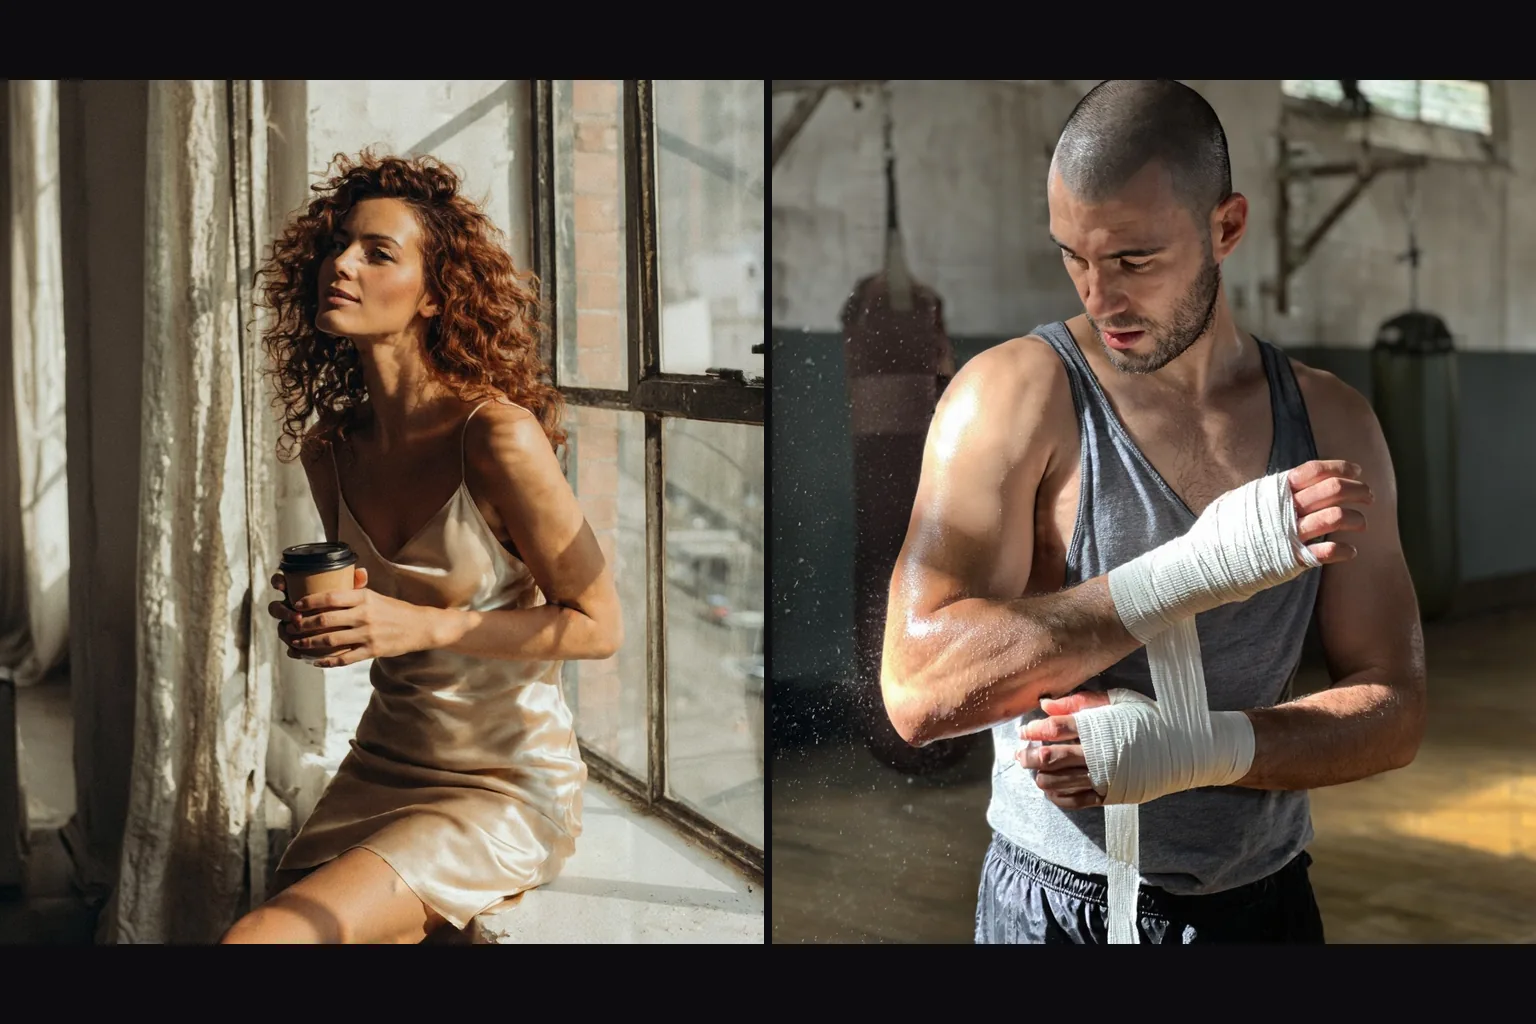
Das Modell folgt dem Prompt gut; beschreiben Sie das Foto also so, wie Sie einen Fotografen briefen würden: Motiv, Kleidung, Ort, Licht, Korn. Unsere Porträts im Loft und im Fitnessstudio entstanden aus je einem Satz. Derselbe Satzbau, nur mit getauschtem Motiv, trägt eine ganze Serie.

Auf Base trainierte LoRAs verwenden

Auf Base trainierte LoRAs verwenden

Eine auf Z-Image Base trainierte LoRA funktionierte mit 0.5 und mit 1. Die Illustrations-LoRA mikkoani schaltet sich mit ihrer Phrase „mature illustration with muted color and complex linework“ am Anfang des Prompts ein, und die Phrase allein, ohne die Datei, schob einen Foto-Prompt bereits in Richtung Illustration.

  • Erst die Stärke wählen, dann den Prompt umschreiben

    Bei der Bearbeitung entscheidet strength, wie viel von der Vorlage übrig bleibt. In unserer Reihe ließen 0.3 und 0.5 das Bild fast unverändert und 0.6 veränderte es leicht. Bei 0.7 begann sich der Inhalt zu ändern, während die Komposition erhalten blieb, 0.75 stellte die Szene neu und inszenierte sie neu bei erhaltenem Licht und Farbpalette, und 0.85 ergab ein neues Bild. Mit einer Stil-LoRA stilisierte 0.6 das ganze Bild neu und behielt die Komposition genau bei.

  • Neustilisierung erwarten, keine Anweisungen

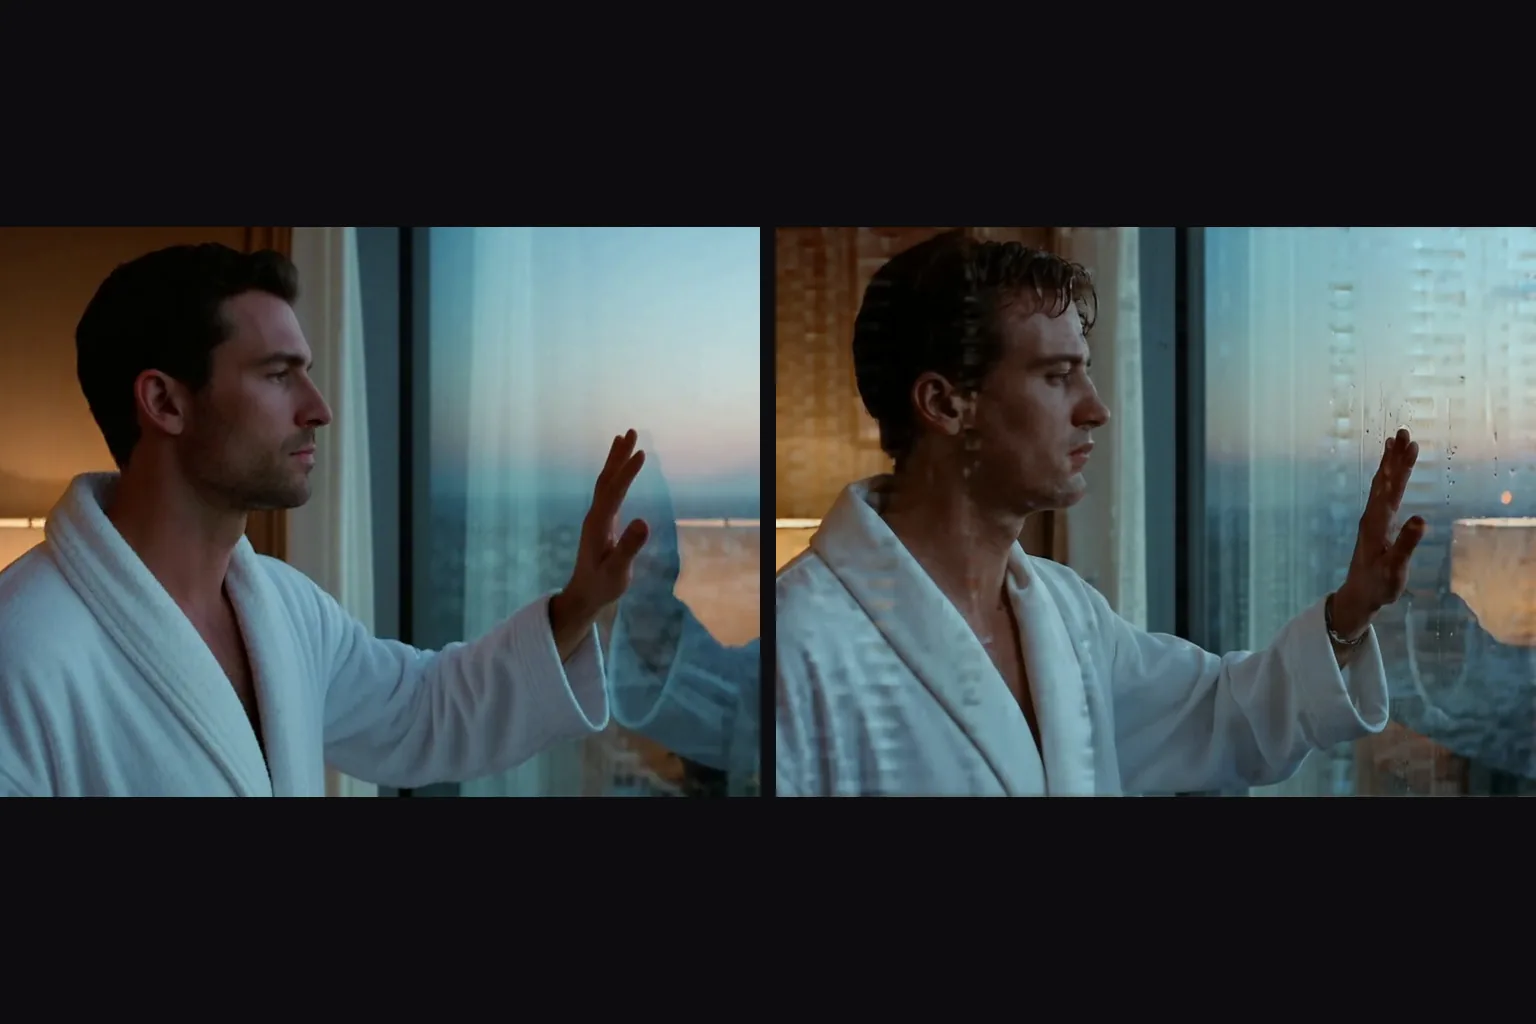
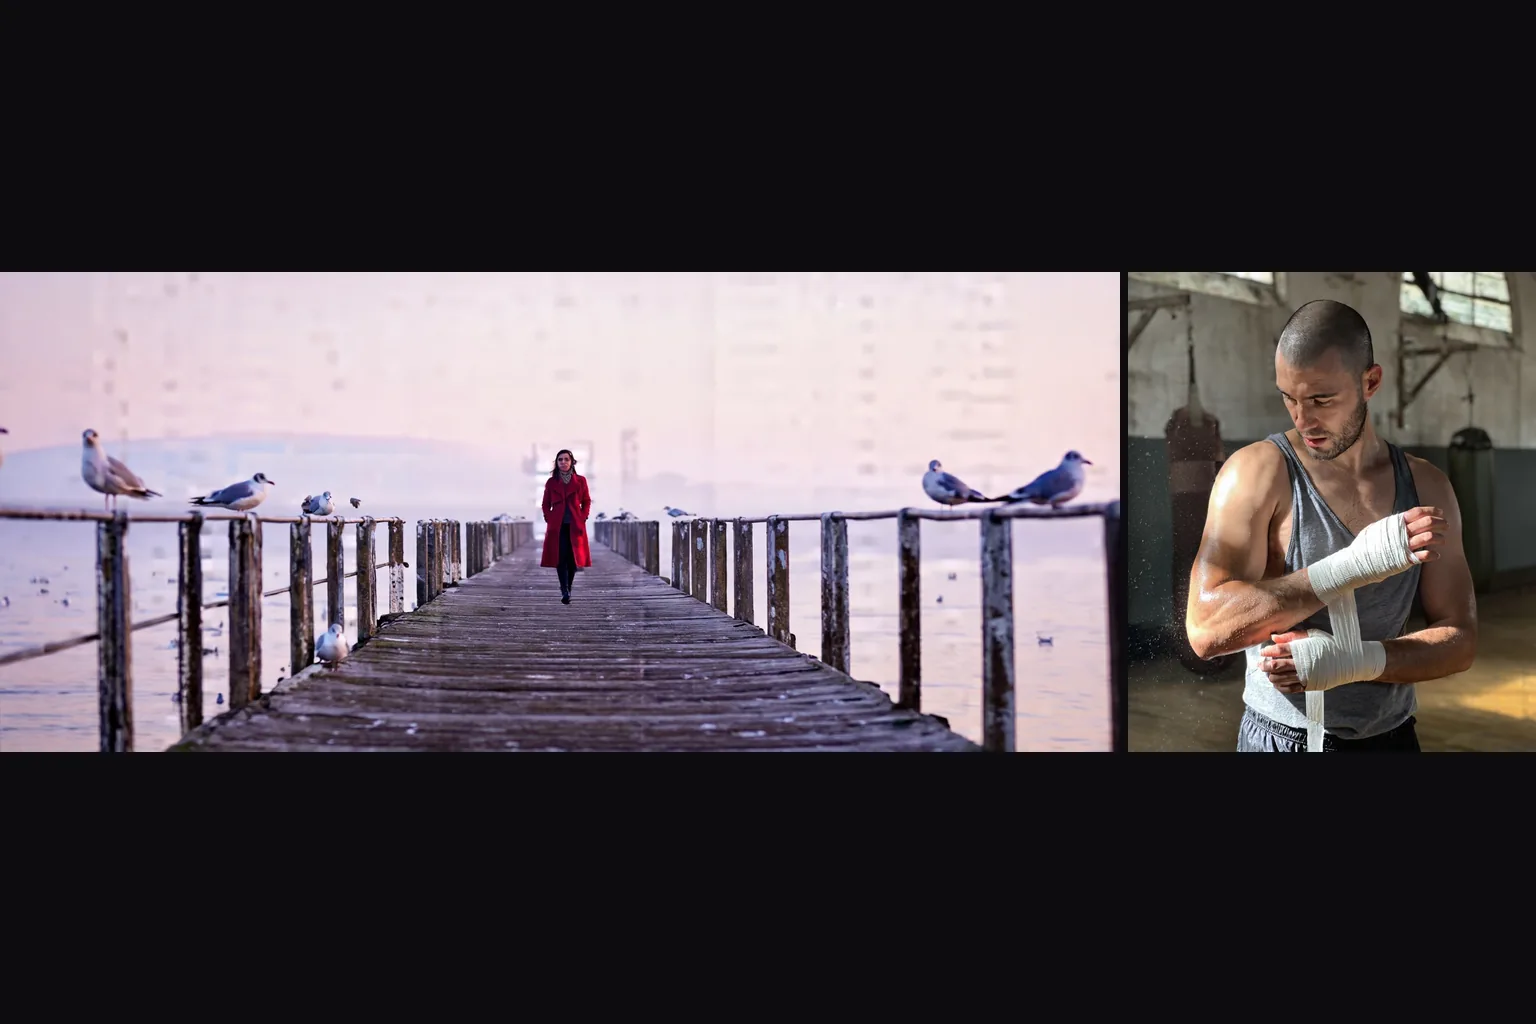
    Das Bearbeitungsmodell zeichnet das Bild aus Ihrer Beschreibung neu. „Make it black and white“ blieb in unserem Test bei 0.65 und 0.8 farbig, wie das rechte Bild zeigt. Für einen Wechsel des Mediums nehmen Sie eine Stil-LoRA; für eine andere Szene beschreiben Sie sie vollständig.

  • Auf die Größen achten

    Text-zu-Bild bietet neun Verhältnisse, von 1024×1024 für 1:1 bis 1536×640 für 21:9, und jedes kam in genau der angeforderten Größe zurück. Bei der Bearbeitung legen 1k und 1.5k die lange Seite fest, und das Verhältnis der Vorlage bleibt erhalten: Ein 2:3-Foto in 1k kam mit 680×1024 zurück, ein 16:9-Foto in 1.5k mit 1536×856.

Wer Z-Image Base LoRA nutzt

  • Gedeckte, linienreiche Illustration aus Text

    Illustratoren und Concept Artists

    Gedeckte, linienreiche Illustration aus Text

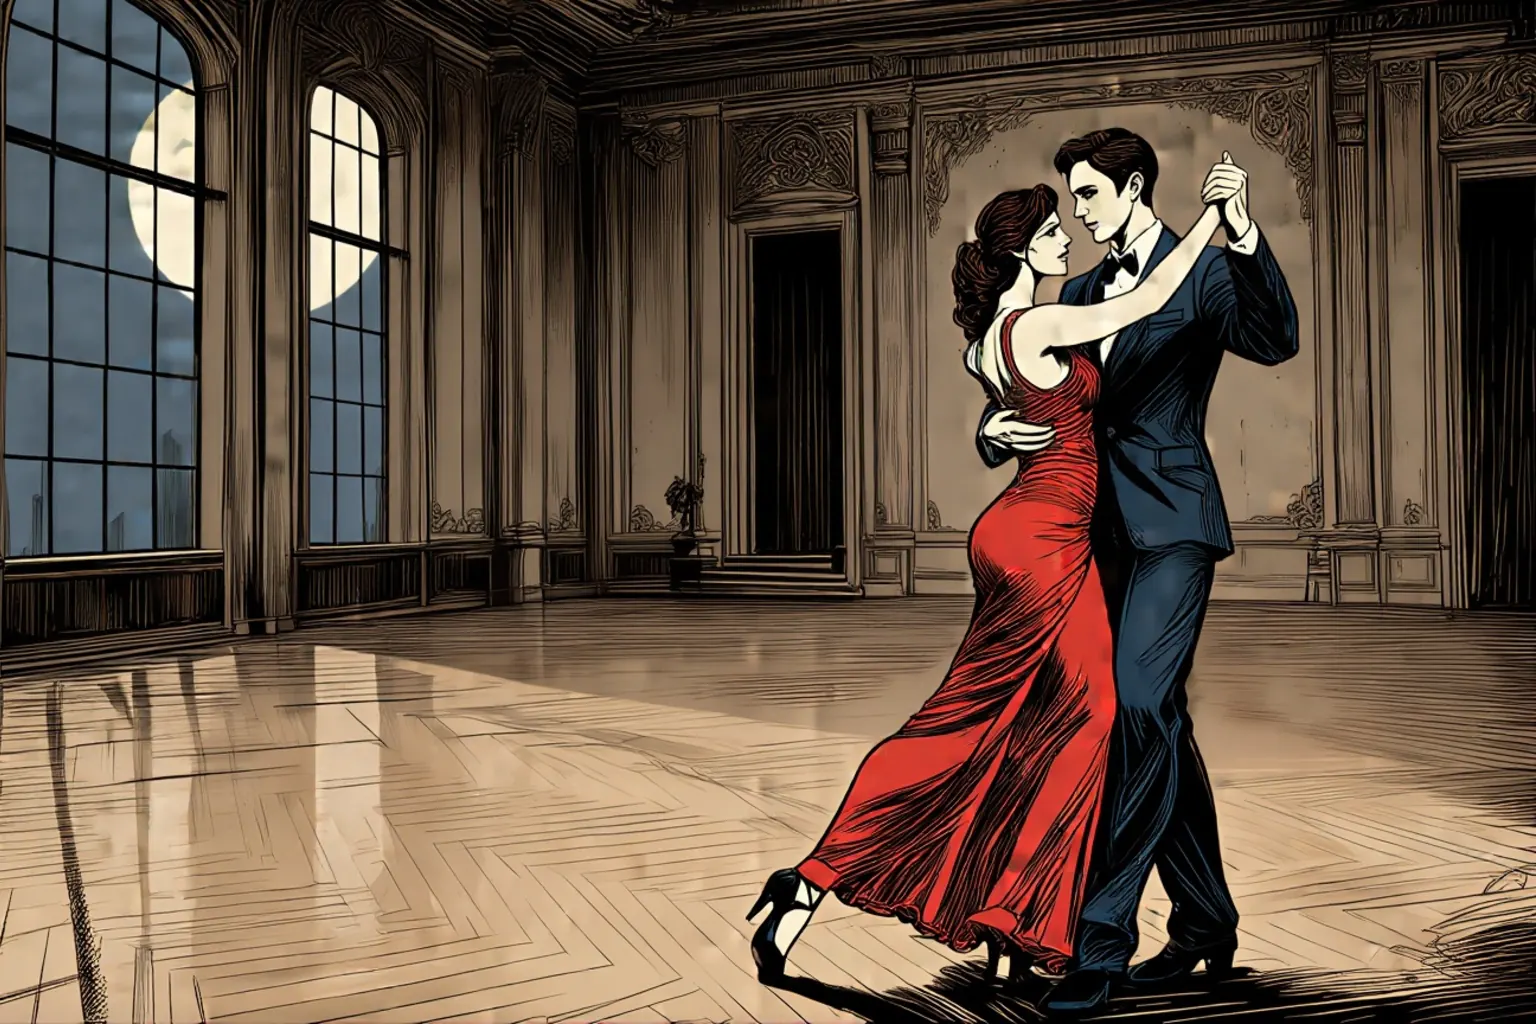
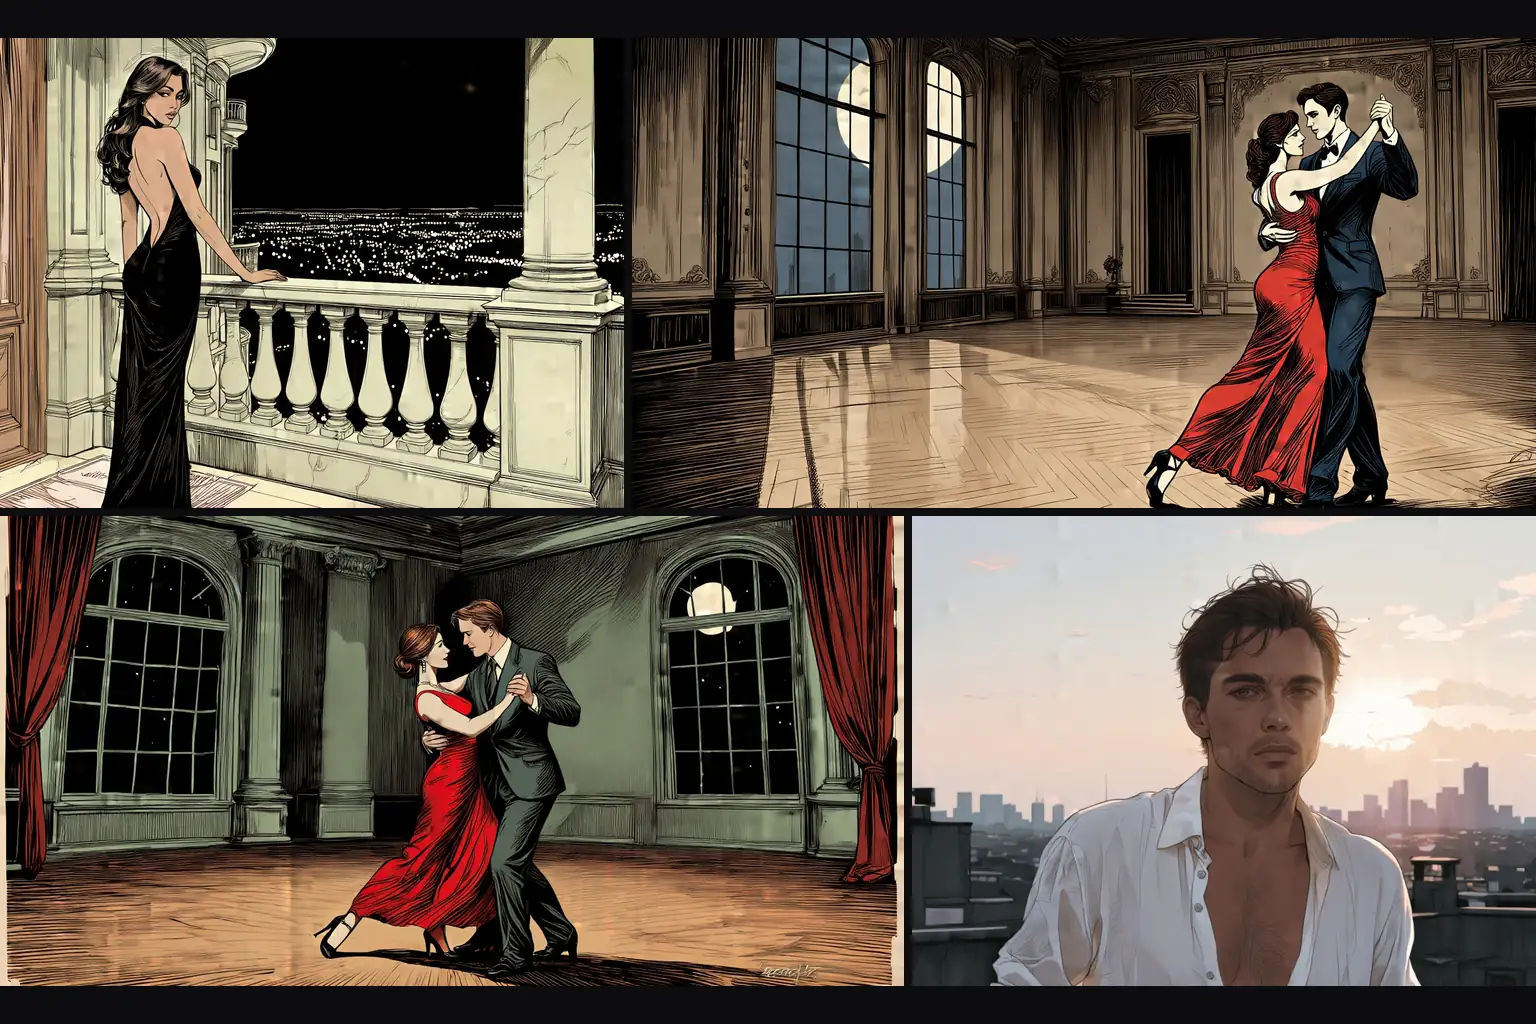
    Mit der LoRA mikkoani bei 1 kamen unsere Prompts für einen Tanz im Ballsaal, einen Balkon bei Nacht und ein Paar in einer mondhellen Halle alle als getuschte Illustration in gedeckten Farben zurück. Lassen Sie die Phrase vorn und schreiben Sie die Szene in Sätzen.

  • Ein Foto wird zur Illustration

    Fotografen und Retuscheure

    Ein Foto wird zur Illustration

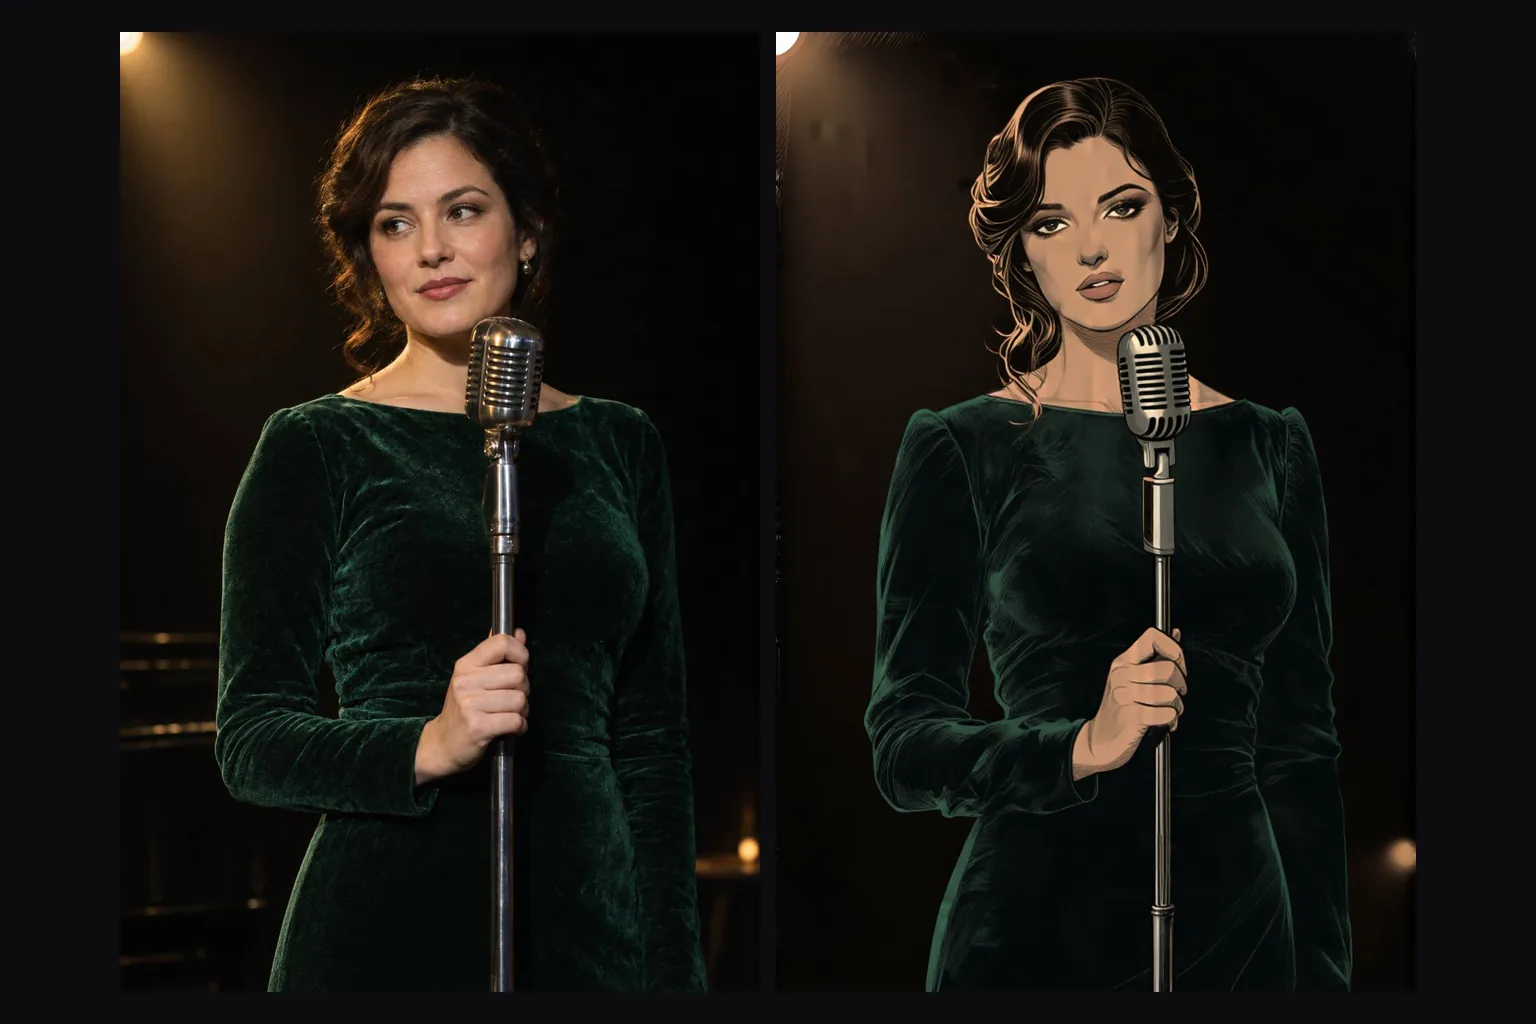
    Links ist ein Vorlagenfoto einer Sängerin im grünen Samtkleid, rechts die Bearbeitung mit der LoRA mikkoani bei strength 0.6. Pose, Mikrofon und Bildausschnitt blieben, wo sie waren, während die Darstellung gezeichnet wurde.

  • Entscheiden, wie weit eine Variation geht

    Social- und Kampagnen-Teams

    Entscheiden, wie weit eine Variation geht

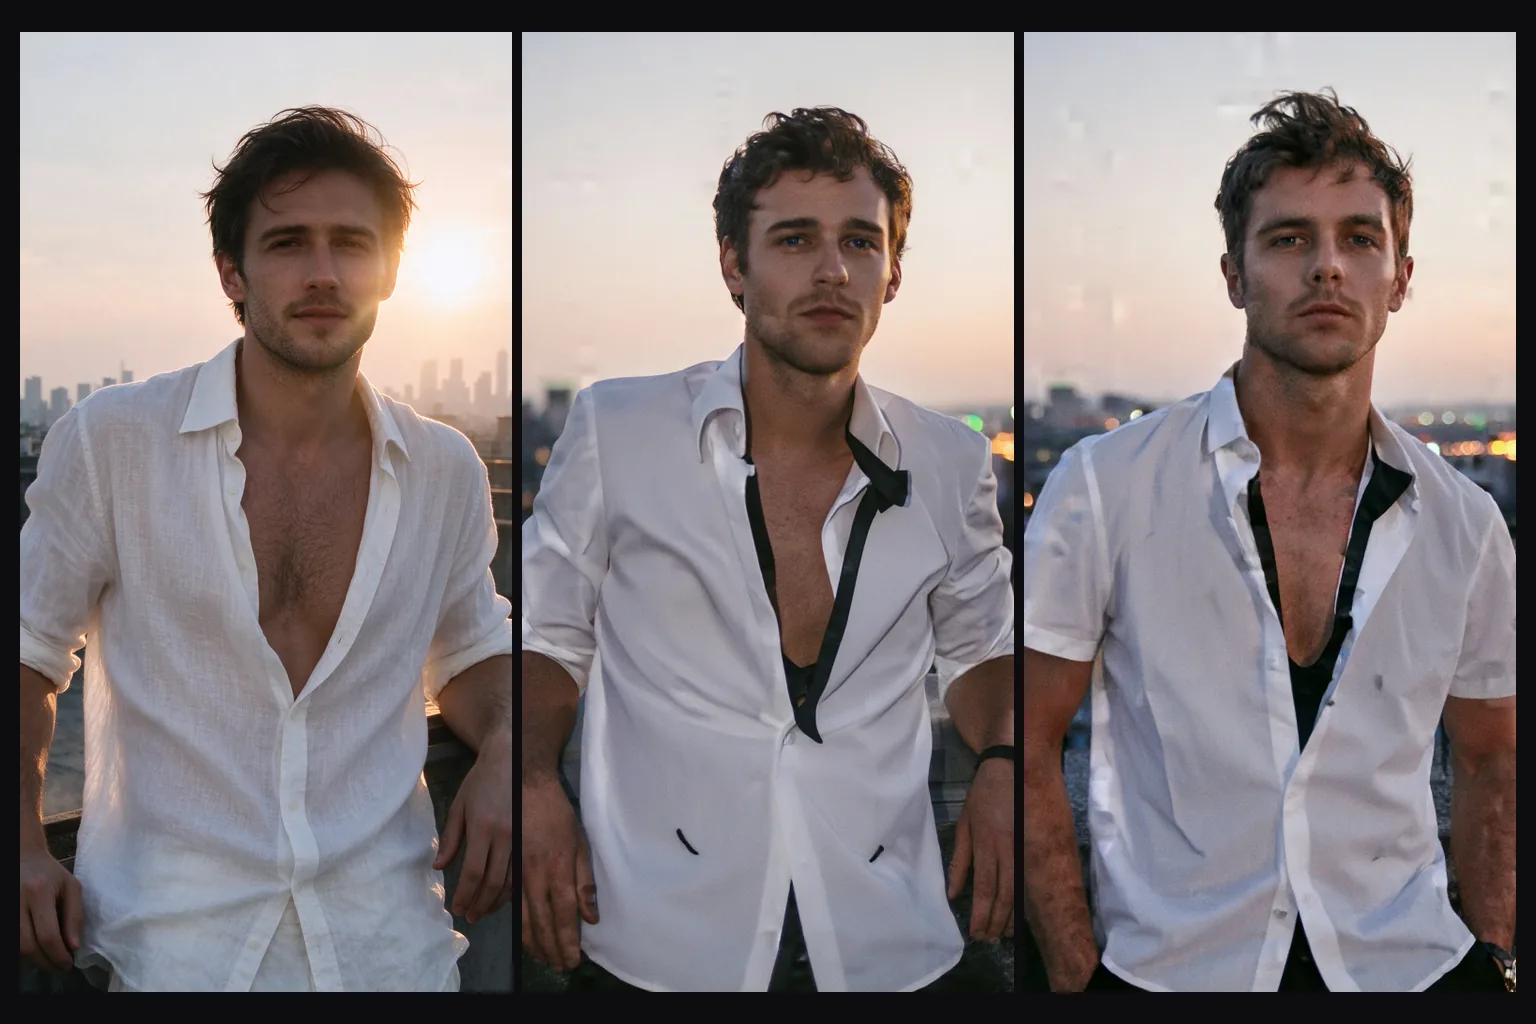
    Unser Dachporträt durchlief eine Bearbeitung ohne LoRA mit der Bitte um einen Smoking bei 0.7 und 0.8. Es änderte sich wenig, und die Komposition blieb. Nutzen Sie die Stärke als Variationsregler und heben Sie die höheren Werte für den Fall auf, dass Sie ein anderes Bild wollen.

  • Breite 21:9-Szenen mit 1536 Pixeln

    Cinematic- und Wallpaper-Macher

    Breite 21:9-Szenen mit 1536 Pixeln

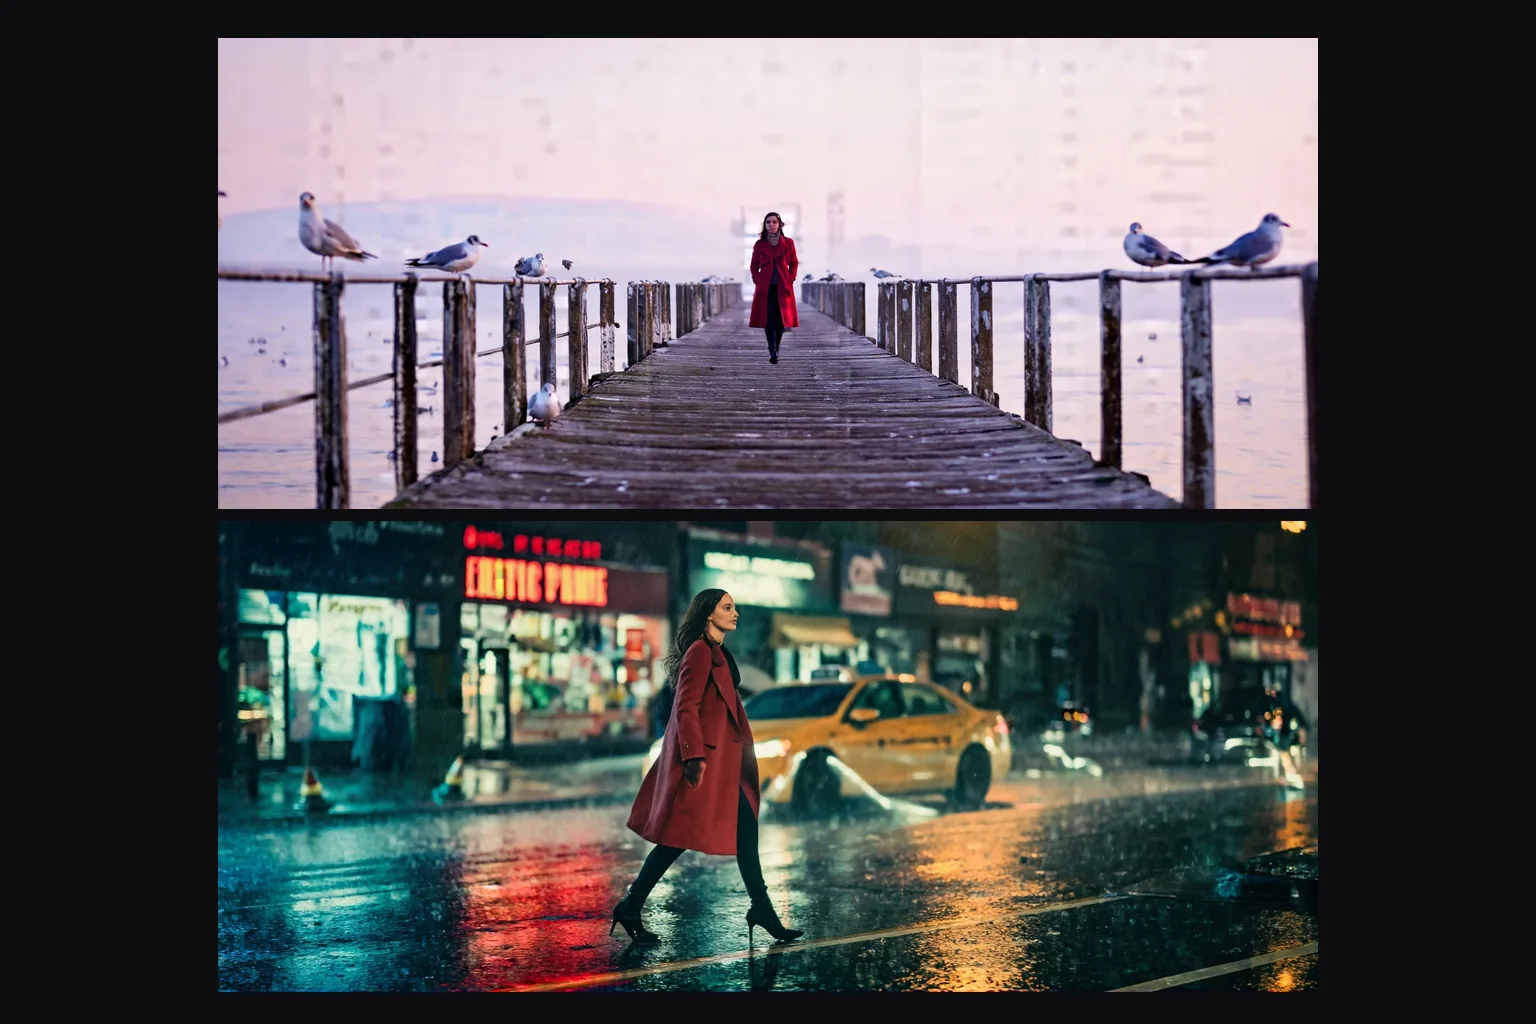
    Eine Frau im roten Mantel auf einem Nebel-Pier im Morgengrauen und auf einer regennassen Neonstraße entstanden beide aus einfachen Sätzen in 21:9 (1536×640), ohne LoRA. Das breite Verhältnis ist Teil des Prompts, kein nachträglicher Zuschnitt.

Vom ersten Prompt zur fertigen Bearbeitung mit Z-Image Base LoRA

  1. Mit einem Prompt aus einfachen Sätzen starten

    Lassen Sie Text-zu-Bild zuerst ohne LoRA laufen, im Verhältnis, in dem Sie veröffentlichen, um zu sehen, was das Basismodell liefert.

  2. Eine auf Base trainierte LoRA ergänzen

    Kopieren Sie den direkten Download-Link zur .safetensors-Datei und lassen Sie sie mit und ohne Datei beim selben Seed laufen.

  3. Den scale prüfen

    Probieren Sie 0.5 und 1 und behalten Sie den Wert, bei dem der Look greift, ohne das Motiv zu überrollen.

  4. Mit einer Stärkereihe bearbeiten

    Senden Sie ein Quellbild mit dem Array loras und beginnen Sie bei 0.6; nehmen Sie 0.7 und 0.75, wenn die Szene neu inszeniert werden soll.

  5. Das ganze Ergebnis beschreiben

    Das Modell zeichnet das gesamte Bild neu; schreiben Sie also das vollständige Bild, nicht nur die Änderung.

Z-Image Base LoRA-Prompts zum Kopieren

  • Ein Foto aus einfachen Sätzen

    Keine LoRA; Hochformat 2:3.

    A photograph of a woman in her thirties with curly auburn hair, wearing a champagne satin slip dress, sitting on a windowsill in a sunlit loft, holding a coffee cup with both hands, golden hour light on her face, soft film grain.
  • Eine gedeckte Illustration

    Mit der LoRA mikkoani bei scale 1 und dem Verhältnis 16:9; die Phrase bleibt vorn.

    mature illustration with muted color and complex linework. A woman in her thirties in a red evening dress and a man in his thirties in a dark suit dance close in an empty ballroom at night, moonlight through tall windows, long shadows on the parquet floor.
  • Ein Foto wird zu gezeichneter Linienführung

    Für den Bearbeitungs-Endpunkt mit der LoRA mikkoani bei scale 1 und strength 0.6. Beschreiben Sie das ganze Bild, nicht nur die Änderung.

    mature illustration with muted color and complex linework. A woman with wavy dark hair in a green velvet dress sings into a vintage microphone on a dark stage, warm spotlight from above.

Weitere Fragen zu Z-Image Base LoRA

Ihr Labor für das Basismodell

Beginnen Sie mit einem Prompt aus einfachen Sätzen, ergänzen Sie eine auf Base trainierte LoRA und belegen Sie sie mit einem Paar mit und ohne Datei.

Steigern Sie bei der Bearbeitung die Stärke ab 0.6 und beschreiben Sie das ganze Ergebnis. Ändert eine Datei nichts oder zerstört sie das Bild, wurde sie für ein anderes Modell trainiert.