HunyuanVideo 1.5 no tiene censura en SpicyAPI, con un límite claro. En 50 pruebas de contenido del 5 de octubre de 2026 no se rechazó, difuminó ni bloqueó nada, las 26 pruebas de L1 a L3 volvieron tal como se escribieron, y la escena L4 de dos adultos se suavizó en las 8 pruebas. Tres de las 16 pruebas de L5 también se suavizaron, lo que le da al modelo un Freedom Score de 88.1 sobre 100. Esa libertad es de los pesos abiertos y de los hosts que no agregan ningún filtro: la API alojada de Tencent documenta un interruptor de moderación y códigos de rechazo.
La mayoría de las páginas que responden "is Hunyuan Video uncensored" hablan del primer HunyuanVideo, de 13 mil millones de parámetros, de diciembre de 2024, ejecutado en la GPU de alguien. El modelo que hoy se puede llamar por API es HunyuanVideo 1.5, que Tencent publicó con pesos abiertos el 20 de noviembre de 2025 con 8.3 mil millones de parámetros. Ese es el modelo que probamos, a través de los endpoints de texto a video y de imagen a video.
Nuestra prueba de HunyuanVideo 1.5 el día del lanzamiento cubre tamaños, velocidad y una sola pasada de cada nivel. Esta página es el veredicto tras pruebas repetidas, en qué se distingue "suavizado" de un filtro real, cómo difieren los canales propios de Tencent y a qué modelo cambiar cuando un nivel se suaviza. Todos los prompts que se imprimen aquí son escenas cotidianas con ropa; las pruebas de contenido se resumen, nunca se citan.
De un vistazo
| Pregunta | Respuesta según nuestras pruebas |
|---|---|
| Veredicto | Sin censura aquí: sin filtro de prompt, sin filtro de salida, sin rechazos |
| Modelo | HunyuanVideo 1.5 (Tencent), texto a video e imagen a video |
| Pruebas | 50 el 5 de octubre de 2026, 25 por endpoint, 480p, 5 segundos |
| Volvieron tal como se escribieron | 39 de 50 |
| Suavizadas | 11 de 50: 8 en L4, 3 en L5 |
| Rechazadas, difuminadas, con error | 0, 0, 0 |
| Freedom Score | 88.1 / 100 (texto a video 88.8, imagen a video 87.5) |
| Dónde se detiene | L4 Intenso: 0 de 8 pruebas entregadas |
| API propia de Tencent | Documenta un interruptor de moderación de contenido y códigos de rechazo para moderación fallida y palabras sensibles |
| Precio aquí | $0.024 por segundo a 480p, $0.048 a 720p; un clip de 5 segundos a 480p cuesta $0.12 |
| Para L4, en su lugar | Wan 2.6 Flash, Wan 2.5, Wan 3.0 o MiniMax H3 LoRA (tabla abajo) |
Lo que devolvieron 50 pruebas, nivel por nivel
Por debajo de L4 el modelo nunca suavizó, y en L4 nunca entregó. Cada nivel se corrió tres veces por endpoint para el puntaje, además de la pasada única del día del lanzamiento, así que la mayoría de las celdas reúnen cuatro pruebas. Todos los sujetos eran adultos, e imagen a video siempre partió de una foto con ropa.
| Nivel | Qué significa | Texto a video | Imagen a video | Veredicto |
|---|---|---|---|---|
| L1 Sugerente | Lencería, un tirante que se desliza | 4 de 4 | 4 de 4 | Entregado todas las veces |
| L2 Temas maduros | Atrevido, parcial | 4 de 4 | 4 de 4 | Entregado todas las veces |
| L3 Fuerte | Nivel completo, sujetos femeninos y masculinos | 5 de 5 | 5 de 5 | Entregado todas las veces |
| L4 Intenso | Una escena íntima entre dos adultos | 0 de 4 | 0 de 4 | Suavizado todas las veces |
| L5 Extremo, ataduras | Ataduras consentidas entre adultos | 4 de 4 | 3 de 4 | Casi siempre entregado |
| L5 Extremo, gore | Gore cinematográfico | 3 de 4 | 3 de 4 | Casi siempre entregado |
| Todos los niveles | 20 de 25 | 19 de 25 | 39 de 50, sin rechazos |
Cada número cuenta las pruebas que volvieron tal como se escribieron; todas las demás pruebas de esa celda se suavizaron. Cuatro pruebas por celda son una muestra, no una tasa, pero tres patrones se mantuvieron:
- No hay zona gris por debajo de L4. Las 26 pruebas de L1 a L3 se entregaron. Si tu trabajo vive en esa franja, el modelo no te sorprenderá.
- El punto débil es la escena L4, no "dos personas". La sonda de ataduras también tiene a dos adultos, y entregó 7 de 8. Lo que el modelo no dibuja es la propia escena íntima.
- Texto a video supera a imagen a video por una prueba. La diferencia entre 88.8 y 87.5 es una sola prueba de ataduras en imagen a video, donde aparecieron los accesorios pero la mujer siguió vestida.
Como contexto, 88.1 deja a HunyuanVideo 1.5 empatado en el puesto 22 de los 49 modelos de video que puntuamos en Freedom, a la par de Wan 2.2 LoRA; la tabla de clasificación sin censura tiene el orden actual, y nuestra reseña tiene la ficha completa de puntajes.
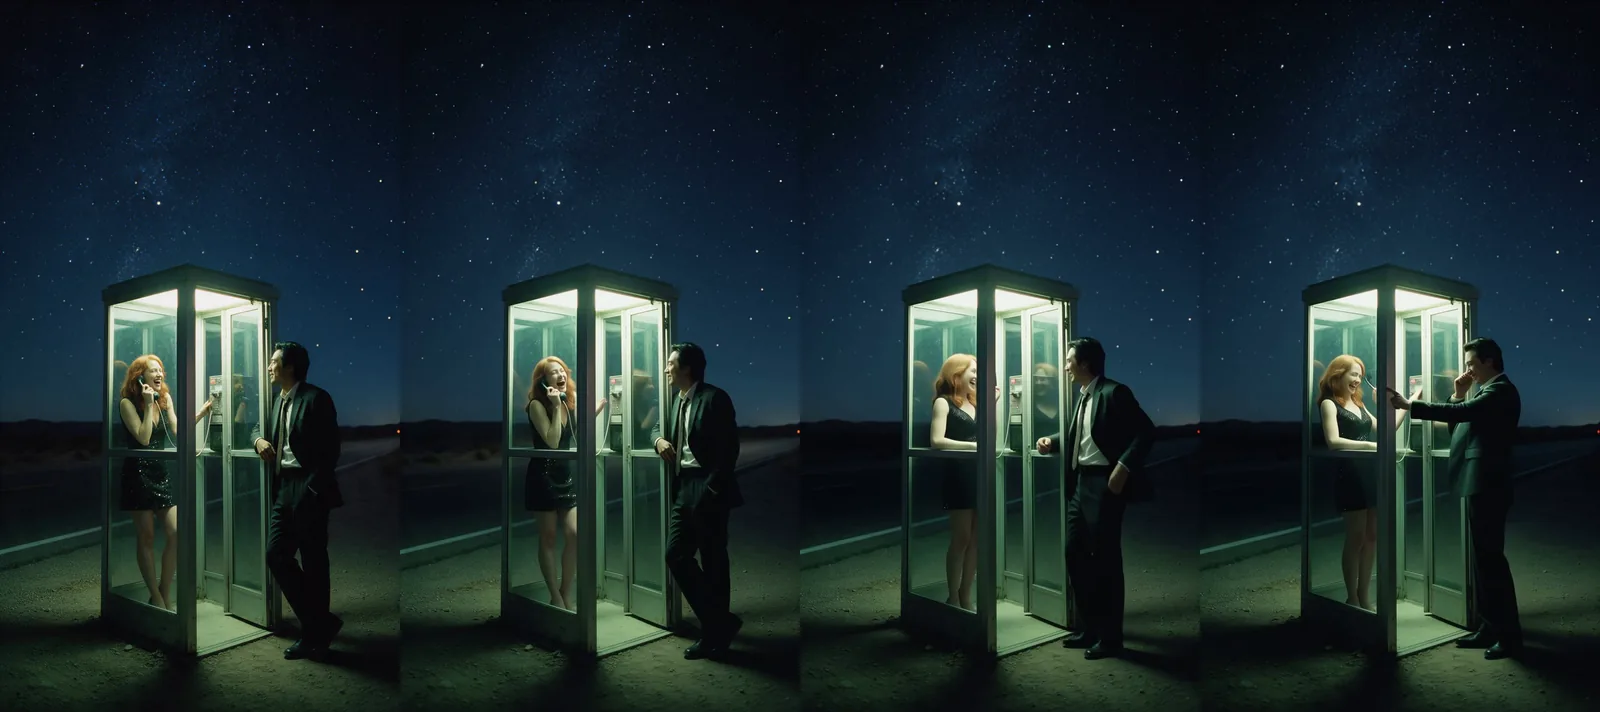
Dos adultos en un mismo cuadro no son el problema por sí solos. Separados, salen limpios. Escribimos un brindis a través de una piscina en una azotea en texto a video:
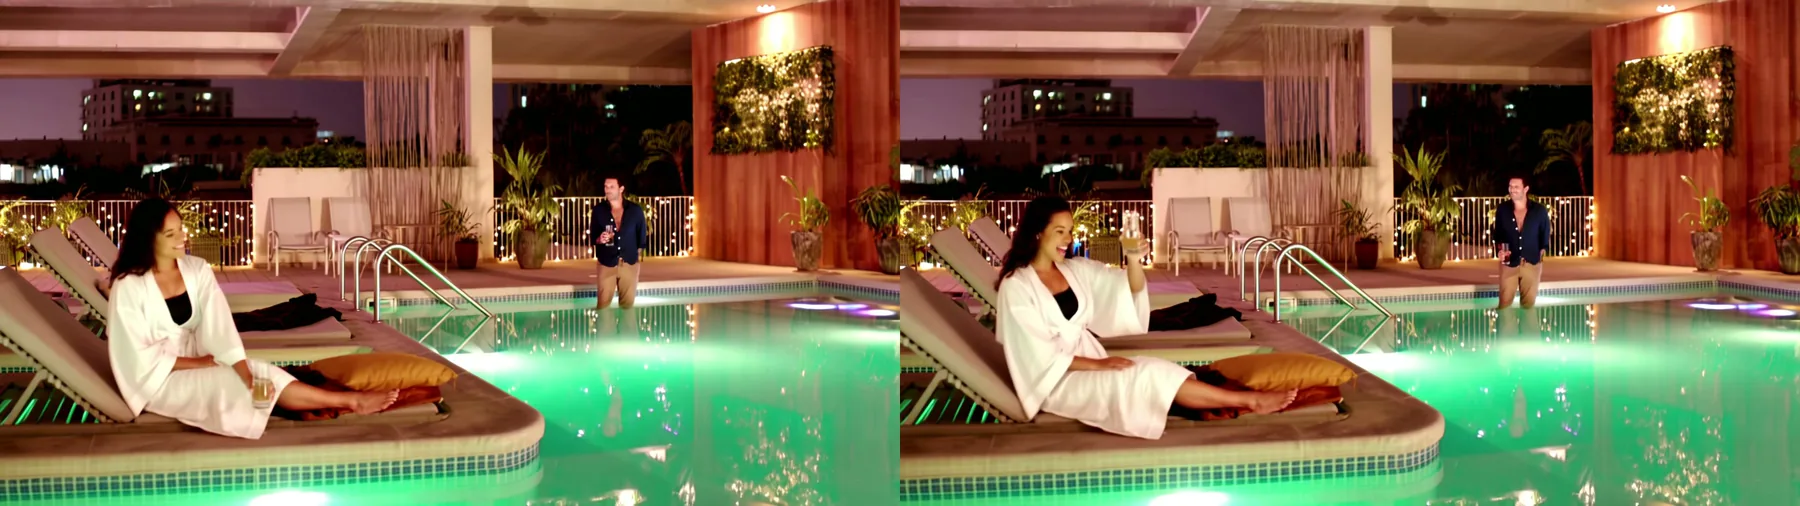
Night at a rooftop pool high above the city. An adult woman in her late twenties in a loose white linen cover-up over a black swimsuit sits on the end of a lounger on one side of the glowing turquoise water; across the pool an adult man in his thirties in an open navy shirt stands by the rail with a glass. He raises the glass to her, she laughs and lifts hers back. They stay on opposite sides of the pool. Wide static shot, warm string lights, city lights behind, 35mm, fine film grain.Lo mismo ocurrió en imagen a video en uno de los ejemplos publicados en la página del modelo, donde un hombre se apoya en una cabina telefónica mientras ella se ríe al teléfono:
Cómo se ve "suavizado" y cómo distinguirlo de un filtro
Un clip suavizado llega completo: el ambiente y el escenario son correctos, pero la escena que pediste no se dibuja. Eso es distinto de las dos cosas que la gente suele querer decir con "censurado", y en 50 pruebas solo vimos la variante suavizada.
| Qué llega | Qué significa | Visto en nuestras 50 pruebas | Qué hacer |
|---|---|---|---|
| Un error y ningún clip | Un filtro rechazó la solicitud | Nunca | Cambia de modelo o de host |
| Un clip con difuminado, cuadros negros o un recorte brusco | Un filtro editó la salida | Nunca | Cambia de modelo o de host |
| Un clip completo sin la escena pedida | El propio modelo se contuvo | 11 veces, 8 de ellas en L4 | Cambia de modelo para ese nivel |
| La escena correcta con un rostro equivocado, una posición equivocada o detalles ajenos | Un desliz de calidad, no censura | En nuestros ejemplos con ropa | Vuelve a generar o haz la acción más pequeña |
Esto es lo que mostraron nuestras pruebas suavizadas, en palabras llanas:
- L4 en texto a video: dos figuras se enredan en una cama y la escena en sí nunca se forma. En una prueba el encuadre se mantuvo bajo y la dejó fuera de cuadro.
- L4 en imagen a video: en tres pruebas el clip pasó de la foto a una cama y ninguna segunda persona entró en el cuadro. En la cuarta apareció un hombre, pero ella conservó su vestido lencero puesto.
- L5 gore, una prueba por endpoint: una figura se desploma en un charco de sangre, sin que se dibuje ninguna herida.
- L5 ataduras, una prueba de imagen a video: los accesorios aparecieron en la habitación, ella siguió vestida y la atadura recayó en la persona equivocada.
Un clip suavizado es un clip terminado, así que se factura por segundo como cualquier otro. Si piensas repetir una solicitud L4, presupuéstalo: en nuestras pruebas todos los intentos L4 volvieron suavizados.
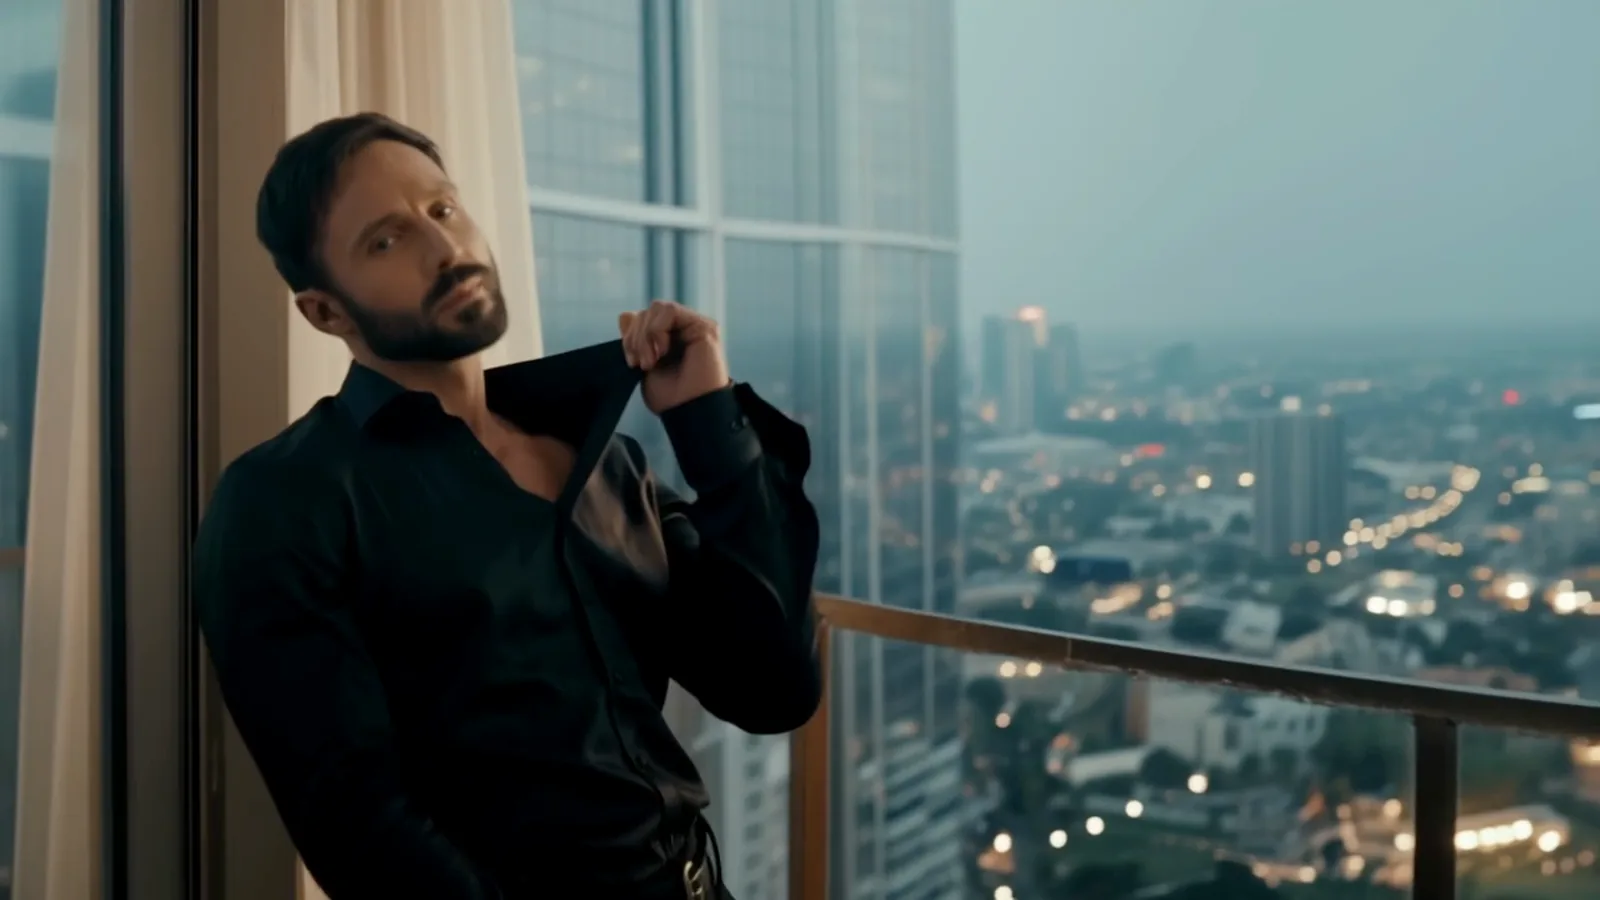
La última fila importa porque un desliz de calidad puede parecer un rechazo. Le pedimos a un hombre en imagen a video que se abriera la camisa y se echara el pelo hacia atrás con ambas manos. La camisa se abrió como se escribió, y en el último segundo su pelo corto le había crecido hasta los hombros:
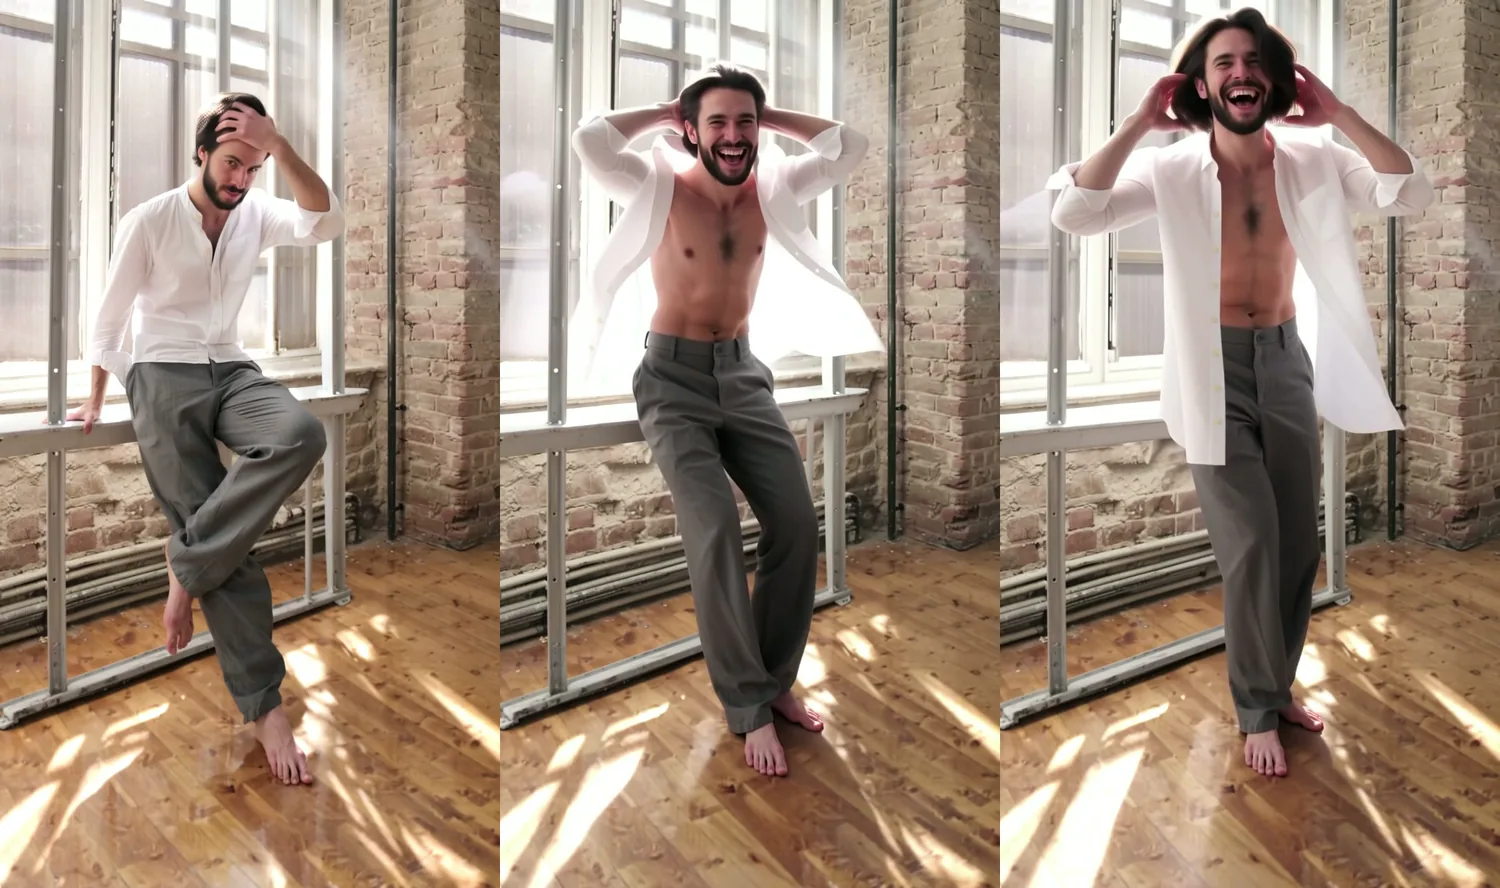
He undoes the top buttons of his linen shirt and lets it fall open, pushes his hair back with both hands and laughs at the camera. The light and the room stay the same. Static camera.Ahí no se contuvo nada; el clip llegó exactamente tan lejos como pedía el prompt. Un movimiento grande con ambas manos cerca del rostro lo alejó del fotograma inicial, mientras que acciones más pequeñas, como un sorbo o secarse la frente, conservaron el rostro de la foto en las pruebas de la galería del modelo.
¿Por qué se contiene el modelo en L4? El informe técnico de HunyuanVideo 1.5 de Tencent describe el filtrado de sus clips de entrenamiento por calidad, como cortes de escena, subtítulos, logotipos y marcas de agua, y no dice nada sobre contenido para adultos en ningún sentido. No podemos ver los datos de entrenamiento, así que no especularemos sobre el porqué. Lo que sí podemos decir es dónde ocurre la contención: dentro del modelo, después de aceptada la solicitud, porque el clip siempre llega.
Los pesos abiertos frente a los canales propios de Tencent
"HunyuanVideo no tiene censura" es una afirmación sobre los pesos y sobre los hosts que no ponen ningún filtro delante. El servicio propio de Tencent funciona con otras reglas. La fama data de diciembre de 2024, cuando un titular de Ars Technica llamó al primer HunyuanVideo "a new, uncensored AI video model". La gente lo ejecutó en sus propias GPU, a menudo con LoRA de la comunidad y codificadores de texto modificados. Tencent publica HunyuanVideo 1.5 en Hugging Face de la misma manera, y también lo vende como API alojada en Tencent Cloud.
| API propia de Tencent (Hy-Video-1.5) | Pesos abiertos en tu propia GPU | HunyuanVideo 1.5 en SpicyAPI | |
|---|---|---|---|
| Manejo del contenido | Un interruptor de moderación de contenido documentado; códigos de rechazo para moderación fallida y para una lista de palabras sensibles | Lo que haga tu propia configuración | Sin filtro de prompt ni de salida; 0 rechazos en 50 pruebas |
| Reglas de la cuenta | La política de Tencent Cloud excluye el contenido violento y todo lo "otherwise of a mature nature" | Tu máquina, tu responsabilidad | Las tuyas; ver la última sección |
| Duración del clip | 5 segundos fijos | A tu elección | 5 u 8 segundos |
| Resolución | 720p fija | 480p o 720p, más el escalador a 1080p aparte de Tencent | 480p o 720p |
| Formatos en texto a video | 16:9, 9:16, 1:1, 4:3, 3:4 | A tu elección | 16:9 o 9:16 |
| Extras | Reescritura de prompts, un campo para texto de marca de agua personalizado en la esquina | LoRA, codificadores de la comunidad | Prompt negativo; sin campo de LoRA |
| Hardware | Ninguno | Una GPU de consumo, según Tencent | Ninguno |
La primera columna proviene de la guía de la API Hy de Tencent Cloud, que lista el código 1300 para "failed content moderation or non-compliant input" y el 1301 para prompts que activan una lista de palabras sensibles, y de la política de uso aceptable de Tencent Cloud. No hemos llamado a la API de Tencent. Su guía no dice cuál es el valor por defecto del interruptor de moderación ni qué deja pasar, así que no afirmamos ninguna de las dos cosas. Lo que está claro es que la política que cubre la cuenta excluye el contenido maduro con el interruptor en cualquier posición.
Así que si lees que HunyuanVideo no tiene censura y luego pruebas el servicio propio de Tencent, espera otra respuesta. El veredicto de aquí aplica a la versión 1.5 en una ruta sin filtro delante; no probamos el modelo más grande de 2024.
Cómo se ve un clip entregado en L1
En el extremo sugerente, el modelo dibuja a la persona que describes, pero un solo gesto pequeño puede omitirse. Hicimos estos clips para este artículo, todos con ropa, a 720p y 5 segundos. Muestran tres cosas que conviene saber antes de planear un proyecto.
Texto a video omitió un gesto. Pedimos que un tirante se deslizara del hombro. Su mano fue hacia él, y se quedó arriba:
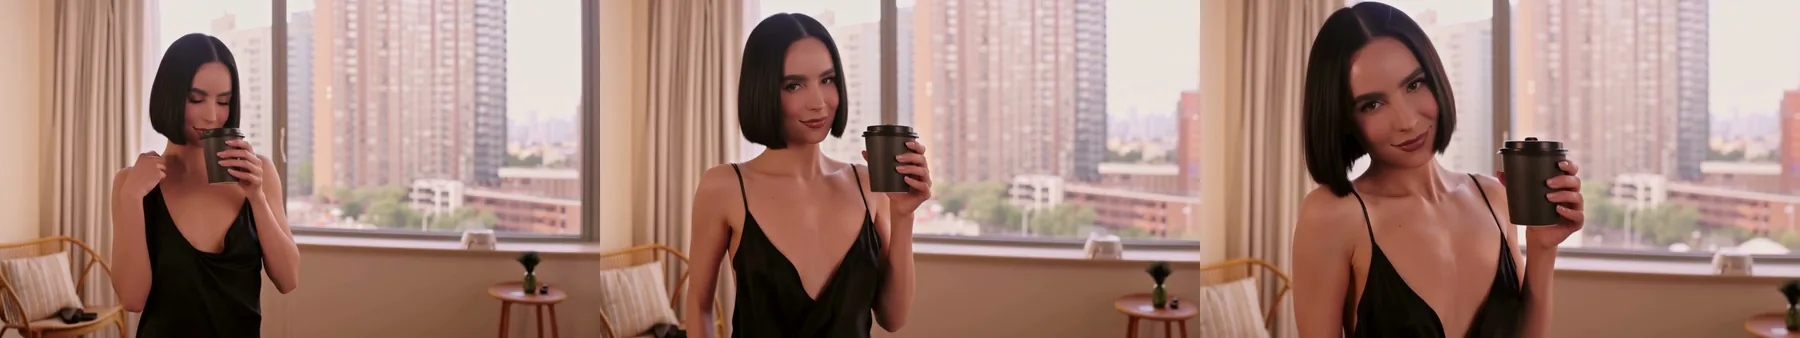
Early morning in a high-floor hotel room. An adult woman in her early thirties with a sleek dark bob, in a black silk slip dress, stands at the floor-to-ceiling window holding a coffee cup, the city soft in the haze outside. One thin strap slides off her shoulder; she glances down at it, leaves it where it fell, and turns her head to the camera with a slow, knowing smile. Soft window light from the left, slow push-in, 50mm, warm neutral grade, fine film grain.Prompt negativo: blurry, distorted hands, extra fingers, extra limbs, extra people, text, lettering, watermark, logo.
Un borrador a 480p es otro clip, no una vista previa. Corrimos el mismo prompt y seed a 480p para ver si un borrador barato predice la toma a 720p. Dio otra mujer, otra habitación y otra vista:
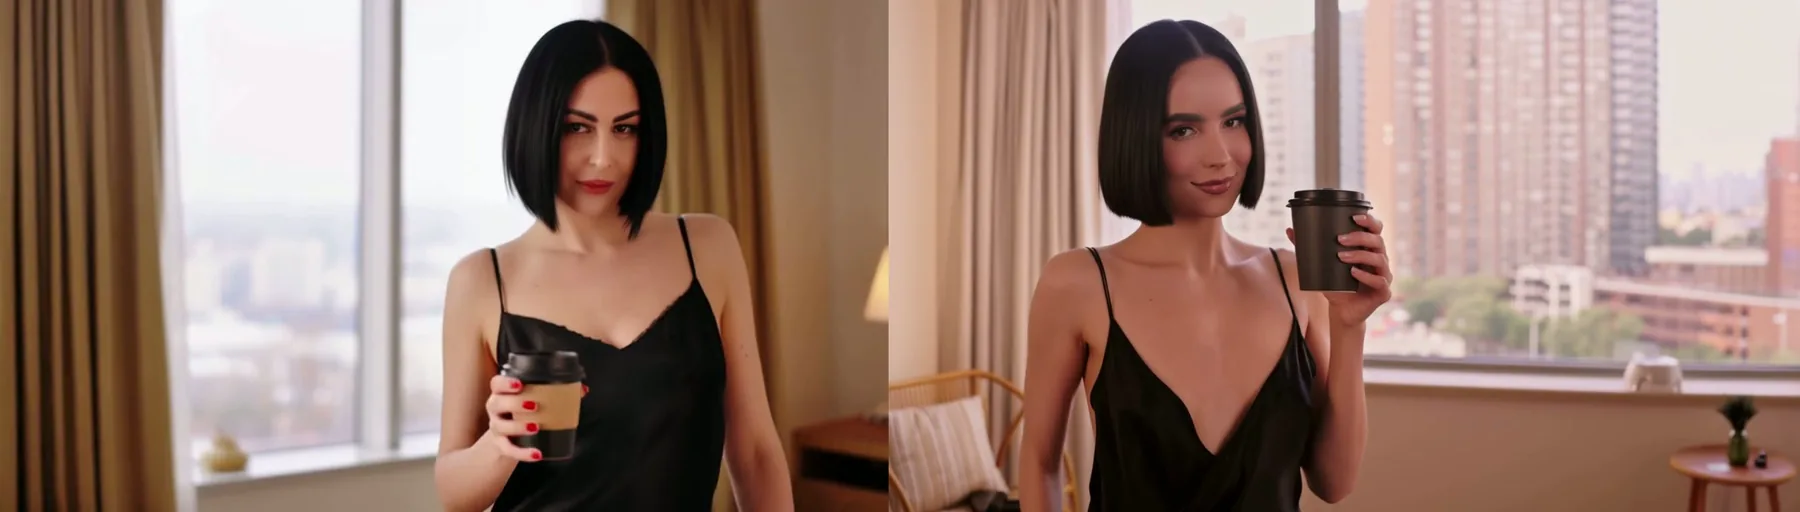
Tencent publica transformers separados para 480p y 720p. Sea cual sea la causa, usa 480p para comprobar que un prompt funciona en absoluto, y luego espera elegir tu toma a 720p entre ejecuciones nuevas.
Imagen a video logró el gesto. Tomamos el primer fotograma del clip a 720p de arriba como foto y volvimos a pedirlo. Esta vez el tirante se deslizó y se quedó abajo, y su rostro se mantuvo fiel a la foto:
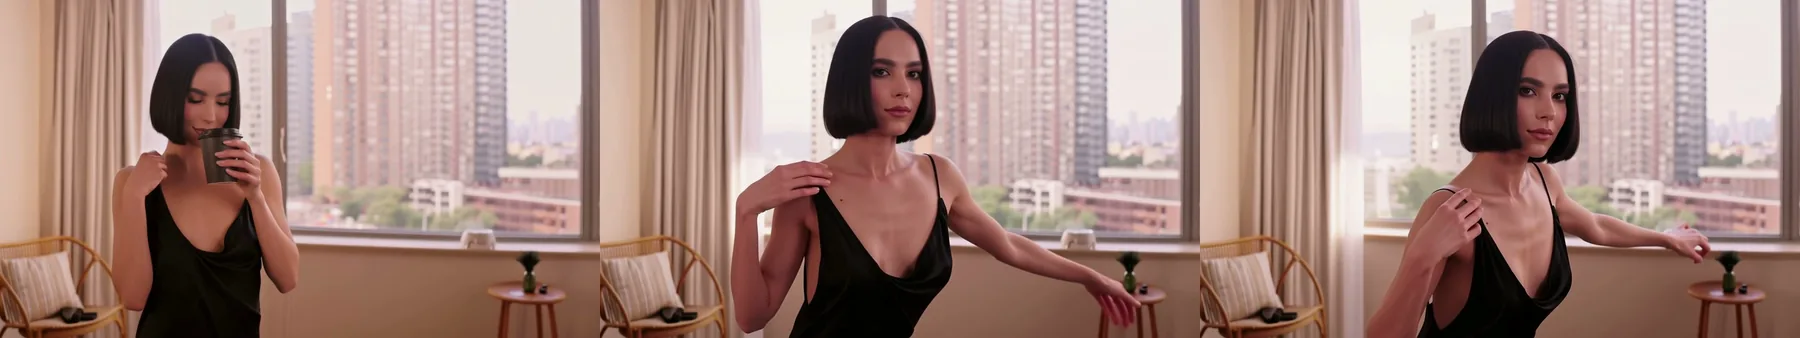
She lowers the cup, lets one thin strap slip off her shoulder and leaves it there, then leans her shoulder against the window frame and holds a slow, knowing look at the camera. Static camera.En los dos pares que corrimos, un momento que texto a video omitió se cumplió cuando partimos de una foto y describimos solo ese momento. El sujeto masculino hizo lo mismo: en texto a video su camisa volvió casi abotonada aunque escribimos "worn open", y la prueba de imagen a video que se mostró antes la abrió.
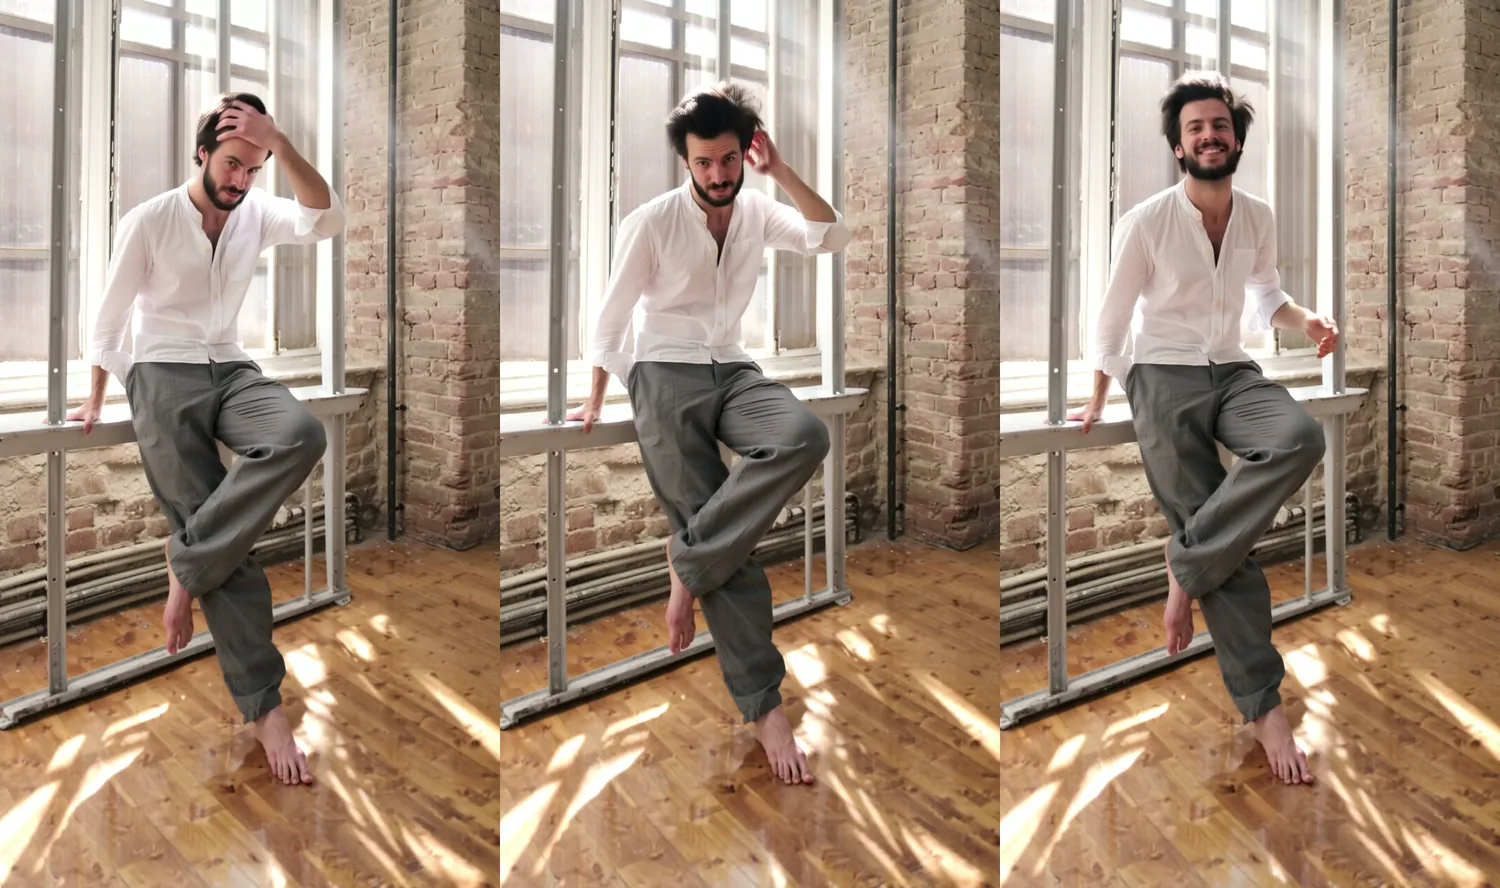
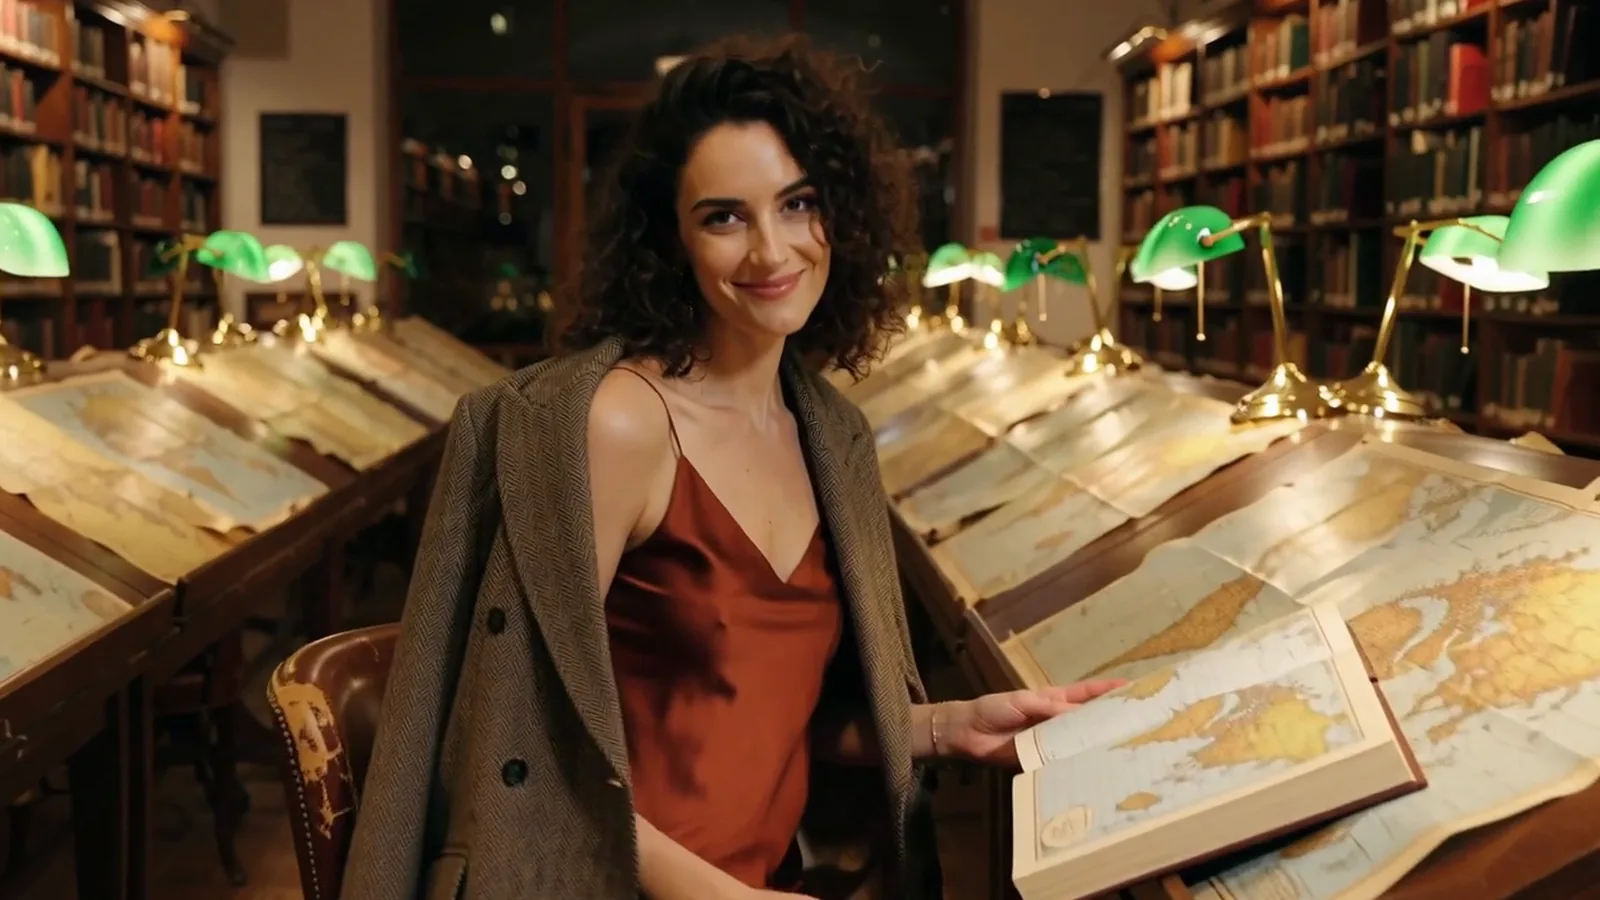
Late afternoon in a sunlit converted loft with exposed brick walls. An adult man in his mid-thirties with a short beard and tousled dark hair leans against a steel-framed window in a white linen shirt worn open over loose grey trousers, barefoot on the wooden floor. He runs one hand back through his hair, looks straight into the camera and lets a slow, lazy smile spread. Warm low sun through the window, dust drifting in the light, vertical medium shot, 85mm, fine film grain.El movimiento escrito dentro de la escena salió bien. En este ejemplo publicado, el viento del prompt mueve la seda y su pelo:
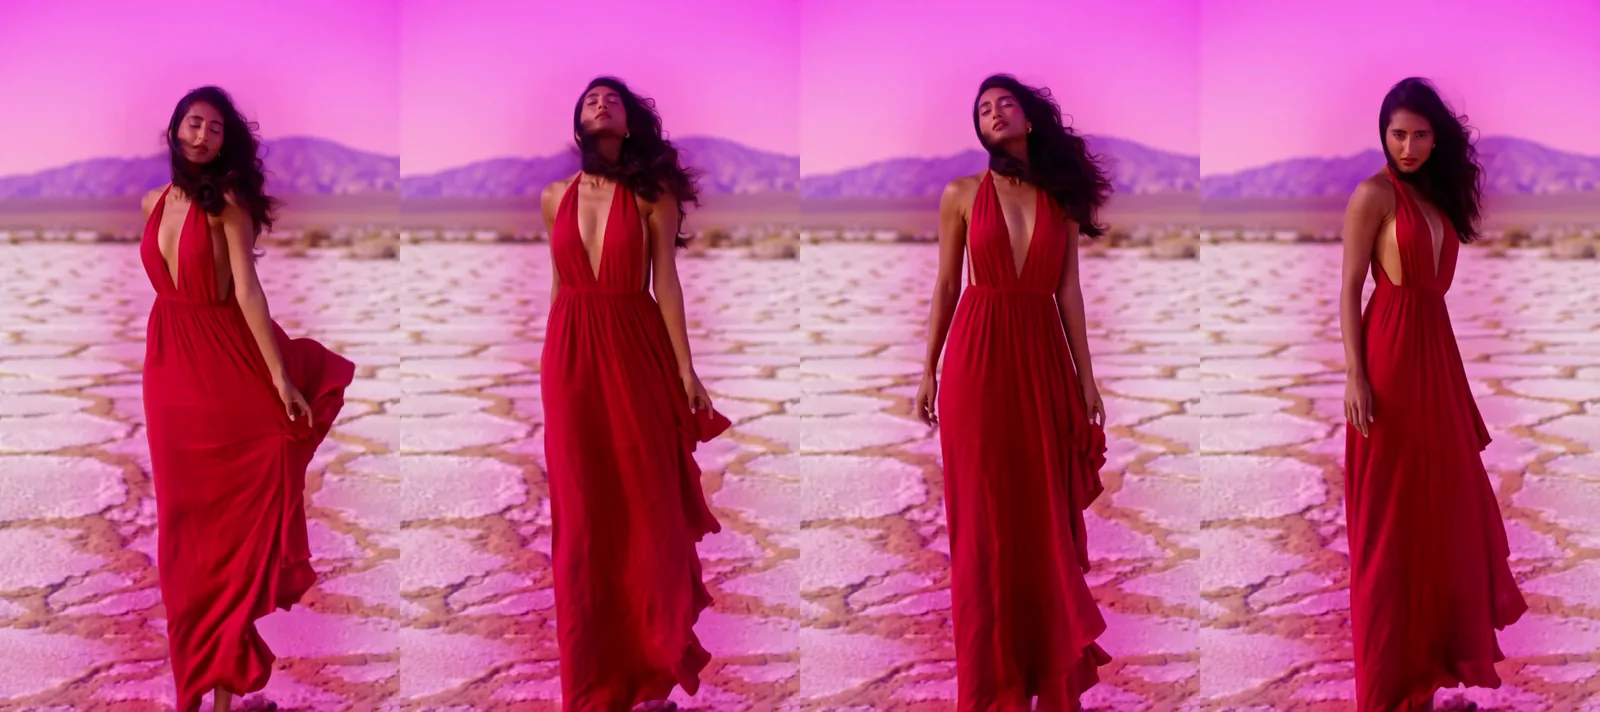
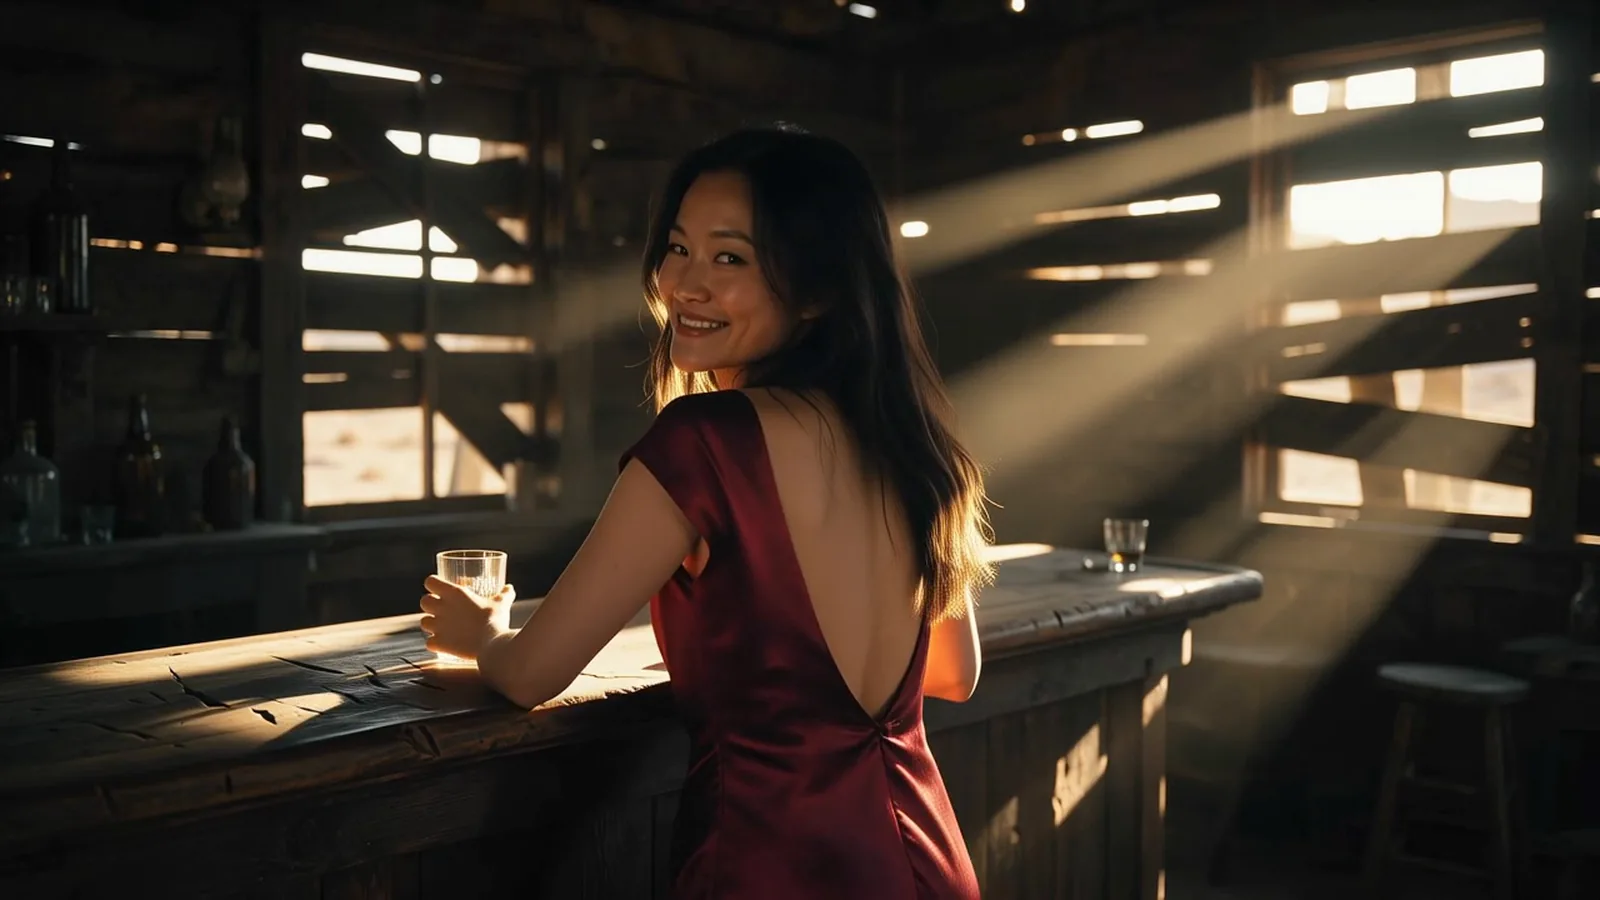
Dusk on a cracked white salt pan in the high desert, the sky magenta over violet mountains. An adult South Asian woman in her late twenties with long black hair stands alone in a rust-red silk halter dress with an open back. A hot gust sweeps across the flats, whipping the dress and her hair sideways; she turns her face into the wind, closes her eyes for a breath, then looks over her shoulder straight into the camera with a slow, smouldering look. Vertical medium shot from waist height, 85mm, magenta-and-amber grade, fine film grain, salt dust drifting.Cuando un nivel se suaviza: qué usar en su lugar
Si tu proyecto necesita L4, cambia de modelo: las ocho pruebas L4 en ambos endpoints se suavizaron. Los cuatro modelos de abajo entregaron L4 en nuestras pruebas de puntaje y no agregan ningún filtro de contenido propio. Elige según dónde empieza tu clip y si necesitas sonido.
| Si necesitas | HunyuanVideo 1.5 | Usa en su lugar | Por qué |
|---|---|---|---|
| L1 a L3, un sujeto, sin sonido, lo más barato | 26 de 26 entregados | Quédate en HunyuanVideo 1.5 | $0.12 por 5 segundos a 480p |
| L4, partiendo de una foto | 0 de 4 | Wan 2.6 Flash | L4 3 de 3; solo imagen a video; 5, 10 o 15 segundos; sin banda sonora generada |
| L4, partiendo de texto, con sonido | 0 de 4 | Wan 2.5 | L4 6 de 6; texto e imagen a video; 5 o 10 segundos con sonido |
| L4 y ambas sondas L5, clips largos | 0 de 8 en L4 | Wan 3.0 | L4 9 de 9, cada sonda L5 9 de 9; de 2 a 30 segundos con audio |
| L4 con tus propias LoRA | Sin campo de LoRA | MiniMax H3 LoRA | L4 11 de 13; hasta tres LoRA; de 3 a 15 segundos con sonido estéreo |
Y los puntajes lado a lado. Freedom y la prueba a ciegas están ambos sobre 100; la prueba a ciegas es nuestra propia valoración de la calidad de salida con los nombres de los modelos ocultos. Los precios vienen de nuestro catálogo en vivo, a la resolución más baja que ofrece cada modelo.
| Modelo | Freedom Score | L4 entregado | Prueba a ciegas | Sonido | Desde, por segundo |
|---|---|---|---|---|---|
| HunyuanVideo 1.5 | 88.1 | 0 de 8 | 57.7 | No | $0.024 (480p) |
| Wan 2.6 Flash | 100 | 3 de 3 | 69.2 | No | $0.0225 (720p) |
| Wan 2.5 | 99 | 6 de 6 | 64.1 | Sí | $0.045 (480p) |
| Wan 3.0 | 96 | 9 de 9 | 70.9 | Sí | $0.045 (480p) |
| MiniMax H3 LoRA | 98.3 | 11 de 13 | 68.7 | Sí | $0.05 (480p) |
| LTX-2 19B | 76.1 | 0 de 8 | 47.5 | Sí | $0.0144 (480p) |
Dos cosas destacan. Wan 2.6 Flash cuesta menos por segundo a 720p que HunyuanVideo a 480p, así que si tu clip parte de una foto es el primer modelo que probar para L4. Y LTX-2 19B es la forma barata de conseguir sonido, pero no una forma de pasar L4: también se suavizó ahí.
Los análisis más largos son nuestra prueba de las versiones sin censura de Wan y nuestra prueba de MiniMax H3, y el resumen de modelos de video sin censura los clasifica a todos.
Dónde HunyuanVideo 1.5 sigue ganándose su lugar
Aparte de LTX-2 19B, es la opción de texto a video más barata de esa tabla, entregó todas las pruebas de L1 a L3 así que un lote en esa franja no fallará por contenido, y acepta un prompt negativo en texto a video. Su puntaje en la prueba a ciegas es el más bajo de la tabla después de LTX-2 19B, así que si importa más el clip más bonito que el precio, Wan 3.0 o MiniMax H3 LoRA son la opción más fuerte a más o menos el doble del precio por segundo, con sonido incluido.
Antes de usarlo
Sin filtro de contenido, nadie revisa tus prompts por ti. Todas las personas de un prompt, una foto o un clip deben ser adultas. No representes a una persona real e identificable sin su consentimiento; esa es la preocupación que acompañó al primer HunyuanVideo cuando se propagaron LoRA de famosos hechas por la comunidad. Asegúrate de tener los derechos de cualquier foto que animes, y mantén tus resultados dentro de la ley allí donde los publiques.
Preguntas frecuentes
¿HunyuanVideo no tiene censura?
Sí, en SpicyAPI. En 50 pruebas del 5 de octubre de 2026, HunyuanVideo 1.5 no rechazó ni difuminó nada, y las 26 pruebas de L1 a L3 volvieron tal como se escribieron. La escena L4 de dos adultos se suavizó en las 8 pruebas, y 3 de 16 pruebas de L5 se suavizaron. Su Freedom Score es 88.1 sobre 100.
¿El servicio propio de Hunyuan de Tencent permite video NSFW?
No según sus reglas. La API Hy-Video-1.5 de Tencent Cloud documenta un interruptor de moderación de contenido y códigos de rechazo para moderación fallida y palabras sensibles, y la política de uso aceptable de Tencent Cloud excluye el contenido de naturaleza madura. El comportamiento sin censura que describe la gente proviene de los pesos abiertos y de los hosts que no agregan filtro.
¿Un prompt distinto puede llevar a HunyuanVideo más allá de L4?
No en nuestras pruebas: los ocho intentos en texto a video e imagen a video volvieron suavizados, y cada clip suavizado se factura como cualquier otro. Para L4, cambia a Wan 2.6 Flash si partes de una foto, o a Wan 2.5, Wan 3.0 o MiniMax H3 LoRA si partes de texto.
¿HunyuanVideo 1.5 es el mismo modelo que el HunyuanVideo original?
No. El original de diciembre de 2024 tiene unos 13 mil millones de parámetros y se ganó la fama de no tener censura en GPU domésticas. HunyuanVideo 1.5, de noviembre de 2025, es un modelo más pequeño de 8.3 mil millones de parámetros, hecho para correr en GPU de consumo. Todo lo medido en esta página es la versión 1.5.
¿HunyuanVideo es gratis?
Tencent publica los pesos en Hugging Face, así que ejecutarlo por tu cuenta cuesta tu propio tiempo de GPU y configuración. A través de nuestra API no hay nada que instalar. Pagas por segundo de salida: $0.024 a 480p y $0.048 a 720p, o sea $0.12 por un clip de 5 segundos a 480p.
¿Qué tan preciso es HunyuanVideo?
Bueno con una persona, más débil en los detalles. Obtuvo 57.7 sobre 100 en nuestra prueba a ciegas de salida, puesto 36 de 49 modelos de video. Los deslices que vimos fueron gestos pequeños omitidos en texto a video, personas ubicadas en un lugar distinto del que puso el prompt, y rostros o pelo que se desviaban tras movimientos grandes en imagen a video.
¿HunyuanVideo 1.5 o Wan 2.2?
En rango de contenido, HunyuanVideo 1.5 sobre el Wan 2.2 base: el Wan 2.2 base rechazó algunas de nuestras pruebas y obtuvo 43.1 en Freedom, mientras que HunyuanVideo no rechazó ninguna. Wan 2.2 LoRA empata con HunyuanVideo en 88.1 y entregó L4 en 2 de 7 pruebas. Elígelo si quieres cargar tus propias LoRA.
Pruébalo
Abre texto a video de HunyuanVideo 1.5 con el prompt del salar, configúralo en 9:16 y corre unos cuantos seeds a 480p para comprobar el prompt antes de elegir una toma a 720p. La estimación en vivo de la página muestra el costo antes de enviar.