HunyuanVideo 1.5 sigue mejor un prompt cuando se lee como una lista de planos: un adulto, lo que lleva puesto, dos o tres acciones pequeñas en orden, un movimiento de cámara y la luz. En 50 pruebas de contenido para adultos del 5 de octubre de 2026, todas las solicitudes de L1 a L3 volvieron tal como se escribieron (26 de 26), mientras que las 8 escenas íntimas entre dos adultos volvieron suavizadas, así que ahí es donde reescribir deja de rendir. En imagen a video, el fotograma inicial hace la mayor parte del trabajo: las acciones pequeñas conservaron el rostro de la foto, y pedir un lugar nuevo lo reemplazó.
La escala de contenido completa, los tamaños, las velocidades y la comparación con LTX-2 están en nuestra prueba NSFW de HunyuanVideo 1.5. Esta guía trata del prompt: qué redacción sigue el modelo y cuál ignora, con clips lado a lado que corrimos para esta guía. Todos los prompts que se imprimen aquí son escenas con adultos vestidos en el extremo sugerente, y puedes correrlos desde la página de la familia HunyuanVideo 1.5.
De un vistazo
| Prompts para HunyuanVideo 1.5, según nuestras pruebas | |
|---|---|
| Forma de prompt que funcionó | Sujeto, vestuario, dos o tres acciones en orden, un movimiento de cámara, luz y aspecto |
| Adjetivos de ambiente ("sultry", "seductive") | Una mirada posada y poco movimiento, en los dos seeds de prueba |
| L1 a L3 | 26 de 26 entregados, en ambos endpoints |
| L4, dos adultos | 0 de 8 entregados: todos suavizados, ninguno rechazado |
| L5 | Ataduras: 7 de 8 entregados; gore cinematográfico: 6 de 8 |
| Prompt negativo | Solo en texto a video. Reduce artefactos, nunca es una garantía |
| Prompt de imagen a video | Opcional. Describe el momento siguiente en el mismo lugar |
| Ajustes | 480p o 720p, 5 u 8 segundos, sin sonido; 16:9 o 9:16 en texto a video; imagen a video conserva la forma de la foto |
| Precio | $0.024 por segundo a 480p, $0.048 a 720p ($0.12 por un borrador de 5 segundos) |
Los cinco espacios que lee HunyuanVideo 1.5
El manual de prompts de HunyuanVideo 1.5 de Tencent arma un prompt de texto a video con sujeto, movimiento y escena, y con plano, cámara, iluminación, estilo y atmósfera como extras. Pide que las acciones vayan en orden temporal ("first… then… finally") y que las emociones se escriban como pequeños detalles físicos. Para clips orientados a adultos dividimos el sujeto en dos, porque la línea de vestuario es donde vive el nivel de la escena.
| Espacio | Qué escribir | Nuestro ejemplo |
|---|---|---|
| 1. Sujeto | Un adulto: rango de edad, pelo, un detalle distintivo | Una mujer adulta de unos treinta y pocos años |
| 2. Vestuario | Prenda, tela, color y su estado | con un vestido lencero de satén negro |
| 3. Acciones | Dos o tres acciones pequeñas con "first", "then", "finally" | se acomoda un tirante en el hombro, mira hacia atrás a la cámara, sonríe |
| 4. Cámara | Un movimiento: avance, órbita, fija, en mano | Avance lento |
| 5. Luz y aspecto | La fuente de luz, más una etiqueta de estilo corta | luz cálida de lámpara, cinematic, photorealistic |
El lugar va entre el sujeto y la acción. El prompt completo:
An adult woman in her early thirties in a black satin slip dress stands by the window of a dim hotel room at night, city lights behind her. First she slides one strap back onto her shoulder, then she glances over her shoulder at the camera, and finally she lets a slow, knowing smile break. Slow push-in, warm lamp light, cinematic, photorealistic.Abre este prompt en texto a video de HunyuanVideo 1.5 →
Tres hábitos marcaron la mayor diferencia en nuestras pruebas:
- Un adulto por clip, salvo que la escena necesite dos.
- Nombra la habitación por lo que hay en ella. En los dos clips de dos personas con el seed 62001 (ver abajo), "hotel bar" volvió como una habitación de hotel con una cama. Si el lugar importa, enumera la barra, los taburetes y las botellas.
- Mantén fija la línea del sujeto mientras iteras. Cambiar una sola frase redibuja a toda la persona, incluso con el mismo seed.
Palabras de ambiente o detalles de acción
Los prompts para adultos tienden a acumular palabras de ambiente. Corrimos el prompt de arriba contra el mismo prompt con la frase de acción reemplazada por "She is sultry, seductive and sensual, radiating desire." Mismo seed, mismo prompt negativo, 480p, 5 segundos, dos seeds cada uno.
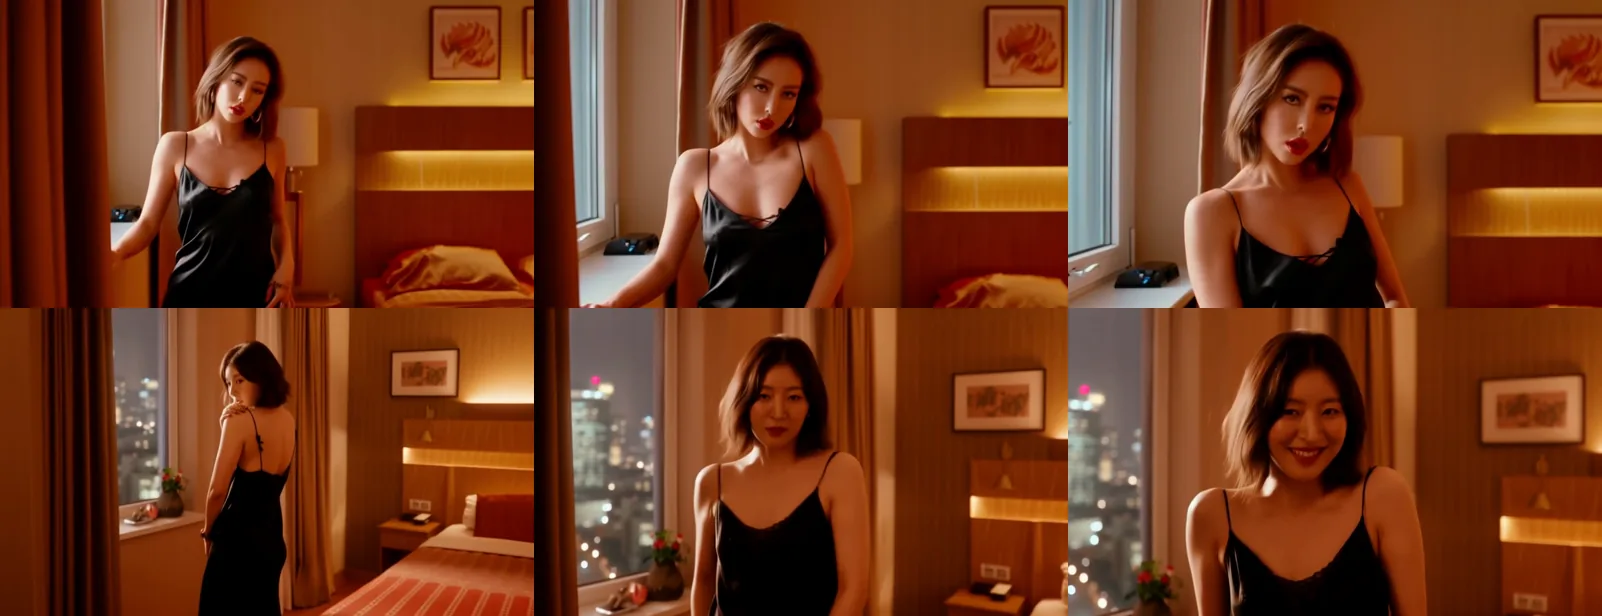
Texto a video, 480p, seed 61002, inicio, medio y final de cada clip. Arriba: el prompt con palabras de ambiente. Abajo: el prompt con acciones. El seed 61001 se comportó igual.
Los adjetivos produjeron una pose de sesión de moda: labios entreabiertos, una mirada fija, una mano inmóvil y el avance de cámara haciendo todo el movimiento. En este seed también desapareció la ciudad nocturna detrás de ella. La versión con acciones recorrió los tres momentos en ambos seeds y terminó en la sonrisa, aunque los dos primeros se fundieron (ya miraba hacia atrás cuando su mano fue al tirante). Es el costo habitual de tres acciones en cinco segundos.
La regla: escribe lo que el espectador debe ver que ocurre, no cómo debe sentirse. "A slow, knowing smile" hace el trabajo de "seductive", y el modelo puede dibujarla.
Elige gestos que el modelo conoce
El prompt detrás de la portada de esta guía le pedía a un hombre en un balcón de hotel que "loosen one cuff", luego sostuviera la mirada a la cámara y después sonriera a medias. En ambos seeds el puño nunca se movió: un hombre se abrió el cuello de la camisa, y el otro apoyó una mano en el cuello y la barbilla. La mirada llegó las dos veces.
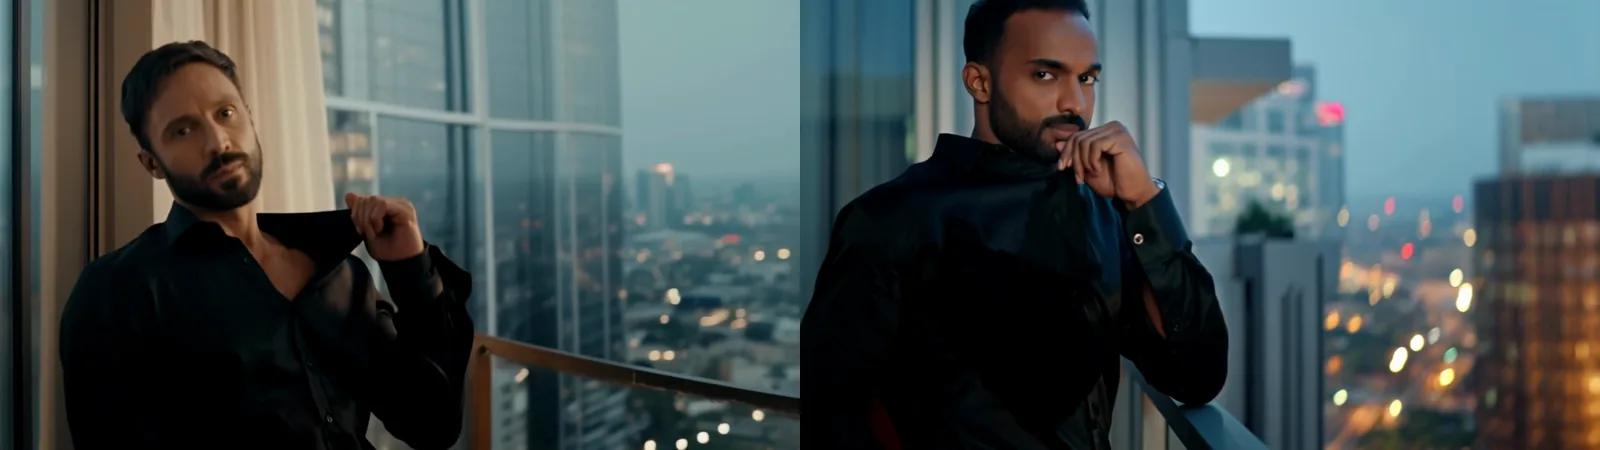
Texto a video, 720p, el mismo prompt con los seeds 64001 (izquierda) y 64002 (derecha). El prompt pedía que se aflojara un puño.
Los gestos pequeños poco comunes se cambian por otros conocidos. Si un gesto importa, elige uno que el modelo haya visto claramente muchas veces (una mano por el pelo, un tirante que se desliza, un cuello que se acomoda) y compruébalo primero en un borrador a 480p.
Hasta dónde llegar, nivel por nivel
Nada de nuestro lado filtra el prompt, la foto ni el resultado. Lo que cambia entre niveles es cómo responde el propio modelo, y eso decide si vale la pena pagar otra reescritura. Estas cifras suman ambos endpoints a lo largo de 50 pruebas del 5 de octubre de 2026, a 480p y 5 segundos, con todos los sujetos adultos. No imprimimos prompts por encima de L1.
| Nivel | Qué significa | Entregado | Para tu prompt |
|---|---|---|---|
| L1 Sugerente | Lencería, un tirante que se desliza | 8 de 8 | Nombra la prenda y lo único que le pasa |
| L2 Temas maduros | Contenido parcial | 8 de 8 | Los mismos cinco espacios; la línea de vestuario y una acción llevan el nivel |
| L3 Fuerte | Contenido fuerte | 10 de 10 | Igual; una persona, una acción |
| L4 Intenso | Una escena íntima entre dos adultos | 0 de 8 | Suavizado todas las veces. No gastes reintentos aquí |
| L5 Extremo | Ataduras consentidas entre adultos, o gore cinematográfico | 7 de 8 y 6 de 8 | Los fallos conservaron los accesorios o la sangre pero omitieron parte de la escena |
Ninguna prueba fue rechazada ni difuminada. En L4, texto a video dio dos figuras enredadas o recortadas sobre una cama sin dibujar la escena en las cuatro pruebas, e imagen a video cortó del fotograma inicial a una nueva toma de dormitorio sin nadie más (las tres sondas de nuestra segunda ronda). No vimos rechazo ni difuminado, así que esto parece contención del propio modelo, no un filtro. El techo práctico para trabajo con adultos es un adulto por clip, donde todas las pruebas de L1 a L3 salieron bien. La reseña de HunyuanVideo 1.5 fija su Freedom Score en 88.1.
Dos adultos en un clip: un punto de contacto
Dos personas en contacto cercano son el punto débil de este modelo. Escribimos un mismo momento de dos formas: un abrazo completo ("They wrap their arms around each other and sway pressed close together, her face buried in his neck") y un único punto de contacto con espacio entre ellos:
An adult couple in their thirties in a dim hotel bar at night, she in a dark green satin dress on the left, he in a white shirt with rolled sleeves on the right. They stand a hand's width apart; her palm rests flat on his chest and his hand rests at her waist. She leans in until her forehead touches his, then they both smile. Warm amber light, slow push-in, cinematic, photorealistic.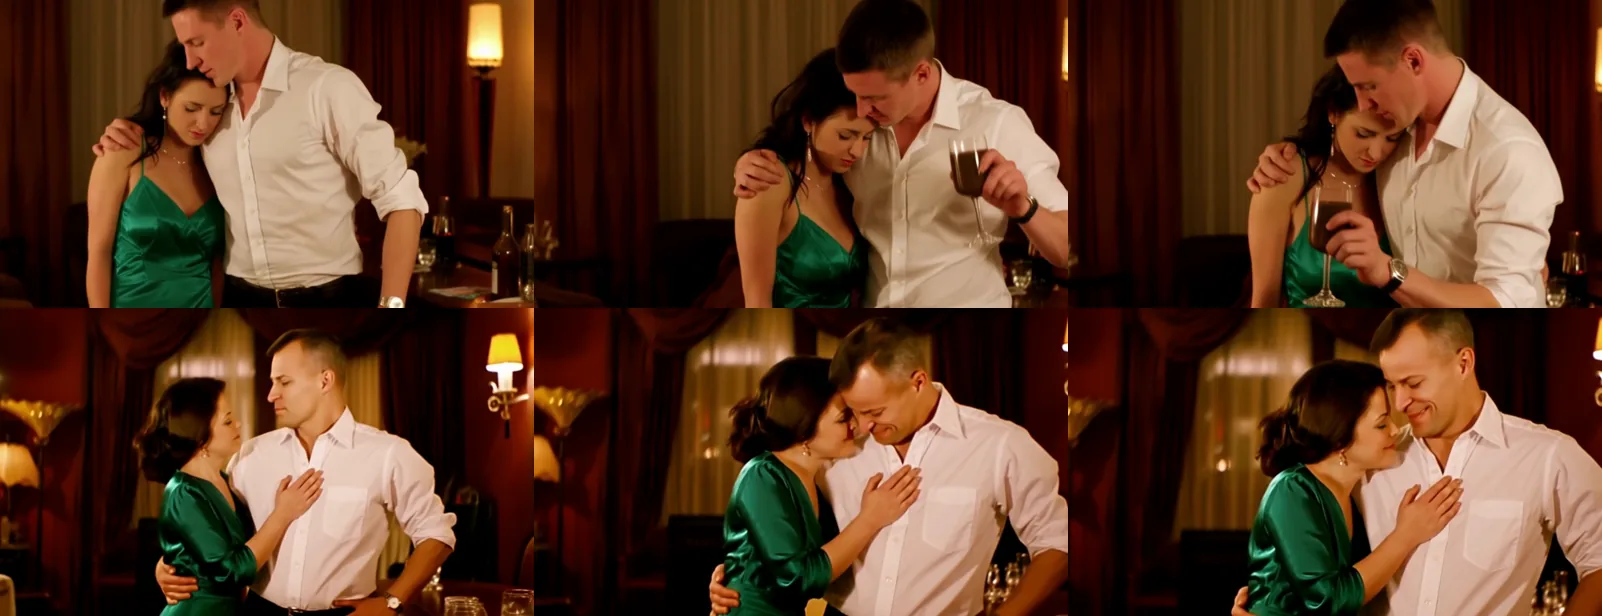
Texto a video, 480p, seed 62002. Arriba: el prompt del abrazo completo. Abajo: el prompt del punto de contacto.
El abrazo nunca ocurrió como se escribió. En este seed se volvió un abrazo de lado mientras él bebía de una copa que nadie pidió; en el otro, sus manos se desdibujaron juntas en el hombro de ella. La versión de un punto de contacto cumplió todos los momentos en ambos seeds: palma en el pecho, mano en la cintura, frentes juntas, dos sonrisas. Izquierda y derecha se respetaron en un seed y se invirtieron en el otro, así que trata las posiciones como una pista.
Para dos personas: da a cada una un atuendo distinto, describe uno o dos puntos de contacto y el espacio entre ellas, y termina con un gesto facial.
El prompt negativo: para qué sirve
Texto a video acepta un negative_prompt; imagen a video no. El código del propio publicador lo deja vacío por defecto y su manual no lo menciona, así que trátalo como una lista de lo que nunca quieres en cuadro. Nuestra lista base:
blurry, distorted hands, extra fingers, extra limbs, text, watermarkLo que detuvo y lo que no en nuestras pruebas de ejemplo del 5 de octubre:
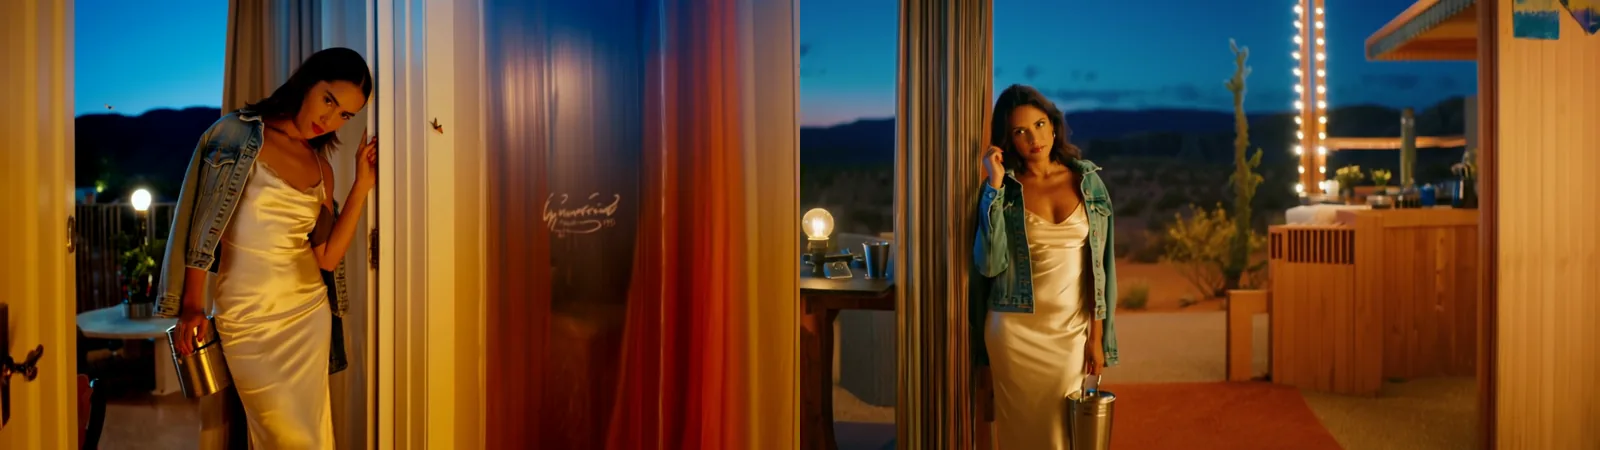
Texto a video, 720p, el mismo prompt y prompt negativo (que incluye "text, lettering, logo") en dos seeds. El clip de la izquierda aun así dibujó letras en la cortina.
Ese prompt también decía "no signs or lettering anywhere". HunyuanVideo 1.5 está hecho para renderizar texto (su manual lo muestra escribiendo palabras entre comillas en las escenas), y en nuestras pruebas inventó letras en cortinas, placas de matrícula e insignias de autos. El prompt negativo baja las probabilidades; un seed nuevo es el reintento más barato para lo que se cuela.
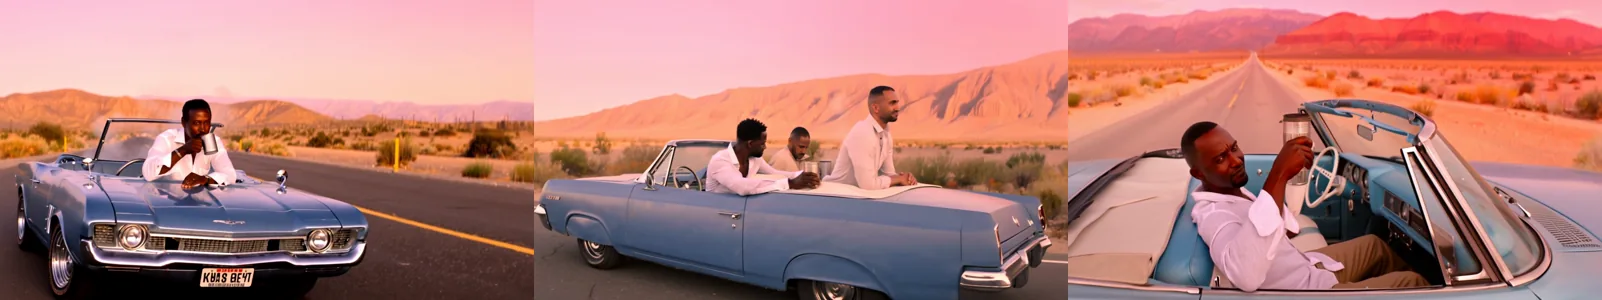
Texto a video, 720p, tres versiones de una misma toma. Izquierda: "no number plate, no lettering" en el prompt, sin prompt negativo. Centro: un prompt negativo sin "extra people". Derecha: se agregó "extra people" y la cámara se acercó.
Dos lecciones. El prompt negativo solo cubre lo que nombras: el clip del centro pidió un hombre y dio tres, y agregar "extra people" lo corrigió. Y el encuadre corrige más que la lista: los planos abiertos le dieron al modelo espacio para inventar placas, insignias y pasajeros, mientras que el primer plano dejó solo una pequeña marca cromada en el primer segundo. En escenas para adultos, vigila igual los espejos, pósteres y pantallas del fondo.
Imagen a video: el fotograma inicial hace el trabajo pesado
En el endpoint de imagen a video, la foto fija el rostro, el vestuario, la luz, la forma del encuadre y el nivel inicial de la escena. El prompt solo dice qué pasa después, en el orden del publicador: movimiento del sujeto, movimiento de la escena, cámara. Es opcional, y no hay campo de prompt negativo.
Le dimos a un mismo fotograma inicial dos prompts, dos seeds cada uno: uno que se queda en la foto y otro que sale de ella. El fotograma es una imagen fija 3:4 hecha con el modelo de imagen Jib Mix Qwen, una forma común de preparar un personaje antes de animarlo.
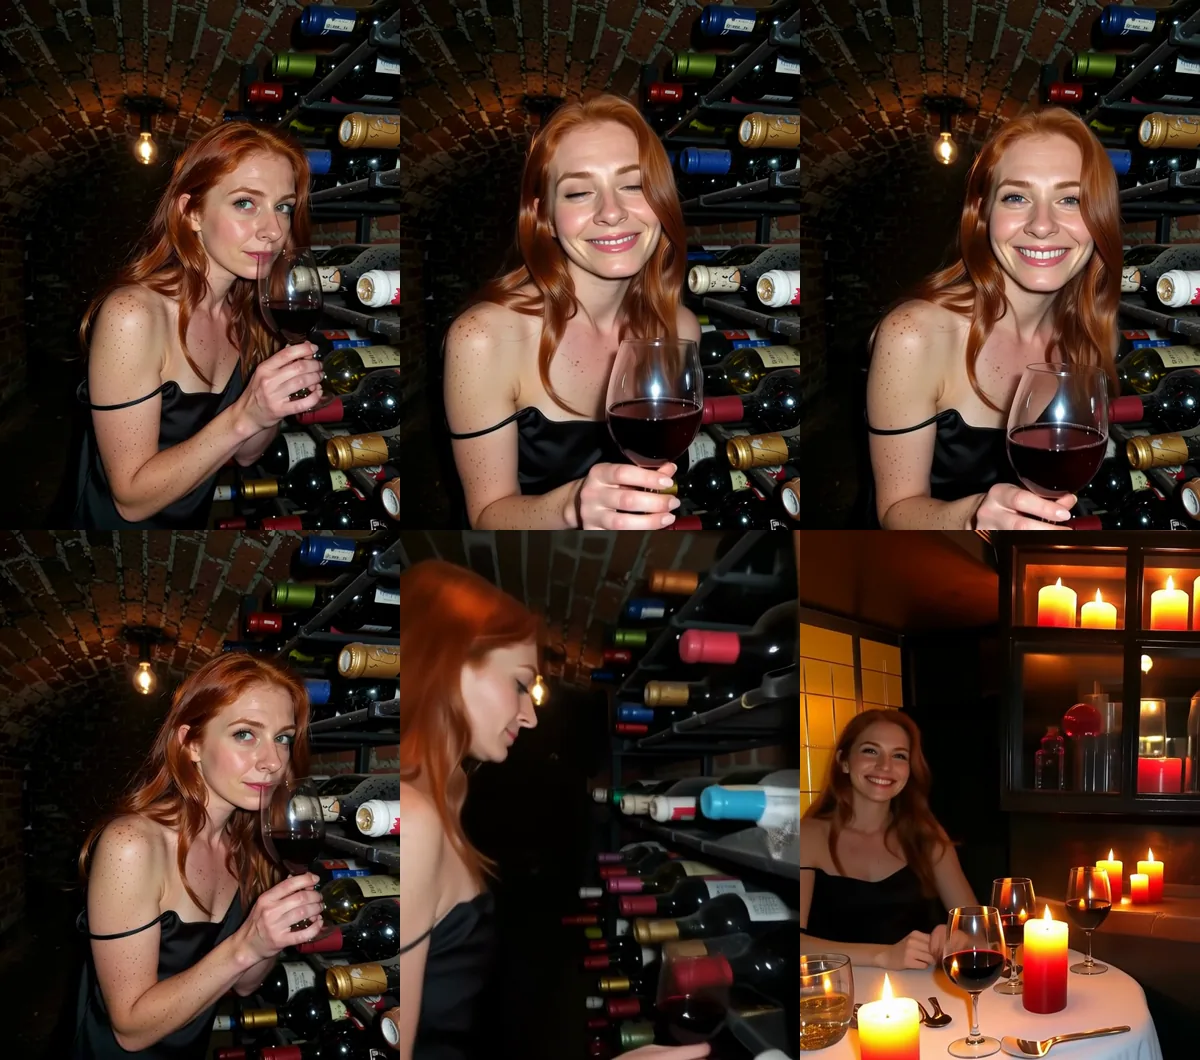
Imagen a video, 480p, seed 63001; el clip volvió en 544 x 720. Arriba: "She lowers the wine glass, turns her head toward the camera and holds the look, then lets a slow smile spread. The light bulb above her sways slightly. The camera holds still." Abajo: "She sets the wine glass down, walks up the cellar stairs into a candlelit restaurant upstairs, sits at a table by the window and smiles at the camera." El seed 63002 coincidió.
Quedarse en el sótano conservó su rostro, sus pecas y el tirante caído en ambos seeds. Salir cortó a una habitación nueva en ambos seeds, y después del corte el rostro, el vestido y el tirante cambiaron. Si la escena necesita un segundo lugar, haz un segundo fotograma inicial.
El tamaño del movimiento también importa, como sugieren dos de nuestras pruebas del 5 de octubre a 720p:
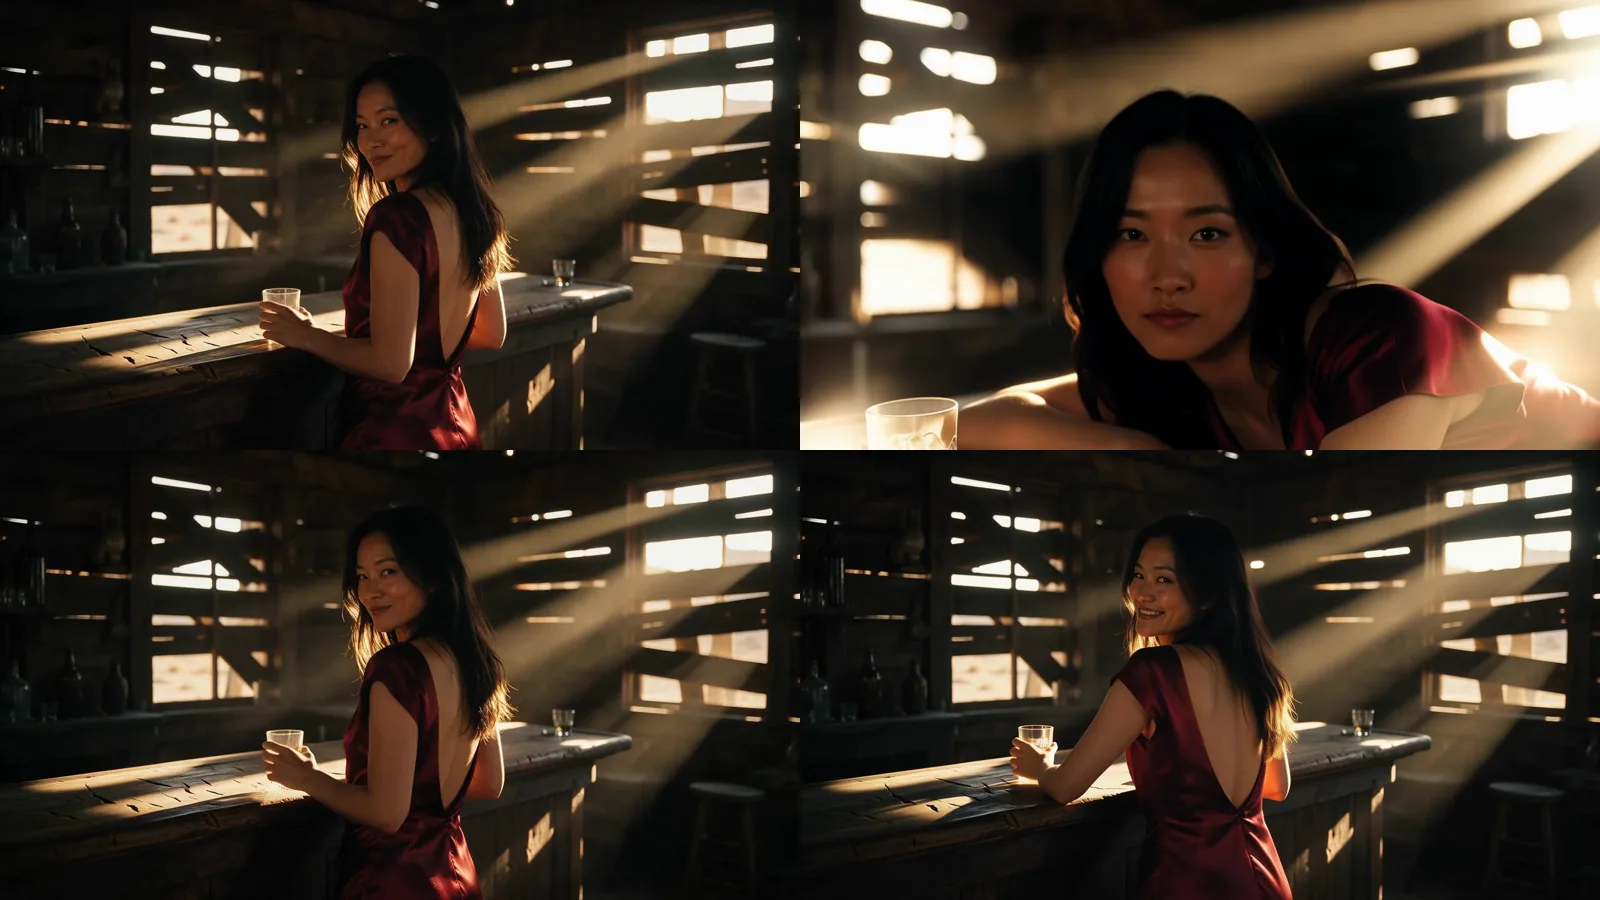
Imagen a video, un fotograma inicial, inicio y final de dos clips con seeds distintos. Arriba: "turns slowly to face the camera and leans back on her elbows", ligero avance de cámara. Abajo: "takes a slow sip… lets a slow, amused smile spread", cámara fija.
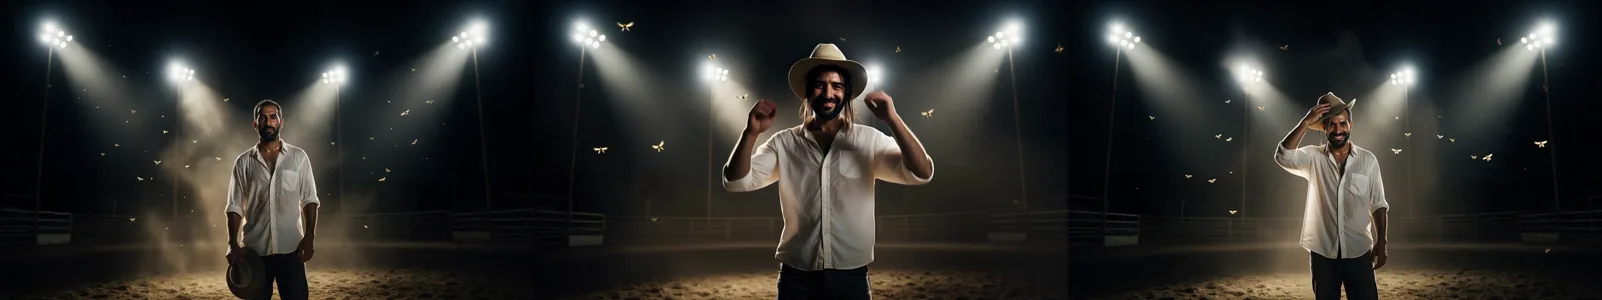
Imagen a video, un fotograma inicial. Centro: se le pidió sacudirse el polvo del sombrero, pasarse una mano por el pelo y ponerse el sombrero. Derecha: se le pidió solo secarse la frente; el modelo se puso el sombrero por su cuenta y el rostro se mantuvo.
En ambos fallos, las manos cruzaron el rostro o el rostro se acercó al lente más que en la foto, así que el modelo probablemente tuvo que redibujarlo, y dibujó a otra persona. Mantén las acciones pequeñas (un sorbo, una mirada, una sonrisa), la cámara fija o lenta, y limita a un solo gesto todo lo que cubra el rostro.
El fotograma inicial también fija el nivel de partida: con fotos vestidas, los prompts de nuestra escala llevaron a una sola figura hasta L3 conservando el rostro y la habitación, pero una escena de dos personas a partir de una foto de una persona nunca apareció.
Resolución, duración y formato
| Elección | Nuestra opción | Por qué |
|---|---|---|
| 480p o 720p | Borradores a 480p, 720p para la toma buena | La mitad del precio; 480p tardó de 39 a 73 segundos de tiempo del modelo en las pruebas de esta guía, 720p de dos a cuatro minutos |
| 5 u 8 segundos | 5, salvo que tengas cuatro o más acciones | Tres acciones llenaron 5 segundos; 8 segundos cuestan un 60% más |
| 16:9 o 9:16 | 9:16 para feeds de teléfono | Escribe el encuadre para la forma, por ejemplo "vertical medium shot from waist height" |
| Forma en imagen a video | Recorta primero la foto | El clip sigue la foto |
| Seed | Fijo mientras editas | El mismo seed no promete un clip idéntico |
Un borrador de 5 segundos a 480p cuesta $0.12, un final de 5 segundos a 720p $0.24 y un clip de 8 segundos a 720p $0.384, en cualquiera de los dos endpoints. Los clips no tienen sonido, así que planea el audio en la edición: cómo agregar voz y música a un video NSFW con IA.
Patrones que se desviaron y qué escribir en su lugar
| Patrón | Qué vimos | En su lugar |
|---|---|---|
| Adjetivos de ambiente | Mirada posada, detalles de la escena omitidos | Dos o tres acciones visibles |
| Abrazo completo entre dos adultos | Un abrazo de lado, manos desdibujadas, un objeto inventado | Uno o dos puntos de contacto |
| Un gesto poco común ("loosens one cuff") | Cambiado por una mano en el cuello de la camisa | Un gesto común |
| "No lettering" en el prompt principal | Una placa inventada | Prompt negativo y un encuadre más cerrado |
| Plano abierto con autos o letreros | Texto inventado y personas de más | Acerca la cámara |
| Pose reclinada de cuerpo entero | Un pie de más; se ignoró un primer plano pedido | Encuadra de la cintura para arriba |
| Imagen a video: un lugar nuevo o inclinarse hacia el lente | Un rostro nuevo | Un segundo fotograma inicial, movimientos pequeños |
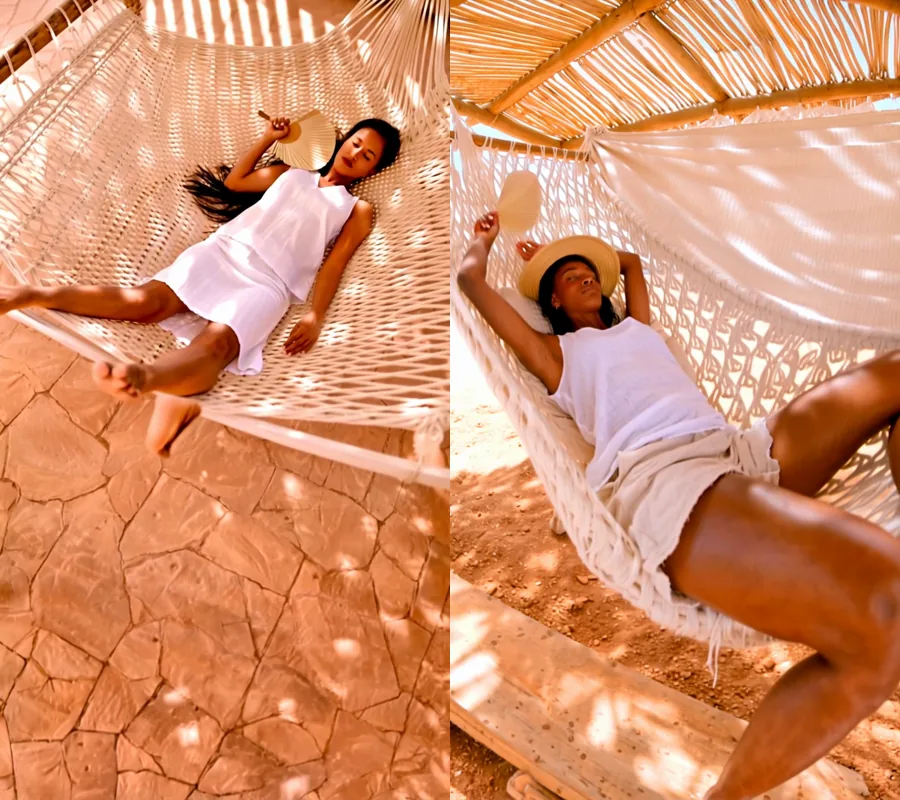
Texto a video, 720p, 9:16, dos tomas de un mismo plano reclinado de nuestras pruebas del 5 de octubre. El prompt de la derecha pedía su rostro y sus hombros en primer plano. No se cumplió en ninguna.
Lista de verificación del prompt
Antes de pagar una toma a 720p:
- La línea del sujeto dice "adult" y da un rango de edad; la línea de vestuario da prenda, tela, color y estado.
- Dos o tres acciones visibles en orden, con gestos comunes, sin adjetivos de ambiente que las reemplacen.
- Un movimiento de cámara, con un encuadre lo bastante cerrado para dejar fuera letreros, placas, pantallas y personas de más; el lugar descrito por sus objetos.
- Dos personas solo si hace falta: atuendos distintos, uno o dos puntos de contacto, un gesto facial para terminar.
- Texto a video: un prompt negativo corto que nombre tus problemas reales. Imagen a video: una foto recortada, la misma habitación, acciones pequeñas.
- Un borrador de 5 segundos a 480p con seed fijo, y luego 720p para la toma buena.
Si necesitas sonido con la imagen, LTX-2 19B agrega una pista de audio a cada clip, y nuestra guía de prompts para video con IA sin censura compara cómo se comporta un mismo prompt en distintos modelos.
Preguntas frecuentes
¿Cómo escribo prompts NSFW para HunyuanVideo 1.5?
Escribe una lista de planos: un adulto, el vestuario, dos o tres acciones pequeñas en orden, un movimiento de cámara, y luego la luz y una etiqueta de estilo corta. En nuestras 50 pruebas todas las solicitudes de L1 a L3 volvieron tal como se escribieron, mientras que las escenas íntimas de dos personas se suavizaron siempre, así que limita el trabajo con adultos a una persona por clip.
¿Cómo hago un prompt para convertir una imagen en video?
Usa el endpoint de imagen a video y describe solo lo que pasa después en el mismo lugar: una acción pequeña, un gesto facial y la cámara. La foto ya fija el rostro, el atuendo y la luz. Los prompts que enviaban a la persona a otro lugar cortaron a una toma nueva con otro rostro en ambos seeds.
¿Hunyuan tiene imagen a video?
Sí. HunyuanVideo 1.5 tiene un endpoint de texto a video y un endpoint de imagen a video. El clip de imagen a video conserva la forma de tu foto, y su prompt es opcional.
¿HunyuanVideo 1.5 usa un prompt negativo?
En texto a video, sí. Se aceptó en todas las pruebas en las que lo pasamos, y nombrar un problema concreto ("extra people") lo eliminó, pero las letras inventadas se colaron una vez. Imagen a video no tiene campo de prompt negativo.
¿Por qué mi clip de HunyuanVideo volvió atenuado?
Si era una escena íntima entre dos adultos, es el límite del propio modelo: las 8 pruebas a ese nivel volvieron suavizadas, sin rechazo. Si era un adulto, haz las acciones concretas; las palabras de ambiente nos dieron clips posados y estáticos que se leían como más tímidos.
¿Por qué mi clip de imagen a video va en cámara lenta?
No lo hemos medido nosotros. Cuando un usuario reportó cámara lenta en el seguimiento de incidencias de GitHub del publicador, los mantenedores aconsejaron describir acciones más rápidas en el prompt, por ejemplo "turns quickly and laughs" en lugar de "slowly turns".