HunyuanVideo 1.5 suit le mieux un prompt qui se lit comme un plan de tournage : un adulte, ce qu’il porte, deux ou trois petites actions dans l’ordre, un mouvement de caméra et la lumière. Sur 50 essais de contenu pour adultes le 5 octobre 2026, toutes les demandes de L1 à L3 sont revenues comme écrites (26 sur 26), alors que les 8 scènes intimes entre deux adultes sont toutes revenues atténuées : c’est là que reformuler ne rapporte plus rien. En image vers vidéo, l’image de départ fait l’essentiel du travail : de petites actions ont gardé le visage de la photo, et demander un nouveau lieu l’a remplacé.
L’échelle de contenu complète, les tailles, les vitesses et la comparaison avec LTX-2 figurent dans notre test NSFW de HunyuanVideo 1.5. Ce guide porte sur le prompt : les formulations que le modèle suit et celles qu’il ignore, avec des clips côte à côte réalisés pour ce guide. Chaque prompt reproduit ici est une scène avec des adultes habillés, du côté suggestif, et vous pouvez les lancer depuis la page de la famille HunyuanVideo 1.5.
En un coup d’œil
| Prompts pour HunyuanVideo 1.5, d’après nos essais | |
|---|---|
| Forme de prompt qui a marché | Sujet, garde-robe, deux ou trois actions dans l’ordre, un mouvement de caméra, lumière et rendu |
| Adjectifs d’ambiance (« sultry », « seductive ») | Un regard posé et peu de mouvement, sur les deux seeds testées |
| L1 à L3 | 26 sur 26 rendus, sur les deux points d’accès |
| L4, deux adultes | 0 sur 8 rendu : tout atténué, rien refusé |
| L5 | Contrainte : 7 sur 8 rendus, gore cinématographique : 6 sur 8 |
| Prompt négatif | Texte vers vidéo uniquement. Réduit les artefacts, jamais une garantie |
| Prompt en image vers vidéo | Facultatif. Décrivez l’instant suivant, au même endroit |
| Réglages | 480p ou 720p, 5 ou 8 secondes, muet ; 16:9 ou 9:16 en texte vers vidéo ; l’image vers vidéo garde la forme de la photo |
| Prix | 0,024 $ par seconde en 480p, 0,048 $ en 720p (0,12 $ pour un brouillon de 5 secondes) |
Les cinq emplacements que lit HunyuanVideo 1.5
Le guide de prompts de HunyuanVideo 1.5 de Tencent construit un prompt de texte vers vidéo à partir du sujet, du mouvement et du décor, avec en options le plan, la caméra, la lumière, le style et l’atmosphère. Il demande des actions dans l’ordre du temps (« first… then… finally ») et des émotions écrites sous forme de petits détails physiques. Pour des clips destinés aux adultes, nous scindons le sujet en deux, car c’est dans la ligne de garde-robe que se joue le niveau de la scène.
| Emplacement | Quoi écrire | Notre exemple |
|---|---|---|
| 1. Sujet | Un adulte : tranche d’âge, cheveux, un détail marquant | An adult woman in her early thirties |
| 2. Garde-robe | Vêtement, tissu, couleur et son état | in a black satin slip dress |
| 3. Actions | Deux ou trois petites actions avec « first », « then », « finally » | slides one strap back onto her shoulder, glances back at the camera, smiles |
| 4. Caméra | Un seul mouvement : travelling avant, orbite, fixe, caméra à l’épaule | Slow push-in |
| 5. Lumière et rendu | La source de lumière, plus une courte étiquette de style | warm lamp light, cinematic, photorealistic |
Le lieu se place entre le sujet et l’action. Le prompt complet :
An adult woman in her early thirties in a black satin slip dress stands by the window of a dim hotel room at night, city lights behind her. First she slides one strap back onto her shoulder, then she glances over her shoulder at the camera, and finally she lets a slow, knowing smile break. Slow push-in, warm lamp light, cinematic, photorealistic.Ouvrir ce prompt dans HunyuanVideo 1.5 texte vers vidéo →
Trois habitudes ont fait la plus grande différence dans nos essais :
- Un adulte par clip, sauf si la scène en demande deux.
- Nommez la pièce par ce qu’elle contient. Dans les deux clips à deux personnes sur la seed 62001 (voir plus bas), « hotel bar » est revenu en chambre d’hôtel avec un lit. Si le lieu compte, listez le comptoir, les tabourets et les bouteilles.
- Gardez la ligne du sujet identique pendant que vous itérez. Changer une seule phrase redessine toute la personne, même avec la même seed.
Mots d’ambiance ou détails d’action
Les prompts pour adultes ont tendance à empiler les mots d’ambiance. Nous avons lancé le prompt ci-dessus face au même prompt dont la phrase d’action était remplacée par « She is sultry, seductive and sensual, radiating desire. » Même seed, même prompt négatif, 480p, 5 secondes, deux seeds chacun.
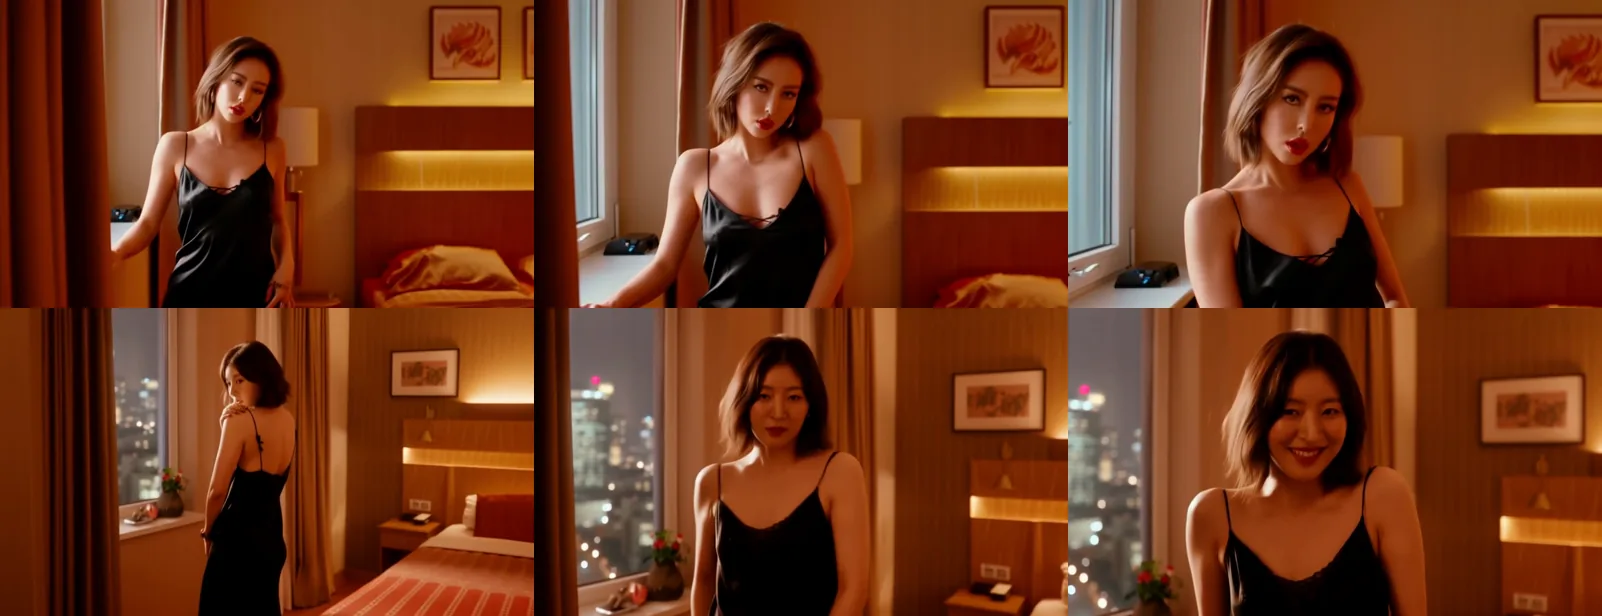
Texte vers vidéo, 480p, seed 61002, début, milieu et fin de chaque clip. En haut : le prompt aux mots d’ambiance. En bas : le prompt par actions. La seed 61001 s’est comportée de la même façon.
Les adjectifs ont produit une pose de shooting de mode : lèvres entrouvertes, regard fixe, une main immobile, et le travelling avant qui fait tout le mouvement. Sur cette seed, la ville nocturne derrière elle a aussi disparu. La version par actions a traversé les trois temps sur les deux seeds et s’est terminée sur le sourire, même si les deux premiers temps se sont confondus (elle regardait déjà en arrière quand sa main est allée vers la bretelle). C’est le coût habituel de trois actions en cinq secondes.
La règle : écrivez ce que le spectateur doit voir se produire, pas ce qu’il doit ressentir. « A slow, knowing smile » fait le travail de « seductive », et le modèle sait le dessiner.
Choisissez des gestes que le modèle connaît
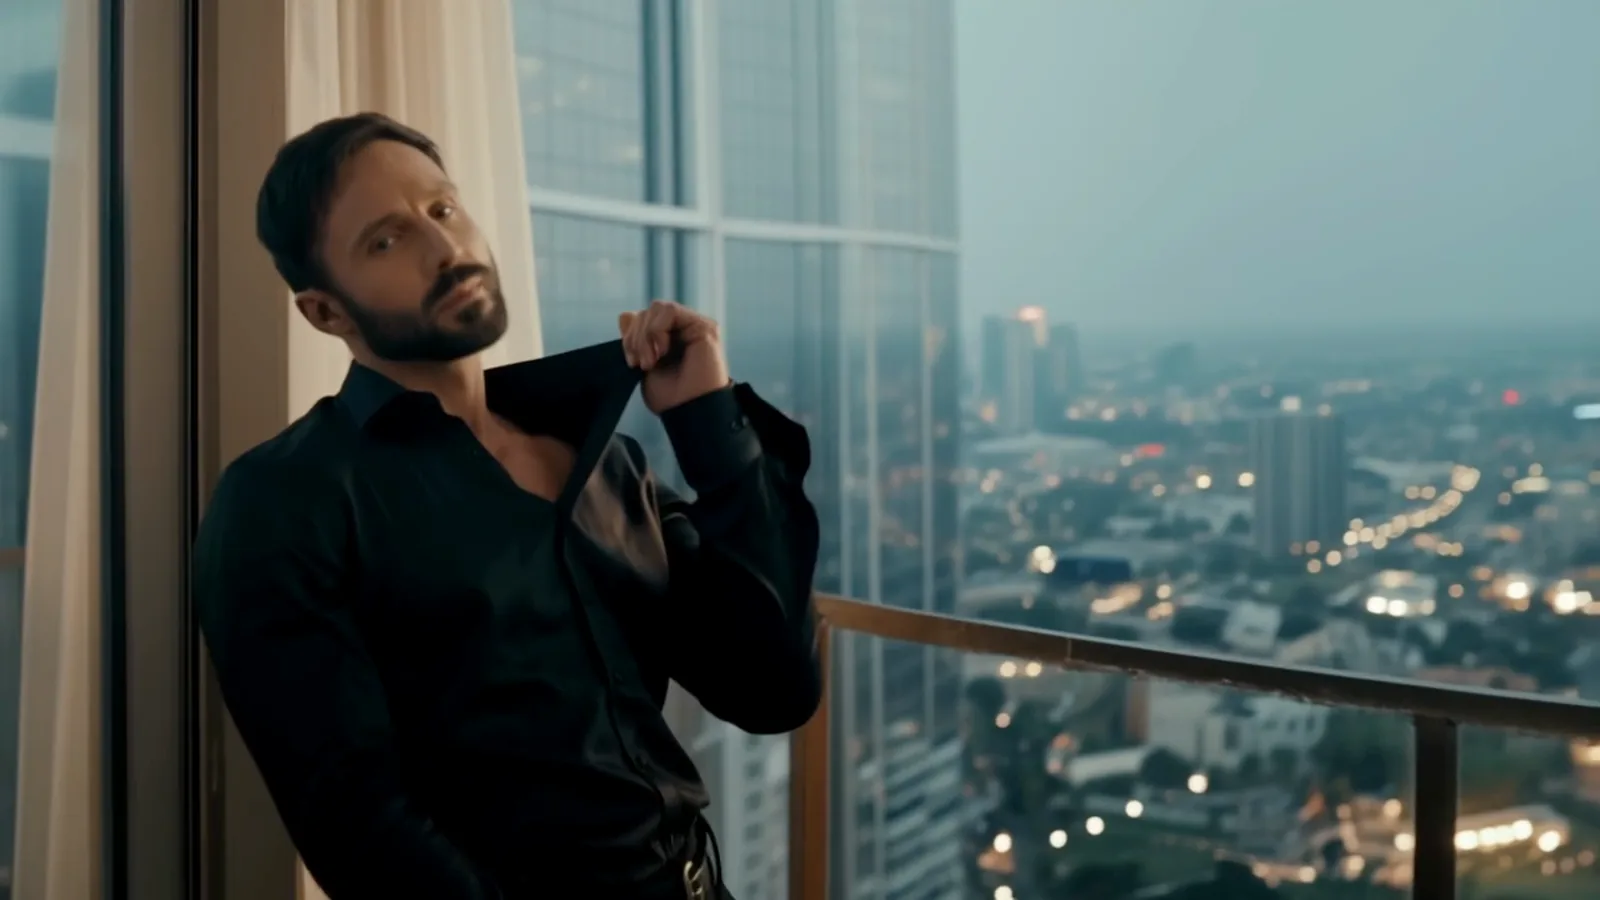
Le prompt derrière la couverture de ce guide demandait à un homme sur un balcon d’hôtel de « loosen one cuff », puis de tenir un regard vers la caméra, puis d’esquisser un demi-sourire. Sur les deux seeds, la manchette n’a jamais bougé : l’un des hommes a ouvert son col, l’autre a posé une main sur son col et son menton. Le regard est passé les deux fois.
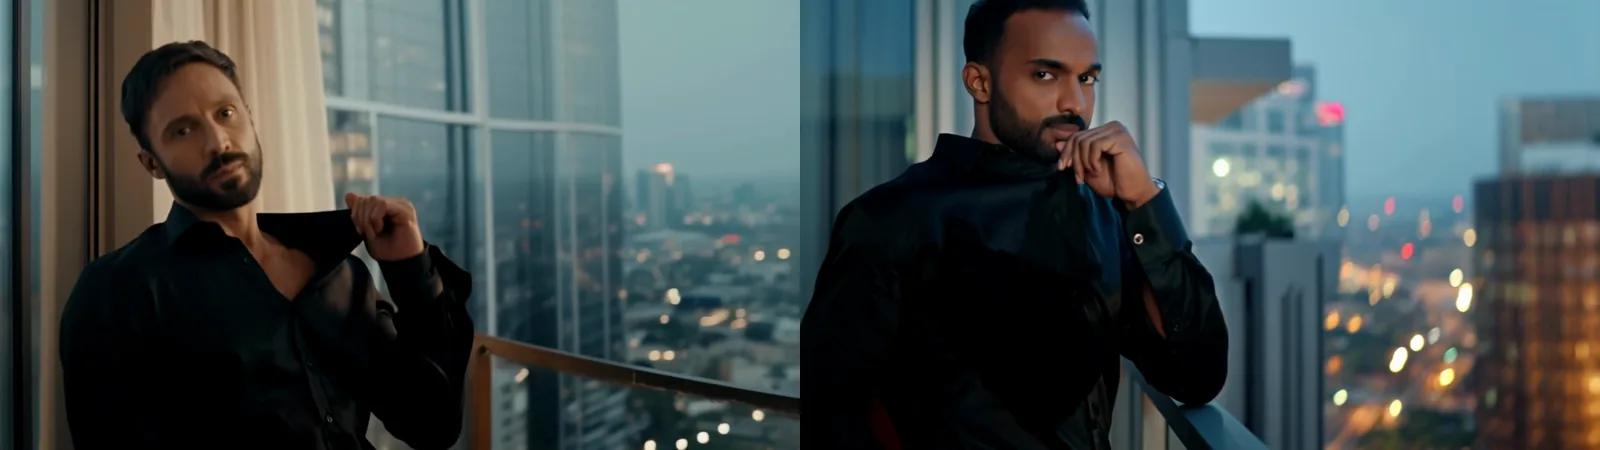
Texte vers vidéo, 720p, le même prompt sur les seeds 64001 (à gauche) et 64002 (à droite). Le prompt demandait de desserrer une manchette.
Les petits gestes inhabituels sont remplacés par des gestes familiers. Si un geste compte, choisissez-en un que le modèle a manifestement vu très souvent (une main dans les cheveux, une bretelle qui glisse, un col ajusté) et vérifiez-le d’abord dans un brouillon en 480p.
Jusqu’où aller, palier par palier
Rien de notre côté ne filtre le prompt, la photo ni le résultat. Ce qui change d’un palier à l’autre, c’est la réponse du modèle lui-même, et c’est elle qui décide si une nouvelle reformulation vaut la dépense. Ces chiffres regroupent les deux points d’accès sur 50 essais le 5 octobre 2026, en 480p et 5 secondes, tous les sujets étant des adultes. Nous ne reproduisons aucun prompt au-delà de L1.
| Palier | Ce que cela signifie | Rendu | Pour votre prompt |
|---|---|---|---|
| L1 Suggestif | Lingerie, une bretelle qui glisse | 8 sur 8 | Nommez le vêtement et l’unique chose qui lui arrive |
| L2 Partiel | Contenu partiel | 8 sur 8 | Les mêmes cinq emplacements ; la ligne de garde-robe et une action portent le palier |
| L3 Fort | Contenu fort | 10 sur 10 | Pareil ; une personne, une action |
| L4 Intense | Une scène intime entre deux adultes | 0 sur 8 | Atténué à chaque fois. Ne dépensez pas d’essais ici |
| L5 Extrême | Contrainte consentie entre adultes, ou gore cinématographique | 7 sur 8 et 6 sur 8 | Les ratés ont gardé les accessoires ou le sang mais ont laissé de côté une partie de la scène |
Aucun essai n’a été refusé ni flouté. Au palier L4, le texte vers vidéo a donné deux silhouettes emmêlées ou coupées sur un lit, sans dessiner la scène, sur les quatre essais, et l’image vers vidéo a quitté l’image de départ pour un nouveau plan de chambre où il n’y avait personne d’autre (les trois sondes de notre deuxième série). Nous n’avons vu ni refus ni flou : cela ressemble donc à la retenue du modèle lui-même, pas à un filtre. Le plafond pratique pour le travail destiné aux adultes est un adulte par clip, là où tous les essais de L1 à L3 sont passés. La critique de HunyuanVideo 1.5 lui donne un Freedom Score de 88,1.
Deux adultes dans un clip : un seul point de contact
Deux personnes en contact rapproché, c’est le point faible de ce modèle. Nous avons écrit un même moment de deux façons : une étreinte complète (« They wrap their arms around each other and sway pressed close together, her face buried in his neck ») et un seul point de contact avec de l’espace entre eux :
An adult couple in their thirties in a dim hotel bar at night, she in a dark green satin dress on the left, he in a white shirt with rolled sleeves on the right. They stand a hand's width apart; her palm rests flat on his chest and his hand rests at her waist. She leans in until her forehead touches his, then they both smile. Warm amber light, slow push-in, cinematic, photorealistic.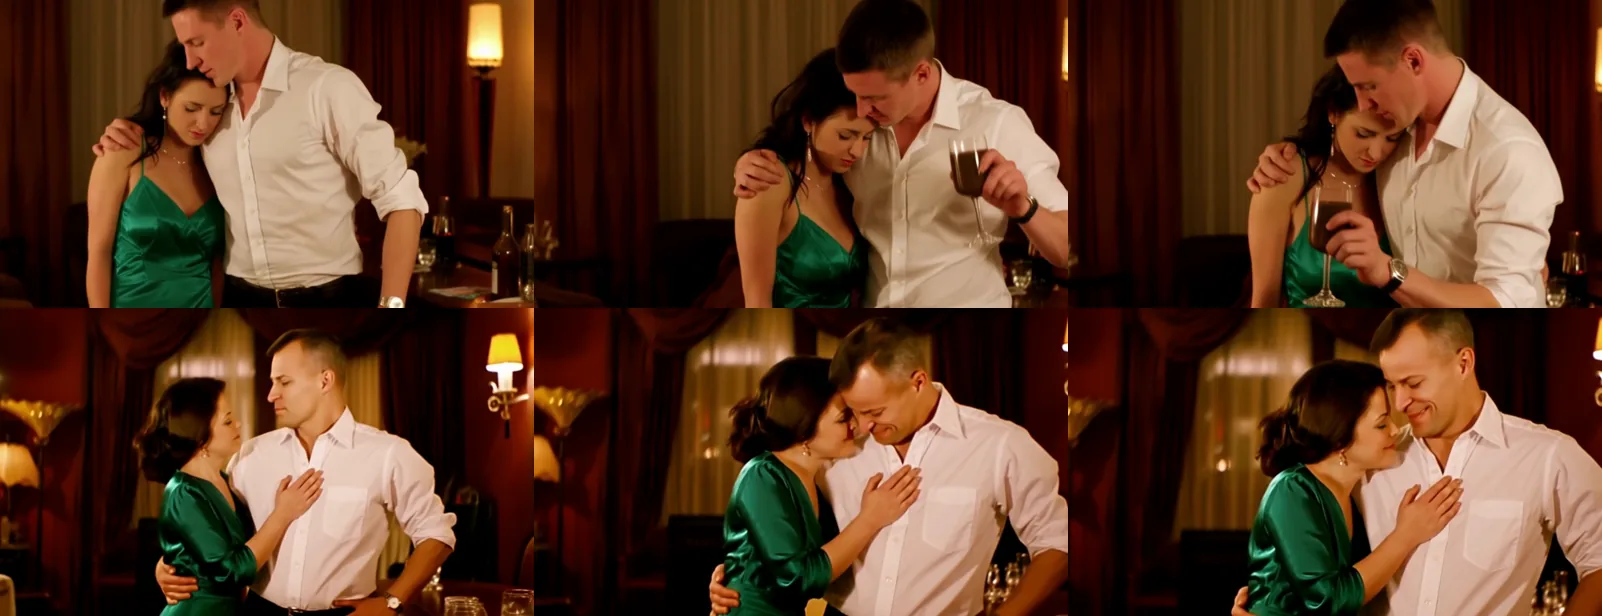
Texte vers vidéo, 480p, seed 62002. En haut : le prompt d’étreinte complète. En bas : le prompt à un point de contact.
L’étreinte n’a jamais eu lieu comme écrite. Sur cette seed, elle est devenue une accolade de côté pendant qu’il buvait dans un verre que personne n’avait demandé ; sur l’autre, leurs mains se sont brouillées ensemble sur l’épaule. La version à un point de contact a rendu chaque temps sur les deux seeds : paume sur la poitrine, main à la taille, fronts qui se touchent, deux sourires. La gauche et la droite ont été respectées sur une seed et inversées sur l’autre : prenez donc les positions comme une indication.
Pour deux personnes : donnez à chacune une tenue distincte, décrivez un ou deux points de contact et l’espace entre elles, et terminez sur un temps du visage.
Le prompt négatif : à quoi il sert
Le texte vers vidéo accepte un negative_prompt ; l’image vers vidéo non. Le code de l’éditeur le laisse vide par défaut et son guide ne le mentionne pas : considérez-le donc comme une liste de ce que vous ne voulez jamais voir dans le cadre. Notre liste de départ :
blurry, distorted hands, extra fingers, extra limbs, text, watermarkCe qu’il a arrêté ou non dans nos essais du 5 octobre :
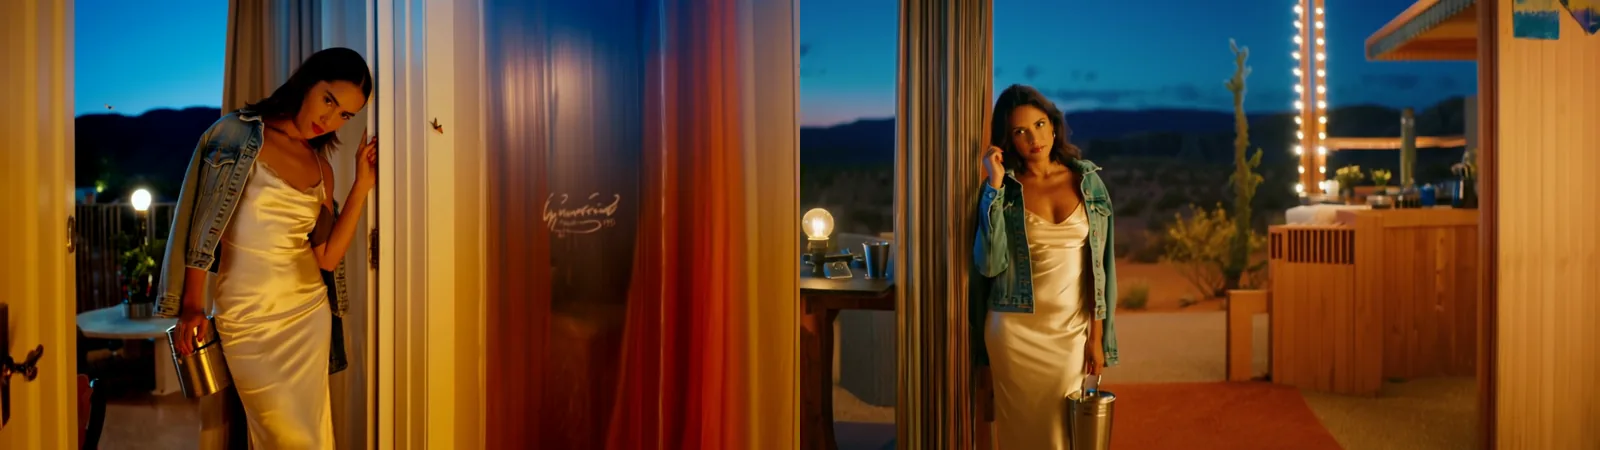
Texte vers vidéo, 720p, le même prompt et le même prompt négatif (qui liste « text, lettering, logo ») sur deux seeds. Le clip de gauche a quand même dessiné de l’écriture sur le rideau.
Ce prompt disait aussi « no signs or lettering anywhere ». HunyuanVideo 1.5 est conçu pour rendre du texte (son guide le montre en train d’écrire des mots entre guillemets dans les scènes), et dans nos essais il a inventé des lettres sur des rideaux, des plaques d’immatriculation et des badges de voiture. Le prompt négatif réduit les chances ; une nouvelle seed est le réessai le moins cher pour ce qui passe quand même.
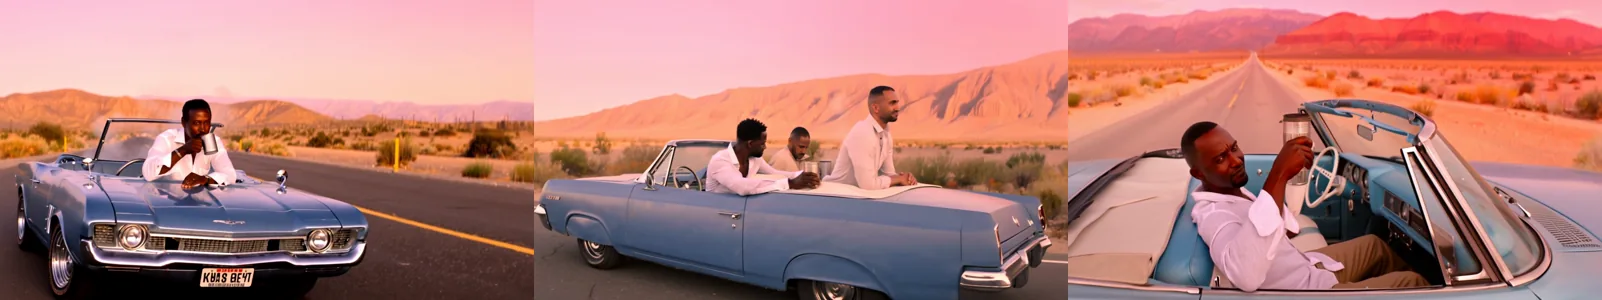
Texte vers vidéo, 720p, trois versions d’un même plan. À gauche : « no number plate, no lettering » dans le prompt, sans prompt négatif. Au milieu : un prompt négatif sans « extra people ». À droite : « extra people » ajouté et la caméra rapprochée.
Deux leçons. Le prompt négatif ne couvre que ce que vous nommez : le clip du milieu demandait un homme et en a donné trois, et ajouter « extra people » a réglé le problème. Et le cadrage corrige mieux que la liste : les plans larges ont laissé au modèle la place d’inventer des plaques, des badges et des passagers, alors que le plan rapproché n’a laissé qu’une petite marque chromée dans la première seconde. Dans les scènes pour adultes, surveillez de la même façon les miroirs, les affiches et les écrans à l’arrière-plan.
Image vers vidéo : l’image de départ fait le gros du travail
Sur le point d’accès image vers vidéo, la photo fixe le visage, la garde-robe, la lumière, la forme du cadre et le palier de départ de la scène. Le prompt dit seulement ce qui se passe ensuite, dans l’ordre de l’éditeur : mouvement du sujet, mouvement du décor, caméra. Il est facultatif, et il n’y a pas de champ de prompt négatif.
Nous avons donné à une même image de départ deux prompts, deux seeds chacun : l’un qui reste dans la photo et l’autre qui en sort. L’image est un cliché 3:4 réalisé avec le modèle d’image Jib Mix Qwen, une façon courante de poser un personnage avant de l’animer.
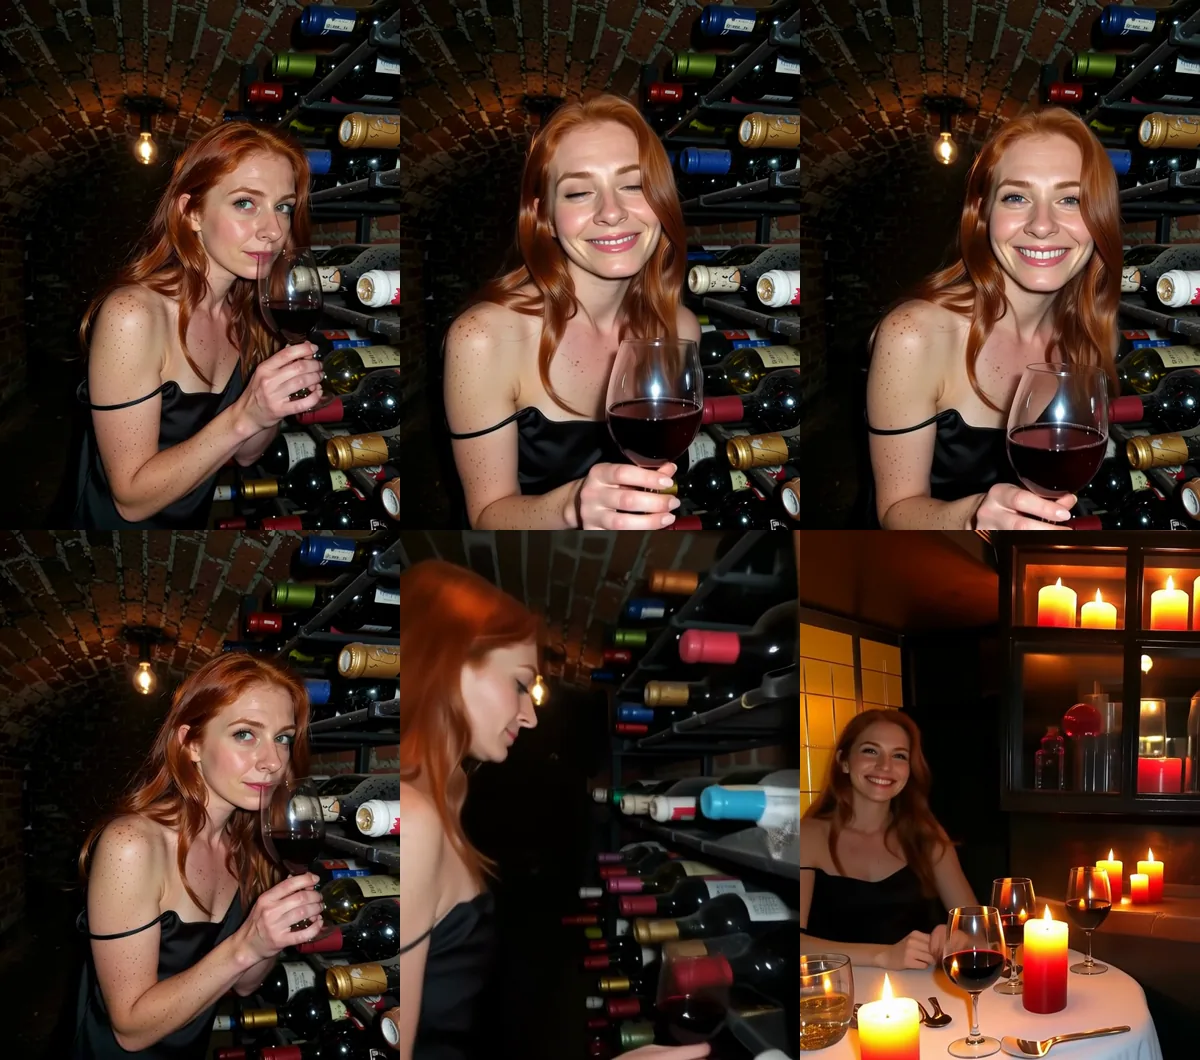
Image vers vidéo, 480p, seed 63001 ; le clip est revenu en 544 x 720. En haut : « She lowers the wine glass, turns her head toward the camera and holds the look, then lets a slow smile spread. The light bulb above her sways slightly. The camera holds still. » En bas : « She sets the wine glass down, walks up the cellar stairs into a candlelit restaurant upstairs, sits at a table by the window and smiles at the camera. » La seed 63002 a donné la même chose.
Rester dans la cave a gardé son visage, ses taches de rousseur et sa bretelle qui glisse sur les deux seeds. Sortir de la pièce a coupé vers une nouvelle pièce sur les deux seeds, et après la coupe, le visage, la robe et la bretelle ont tous changé. Si la scène exige un second lieu, faites une seconde image de départ.
L’ampleur du mouvement compte aussi, comme le suggèrent deux de nos essais du 5 octobre en 720p :
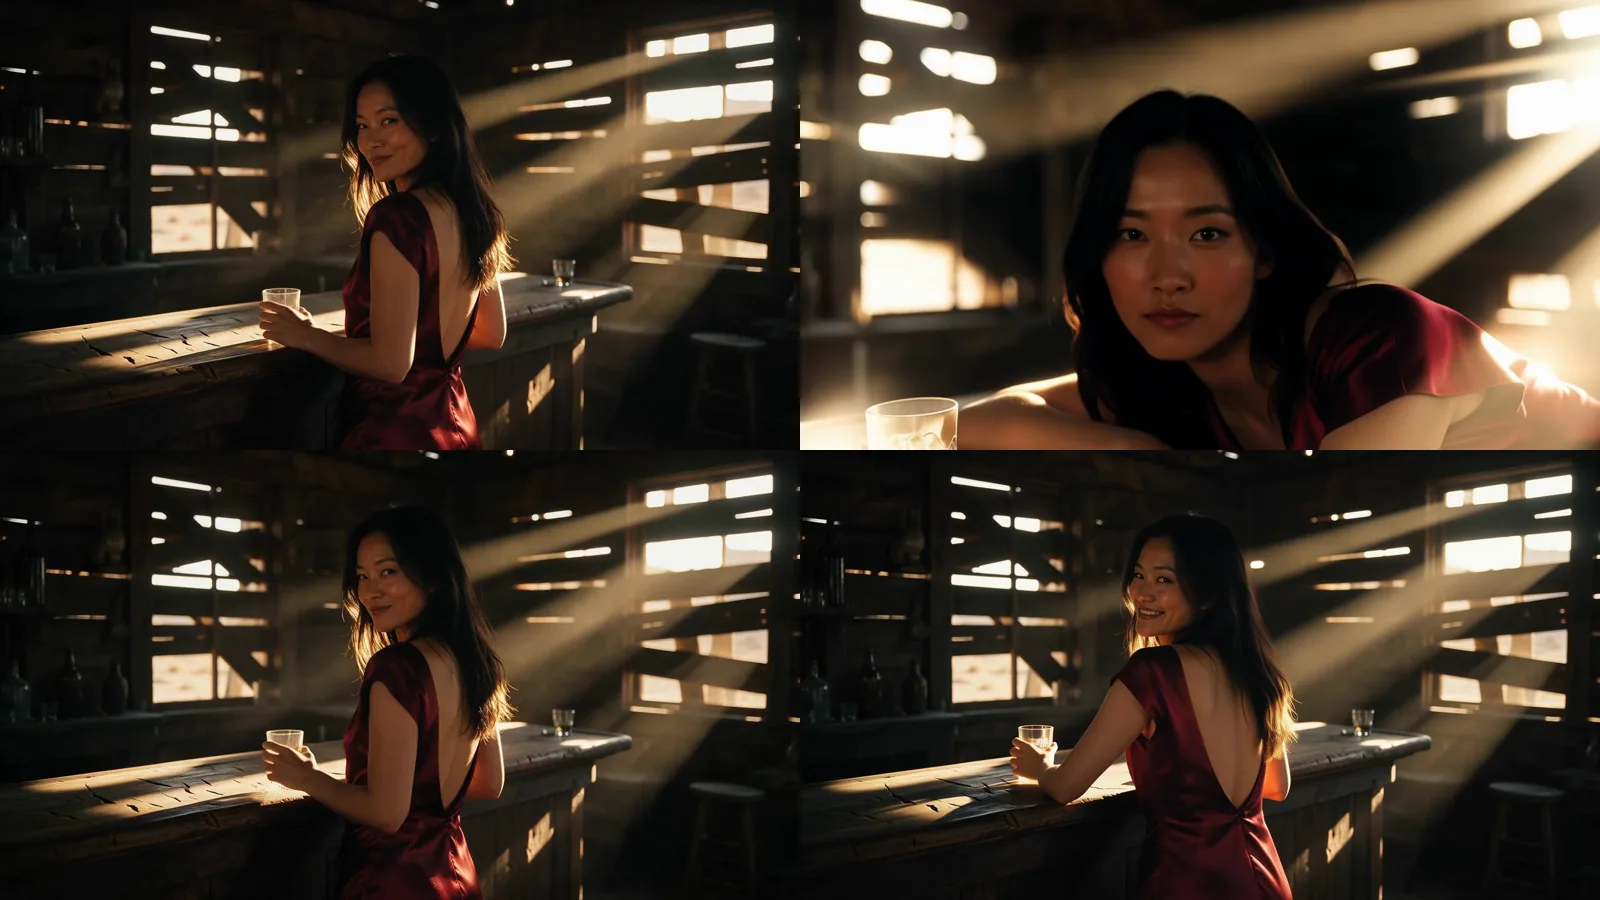
Image vers vidéo, une même image de départ, début et fin de deux clips sur des seeds différentes. En haut : « turns slowly to face the camera and leans back on her elbows », léger travelling avant. En bas : « takes a slow sip… lets a slow, amused smile spread », caméra fixe.
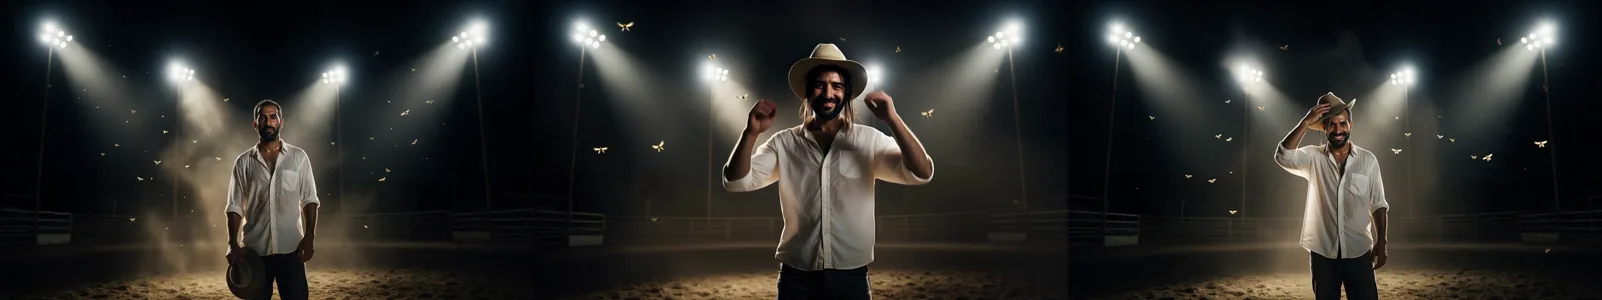
Image vers vidéo, une même image de départ. Au milieu : on lui a demandé de tapoter la poussière de son chapeau, de passer une main dans ses cheveux et de mettre le chapeau. À droite : on lui a seulement demandé de s’essuyer le front ; le modèle a mis le chapeau de lui-même et le visage a tenu.
Dans les deux ratés, des mains ont traversé le visage ou le visage s’est rapproché de l’objectif plus que sur la photo : le modèle a donc probablement dû le redessiner, et a dessiné quelqu’un d’autre. Gardez les temps petits (une gorgée, un regard, un sourire), la caméra fixe ou lente, et tout ce qui couvre le visage limité à un seul geste.
L’image de départ fixe aussi le palier de départ : à partir de photos habillées, nos prompts d’échelle ont mené une seule silhouette jusqu’à L3 en gardant le visage et la pièce, mais une scène à deux personnes à partir d’une photo d’une seule personne n’est jamais apparue.
Résolution, durée et format
| Choix | Notre préférence | Pourquoi |
|---|---|---|
| 480p ou 720p | Brouillons en 480p, 720p pour le clip retenu | Moitié moins cher ; le 480p a pris de 39 à 73 secondes de temps de modèle dans les essais de ce guide, le 720p de deux à quatre minutes |
| 5 ou 8 secondes | 5, sauf si vous avez quatre temps ou plus | Trois temps ont rempli 5 secondes ; 8 secondes coûtent 60 % de plus |
| 16:9 ou 9:16 | 9:16 pour les flux sur téléphone | Écrivez le cadrage pour la forme, par exemple « vertical medium shot from waist height » |
| Forme en image vers vidéo | Recadrez d’abord la photo | Le clip suit la photo |
| Seed | Fixe pendant que vous modifiez | Une même seed ne promet pas un clip identique |
Un brouillon de 5 secondes en 480p coûte 0,12 $, un clip final de 5 secondes en 720p 0,24 $ et un clip de 8 secondes en 720p 0,384 $, sur l’un ou l’autre point d’accès. Les clips sont muets : prévoyez le son au montage, avec ajouter voix et musique à une vidéo IA NSFW.
Les schémas qui ont dérivé, et quoi écrire à la place
| Schéma | Ce que nous avons vu | À la place |
|---|---|---|
| Adjectifs d’ambiance | Regard posé, détails de la scène perdus | Deux ou trois temps visibles |
| Étreinte complète entre deux adultes | Une accolade, des mains brouillées, un accessoire inventé | Un ou deux points de contact |
| Un geste rare (« loosens one cuff ») | Remplacé par une main sur le col | Un geste courant |
| « No lettering » dans le prompt principal | Une plaque d’immatriculation inventée | Prompt négatif et cadrage plus serré |
| Plan large avec voitures ou enseignes | Texte inventé et personnes en trop | Rapprochez la caméra |
| Pose allongée en pied | Un pied en trop ; un gros plan demandé ignoré | Cadrez à partir de la taille |
| Image vers vidéo : un nouveau lieu ou un mouvement vers l’objectif | Un nouveau visage | Seconde image de départ, petits mouvements |
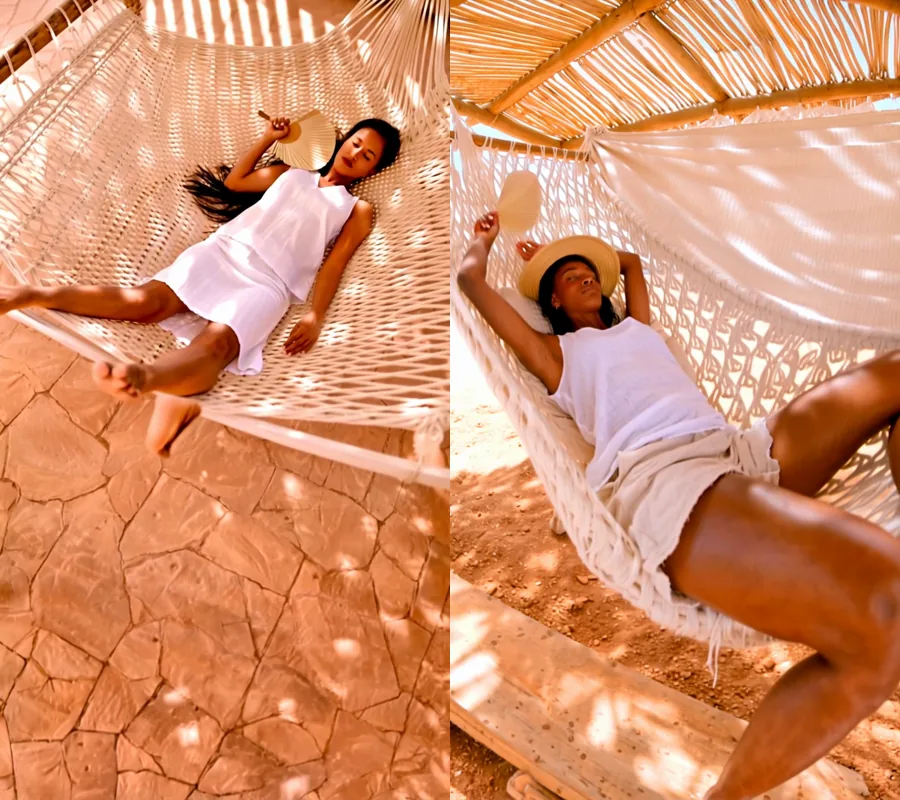
Texte vers vidéo, 720p, 9:16, deux prises d’un même plan allongé de nos essais du 5 octobre. Le prompt de droite demandait son visage et ses épaules en gros plan. Aucun des deux n’a été respecté.
Liste de contrôle du prompt
Avant de payer une prise en 720p :
- La ligne du sujet dit « adult » et donne une tranche d’âge ; la ligne de garde-robe donne vêtement, tissu, couleur et état.
- Deux ou trois temps d’action visibles dans l’ordre, avec des gestes courants, sans adjectifs d’ambiance qui les remplacent.
- Un seul mouvement de caméra, cadré assez serré pour laisser de côté enseignes, plaques, écrans et personnes en trop ; le lieu décrit par ses objets.
- Deux personnes seulement si nécessaire : tenues distinctes, un ou deux points de contact, un temps du visage pour finir.
- Texte vers vidéo : un court prompt négatif qui nomme vos vrais problèmes. Image vers vidéo : une photo recadrée, la même pièce, de petits temps.
- Un brouillon en 480p de 5 secondes sur une seed fixe, puis le 720p pour le clip retenu.
Si vous voulez du son avec l’image, LTX-2 19B ajoute une piste audio à chaque clip, et notre guide de prompts pour vidéo IA sans censure compare le comportement d’un même prompt selon les modèles.
FAQ
Comment écrire des prompts NSFW pour HunyuanVideo 1.5 ?
Écrivez un plan de tournage : un adulte, la garde-robe, deux ou trois petites actions dans l’ordre, un mouvement de caméra, puis la lumière et une courte étiquette de style. Dans nos 50 essais, chaque demande de L1 à L3 est revenue comme écrite, alors que les scènes intimes à deux personnes ont été atténuées à chaque fois : limitez donc le travail pour adultes à une personne par clip.
Comment transformer une image en vidéo avec un prompt ?
Utilisez le point d’accès image vers vidéo et décrivez seulement ce qui se passe ensuite au même endroit : une petite action, un temps du visage et la caméra. La photo fixe déjà le visage, la tenue et la lumière. Les prompts qui envoyaient la personne ailleurs ont coupé vers un nouveau plan avec un autre visage sur nos deux seeds.
Hunyuan propose-t-il l’image vers vidéo ?
Oui. HunyuanVideo 1.5 a un point d’accès texte vers vidéo et un point d’accès image vers vidéo. Le clip d’image vers vidéo garde la forme de votre photo, et son prompt est facultatif.
HunyuanVideo 1.5 utilise-t-il un prompt négatif ?
En texte vers vidéo, oui. Il a été accepté à chaque essai où nous en avons passé un, et nommer un problème précis (« extra people ») l’a fait disparaître, mais des lettres inventées sont quand même passées une fois. L’image vers vidéo n’a pas de champ de prompt négatif.
Pourquoi mon clip HunyuanVideo est-il revenu édulcoré ?
S’il s’agissait d’une scène intime entre deux adultes, c’est la limite du modèle lui-même : nos 8 essais à ce palier sont tous revenus atténués, sans refus. S’il s’agissait d’un seul adulte, rendez les actions concrètes ; les mots d’ambiance nous ont donné des clips posés et statiques qui paraissent sages.
Pourquoi mon clip image vers vidéo est-il au ralenti ?
Nous ne l’avons pas mesuré nous-mêmes. Quand un utilisateur a signalé un ralenti sur le suivi d’incidents GitHub de l’éditeur, les mainteneurs ont conseillé de décrire des actions plus rapides dans le prompt, par exemple « turns quickly and laughs » plutôt que « slowly turns ».