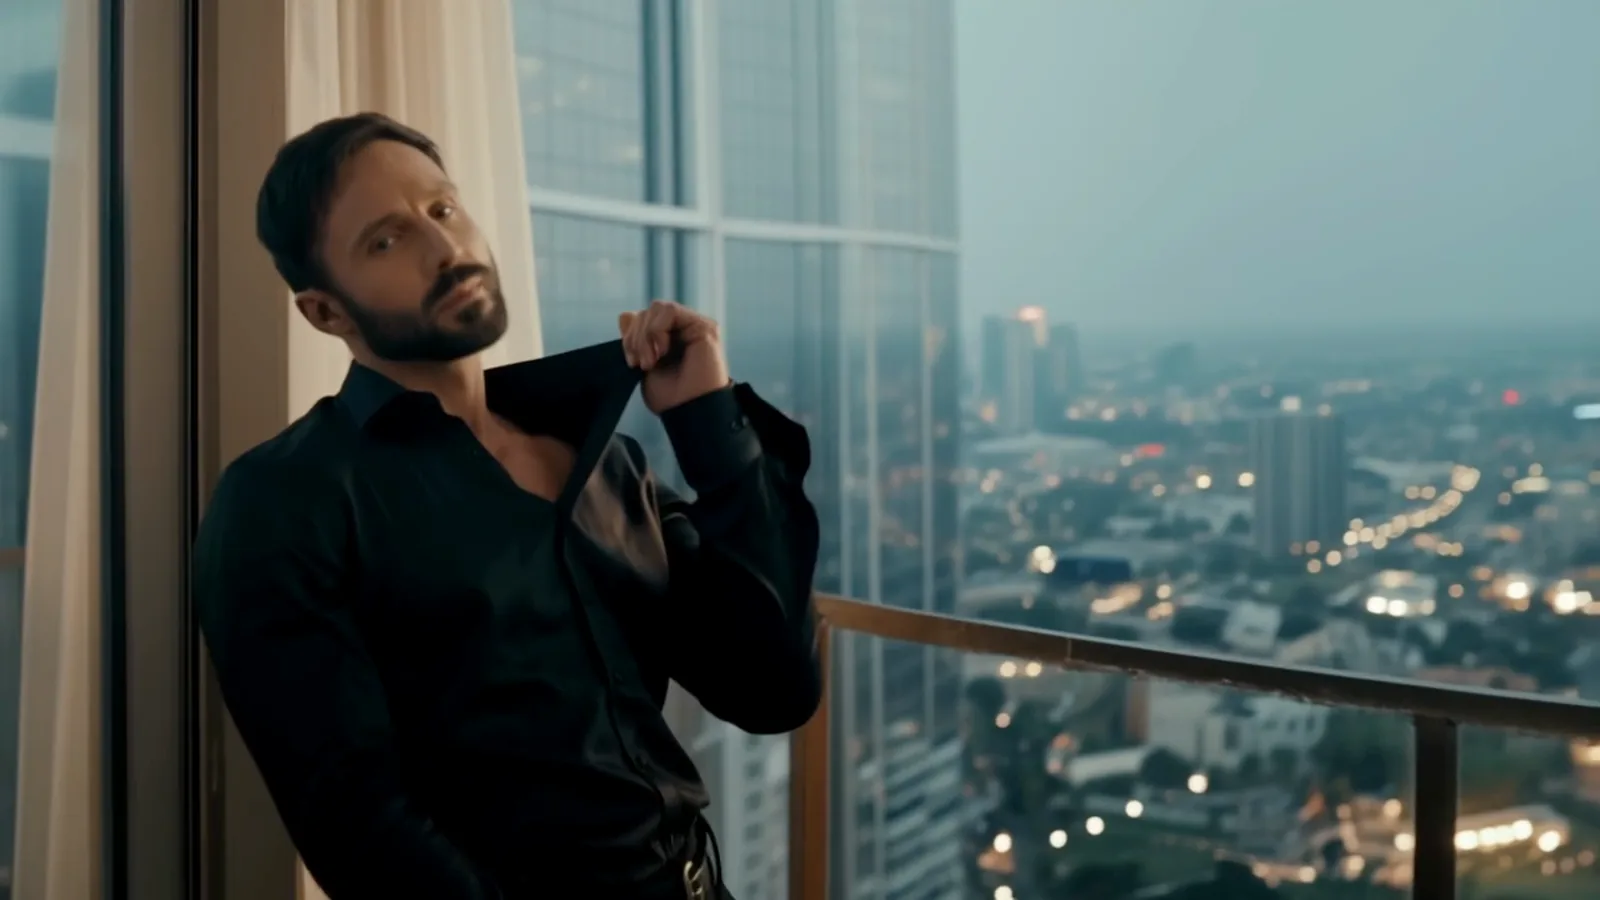
HunyuanVideo 1.5 segue meglio un prompt che si legge come una lista di inquadrature: un adulto, che cosa indossa, due o tre piccole azioni in ordine, un movimento di camera e la luce. In 50 prove con contenuti per adulti del 5 ottobre 2026, ogni richiesta da L1 a L3 è tornata come l'avevamo scritta (26 su 26), mentre tutte le 8 scene intime tra due adulti sono tornate attenuate: è lì che riscrivere il prompt smette di servire. Da immagine a video il frame iniziale fa gran parte del lavoro: le piccole azioni hanno mantenuto il volto della foto, mentre chiedere un nuovo luogo lo ha sostituito.
La scala completa dei contenuti, le dimensioni, le velocità e il confronto con LTX-2 sono nel nostro test NSFW di HunyuanVideo 1.5. Questa guida riguarda il prompt: quali formulazioni il modello segue e quali ignora, mostrate con clip affiancate eseguite apposta per la guida. Ogni prompt riportato qui è una scena con un adulto vestito, sul versante allusivo, e puoi eseguirli dalla pagina della famiglia HunyuanVideo 1.5.
In breve
| Prompt per HunyuanVideo 1.5, dalle nostre prove | |
|---|---|
| Struttura di prompt che ha funzionato | Soggetto, abbigliamento, due o tre azioni in ordine, un movimento di camera, luce e look |
| Aggettivi d'atmosfera ("sultry", "seductive") | Uno sguardo in posa e poco movimento, in entrambi i seed di prova |
| Da L1 a L3 | 26 su 26 resi, su entrambi gli endpoint |
| L4, due adulti | 0 su 8 resi: tutti attenuati, nessuno rifiutato |
| L5 | Bondage 7 su 8 resi, gore cinematografico 6 su 8 |
| Prompt negativo | Solo da testo a video. Riduce gli artefatti, non è mai una garanzia |
| Prompt da immagine a video | Facoltativo. Descrivi il momento successivo nello stesso luogo |
| Impostazioni | 480p o 720p, 5 o 8 secondi, muto; 16:9 o 9:16 da testo a video; da immagine a video mantiene la forma della foto |
| Prezzo | $0,024 al secondo a 480p, $0,048 a 720p ($0,12 per una bozza di 5 secondi) |
I cinque slot che HunyuanVideo 1.5 legge
Il manuale dei prompt di HunyuanVideo 1.5 di Tencent costruisce un prompt da testo a video con soggetto, movimento e scena, e come extra inquadratura, camera, luce, stile e atmosfera. Chiede di descrivere le azioni in ordine temporale ("first… then… finally") e di scrivere le emozioni come piccoli dettagli fisici. Per le clip rivolte a un pubblico adulto dividiamo il soggetto in due, perché è nella riga dell'abbigliamento che vive il livello della scena.
| Slot | Che cosa scrivere | Il nostro esempio |
|---|---|---|
| 1. Soggetto | Un adulto: fascia d'età, capelli, un dettaglio distintivo | An adult woman in her early thirties |
| 2. Abbigliamento | Capo, tessuto, colore e il suo stato | in a black satin slip dress |
| 3. Azioni | Due o tre piccole azioni con "first", "then", "finally" | slides one strap back onto her shoulder, glances back at the camera, smiles |
| 4. Camera | Un solo movimento: avvicinamento, orbita, fissa, a mano | Slow push-in |
| 5. Luce e look | La fonte di luce, più una breve etichetta di stile | warm lamp light, cinematic, photorealistic |
Il luogo va tra il soggetto e l'azione. Il prompt completo:
An adult woman in her early thirties in a black satin slip dress stands by the window of a dim hotel room at night, city lights behind her. First she slides one strap back onto her shoulder, then she glances over her shoulder at the camera, and finally she lets a slow, knowing smile break. Slow push-in, warm lamp light, cinematic, photorealistic.Apri questo prompt in HunyuanVideo 1.5 da testo a video →
Tre abitudini hanno fatto la differenza più grande nelle nostre prove:
- Un adulto per clip, a meno che la scena non ne richieda due.
- Nomina la stanza per ciò che contiene. In entrambe le clip a due persone con il seed 62001 (vedi sotto), "hotel bar" è tornato come una camera d'albergo con un letto. Se il luogo conta, elenca il bancone, gli sgabelli e le bottiglie.
- Tieni ferma la riga del soggetto mentre iteri. Cambiare una sola frase ridisegna l'intera persona, anche con lo stesso seed.
Aggettivi d'atmosfera o dettagli d'azione
I prompt per adulti tendono ad accumulare aggettivi d'atmosfera. Abbiamo confrontato il prompt qui sopra con lo stesso prompt in cui la frase d'azione era sostituita da "She is sultry, seductive and sensual, radiating desire." Stesso seed, stesso prompt negativo, 480p, 5 secondi, due seed ciascuno.
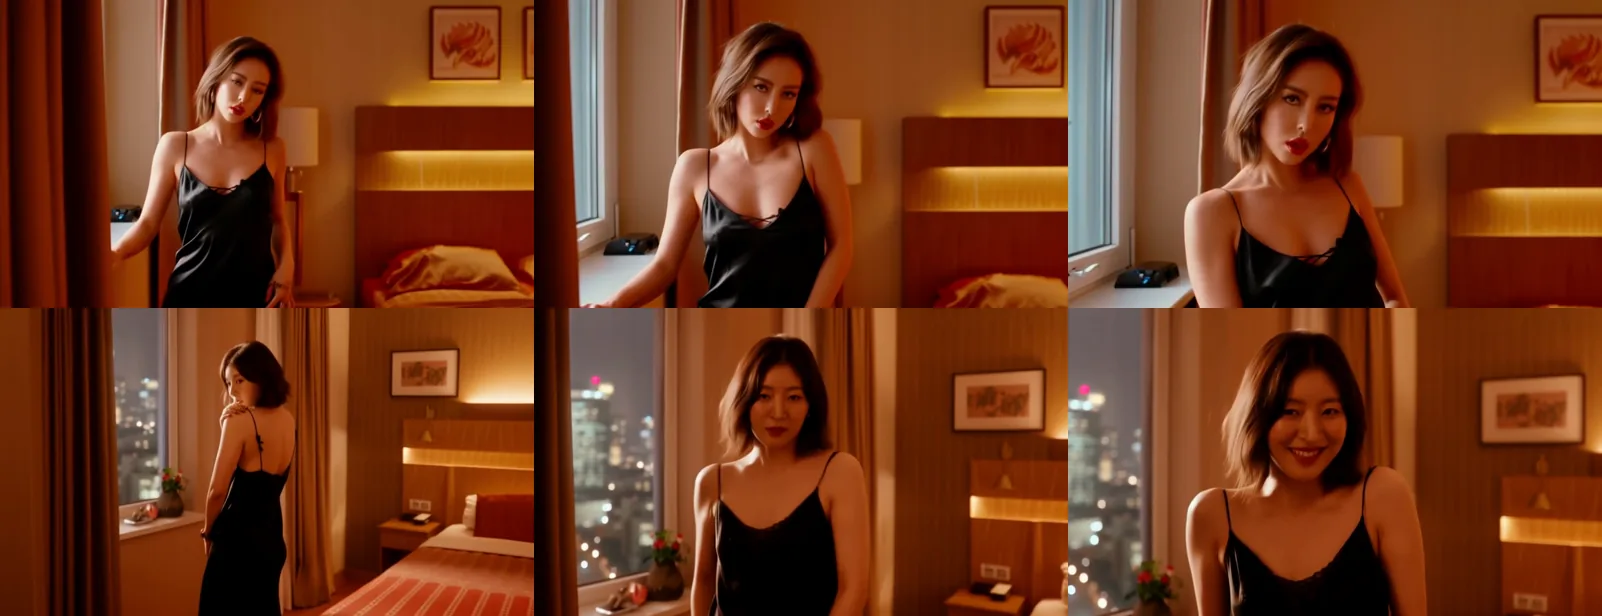
Da testo a video, 480p, seed 61002, inizio, metà e fine di ogni clip. In alto: il prompt con gli aggettivi d'atmosfera. In basso: il prompt con le azioni. Il seed 61001 si è comportato allo stesso modo.
Gli aggettivi hanno prodotto una posa da servizio di moda: labbra socchiuse, sguardo fisso, una mano ferma, e l'avvicinamento di camera a fare tutto il movimento. In questo seed è sparita anche la città notturna alle sue spalle. La versione con le azioni ha attraversato tutti e tre i momenti in entrambi i seed e si è chiusa sul sorriso, anche se i primi due momenti si sono fusi (lei stava già guardando indietro mentre la mano andava alla spallina). È il costo abituale di tre azioni in cinque secondi.
La regola: scrivi ciò che chi guarda deve vedere accadere, non come deve sentirlo. "A slow, knowing smile" fa il lavoro di "seductive", e il modello sa disegnarlo.
Scegli gesti che il modello conosce
Il prompt dietro la copertina di questa guida chiedeva a un uomo su un balcone d'albergo di "loosen one cuff", poi di reggere lo sguardo verso la camera, poi di accennare un mezzo sorriso. In entrambi i seed il polsino non si è mosso: un uomo si è aperto il colletto, l'altro ha appoggiato una mano al colletto e al mento. Lo sguardo è arrivato entrambe le volte.
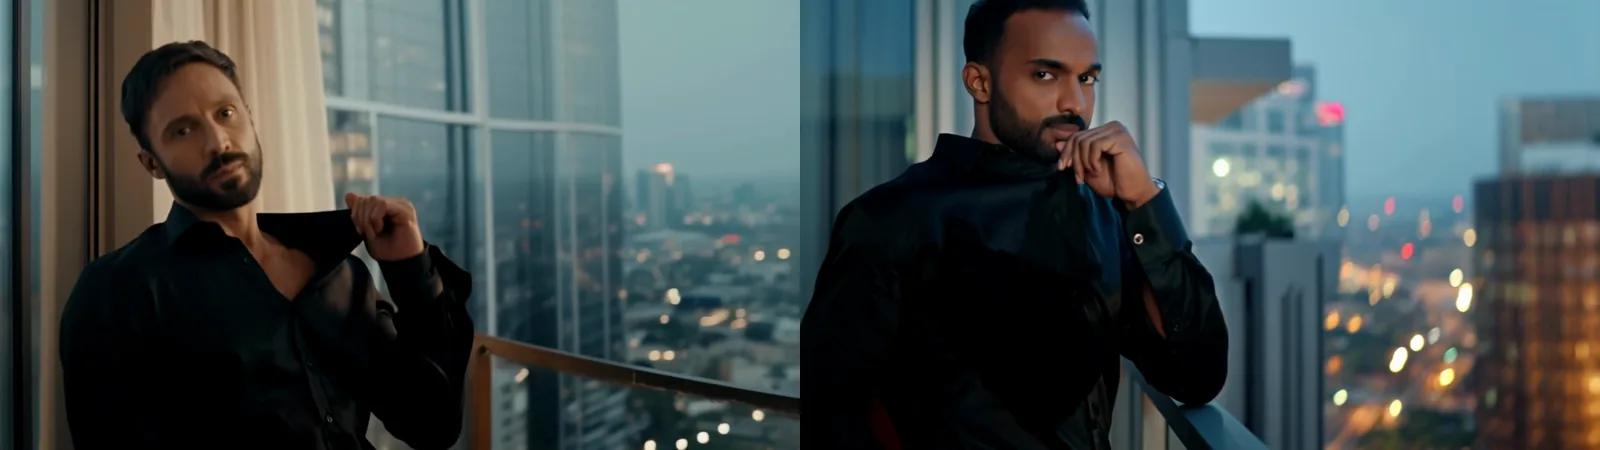
Da testo a video, 720p, lo stesso prompt con i seed 64001 (a sinistra) e 64002 (a destra). Il prompt chiedeva di allentare un polsino.
I piccoli gesti insoliti vengono sostituiti da quelli familiari. Se un gesto conta, scegline uno che il modello ha visto chiaramente molte volte (una mano tra i capelli, una spallina che scivola, un colletto sistemato) e verificalo prima in una bozza a 480p.
Fin dove spingersi, livello per livello
Nulla da parte nostra filtra il prompt, la foto o il risultato. Ciò che cambia da un livello all'altro è come risponde il modello stesso, ed è questo a decidere se vale la pena pagare un'altra riscrittura. Questi numeri riuniscono entrambi gli endpoint su 50 prove del 5 ottobre 2026, a 480p e 5 secondi, con tutti i soggetti adulti. Sopra L1 non riportiamo i prompt.
| Livello | Che cosa significa | Reso | Per il tuo prompt |
|---|---|---|---|
| L1 Allusivo | Lingerie, una spallina che scivola | 8 su 8 | Nomina il capo e l'unica cosa che gli succede |
| L2 Parziale | Contenuto parziale | 8 su 8 | Stessi cinque slot; la riga dell'abbigliamento e un'azione portano il livello |
| L3 Forte | Contenuto forte | 10 su 10 | Uguale; una persona, un'azione |
| L4 Intenso | Una scena intima tra due adulti | 0 su 8 | Attenuato ogni volta. Non spendere tentativi qui |
| L5 Estremo | Bondage consensuale tra adulti, o gore cinematografico | 7 su 8 e 6 su 8 | Gli insuccessi hanno mantenuto gli oggetti di scena o il sangue ma hanno lasciato fuori parte della scena |
Nessuna prova è stata rifiutata o sfocata. A L4, da testo a video ha dato due figure ingarbugliate o tagliate su un letto senza disegnare la scena in tutte e quattro le prove, e da immagine a video ha staccato dal frame iniziale su una nuova inquadratura di camera da letto senza nessun altro (tutte e tre le sonde della nostra seconda esecuzione). Non abbiamo visto né rifiuti né sfocature, quindi sembra una restrizione del modello e non un filtro. Il tetto pratico per i lavori per adulti è un adulto per clip, dove ogni prova da L1 a L3 è andata a buon fine. La recensione di HunyuanVideo 1.5 colloca il suo Freedom Score a 88,1.
Due adulti in una clip: un solo punto di contatto
Due persone a stretto contatto sono il punto debole di questo modello. Abbiamo scritto un momento in due modi: un abbraccio completo ("They wrap their arms around each other and sway pressed close together, her face buried in his neck") e un solo punto di contatto con dello spazio tra loro:
An adult couple in their thirties in a dim hotel bar at night, she in a dark green satin dress on the left, he in a white shirt with rolled sleeves on the right. They stand a hand's width apart; her palm rests flat on his chest and his hand rests at her waist. She leans in until her forehead touches his, then they both smile. Warm amber light, slow push-in, cinematic, photorealistic.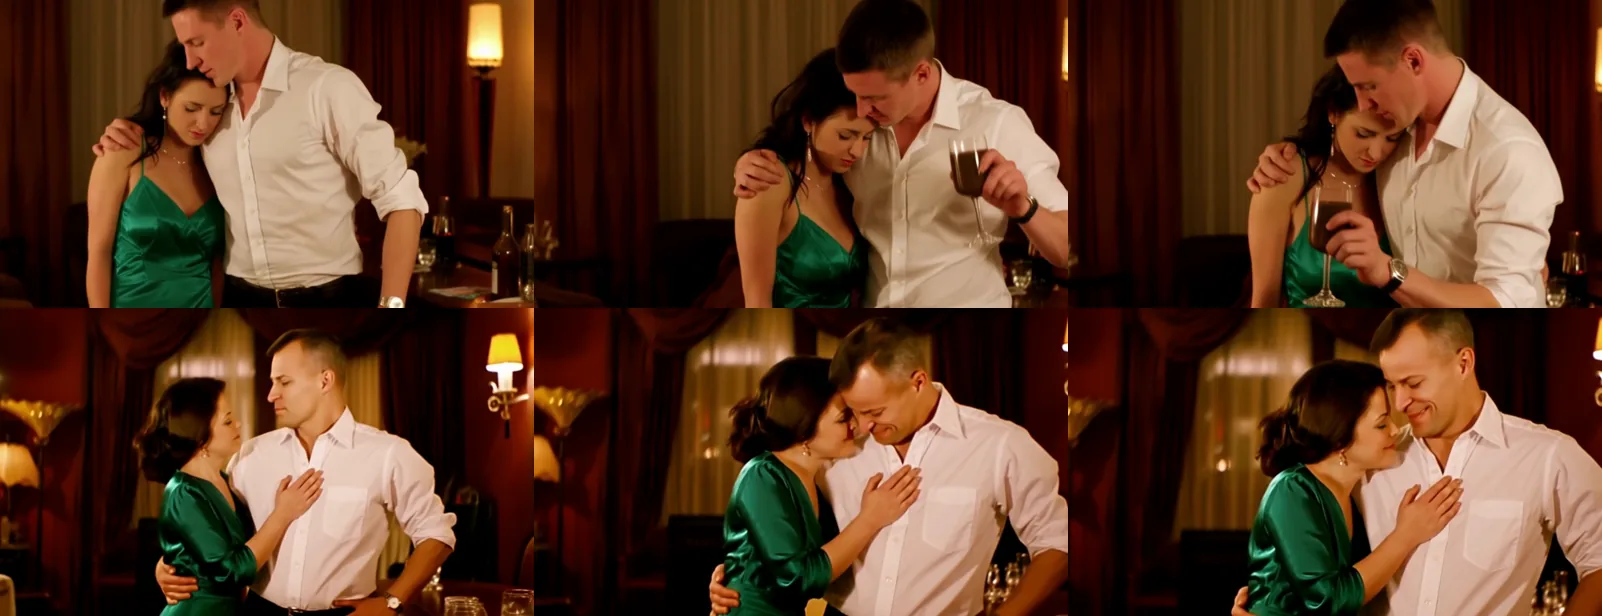
Da testo a video, 480p, seed 62002. In alto: il prompt con l'abbraccio completo. In basso: il prompt con il punto di contatto.
L'abbraccio non è mai avvenuto come scritto. In questo seed è diventato un abbraccio di lato mentre lui beveva da un bicchiere che nessuno aveva chiesto; nell'altro, le loro mani si sono sfocate insieme sulla spalla di lei. La versione con il punto di contatto ha reso ogni momento in entrambi i seed: palmo sul petto, mano sulla vita, fronti vicine, due sorrisi. Sinistra e destra sono state rispettate in un seed e invertite nell'altro, quindi considera le posizioni solo un suggerimento.
Per due persone: dai a ciascuna un abbigliamento distinto, descrivi uno o due punti di contatto e lo spazio tra loro, e chiudi su un momento del volto.
Il prompt negativo: a che cosa serve
Da testo a video accetta un negative_prompt; da immagine a video no. Il codice dell'editore lo lascia vuoto per impostazione predefinita e il suo manuale non lo menziona, quindi consideralo un elenco di cose che non vuoi mai nell'inquadratura. La nostra lista di partenza:
blurry, distorted hands, extra fingers, extra limbs, text, watermarkChe cosa ha fermato e che cosa no nelle nostre esecuzioni di esempio del 5 ottobre:
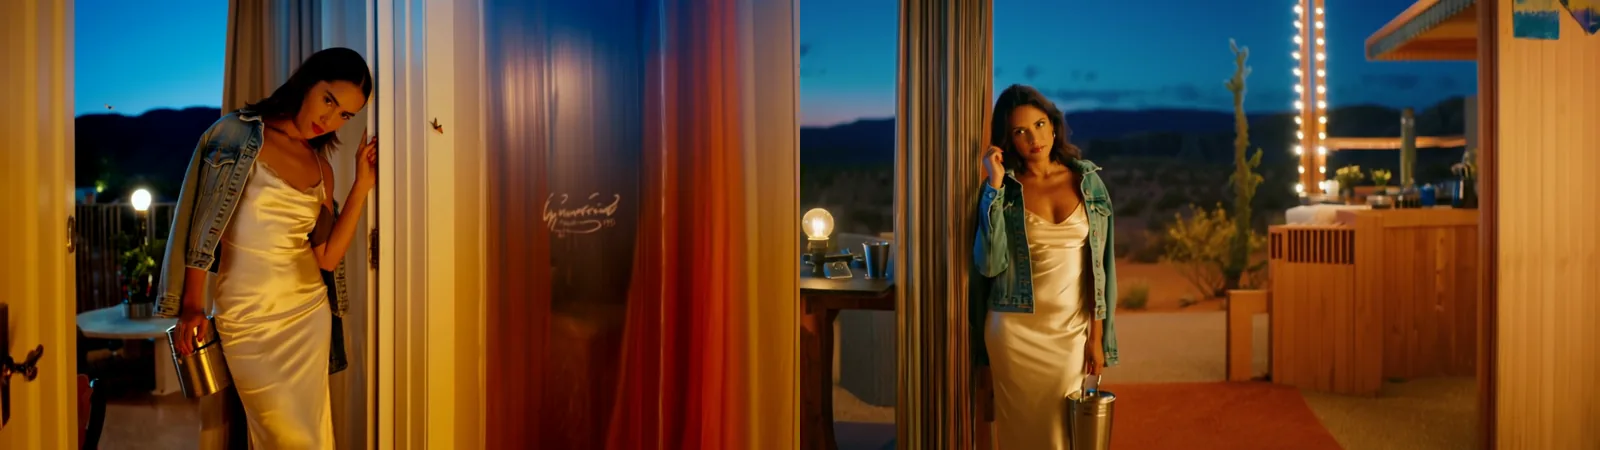
Da testo a video, 720p, lo stesso prompt e lo stesso prompt negativo (che elenca "text, lettering, logo") su due seed. La clip a sinistra ha comunque disegnato dei caratteri sulla tenda.
Quel prompt diceva anche "no signs or lettering anywhere". HunyuanVideo 1.5 è costruito per rendere il testo (il suo manuale lo mostra mentre scrive nelle scene le parole tra virgolette), e nelle nostre esecuzioni ha inventato scritte su tende, targhe e stemmi delle auto. Il prompt negativo abbassa le probabilità; un nuovo seed è il tentativo più economico per ciò che sfugge.
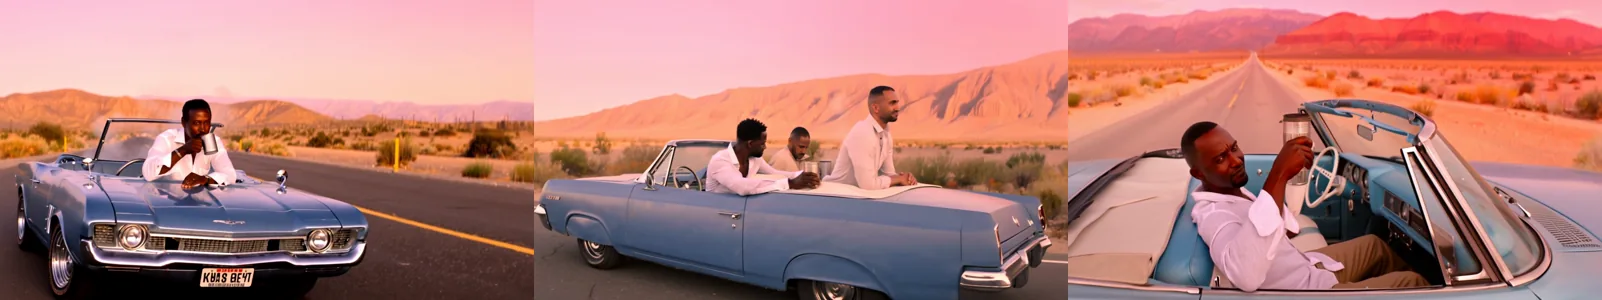
Da testo a video, 720p, tre versioni della stessa inquadratura. A sinistra: "no number plate, no lettering" nel prompt, nessun prompt negativo. Al centro: un prompt negativo senza "extra people". A destra: "extra people" aggiunto e camera avvicinata.
Due lezioni. Il prompt negativo copre solo ciò che nomini: la clip centrale chiedeva un uomo e ne ha dati tre, e aggiungere "extra people" ha risolto. E l'inquadratura è una correzione più forte dell'elenco: i campi larghi hanno lasciato al modello spazio per inventare targhe, stemmi e passeggeri, mentre il primo piano ha lasciato solo un piccolo segno cromato nel primo secondo. Nelle scene per adulti, tieni d'occhio allo stesso modo specchi, poster e schermi sullo sfondo.
Da immagine a video: il frame iniziale fa il lavoro pesante
Sull'endpoint da immagine a video la foto fissa il volto, l'abbigliamento, la luce, la forma dell'inquadratura e il livello di partenza della scena. Il prompt dice solo che cosa succede dopo, nell'ordine dell'editore: movimento del soggetto, movimento della scena, camera. È facoltativo, e non c'è un campo per il prompt negativo.
Abbiamo dato a un solo frame iniziale due prompt, due seed ciascuno: uno che resta nella foto e uno che ne esce. Il frame è una still 3:4 creata con il modello di immagini Jib Mix Qwen, un modo comune di preparare un personaggio prima di animarlo.
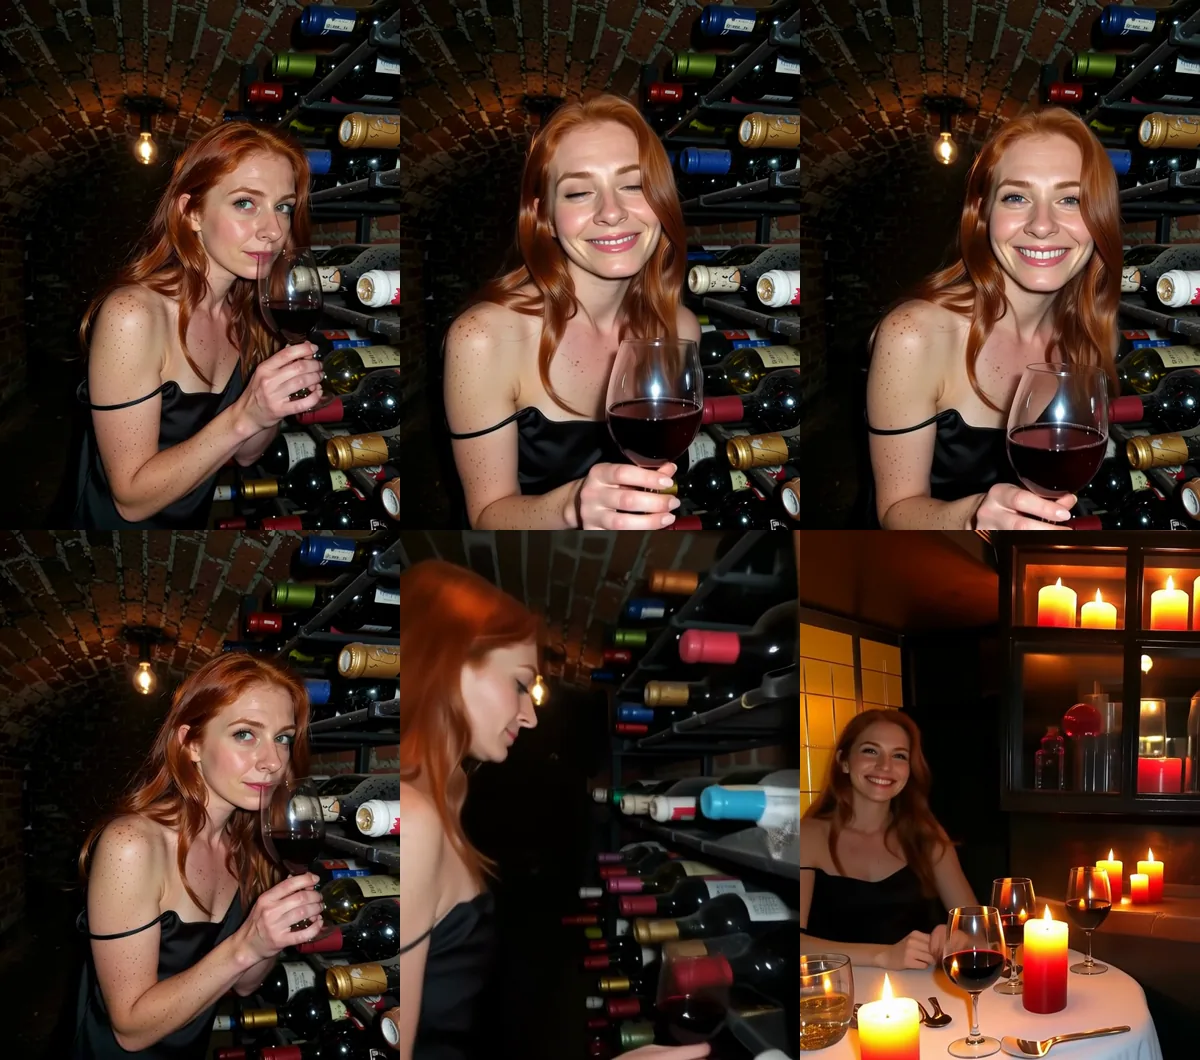
Da immagine a video, 480p, seed 63001; la clip è tornata a 544 x 720. In alto: "She lowers the wine glass, turns her head toward the camera and holds the look, then lets a slow smile spread. The light bulb above her sways slightly. The camera holds still." In basso: "She sets the wine glass down, walks up the cellar stairs into a candlelit restaurant upstairs, sits at a table by the window and smiles at the camera." Il seed 63002 ha dato lo stesso risultato.
Restare nella cantina ha mantenuto il volto, le lentiggini e la spallina scivolata in entrambi i seed. Uscirne ha prodotto uno stacco su una nuova stanza in entrambi i seed, e dopo lo stacco il volto, l'abito e la spallina sono cambiati. Se la scena richiede un secondo luogo, crea un secondo frame iniziale.
Conta anche la grandezza del movimento, come suggeriscono due delle nostre esecuzioni del 5 ottobre a 720p:
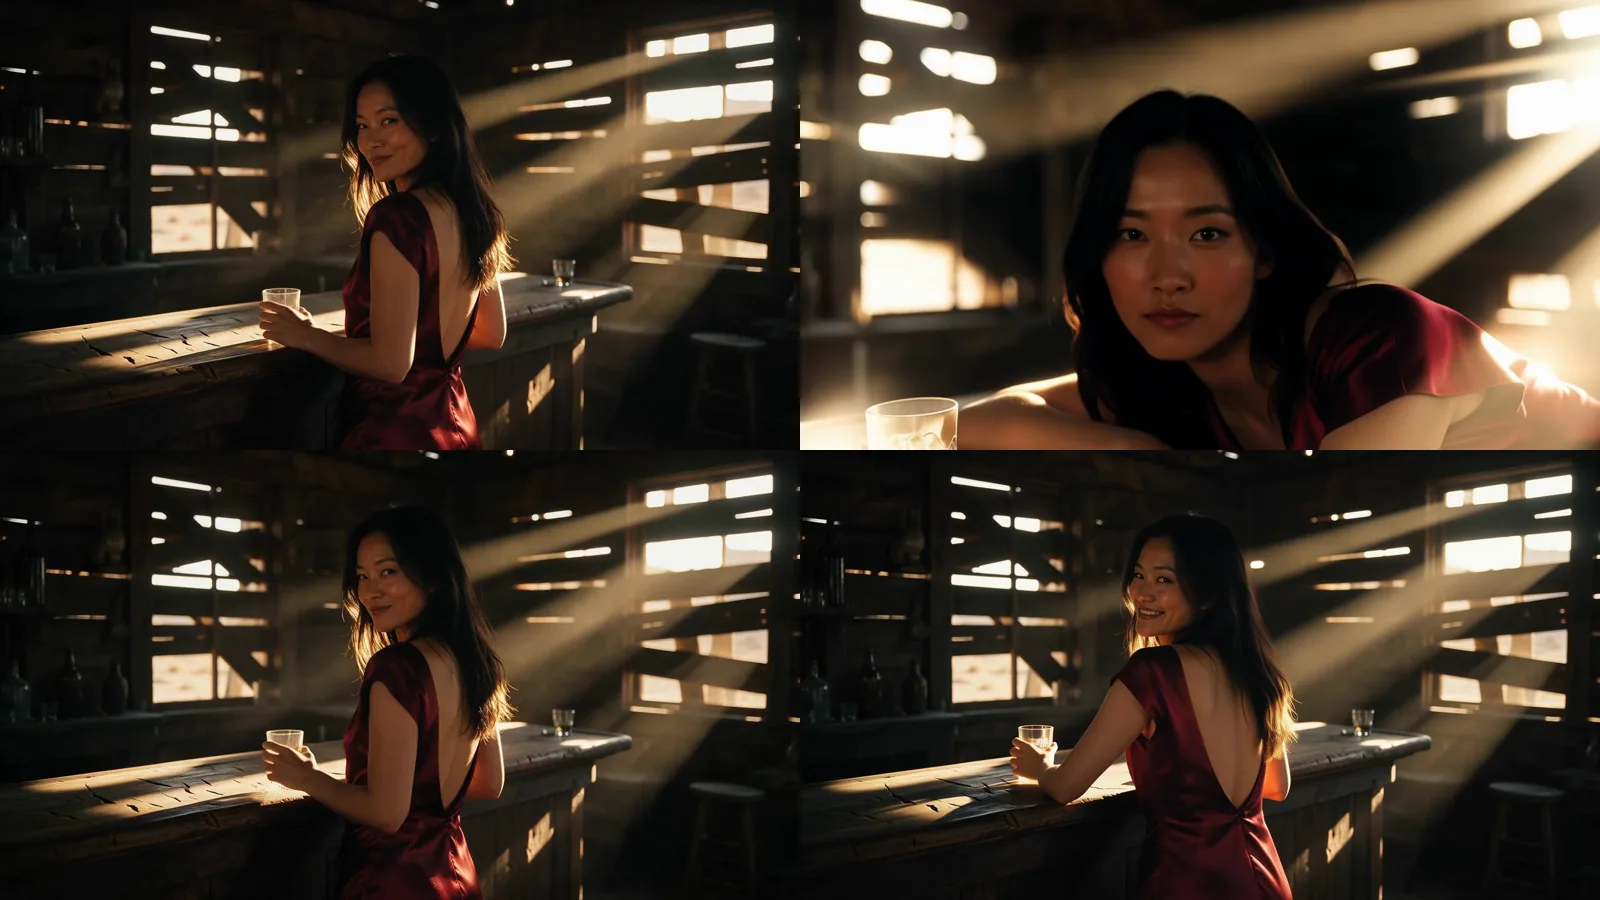
Da immagine a video, un solo frame iniziale, inizio e fine di due clip con seed diversi. In alto: "turns slowly to face the camera and leans back on her elbows", leggero avvicinamento. In basso: "takes a slow sip… lets a slow, amused smile spread", camera fissa.
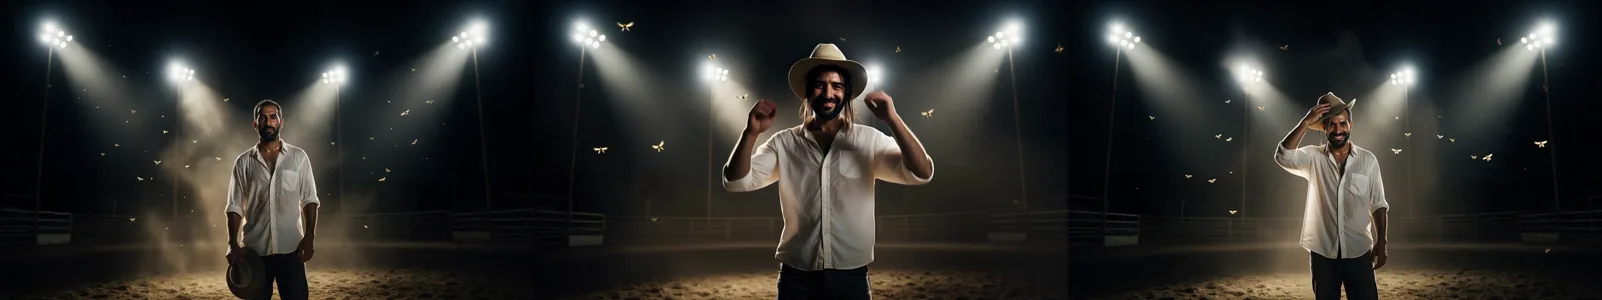
Da immagine a video, un solo frame iniziale. Al centro: gli è stato chiesto di scrollarsi la polvere dal cappello, passarsi una mano tra i capelli e mettere il cappello. A destra: gli è stato chiesto solo di asciugarsi la fronte; il modello ha messo il cappello da solo e il volto ha tenuto.
In entrambi gli insuccessi, le mani hanno attraversato il volto o il volto si è avvicinato all'obiettivo più che nella foto, quindi il modello ha probabilmente dovuto ridisegnarlo, e ha disegnato qualcun altro. Mantieni i movimenti piccoli (un sorso, uno sguardo, un sorriso), la camera fissa o lenta e, per tutto ciò che copre il volto, un solo gesto.
Il frame iniziale fissa anche il livello di partenza: da foto vestite, i prompt della nostra scala hanno portato una singola figura fino a L3 mantenendo volto e stanza, ma una scena a due persone partendo da una foto di una sola persona non è mai comparsa.
Risoluzione, durata e proporzioni
| Scelta | La nostra preferenza | Perché |
|---|---|---|
| 480p o 720p | Bozze a 480p, 720p per la clip definitiva | Metà del prezzo; 480p ha richiesto da 39 a 73 secondi di tempo del modello nelle prove di questa guida, 720p da due a quattro minuti |
| 5 o 8 secondi | 5, a meno che tu non abbia quattro o più momenti | Tre momenti hanno riempito 5 secondi; 8 secondi costano il 60% in più |
| 16:9 o 9:16 | 9:16 per i feed da telefono | Scrivi l'inquadratura per la forma, ad esempio "vertical medium shot from waist height" |
| Forma da immagine a video | Ritaglia prima la foto | La clip segue la foto |
| Seed | Fisso mentre modifichi | Lo stesso seed non promette una clip identica |
Una bozza a 480p di 5 secondi costa $0,12, una clip finale a 720p di 5 secondi $0,24 e una clip a 720p di 8 secondi $0,384, su entrambi gli endpoint. Le clip sono mute, quindi pianifica il suono in fase di montaggio: aggiungere voce e musica a un video AI NSFW.
Schemi che hanno deviato e che cosa scrivere al loro posto
| Schema | Che cosa abbiamo visto | Al suo posto |
|---|---|---|
| Aggettivi d'atmosfera | Sguardo in posa, dettagli della scena persi | Due o tre momenti visibili |
| Abbraccio completo tra due adulti | Un abbraccio, mani sfocate, un oggetto inventato | Uno o due punti di contatto |
| Un gesto raro ("loosens one cuff") | Sostituito da una mano sul colletto | Un gesto comune |
| "No lettering" nel prompt principale | Una targa inventata | Prompt negativo e inquadratura più stretta |
| Campo largo con auto o insegne | Testo inventato e persone in più | Avvicina la camera |
| Posa sdraiata a figura intera | Un piede in più; un primo piano richiesto ignorato | Inquadra dalla vita in su |
| Da immagine a video: un nuovo luogo o un avvicinamento verso l'obiettivo | Un nuovo volto | Un secondo frame iniziale, movimenti piccoli |
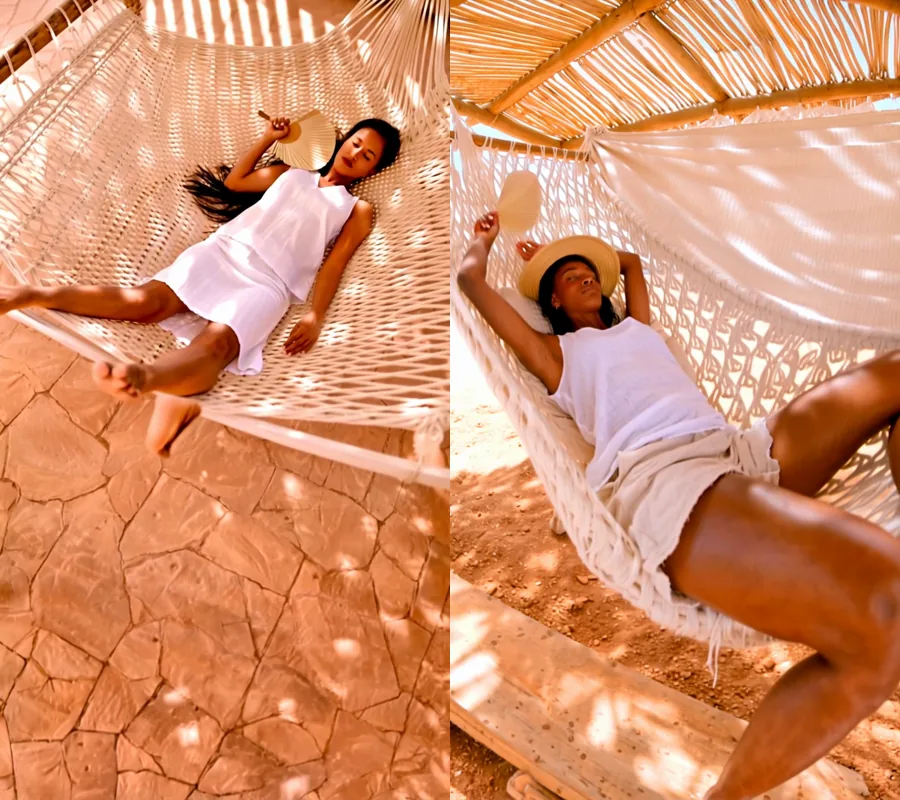
Da testo a video, 720p, 9:16, due riprese della stessa inquadratura da sdraiata, dalle nostre esecuzioni del 5 ottobre. Il prompt a destra chiedeva il volto e le spalle in primo piano. Nessuno dei due è stato mantenuto.
Lista di controllo del prompt
Prima di pagare una ripresa a 720p:
- La riga del soggetto dice "adult" e indica una fascia d'età; la riga dell'abbigliamento indica capo, tessuto, colore e stato.
- Due o tre momenti d'azione visibili, in ordine, con gesti comuni e senza aggettivi d'atmosfera al loro posto.
- Un movimento di camera, con un'inquadratura abbastanza stretta da lasciare fuori insegne, targhe, schermi e persone in più; il luogo descritto dai suoi oggetti.
- Due persone solo se servono: abbigliamenti distinti, uno o due punti di contatto, un momento del volto con cui chiudere.
- Da testo a video: un breve prompt negativo che nomina i tuoi problemi reali. Da immagine a video: una foto ritagliata, la stessa stanza, piccoli movimenti.
- Una bozza a 480p di 5 secondi con seed fisso, poi 720p per quella buona.
Se ti serve il suono insieme all'immagine, LTX-2 19B aggiunge una traccia audio a ogni clip, e la nostra guida ai prompt per video AI senza censura confronta come si comporta uno stesso prompt tra i vari modelli.
FAQ
Come si scrivono i prompt NSFW per HunyuanVideo 1.5?
Scrivi una lista di inquadrature: un adulto, l'abbigliamento, due o tre piccole azioni in ordine, un movimento di camera, poi la luce e una breve etichetta di stile. Nelle nostre 50 prove ogni richiesta da L1 a L3 è tornata come scritta, mentre le scene intime a due persone sono state attenuate ogni volta, quindi per i lavori per adulti tieni una persona per clip.
Come si trasforma un'immagine in un video con un prompt?
Usa l'endpoint da immagine a video e descrivi solo ciò che accade dopo nello stesso luogo: una piccola azione, un momento del volto e la camera. La foto fissa già volto, abbigliamento e luce. I prompt che mandavano la persona altrove hanno staccato su una nuova inquadratura con un volto diverso in entrambi i nostri seed.
Hunyuan ha il video da immagine?
Sì. HunyuanVideo 1.5 ha un endpoint da testo a video e un endpoint da immagine a video. La clip da immagine a video mantiene la forma della tua foto e il suo prompt è facoltativo.
HunyuanVideo 1.5 usa un prompt negativo?
Da testo a video, sì. È stato accettato in ogni prova in cui ne abbiamo passato uno, e nominare un problema specifico ("extra people") lo ha eliminato, ma una scritta inventata è comunque passata una volta. Da immagine a video non ha un campo per il prompt negativo.
Perché la mia clip di HunyuanVideo è tornata attenuata?
Se era una scena intima tra due adulti, è un limite del modello stesso: tutte le nostre 8 prove a quel livello sono tornate attenuate, senza alcun rifiuto. Se era un adulto solo, rendi concrete le azioni; gli aggettivi d'atmosfera ci hanno dato clip in posa e statiche che risultavano caute.
Perché la mia clip da immagine a video è al rallentatore?
Non l'abbiamo misurato noi. Quando un utente ha segnalato il rallentatore nel tracker di GitHub dell'editore, i maintainer hanno consigliato di descrivere nel prompt azioni più rapide, per esempio "turns quickly and laughs" invece di "slowly turns".