Hai scritto una scena, ma il clip è risultato più blando o è stato rifiutato. Distingui prima i limiti di contenuto del modello da un’azione poco chiara o da un’immagine iniziale che contraddice il prompt.
In breve: il modello conta più delle parole. Nei nostri test di settembre 2026, prompt semplici e diretti hanno prodotto risultati corrispondenti nelle scene campionate su MiniMax H3, Wan 3.0, Wan 2.6, Wan 2.5, Seedance 2.5 e LTX 2.5, mentre H3 Max e Wan 2.2 rifiutano o attenuano la maggior parte dei prompt ai livelli superiori.
Categorie: L1 allusivo, L2 NSFW moderato, L3 NSFW avanzato, L4 scene adulte più intense, L5A contenuti adulti aggiuntivi.
La versione in 30 secondi
- Da testo a video, scegli prima il modello: MiniMax H3, Wan 3.0, Seedance 2.5 o LTX 2.5. Poi specifica azione e inquadratura.
- Da immagine a video, componi prima il fotogramma iniziale. Il prompt dirige il movimento da quel punto di partenza visivo.
- Cinque parti, in quest’ordine: soggetto, azione, camera, luce, suono. Due o tre azioni ogni 5 secondi.
- Le bozze costano poco: 5 secondi costano $0.095 su Wan 2.2 Spicy a 480p e $0.185 su MiniMax H3 a 768p.
Prova MiniMax H3 da testo a video →
Lavori con un solo modello? La guida ai prompt MiniMax H3 e la guida ai prompt Seedance 2.5 approfondiscono l’argomento.
Come scrivere un prompt video senza censura: cinque parti, in ordine
Un modello video rende ciò che nomini e inventa il resto. Il prompt 5, smontato:
| Parte | Cosa scrivere | Dal prompt 5 |
|---|---|---|
| Soggetto | «Adult», chi, abbigliamento, dove | An adult woman in an oversized linen shirt wakes on a sheepskin rug by a loft window |
| Azione | Una breve sequenza di azioni collegate | She rolls onto her back, stretches, sits up, then turns and looks into the lens |
| Camera | Un solo movimento, in una frase a sé | One slow dolly-in at floor height. |
| Luce | Una fonte e il suo colore | Soft white window light, dust in the air. |
| Suono | Cosa si sente, oppure «no music» | Birdsong outside, quiet room tone, no music. |
- Dillo chiaramente. Nomina abiti e oggetti con parole semplici.
- Adatta le parole all’input. Dal testo, descrivi personaggi, abiti e ambiente. Da un’immagine, concentrati su ciò che cambia mantenendo chiara la scena esistente.
- Adatta le azioni alla durata. Una piccola azione diluita nel clip appare lenta; sei azioni compresse ne fanno saltare alcune. Usa un paragrafo scorrevole e un movimento di camera. La lunghezza non è il limite (Wan 2.6 accetta 1.500 caratteri, H3 7.000).
- Scrivi ciò che vuoi, non ciò che devi evitare. Una ripresa H3 piena di divieti si è bloccata; “stays fully on for the entire shot” ha mantenuto un abito per tutto un clip H3.
- Specifica che tutti sono adulti e, con due persone, chi fa cosa. Evita “8k, masterpiece” e considera “cinematic” quasi vuoto da solo: grana, profondità di campo e un movimento di camera preciso fanno il lavoro.
- Disattiva l’espansione per un prompt preciso. È disattivata per impostazione predefinita su Wan 3.0 e Wan 2.6; disattivala su Wan 3.0 Pro, dove è attiva. L’espansione riscrive il prompt: può sviluppare un’idea di una riga o cambiare un brief dettagliato.
Un clip attenuato, con il prompt riscritto
Un brief vago lascia al modello l’azione, l’inquadratura e il tono da inventare. Chiarirlo aiuta quando il clip viene generato ma non rispecchia la tua intenzione; non risolve ogni rifiuto. Una tipica prima bozza debole:
A beautiful sensual woman in a bedroom, cinematic, moving slowly, don't zoom, 8k masterpiece.
La stessa scena in cinque parti:
An adult woman in a white cotton shirt sits on the edge of an unmade bed in morning light. She pulls her hair over one shoulder, then turns and looks into the lens. Static camera at mattress height. Soft window light from the left. Sheets rustling, quiet room tone.
Cosa è cambiato: “beautiful sensual” è diventato abiti, luogo e azione precisi; “slowly” e “don't zoom”, due azioni e una camera statica; luce e suono sono specificati. Se il risultato continua a deviare, cambia una cosa per esecuzione e mantieni il seed quando il modello lo offre (Wan 3.0, Seedance, LTX 2.5).
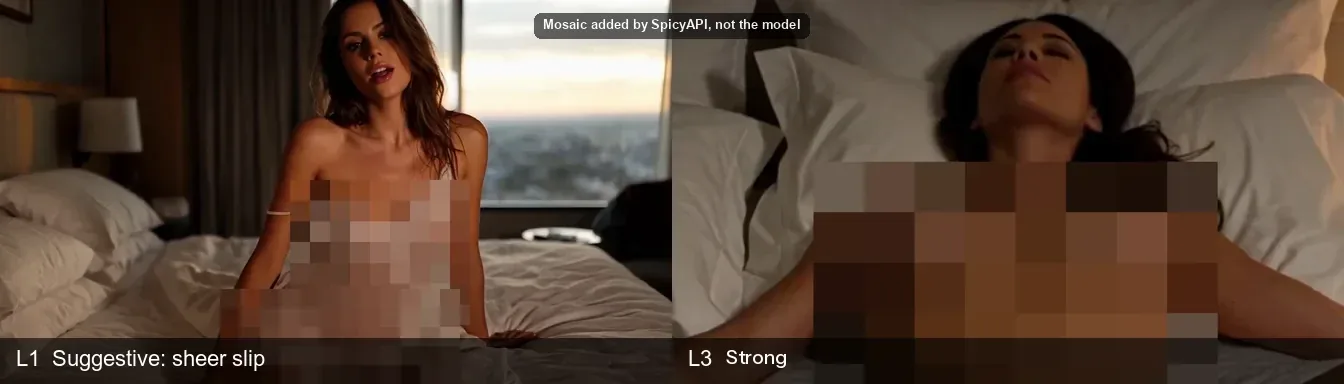
MiniMax H3 da testo a video. A sinistra: una riga del soggetto L1. A destra: una riga del soggetto L3, ritagliata. Il mosaico è nostro.
Da testo a video o da immagine a video: chi decide fin dove si arriva
Da testo a video: decide il modello
Per scene adulte più intense, scegli Wan 3.0, Seedance 2.5 o LTX 2.5 prima di perfezionare le parole. Le vecchie versioni base Seedance 2.0, Fast e Mini spesso attenuavano l’azione. Scegli anche il tipo di input, oltre alla famiglia: un risultato da testo non indica come lo stesso modello animerà un’immagine.
Nomina l’ultima azione. Wan 3.0 può continuarla oltre quanto intendevi, quindi dai alla ripresa una conclusione chiara.
Da immagine a video: l’immagine fissa il livello, il prompt la muove
L’immagine stabilisce la scena visibile. Inserisci stile e composizione desiderati nell’immagine, invece di chiedere a un prompt più intenso di ricostruire una scena più blanda. MiniMax H3 e Vidu Q3 tendono a restare vicini all’immagine fornita; Seedance, Wan 3.0 e LTX 2.5 possono svilupparla ulteriormente.
Il prompt dirige il movimento. Cambiare la stanza a parole può spostare lì tutta la scena; mantieni l’azione coerente con l’immagine. Il test Vidu Q3 mostra altri comportamenti specifici del modello.
Per un finale preciso, aggiungi un fotogramma finale su H3, Seedance 2.5, LTX 2.5 o Wan 3.0 da immagine a video. Fai corrispondere soggetto, abiti e luce nei due fotogrammi.
Wan 2.6 da immagine a video segue la forma dell’immagine, quindi ritagliala prima di caricarla. H3 Spicy, Vidu Q3 Spicy, LTX 2.3 Spicy, Seedance 2.5 Spicy e Wan 3.0 possono animare un’immagine senza prompt; scrivine uno quando conta il movimento. Prepara l’immagine con un modello di immagini senza censura.
15 prompt video senza censura da copiare, per scena
Adatta questi esempi non espliciti cambiando personaggi adulti, scena e azione, mantenendo chiari camera e finale.
1. In prima persona, accanto al letto (da testo a video)
Prova su LTX 2.5: indica dove si trova la camera prima di descrivere cosa fa la donna.
First-person point of view: the camera is a person lying back against the headboard of a bed at night, looking toward the end of the bed. An adult woman in a long ivory silk robe over a black slip dress steps up, kneels onto the mattress and leans down toward the lens with one hand planted beside it, her hair falling forward around her face. She stops close, tilts her head, smiles, and reaches out and taps one fingertip against the lens. Warm bedside lamp rim light, deep shadow, shallow focus, gentle handheld drift, 35mm film grain.
2. Una vestaglia e uno sguardo, da un’immagine (da immagine a video)
Prova su Vidu Q3 Spicy: prompt facoltativo. Un’azione, un suono, un movimento di camera; l’immagine fornisce il resto.
She finishes pouring, sets the flask down and lifts her eyes to camera with a small smile, steam rising from the cup, the yukata sliding a fraction lower on her shoulder. Paper shoji glow, evening cicadas, very slow push-in.
3. Vapore e uno sguardo indietro (da immagine a video)
Prova su MiniMax H3 Spicy: un movimento continuo; lascia al vapore il finale. Non c’è un interruttore audio, quindi aggiungi il suono nel montaggio se ti serve.
She rolls her shoulders back and stretches upward in the cedar heat, water running the length of her spine. She turns her head to look back over one shoulder into the lens, then steps forward into the billowing steam. The vapour boils up around her and swallows the far wall. Slow handheld drift following her, warm cedar light, condensation crawling down the glass. Cinematic, shallow depth of field, heavy film grain.
4. La vasca, voltandosi verso la camera (da testo a video)
Prova su Seedance 2.0: suono senza costi extra e seed. Se restituisce un errore di copyright, riprova o usa Seedance 2.0 Fast o 2.5.
An adult woman sits on the rim of a clawfoot bath in a dark tiled bathroom at night, a white towel wrapped around her. She pins her wet hair up with both hands, turns her head toward the camera in profile, then lowers her arms and looks straight into the lens. Slow push-in from the doorway. One warm wall sconce, steam fogging the mirror behind her. A dripping tap, quiet room tone.
5. Luce del mattino, da sola, da testo (da testo a video)
Prova su Wan 2.6: resta vicino alle tue parole.
An adult woman in an oversized linen shirt wakes on a sheepskin rug in front of a tall loft window in morning light. She rolls onto her back, stretches both arms above her head, sits up, then turns and looks straight into the lens with a slow smile. One slow dolly-in at floor height. Soft white window light, dust in the air. Birdsong outside, quiet room tone, no music.
6. La bozza testuale più economica (da testo a video)
Prova su Seedance 2.0 Mini: il Seedance più economico. Dai al soggetto qualcosa di quotidiano da fare.
An adult woman in a white cotton sundress lies on her stomach across a rumpled white bed in afternoon light, reading a paperback, ankles crossed in the air. She lowers the book, rolls onto her side toward the camera and props her head on one hand, then laughs at something off screen. Static camera at mattress height. Warm sun through half-closed blinds, striped light across the sheets. Pages turning, a ceiling fan ticking.
7. La tua immagine: scrivi solo il movimento (da immagine a video)
Prova su MiniMax H3: mantieni la scena esistente e descrivine la continuazione.
She tips her head back under the water and runs both hands through her wet hair, then turns to face the camera and wipes the water from her eyes with the back of her wrist. Steam drifts across the glass behind her. Static camera at chest height. Running water, a soft echo, no music.
8. Coppia: vento sul balcone (da testo a video)
Prova su Wan 3.0 Prime: circa $0.31 per cinque secondi a 480p; un’azione condivisa, un movimento di camera.
Golden hour on a hotel balcony: she stands at the rail in a silk robe that lifts and falls in the wind, and he comes up behind her and closes both arms around her waist. She leans back into him and turns her face up to his. The robe streams sideways, the city hazes gold below. Slow orbit around the pair at the rail. Cinematic, shallow depth of field, heavy film grain.
9. Coppia: il sedile posteriore (da testo a video)
Prova su Wan 2.6, per lo stesso motivo del prompt 5. Questo file di esempio non ha una traccia audio.
A couple in a rain-streaked car at night: she climbs across from the passenger seat into his lap and takes his face in both hands. He slides a hand up her back and the window fogs where her shoulder presses it. Rain runs down the glass, headlights sweep past and go. Slow push in from the back seat, warm dashboard glow against cold rain light. Cinematic, shallow depth of field, heavy film grain.
10. Coppia: due donne al drive-in (da testo a video)
Prova su Wan 3.0: suono attivo o disattivato e seed. Abiti per ogni persona, poi chi si muove per primo.
35mm film still, warm grain and halation. Two adult women lie back in the open tailgate of a station wagon at a drive-in cinema, a plaid blanket over their legs; one wears a white ribbed tank top, the other a red gingham bikini top and denim shorts. The projector beam flickers across them; one turns, brushes hair from the other's face, and they kiss slowly as the screen light shifts from blue to gold. Summer night, moths in the beam, loose handheld frame.
11. Camera: la discesa della gru (da testo a video)
Prova su LTX 2.5: fino a 4K, con seed. La camera ha le sue tre parole.
Ultra-detailed cinematic shot: an adult woman in a floor-length emerald silk gown descends a marble staircase in an empty opera house, the high slit opening across her leg with each step, chandelier light glittering through the fabric. Slow crane down, immaculate texture detail, orchestra tuning drifting up from the pit.
12. Camera: prima persona, da un’immagine (da immagine a video)
Prova su Wan 2.6 Spicy: $0.475 per cinque secondi a 720p; l’immagine stabilisce l’inquadratura. Per una soggettiva, muovi la camera come un corpo: un’oscillazione, non una gru.
Her toes flex and hook deeper into the silk, one knee slowly straightening, the sheets sliding and rippling under her legs. The slatted bars of light creep across the bed as the blind stirs in the draught. Handheld point-of-view sway, warm red and gold, quiet morning room tone.
13. Rallentatore, di proposito (da testo a video)
Prova su Wan 3.0 Pro: minimo 1080p, circa $0.72 per cinque secondi; disattiva l’espansione del prompt, attiva per impostazione predefinita su Pro. Scrivi “slow-motion” una volta all’inizio; evita poi “slowly” nei verbi.
Slow-motion perfume commercial. An adult woman in a backless black gown turns away from a rain-lashed window, the low back of the dress catching a single hard key light down her spine, droplets of water flicking from her hair as she moves. Macro-sharp fabric detail, deep shadow, 4K product-film polish, low cello note and rain.
14. Guida il suono: il bar (da testo a video)
Prova su Seedance 2.0: suono senza costi extra. Ogni suono proviene da qualcosa sullo schermo. Se restituisce un errore di copyright, riprova o usa Seedance 2.0 Fast o 2.5.
Photorealistic live-action, not animation. A real adult woman in a chocolate satin robe works behind a dim neon bar, a large fluffy faux fox tail accessory clipped at the small of her back. She shakes a cocktail, turns to set the glass on the counter and the tail sways with the movement, then she looks back at camera with a teasing smile. Warm red lantern light, 35mm grain, slow push-in, ice rattling and low bar chatter.
15. Che resti vestita: una versione sicura da un modello Spicy (da immagine a video)
Prova su Seedance 2.0 Fast Spicy: circa $0.41 per cinque secondi a 480p. Alcuni clip di test Spicy hanno cambiato gli abiti senza richiesta. Nomina ciò che deve restare indossato; controlla il risultato invece di considerare l’istruzione un blocco garantito.
First person point of view, the camera stays where it is on the pillow and does not move. She lowers herself closer toward the lens, her long hair falling forward around the edges of the frame, and holds eye contact. She keeps the black lace top and the black satin robe on the whole time and stays fully dressed. Candlelight flickers behind her; the background stays black. Only her movement, no camera move, no cut.
Cosa viene attenuato e cosa passa
Distingui l’errore restituito da un clip generato ma più blando. La policy del modello, la validazione degli input e un brief contraddittorio richiedono correzioni diverse.
| Hai mandato | A | Cosa è tornato | Manda invece |
|---|---|---|---|
| Un prompt L5A | Wan 2.2 da testo a video | Rifiutato, non addebitato (anche L1 rifiutato) | Wan 3.0, Wan 2.6 o Wan 2.5 da testo a video |
| Un prompt L4 su un’immagine L3 | H3 Max da immagine a video | Rifiutato | MiniMax H3 da immagine a video |
| Un prompt L5A su un’immagine L3 | Wan 2.2 da immagine a video | In parte mantenuto, il resto attenuato | Wan 2.2 Spicy o Wan 3.0 da immagine a video |
| Un prompt L4 | H3 Max da testo a video | Una scena molto più blanda, addebitata; esecuzioni successive rifiutate o attenuate | MiniMax H3 da testo a video: come scritto |
| Un prompt L4 | HappyHorse 1.1 da testo a video | Prompt rifiutato, non addebitato; L3 per lo più accettato | MiniMax H3 da testo a video |
| Parole forti, immagine innocua | Seedance da immagine a video | Diversi clip blandi | Componi l’immagine per la scena prevista |
| Un prompt L4 su un’immagine L3 | Seedance 2.0, 2.0 Fast, 2.0 Mini da immagine a video | Per lo più attenuato | Seedance 2.5 o Wan 3.0 da immagine a video |
| Un semplice prompt L1 | Seedance 2.0 da testo a video | Errori di copyright ripetuti | Riprova, o Seedance 2.0 Fast o 2.5 da testo a video |
| Un’immagine L3, senza prompt | H3 da immagine a video; Vidu Q3, Pro, Turbo | Respinto, non addebitato | Una riga di movimento |
| Video di riferimento L3 | Wan 2.6 da riferimento a video | Rifiutato, non addebitato | Wan 3.0 da riferimento a video |
| Parole semplici o un’etichetta di genere | Wan 2.6 da testo a video | Entrambi come scritti | Uno qualsiasi |
Un rifiuto normalmente libera la preautorizzazione; le eccezioni sono nella pagina del modello. Controlla settled e cost (policy). Un clip attenuato viene addebitato, quindi controlla i fotogrammi.
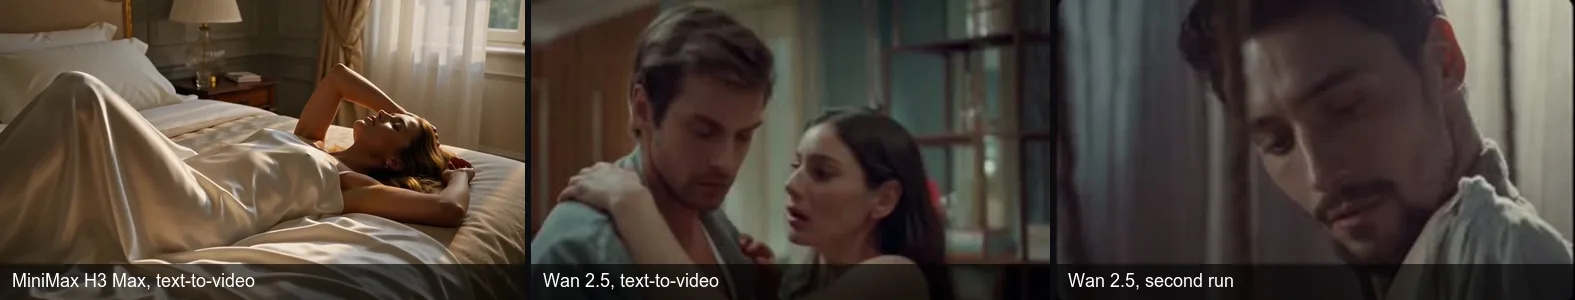
Ecco come appare «attenuato». A sinistra: MiniMax H3 Max da testo a video, prompt L4. Al centro e a destra: Wan 2.5 da testo a video, il nostro prompt L5A e una seconda esecuzione riformulata. Fotogrammi non modificati, tutti addebitati. Le esecuzioni successive di Wan 2.5 hanno realizzato questa categoria come richiesto; questi fotogrammi mostrano i precedenti risultati attenuati.
Un prompt, più modelli: cosa abbiamo visto davvero
Un brief con contenuti adulti aggiuntivi ha prodotto ritmi e messe in scena diversi tra i modelli:
| Modello | Cosa ha fatto con lo stesso brief | Per il tuo prompt |
|---|---|---|
| MiniMax H3 | Ogni elemento come scritto | Nomina tutto ciò che vuoi |
| Modelli Wan 3.0 | Ha realizzato il brief adulto, poi aggiunto altre azioni | Nomina l’ultima azione, controlla il finale |
| LTX 2.5 | Ha seguito il testo; da un’immagine ha richiesto azioni esplicite e mostrato arti fusi | Da un’immagine, scrivi due o tre azioni |
| Wan 3.0 Prime, immagine | Ha mantenuto sola la persona nell’immagine | Metti nell’immagine ciò che ti serve |
| Wan 2.2 Spicy | Ha introdotto una seconda persona | Controlla che non spunti nessuno in più |
| Vidu Q3, Q3 Spicy | Ha aggiunto elementi L5A e una seconda persona; ha illuminato la stanza di rosso | Nomina la stanza e la luce che hai |
| Seedance 2.0 Fast | È rimasto vicino all’immagine e ha attenuato l’azione più intensa richiesta | Metti l’azione nell’immagine |
| Seedance 2.0 Spicy, 2.0 Fast Spicy, LTX 2.3 Spicy | È salito a L4 senza richiesta | Usa MiniMax H3 da immagine a video o specifica il finale e controlla gli ultimi fotogrammi |
Due versioni della stessa scena di moda mostrano perché la durata deve far parte del brief di movimento.
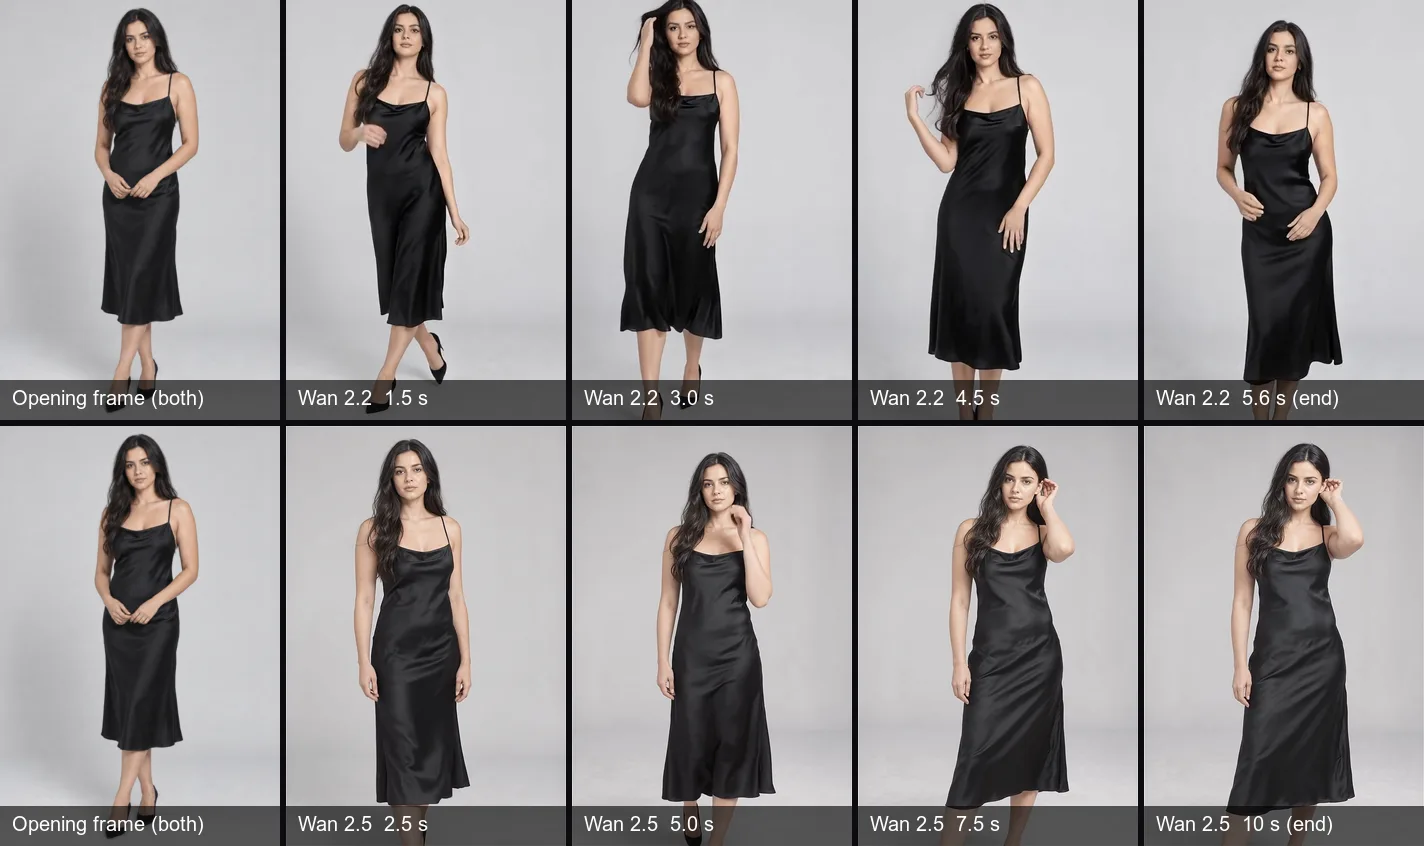
Stessa immagine, prompt di movimento molto simili. In alto: Wan 2.2, 720p, 5,8 secondi. In basso: Wan 2.5, 1080p, 10 secondi. Clip Wan 2.2 · Clip Wan 2.5.
Il brief di movimento condiviso era:
She shifts her weight, turns her shoulders toward the lens and takes two slow steps forward, the satin of the dress catching the light as it moves. She tucks her hair behind one ear and holds the look. Locked camera, clean grey studio.
Wan 2.2 ha completato i passi entro 1,5 secondi ed è tornato verso la posa iniziale; Wan 2.5 ha distribuito le azioni su dieci secondi e mantenuto l’ultima. Adatta le azioni alla durata e dai al finale qualcosa da mantenere.
Dove le clip vanno storte, e la soluzione
| Cosa vedi | Soluzione |
|---|---|
| Rallentatore, movimenti rigidi | Due o tre azioni ogni 5 secondi, niente «slowly» su ogni verbo; su Wan, aggiungi «real-time speed» |
| Da immagine a video si muove appena | Solo verbi, senza descrivere l’immagine |
| L’intero clip si blocca | Se il prompt vieta soprattutto il movimento, prova una breve sequenza di azioni positive; semplifica prima di aggiungere istruzioni |
| Un volto diverso a ogni esecuzione | Riutilizza un’immagine chiara o un riferimento del personaggio; mantieni il seed dove disponibile. MiniMax H3 base e Vidu Q3 Spicy non hanno un campo seed |
| Una scena attenuata o più innocua | Passa a un modello senza censura (H3 invece di H3 Max, Wan 3.0 invece di Wan 2.2) o parti da un’immagine al livello desiderato |
| La camera stacca su un’altra inquadratura | “One continuous shot, no cuts”; mantieni shot_type su single (predefinito su Wan 2.6) |
| La camera si avvicina da sola | «Static tripod shot: the framing stays as in the first frame»; su Wan, metti «zoom, push-in, close-up» nel prompt negativo quando c’è |
| Va oltre quanto chiesto | Specifica il finale, aggiungi un fotogramma finale compatibile dove disponibile o prova un’attività i cui risultati restano più vicini al brief |
| Una riscrittura cambia tutto | Cambia un campo per esecuzione e mantieni il seed dove disponibile; disattiva l’espansione |
| Musica che non hai chiesto | H3 aggiunge audio a ogni clip: nomina il suono e aggiungi «no music» |
| Nessun suono | Aggiungi il suono nel montaggio o usa un’attività audiovisiva. H3 Spicy non ha un interruttore audio; controlla la traccia consegnata |
Più lungo di una ripresa? La guida ai video senza censura più lunghi concatena le clip a partire dall’ultimo fotogramma.
Promemoria dei prompt: una riga per modello
Prezzo: cinque secondi alla risoluzione più economica disponibile. Sono costi di output; le attività con video di riferimento possono aggiungere addebiti separati.
| Modello | Parte da | Scrivilo così | 5 s da |
|---|---|---|---|
| MiniMax H3 | Testo, immagine, immagini/video di riferimento | Parole semplici, tutto nominato; l’immagine stabilisce il volto. Guida | $0.185 |
| MiniMax H3 Spicy | Immagine | Prompt facoltativo; basta un’azione; nessun interruttore audio | $0.19 |
| MiniMax H3 Max | Testo, immagine | Da testo a video è «Filtered», da immagine a video «Softened»: i prompt dei livelli alti vanno su H3 | $0.25 |
| Wan 3.0 | Testo, immagine, immagini/video di riferimento | Nomina l’ultima azione; tende a spingersi oltre | $0.225 |
| Wan 2.6 | Testo, immagine | Resta vicino alle tue parole | $0.45 |
| Wan 2.5 | Testo, immagine | Parole semplici in entrambi i percorsi | $0.225 |
| Wan 2.2 Spicy | Immagine | Tre o quattro azioni, “real-time speed”; senza audio | $0.095 |
| Seedance 2.0 | Testo, immagine, immagini/video di riferimento | «One continuous shot, no cuts» | $0.35 |
| Seedance 2.0 Mini | Testo, immagine, immagini/video di riferimento | La bozza Seedance più economica | $0.12 |
| Seedance 2.5 | Testo, immagine, immagini/video di riferimento | Riprese da 30 secondi. Guida | $0.62 |
| Seedance 2.5 Spicy | Immagine | Prompt facoltativo; crea bozze a 480p su questo modello | $1.08 |
| LTX 2.5 | Testo, immagine | Azioni unite da «then» | $0.45 |
| LTX 2.3 Spicy | Immagine | Prompt breve o nessuno; si spinge oltre; muto | $0.095 |
| Vidu Q3 Spicy | Immagine | Nomina la stanza che hai; prompt facoltativo | $0.33 |
| Vidu Q3 Turbo | Immagine | La bozza più economica fedele all’immagine | $0.21 |
Quando cambi model, verifica gli input accettati dalla nuova attività: testo, immagine e riferimenti richiedono campi diversi.
Domande frequenti
Come si scrivono prompt senza censura per i video IA?
Usa il prompt 5 da testo o il 7 da un’immagine. Sostituisci personaggi e ambiente, mantieni un movimento di camera e scegli l’attività di input corrispondente nella tabella dei modelli.
Perché il mio video IA è tornato attenuato?
Se la categoria non è supportata, passa da H3 Max o Wan 2.2 base a un’alternativa testata. Se la scena è corretta ma il movimento no, semplifica l’azione invece di riscrivere tutta la ripresa.
Il prompt può portare un clip da immagine a video oltre l’immagine iniziale?
Sì. Alcune attività aggiungono azione, persone o un nuovo ambiente. Per preservare abiti e inquadratura, rendi esplicite queste istruzioni ed evita di descrivere un’altra stanza.
Servono eufemismi o posso scrivere in modo diretto?
Scrivi chiaramente: nomina personaggi adulti, stile e azione. Etichette di genere vaghe lasciano più spazio all’invenzione del modello.
Come mantengo la stessa persona tra una clip e l’altra?
Riutilizza un’immagine chiara o immagini di riferimento del personaggio. Mantieni coerenti acconciatura, abiti e luce, e rimuovi i volti concorrenti dalle immagini di riferimento del luogo. Consulta la guida ai video senza censura più lunghi.
Pago le clip rifiutate o attenuate?
Rifiutato: normalmente no, la preautorizzazione viene liberata. Attenuato: sì, al prezzo normale.
La tua parte
SpicyAPI non aggiunge filtri di contenuto; i modelli a monte possono comunque controllare o rifiutare gli input. Usa adulti consenzienti e materiale che hai diritto di caricare, e rispetta la legge dove pubblichi.
Lancia il tuo primo prompt
Crea un account, scegli un prompt sopra e premi Run. Crea una bozza alla risoluzione più bassa, poi rigenera a una più alta. Il resto è nel catalogo video senza censura.
Da un prompt Playground all’API
Prova prima un prompt tramite il link del modello, scegli cinque secondi alla risoluzione più bassa e controlla la ripresa completata. Per un’applicazione che deve ripetere il flusso:
Imposta SPICY_API_KEY nel tuo ambiente. Questo esempio Python 3 invia una nuova ripresa dopo che ne confermi il prezzo.
import json
import os
import urllib.request
import uuid

base = "https://api.spicyapi.ai/api/v1"
headers = {"Authorization": "Bearer " + os.environ["SPICY_API_KEY"],
           "Content-Type": "application/json", "User-Agent": "SpicyAPI-Blog/1.0"}
settings = {
    "duration_seconds": 5,
    "resolution": "480p",
    "generate_audio": False,
    "aspect_ratio": "16:9"
}
settings["prompt"] = 'A slow camera push toward the subject. Keep the setting and clothing unchanged. One continuous shot.'
payload = {"model": "bytedance/seedance-2.5/text-to-video", "input": settings}

def post(path, body):
    request = urllib.request.Request(base + path, json.dumps(body).encode(), headers)
    with urllib.request.urlopen(request, timeout=60) as response:
        result = json.load(response)
    if result.get("code") != 200:
        raise RuntimeError(result)
    return result["data"]

quote = post("/jobs/quote", payload)
if input(f"Maximum charge ${quote['maxCharge']}. Type yes to generate: ") != "yes":
    raise SystemExit("Stopped before generation")
headers["Idempotency-Key"] = str(uuid.uuid4())
print("Request key:", headers["Idempotency-Key"], flush=True)
task = post("/jobs/createTask", {**payload, "quoteId": quote["quoteId"],
                              "expectedCost": quote["estimatedCost"]})
print("Task ID:", task["taskId"])
Conserva la chiave di richiesta stampata per recuperare quella stessa richiesta; ogni nuova ripresa riceve una chiave nuova. La documentazione dell’API delle attività spiega consegna e recupero dei risultati.
Per riprese ripetute, lascia che un Agent usi un file di input approvato: CLI spicyapi tasks create --model bytedance/seedance-2.5/text-to-video --input-file input.json --wait; MCP, chiedigli di chiamare spicyapi_task_create con quel modello e input; Skill, chiedi “Use the spicyapi Skill to generate this approved shot and return the result.” CLI e MCP mostrano il prezzo prima della creazione. Consulta la documentazione di integrazione Agent.