Vai al contenuto principale

Il text-to-video MiniMax H3 trasforma un brief scritto in una clip da 5 a 15 secondi con audio generato, a 768p o 2k. Scegli tra sei proporzioni: 16:9, 9:16, 1:1, 4:3, 3:4 e 21:9.

Da $0.037/s53% sotto il prezzo di listino del produttore del modello

Playground

Input

Da testo a video
264/7000
Scrivilo come un'inquadratura: soggetto, azione, movimento di macchina, luce, suono. Le formulazioni senza censura sono accettate. almeno 1 caratteri · al massimo 7000 caratteri
16:9, 9:16, 1:1, 4:3, 3:4 oppure 21:9. Il 21:9 dà il formato anamorfico.
incide sul prezzo
768p o 2k, entrambe native. Bozza a 768p, consegna a 2k.
Durataincide sul prezzo
Secondi interi, da 5 a 15. Determina il prezzo. non meno di 5 · non più di 15
Controllo di sicurezzaDisattivato

SpicyAPI non applica nessun controllo di sicurezza a questo modello. Il tuo prompt e i tuoi media arrivano al modello così come li hai scritti, ed è il modello stesso a decidere che cosa torna indietro.

Controllo del tuo account prima di abilitare invio e prezzi.

Output

Pronto per una nuova esecuzione
Risultato di esempio

Manca il modello che ti serve?

Dicci cosa aggiungere e dove lo useresti. Le richieste arrivano a chi decide quali modelli integrare per primi.

VIDEO SENZA CENSURA CON AUDIO

L’API di MiniMax H3 in sintesi

Scrivi la scena, parti dalla tua immagine o componi il cast con delle foto: va in scena esattamente come l’hai scritta.

Livelli superati
4/4
Dal livello Lieve al più forte, ogni fotogramma verificato uno per uno.
Clip più lunga
15S
Abbastanza per una scena intera, non solo per un loop.
Risoluzione massima
2K
Bozze a 768p, la ripresa migliore in 2K.
Audio incluso
AUDIO
Ambiente, passi, musica e battute arrivano insieme all’immagine.
Foto di riferimento
9
Tieni stabili volto, outfit e ambiente da un’inquadratura all’altra.
Pronto per il verticale
9:16
Sei formati, dal panoramico 21:9 al 9:16 per Reels e TikTok.

Risultati

Cosa puoi creare con MiniMax H3

  • Da testo

    Un’inquadratura finita da un paragrafo

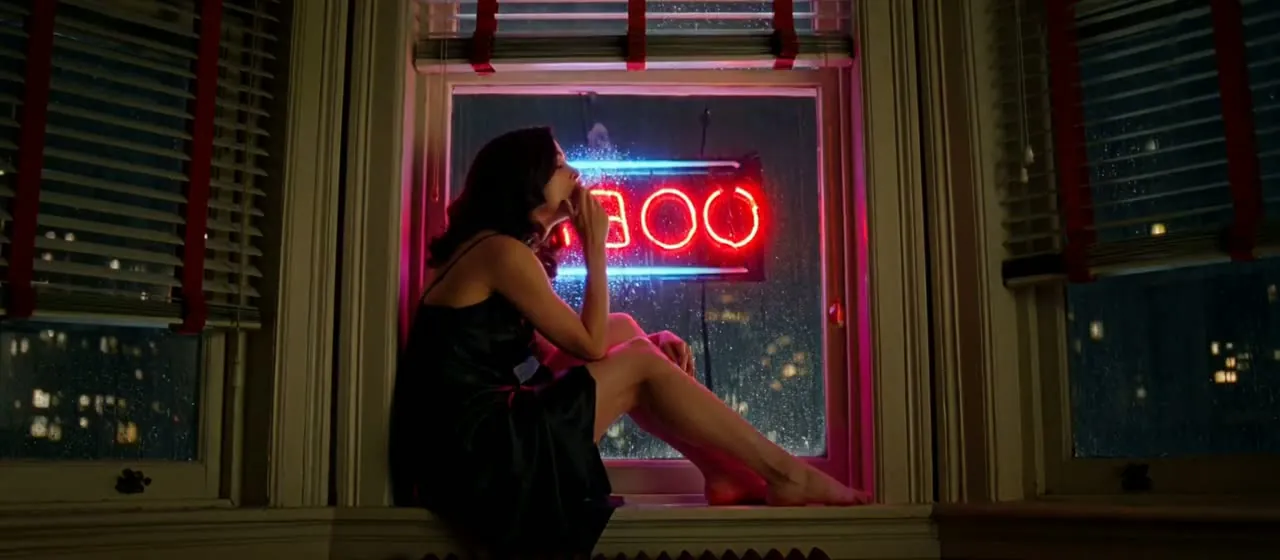
    Di’ chi c’è in scena, cosa succede, dove va la camera e cosa si sente. H3 restituisce luce, grana, movimento e una colonna sonora coerente in un’unica clip. Questa scena noir alla finestra sono quattro frasi e nient’altro.

    Da testo a video, 5 secondi a 768p in 21:9. Le ombre delle veneziane, il pulsare del neon e la lenta rotazione della testa nascono da un’unica descrizione scritta.

  • Da un’immagine

    La tua immagine, messa in movimento

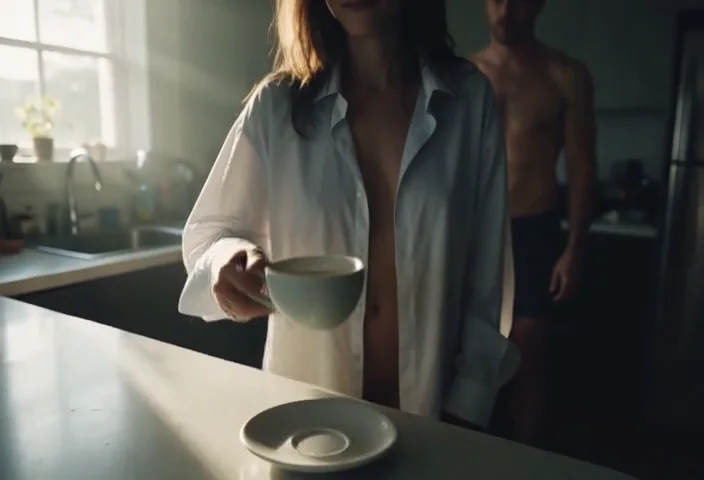
    Parti da un fermo immagine e descrivi solo cosa succede dopo. Qui l’immagine iniziale era una tazza di caffè sul bancone; la mano, la panoramica verso la camicia e l’uomo che si sveglia dietro di lei sono venuti tutti dal prompt.

    Da immagine a video, 6 secondi: il movimento di camera e la seconda persona vengono dal prompt, non dall’immagine.

  • Da riferimenti

    Stessa donna, stesso outfit, una nuova scena

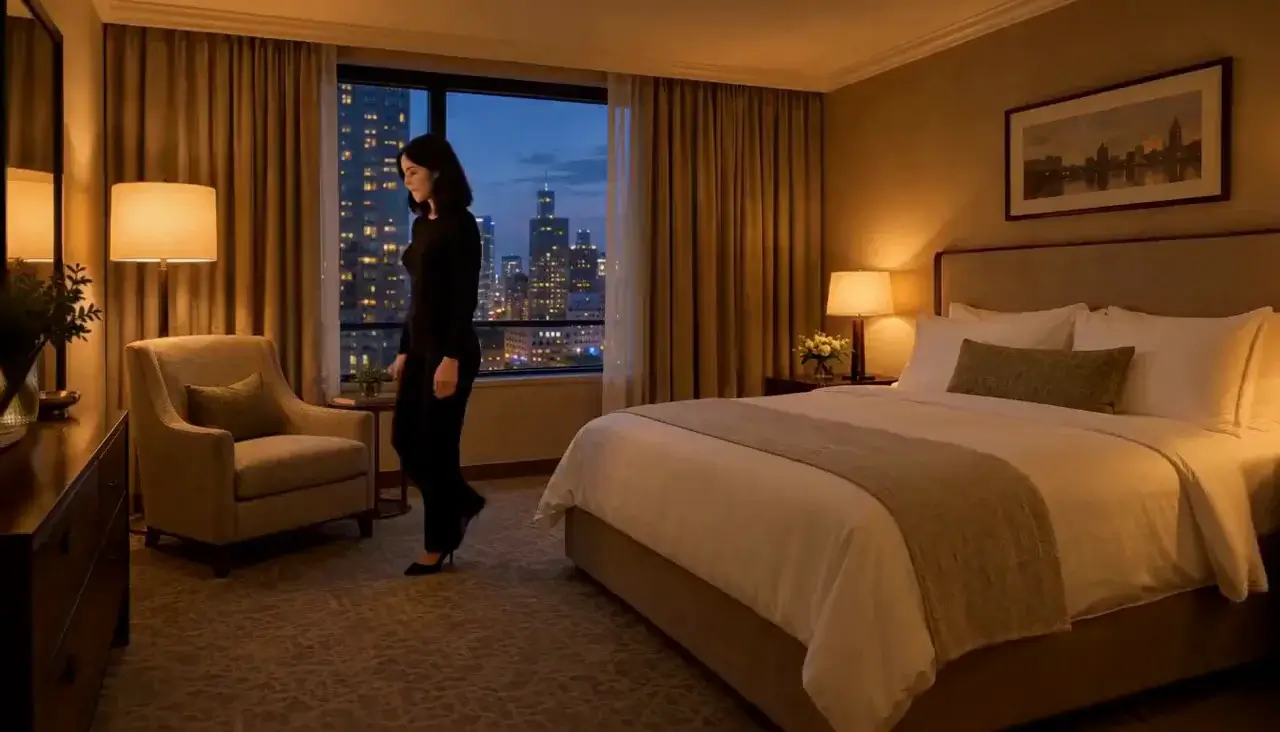
    Dagli un volto, un outfit e una stanza come foto separate e li mette insieme in un’inquadratura che non hai mai girato. È così che un personaggio resta riconoscibile da una clip all’altra.

    Riferimento in video, 6 secondi a 768p: volto, abito e stanza vengono ciascuno da una foto di riferimento separata.

  • Con l’audio

    La colonna sonora nasce insieme all’immagine

    Dialoghi, suono d’ambiente e musica vengono generati nello stesso passaggio. La frase cantata, il riverbero del locale e il brusio del pubblico in questa clip erano tutti scritti nel prompt, senza un passaggio audio a parte.

    Da riferimento a video con audio: la frase cantata, il riverbero del locale e il brusio del pubblico erano tutti scritti nel prompt.

Altre clip create con MiniMax H3

  • Da testo a video, 5 secondi a 768p: due viste della stessa persona in un’unica inquadratura, mantenute durante un lento arco di camera.
    5 s
  • 5 s
  • 5 s
  • 5 s
  • 5 s

Test dei contenuti

MiniMax H3 è senza censura? Cosa abbiamo testato

Abbiamo eseguito ogni livello sulla nostra configurazione reale e controllato ogni clip fotogramma per fotogramma. Superato significa che il contenuto era davvero sullo schermo, non solo che la richiesta è passata.

Livelli di contenuto testati su MiniMax H3, per modalità
LivelloDa testo a videoDa immagine a videoDa riferimento a video
LieveI prompt più leggeri della prova
GeneratoTestato il 22 set 2026
Non ancora testato
Non ancora testato
ModeratoDove i modelli con filtro iniziano a rifiutare
Non ancora testato
Non ancora testato
Non ancora testato
ForteLa metà della scala
GeneratoTestato il 22 set 2026
GeneratoTestato il 14 set 2026
Molto forteDove la maggior parte dei modelli comincia a frenare
GeneratoTestato il 22 set 2026
Non ancora testato
Non ancora testato
MassimoIl vertice della scala
GeneratoTestato il 22 set 2026
Non ancora testato

Generato: sullo schermo come scritto. Attenuato: generato, ma più tenue di quanto scritto. Rifiutato: respinto. Non ancora testato: non abbiamo ancora provato quel livello in quella modalità.

Come si comporta ogni modalità

Da testo a video
Ogni livello che abbiamo chiesto è arrivato sullo schermo, compresi i più forti. Quello che le sole parole non fissano è la persona: volto, corpo e abiti vengono decisi da capo a ogni generazione. Se ti serve lo stesso personaggio due volte, genera prima l’immagine iniziale e passa a immagine a video.
Da immagine a video
L’immagine iniziale viene seguita da vicino: la scena dell’immagine resta così com’è per tutta la clip. Un’immagine finale fissa la chiusura, ma sulle clip da 15 secondi la parte centrale può derivare: tieni le due immagini vicine per luce e inquadratura.
Da riferimento a video
Un riferimento viene mantenuto così come lo invii: quello che mostrava il nostro riferimento è tornato invariato nella clip. L’identità regge meglio con tre o quattro foto nitide, ognuna con un solo compito. Se riempi tutti e nove gli slot con scatti che si sovrappongono, il modello inizia a fonderli in una persona nuova.
Tutte le modalità
Tutte le immagini che abbiamo testato come immagine iniziale o come riferimento erano generate con l’IA. Le foto di persone reali sono l’unico input che non abbiamo ancora provato.

Casi d’uso

Cosa costruire con l’API di MiniMax H3

  • Scene senza censura che altre API video rifiutano

    Le scene che altre API bloccano passano al primo tentativo invece di rimbalzare su un filtro dei prompt. Scrivi la scena per il testo a video, oppure genera prima la persona esatta e anima quell’immagine quando il look deve essere preciso.

  • Clip verticali con audio per i social

    Clip 9:16 che hanno già il loro audio: un teaser di dieci secondi, un loop d’atmosfera, un momento di reazione. Fai le bozze a 768p finché il ritmo funziona, poi rigenera la ripresa migliore in 2K.

  • Un personaggio ricorrente lungo una serie

    Tieni stabili un volto, un outfit e una stanza da un episodio all’altro con le foto di riferimento, e scrivi solo cosa cambia in ogni nuova inquadratura.

  • Scene più lunghe, un’inquadratura alla volta

    Concatena clip da 15 secondi in una scena completa: l’ultima immagine di ogni clip approvata diventa la prima della successiva, così abiti, set e luce attraversano lo stacco.

Prompt

Esempi di prompt per MiniMax H3 da copiare

Incollane uno così com’è nel playground, poi cambia una cosa alla volta.

  • Da testo a video

    Finestra noir, scritta come una lista di inquadrature

    Risultato di questo prompt

    Film noir. An adult woman in a black satin nightgown sits on a wide apartment windowsill at night, one knee drawn up, exhaling cigarette smoke against the rain-streaked glass as a neon sign pulses red across her face. She turns her head slowly toward camera. Venetian blind shadows, deep blacks, 1970s grain, rain and distant traffic.

    Perché funziona. Si legge come una lista di inquadrature (chi, cosa succede, la luce e poi il suono), quindi non resta nulla da indovinare, e pioggia e traffico arrivano anche nella colonna sonora.

  • Da testo a video

    Nomina l’inquadratura, non l’atmosfera

    A woman in a silk slip dress sits on the edge of a hotel bed at dusk, looking out of the window, warm backlight, soft haze, slow push-in, cinematic

    Invece di “woman in a hotel room”

    Perché funziona. Nominare l’abito, il controluce del tramonto e il movimento di camera dà al modello un’inquadratura da girare; la versione corta lascia posa, luce e camera al caso.

  • Da immagine a video

    L’immagine imposta la scena, le parole la muovono

    Risultato di questo prompt

    The cup is lifted out of frame by a hand, then the camera tilts up: she is wearing an oversized men's shirt, and further back in the dim room a man is just getting up. Slow tilt and rack focus. Cinematic, shallow depth of field, heavy film grain, morning grey-gold.

    Perché funziona. Il prompt descrive solo cosa succede dopo la prima immagine (la mano, la panoramica, la seconda persona) e lascia il look all’immagine.

    Questa modalità parte dalla tua immagine: aggiungila nel playground prima di avviare.

  • Da riferimento a video

    Stessa donna, stesso outfit, nuova inquadratura

    Risultato di questo prompt

    Keep the woman from Picture 1 and the black lace slip from Picture 2, in the hotel room from Picture 3. She sits on the arm of the chair, crosses her legs and looks up at camera. Slow handheld drift, warm lamp, quiet room tone.

    Perché funziona. Ogni foto ha un solo compito e viene chiamata per numero, così volto, outfit e stanza si mantengono invece di mescolarsi.

Confronto

MiniMax H3 e i modelli simili: quale scegliere

ModelloModalitàDaContenutoSceglilo se
MiniMax H3Questa paginaDa immagine a video · Da riferimento a video · Da testo a video · Estensione video$0.037 / secondo generatoSenza censura — Questo modello dichiara di non applicare alcun filtro sui contenuti. SpicyAPI inoltra la richiesta senza aggiungere controlli di piattaforma; gli obblighi di legge e la verifica del consenso restano a carico del cliente.Vuoi un solo modello per una frase, un’immagine iniziale o foto di riferimento, con audio, dalle bozze economiche fino al 2K.
MiniMax H3 SpicyDa immagine a video · Estensione video$0.038 / secondo generatoSenza censura — Questo modello dichiara di non applicare alcun filtro sui contenuti. SpicyAPI inoltra la richiesta senza aggiungere controlli di piattaforma; gli obblighi di legge e la verifica del consenso restano a carico del cliente.Parti dalla tua immagine iniziale e vuoi un’edizione senza censura messa a punto con LoRA.
MiniMax H3 MaxDa immagine a video · Da testo a video · Estensione video$0.05 / secondo generatoAttenuato — Questo modello restituisce un risultato invece di un errore, ma le richieste oltre i suoi limiti tornano attenuate. La chiamata risulta comunque riuscita e viene comunque addebitata: controlla l’output, non il codice di stato. Da immagine a video — Attenuato; Estensione video — Attenuato; Da testo a video — Filtrato.Le tue scene restano al livello Lieve e vuoi la variante veloce Max, che arriva al massimo a 768p.
Seedance 2.5Da immagine a video · Da riferimento a video · Da testo a video · Estensione video$0.074 / secondo generatoSenza censura — Questo modello dichiara di non applicare alcun filtro sui contenuti. SpicyAPI inoltra la richiesta senza aggiungere controlli di piattaforma; gli obblighi di legge e la verifica del consenso restano a carico del cliente.Ti serve una singola clip più lunga di 15 secondi, o più di nove immagini di riferimento in un’inquadratura.

Prezzi

Prezzi dell’API di MiniMax H3

Una clip di 5 secondi parte da $0.185 a 768p e da $0.29 a 2K.

Il Playground mostra il prezzo esatto per le tue impostazioni prima dell’avvio. Le attività fallite o scadute di norma non vengono addebitate. Alcuni modelli addebitano i rifiuti dei contenuti come indicato nella loro pagina; verifica queste condizioni di fatturazione prima dell’invio.

Vedi tutte le fasce di prezzo

Per iniziare

Come usare l’API di MiniMax H3 in tre passaggi

  1. Passaggio 1

    Provalo nel playground

    Scegli una modalità qui sopra (una frase, la tua immagine iniziale o qualche foto di riferimento), incolla uno dei prompt di questa pagina e avvialo. Il prezzo esatto compare prima di qualsiasi addebito.

  2. Passaggio 2

    Ottieni una chiave API

    Registrati, ricarica con carta o cripto e crea una chiave nella console. Nessun abbonamento: paghi i secondi di video che generi.

  3. Passaggio 3

    Invia la stessa richiesta dal tuo codice

    Copia la richiesta dalla scheda API: è lo stesso body che il playground ha appena eseguito. La clip finita arriva al tuo webhook, oppure la recuperi con l’ID del task.

Riferimento dei parametri ed esempi di codice sono nelle schede API e Readme, in cima a questa pagina.

Perché SpicyAPI

Perché usare MiniMax H3 su SpicyAPI

  • Nessun filtro da parte nostra

    Non aggiungiamo alcun filtro dei contenuti. Quello che il modello genera è quello che ricevi.

  • Testato, non ipotizzato

    I livelli di contenuto vengono da generazioni reali che abbiamo eseguito e controllato, con la data del test sulla pagina.

  • Paghi a risultato, in dollari

    Nessun abbonamento e nessun credito. Le attività fallite o scadute di norma non vengono addebitate. Alcuni modelli addebitano i rifiuti dei contenuti come indicato nella loro pagina; verifica queste condizioni di fatturazione prima dell’invio.

  • Una chiave per tutti i modelli

    Una sola chiave API e un unico saldo coprono i modelli di immagini, video, audio e chat, così puoi esplorare più modelli dallo stesso account.

FAQ

Domande frequenti sull’API di MiniMax H3

Informazioni su MiniMax H3

MiniMax H3 è il modello video con audio di MiniMax, disponibile su SpicyAPI in queste modalità: testo a video, immagine a video, riferimento a video ed estensione video. Le clip durano fino a 15 secondi a 768p o 2K, in formati che vanno dal panoramico 21:9 al verticale 9:16. Nei nostri test del 2026-09-22 ogni livello della nostra scala di contenuti è uscito come richiesto, senza attenuazioni. SpicyAPI non aggiunge alcun filtro dei contenuti e addebita al secondo di output in dollari USA, senza abbonamento. Sei responsabile di avere i diritti e il consenso per tutto ciò che carichi e dell’uso che fai di ciò che generi.

Tutti i modelli MiniMax11

Modelli correlati e attività successive