Introduzione
MiniMax H3 Riferimenti in video genera un’inquadratura da una a nove immagini di riferimento e da un prompt che le richiama per numero: Picture 1, Picture 2 e così via. Restituisce da 4 a 15 secondi interi a 768p o 2k in uno dei sei formati, con l’audio generato insieme. Alle immagini si possono aggiungere fino a tre video e tre clip audio di riferimento, ciascun gruppo per un massimo di 15 secondi in totale.
Scegli il metodo in base al materiale di partenza
| Materiale di partenza | Metodo |
|---|---|
| una scena scritta o una sceneggiatura | MiniMax H3 Testo in video |
| un’immagine iniziale approvata | MiniMax H3 Immagine in video |
| da una a nove immagini di riferimento | MiniMax H3 Riferimenti in video |
Caratteristiche principali
Fino a nove slot numerati per le immagini
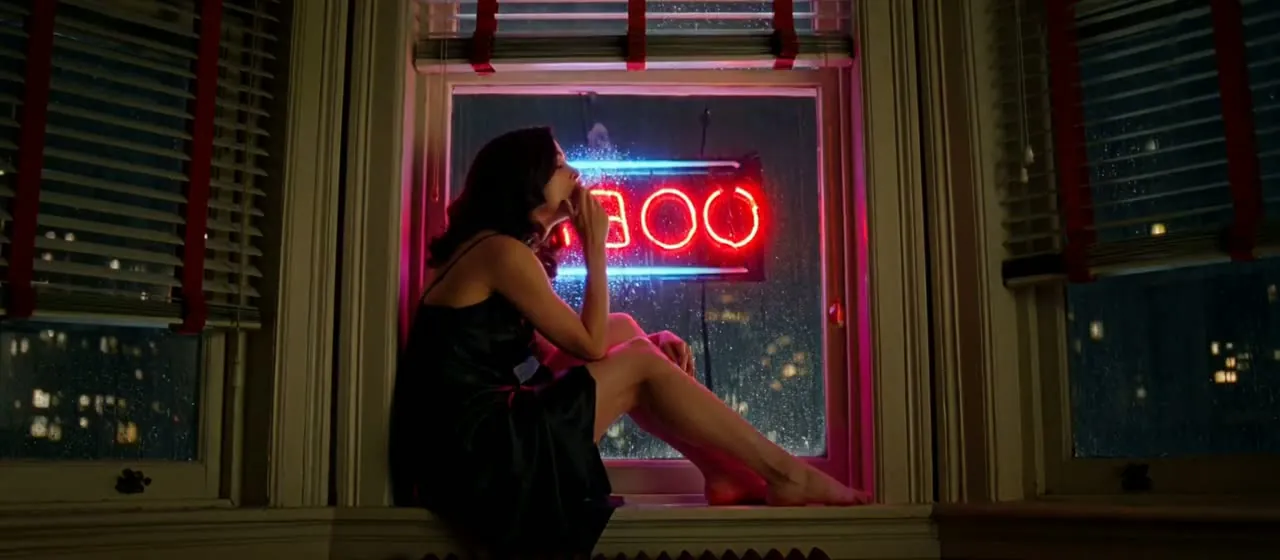
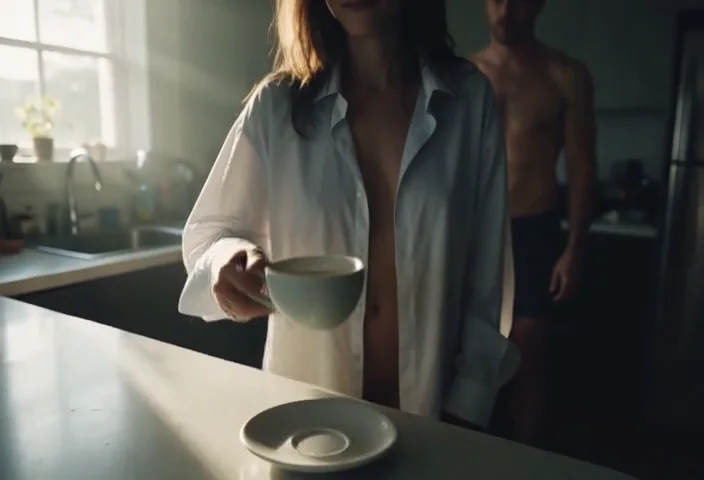
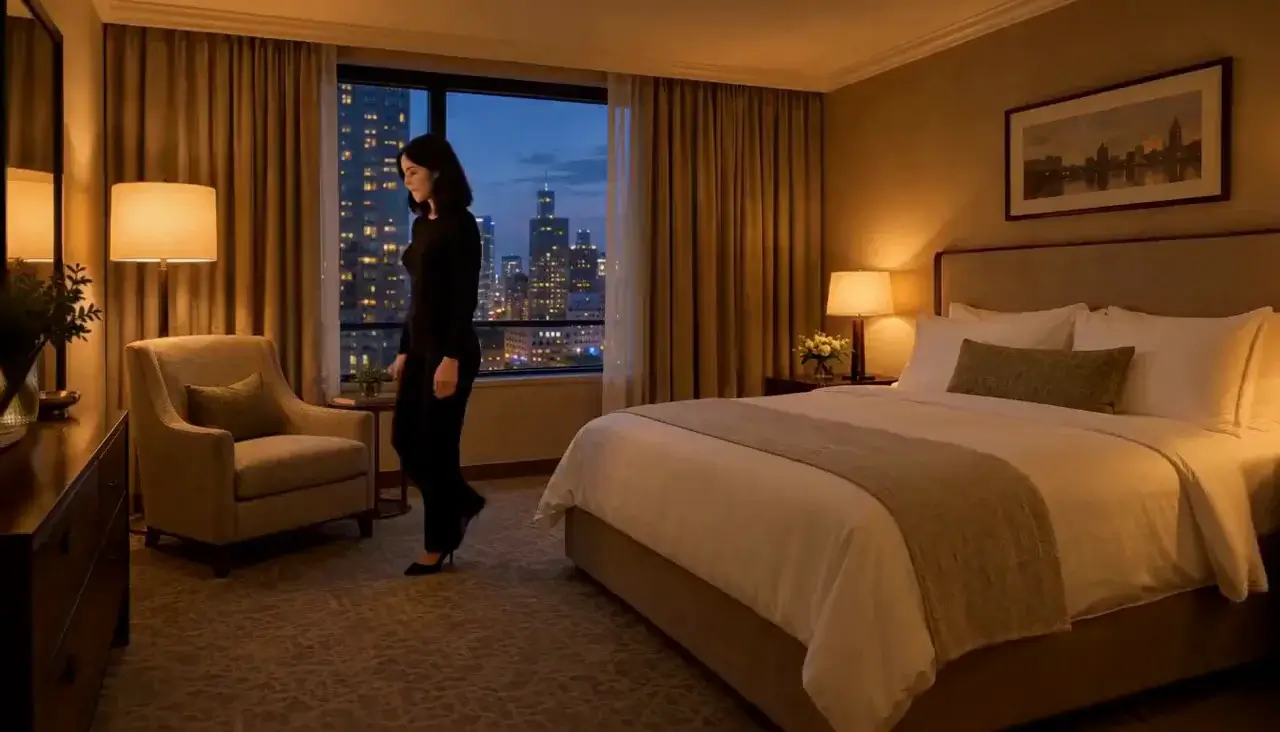
reference_image_urls accetta da una a nove immagini, e il prompt le richiama per posizione. Un’immagine può portare il volto, un’altra il costume e una terza la stanza. L'esempio di continuità del personaggio fa esattamente questo: mantiene la donna dell'immagine 1 nell'abito dell'immagine 2 dentro la camera d'albergo dell'immagine 3.
Una nuova angolazione su un set esistente
I riferimenti mantengono coerente una produzione quando la camera si sposta altrove. L’esempio red-dress-theatre-three-angles fissa con tre immagini l’interprete, l’abito e il palco, poi chiede una terza angolazione, così la nuova posizione non diventa di nascosto un’altra produzione. È stato generato in 3:4 per cinque secondi.
Movimento e suono arrivano dal prompt
Movimento e audio si possono scrivere o passare come riferimento. L’esempio voice-and-room invia due immagini, l’interprete e le luci di scena, e descrive a parole l’acustica del club: riverbero caldo e il brusio del pubblico. Un video di riferimento porta il movimento e si richiama come <Video 1>; l’audio di riferimento fissa una voce o un suono. Le prime cinque immagini di riferimento sono incluse e ogni immagine dopo la quinta aggiunge un costo; i secondi di video di riferimento hanno una tariffa al secondo propria, più bassa di quella di uscita, e l’audio di riferimento è gratuito. La stima in tempo reale riflette tutto prima dell’invio.
Parametri della richiesta
| Parametro | Obbligatorio | Nota |
|---|---|---|
prompt | Sì | Chiama ogni riferimento per numero – <Picture 1>, <Picture 2> –, di' che compito ha, poi scrivi movimento e suono. almeno 1 caratteri · al massimo 7000 caratteri |
reference_image_urls | Sì | Da una a nove immagini. Le prime cinque sono comprese nel prezzo, ogni immagine in più aggiunge un costo. almeno 1 elementi · al massimo 9 elementi |
reference_video_urls | No | Fino a tre video di riferimento, da 2 a 15 secondi ciascuno e 15 secondi in totale, per il movimento, la camera o un personaggio in azione. almeno 1 elementi · al massimo 3 elementi |
reference_audio_urls | No | Fino a tre clip audio di riferimento, WAV o MP3, da 2 a 15 secondi ciascuna e 15 secondi in totale, per una voce o un suono che la clip deve seguire. almeno 1 elementi · al massimo 3 elementi |
aspect_ratio | No | 16:9, 9:16, 1:1, 4:3, 3:4 oppure 21:9. Il 21:9 dà il formato anamorfico. |
resolution | No | 768p o 2k, entrambe native. Bozza a 768p, consegna a 2k. |
duration_seconds | No | Secondi interi, da 4 a 15. I quattro secondi sono disponibili solo a 768p. |
Prezzi
Immagini di riferimento: le prime cinque sono incluse, ogni immagine in più aggiunge un costo. I secondi di video di riferimento hanno una tariffa al secondo propria, più bassa di quella dei secondi di uscita; ogni clip si arrotonda per eccesso al secondo intero, al massimo 15 secondi in totale. L’audio di riferimento è gratuito.
| Specifiche | Prezzo |
|---|---|
| $0.037 / secondo |
| $0.058 / secondo |
Casi d’uso
Mantenere un personaggio ricorrente tra le inquadrature
Riusa lo stesso set di immagini di riferimento per ogni inquadratura di una sequenza e cambia nel prompt solo le righe di azione e luogo. L’endpoint non accetta seed, quindi sono i riferimenti a tenere ferma l’identità da una ripresa all’altra; il solo testo divergerebbe.
Collocare un’interprete in uno spazio preciso
Abbina un ritratto a un’immagine separata dello spazio e descrivi cosa succede lì. In voice-and-room l’interprete si avvicina al microfono, dice una battuta e sorride; la seconda immagine porta le luci di scena, il prompt porta il suono dell’ambiente.
Tenere fermo un capo o un oggetto in movimento
Dai a un capo o a un oggetto il suo slot invece di sperare che sopravviva dentro un ritratto. L’esempio red-dress scrive allora cosa fa l’abito mentre lei si muove, lo spacco che si apre a ogni passo verso il proscenio, perché taglio e colore sono già fissati da un riferimento.
Consigli avanzati
Assegna a ogni immagine un solo compito
Apri il prompt con la corrispondenza, come fa character-continuity: «Keep the woman from Picture 1 and the black lace slip from Picture 2, in the hotel room from Picture 3.» Poi scrivi l’azione. Tre o quattro immagini con compiti distinti funzionano meglio di nove che si sovrappongono; quando più immagini mostrano lo stesso soggetto, il modello ne fa la media invece di sceglierne una.
Scrivi solo ciò che i riferimenti non coprono
Quando identità, costume e luogo sono coperti dalle immagini, usa il prompt per movimento, camera e suono: «She sits on the arm of the chair, crosses her legs and looks up at camera. Slow handheld drift, warm lamp, quiet room tone.» Descrivere di nuovo il volto a parole dà al modello una seconda descrizione che potrebbe non coincidere con l’immagine.
Bozze piccole, poi la consegna
La durata va da 4 a 15 secondi, e 4 secondi sono disponibili solo a 768p. Fai bozze a una risoluzione più bassa con il set di riferimenti che intendi tenere, poi ripeti in 2k. Se una ripresa diverge, cambia un solo riferimento o una sola istruzione alla volta, così capisci quale modifica ha fatto la differenza.
Avvio rapido dell’API
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "minimax/h3/reference-to-video",
  "input": {
    "aspect_ratio": "16:9",
    "duration_seconds": 5,
    "enable_prompt_expansion": false,
    "prompt": "A slow aerial shot drifting over a misty pine forest at sunrise",
    "reference_image_urls": [
      "https://example.com/reference.png"
    ],
    "resolution": "768p"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
Nel riferimento dell’API trovi autenticazione, schema completo, polling e gestione degli errori.