Opisujesz scenę, lecz klip jest łagodniejszy albo zostaje odrzucony. Najpierw odróżnij ograniczenia treści modelu od niejasnej akcji lub obrazu początkowego sprzecznego z promptem.
Krótka odpowiedź: model jest ważniejszy od słów. W testach z września 2026 proste, bezpośrednie prompty dawały zgodne wyniki w sprawdzonych scenach na MiniMax H3, Wan 3.0, Wan 2.6, Wan 2.5, Seedance 2.5 i LTX 2.5, natomiast H3 Max i Wan 2.2 odrzucają lub łagodzą większość promptów na wyższych poziomach.
Kategorie: L1 sugestywne, L2 umiarkowane NSFW, L3 zaawansowane NSFW, L4 intensywniejsze sceny dla dorosłych, L5A dodatkowe treści dla dorosłych.
Wersja w 30 sekund
- W generowaniu z tekstu najpierw wybierz model: MiniMax H3, Wan 3.0, Seedance 2.5 lub LTX 2.5. Następnie określ akcję i kadrowanie.
- W generowaniu z obrazu najpierw skomponuj klatkę początkową. Prompt kieruje ruchem z tego wizualnego punktu wyjścia.
- Pięć części, w tej kolejności: postać, akcja, kamera, światło, dźwięk. Dwie lub trzy akcje na 5 sekund.
- Szkice są tanie: 5 sekund kosztuje 0,095 $ na Wan 2.2 Spicy w 480p i 0,185 $ na MiniMax H3 w 768p.
Wypróbuj MiniMax H3 tekst na wideo →
Pracujesz z jednym modelem? Przewodnik po promptach MiniMax H3 i przewodnik po promptach Seedance 2.5 omawiają temat szerzej.
Jak napisać prompt wideo bez cenzury: pięć części, po kolei
Model wideo renderuje to, co nazwiesz, a resztę wymyśla sam. Prompt 5 w rozbiorze:
| Część | Co napisać | Z promptu 5 |
|---|---|---|
| Postać | „Adult”, kto, strój, gdzie | An adult woman in an oversized linen shirt wakes on a sheepskin rug by a loft window |
| Akcja | Krótka sekwencja połączonych czynności | She rolls onto her back, stretches, sits up, then turns and looks into the lens |
| Kamera | Jeden ruch, osobnym zdaniem | One slow dolly-in at floor height. |
| Światło | Jedno źródło i jego kolor | Soft white window light, dust in the air. |
| Dźwięk | Co słychać, albo „no music” | Birdsong outside, quiet room tone, no music. |
- Pisz wprost. Nazywaj ubrania i rekwizyty prostymi słowami.
- Dopasuj słowa do wejścia. Z tekstu opisz postacie, stroje i otoczenie. Z obrazu skup się na zmianach, zachowując jasny opis istniejącej sceny.
- Dopasuj akcję do czasu. Drobna czynność rozciągnięta na cały klip jest powolna; sześć stłoczonych powoduje pominięcia. Użyj płynnego akapitu i jednego ruchu kamery. Długość nie jest ograniczeniem (Wan 2.6 przyjmuje 1 500 znaków, H3 7 000).
- Pisz, czego chcesz, zamiast czego unikać. Ujęcie H3 pełne zakazów zatrzymało się; „stays fully on for the entire shot” zachowało ubranie przez cały klip H3.
- Określ wszystkich jako dorosłych, a przy dwóch osobach napisz, kto co robi. Pomiń „8k, masterpiece”; samo „cinematic” niewiele znaczy: liczą się ziarno filmowe, głębia ostrości i nazwany ruch kamery.
- Przy precyzyjnym prompcie wyłącz rozszerzanie. Domyślnie jest wyłączone na Wan 3.0 i Wan 2.6; wyłącz je na Wan 3.0 Pro, gdzie jest włączone. Rozszerzanie przepisuje prompt: może rozwinąć jednozdaniowy pomysł lub zmienić szczegółowy opis.
Łagodniejszy klip po zmianie promptu
Niejasny opis pozostawia modelowi wymyślenie akcji, kadru i tonu. Doprecyzowanie pomaga, gdy klip powstaje, ale nie odpowiada intencji; nie naprawia każdego odrzucenia. Typowa słaba pierwsza wersja:
A beautiful sensual woman in a bedroom, cinematic, moving slowly, don't zoom, 8k masterpiece.
Ta sama scena w pięciu elementach:
An adult woman in a white cotton shirt sits on the edge of an unmade bed in morning light. She pulls her hair over one shoulder, then turns and looks into the lens. Static camera at mattress height. Soft window light from the left. Sheets rustling, quiet room tone.
Zmiany: zamiast „beautiful sensual” pojawiły się konkretne ubrania, miejsce i akcja; zamiast „slowly” i „don't zoom” — dwie czynności i statyczna kamera; określono światło i dźwięk. Jeśli wynik nadal odbiega, zmieniaj jedną rzecz na próbę i zachowuj seed tam, gdzie model go oferuje (Wan 3.0, Seedance, LTX 2.5).
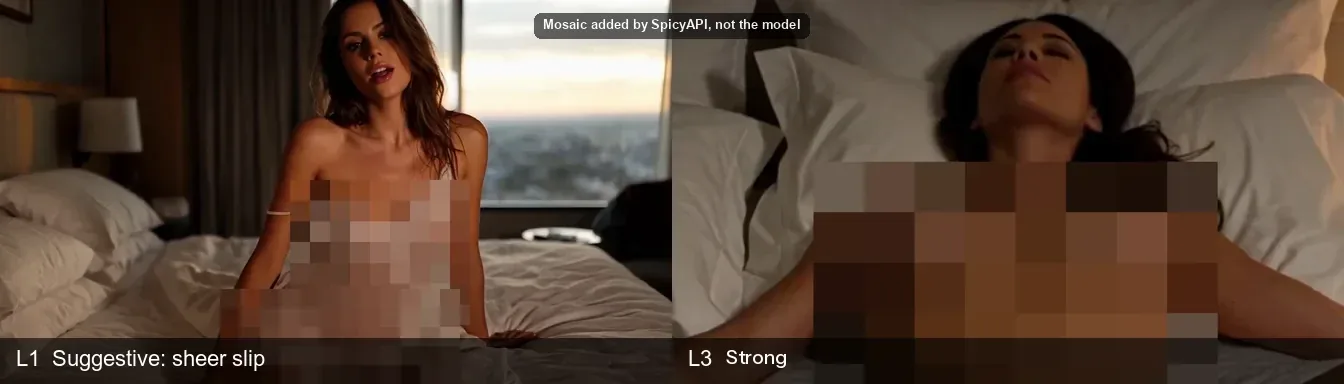
MiniMax H3 z tekstu na wideo. Po lewej: opis postaci L1. Po prawej: przycięty opis postaci L3. Mozaika jest nasza.
Tekst na wideo czy obraz na wideo: kto decyduje, jak daleko to zajdzie
Tekst na wideo: decyduje model
Do intensywniejszych scen dla dorosłych wybierz Wan 3.0, Seedance 2.5 lub LTX 2.5 przed szlifowaniem słów. Starsze podstawowe Seedance 2.0, Fast i Mini często łagodziły akcję. Wybierz zadanie wejściowe oprócz rodziny: wynik z tekstu nie wskazuje, jak ten sam model ożywi obraz.
Nazwij ostatnią czynność. Wan 3.0 może kontynuować akcję dalej niż zamierzasz, więc nadaj ujęciu wyraźny koniec.
Obraz na wideo: obraz ustala poziom, prompt wprawia go w ruch
Obraz ustala widoczną scenę. Umieść zamierzony styl i kompozycję w obrazie zamiast prosić intensywniejszy prompt o przebudowę łagodniejszego obrazu. MiniMax H3 i Vidu Q3 zwykle pozostają blisko dostarczonego obrazu; Seedance, Wan 3.0 i LTX 2.5 mogą go rozwinąć.
Prompt kieruje ruchem. Zmiana pokoju słowami może przenieść tam całą scenę; zachowaj zgodność akcji z obrazem. Więcej zachowań charakterystycznych dla modelu opisuje test Vidu Q3.
Dla konkretnego zakończenia dodaj klatkę końcową w H3, Seedance 2.5, LTX 2.5 lub Wan 3.0 obraz na wideo. Dopasuj obie pod względem postaci, stroju i światła.
Wan 2.6 obraz na wideo zachowuje kształt obrazu, więc przytnij go przed wysłaniem. H3 Spicy, Vidu Q3 Spicy, LTX 2.3 Spicy, Seedance 2.5 Spicy i Wan 3.0 potrafią ożywić obraz bez promptu; napisz go, gdy ruch ma znaczenie. Przygotuj obraz za pomocą modelu obrazów bez cenzury.
15 promptów wideo bez cenzury do skopiowania, według scen
Dostosuj te niegraficzne przykłady, zmieniając dorosłe postacie, scenę i akcję, ale zachowując jasny opis kamery i zakończenia.
1. Z pierwszej osoby, przy łóżku (tekst na wideo)
Wypróbuj na LTX 2.5: określ położenie kamery przed opisem czynności kobiety.
First-person point of view: the camera is a person lying back against the headboard of a bed at night, looking toward the end of the bed. An adult woman in a long ivory silk robe over a black slip dress steps up, kneels onto the mattress and leans down toward the lens with one hand planted beside it, her hair falling forward around her face. She stops close, tilts her head, smiles, and reaches out and taps one fingertip against the lens. Warm bedside lamp rim light, deep shadow, shallow focus, gentle handheld drift, 35mm film grain.
2. Szlafrok i spojrzenie, z obrazu (obraz na wideo)
Wypróbuj na Vidu Q3 Spicy: prompt opcjonalny. Jedna czynność, jeden dźwięk, jeden ruch kamery; obraz dostarcza resztę.
She finishes pouring, sets the flask down and lifts her eyes to camera with a small smile, steam rising from the cup, the yukata sliding a fraction lower on her shoulder. Paper shoji glow, evening cicadas, very slow push-in.
3. Para wodna i spojrzenie przez ramię (obraz na wideo)
Wypróbuj na MiniMax H3 Spicy: jeden ciągły ruch; niech para zamknie ujęcie. Nie ma przełącznika dźwięku, więc dodaj go w montażu, jeśli potrzebujesz.
She rolls her shoulders back and stretches upward in the cedar heat, water running the length of her spine. She turns her head to look back over one shoulder into the lens, then steps forward into the billowing steam. The vapour boils up around her and swallows the far wall. Slow handheld drift following her, warm cedar light, condensation crawling down the glass. Cinematic, shallow depth of field, heavy film grain.
4. Wanna, obrót do kamery (tekst na wideo)
Wypróbuj na Seedance 2.0: dźwięk bez dopłaty i seed. Przy błędzie praw autorskich ponów generowanie lub użyj Seedance 2.0 Fast albo 2.5.
An adult woman sits on the rim of a clawfoot bath in a dark tiled bathroom at night, a white towel wrapped around her. She pins her wet hair up with both hands, turns her head toward the camera in profile, then lowers her arms and looks straight into the lens. Slow push-in from the doorway. One warm wall sconce, steam fogging the mirror behind her. A dripping tap, quiet room tone.
5. Poranne światło, solo, z tekstu (tekst na wideo)
Wypróbuj na Wan 2.6: pozostaje blisko Twoich słów.
An adult woman in an oversized linen shirt wakes on a sheepskin rug in front of a tall loft window in morning light. She rolls onto her back, stretches both arms above her head, sits up, then turns and looks straight into the lens with a slow smile. One slow dolly-in at floor height. Soft white window light, dust in the air. Birdsong outside, quiet room tone, no music.
6. Najtańszy szkic z tekstu (tekst na wideo)
Wypróbuj na Seedance 2.0 Mini: najtańszy Seedance. Daj postaci zwykłą czynność do wykonania.
An adult woman in a white cotton sundress lies on her stomach across a rumpled white bed in afternoon light, reading a paperback, ankles crossed in the air. She lowers the book, rolls onto her side toward the camera and props her head on one hand, then laughs at something off screen. Static camera at mattress height. Warm sun through half-closed blinds, striped light across the sheets. Pages turning, a ceiling fan ticking.
7. Twój własny kadr: pisz tylko ruch (obraz na wideo)
Wypróbuj na MiniMax H3: zachowaj istniejącą scenę i opisz jej dalszy ciąg.
She tips her head back under the water and runs both hands through her wet hair, then turns to face the camera and wipes the water from her eyes with the back of her wrist. Steam drifts across the glass behind her. Static camera at chest height. Running water, a soft echo, no music.
8. Para: wiatr na balkonie (tekst na wideo)
Wypróbuj na Wan 3.0 Prime: około 0,31 $ za pięć sekund w 480p; jedna wspólna czynność, jeden ruch kamery.
Golden hour on a hotel balcony: she stands at the rail in a silk robe that lifts and falls in the wind, and he comes up behind her and closes both arms around her waist. She leans back into him and turns her face up to his. The robe streams sideways, the city hazes gold below. Slow orbit around the pair at the rail. Cinematic, shallow depth of field, heavy film grain.
9. Para: tylne siedzenie (tekst na wideo)
Wypróbuj na Wan 2.6, z tego samego powodu co prompt 5. Ten plik przykładowy nie ma ścieżki audio.
A couple in a rain-streaked car at night: she climbs across from the passenger seat into his lap and takes his face in both hands. He slides a hand up her back and the window fogs where her shoulder presses it. Rain runs down the glass, headlights sweep past and go. Slow push in from the back seat, warm dashboard glow against cold rain light. Cinematic, shallow depth of field, heavy film grain.
10. Para: dwie kobiety w kinie samochodowym (tekst na wideo)
Wypróbuj na Wan 3.0: dźwięk włączony lub wyłączony i seed. Strój każdej osoby, potem kto porusza się pierwszy.
35mm film still, warm grain and halation. Two adult women lie back in the open tailgate of a station wagon at a drive-in cinema, a plaid blanket over their legs; one wears a white ribbed tank top, the other a red gingham bikini top and denim shorts. The projector beam flickers across them; one turns, brushes hair from the other's face, and they kiss slowly as the screen light shifts from blue to gold. Summer night, moths in the beam, loose handheld frame.
11. Kamera: zjazd żurawiem w dół (tekst na wideo)
Wypróbuj na LTX 2.5: do 4K, z seed. Kamera otrzymuje własne trzy słowa.
Ultra-detailed cinematic shot: an adult woman in a floor-length emerald silk gown descends a marble staircase in an empty opera house, the high slit opening across her leg with each step, chandelier light glittering through the fabric. Slow crane down, immaculate texture detail, orchestra tuning drifting up from the pit.
12. Kamera: widok z pierwszej osoby, z kadru (obraz na wideo)
Wypróbuj na Wan 2.6 Spicy: 0,475 $ za pięć sekund w 720p; obraz ustala kadr. Przy perspektywie pierwszej osoby ruszaj kamerą jak ciałem: kołysanie, nie żuraw.
Her toes flex and hook deeper into the silk, one knee slowly straightening, the sheets sliding and rippling under her legs. The slatted bars of light creep across the bed as the blind stirs in the draught. Handheld point-of-view sway, warm red and gold, quiet morning room tone.
13. Zwolnione tempo, celowo (tekst na wideo)
Wypróbuj na Wan 3.0 Pro: minimum 1080p, około 0,72 $ za pięć sekund; wyłącz rozszerzanie promptu, domyślnie włączone w Pro. Napisz „slow-motion” raz na początku; nie dodawaj „slowly” do pozostałych czasowników.
Slow-motion perfume commercial. An adult woman in a backless black gown turns away from a rain-lashed window, the low back of the dress catching a single hard key light down her spine, droplets of water flicking from her hair as she moves. Macro-sharp fabric detail, deep shadow, 4K product-film polish, low cello note and rain.
14. Prowadzi dźwięk: bar (tekst na wideo)
Wypróbuj na Seedance 2.0: dźwięk bez dopłaty. Każdy dźwięk pochodzi od czegoś na ekranie. Przy błędzie praw autorskich ponów generowanie lub użyj Seedance 2.0 Fast albo 2.5.
Photorealistic live-action, not animation. A real adult woman in a chocolate satin robe works behind a dim neon bar, a large fluffy faux fox tail accessory clipped at the small of her back. She shakes a cocktail, turns to set the glass on the counter and the tail sways with the movement, then she looks back at camera with a teasing smile. Warm red lantern light, 35mm grain, slow push-in, ice rattling and low bar chatter.
15. Ubranie zostaje: bezpieczna wersja z modelu Spicy (obraz na wideo)
Wypróbuj na Seedance 2.0 Fast Spicy: około 0,41 $ za pięć sekund w 480p. Niektóre klipy testowe Spicy zmieniały stroje bez prośby. Nazwij ubrania, które mają pozostać; sprawdź wynik zamiast traktować instrukcję jak blokadę.
First person point of view, the camera stays where it is on the pillow and does not move. She lowers herself closer toward the lens, her long hair falling forward around the edges of the frame, and holds eye contact. She keeps the black lace top and the black satin robe on the whole time and stays fully dressed. Candlelight flickers behind her; the background stays black. Only her movement, no camera move, no cut.
Co zostaje złagodzone, a co przechodzi
Odróżnij zwrócony błąd od wygenerowanego, lecz łagodniejszego klipu. Zasady modelu, walidacja wejścia i sprzeczny opis wymagają różnych zmian.
| Wysłałeś | Do | Co wróciło | Wyślij zamiast tego |
|---|---|---|---|
| Prompt L5A | Wan 2.2 tekst na wideo | Odrzucony, bez opłaty (L1 też odrzucony) | Wan 3.0, Wan 2.6 lub Wan 2.5 tekst na wideo |
| Prompt L4 na kadrze L3 | H3 Max obraz na wideo | Odrzucony | MiniMax H3 obraz na wideo |
| Prompt L5A na obrazie L3 | Wan 2.2 obraz na wideo | Częściowo zachowany, reszta złagodzona | Wan 2.2 Spicy lub Wan 3.0 obraz na wideo |
| Prompt L4 | H3 Max tekst na wideo | Znacznie łagodniejsza scena, rozliczona; późniejsze próby odrzucone lub złagodzone | MiniMax H3 tekst na wideo: zgodnie z opisem |
| Prompt L4 | HappyHorse 1.1 tekst na wideo | Odrzucony na etapie promptu, bez opłaty; L3 przeważnie przechodził | MiniMax H3 tekst na wideo |
| Mocne słowa, grzeczny kadr | Seedance obraz na wideo | Kilka łagodnych klipów | Skomponuj obraz dla zamierzonej sceny |
| Prompt L4 na kadrze L3 | Seedance 2.0, 2.0 Fast, 2.0 Mini obraz na wideo | Przeważnie złagodzone | Seedance 2.5 lub Wan 3.0 obraz na wideo |
| Zwykły prompt L1 | Seedance 2.0 tekst na wideo | Powtarzające się błędy praw autorskich | Ponów próbę lub Seedance 2.0 Fast albo 2.5 tekst na wideo |
| Kadr L3, bez promptu | H3 obraz na wideo; Vidu Q3, Pro, Turbo | Odrzucone, bez opłaty | Jedno zdanie o ruchu |
| Wideo referencyjne L3 | Wan 2.6 referencja na wideo | Odmowa, bez opłaty | Wan 3.0 referencja na wideo |
| Proste słowa kontra nazwa gatunku | Wan 2.6 tekst na wideo | Oba zgodnie z opisem | Obojętnie |
Odrzucenie zwykle zwalnia blokadę środków; wyjątki podaje strona modelu. Sprawdź settled i cost (zasady). Łagodniejszy klip jest rozliczany, więc obejrzyj klatki.
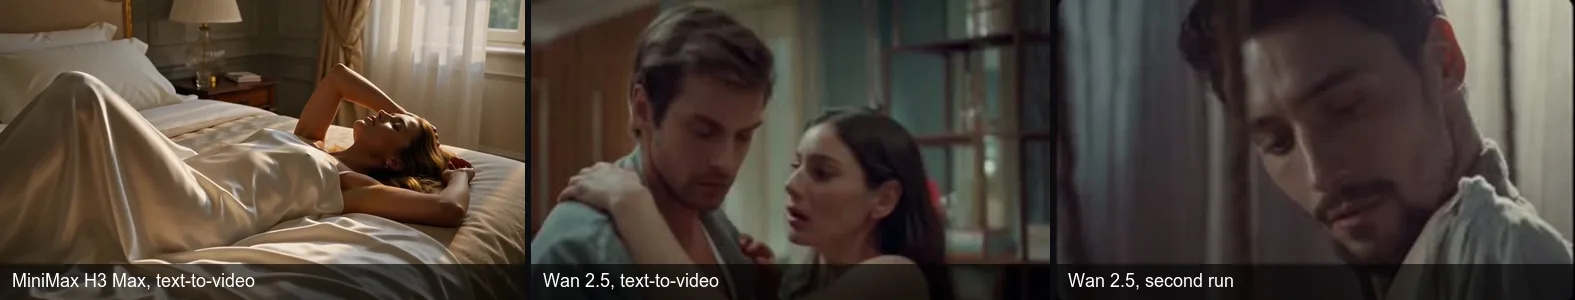
Tak wygląda „złagodzone”. Po lewej: MiniMax H3 Max tekst na wideo, prompt L4. Środek i prawa: Wan 2.5 tekst na wideo, nasz prompt L5A i druga próba ze zmienionym opisem. Klatki bez edycji, wszystkie rozliczone. Późniejsze próby Wan 2.5 realizowały tę kategorię zgodnie z prośbą; te klatki ilustrują wcześniejsze złagodzone wyniki.
Jeden prompt, różne modele: co naprawdę zobaczyliśmy
Opis dodatkowych treści dla dorosłych dał różne tempo i inscenizację w zależności od modelu:
| Model | Co zrobił z tym samym briefem | Dla Twojego promptu |
|---|---|---|
| MiniMax H3 | Każdy element zgodnie z opisem | Nazwij wszystko, czego chcesz |
| Modele Wan 3.0 | Zrealizował opis dla dorosłych, potem dodał akcję | Nazwij ostatnią akcję, sprawdź zakończenie |
| LTX 2.5 | Podążył za tekstem; z obrazu wymagał wyraźnych czynności i pokazał zlane kończyny | Z obrazu napisz dwie lub trzy czynności |
| Wan 3.0 Prime, obraz | Zachował samotną postać z obrazu | To, czego potrzebujesz, umieść w kadrze |
| Wan 2.2 Spicy | Dodał drugą osobę | Sprawdzaj, czy nie ma dodatkowych osób |
| Vidu Q3, Q3 Spicy | Dodał elementy L5A i drugą osobę; zmienił oświetlenie pokoju na czerwone | Nazwij pokój i światło, które masz |
| Seedance 2.0 Fast | Pozostał blisko obrazu i złagodził intensywniejszą żądaną akcję | Akcję umieść w kadrze |
| Seedance 2.0 Spicy, 2.0 Fast Spicy, LTX 2.3 Spicy | Przeszedł do L4 bez prośby | Użyj MiniMax H3 obraz na wideo lub określ zakończenie i sprawdź ostatnie klatki |
Dwie wersje tej samej sceny modowej pokazują, dlaczego opis ruchu powinien uwzględniać czas.
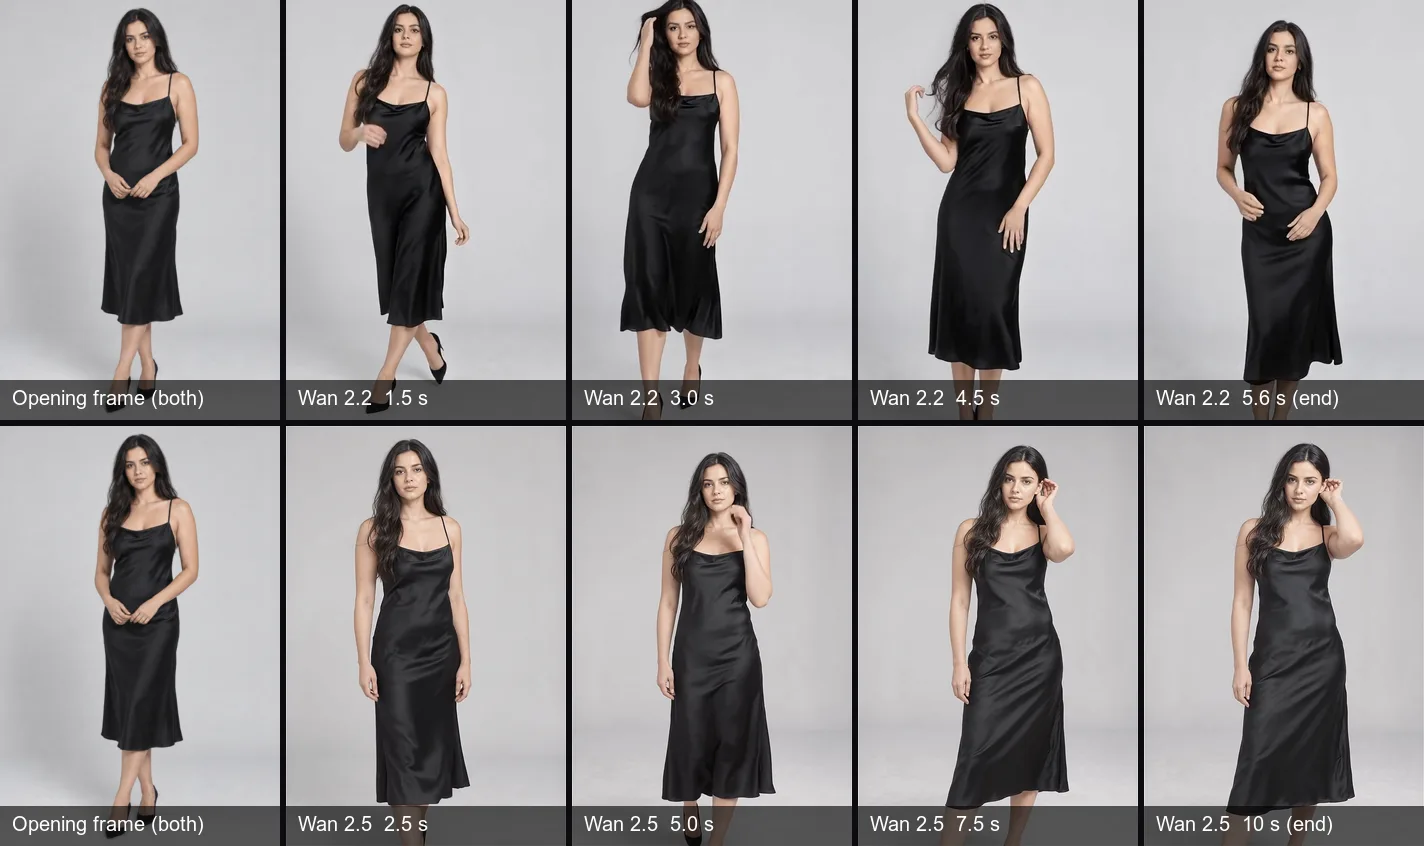
Ten sam obraz, bardzo podobne prompty ruchu. Góra: Wan 2.2, 720p, 5,8 sekundy. Dół: Wan 2.5, 1080p, 10 sekund. Klip Wan 2.2 · Klip Wan 2.5.
Wspólny opis ruchu brzmiał:
She shifts her weight, turns her shoulders toward the lens and takes two slow steps forward, the satin of the dress catching the light as it moves. She tucks her hair behind one ear and holds the look. Locked camera, clean grey studio.
Wan 2.2 zakończył kroki do 1,5 sekundy i zaczął wracać do pozy początkowej; Wan 2.5 rozłożył akcję na dziesięć sekund i utrzymał ostatnią czynność. Dopasuj akcję do długości i nadaj zakończeniu stan do utrzymania.
Gdzie klipy się sypią, i jak to naprawić
| Co widzisz | Poprawka |
|---|---|
| Zwolnione tempo, sztywny ruch | Dwie lub trzy akcje na 5 sekund, bez „slowly” przy każdym czasowniku; na Wan dodaj „real-time speed” |
| Obraz na wideo prawie się nie rusza | Tylko czasowniki, bez opisywania obrazu |
| Cały klip zastyga | Jeśli prompt głównie zabrania ruchu, wypróbuj krótką sekwencję pozytywnych czynności; uprość akcję przed dodawaniem instrukcji |
| Przy każdym przebiegu inna twarz | Ponownie użyj wyraźnego obrazu lub referencji postaci; zachowaj seed, jeśli dostępny. Podstawowy MiniMax H3 i Vidu Q3 Spicy nie mają pola seed |
| Scena złagodzona albo grzeczniejsza | Przełącz na model bez cenzury (H3 zamiast H3 Max, Wan 3.0 zamiast Wan 2.2) lub zacznij od obrazu na żądanym poziomie |
| Kamera tnie na inne ujęcie | „One continuous shot, no cuts”; zachowaj shot_type jako single (domyślnie w Wan 2.6) |
| Kamera sama się przybliża | „Static tripod shot: the framing stays as in the first frame”; na Wan wpisz „zoom, push-in, close-up” do negatywnego promptu, jeśli jest |
| Idzie dalej, niż prosiłeś | Nazwij zakończenie, dodaj zgodną klatkę końcową, jeśli dostępna, lub wypróbuj zadanie, którego wyniki były bliższe opisowi |
| Zmiana opisu zmienia wszystko | Zmieniaj jedno pole na próbę i zachowuj seed, jeśli dostępny; wyłącz rozszerzanie |
| Muzyka, o którą nie prosiłeś | H3 dodaje dźwięk do każdego klipu: nazwij dźwięk i dopisz „no music” |
| Zero dźwięku | Dodaj dźwięk w montażu lub użyj zadania audiowizualnego. H3 Spicy nie ma przełącznika dźwięku; sprawdź dostarczoną ścieżkę |
Dłużej niż jedno ujęcie? Przewodnik po dłuższych filmach bez cenzury łączy klipy od ostatniej klatki.
Ściąga z promptów: jeden wiersz na model
Cena: pięć sekund przy najtańszej dostępnej rozdzielczości. To koszty wyjścia; zadania z wideo referencyjnym mogą doliczać osobne opłaty.
| Model | Start od | Pisz tak | 5 s od |
|---|---|---|---|
| MiniMax H3 | Tekst, obraz, obrazy/wideo referencyjne | Proste słowa, wszystko nazwane; obraz ustala twarz. Przewodnik | 0,185 $ |
| MiniMax H3 Spicy | Obraz | Prompt opcjonalny; jedna czynność wystarczy; brak przełącznika dźwięku | 0,19 $ |
| MiniMax H3 Max | Tekst, obraz | Tekst na wideo jest „Filtered”, obraz na wideo „Softened”: prompty z wyższych poziomów wysyłaj do H3 | 0,25 $ |
| Wan 3.0 | Tekst, obraz, obrazy/wideo referencyjne | Nazwij ostatnią akcję; lubi eskalować | 0,225 $ |
| Wan 2.6 | Tekst, obraz | Trzyma się blisko Twoich słów | 0,45 $ |
| Wan 2.5 | Tekst, obraz | Proste słowa w obu ścieżkach | 0,225 $ |
| Wan 2.2 Spicy | Obraz | Trzy lub cztery czynności, „real-time speed”; bez dźwięku | 0,095 $ |
| Seedance 2.0 | Tekst, obraz, obrazy/wideo referencyjne | „One continuous shot, no cuts” | 0,35 $ |
| Seedance 2.0 Mini | Tekst, obraz, obrazy/wideo referencyjne | Najtańszy szkic na Seedance | 0,12 $ |
| Seedance 2.5 | Tekst, obraz, obrazy/wideo referencyjne | Ujęcia po 30 sekund. Przewodnik | 0,62 $ |
| Seedance 2.5 Spicy | Obraz | Prompt opcjonalny; twórz szkic w 480p na tym modelu | 1,08 $ |
| LTX 2.5 | Tekst, obraz | Akcje połączone przez „then” | 0,45 $ |
| LTX 2.3 Spicy | Obraz | Krótki prompt albo żaden; eskaluje; niemy | 0,095 $ |
| Vidu Q3 Spicy | Obraz | Nazwij pokój, który masz; prompt opcjonalny | 0,33 $ |
| Vidu Q3 Turbo | Obraz | Najtańszy szkic wierny kadrowi | 0,21 $ |
Zmieniając model, sprawdź wejścia akceptowane przez nowe zadanie: tekst, obraz i referencje korzystają z różnych pól.
FAQ
Jak pisać prompty bez cenzury do wideo AI?
Użyj promptu 5 z tekstu albo 7 z obrazu. Zmień postacie i otoczenie, zachowaj jeden ruch kamery i wybierz odpowiednie zadanie wejściowe w tabeli modeli.
Dlaczego moje wideo AI wróciło złagodzone?
Jeśli kategoria nie jest obsługiwana, zamień H3 Max lub podstawowy Wan 2.2 na sprawdzoną alternatywę. Jeśli scena jest właściwa, lecz ruch nie, uprość czynność zamiast przepisywać całe ujęcie.
Czy prompt może rozwinąć klip obraz na wideo poza zawartość obrazu?
Tak. Niektóre zadania dodają akcję, osoby lub nowe otoczenie. Aby zachować strój i kadr, określ te instrukcje wyraźnie i unikaj opisywania innego pokoju.
Potrzebuję eufemizmów, czy mogę pisać wprost?
Pisz wprost: nazwij dorosłe postacie, styl i akcję. Niejasne nazwy gatunków pozostawiają modelowi więcej do wymyślenia.
Jak zachować tę samą osobę w kolejnych klipach?
Używaj ponownie jednego wyraźnego obrazu lub obrazów referencyjnych postaci. Zachowaj fryzurę, strój i światło, a z obrazów referencyjnych miejsca usuń konkurujące twarze. Zobacz przewodnik po dłuższych filmach bez cenzury.
Czy płacę za odrzucone albo złagodzone klipy?
Odrzucone: zwykle nie, blokada środków jest zwalniana. Złagodzone: tak, po normalnej cenie.
Twoja część
SpicyAPI nie dodaje filtrów treści; modele nadrzędne nadal mogą sprawdzać lub odrzucać wejście. Korzystaj z dorosłych osób, które wyraziły zgodę, i z materiałów, które masz prawo wysłać, oraz przestrzegaj prawa miejsca publikacji.
Uruchom pierwszy prompt
Załóż konto, wybierz prompt powyżej i naciśnij Run. Zrób szkic przy najniższej rozdzielczości, potem wygeneruj ponownie w wyższej. Reszta znajduje się w katalogu wideo bez cenzury.
Od promptu Playground do API
Najpierw wypróbuj prompt przez link modelu, wybierz pięć sekund przy najniższej rozdzielczości i sprawdź gotowe ujęcie. Dla aplikacji powtarzającej ten proces:
Ustaw SPICY_API_KEY w środowisku. Ten przykład Python 3 wysyła nowe ujęcie po potwierdzeniu ceny.
import json
import os
import urllib.request
import uuid

base = "https://api.spicyapi.ai/api/v1"
headers = {"Authorization": "Bearer " + os.environ["SPICY_API_KEY"],
           "Content-Type": "application/json", "User-Agent": "SpicyAPI-Blog/1.0"}
settings = {
    "duration_seconds": 5,
    "resolution": "480p",
    "generate_audio": False,
    "aspect_ratio": "16:9"
}
settings["prompt"] = 'A slow camera push toward the subject. Keep the setting and clothing unchanged. One continuous shot.'
payload = {"model": "bytedance/seedance-2.5/text-to-video", "input": settings}

def post(path, body):
    request = urllib.request.Request(base + path, json.dumps(body).encode(), headers)
    with urllib.request.urlopen(request, timeout=60) as response:
        result = json.load(response)
    if result.get("code") != 200:
        raise RuntimeError(result)
    return result["data"]

quote = post("/jobs/quote", payload)
if input(f"Maximum charge ${quote['maxCharge']}. Type yes to generate: ") != "yes":
    raise SystemExit("Stopped before generation")
headers["Idempotency-Key"] = str(uuid.uuid4())
print("Request key:", headers["Idempotency-Key"], flush=True)
task = post("/jobs/createTask", {**payload, "quoteId": quote["quoteId"],
                              "expectedCost": quote["estimatedCost"]})
print("Task ID:", task["taskId"])
Zachowaj wydrukowany klucz żądania, aby odzyskać to samo żądanie; nowe ujęcie otrzymuje nowy klucz. Dokumentacja API zadań opisuje dostarczanie i odzyskiwanie wyników.
Przy powtarzanych ujęciach pozwól Agentowi użyć zatwierdzonego pliku wejściowego: CLI spicyapi tasks create --model bytedance/seedance-2.5/text-to-video --input-file input.json --wait; MCP, poproś o wywołanie spicyapi_task_create z tym modelem i wejściem; Skill, poproś „Use the spicyapi Skill to generate this approved shot and return the result.” CLI i MCP pokazują cenę przed utworzeniem. Zobacz dokumentację integracji Agent.