Per un personaggio adulto ricorrente, parti da immagine a video quando volto, abiti e inquadratura iniziale sono approvati. Parti da testo a video se stai ancora scegliendo il personaggio o esplorando la scena. Un’immagine fornisce un’apertura precisa; un prompt testuale lascia che il modello la inventi. Nessun input garantisce che il volto resti stabile quando il personaggio si muove.
Il confronto usa MiniMax H3 perché SpicyAPI offre entrambe le attività agli stessi prezzi al secondo. La scelta dipende da ciò che hai già e da ciò che va corretto, non da uno sconto per uno dei percorsi. I prompt di esempio usano una persona adulta immaginaria completamente vestita.
La stessa famiglia, due input diversi
| Specifiche attuali di MiniMax H3 | Da testo a video | Da immagine a video |
|---|---|---|
| Input richiesto | prompt | prompt e image_url |
| Durata | 5–15 secondi interi | 4–15 secondi interi; 2k richiede almeno 5 |
| Risoluzioni | 768p, 2k | 768p, 2k |
| Formato del frame | aspect_ratio: 16:9, 9:16, 1:1, 4:3, 3:4, 21:9 | Definito dall’immagine iniziale; nessun campo per il rapporto d’aspetto |
| Immagine finale facoltativa | Non disponibile | last_image_url |
| seed | Non disponibile | Non disponibile |
I dettagli sono nelle pagine da testo a video e da immagine a video.
Entrambe le attività generano l’audio insieme al video. Descrivi il suono nel prompt, anche se è solo pioggia e ambiente della stanza; un’immagine non può indicare quale colonna sonora appartiene alla scena.
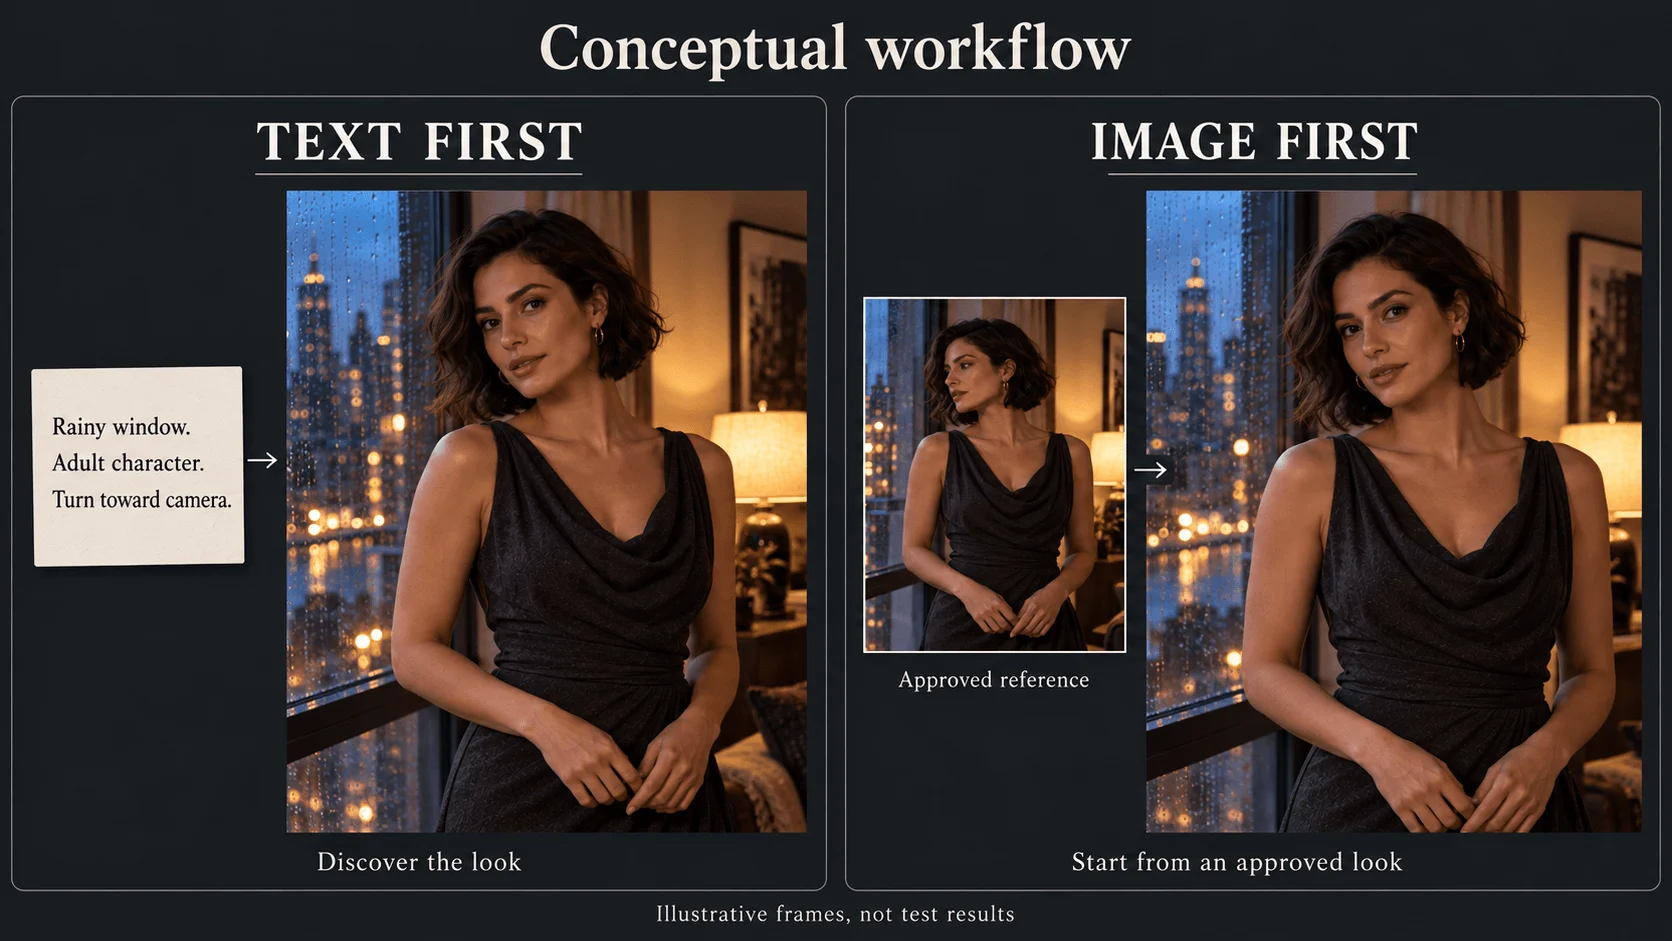
Partire dal testo permette di scoprire l’aspetto; partire dall’immagine fornisce un aspetto iniziale approvato. Sono illustrazioni, non risultati di MiniMax.
Cosa significa per chi crea contenuti NSFW
Nei nostri test di settembre 2026, entrambe le attività H3 hanno accettato richieste per contenuti adulti fino al livello più intenso verificato: da testo a video con una descrizione scritta, e da immagine a video con immagini iniziali generate dall’IA. Entrambe sono elencate come senza restrizioni: il percorso non cambia ciò che è consentito, ma il controllo che hai.
Accettazione e identità sono questioni distinte. Un modello può accettare il soggetto e comunque cambiare il volto a metà di una rotazione. Scegli quindi il percorso in base all’inquadratura e valuta se il personaggio resta riconoscibile.
MiniMax H3 Spicy è una famiglia separata da immagine a video, non la modalità con input immagine di H3 ordinario. A 768p il prezzo attuale è $0.084 al secondo, contro $0.037 per H3 ordinario a 768p. Non confrontare quel prezzo superiore con H3 ordinario da testo a video chiamando la differenza «sovrapprezzo da immagine a video». Anche H3 LoRA è una famiglia separata per pesi LoRA compatibili, non un interruttore in questi due moduli.
Percorso A: scoprire l’inquadratura dal testo
Usa questo percorso per un nuovo personaggio immaginario o un teaser autonomo quando il volto preciso non è ancora definito. La descrizione di esempio contiene una sola azione: Mara, di 30 anni, si volta da una finestra rigata dalla pioggia verso lo spettatore. Il suo abito da sera color antracite resta indossato; la camera resta fissa.
- Apri MiniMax H3 da testo a video.
- Nel modulo imposta Aspect ratio su 9:16, Resolution su 768p e Duration su 5.
- Incolla il prompt seguente in Prompt e controlla la stima prima di avviare la generazione.
Vertical medium shot of Mara, a fictional 30-year-old woman with a short dark bob, wearing a charcoal evening dress beside a rain-streaked window. Cool window light illuminates her face; a warm lamp glows behind her. She begins looking toward the window, slowly turns her head toward the camera, then holds eye contact. Her face and upper body stay in frame. Static camera. The dress remains unchanged. Audio: soft rain against the glass and quiet room tone, no speech or music.
Sceglilo quando: il personaggio è ancora da definire, vuoi esplorare aspetti e ambientazioni oppure una sola clip autonoma costituisce tutto il lavoro. Scegli un altro percorso quando: volto o abiti sono già fissati; usa il percorso B.
Valuta il primo risultato come scelta del personaggio più messa in scena. Se il volto è piacevole ma diverso da quello di un personaggio consolidato, l’input solo testuale non ha fornito quel volto. Ripetere nome e descrizione dei capelli non trasforma una nuova generazione in un riferimento d’identità.
Quando approvi un aspetto, salvalo prima di cambiare il prompt. “Keep everything, only change the lamp” resta una nuova generazione in questa attività, non un ritocco locale. Se la lampada conta, prepara un’immagine iniziale approvata con la lampada corretta e passa al secondo percorso.
Percorso B: animare un’apertura approvata
Usa da immagine a video quando il pubblico riconosce già Mara o l’inquadratura deve corrispondere a un’immagine di campagna approvata. L’immagine deve mostrare l’inizio dell’azione, non essere semplicemente il tuo miglior ritratto del personaggio.
Per la rotazione vicino alla finestra, prepara un’inquadratura media verticale con la testa orientata verso la finestra, una parte sufficiente del volto visibile per controllarla e spazio intorno alle spalle. Un primo piano del volto molto stretto è un cattivo punto di partenza per un’ampia rotazione di andata e ritorno. Ricomponi prima l’immagine, invece di chiedere al prompt di movimento di risolvere insieme ritaglio, identità e azione.
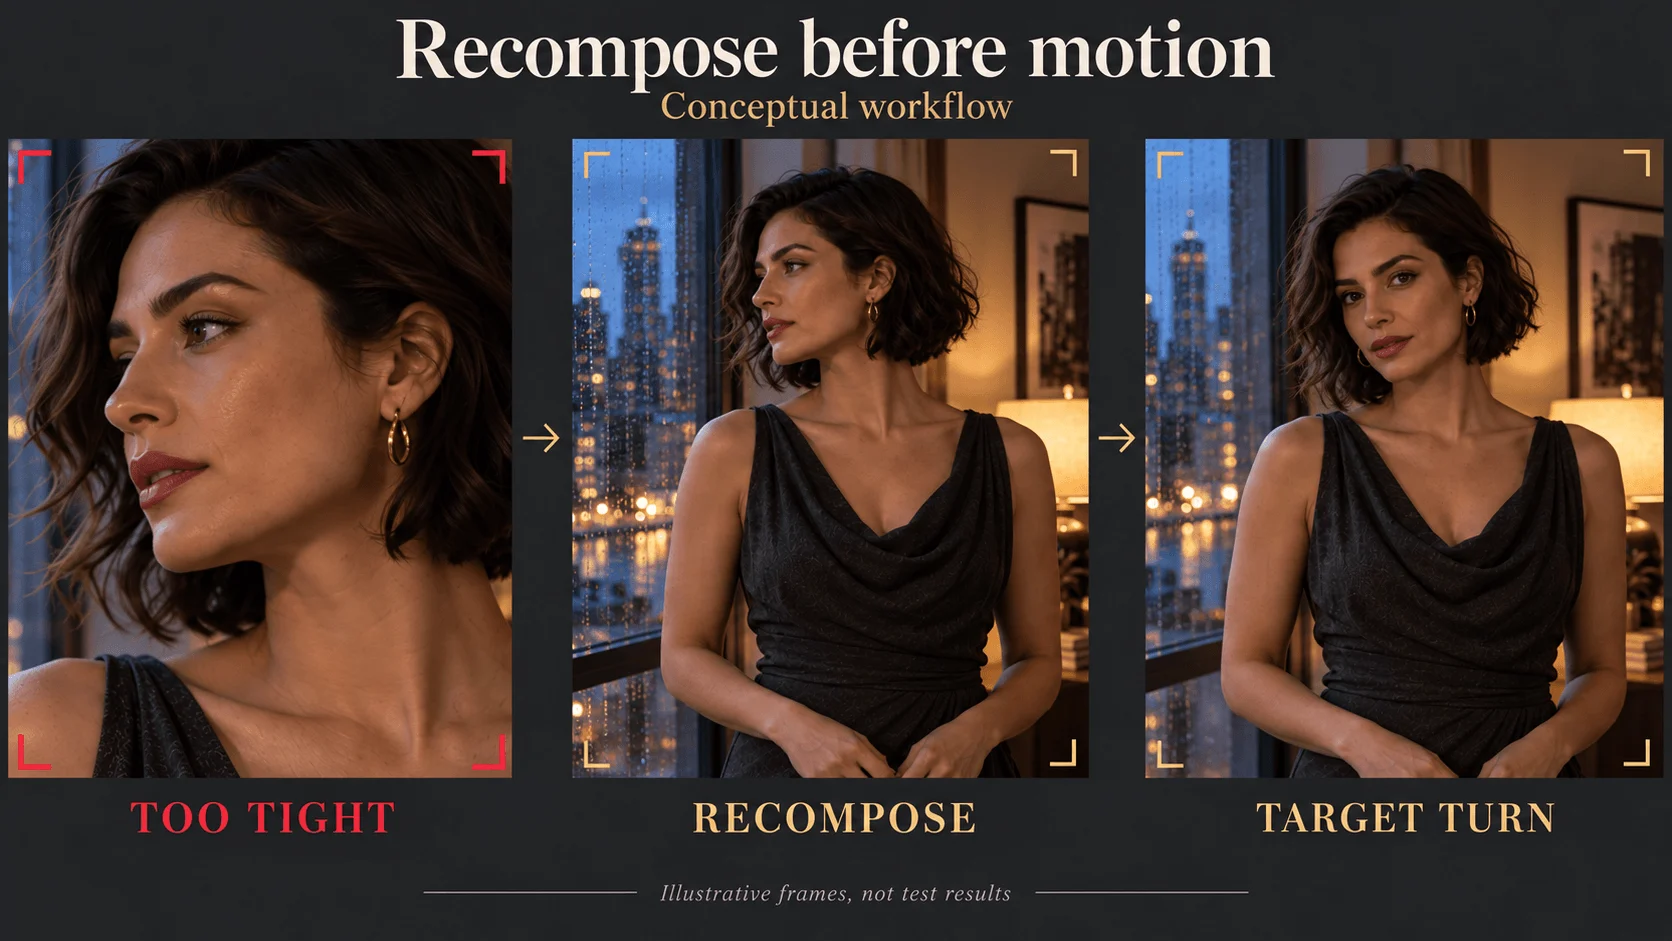
Correggi un ritaglio troppo restrittivo prima di chiedere movimento.
- Apri MiniMax H3 da immagine a video.
- Aggiungi l’apertura verticale approvata in Input image. Ogni lato deve misurare 256–5.760 pixel, il rapporto deve essere tra 2:5 e 5:2 e il file deve essere inferiore a 10 MB (il limite di Playground).
- Imposta Resolution su 768p e Duration su 5. L’immagine fornisce il rapporto; questa attività non ha il campo Aspect ratio.
- Incolla il prompt di movimento seguente in Prompt. Lascia Closing frame vuoto per la prima semplice rotazione.
She slowly turns her head from the window toward the camera, then holds direct eye contact. Her shoulders stay relaxed. The camera remains fixed. Audio: soft rain against the glass and quiet room tone, no speech or music.
L’immagine mostra già volto, abito e stanza, quindi il prompt indica solo ciò che cambia.
Controlla l’apertura, il punto intermedio e la posa finale mantenuta. Un primo frame corrispondente può nascondere un volto che cambia in seguito. Se la rotazione mostra un profilo poco convincente, prova un angolo iniziale che mostri meglio la parte rilevante del volto o richiedi una rotazione minore. Se il contatto visivo diretto è essenziale, conserva quel finale invece di ridurre il movimento finché il personaggio agisce appena.
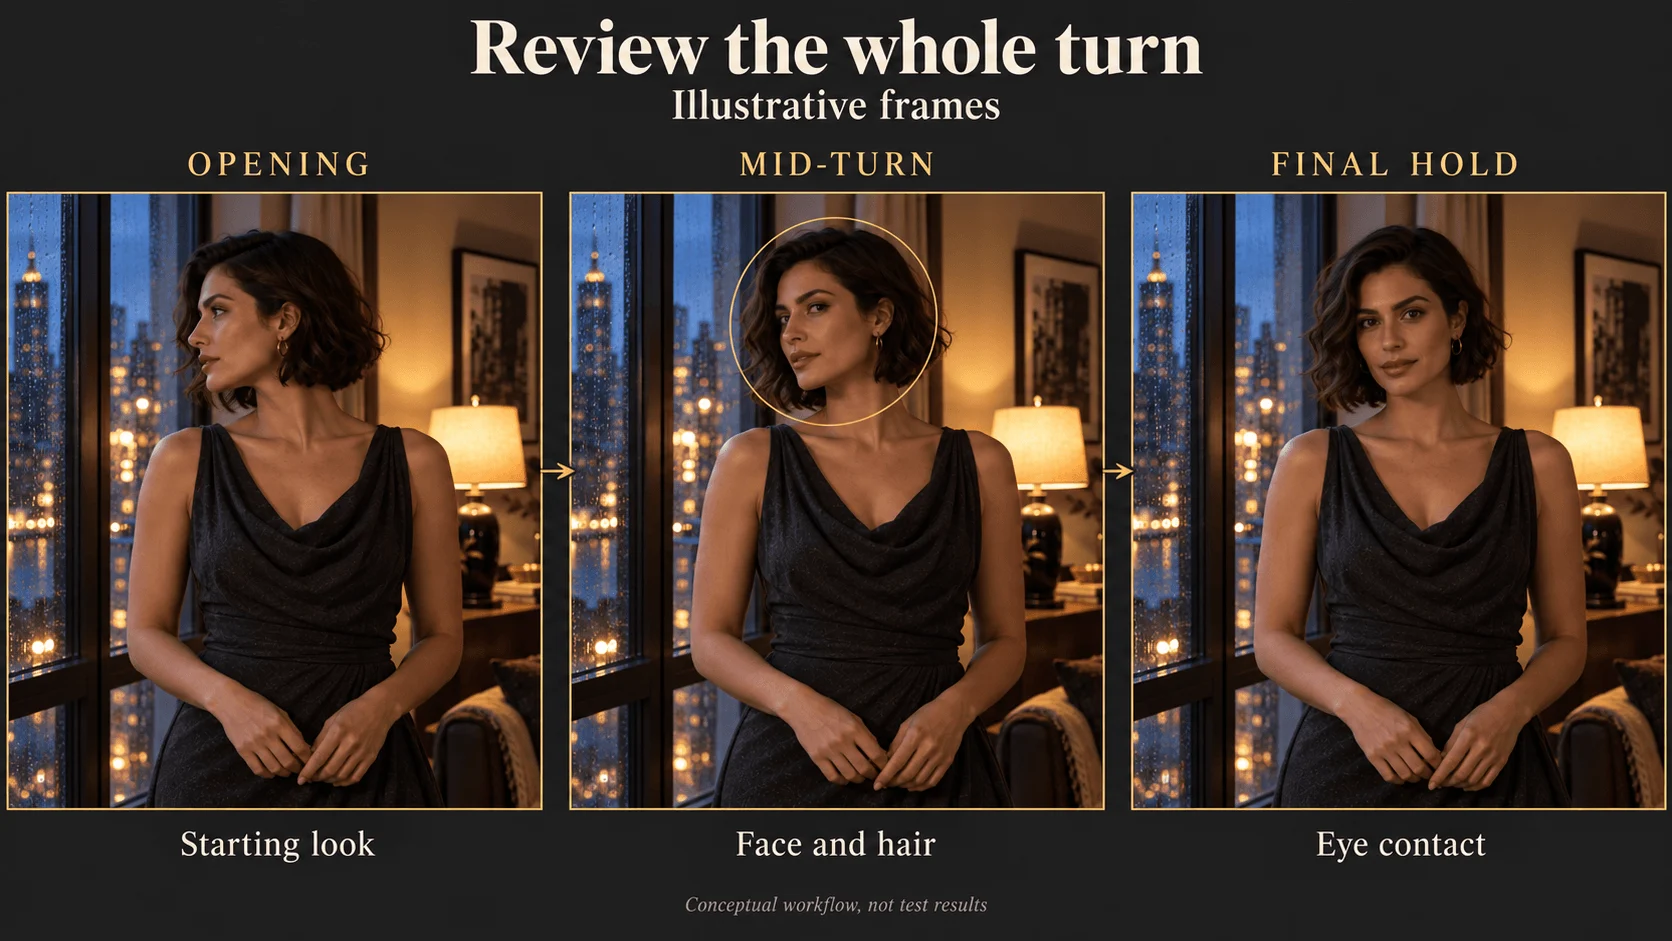
Controlla apertura, rotazione e posa finale mantenuta come verifiche di accettazione separate.
Sceglilo quando: il personaggio ricorre, l’inquadratura deve corrispondere a un’immagine approvata oppure hai già fissato volto e abiti. Scegli un altro percorso quando: devi ancora trovare l’aspetto, perché un’immagine fissa anche i propri punti deboli.
Il frame finale facoltativo (last_image_url nell’API) è utile quando hai approvato anche la composizione finale. Preparalo con lo stesso personaggio, gli stessi abiti e la stessa illuminazione, chiedendo un’azione che colleghi plausibilmente i frame. Vincola la destinazione; non fornisce ogni posizione intermedia delle mani né garantisce una transizione corretta.
Quanto costano cinque secondi
I prezzi attuali di H3 ordinario sono identici per le due attività:
| Risoluzione | USD al secondo | Generazione di cinque secondi |
|---|---|---|
| 768p | $0.037 | $0.185 |
| 2k | $0.058 | $0.290 |
La creazione dell’immagine è un costo aggiuntivo. Se hai già un’immagine statica approvata, la preparazione può costare quasi nulla; se prima generi e scarti molte immagini, conta quella spesa. A 768p, tre tentativi da testo a video costano $0.555, mentre un tentativo da immagine a video costa $0.185 più l’immagine: il percorso con immagine conviene solo se l’immagine approvata costa meno di $0.37. Se entrambi riescono al primo tentativo, da testo a video è più economico perché il percorso con immagine aggiunge il costo dell’immagine statica.
Preparare una bozza a 768p e finalizzare a 2k è la strategia economica, ma l’esecuzione a 2k è una nuova ripresa, non un upscaling della bozza: H3 non espone seed, quindi anche una richiesta identica restituisce un movimento diverso. Se il movimento accettato deve restare esattamente uguale, usa un’attività separata di upscaling. Le famiglie che espongono seed, come H3 Spicy da immagine a video o Seedance 2.5, consentono di ripetere una richiesta in modo più riproducibile.
Correggi il primo difetto visibile
| Cosa vedi | Azione successiva |
|---|---|
| Abito sbagliato nell’immagine iniziale | Correggere l’immagine statica prima di un’altra generazione video |
| Volto corretto all’inizio, diverso durante la rotazione | Ridurre la rotazione o preparare un angolo iniziale più informativo |
| Buon ritratto, ma poco spazio per il gesto | Allargare o ricomporre l’immagine iniziale |
| La camera avanza nonostante la richiesta di camera fissa | Eliminare le istruzioni di camera in conflitto e mantenere un comando di movimento |
| La rotazione richiesta non si conclude | Eliminare le azioni secondarie o consentire una durata maggiore |
| Hai un ritratto del personaggio, ma servono una nuova stanza e una nuova posa | Preparare la nuova apertura o usare l’attività separata da riferimento a video |
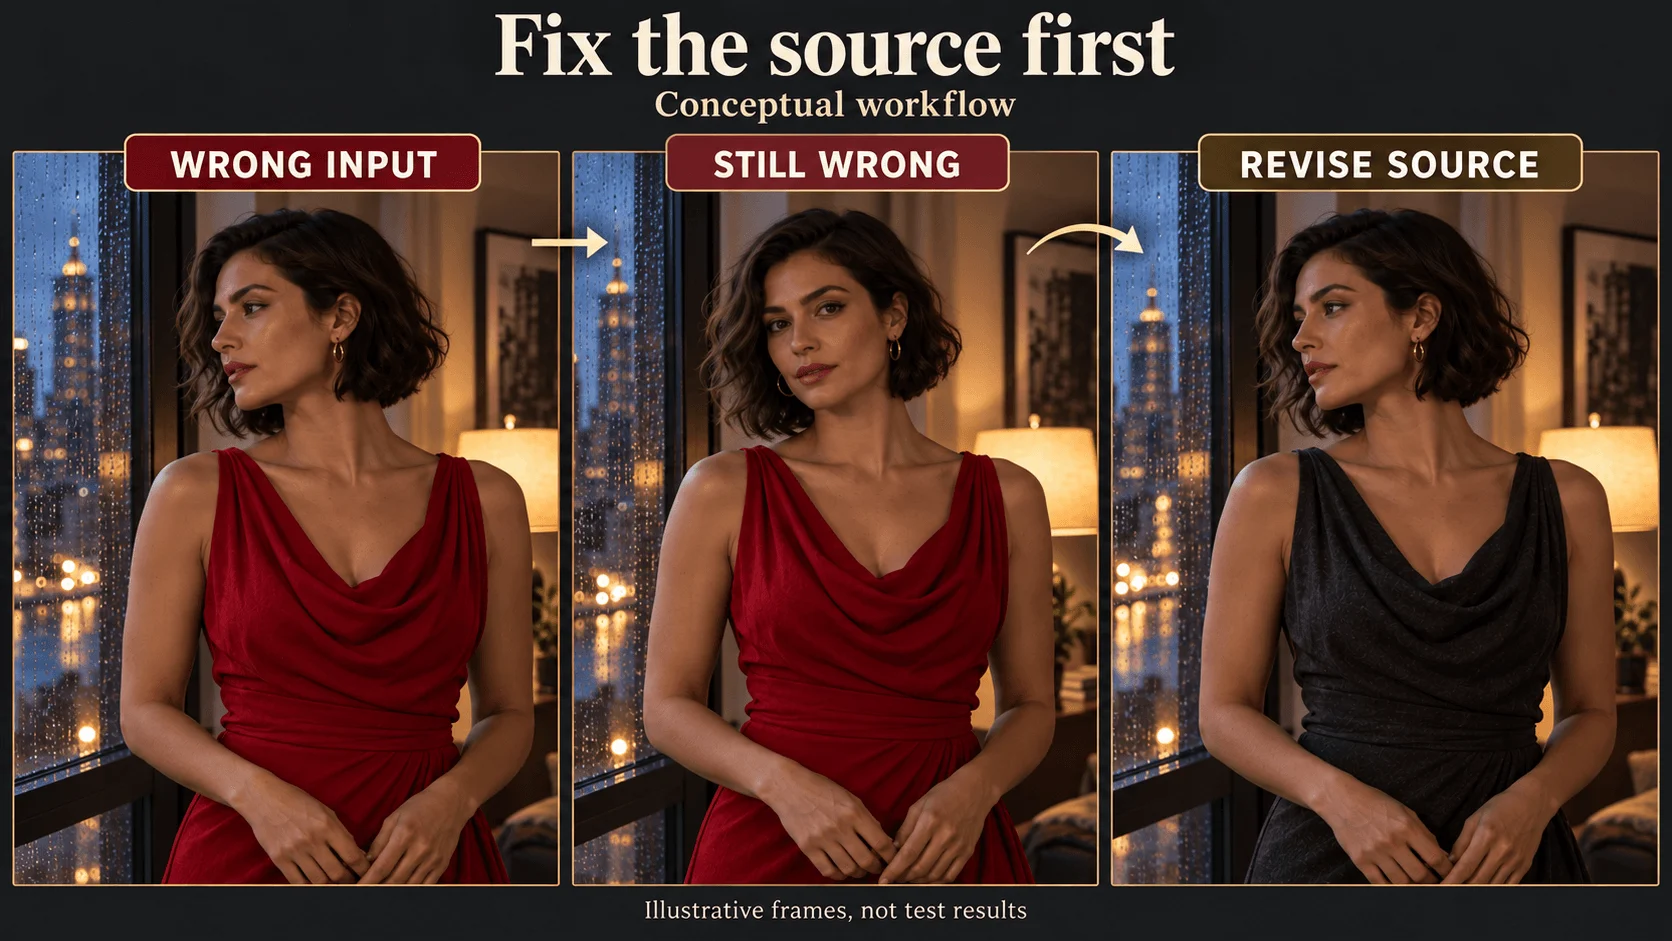
Se gli abiti iniziali sono sbagliati, modifica la fonte prima di un altro tentativo di movimento.
Un riferimento d’identità e un frame iniziale sono risorse diverse. Se vuoi Mara seduta a un tavolo, non caricare il suo ritratto alla finestra come apertura letterale aspettandoti che funzioni solo da riferimento del volto. H3 da riferimento a video è un’attività separata che accetta da una a nove immagini di riferimento; verifica separatamente input aggiuntivi e stima.
Esegui dall’API
Quando una generazione in Playground è soddisfacente, la stessa richiesta funziona dal codice. Questo è l’esempio da testo a video; per il flusso da immagine a video, cambia il modello in minimax/h3/image-to-video, elimina aspect_ratio e aggiungi image_url.
import os
import uuid

import requests

response = requests.post(
    "https://api.spicyapi.ai/api/v1/jobs/createTask",
    headers={
        "Authorization": f"Bearer {os.environ['SPICY_API_KEY']}",
        "Idempotency-Key": str(uuid.uuid4()),  # new key for each new request
    },
    json={
        "model": "minimax/h3/text-to-video",
        "input": {
            "prompt": "Vertical medium shot of Mara, a fictional 30-year-old woman with a short dark bob, wearing a charcoal evening dress beside a rain-streaked window. She slowly turns her head toward the camera, then holds eye contact. Static camera. Audio: soft rain, quiet room tone.",
            "aspect_ratio": "9:16",
            "resolution": "768p",
            "duration_seconds": 5,
        },
    },
)
print(response.json())
Campi, risultati ed errori sono nel riferimento API.
Oppure lascia che lo esegua un Agent. Un agente può fare la stessa chiamata tramite la CLI, il server MCP o l’Agent Skill. Tutti e tre leggono lo schema aggiornato del modello; CLI e MCP mostrano il prezzo e chiedono conferma prima di creare un’attività.
# CLI
npx @spicyapi/cli tasks create --model minimax/h3/text-to-video \
  --input-json '{"prompt": "Mara turns from a rain-streaked window toward the camera and holds eye contact. Static camera. Audio: soft rain.", "aspect_ratio": "9:16", "resolution": "768p", "duration_seconds": 5}' --wait

# MCP server: the command your assistant's MCP config runs
npx --yes --package=@spicyapi/mcp spicyapi-mcp

# Agent Skill
npx skills add spicyapi-ai/spicy-skill
Crea una scena più lunga di 15 secondi
Una richiesta H3 arriva al massimo a 15 secondi e non esiste un’attività di estensione. Approva la clip, estrai il suo frame finale e usalo come immagine iniziale dell’inquadratura successiva da immagine a video; ogni prompt descrive quindi solo ciò che accade dopo. In questo modo trasferisci l’aspetto della ripresa precedente al frame iniziale successivo, invece di chiedere al testo di ridefinire il personaggio ogni volta.
Quale percorso scegliere
Per una serie settimanale con un personaggio, approva un’immagine iniziale per ogni inquadratura e animala. Per una nuova ambientazione senza personaggi fissati, parti dal testo e tratta il risultato come esplorazione. Cambia quando volto e composizione diventano requisiti da preservare.