Hai un'immagine fissa del tuo personaggio adulto ricorrente, una breve scena in mente e una coda di clip da realizzare. Un workflow MiniMax H3 a quattro passi sembra la scelta ovvia. Poi il volto perde definizione durante una rotazione, il modello aggiunge un'azione mai richiesta oppure l'immagine funziona ma la voce no. Qui Turbo indica la LoRA di accelerazione della community per H3, non il prodotto commerciale separato H3 Max Turbo.
Scegli Turbo per riprese semplici e circoscritte e per esplorare rapidamente. Per una nuova configurazione testo/keyframe a 768p, FL2VA 8-step v1.0 768p è un punto di partenza documentato perché è l'attuale configurazione Studio dell'autore. Conserva un workflow base senza Turbo per una ripresa in cui l'azione richiesta continua a sparire. La scelta dello Studio e la dichiarazione dell'autore sul miglioramento di audio e video non dimostrano che otto passi producano generalmente dialoghi o dettagli dei tessuti migliori.
Ciò che sacrifichi non è una percentuale documentata di qualità. Scegli un modello adattato a una sequenza di campionamento molto più breve, con presupposti specifici sul task e sulla risoluzione. Il possibile costo è una realizzazione meno affidabile dei dettagli richiesti dalla tua scena. Nemmeno base promette una clip perfetta.
Non abbiamo eseguito scene per adulti con input identici su Turbo e base, quindi questo confronto non può classificare rifiuti, attenuazione dei contenuti o conservazione dei dettagli del personaggio. Spiega versioni rilasciate, indicazioni degli autori e segnalazioni della community, trasformando poi le differenze in scelte pratiche di workflow.
| Cosa devi realizzare | Da dove partire | Perché |
|---|---|---|
| Un breve teaser ritratto da un'immagine iniziale approvata | FL2VA Turbo corrispondente al task | Aspetto e composizione hanno già un punto di partenza visivo |
| Un nuovo workflow locale testo/keyframe a 768p | FL2VA 8-step v1.0 768p | L'attuale configurazione Studio dell'autore fornisce una ricetta iniziale documentata |
| Una nuova ripresa assemblata da riferimenti separati di personaggio, outfit e stanza | Ref2VA con il proprio checkpoint | Il condizionamento tramite riferimenti è un task diverso; le impostazioni FL2VA non sono intercambiabili |
| Una scena con riferimenti che continua a omettere un'azione necessaria | Ref2VA senza Turbo, con una sequenza d'azioni più semplice | Evita di spendere altri tentativi sulla stessa approssimazione veloce |
| Clip occasionali senza mantenere una configurazione locale | H3 ospitato, con il task realmente necessario | Acquisti una generazione completata alla tariffa mostrata invece di gestire un sampler |
Prima identifica quale «H3 Turbo» intendi
Questo confronto riguarda le LoRA Turbo ModelTC / LightX2V per il modello base aperto H3. Qui «base» significa H3 senza quella LoRA di accelerazione. Un prodotto commerciale chiamato H3 Max Turbo, l'adapter di accelerazione di un altro creator e un endpoint H3 ospitato sono scelte separate. Condividere «H3» o «Turbo» nel nome non rende intercambiabili qualità, impostazioni o prezzi.
Una LoRA Turbo ha anche una funzione diversa da una LoRA del personaggio. La prima cambia il modo in cui H3 raggiunge un risultato con meno valutazioni del modello; la seconda adatta un modello a una persona, uno stile o un concetto. Aggiungere un adapter di accelerazione non insegna al modello chi sia il tuo personaggio ricorrente di fantasia. Viceversa, caricare una LoRA del personaggio non stabilisce una ricetta di generazione a quattro passi.
La tabella dei checkpoint dell'autore distingue queste versioni:
| Checkpoint Turbo | Task | Dimensione di addestramento | Valutazioni consigliate | Shift video / audio |
|---|---|---|---|---|
| FL2VA 4-step v0.1 | Testo o keyframe | 544p, forme miste | 4 | 12 / 3 |
| FL2VA 8-step v1.0 | Testo o keyframe | 544p, forme miste | 8 o 4 | 12 / 3 |
| FL2VA 4-step v1.0 768p | Testo o keyframe | 1344 × 768 | 4 | 6 / 3 |
| FL2VA 8-step v1.0 768p | Testo o keyframe | 1344 × 768 | 8 | 6 / 3 |
| Ref2VA 4-step v0.1 | Riferimenti | 544p, forme miste | 4 | 12 / 3 |
FL2VA comprende la generazione solo testuale e il condizionamento con primo e ultimo fotogramma. Ref2VA è il ramo condizionato dai riferimenti. «VA» indica video e audio.
La distinzione pratica è immediata: un workflow a quattro passi con riferimenti non è l'alternativa a quattro passi a ogni workflow immagine a otto passi. Animare un ritratto iniziale e costruire una scena da tre immagini di riferimento impongono a H3 esigenze diverse. Scegli prima il task, poi il checkpoint di accelerazione compatibile.
La model card LightX2V identifica l'attuale modello dello Studio come FL2VA eight-step v1.0 768p e descrive miglioramenti di video e audio. È una dichiarazione dell'autore sulla versione. Offre un ragionevole punto di partenza per un nuovo workflow testo/keyframe; non dimostra che la stessa configurazione vinca su ogni scena per adulti o fine-tune precedente della community.
Cosa cambia con meno passi e cosa rimane invariato
Un passo di campionamento della diffusione è un'altra valutazione usata per avvicinare il risultato in sviluppo all'immagine, al movimento e al suono richiesti. La distillazione dei passi addestra un adapter per un percorso più breve attraverso quel processo. Non equivale a prendere un workflow base ordinario, cambiare «50» in «4» e aspettarsi lo stesso risultato.
H3 genera insieme immagine e colonna sonora. La documentazione dell'implementazione Diffusers descrive schedule separati per video e audio in un unico ciclo di denoising. Distingue anche il transformer per keyframe da quello per riferimenti. Queste differenze spiegano perché un disallineamento apparentemente piccolo nelle impostazioni possa influire sia sul movimento sia sul suono.
Per i creator ne derivano due conseguenze utili.
Primo, il numero di passi è solo una parte della ricetta. Adapter, schedule e task progettati insieme sono un punto di partenza più solido di una lista di impostazioni singolarmente popolari raccolte da workflow diversi. Uno screenshot visivamente impressionante non dice se l'autore abbia anche cambiato pesi base, quantizzazione, dimensioni dell'input o percorso audio.
Secondo, il campionamento più veloce non rende meno importante l'input. Una mano tagliata nel primo fotogramma resta un'informazione mancante. Un profilo laterale che contraddice il ritratto frontale resta un riferimento in conflitto. Un'istruzione di cinque secondi con un ingresso, una rotazione, un aggiustamento dell'outfit, una frase parlata e un'orbita della fotocamera continua a chiedere diversi eventi in un breve intervallo.
Il modo più utile di considerare il compromesso è la tolleranza agli errori in quella specifica ripresa. Se la consegna è un loop d'atmosfera silenzioso, una colonna sonora generata imperfetta può non costare nulla perché prevedi già di sostituirla. Se è un saluto personale da un personaggio ricorrente, parole sbagliate possono rendere inutilizzabile una clip altrimenti attraente.
Un risultato a otto passi può essere quello finale. Un risultato base può fallire. Nessuna etichetta dovrebbe deciderlo in anticipo. Scegliere un percorso serve a evitare di pagare capacità o compromessi non necessari alla tua ripresa.
Quando Turbo è una scelta utile per personaggi adulti
Un teaser ritratto con una sola azione visibile
Considera una donna di fantasia sulla trentina con un abito da sera in un appartamento illuminato delicatamente. Il ritratto iniziale è approvato: volto, capelli, outfit e stanza sono già corretti. Il video deve farla girare leggermente verso la fotocamera e fermarsi in un sorriso.
È un task Turbo sensato perché il brief contiene un unico cambiamento principale. Lo spettatore deve riconoscere il personaggio e leggerne l'espressione; la clip non deve introdurre un'altra persona, ricostruire una stanza non visibile o sincronizzare una conversazione. Da immagine a video offre al movimento una composizione iniziale esplicita.
Affida all'immagine iniziale i dettagli dell'aspetto. Inserisci azione, fotocamera e suono nel prompt di movimento. Ripetere una lunga descrizione fisica può introdurre differenze rispetto all'immagine: un nuovo aggettivo sull'acconciatura o un colore del vestito leggermente diverso diventano altre istruzioni da conciliare.
Lo stesso approccio vale per una serie privata per adulti quando la fonte è più matura. La decisione sull'accelerazione riguarda quanto movimento e continuità debba offrire la clip. La parola «Turbo» da sola non fornisce prove che un particolare servizio ospitato accetti il contenuto richiesto.
Una scena finita con dialogo
Per un breve saluto, usa una ricetta dell'autore corrispondente al task, una frase corta e abbastanza tempo perché il personaggio parli. Mantieni modesto il movimento. Un'orbita della fotocamera, una rotazione completa del corpo e una frase rivolta allo spettatore creano esigenze concorrenti di orientamento del volto e temporizzazione.
Se la frase parlata è il prodotto, considera essenziale l'intelligibilità. Una clip con espressione corretta e parole errate non è un saluto più economico. Se la voce resta inaffidabile con il workflow attuale, un tentativo base o una traccia vocale prodotta separatamente sono passaggi più mirati che aggiungere cinque sinonimi di «voce chiara».
L'audio separato è particolarmente pratico per una narrazione fuori campo o un montaggio di ritratti silenziosi. È meno semplice quando la bocca visibile del personaggio deve corrispondere a una frase precisa. Questa distinzione dovrebbe influenzare la ripresa prima del rendering.
Due personaggi o più ruoli dei riferimenti
Una coppia ricorrente in una stanza familiare richiede più di due bei volti. La scena può dover conservare chi indossa quale outfit, dove si trova ciascuno, chi si muove per primo e chi parla. Se i riferimenti assegnano questi ruoli, scegli Ref2VA e specifica esplicitamente la funzione degli input.
Una recente discussione della community sulle impostazioni H3 senza Turbo include il resoconto di un creator: Turbo gestiva richieste semplici ma ometteva istruzioni o inventava eventi nelle scene con riferimenti più complesse. Il resoconto non misura un tasso universale di fallimento. È un avvertimento utile proprio quando una relazione o un'azione mancante invalida la clip.
Se un'azione complessa è essenziale e il percorso rapido continua a ometterla, un workflow con riferimenti senza Turbo è una diramazione ragionevole. Se serve soltanto un teaser breve, semplifica invece la ripresa: un personaggio reagisce mentre l'altro resta fermo, oppure dividi la sequenza in due riprese corte. È una decisione editoriale su come raccontare la scena, non l'affermazione che più passi garantiscano un'interazione corretta.
Una sequenza esplorativa che prevedi di scartare
Turbo è sensato anche quando lo scopo della clip è rispondere a una domanda creativa preliminare: il personaggio si gira verso la finestra o verso lo spettatore? La fotocamera resta vicina o arretra? L'atmosfera funziona meglio prima o dopo che il personaggio si siede?
Qui l'output temporaneo può essere utile nonostante difetti di texture che lo escluderebbero come video finito. Conserva la scelta creativa riuscita, poi genera la ripresa finale con percorso e risoluzione appropriati alla consegna. Non presumere che un nuovo rendering base riproduca esattamente la ripresa Turbo. Se conta un fotogramma particolare, conservalo come input immagine della ripresa successiva invece di trattare un seed come uno storyboard trasferibile.
Usa le impostazioni del checkpoint scelto
Le istruzioni ComfyUI dell'autore richiedono ComfyUI 0.31.0 o successivo, usano i nodi H3 principali e impostano Euler come campionamento predefinito. Dicono esplicitamente di impostare insieme adapter, numero di passi ed entrambi gli shift. Le dimensioni dell'immagine devono essere multipli di 32.
Questa è la ricetta iniziale. È anche una base diagnostica più utile del presumere che un vecchio workflow condiviso corrisponda ancora al file del modello più recente.
Per una ripresa FL2VA a 768p, seleziona l'adapter 768p e le impostazioni corrispondenti della tabella. Aumentare soltanto la tela del vecchio workflow 544p non lo trasforma nella versione addestrata a 768p. Per una scena con riferimenti, usa adapter e workflow dei riferimenti. La guida alla configurazione Diffusers avverte di non mettere un adapter FL2VA sul transformer dei riferimenti salvo sia stato addestrato specificamente per esso; il suo esempio Ref2VA senza Turbo usa 50 valutazioni.
Cinquanta è una base fornita dall'autore, non la scoperta che ogni scena richieda esattamente cinquanta. Analogamente, otto non è un'impostazione universale di riparazione per qualsiasi file con «4-step» nel nome. Usa il conteggio consigliato per la versione scelta prima di esplorare schedule personalizzati.
Un dettaglio tecnico conta seguendo tutorial diversi: NFE significa valutazioni del modello, e le interfacce non contano sempre i «passi» allo stesso modo. Lo script di inferenza ModelTC definisce l'argomento dei passi come valutazioni e aggiunge il punto terminale dello schedule richiesto da Diffusers. Copiare lo stesso numero in un wrapper diverso può quindi descrivere uno schedule diverso. Usa il significato documentato di quel wrapper invece di correggere un grafo funzionante dell'autore perché un'altra schermata mostra un punto in più.
Non considerare la forza della LoRA di accelerazione un cursore d'intensità dei contenuti per adulti. Controlla l'influenza dell'adapter sul modello. Ridurla cambia la ricetta di accelerazione; aumentarla non dimostra un comportamento più permissivo dei contenuti. Se usi anche una LoRA di personaggio o stile, tienila distinta dall'impostazione Turbo sia concettualmente sia nel workflow.
La risoluzione cambia il compromesso che stai scegliendo
Un ritratto ravvicinato e una composizione a figura intera possono avere le stesse dimensioni di output ed esigenze molto diverse sul dettaglio del volto. Nel ritratto, il volto occupa gran parte dell'immagine. A figura intera può essere così piccolo che un movimento minimo elimina distinzioni utili attorno a occhi o bocca.
Per un personaggio adulto ricorrente, l'inquadratura è quindi una scelta creativa oltre che un costo di rendering. Se la riconoscibilità conta più della stanza, avvicina la composizione iniziale. Spendere altri pixel su una parete vuota sostituisce male lo spazio necessario al volto.
Le versioni Turbo 544p e 768p rendono più esplicita questa scelta. Usa la risoluzione adatta al checkpoint anziché presumere che un adapter si comporti identicamente a ogni dimensione della tela. Chi crea ritratti deve anche notare che la tela di addestramento 768p indicata è orizzontale. Puoi scegliere altre forme supportate nel workflow, ma la specifica pubblicata dell'addestramento non dimostra qualità uguale a ogni rapporto d'aspetto.
Il ridimensionamento dei riferimenti è un altro controllo distinto. ModelTC consiglia la policy match per l'inferenza distillata con riferimenti perché segue la policy di addestramento. Conserva la forma, segue il budget di pixel obiettivo e non ingrandisce un input più piccolo. È diverso dal forzare ogni riferimento a un lato corto di 2048 pixel. Dimensioni maggiori dei riferimenti, da sole, non giustificano aspettative di identità migliore o generazione più veloce.
La preparazione utile per il creator è semplice: fornisci un riferimento chiaro i cui dettagli importanti siano visibili prima del ridimensionamento. Evita un volto in un minuscolo angolo di un collage molto grande. Se la fonte ha mani ambigue, gioielli elaborati o una fantasia del vestito impastata dalla compressione, correggi l'immagine fissa prima di chiedere a uno dei due percorsi di animarla.
I dettagli fini hanno anche un requisito temporale. Un motivo simile al pizzo bello in un fotogramma ma che cambia forma ogni pochi fotogrammi distrae durante il movimento. Aumentare le dimensioni di output può rendere l'instabilità più visibile. Un upscaler può ingrandire un file; non può stabilire quale delle fantasie variabili fosse quella desiderata.
Se movimento e identità della clip sono già utili, l'ingrandimento può essere adatto alla consegna. Se l'identità cambia o il tessuto si trasforma, rigenera o semplifica prima la ripresa. Così eviti di pagare per rendere più nitido un errore.
I problemi audio richiedono una diagnosi più specifica
Il motivo più forte per essere prudenti con l'audio Turbo è la varietà dei sintomi segnalati, non l'affermazione che tutte le clip H3 veloci suonino male.
In una discussione LightX2V sugli effetti sonori, un creator segnalava effetti assenti o deboli; un altro descriveva lieve distorsione o eco lodando però l'immagine. Altrove, il primo thread del manutentore sulla conversione ComfyUI segnalava una differenza audio fra implementazioni, seguita da una risposta della community che indicava una correzione. Sono osservazioni sensibili a configurazione e versione, non un benchmark attuale di ogni versione.
La distinzione conta perché i rimedi sono diversi.
Manca un effetto ambientale delicato. Se la clip è altrimenti corretta, aggiungi l'effetto in montaggio. Un breve fruscio di tessuto o l'ambienza della stanza non giustificano solitamente rigenerare tutta la performance del personaggio. Se il suono deve coincidere con un'azione visibile, posizionalo su quell'azione nel montaggio.
Il personaggio parla quando la scena dovrebbe essere silenziosa. Rendi esplicito il suono desiderato e rimuovi formulazioni che suggeriscono conversazione. Se la bocca resta ferma, sostituire l'audio può completare la ripresa. Se la bocca forma visibilmente parole inventate, silenziare la traccia lascia un problema visivo; accorcia la parte utilizzabile o rigenera eliminando il dialogo dalla scena.
Le parole richieste sono sbagliate. Mantieni un solo parlante, una sola frase breve e abbastanza tempo attorno a essa. Usa la sintassi di dialogo documentata per il workflow selezionato. Se la frase resta errata, cambia percorso o produci la voce separatamente; accumulare parlato, musica ed effetti nel prompt aggiunge altre possibili fonti di errore.
L'intera colonna sonora è distorta o instabile. Torna al workflow attuale dell'autore e agli schedule abbinati video/audio prima di decidere che servono più passi. Un problema d'implementazione e uno di richiesta creativa non devono portarti nello stesso ciclo di nuovi rendering.
Nella narrativa per adulti, suoni discreti possono essere una parte importante dell'atmosfera. Puoi comunque decidere che l'immagine generata abbia valore e completare la colonna sonora separatamente. Fallo come scelta produttiva consapevole, includendo il tempo di editing audio nel costo della clip.
Una ripresa utilizzabile del personaggio di cinque secondi
Ecco un esempio di pianificazione per il personaggio ricorrente di fantasia di un creator per adulti. È un prompt adattabile, non il resoconto di un risultato generato.
L'immagine sorgente mostra una donna di fantasia sulla trentina con un abito da sera rosso scuro accanto alla finestra di una suite d'albergo. Il volto è chiaro, una mano poggia sul davanzale e l'altra è visibile vicino alla vita. Una lampada nella stanza fornisce luce calda. Non ci sono specchi, didascalie o persone aggiuntive.
La ripresa richiesta è volutamente piccola: gira la testa verso lo spettatore, mantiene il contatto visivo e accenna un sorriso. Basta per un teaser del personaggio. Conserva il contesto per adulti senza chiedere a una clip di cinque secondi diversi eventi non correlati.
Per un workflow locale che accetta il formato di prompt strutturato, usa:
integratedmultimodaldescription: Usa Picture 1 come composizione iniziale. [Shot 1] La donna di fantasia sulla trentina resta accanto alla finestra con lo stesso abito da sera rosso scuro. Gira lentamente la testa verso la fotocamera, mantiene il contatto visivo e accenna un sorriso. Entrambe le mani restano nelle posizioni iniziali. La fotocamera resta ferma. Conserva volto, acconciatura, abito, finestra e illuminazione calda della lampada per tutta questa singola ripresa.
overall_soundscape: Ambiente interno silenzioso con un breve e debole movimento del tessuto. Nessun dialogo.
nondiegeticmusic: N/A.
La struttura segue la separazione fra immagini, ambienza e musica nella guida ai prompt di MiniMax. Scena e formulazione qui sono originali. Nel Playground ospitato, inserisci le stesse istruzioni visive e sonore nel campo prompt e carica l'immagine iniziale nell'input immagine; queste etichette sono testo del prompt, non campi API aggiuntivi.
Perché queste istruzioni sono utili
L'immagine iniziale determina l'aspetto. «Gira la testa» definisce un cambiamento più piccolo di «si gira verso la fotocamera», interpretabile come una rotazione completa del corpo. Tenere entrambe le mani ferme elimina un'azione non necessaria. Una fotocamera ferma evita di cambiare la scala del volto mentre il personaggio si muove. «Singola ripresa» chiarisce che non vuoi un taglio su un altro angolo.
Questo non garantisce il rispetto delle istruzioni. Rende più facile identificare e correggere un movimento indesiderato perché il brief è inequivocabile.
Se vuoi un po' più di energia, cambia un solo requisito creativo: sostituisci la rotazione della testa con una lieve inclinazione verso la fotocamera mantenendo il resto. È una nuova idea di ripresa, non un test di qualità. Se vuoi invece muovere la fotocamera, mantieni il personaggio quasi fermo e chiedi un breve e lento avvicinamento. Combinare subito entrambi rende più difficile conservare la composizione ravvicinata già scelta.
Aggiungi un saluto parlato solo se ti serve
Per una variante di saluto, rimuovi «Nessun dialogo» e aggiungi una frase corta dopo il sorriso. In un workflow locale che usa i tag di dialogo MiniMax, una frase può avere questa forma: She says <d>[English] I saved this moment for you.</d> Mantieni naturale l'interpretazione e lascia tempo per l'espressione prima e dopo.
Non aggiungere un secondo parlante o canto di sottofondo alla stessa richiesta breve. Lo scopo della variante è pronunciare quella frase con la voce del personaggio, quindi qualunque elemento concorrente deve giustificare la propria presenza.
Usa riferimenti quando ti serve una nuova composizione
Immagina che l'episodio successivo richieda la stessa donna seduta su un divano nella medesima suite. Il ritratto originale alla finestra è ora un riferimento d'identità, non necessariamente il fotogramma iniziale del video. Questo cambia il task.
Usa un'immagine chiara del personaggio, una dell'outfit se necessaria e una che definisce la stanza. Dì al workflow con riferimenti che la prima definisce la donna, la seconda l'outfit e la terza la stanza. Poi descrivi la ripresa seduta. Evita di chiedere a tutte e tre di determinare contemporaneamente il fotogramma iniziale.
Se ti serve precisamente la composizione seduta, crea e approva prima quell'immagine fissa, poi animala da immagine a video. Hai spostato una decisione compositiva difficile alla fase dell'immagine fissa, dove è più facile vederla e correggerla. Può valere più che cambiare il sampler video.
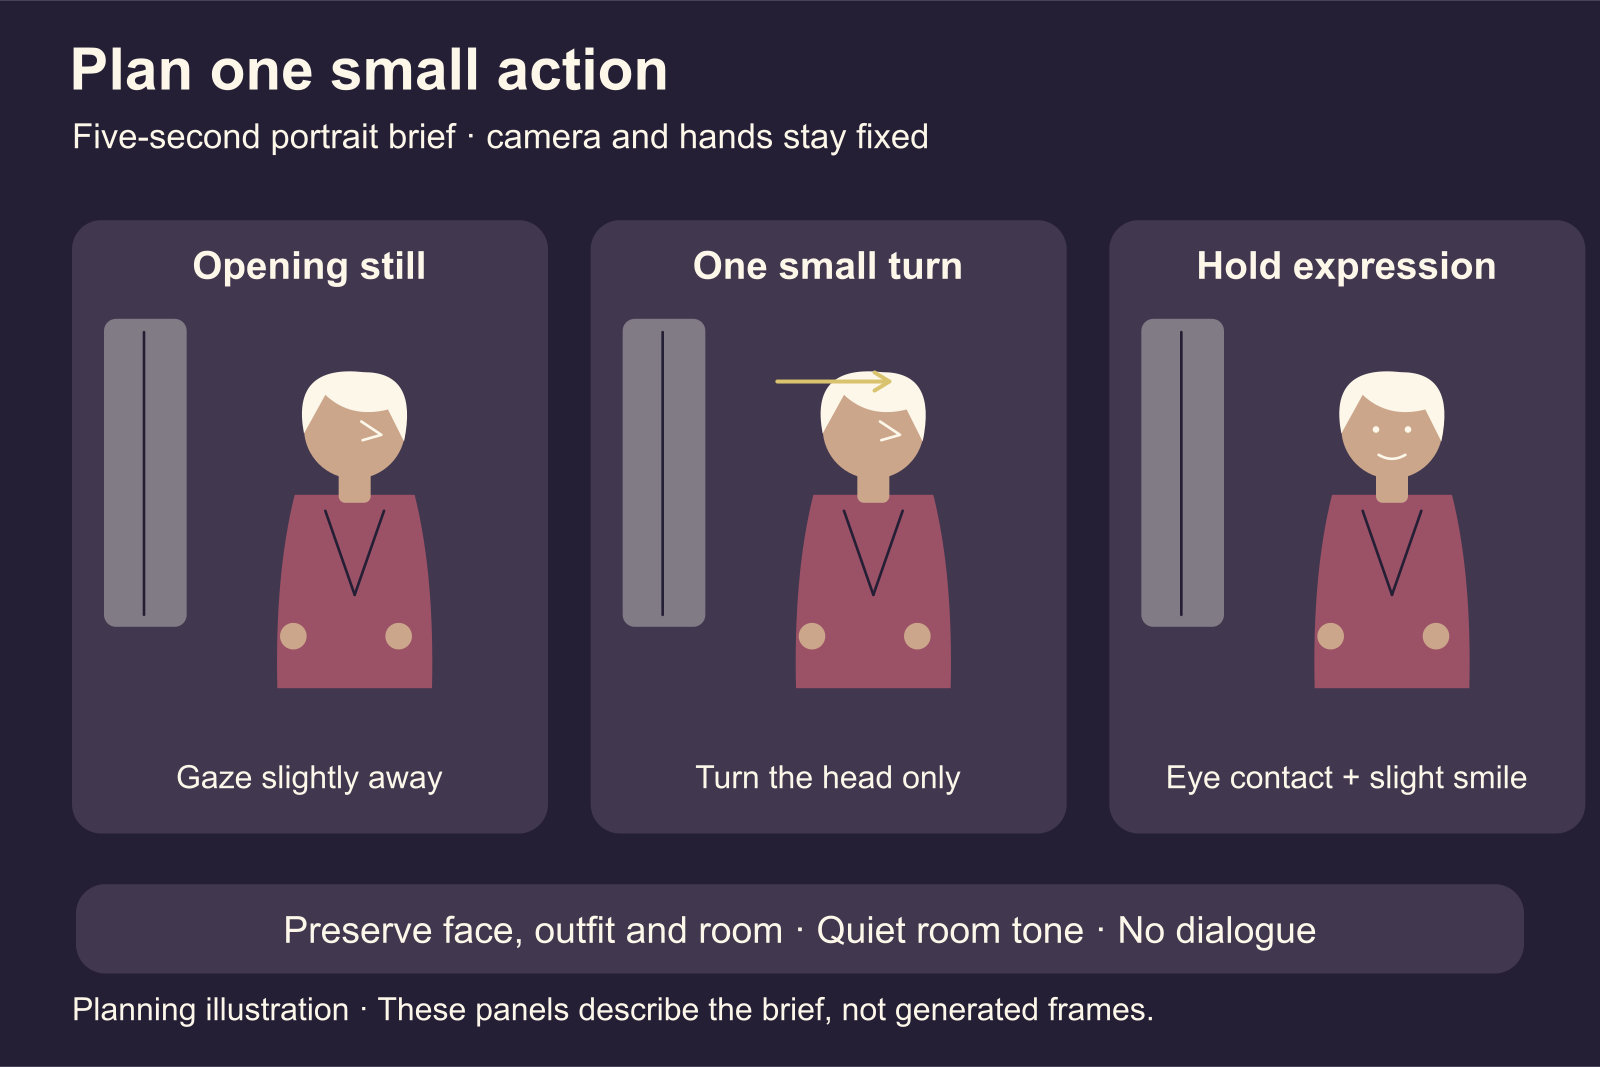
Illustrazione di pianificazione: mantieni fotocamera e mani ferme chiedendo una piccola rotazione della testa.
Quando un risultato fallisce, cambia la parte che ha fallito
Una clip veloce deludente è un sintomo. Non identifica automaticamente Turbo come causa.
| Cosa vedi o senti | Modifica successiva utile | Perché viene prima di un altro tentativo casuale |
|---|---|---|
| Il volto è poco chiaro già nell'immagine iniziale | Migliora o ritaglia l'immagine prima dell'animazione | Il video richiede una fonte riconoscibile |
| Il volto cambia soprattutto durante una grande rotazione | Riduci la rotazione o fornisci una vista adatta tramite il task con riferimenti | L'intervallo difficile è l'angolo appena rivelato |
| Il modello aggiunge una camminata, un gesto o una seconda azione | Sostituisci il linguaggio ampio con una sola azione visibile ed elementi esplicitamente fermi | Il movimento richiesto può essere ambiguo |
| Diverse istruzioni essenziali dei riferimenti continuano a sparire | Usa Ref2VA senza Turbo o dividi la scena in riprese più semplici | Ripetere lo stesso percorso veloce non cambia il requisito difficile |
| Mani o capelli si sfocano durante il movimento | Usa la ricetta corrispondente al task, poi riduci i movimenti superflui | Possono contribuire sia configurazione sia complessità del movimento |
| L'immagine funziona ma un breve effetto sonoro no | Aggiungi l'effetto in montaggio | Conserva una performance visiva utile |
| La frase è confusa e la bocca si muove male | Accorcia la frase o cambia percorso di generazione | Sostituire la traccia da sola non corregge il parlato visibile |
| L'intera immagine peggiora dopo l'aggiunta di Turbo | Ripristina adapter, schedule, task e risoluzione corrispondenti | Una ricetta non compatibile non costituisce un confronto significativo fra base e Turbo |
Una discussione sulle LoRA dei riferimenti su Hugging Face include segnalazioni di mani sfocate e perdita di dettaglio dei capelli in movimento, insieme a consigli di cambiare adapter e sampler. Considerali indizi dei problemi incontrati. Alcuni consigli mescolano adapter di task diversi, in contrasto con le attuali indicazioni di compatibilità dell'autore; non sono una soluzione universale affidabile.
Esiste un punto pratico in cui fermarsi. Se la fonte è chiara, la ricetta corrisponde e la stessa azione richiesta continua a sparire, passa a base o riscrivi la ripresa. La domanda utile non è più se puoi trovare un risultato veloce fortunato, ma se quella ricerca costi meno del cambio di approccio.
Rendering più veloce e clip finite più economiche sono numeri diversi
Quattro valutazioni contro otto dicono qualcosa sul lavoro ripetuto del modello. Non dicono che un intero job richieda esattamente metà tempo. Caricamento, elaborazione degli input, decodifica, trasferimento dei pesi e salvataggio richiedono anch'essi tempo. Un primo job a freddo e uno successivo con componenti già disponibili possono sembrare molto diversi.
Nel lavoro locale ci sono anche due tempi. La GPU può lavorare mentre fai altro, ma diagnosticare un grafo o esaminare ripetutamente riprese fallite richiede attenzione. Un percorso che riduce il rendering senza supervisione aggiungendo correzioni manuali può essere un cattivo compromesso per chi crea poche clip.
Per l'hosting a pagamento, usa la tariffa effettivamente mostrata. La tabella seguente non contiene un prezzo Turbo. Sono prezzi pubblici del task standard H3 da immagine a video di SpicyAPI, con immagine iniziale. Gli input pubblici non espongono passi di campionamento locali o l'adapter ModelTC Turbo.
| Risoluzione H3 standard ospitato | Per secondo di output | Una clip di 5 secondi | Dieci generazioni di 5 secondi |
|---|---|---|---|
| 768p | $0.037 | $0.185 | $1.85 |
| 2k | $0.058 | $0.290 | $2.90 |
Il calcolo è tariffa × secondi di output richiesti × generazioni. Da riferimenti a video ha propri costi dei riferimenti, quindi non applicare questa tabella da immagine a video invariata a una richiesta con più riferimenti.
Questi numeri offrono un'alternativa concreta al mantenimento di un workflow locale. Non indicano quanti tentativi serviranno e non stabiliscono un confronto di velocità con la tua GPU.
Il numero che include le riprese scartate
Immagina di generare dieci clip di cinque secondi a 768p a $0.185 ciascuna. La spesa delle generazioni completate è $1.85. Se cinque sono utilizzabili nel progetto, il costo di generazione per clip utilizzabile è $1.85 ÷ 5 = $0.37. Se sono due, è $1.85 ÷ 2 = $0.925. Sono quantità illustrative di risultati accettati applicate a tariffe ospitate reali, non tassi di successo H3 osservati.
Una generazione riuscita che scarti perché espressione, movimento o voce sono errati rientra comunque nel calcolo. È diversa da un task che non genera. Tempo di editing, una voce esterna e ingrandimento si aggiungerebbero al costo della clip finita.
Lo stesso ragionamento vale per Turbo locale. Supponi che un tentativo veloce consumi metà tempo di uno base. Se il percorso veloce richiede il doppio dei tentativi per un risultato accettabile, il vantaggio di rendering è scomparso prima di contare valutazione e correzione. È un esempio di pareggio, non un'affermazione su quei tempi o percentuali di successo di H3.
Più in generale, Turbo risparmia tempo di rendering per clip utilizzabile quando il tempo per tentativo diviso per la quota utilizzabile è inferiore all'equivalente di base. Una percentuale di risultati accettati leggermente peggiore può comunque convenire se il guadagno di velocità è grande; un calo marcato può annullarlo. Non serve un benchmark universale per capire il compromesso.
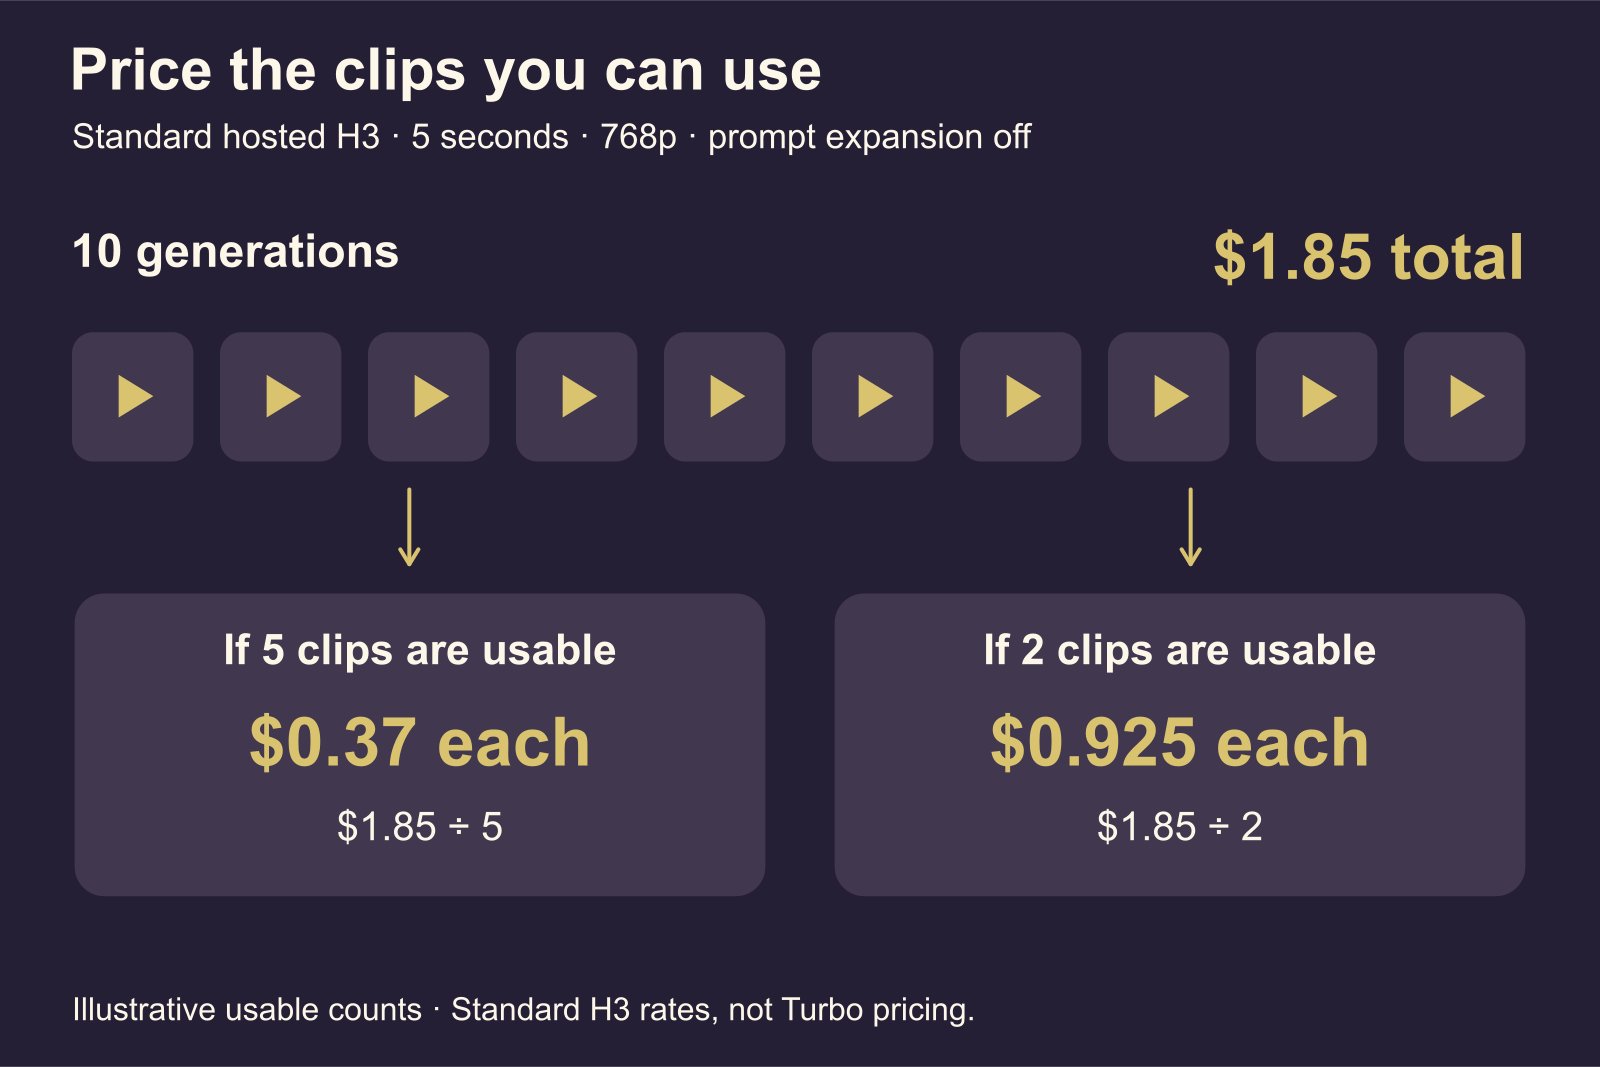
Quantità illustrative di risultati accettati applicate alla tariffa standard H3 ospitata; non sono tassi di successo misurati o prezzi Turbo.
Anche il denaro per le anteprime può essere sprecato
Quattro tentativi di cinque secondi a 768p più uno di cinque secondi a 2k sul task standard ospitato costano 4 × $0.185 + $0.29 = $1.03. Può essere un modo utile di scegliere economicamente azione e composizione della ripresa.
Ma il tentativo finale è una nuova generazione, non una copia garantita ad alta risoluzione della bozza scelta. Se tutte e quattro le anteprime servivano a giudicare piccoli dettagli del volto, la fase a bassa risoluzione potrebbe non aver risposto alla domanda necessaria. Parti dalla risoluzione di consegna quando la decisione riguarda specificamente piccoli tratti, tessuto o volto di un personaggio a figura intera.
Nel lavoro locale, applica lo stesso principio alle anteprime Turbo. Usale per scegliere cose che un'anteprima può mostrare: ritmo, inquadratura approssimativa e compatibilità dell'azione con il personaggio. Non presumere che dimostrino già che un diverso rendering base o una diversa tela conserveranno ogni espressione.
Cosa dovrebbero scegliere ora i creator NSFW
Per un teaser semplice del personaggio, silenzioso o con ambienza leggera, inizia con il workflow Turbo appropriato e una buona immagine iniziale. Usa la tabella dei checkpoint per scegliere una ricetta supportata per task e tela. Conserva un risultato Turbo che soddisfa il brief: l'etichetta non rende una ripresa finita soltanto una bozza.
Per una scena guidata dai riferimenti con diverse relazioni essenziali, usa il percorso dedicato ai riferimenti. Mantieni base disponibile quando la versione veloce continua a perdere quelle relazioni. Per il dialogo, decidi presto se il parlato generato sia essenziale o se puoi finire il suono separatamente.
La capacità sui contenuti resta specifica del servizio. La pagina standard H3 da immagine a video di SpicyAPI riporta esiti di test sui contenuti per adulti per quel task; non stabiliscono il comportamento di una configurazione Turbo locale o di un altro servizio. Accelerazione non significa supporto NSFW. Per le distinzioni fra le famiglie H3 ospitate, usa il confronto H3, Spicy, LoRA e Singularity.
Il passaggio utile è scegliere una ripresa che ti serve davvero, assegnarla a keyframe o riferimenti e usare la ricetta rilasciata corrispondente. Se vuoi un workflow ospitato con fotogramma iniziale, porta il brief di cinque secondi sopra alla pagina standard H3 da immagine a video, carica l'immagine approvata e controlla la stima. Giudica l'acquisto dalla scena finita che puoi usare: personaggio giusto, movimento richiesto e suono utile alla clip.