У вас есть статичный кадр постоянного взрослого персонажа, короткая сцена в голове и очередь роликов. Четырёхшаговый процесс MiniMax H3 кажется очевидным выбором. Затем лицо теряет чёткость при повороте, модель добавляет незапрошенное действие либо картинка удаётся, а голос нет. Здесь Turbo — ускоряющая LoRA сообщества для H3, а не отдельный коммерческий продукт H3 Max Turbo.
Выбирайте Turbo для простых ограниченных кадров и быстрого поиска. Для новой локальной схемы text/keyframe при 768p документированная отправная точка — FL2VA 8-step v1.0 768p, поскольку это текущая конфигурация Studio автора. Сохраняйте базовый процесс без Turbo для кадра, в котором обязательное действие постоянно пропадает. Выбор Studio и заявление автора об улучшении аудио и видео не доказывают, что восемь шагов в целом дают лучший диалог или детали ткани.
Вы не отдаёте документированный процент качества. Вы выбираете модель, адаптированную к намного более короткой схеме семплирования, со своими предпосылками о задаче и разрешении. Возможная цена — менее надёжное выполнение конкретных деталей вашей сцены. Base тоже не обещает идеального ролика.
Мы не пропускали взрослые сцены с одинаковыми входами через Turbo и base, поэтому сравнение не ранжирует отказы, смягчённый контент или сохранение деталей персонажа. Оно объясняет выпущенные версии, рекомендации автора и сообщения сообщества об ошибках, затем переводит различия в практический выбор процесса.
| Что нужно создать | С чего начать | Почему |
|---|---|---|
| Короткий портретный тизер от утверждённого первого кадра | Соответствующий задаче FL2VA Turbo | Для внешности и композиции уже есть визуальная основа |
| Новый локальный процесс text/keyframe при 768p | FL2VA 8-step v1.0 768p | Текущая конфигурация Studio автора даёт документированный начальный рецепт |
| Новый кадр из отдельных референсов персонажа, одежды и комнаты | Ref2VA с собственным checkpoint | Обусловливание референсами — другая задача; настройки FL2VA не взаимозаменяемы |
| Референсная сцена, которая постоянно опускает нужное действие | Ref2VA без Turbo с более простой последовательностью действий | Не тратьте новые попытки на то же быстрое приближение |
| Редкие ролики без поддержки локальной установки | Размещённый H3 с фактически нужной задачей | Вы покупаете завершённую генерацию по показанной ставке вместо управления sampler |
Сначала определите, какой «H3 Turbo» вы имеете в виду
Сравнение посвящено Turbo LoRA от ModelTC / LightX2V для открытой базовой модели H3. «Base» здесь — H3 без этой ускоряющей LoRA. Коммерческий продукт H3 Max Turbo, ускоряющий адаптер другого автора и размещённый эндпоинт H3 — отдельные варианты. Общие слова «H3» или «Turbo» в имени не делают качество, настройки или цены взаимозаменяемыми.
Turbo LoRA также решает другую задачу, чем LoRA персонажа. Одна меняет путь H3 к результату при меньшем числе вычислений модели; другая адаптирует модель к человеку, стилю или концепции. Добавление ускоряющего адаптера не учит модель узнавать постоянного вымышленного персонажа. И наоборот: загрузка LoRA персонажа не задаёт рецепт генерации в четыре шага.
Таблица checkpoint автора различает такие выпуски:
| Turbo checkpoint | Задачи | Размер обучения | Рекомендованные вычисления | Video / audio shift |
|---|---|---|---|---|
| FL2VA 4-step v0.1 | Текст или ключевые кадры | 544p, разные формы | 4 | 12 / 3 |
| FL2VA 8-step v1.0 | Текст или ключевые кадры | 544p, разные формы | 8 или 4 | 12 / 3 |
| FL2VA 4-step v1.0 768p | Текст или ключевые кадры | 1344 × 768 | 4 | 6 / 3 |
| FL2VA 8-step v1.0 768p | Текст или ключевые кадры | 1344 × 768 | 8 | 6 / 3 |
| Ref2VA 4-step v0.1 | Референсы | 544p, разные формы | 4 | 12 / 3 |
FL2VA охватывает генерацию только из текста и обусловливание первым/последним кадром. Ref2VA — ветка с обусловливанием референсами. «VA» означает video и audio.
Практическая разница видна сразу: четырёхшаговый референсный процесс — не четырёхшаговая альтернатива каждому восьмишаговому процессу изображений. Запрос оживить начальный портрет и запрос собрать сцену из трёх референсных картинок предъявляют разные требования H3. Сначала выберите задачу, затем совместимый ускоряющий checkpoint.
Model card LightX2V называет текущей моделью Studio FL2VA eight-step v1.0 768p и описывает улучшения видео и аудио. Это заявление автора о выпуске. Оно даёт разумный старт для нового text/keyframe-процесса, но не доказывает победы той же настройки в каждой взрослой сцене или старом fine-tune сообщества.
Что меняет меньшее число шагов, а что остаётся прежним
Шаг диффузионного семплирования — очередное вычисление, приближающее создаваемый результат к нужным изображению, движению и звуку. Дистилляция шагов обучает адаптер более короткому пути. Это не то же самое, что взять обычный базовый процесс, заменить «50» на «4» и ждать того же результата.
H3 генерирует изображение и звуковую дорожку вместе. Документация реализации Diffusers описывает отдельные схемы видео и аудио внутри одного цикла удаления шума. Она также различает transformer ключевых кадров и transformer референсов. Эти различия объясняют, почему на вид небольшое несовпадение настроек может влиять и на движение, и на звук.
Для авторов есть два полезных следствия.
Во-первых, число шагов — лишь часть рецепта. Адаптер, схема и задача, созданные вместе, дают более сильную основу, чем набор популярных по отдельности настроек из несвязанных процессов. Эффектный скриншот не показывает, менял ли автор также базовые веса, квантизацию, размер входа или аудиопуть.
Во-вторых, быстрое семплирование не уменьшает важность входных данных. Обрезанная кисть на первом кадре всё ещё означает отсутствие информации. Профиль, противоречащий фронтальному портрету, остаётся конфликтующим референсом. Пятисекундная инструкция с появлением, поворотом, поправлением одежды, произнесённой фразой и облётом камеры всё равно просит несколько событий за короткий интервал.
Полезнее всего понимать этот обмен как допустимость ошибок именно в данном кадре. Если нужен беззвучный атмосферный loop, несовершенная сгенерированная дорожка может ничего не стоить, потому что её планировалось заменить. Если нужен личный привет от постоянного персонажа, неправильные слова способны сделать красивый ролик непригодным.
Восьмишаговый результат может быть финальным. Базовый может не удаться. Ни одна метка не должна решать это заранее. Смысл выбора маршрута — не платить за возможности или компромиссы, которые кадру не нужны.
Когда Turbo полезен для взрослых персонажей
Портретный тизер с одним видимым действием
Представьте вымышленную женщину тридцати с небольшим лет в вечернем платье в мягко освещённой квартире. Начальный портрет утверждён: лицо, волосы, одежда и комната уже правильные. Видео должно немного повернуть её к камере и завершиться улыбкой.
Это разумная задача Turbo: в задании одно главное изменение. Зритель должен узнавать персонажа и читать выражение; ролику не нужно вводить второго человека, восстанавливать невидимую комнату или синхронизировать разговор. Image-to-video даёт движению явную начальную композицию.
Оставьте детали внешности начальному изображению. Действие, камеру и звук поместите в промпт движения. Повторение длинного физического описания может внести расхождения с картинкой: новое прилагательное о причёске или чуть другой цвет платья становится ещё одной инструкцией для согласования.
Для частной взрослой серии тот же подход действует и при более взрослом исходном изображении. Решение об ускорении касается необходимого движения и непрерывности ролика. Само слово «Turbo» не доказывает, принимает ли конкретный размещённый сервис нужный контент.
Законченная сцена с диалогом
Для короткого приветствия используйте рецепт автора под задачу, короткую фразу и достаточно времени для речи. Оставляйте движение скромным. Облёт камеры, полный разворот тела и фраза к зрителю предъявляют конкурирующие требования к ориентации лица и времени.
Если продукт — произнесённая фраза, разборчивость обязательна. Ролик с правильным выражением и неверными словами — не более дешёвое приветствие. Если речь остаётся ненадёжной при текущем процессе, попытка base или отдельная голосовая дорожка — более целенаправленный шаг, чем пять синонимов «ясного голоса».
Отдельное аудио особенно практично для закадрового рассказа или беззвучного монтажа портретов. Это сложнее, когда видимый рот персонажа должен совпасть с точной фразой. Такое различие должно влиять на кадр до рендера.
Два персонажа или несколько ролей референсов
Постоянной паре в знакомой комнате нужны не только два привлекательных лица. Сцена может требовать сохранения того, кто носит какой наряд, где стоит, кто первым двигается и кто говорит. Если роли задают референсы, выбирайте Ref2VA и явно называйте задачи входов.
Недавнее обсуждение сообщества о настройках H3 без Turbo включает сообщение автора: Turbo справлялся с простыми запросами, но опускал инструкции или придумывал события в сложных референсных сценах. Это не измеряет универсальную частоту ошибок. Это полезное предупреждение именно для ситуации, когда отсутствие отношения или действия делает ролик непригодным.
Если сложное действие обязательно, а быстрый маршрут постоянно его опускает, разумная следующая ветка — референсный процесс без Turbo. Если нужен лишь короткий тизер, упростите кадр: один персонаж реагирует, второй остаётся на месте, либо разделите последовательность на два коротких кадра. Это редакционное решение о передаче сцены, а не заявление, что дополнительные шаги гарантируют правильное взаимодействие.
Поисковая последовательность, которую вы готовы отбросить
Turbo также уместен, когда цель ролика — ответить на приблизительный творческий вопрос: персонаж поворачивается к окну или зрителю; камера остаётся близко или отъезжает; настроение читается лучше до или после того, как персонаж сел?
Временный результат может быть полезен несмотря на дефекты текстуры, исключающие его как готовое видео. Сохраните удачный творческий выбор, затем создайте финальный кадр маршрутом и разрешением для передачи. Не предполагайте точного воспроизведения дубля Turbo при перерендере base. Если важен конкретный кадр, сохраните его входным изображением для следующего кадра вместо трактовки seed как переносимой раскадровки.
Используйте настройки выбранного checkpoint
Инструкция ComfyUI автора требует ComfyUI 0.31.0 или новее, использует основные узлы H3 и по умолчанию семплирование Euler. Она прямо просит настраивать адаптер, число шагов и оба shift вместе. Размеры изображения должны быть кратны 32.
Это начальный рецепт. Он также полезнее как база поиска ошибок, чем предположение, что старый общий workflow по-прежнему соответствует новому файлу модели.
Для кадра FL2VA 768p выберите адаптер 768p и соответствующие настройки таблицы. Увеличение холста старого процесса 544p само по себе не превращает его в версию, обученную на 768p. Для сцены с референсами используйте референсный адаптер и процесс. Руководство Diffusers предупреждает не ставить адаптер FL2VA на референсный transformer, если он специально для этого не обучен; пример Ref2VA без Turbo использует 50 вычислений.
Пятьдесят — базовая настройка автора, а не вывод, что каждой сцене нужно ровно пятьдесят. Восемь также не универсальная настройка исправления любого файла со словами «4-step» в имени. До собственных схем используйте рекомендованное число для выбранного выпуска.
При переходе между уроками важна техническая деталь: NFE означает вычисления модели, а интерфейсы не всегда одинаково считают «шаги». Скрипт inference ModelTC определяет аргумент шагов как вычисления и добавляет терминальную точку схемы, нужную Diffusers. Поэтому то же число в другой обёртке может описывать другую схему. Используйте документированный смысл её настроек вместо исправления работающего графа автора из-за лишней точки на другом экране.
Не считайте силу ускоряющей LoRA ползунком интенсивности взрослого контента. Она управляет влиянием адаптера на модель. Её снижение меняет рецепт ускорения; увеличение не доказывает более свободного поведения контента. Если используете также LoRA персонажа или стиля, отделяйте их от настройки Turbo и в понимании, и в процессе.
Разрешение меняет выбранный компромисс
Крупный портрет и композиция в полный рост могут иметь одинаковые размеры результата и очень разные требования к деталям лица. В портрете лицо занимает значительную часть кадра. В полном росте оно может быть столь маленьким, что небольшое движение убирает полезные различия вокруг глаз или рта.
Для постоянного взрослого персонажа размер кадра поэтому и творческий выбор, и стоимость рендера. Если узнаваемость важнее комнаты, приблизьте начальную композицию. Дополнительные пиксели пустой стены плохо заменяют достаточное пространство лица.
Выпуски Turbo 544p и 768p делают выбор явнее. Используйте разрешение под checkpoint, не предполагая одинакового поведения одного адаптера на любом холсте. Создателям портретов стоит заметить, что указанный обучающий холст 768p горизонтальный. В процессе можно выбрать другие поддерживаемые формы, но опубликованная спецификация обучения не доказывает одинакового качества при любом соотношении сторон.
Изменение размеров референса — отдельная настройка. Для дистиллированного референсного inference ModelTC рекомендует политику match, соответствующую обучению. Она сохраняет форму, следует целевому бюджету пикселей и не увеличивает меньший вход. Это отличается от принудительной короткой стороны 2048 пикселей для каждого референса. Большие размеры референса сами по себе не дают основания ждать лучшего сходства или быстрой генерации.
Для автора полезная подготовка проста: дайте чёткий референс с видимыми важными деталями до изменения размера. Не используйте лицо в крошечном углу большого коллажа. Если кисти неясны, украшения сложны или рисунок платья размыт сжатием, исправьте статичный кадр до попытки оживить его любым маршрутом.
Мелкие детали также должны сохраняться во времени. Узор, похожий на кружево, красивый в одном кадре, но меняющий форму через несколько кадров, отвлекает в движении. Увеличение размеров результата способно сделать нестабильность заметнее. Апскейлер увеличивает файл, но не устанавливает, какой из меняющихся узоров был задуман.
Если движение и внешность уже полезны, увеличение может подходить для передачи. Если внешность меняется или ткань превращается во что-то другое, сначала повторите генерацию или упростите кадр. Это избавит от платы за повышение резкости ошибки.
Жалобам на звук нужен конкретный диагноз
Самая веская причина осторожности с аудио Turbo — диапазон описанных симптомов, а не утверждение, что все быстрые ролики H3 звучат плохо.
В обсуждении звуковых эффектов LightX2V автор сообщал об отсутствующих или слабых эффектах; другой описывал небольшое искажение или эхо, хваля картинку. В ранней теме разработчика о конвертации ComfyUI описано различие звука между реализациями, за которым последовал ответ сообщества с указанием исправления аудио. Это наблюдения, зависящие от конфигурации и версии, а не текущий benchmark каждого выпуска.
Различие важно: способы исправления разные.
Нет тихого эффекта комнаты. Если ролик в остальном правильный, добавьте эффект при монтаже. Короткий шелест ткани или атмосфера комнаты обычно не оправдывают повторную генерацию всего выступления персонажа. Если звук должен совпадать с видимым действием, расположите его в точке действия при монтаже.
Персонаж говорит в сцене, которая должна быть без речи. Явно задайте нужный звук и уберите формулировки, предполагающие разговор. Если рот остаётся неподвижным, замена аудио может завершить кадр. Если рот заметно произносит придуманную речь, отключение дорожки оставляет визуальную проблему; сократите пригодный участок или повторите генерацию, убрав диалог из сцены.
Нужные слова неверны. Оставьте одного говорящего, одно короткое предложение и достаточно времени вокруг него. Используйте синтаксис диалога, документированный для выбранного процесса. Если фраза всё равно неверна, смените маршрут или создайте голос отдельно; нагромождение речи, музыки и эффектов в промпте увеличивает число возможных ошибок.
Вся дорожка искажена или нестабильна. Вернитесь к текущему процессу автора и согласованной схеме видео/аудио до решения, что помогут дополнительные шаги. Ошибка реализации и ошибка творческого запроса не должны вести к одному циклу повторных рендеров.
Для взрослых художественных историй тихий звук может существенно задавать настроение сцены. Вы всё равно можете решить, что созданная картинка ценна, и закончить дорожку отдельно. Сделайте это намеренным производственным выбором, чтобы время редактирования аудио входило в стоимость ролика.
Пригодный пятисекундный кадр персонажа
Вот плановый пример для постоянного вымышленного персонажа автора взрослого контента. Это промпт для адаптации, а не отчёт о сгенерированном результате.
Исходный кадр показывает вымышленную женщину тридцати с небольшим лет в тёмно-красном вечернем платье у окна гостиничного номера. Лицо чёткое, одна рука лежит на подоконнике, другая видна у талии. Тёплый свет исходит от лампы в комнате. Нет зеркал, подписей или дополнительных людей.
Запрошенное действие намеренно небольшое: она поворачивает голову к зрителю, удерживает взгляд и слегка улыбается. Для тизера персонажа этого достаточно. Это сохраняет контекст взрослой аудитории, не требуя нескольких несвязанных событий от пятисекундного ролика.
Для локального процесса, принимающего структурированный формат промпта, используйте:
integratedmultimodaldescription: Используй Picture 1 как начальную композицию. [Shot 1] Вымышленная женщина тридцати с небольшим лет остаётся рядом с окном в том же тёмно-красном вечернем платье. Она медленно поворачивает голову к камере, удерживает взгляд и слегка улыбается. Обе руки остаются в начальных положениях. Камера неподвижна. Сохраняй лицо, причёску, платье, окно и тёплый свет лампы на протяжении этого единого кадра.
overall_soundscape: Тихий комнатный фон со слабым коротким шелестом ткани. Без диалога.
nondiegeticmusic: N/A.
Структура следует разделению визуального описания, атмосферы и музыки в руководстве MiniMax по промптам. Сцена и формулировки здесь оригинальные. В размещённом Playground поместите те же визуальные и звуковые инструкции в поле промпта, а начальное изображение загрузите во вход картинки; метки — текст промпта, а не дополнительные поля API.
Почему эти указания полезны
Начальное изображение определяет внешность. «Поворачивает голову» задаёт меньшее изменение, чем «поворачивается к камере», которое может быть понято как разворот всего тела. Сохранение обеих рук на месте исключает ненужное действие. Неподвижная камера не меняет масштаб лица во время движения персонажа. «Единый кадр» ясно говорит, что перехода на другой ракурс не требуется.
Это не гарантирует соблюдения. Но нежелательное движение проще определить и исправить, потому что задание однозначно.
Если нужна чуть большая энергия, измените одно творческое требование: замените поворот головы небольшим наклоном к камере, оставив остальное. Это новая идея кадра, а не тест качества. Если должна двигаться камера, оставьте персонажа почти неподвижным и попросите короткий медленный наезд. Немедленное сочетание обоих действий усложняет сохранение уже выбранной крупной портретной композиции.
Добавляйте произнесённое приветствие, только если оно нужно
Для варианта приветствия уберите «Без диалога» и добавьте одну короткую фразу после улыбки. В локальном процессе с тегами диалога MiniMax строка может выглядеть так: She says <d>[English] I saved this moment for you.</d> Оставьте естественное произнесение и время на выражение лица до и после.
Не добавляйте второго говорящего или фоновое пение в тот же короткий запрос. Цель варианта — передать предложение голосом персонажа, поэтому всё конкурирующее должно оправдывать своё присутствие.
Используйте референсы, когда нужна новая композиция
Допустим, в следующем эпизоде та же женщина должна сидеть на диване в том же номере. Оригинальный портрет у окна теперь референс внешности, а не обязательно кадр начала видео. Это меняет задачу.
Используйте одно чёткое изображение персонажа, при необходимости одно изображение одежды и одно, задающее комнату. Объясните референсному процессу, что первое определяет женщину, второе — наряд, третье — комнату. Затем опишите кадр сидя. Не просите все три изображения одновременно определять первый кадр.
Если нужна точная сидячая композиция, сначала создайте и утвердите статичный кадр, затем оживите его image-to-video. Сложный выбор композиции перенесён в стадию изображения, где его легче заметить и исправить. Это может быть полезнее смены видеосемплера.
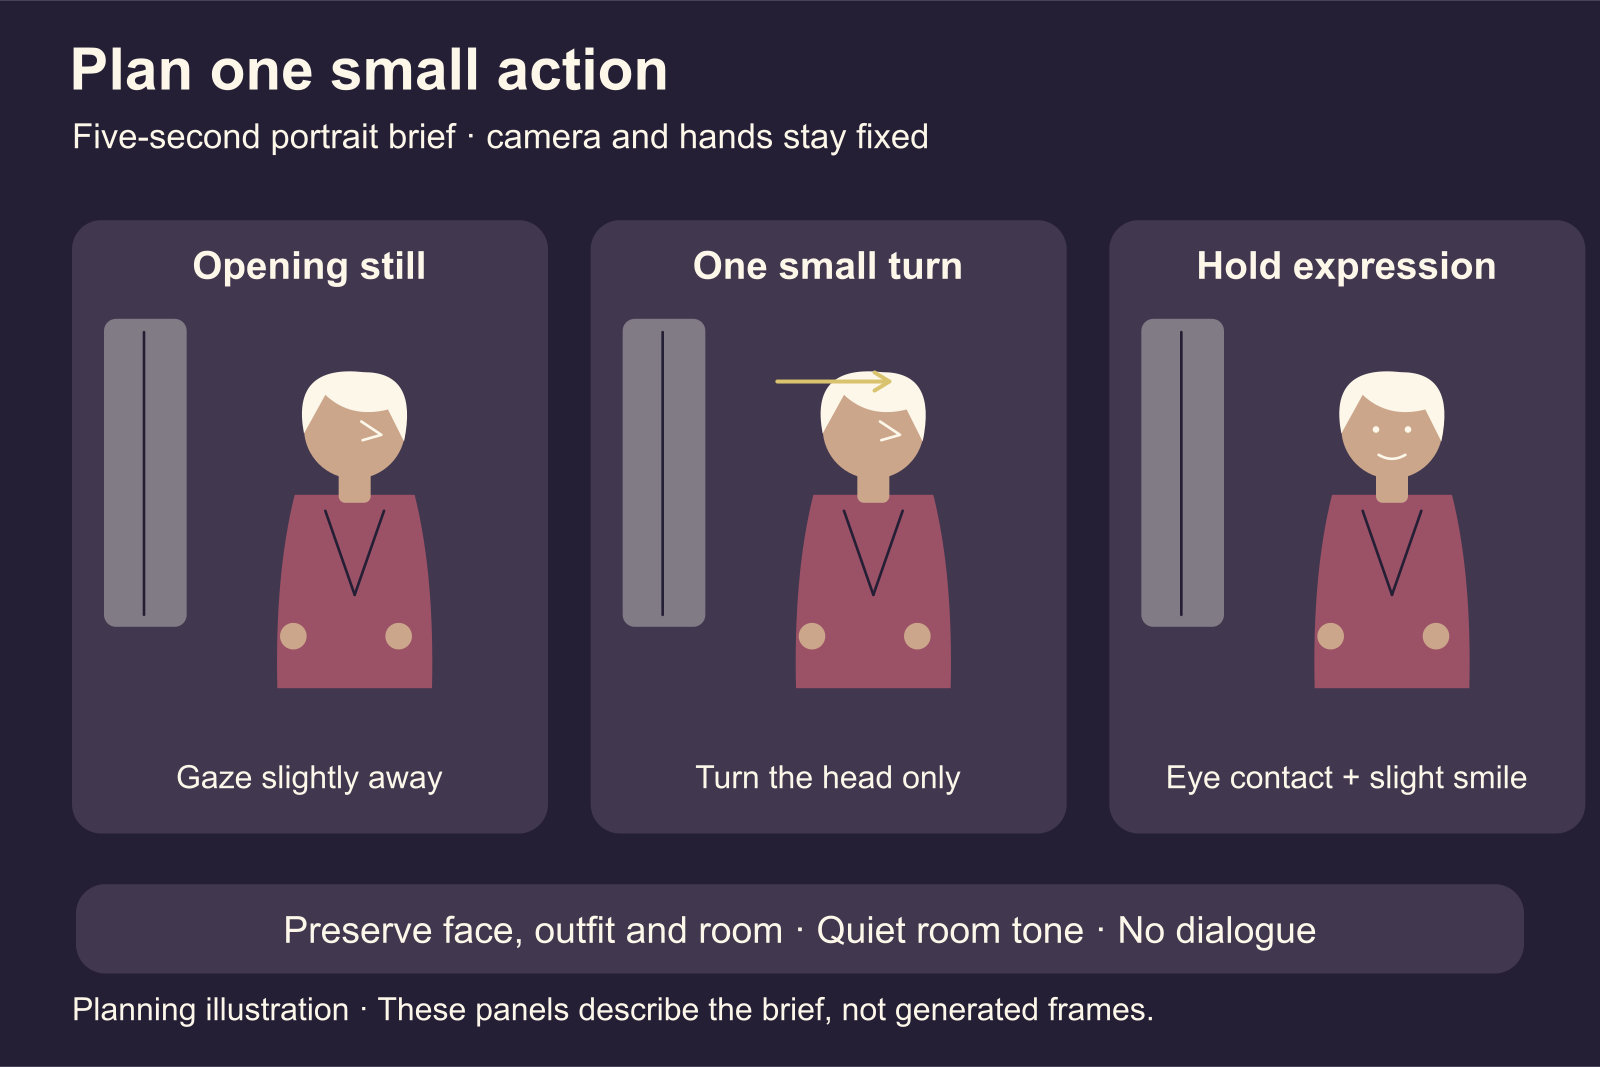
Иллюстрация планирования: сохраняйте неподвижность камеры и рук, запрашивая один небольшой поворот головы.
Если результат не удался, меняйте именно неудавшуюся часть
Разочаровывающий быстрый ролик — симптом. Он не устанавливает автоматически Turbo как причину.
| Что видно или слышно | Полезное следующее изменение | Почему это важнее очередной случайной попытки |
|---|---|---|
| Лицо неясно даже на первом изображении | Улучшите или обрежьте исходник до анимации | Видео нужен узнаваемый источник |
| Лицо меняется главным образом при большом повороте | Уменьшите поворот или дайте нужный вид через референсную задачу | Сложный интервал — вновь открывающийся ракурс |
| Модель добавляет ходьбу, жест или второе действие | Замените общие слова одним видимым действием и явно неподвижными элементами | Нужное движение может быть неоднозначным |
| Несколько обязательных инструкций референса постоянно пропадают | Используйте Ref2VA без Turbo или разделите сцену на простые кадры | Повтор того же быстрого маршрута не меняет сложное требование |
| Руки или волосы размываются при движении | Используйте рецепт под задачу, затем уберите ненужное движение | Влиять могут и конфигурация, и сложность движения |
| Картинка удачна, короткий эффект звука — нет | Добавьте эффект при монтаже | Сохраните полезную визуальную игру |
| Фраза искажена, рот движется неверно | Сократите фразу или смените маршрут генерации | Одна замена дорожки не исправит видимую речь |
| После добавления Turbo вся картинка хуже | Восстановите соответствующие адаптер, схему, задачу и разрешение | Несовпадающий рецепт не даёт содержательного сравнения base и Turbo |
Обсуждение референсной LoRA на Hugging Face содержит сообщения о размытых кистях и потере деталей движущихся волос вместе с предложениями сменить адаптеры и семплеры. Считайте это подсказками к проблемам людей. Некоторые советы смешивают адаптеры задач вопреки текущим рекомендациям автора о совместимости; это не надёжное универсальное исправление.
Есть практическая точка остановки. Если исходный кадр чёткий, рецепт соответствует и то же обязательное действие продолжает пропадать, перейдите на base или перепишите кадр. Полезный вопрос уже не в поиске случайно удачного быстрого результата, а в том, обходится ли этот поиск дешевле, чем смена подхода.
Быстрый рендер и дешёвый готовый ролик — разные числа
Четыре против восьми вычислений говорят о повторяющейся работе модели. Они не означают, что вся задача занимает ровно вдвое меньше времени. Загрузка, обработка входа, декодирование, перенос весов и сохранение тоже требуют времени. Первый холодный запуск и последующий с уже доступными компонентами могут ощущаться совсем по-разному.
Для локальной работы есть два счётчика времени. GPU может работать, пока вы занимаетесь другим, но поиск ошибок графа или постоянный просмотр неудачных дублей требуют внимания. Уменьшение рендера без участия человека с добавлением ручных исправлений может быть плохим обменом для автора нескольких роликов.
Для платного сервиса используйте фактически показанную ставку. В следующей таблице нет цены Turbo. Это публичные цены стандартной задачи H3 image-to-video SpicyAPI с начальным изображением. Публичные входы не предоставляют локальные шаги семплирования или адаптер Turbo ModelTC.
| Разрешение стандартного размещённого H3 | За секунду результата | Один ролик 5 секунд | Десять генераций по 5 секунд |
|---|---|---|---|
| 768p | $0.037 | $0.185 | $1.85 |
| 2k | $0.058 | $0.290 | $2.90 |
Расчёт — ставка × запрошенные секунды результата × число генераций. Reference-to-video имеет собственную плату за референсы, поэтому не переносите таблицу image-to-video без изменений на запрос с несколькими источниками.
Числа дают реальную альтернативу поддержке локального процесса. Они не показывают, сколько попыток понадобится, и не устанавливают сравнение скорости с вашей GPU.
Показатель с учётом отброшенных дублей
Допустим, вы создаёте десять пятисекундных роликов 768p по $0.185. Расход на завершённые генерации — $1.85. Если пять пригодны проекту, стоимость генерации пригодного ролика — $1.85 ÷ 5 = $0.37. Если два — $1.85 ÷ 2 = $0.925. Это иллюстративные количества принятых кадров с реальными ставками сервиса, а не наблюдаемые доли успеха H3.
Успешная генерация, отброшенная из-за неправильных выражения, движения или голоса, всё равно входит в расчёт. Она отличается от задачи, не создавшей результат. Время монтажа, внешняя голосовая дорожка и увеличение добавят к цене законченного ролика.
То же рассуждение применимо к локальному Turbo. Пусть одна быстрая попытка занимает половину времени base. Если для приемлемого результата быстрому маршруту нужно вдвое больше попыток, преимущество рендера исчезает ещё до просмотра и исправления. Это пример точки равенства, а не заявление о таких временах или долях пригодности H3.
В общем случае Turbo экономит время рендера пригодного ролика, когда его время попытки, разделённое на долю пригодных результатов, ниже соответствующего показателя base. Немного меньшая пригодность может оправдываться большим выигрышем скорости; сильное падение пригодности способно его убрать. Для понимания этого обмена универсальный benchmark не нужен.
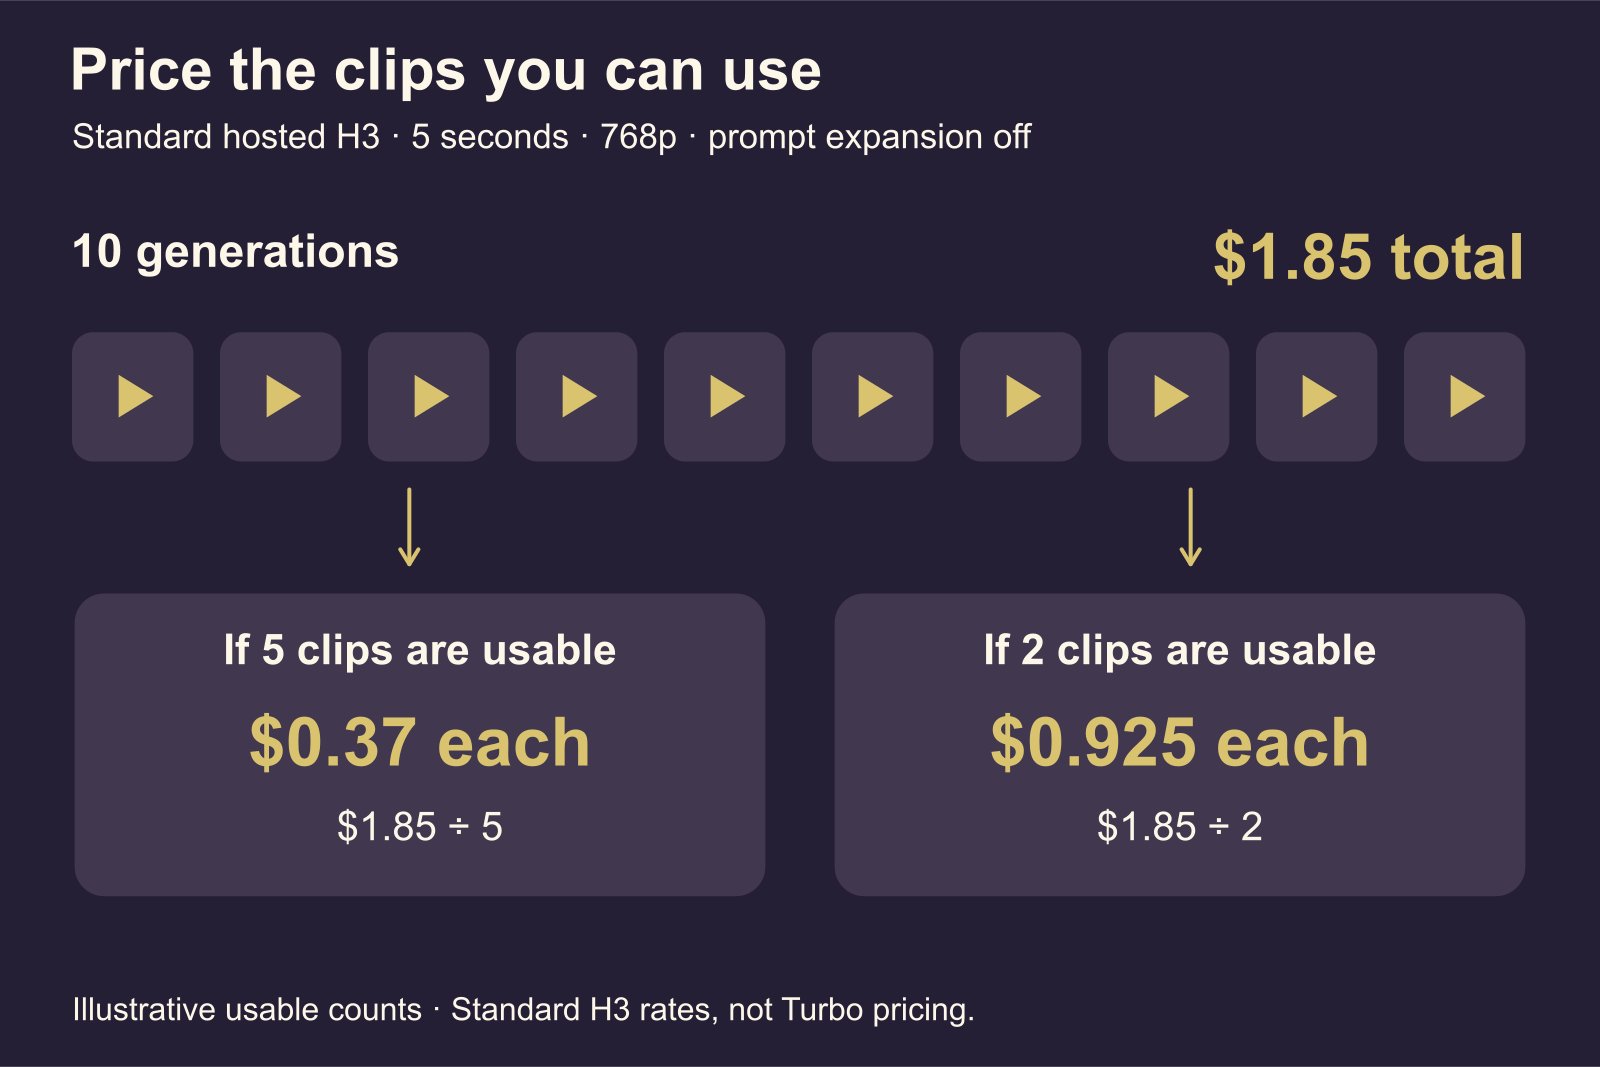
Иллюстративное число пригодных результатов со ставкой стандартного размещённого H3; это не измеренная доля успеха и не цена Turbo.
Деньги на превью тоже можно потратить впустую
Четыре пятисекундные попытки 768p плюс одна пятисекундная 2k в стандартной размещённой задаче изображения стоят 4 × $0.185 + $0.29 = $1.03. Это может помочь недорого выбрать действие и композицию кадра.
Но финальная попытка — новая генерация, а не гарантированная копия выбранной пробы высокого разрешения. Если все четыре превью оценивали тонкие детали лица, низкое разрешение могло не ответить на нужный вопрос. Начните с итогового разрешения передачи, когда решение касается именно мелких черт, ткани или лица персонажа в полный рост.
В локальной работе применяйте тот же принцип к превью Turbo. Выбирайте по ним то, что превью показывает: темп, грубое кадрирование и соответствие действия персонажу. Не считайте доказанным, что другой базовый рендер или холст сохранит каждое выражение.
Что выбрать NSFW-автору дальше
Для простого беззвучного или слегка атмосферного тизера персонажа начните с подходящего процесса Turbo и сильного первого изображения. По таблице checkpoint выберите поддерживаемый рецепт задачи и холста. Сохраняйте результат Turbo, отвечающий заданию: метка не делает законченный кадр лишь черновиком.
Для референсной сцены с несколькими обязательными отношениями используйте специальный референсный маршрут. Держите base доступным, если быстрая версия постоянно теряет эти отношения. Для диалога заранее решите, обязательна ли сгенерированная речь или звук можно закончить отдельно.
Возможности контента остаются конкретными для маршрута. Страница стандартного H3 image-to-video SpicyAPI сообщает результаты проверок взрослого контента этой задачи; они не устанавливают поведение локальной установки Turbo или другого сервиса. Ускорение — не заявление о поддержке NSFW. Различия размещённых семейств H3 объясняет сравнение H3, Spicy, LoRA и Singularity.
Полезное следующее действие — выбрать один действительно нужный кадр, отнести его к ключевым кадрам или референсам и использовать соответствующий выпущенный рецепт. Если нужен размещённый процесс с начальным кадром, перенесите пятисекундное задание выше на стандартную страницу H3 image-to-video, загрузите утверждённое изображение и посмотрите расчёт цены. Оценивайте покупку по пригодной законченной сцене: правильный персонаж, нужное движение и звук, работающий на ролик.