継続して登場する成人キャラクターの静止画、短い場面の案、作る動画の順番があります。4ステップのMiniMax H3なら当然の選択に見えます。ところが振り向きで顔がぼやけ、要求していない動作が増え、映像は良くても声が合いません。ここでいうTurboはH3のコミュニティ製高速化LoRAであり、別の商用製品H3 Max Turboではありません。
単純で範囲の決まった撮影や、素早い案探しにはTurboを選びます。新しい768pのテキスト・キーフレーム環境なら、作者が現在Studioで使うFL2VA 8-step v1.0 768pが、文書化された出発点です。必要な動作が繰り返し消える撮影には、Turboなしのベースの処理も残します。Studioでの採用と、作者の映像・音声の改善という説明だけでは、8ステップで一般に会話や布の細部が良くなるとは証明できません。
失う品質は、文書化された何パーセントという数字ではありません。非常に短いsampling scheduleに合わせたモデルを、そのタスクと解像度の前提とともに選びます。代償となり得るのは、その場面で必要な細部の実行が安定しにくくなることです。ベースも完璧な動画の約束ではありません。
同じ入力の成人向け場面をTurboとベースで実行していないため、拒否、内容の控えめ化、人物の細部の保持には順位を付けられません。公開版、作者の案内、コミュニティの失敗報告を説明し、実践的な選び方へつなげます。
| 作りたいもの | 出発点 | 理由 |
|---|---|---|
| 承認済み開始画像から短い人物ティーザー | タスクに合うFL2VA Turbo | 外見と構図に視覚的な出発点がある |
| 新しいローカル768pのテキスト・キーフレーム処理 | FL2VA 8-step v1.0 768p | 作者の現在のStudio構成に、文書化された開始設定がある |
| 人物、服、部屋を別参照から組み合わせる場面 | 専用checkpointのRef2VA | 参照条件付けは別タスクで、FL2VAの設定を交換できない |
| 必要な動作が何度も省かれる参照場面 | TurboなしのRef2VAと、簡単にした動作順序 | 同じ高速な近似へ追加試行を費やし続けない |
| ローカル環境を保守せず、ときどき動画を作る | 実際に必要なタスクのホスト型H3 | samplerの管理より、表示料金で完成した生成を購入する |
まず、どの「H3 Turbo」かを特定する
比較対象は、公開H3ベースモデル向けのModelTC / LightX2V Turbo LoRAです。「ベース」は高速化LoRAなしのH3を指します。H3 Max Turboという商用製品、別作者の高速化アダプター、ホスト型H3エンドポイントは別の選択肢です。名前に「H3」「Turbo」があっても、品質、設定、料金を同じものとして扱えません。
Turbo LoRAと人物LoRAも目的が違います。一方は少ないモデル評価で結果に至る方法を変え、他方は人物、スタイル、概念へモデルを適応させます。高速化アダプターを加えても、繰り返し使う架空の人物を覚えるわけではありません。人物LoRAを読み込んでも、4ステップの生成設定が確立するわけではありません。
作者のcheckpoint表では、次の公開版を分けています。
| Turbo checkpoint | タスク | 学習サイズ | 推奨評価回数 | video / audio shift |
|---|---|---|---|---|
| FL2VA 4-step v0.1 | テキストまたはキーフレーム | 544p、複数の形 | 4 | 12 / 3 |
| FL2VA 8-step v1.0 | テキストまたはキーフレーム | 544p、複数の形 | 8または4 | 12 / 3 |
| FL2VA 4-step v1.0 768p | テキストまたはキーフレーム | 1344 × 768 | 4 | 6 / 3 |
| FL2VA 8-step v1.0 768p | テキストまたはキーフレーム | 1344 × 768 | 8 | 6 / 3 |
| Ref2VA 4-step v0.1 | 参照 | 544p、複数の形 | 4 | 12 / 3 |
FL2VAはテキストだけの生成と、開始・終了フレームによる条件付けです。Ref2VAは参照条件付きの分岐です。「VA」は動画と音声を示します。
実践上の違いは明確です。4ステップの参照処理は、すべての8ステップの画像処理の4ステップ版ではありません。開始ポートレートを動かす要求と、3参照から場面を作る要求では、H3に必要な仕事が違います。先にタスクを選び、次に互換性のある高速化checkpointを選びます。
LightX2Vのモデルカードは、Studioの現在のモデルをFL2VA 8-step v1.0 768pとし、映像と音声の改善を説明しています。これは作者の公開時の主張です。新しいテキスト・キーフレーム処理の合理的な出発点になりますが、すべての成人向け場面や古いコミュニティの微調整で、その設定が勝つ証明ではありません。
少ないステップで変わること、変わらないこと
拡散モデルのsampling stepは、作りかけの結果を要求する画像、動作、音に近付ける評価です。step distillationは、その過程を短い経路で進むアダプターを学習します。通常のベースの「50」を「4」に変え、同じ結果を期待することとは異なります。
H3は映像と音を一緒に生成します。Diffusersの実装文書では、1つのdenoising loop内に別々の映像・音声scheduleを持つと説明しています。キーフレームtransformerと参照transformerも分けています。一見小さな設定の不一致で、動きと音の両方が変わる理由になります。
制作者に役立つ帰結は2つです。
第一に、step数は設定の一部分です。無関係な処理から人気の設定を集めるより、一緒に設計されたアダプター、schedule、タスクの方が強い出発点です。印象的なスクリーンショットでは、作者がベース重み、量子化、入力サイズ、音声経路も変えたか分かりません。
第二に、高速samplingでも入力の重要性は減りません。開始画像で手が切れていれば情報は欠けたままです。横顔が正面と矛盾すれば、参照は矛盾したままです。5秒に登場、振り向き、衣装調整、一言の発話、カメラの周回を入れれば、小さな時間に複数の出来事を求めていることは変わりません。
交換条件は、その撮影でどの誤りまで許せるかと考えると役立ちます。無音の雰囲気ループで、音を置き換える予定なら、不完全な生成音は問題にならないかもしれません。継続する人物の個人的な挨拶なら、言葉の誤りで、魅力的な映像も使えなくなります。
8ステップの結果が完成版になることも、ベースが失敗することもあります。ラベルで先に決めるべきではありません。経路を選ぶ目的は、その撮影に必要のない能力や妥協に費用を払わないことです。
成人キャラクター制作でTurboが役立つ場面
目に見える動作が1つのポートレートティーザー
柔らかな照明のアパートで、イブニングドレスを着る架空の30代女性を考えます。開始ポートレートは承認済みで、顔、髪、服、部屋は正しくなっています。動画では、少しカメラに向き、笑みを落ち着かせるだけが必要です。
主な変更が1つなので、Turboに合理的なタスクです。見る人は人物と表情を認識できればよく、別の人を登場させたり、見えない部屋を再構成したり、会話を同期したりする必要はありません。画像から動画では、その動作に明示的な開始構図があります。
外見の細部は開始画像に任せ、動作、カメラ、音をプロンプトに入れます。長い身体の説明を繰り返すと、画像との差が入ることがあります。髪型の新しい形容詞や少し違うドレスの色が、モデルの調整すべき追加指示になります。
非公開の成人向けシリーズで、元画像がより成熟した内容でも同じ方法が使えます。高速化の判断は、必要な動作と連続性の量に関係します。「Turbo」だけでは、特定のホスト型サービスがその内容を受け入れる証拠になりません。
会話のある完成場面
短い挨拶には、タスクに合う作者の設定、短いセリフ、話すための十分な時間を使います。動作は控えめにします。カメラの周回、全身の回転、見る人へのセリフでは、顔の向きとタイミングに競合する要求が生まれます。
セリフが製品の目的なら、聞き取れることは必須です。表情が正しく言葉が違う動画は、安い挨拶ではありません。現在の処理でも発話が安定しないなら、「明瞭な声」の同義語を5つ増やすより、ベースの試行か別制作の音声が目的に合う次の一手です。
別音声は、画面外のナレーションや無音のポートレート映像集で特に実用的です。人物の口を正確なセリフに合わせる場合は簡単ではありません。生成前に、その違いを撮影へ反映します。
2人の人物、または複数の参照の役割
同じ部屋の継続するカップルには、魅力的な顔を 2 つ用意するだけでは足りません。誰がどの服を着るか、立ち位置、動く順番、話す人を保つ必要があります。参照で役割を与えるなら、Ref2VAを選び、各入力の仕事を明示します。
最近のTurboなしのH3設定のコミュニティ議論には、Turboは単純な要求に対応したが、複雑な参照場面で指示を省き、出来事を作ったという1人の報告があります。普遍的な失敗率の測定ではありません。必要な関係や動作が欠ければ使えないという状況への、有用な注意点です。
複雑な動作が必須で、高速経路が繰り返し省くなら、Turboなしの参照処理が合理的な次の分岐です。短いティーザーだけなら、1人が反応し他方はその場に残る、または2つの短い撮影へ分けるなど、簡略化します。物語を伝える編集上の判断であり、stepを増やせば正しい相互作用になるという主張ではありません。
捨てる前提で探る場面
人物を窓へ向けるか見る人へ向けるか、カメラを近く保つか引くか、座る前後のどちらで雰囲気が伝わるか。こうした大まかな問いに答える動画にも、Turboは適しています。
完成版には使えない質感の欠陥があっても、仮の出力は役立ちます。成功した制作上の選択を残し、配信に合う経路と解像度で最終撮影を生成します。ベースでの再生成がTurboと同じ撮影を再現するとは考えないでください。特定のフレームが大切なら、seedを移植可能な絵コンテとみなすより、次の撮影の画像入力に残します。
checkpointに合う設定を使う
作者のComfyUI手順はComfyUI 0.31.0以降を要求し、core H3ノードと既定のEuler samplingを使います。アダプター、step数、両方のshiftを一緒に設定するよう明記されています。画像寸法は32の倍数です。
これが開始設定です。古い共有ワークフローが最新モデルファイルに合うと考えるより、トラブルシューティングの基準として役立ちます。
768pのFL2VAなら、表から768p用アダプターと対応設定を選びます。古い544pのキャンバスだけを広げても、768pで学習した版にはなりません。参照場面には参照アダプターと処理を使います。Diffusers設定ガイドは、専用に学習されていないFL2VAアダプターを参照transformerへ入れないよう注意しています。TurboなしRef2VAの例は50評価です。
50は作者の基準であり、すべての場面に必ず50必要という知見ではありません。8も「4-step」と名の付くあらゆるファイルを修復する万能設定ではありません。独自scheduleを探る前に、選んだ版の推奨回数を使います。
異なるチュートリアルを使うとき、技術的に大切なのは、NFEはモデル評価回数であり、UIが「steps」を同じ方法で数えるとは限らないことです。ModelTCの推論スクリプトはstep引数を評価回数として定義し、Diffusersに必要な終端のschedule点を加えます。同じ数を別のwrapperへ入れると、別のscheduleになる場合があります。別の画面で点が1つ多いという理由で、動いている作者のグラフを直さず、そのwrapperの文書上の意味を使います。
高速化LoRAの強さを、成人向け内容の強度スライダーとして扱わないでください。アダプターがモデルに与える影響を調整します。下げれば高速化設定が変わり、上げても許容範囲が広い挙動になる証拠にはなりません。人物やスタイルのLoRAも使うなら、考え方でも処理でもTurbo設定と分けます。
解像度で交換条件が変わる
近いポートレートと全身構図は、同じ出力寸法でも顔の細部への要求が違います。ポートレートでは顔が画面の大部分を占めます。全身では、少し動くだけで目や口の有用な違いが消えるほど小さい場合があります。
継続する成人キャラクターでは、画面サイズは描画費用と同時に制作上の選択です。部屋を見せることより本人の認識が大切なら、開始構図を近くします。空の壁へ画素を使っても、顔に十分な空間を与える代わりにはなりません。
544pと768pのTurbo版では、その選択が明確になります。どんなキャンバスでも同じ挙動と考えず、checkpointに合う解像度を使います。ポートレート制作者は、記載された768pの学習キャンバスが横長であることにも注意します。対応する別の形は選べますが、学習仕様で、どの比率も同じ品質と証明されるわけではありません。
参照画像のリサイズも別の調整です。ModelTCは、学習時の方針に合うため、蒸留した参照推論にmatchを推奨しています。形を保ち、目標の画素予算に従い、小さな入力を拡大しません。すべての参照の短辺を2048ピクセルにすることとは違います。参照の寸法が大きいだけで、本人の保持や速度が良くなるとは期待できません。
制作者の準備は簡単です。リサイズ前に重要な細部が見える明瞭な参照を用意します。大きなコラージュの隅に小さな顔を置かないでください。手が曖昧、宝飾が複雑、ドレスの柄が圧縮でにじんでいるなら、どちらの経路で動かす前にも静止画を直します。
細部には時間方向の要件もあります。1フレームで魅力的なレース状の柄も、数フレームごとに変形すれば、動画では気になります。出力を大きくすると、その不安定さが見やすくなる場合があります。アップスケーラーはファイルを大きくできますが、変化するどの柄が意図したものかは決められません。
動作と本人が使えるなら、拡大が配信に適する場合があります。本人や布が変わるなら、先に再生成か簡略化をします。誤りを鮮明にするための費用を避けられます。
音声への不満は具体的に診断する
Turbo音声に慎重になる主な理由は、報告された症状の幅です。すべての高速H3動画の音が悪いという主張ではありません。
LightX2Vの効果音の議論では、音がないか小さいという報告、映像を評価しつつ少し歪みや反響があるという報告があります。別の保守元による初期ComfyUI変換の議論では実装間の音の違いが報告され、その後、コミュニティの返信が音声修正を案内しました。設定と版に依存する観察であり、現在のすべての版のベンチマークではありません。
対処法が違うため、区別が大切です。
静かな部屋の効果音がない。ほかが正しければ、編集で音を加えます。短い布の擦れや環境音のために、人物の演技全体を再生成する必要は通常ありません。見える動作に同期する必要があれば、編集でその位置に置きます。
無言の場面なのに人物が話す。意図する音を明示し、会話を示す表現を外します。口が動かないなら、音の置き換えで仕上がるかもしれません。勝手に作った発話の口が見えるなら、ミュートしても映像の問題は残ります。使える部分を短く切るか、場面から会話を外して再生成します。
必要な言葉が違う。話者1人、短い1文、その前後の十分な時間にします。選んだ処理の文書にある会話構文を使います。それでも違うなら経路を変えるか声を別制作します。発話、音楽、効果音を詰め込むと、間違える要素が増えます。
音全体が歪む、または不安定。step数が答えと判断する前に、作者の現在の処理と、対になった映像・音声scheduleへ戻ります。実装の問題と制作要求の問題で、同じ再生成ループへ入らないようにします。
成人向け創作では、静かな音が場面の雰囲気を大きく担うことがあります。生成映像には価値があると判断して、音を別に仕上げても構いません。意図した制作上の選択にし、音声編集に使う時間も動画の費用へ含めます。
使える5秒の人物撮影を計画する
継続する架空の成人キャラクターの計画例です。変更して使えるプロンプトであり、生成結果の報告ではありません。
元の静止画は、ホテルのスイートの窓の横で、濃い赤のイブニングドレスを着る架空の30代女性です。顔は明瞭で、片手は窓の縁、もう片手は腰の近くに見えます。室内のランプから暖かな光が当たります。鏡、字幕、追加の人物はありません。
要求する動作は小さく絞ります。頭を見る人へ回し、目線を保ち、わずかに笑います。人物のティーザーには十分です。成人向けの文脈を保ちながら、5秒に無関係な出来事を何個も求めません。
構造化プロンプト形式を使うローカル処理では、次を使います。
integratedmultimodaldescription: Picture 1を開始構図に使います。[Shot 1] 架空の30代女性は、同じ濃い赤のイブニングドレスで窓の横にいます。ゆっくり頭をカメラへ向け、目線を保ち、小さく笑います。両手は開始時の位置に保ちます。カメラは固定です。この単一ショットを通して、顔、髪、ドレス、窓、ランプの暖かな光を保ちます。
overall_soundscape: 静かな室内の環境音と、かすかな短い布の動きの音。セリフなし。
nondiegeticmusic: N/A。
構造は、MiniMaxのプロンプトガイドにある映像、環境音、音楽の分離に従っています。場面と文言は独自です。ホスト型Playgroundでは、同じ映像と音の指示をプロンプト欄に入れ、開始画像を画像入力へアップロードします。このラベルはプロンプトの文章であり、追加APIフィールドではありません。
この指示が役立つ理由
開始画像が外見を決めます。「頭を回す」は、全身回転にも解釈される「カメラに向く」より小さな変更です。両手をその場に保つと、不要な動作を除けます。固定カメラなら人物の動きの間に顔の大きさが変わりません。「単一ショット」で、別の角度へのカットを求めないことを明確にします。
従う保証ではありません。指示が明確なので、望まない動作を特定して直しやすくなります。
少し動きを加えるなら、制作上の要件を1つだけ変えます。頭の回転を、カメラへのわずかな前傾に置き換え、残りは保ちます。新しい撮影案であり、品質テストではありません。カメラを動かしたいなら、人物はほぼ固定し、短くゆっくりした寄りを求めます。最初から両方を組み合わせると、選んだ近いポートレート構図を保ちにくくなります。
必要なときだけ挨拶のセリフを加える
挨拶版では「セリフなし」を外し、笑みの後に短い一言を加えます。MiniMaxの会話タグを使うローカル処理なら、She says <d>[English] I saved this moment for you.</d>のように書けます。話し方は自然にし、前後の表情に時間を残します。
同じ短い要求に2人目の話者や背景の歌を加えないでください。この版の目的は、人物の声でその文を伝えることです。競合する要素は、本当に必要か判断します。
新しい構図には参照を使う
次の回で、同じ女性を同じスイートのソファに座らせるとします。元の窓のポートレートは本人の参照であり、必ずしも動画の開始フレームではなくなります。タスクが変わります。
明瞭な人物画像1枚、必要なら服の画像1枚、部屋を定める画像1枚を使います。参照処理に、1枚目は女性、2枚目は服、3枚目は部屋と伝えてから、座り姿を説明します。3枚すべてに同時に開始フレームを決めさせないでください。
座った構図が正確に必要なら、先にその静止画を作って承認し、画像から動画で動かします。難しい構図の判断を、見て直しやすい静止画の段階へ移せます。動画samplerの変更より価値がある場合があります。
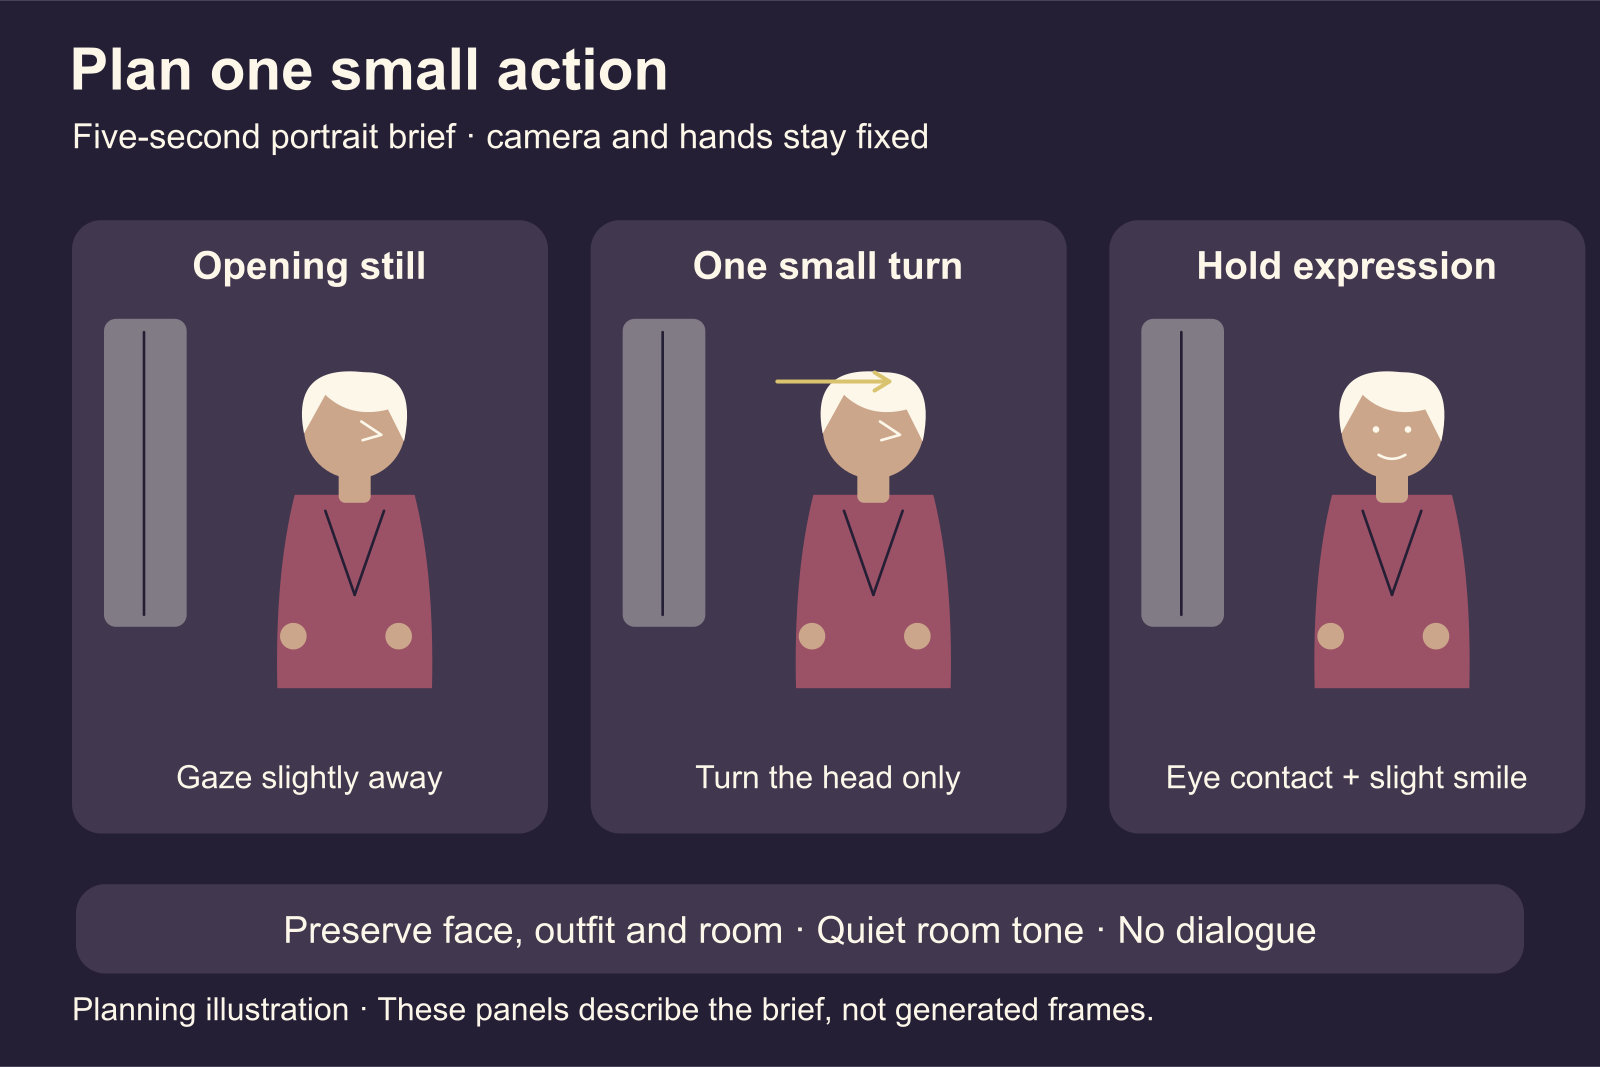
計画図:小さく頭を回す1動作を求め、カメラと手は固定します。
失敗したら、失敗した部分を変える
期待外れの高速動画は症状です。それだけでTurboが原因と分かるわけではありません。
| 見える・聞こえる問題 | 次に役立つ変更 | 無作為な再試行より先に行う理由 |
|---|---|---|
| 開始画像ですでに顔が不明瞭 | 動かす前に静止画を改善・切り抜く | 動画には人物と分かる参照が必要 |
| 大きな振り向きの間に顔が変わる | 回転を減らすか、参照タスクで適切な角度を渡す | 難しいのは新しく見える角度 |
| 歩く、手を動かすなど別の動作が増える | 広い表現を1つの見える動作と固定要素へ置き換える | 動作要求が曖昧かもしれない |
| 必須の参照指示が何個も消える | TurboなしRef2VAか、簡単な撮影へ分ける | 同じ高速経路の反復では難しい要件が変わらない |
| 動きで手や髪がぼやける | タスクに合う設定を使い、不要な動きを減らす | 設定と動作の複雑さの両方が関係する |
| 映像は良いが短い効果音が違う | 編集で効果音を加える | 使える映像の演技を残す |
| セリフが崩れ、口の動きも違う | セリフを短くするか生成経路を変える | 音声だけの置き換えでは見える発話が直らない |
| Turbo追加後に映像全体が悪化 | 対応するアダプター、schedule、タスク、解像度へ戻す | 不一致の設定ではベースとTurboを意味のある比較にできない |
Hugging Faceの参照LoRAの議論には、手のぼやけ、動く髪の細部の喪失、アダプターとsamplerを交換する提案があります。利用者が遭遇した問題の手掛かりとして扱います。タスクのアダプターを混ぜる提案もあり、作者の現在の互換性の案内と矛盾するため、信頼できる万能修復ではありません。
実践上の区切りがあります。静止画が明瞭で設定も合い、同じ必須動作が消え続けるなら、ベースへ移るか撮影を書き直します。幸運な高速結果を探せるかではなく、その探索が方法変更より安いかが重要になります。
描画の速さと、安い完成動画は別の数字
4評価と8評価は、繰り返すモデルの仕事量を示します。ジョブ全体がちょうど半分の時間になるとは言いません。読み込み、入力処理、デコード、重みの移動、保存にも時間がかかります。初回のcold jobと、部品が利用可能な後のジョブでは体感が大きく違います。
ローカル制作には2つの時間もあります。GPUが作業している間に別の仕事はできますが、グラフの修正や失敗した撮影の反復確認には自分の注意が必要です。自動の描画を減らして手作業の修復を増やす経路は、数本だけ作る制作者には不利な場合があります。
有料ホスト型では、実際の表示料金を使います。次の表にTurbo料金はありません。開始画像を使う、SpicyAPIの標準H3画像から動画の公開料金です。公開入力にはローカルsampling stepsやModelTC Turboアダプターの指定がありません。
| 標準ホスト型H3の解像度 | 出力1秒 | 5秒1本 | 5秒を10回生成 |
|---|---|---|---|
| 768p | $0.037 | $0.185 | $1.85 |
| 2k | $0.058 | $0.290 | $2.90 |
計算は単価 × 要求する出力秒数 × 生成回数です。参照から動画には独自の参照料金があるため、この表を複数参照の要求へそのまま使いません。
ローカルの処理を保守することへの、実際の代替の数字です。必要な試行回数を示すものでも、自分のGPUとの速度比較でもありません。
捨てた撮影を含む数字
768p・5秒を1本$0.185で10回生成したとします。完了した生成の費用は$1.85です。5本が使えるなら、使用可能な1本あたり$1.85 ÷ 5 = $0.37、2本なら$1.85 ÷ 2 = $0.925です。実際のホスト型料金に仮の採用数を適用した例であり、観測したH3成功率ではありません。
表情、動作、声が違って捨てた成功生成も計算に入ります。生成自体が失敗したタスクとは異なります。編集時間、外部の声、拡大も完成動画の費用に加わります。
ローカルTurboも同じです。高速な1回がベースの半分の時間と仮定します。採用までに2倍の回数が必要なら、確認や修復を数える前に、描画の利点は消えます。損益分岐の例であり、H3の時間や採用率がそうだという主張ではありません。
一般には、Turboの1回あたりの時間を使える割合で割った値が、ベースの同じ値より小さいと、使える1本あたりの描画時間を節約できます。速度差が大きければ、採用率が少し低くても価値があり、大きく下がれば利点が消えます。その関係を理解するのに、普遍的なベンチマークは必要ありません。
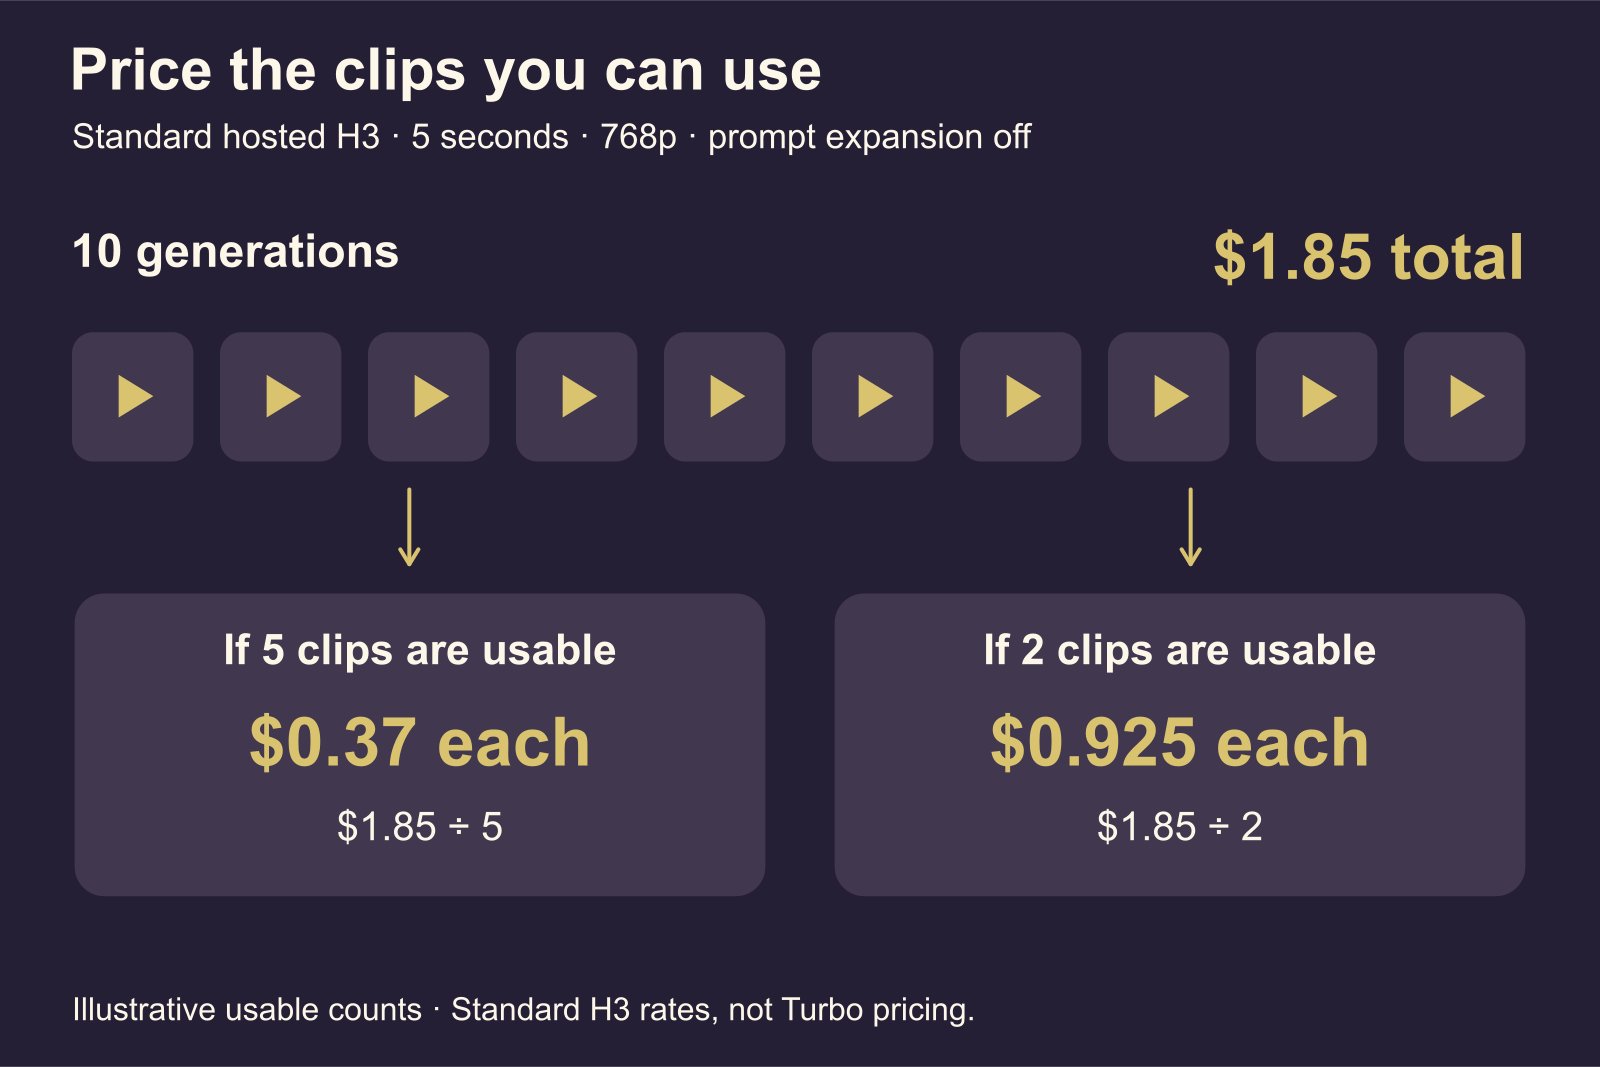
標準ホスト型H3料金に仮の採用数を当てはめた例です。測定した成功率やTurbo料金ではありません。
プレビューの費用も無駄になることがある
標準ホスト型の画像タスクで、768p・5秒を4回、2k・5秒を1回なら、4 × $0.185 + $0.29 = $1.03です。動作と構図を安く選ぶ方法として役立つ場合があります。
最終試行は新しい生成であり、選んだ案の高解像度のコピーを保証しません。4つのプレビューすべてで細かな顔を判断したいなら、低解像度は必要な問いに答えなかったかもしれません。小さな特徴、布、全身人物の顔が判断対象なら、目的の配信解像度から始めます。
ローカルTurboのプレビューでも同じです。進行の速さ、大まかな構図、動作と人物の相性など、プレビューで分かることに使います。異なるベース生成やキャンバスで、すべての表情を保てるとすでに証明したとは考えません。
NSFW制作者が次に選ぶもの
単純な無音、または軽い環境音の人物ティーザーなら、適切なTurbo処理と明瞭な開始画像から始めます。checkpoint表で、タスクとキャンバスに合う設定を選びます。要求を満たしたTurbo結果は残します。ラベルだけで完成した撮影が単なる案になるわけではありません。
必須の関係が複数ある参照場面には、専用の参照経路を使います。高速版がその関係を繰り返し落とすなら、ベースも使えるようにします。会話では、生成発話が必須か、音を別仕上げできるかを早めに決めます。
内容の能力は経路固有です。SpicyAPIの標準H3画像から動画ページの成人向けテスト結果は、そのタスクのもので、ローカルTurboや別サービスの挙動を示しません。高速化はNSFW対応の主張ではありません。ホスト型H3系列の違いには、H3・Spicy・LoRA・Singularity比較を使います。
次は実際に必要な撮影を1つ選び、キーフレームか参照へ割り当て、対応する公開設定を使います。ホスト型の開始フレーム処理なら、上の5秒の案を標準H3画像から動画ページへ持ち込み、承認済みの静止画をアップロードして見積もりを確認します。購入を判断するのは、使える完成場面です。正しい人物、必要な動作、動画に役立つ音を見ます。