最初から音がついた、大人向けのテーマの短いクリップがほしい。窓を打つ雨、カップルの背後の人混み、カメラに向けて静かに言う一言。規制なしの動画モデルの多くは、いまだに無音のファイルを返し、音は別のツールに任せます。
LTX-2 19B は、映像とステレオのサウンドトラックを1回のリクエストで作ります。コンテンツフィルターはなく、動画1秒あたり $0.0144 からです。 2026年10月5日と6日に生成した55本のクリップはすべて、映像の全長にわたる 24 kHz の AAC ステレオトラックを持ち、音は動きに合わせて動きました。クリップの途中でプロペラが回り始めたとき、トラックはそれまでほぼ無音のままでした。得られないのは一貫性です。同じプロンプトの seed 違いで、音量は 30 LU 以上も振れ、条件をそろえた15本のうち5本は、フレームに作り出された字幕が焼き込まれて返りました。
私たちは人間のように聴くことはできないので、ここでの音声に関する主張はすべて測定です。時間経過に伴う音量、ステレオの広がり、長さ。声やメロディがどれだけ良いかは採点していません。埋め込んだクリップは音付きで再生されるので、その部分はご自身で判断してください。モデルは LTX-2 19B のファミリーページと LTX-2 19B LoRA のファミリーページにあります。ここに載せるプロンプトはすべて、服を着た大人のシーンです。
ひと目でわかる要点
| 独自のサウンドトラックを持つ LTX-2 19B | |
|---|---|
| エンドポイント | テキストから動画と画像から動画。LoRA 版は LoRA ファイルを最大3つ追加できる |
| 音声 | すべてのクリップが 24 kHz のステレオ AAC。切るスイッチはない |
| 長さ | 5〜20 の整数秒。55本で、音と映像の長さの差は 0.0004 秒以内 |
| 解像度 | 480p(832 x 448)、720p(1280 x 704)、1080p(1920 x 1024)。9:16 は辺が入れ替わる。画像から動画は写真に従う |
| 価格、ライブカタログ | 1 秒あたり $0.0144、$0.0192、$0.0288。LoRA 版は $0.018、$0.024、$0.036。音声込み |
| 音の操作 | "Audio:" で始まる締めの一文 |
| 実測した音量 | −42.1〜−8.3 LUFS、中央値 −13.2。−1.6 dBTP を超えたクリップはなし |
| うまくいかないこと | seed 間の音量の振れ、作り出された字幕、遅れて来る、または来ないタイミング指定の音 |
| コンテンツ | コンテンツフィルターなし。テキストから動画は段階の7プローブのうち4つ、画像から動画は7つのうち2つが返り、拒否はなし |
サウンドトラックの作られ方
Lightricks は LTX-2 を、同期した映像と音声を生成する一つのモデルと説明しています。実際には次のとおりです。
- 1回のリクエストで1ファイル。 別の音声ジョブも、同期の手順もありません。5秒・720p のクリップは、音声込みで $0.096 です。
- 入力はテキストか写真で、音声ではない。 合わせたい声のファイルを渡すことはできません。
- 音は切れない。 無音のクリップにしたいなら、Studio の動画エディタでクリップの音量を下げるか、ダウンロード後にトラックを外してください。
提供元は、プロンプトへの追従は書き方に大きく左右されること、また音声が発話を含まないと品質が下がることがあることも注意しています。
Audio 行を書く
モデルは、映像も音も同じプロンプトから読みます。当社でうまくいったのは、提供元の LTX-2 プロンプトガイド(1つの段落に4〜8文)に従い、"Audio:" で始まる一文で締めて、それぞれの音をその発生源で名指しする書き方です。公開している例、夜に接岸するフェリーです。
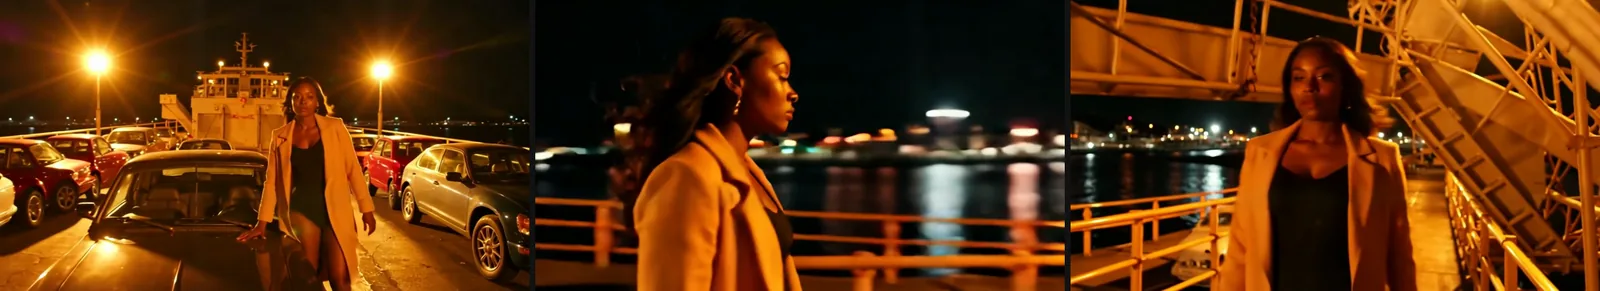
LTX-2 19B、テキストから動画、16:9、720p、6秒、seed 510512。サウンドトラックは、0.5秒ごとのどの区間でも −12.7〜−10.5 dBFS の間にとどまった。
The car deck of a night ferry as it docks. Sodium-vapour lamps turn everything orange and rows of parked cars glint. An adult Black woman in her early thirties in a long camel coat worn open over a fitted black bodysuit leans on the bonnet of a vintage car, her hair whipped by wind from the opening bow. The huge steel ramp lowers with a groan and slams onto the quay, showing the harbour lights beyond; she pushes off the car and walks toward the light, glancing back at the camera. Low-angle wide shot, slow dolly forward, sodium orange against black water, anamorphic flares. Audio: the deep thrum of the engines, chains rattling, the ramp groaning down and landing with a heavy metallic boom that echoes through the hold, then the ship horn.提供元のガイドと当社の実行から、5つの習慣です。
- 音を出すものを名指しする。 "Chains rattling" はフレーム内の何かを指しますが、"atmospheric audio" は発生源をまったく示しません。
- 音は起こる順に並べる。 モデルページにある夜行列車の例は、車輪、風、高まって消える踏切の鐘、遠くの警笛の順です。
- 雰囲気は服装と表情に、部屋の空気は音に任せる。 ずれる肩紐、ゆっくりした微笑み、窓を打つ雨、レコードのサックスで、ほのめかしのシーンには十分です。
- 物音を描写せず、短いセリフを言わせる。 言葉を引用符に入れ、言い方("says softly")を添えます。LTX-2 のコミュニティスレッドでは、声の物音の指定が奇妙な笑い声になったと報告されていました。当社はそれを試していませんが、短いセリフのほうが予測しやすいです。
- 画像から動画では、写真に写っているものに音を与える。 写真は人物と場所を固定するので、次に起こることと、その音を書いてください。別の部屋を描写したプロンプトは、クリップが写真から切り替わる原因になります。
| 指定の種類 | 使った書き方 | 測定でわかったこと |
|---|---|---|
| 安定した背景音 | "the deep thrum of the engines, chains rattling" | クリップ全体で一定のレベル |
| ショット内の一つの出来事 | "the engine coughing and catching into a roar" | ほぼ無音、そしてプロペラが回ると轟音(2つの seed とも) |
| 合図で始まる音楽 | "near silence at first … then … a slow, smoky saxophone ballad starts" | 一方の seed は6秒中の5.0秒で跳ね上がり、もう一方は変化しなかった |
| 引用符つきのセリフ | says softly, "Stay. The rain isn't stopping tonight." | 大きな山が2つ、その間はほぼ無音 |
| 音楽つきの群衆 | "a string quartet playing a slow waltz, the murmur of a crowd" | 一定のレベル。2つの seed の一方で字幕が焼き込まれた |
| かすかな遠い音 | "a faint dance band drifting from a villa along the coast" | 同じ行で4つの seed:−10.9〜−42.1 LUFS |
55本のサウンドトラックからわかったこと
10月5日の例の実行(両エンドポイント、ベースモデルと LoRA 版)から40本、10月6日にベースのテキストから動画で行った条件をそろえた15本を測定しました。形式と長さは ffprobe、統合音量とトゥルーピークは ffmpeg の EBU R128 メーター、下のカーブは0.1秒ごとのスライスのレベル、ステレオの広がりは2つのチャンネルの比較から得ました。
音は常にあり、映像と同じ長さ
55本すべてに 24 kHz のステレオ AAC トラックがあり、プロンプトが音に一度も触れていない2本も含まれます。5秒のリクエストは、映像も音も 5.042 秒、6秒は 6.042 秒、20秒は 20.042 秒で返りました。映像より先に終わるトラックはありませんでした。
音は動きに従う
パイロットが雨の中でプロペラ機に乗り込みます。プロンプトは、スターターの唸り、エンジンのかかり、プロペラの風を求めました。
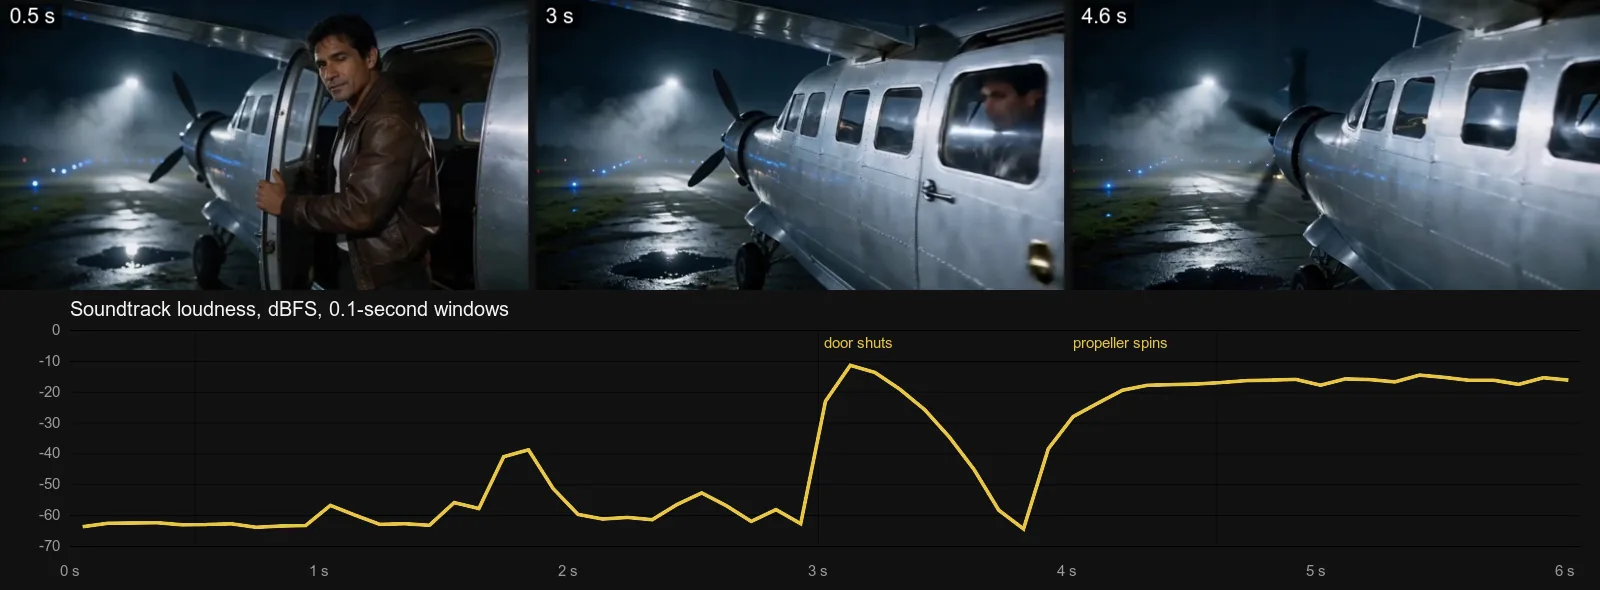
画像から動画、720p、6秒、seed 510515。3秒間は −60 dBFS 付近、ドアが閉まって跳ね上がり、プロペラが回ると約 −16 dBFS。2つ目の seed も3秒間は無音で、そのあと大きく安定したレベルが続いた。
動画:LTX-2 19B 画像から動画、720p、6秒、上で測定したプロペラ機のクリップ。生成されたサウンドトラック付き
これが、映像と一緒に音を生成する最大の理由です。大きな音は、映像が変わる場所に来ます。
タイミング指定は依頼であって、キューシートではない
最初に静けさ、あとから音楽を求めるのは、信頼性が下がります。このロフトのプロンプトは、ほぼ無音、そして針が落ち、サックスのバラードが始まるよう求めました。
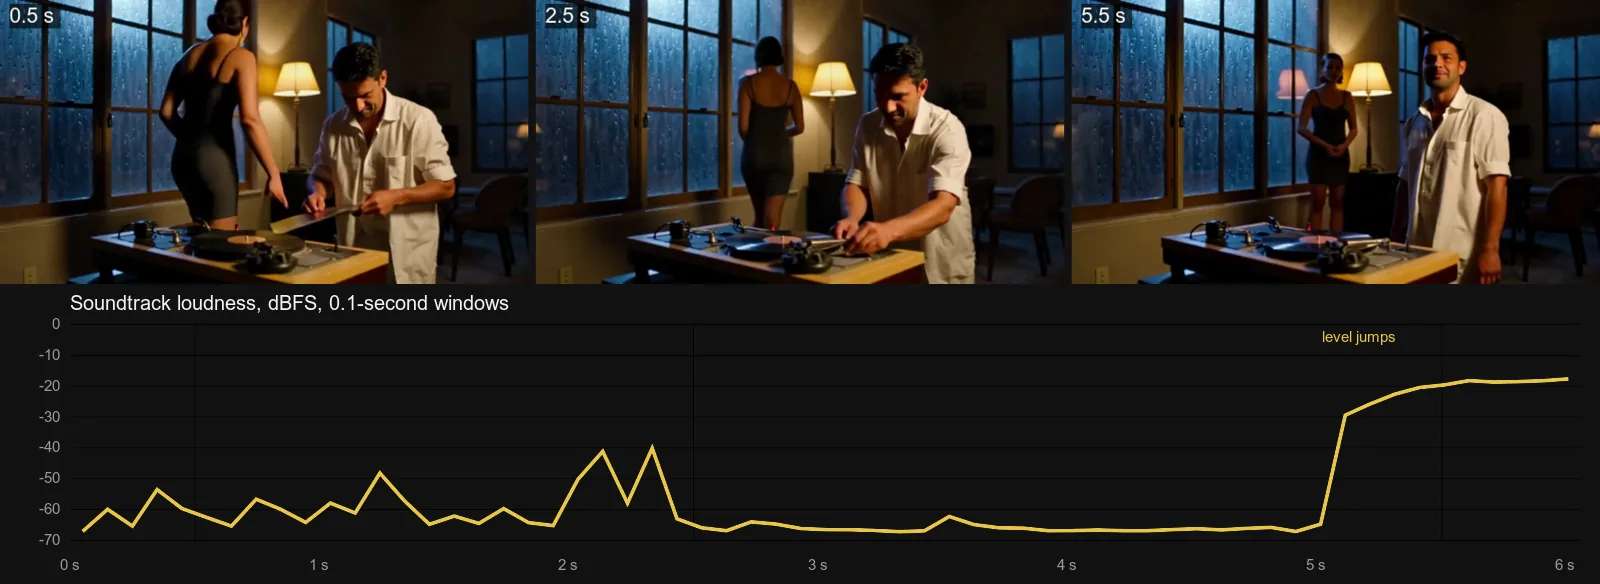
テキストから動画、480p、6秒、seed 610611。レベルは6秒中の5.0秒で跳ね上がる。
2つ目の seed は6秒間ずっと約 −45 dBFS にとどまり、変化しませんでした。音をあるフレームに置く必要があるなら、飛行機のプロンプトのように、その音を出す動作を書いてください。正確さが必須なら、あとから足してください。
音量は seed ごとに大きく変わる
クリップをつなぐときに最も重要です。月明かりのテラスの場面を、同じ Audio 行で4回実行しました。
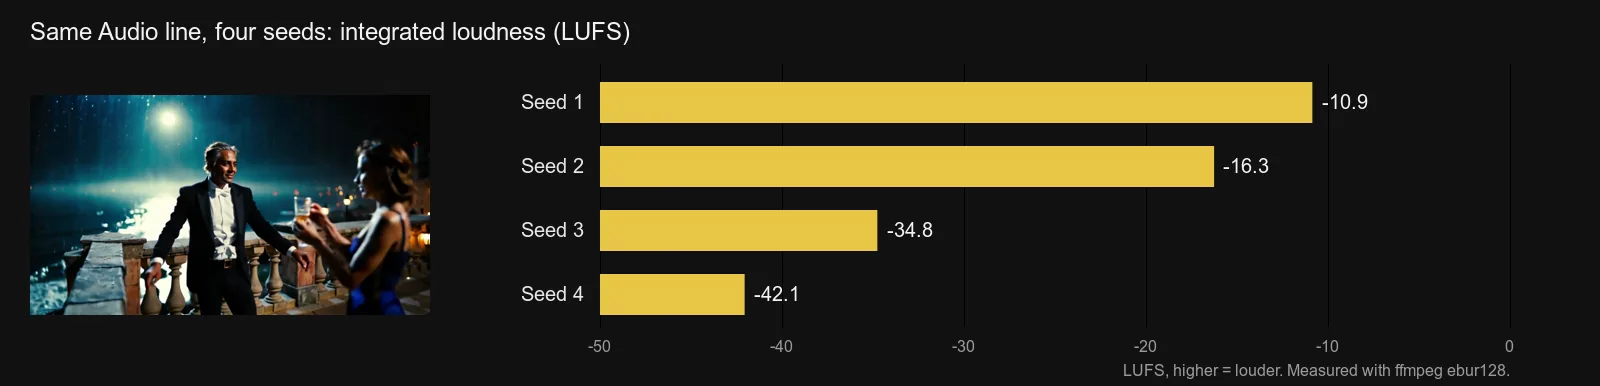
LTX-2 19B LoRA に Dolly Out カメラ LoRA、テキストから動画、720p、5秒、4つの seed。Audio 行は同一。後半2つのプロンプトは、両方の服装をより詳しく描写している。
55本全体で、統合音量は −42.1〜−8.3 LUFS、中央値は −13.2 でした。35本は中央値の 3 LU 以内、7本は −20 より小さい音でした。−1.6 dBTP を超えたクリップはなく、音が割れて返ったものはありません。これは言葉だけでは決まりません。テラスの最も大きな実行と最も小さな実行は、Audio 行が一字一句同じでした。
だから、クリップをつなぐ前に、Studio のエディタかラウドネスノーマライザーで音量をそろえてください。40本の例のクリップのうち6本は、最も大きな瞬間より少なくとも 15 dB 低いところで終わり、すべてカメラ LoRA を読み込んだ実行でした。カットする前に終わりを確認してください。
「ステレオ」は、ときにモノラル
どのファイルにもチャンネルは2つありますが、55本のうち14本ではほぼ同一(相関 0.99 以上)、13本ははっきり異なっていました(0.6 未満)。一つのセリフを軸にした4本は、すべて実質モノラルでした。広がりが大事なら、ヘッドホンで確認してください。
Audio 行を省いても、音は出る
仮面舞踏会の場面を、Audio 行あり(弦楽四重奏、群衆、グラス、彼女の笑い声)で2回、なしで2回、同じ seed で実行しました。
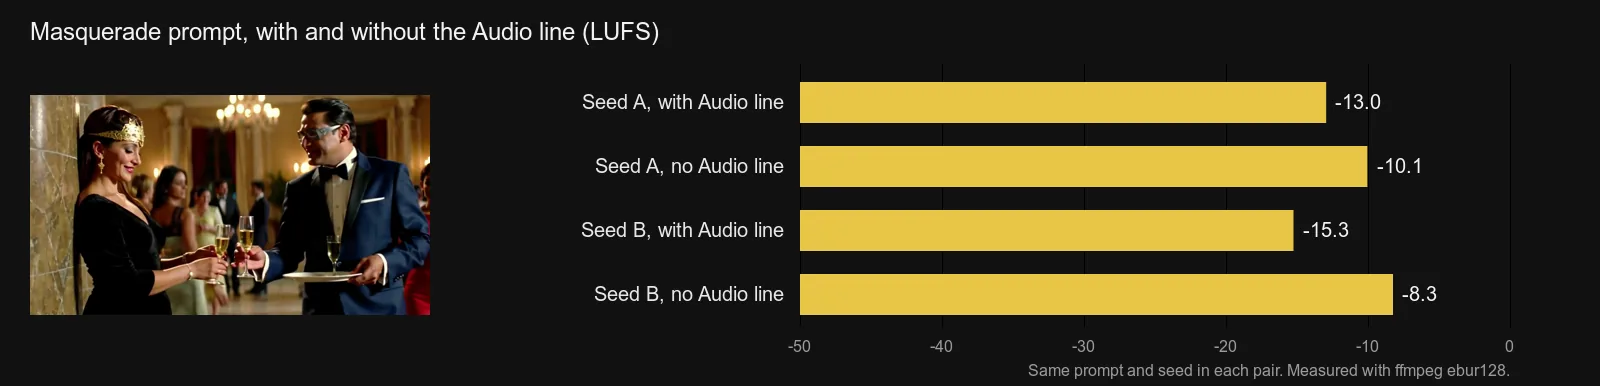
テキストから動画、720p、5秒、seed 610601 と 610602。Audio 行のない2本のクリップのほうが大きな音だった。
行がなくてもトラックは出ますが、中身は選べません。音が主題でないときも、Audio 行は残してください。
20秒も持ちこたえた
長いクリップは、別の音声工程が面倒になるところなので、480p で20秒のクリップを1本実行しました。
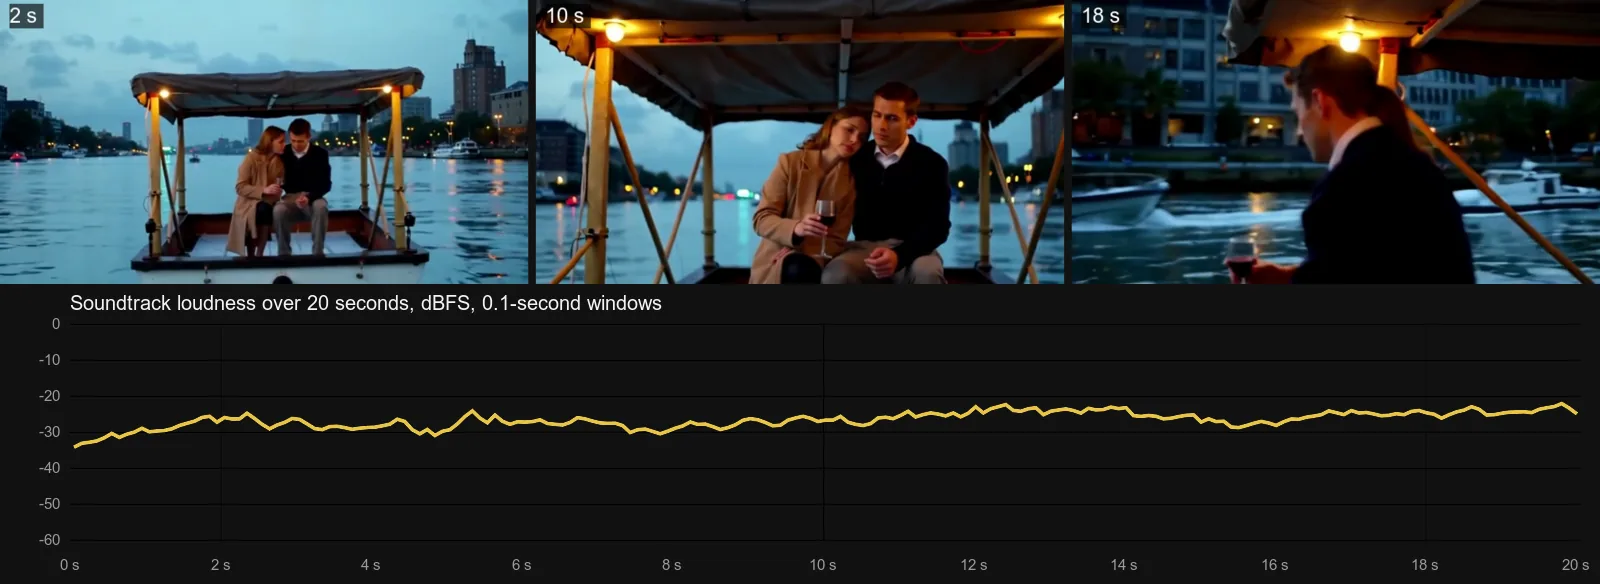
テキストから動画、16:9、480p、20秒、seed 610631。0.5秒ごとの音は −32.6〜−22.9 dBFS の間にとどまった。
動画:LTX-2 19B テキストから動画、480p、20秒、上で測定したハウスボートのクリップ
音は20秒間、持ちこたえました。ずれたのは映像のほうです。ゆっくりした押し込みが続き、彼女がほとんど彼の陰に隠れてしまいました。このクリップの費用は $0.288 でした。実行したままのプロンプトです。ただし、もう推奨しない "no on-screen text" の語句(次のセクションを参照)は除いています。
A houseboat on a river at dusk in light rain. An adult couple in their forties, a woman in a long camel coat and a man in a navy wool sweater, sit close under the canvas awning at the stern sharing a blanket, watching the city lights come on along the bank. He refills her glass of red wine; she leans her head on his shoulder; later a tour boat glides past and its wake rocks them gently. Wide shot, slow push-in, blue dusk with warm string lights, film grain. Audio: rain pattering on the canvas, water lapping against the hull, a distant radio playing old jazz, the low rumble of the passing boat and its wake slapping the side.このプロンプトを LTX-2 19B テキストから動画で実行する →
セリフと、頼んでいない字幕
短いセリフは、ほのめかしのクリップを個人的なものに感じさせます。クリーム色のシルクのローブの女性に、カメラを見上げて、静かに "Stay. The rain isn't stopping tonight." と言うよう頼みました。
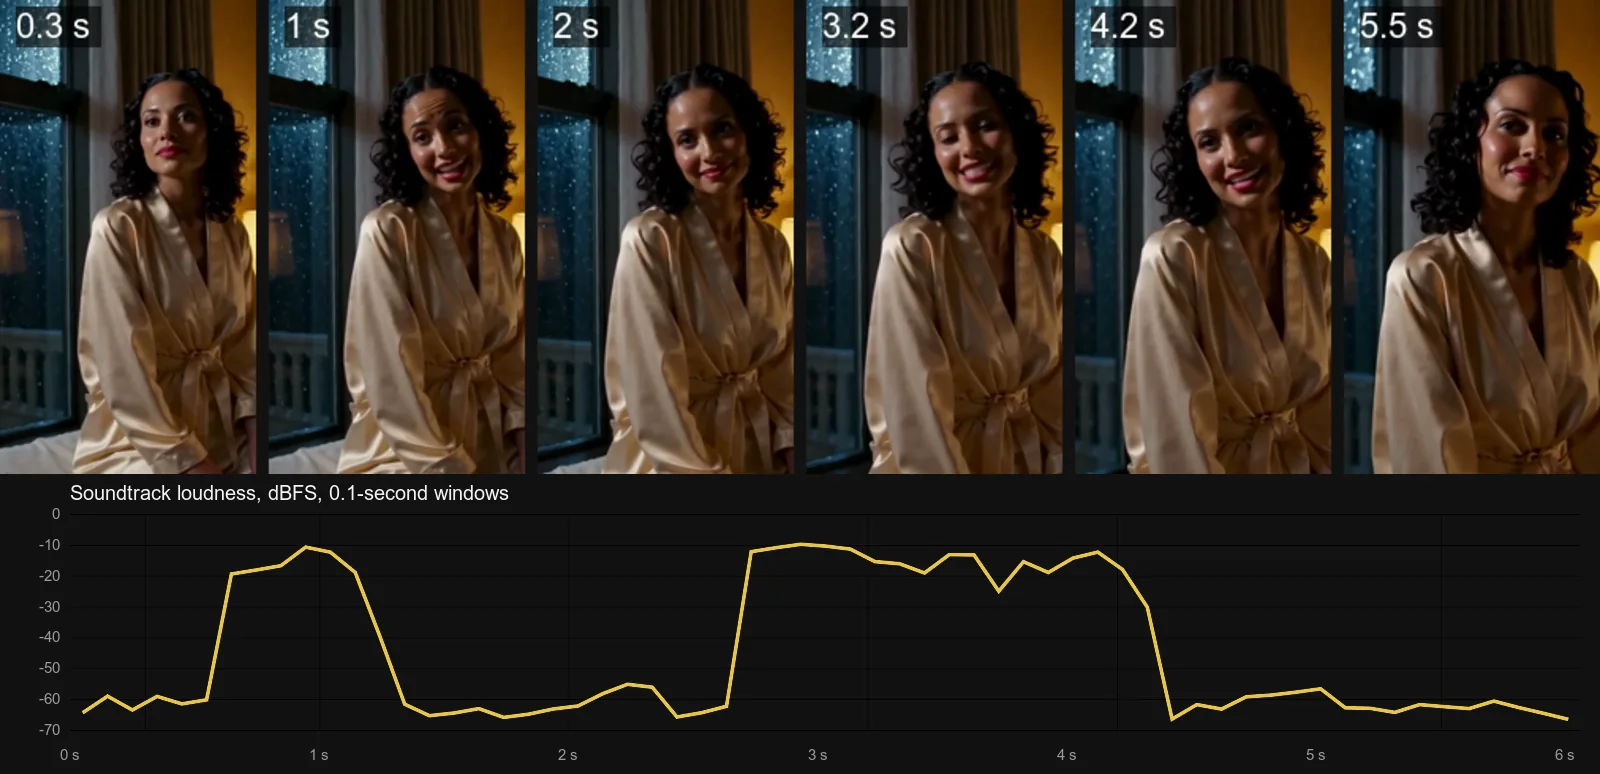
テキストから動画、9:16、480p、6秒、seed 610622。プロンプトに字幕に関する語句なし。
動画:LTX-2 19B テキストから動画、9:16、480p、6秒、上で測定したセリフのクリップ。言葉が合っているか聴いて確かめてください
2つの大きな区間は、二つに分けて言われたセリフと合いますが、言葉は確認していないので、頼る前に聴いてください。カーブがはっきり示すのは、頼んだ「ガラスを打つ一定の雨」が下に流れていなかったことです。山の間と後では、レベルが約 −60 dBFS まで落ちました。声があるとき、それがトラックを占領することがあります。
より大きな驚きは、映像の中の文字でした。条件をそろえた15本のうち5本に、作り出された言葉が焼き込まれていました。
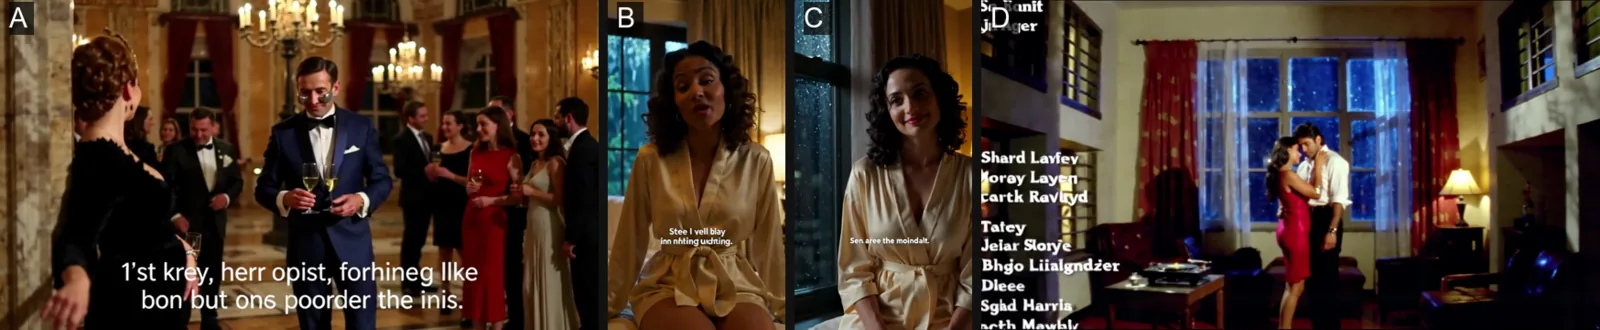
A:Audio 行つきの仮面舞踏会のプロンプト、seed 610601、最初の0.8秒のみ。B と C:"no subtitles, no captions, no on-screen text" を足したセリフのプロンプト、両方の seed。D:レコードに合わせて踊るカップルの 1080p のプロンプト。2つ目の seed は、代わりに一緒に歌う歌詞が出た。
15のプロンプトのうち11は "no subtitles" か "no on-screen text" で終わっていて、字幕が出た5本はすべてその中にありました。そうした語句のない4つのプロンプトは、きれいに返りました。同じセリフのプロンプトを同じ2つの seed で、語句なしならきれいで、語句ありなら字幕が出ました。ただし11のうち6つもきれいで、以前のバッチでは、"no subtitles" をつけた横長の2クリップがきれいに返ったので、この小さなサンプルでは、この語句は何も守らず、むしろ文字を誘発した可能性があります。文字は常に意味不明の文字列で、これは LTX-2 は読める文字を描かないという提供元の注記と合います。
- 字幕に関する語句をプロンプトに入れない。 当社の実行では何も防げませんでした。
- 最初と最後の1秒を確認する。 クリップ A では文字は0.8秒続いたので、冒頭をトリミングして直りました。
- seed を変える。 仮面舞踏会のプロンプトの2つ目の seed はきれいでした。
- 曲を軸にしたプロンプトは二度見る。 レコードに合わせて踊るカップルの 1080p の2本は、どちらもクレジットか歌詞つきで返りました。
内蔵の音声か、無音モデルに音の工程を足すか
もう一つの道は、無音のクリップに、効果音、声、音楽をあとから足すことです。NSFW AI 動画に声と音楽を足す方法と Foley 効果音のワークフローのガイドがその例です。5秒のクリップ1本、ライブカタログの価格、当社の指標のスコアです。
| ルート | 音声 | 5秒のクリップ | Freedom スコア | ブラインドテストのスコア |
|---|---|---|---|---|
| LTX-2 19B、720p | 常にオン、ステレオ | $0.096 | 76.1 | 47.5 |
| MiniMax H3、768p | クリップと一緒に生成 | $0.185 | 70.7 | 67.6 |
| Wan 3.0、720p | 既定でオン、切れる | $0.45 | 96 | 70.9 |
| Seedance 2.0 Fast、720p | 既定でオン。オフにしても料金は下がらない | $0.48 | 72.2 | 68.6 |
| HunyuanVideo 1.5、720p、続けて Foley v1 | 無音のクリップに、あとから効果音 | $0.24 + $0.006 | 88.1 | 57.7 |
Freedom は、モデルが大人向けコンテンツの段階をどれだけ返すかを示す当社の 0〜100 のスコアで、ブラインドテストはモデル名を伏せて映像の品質を採点します。どちらも2026年10月5日時点の当社のライブ指標からで、2段階のルートについては HunyuanVideo のものです。
- 安く何本も音付きの下書きを作るなら LTX-2 19B。 表で最も安いルートで、5秒・720p のクリップは当社の実行で14〜25秒かかりました。引き換えは映像で、ブラインドテストのスコアは5つの中で最低です。
- 映像の品質と大人向けコンテンツでの幅が価格より大事なら Wan 3.0。 1秒あたりの料金は数倍ですが、音も付きます。
- 特定のセリフを言わせたいとき、または気に入った無音のクリップがすでにあるときは、あとから音を足す。 Foley の効果音は 1 秒あたり $0.0012 です。
内蔵ルートの構造上の限界:音はレンダリングに焼き込まれるので、言葉を間違えれば、映像にもう一度お金を払うことになります。
どこまで通るか
LTX-2 19B は、プロンプトも結果も何もフィルタリングしません。当社の7プローブの段階(L1 ほのめかし:下着、ずり落ちる肩紐。L2 部分的。L3 強め。L4 高強度:成人同士の親密なシーン。L5 極限:成人同士の同意に基づく拘束、または映画的なゴア表現)で、テキストから動画は L1、L2、L3、拘束のプローブを書いたとおりに返し、L4、ゴア表現のプローブ、男性がフレームにいるプローブは控えめにしました。画像から動画は L1 と L3 を返し、残りを控えめにしました。拒否はありませんでした。全結果は LTX-2 19B のレビューに、カメラワークと LoRA ファイルは LTX-2 19B LoRA ガイドにあります。この段階には音声固有の指定はなく、プローブのプロンプトは掲載しません。
限界
- 音量は予測できない。 つなぐ前に、すべてのクリップの音量をそろえてください。
- 字幕が出ることがある。 "no subtitles" の語句の有無にかかわらず。採用するクリップはすべて、最初と最後の1秒を確認してください。
- タイミング指定の音は、ずれるか消える。 音はフレーム内の動作に結びつけてください。
- 音声のスイッチも、音声の入力もない。
- 声がトラックを占領することがある。 セリフのクリップでは、頼んだ雨がなかった。
- ステレオの広がりはまちまち。 実質モノラルのクリップもある。
- 映像は、より高いモデルに及ばない。 ブラインドテストのスコアは 47.5。
- 音は測定したが、評価はしていない。 声と音楽は、ご自身の耳で。
FAQ
LTX-2 19B は音声を生成しますか?
はい。すべてのクリップに、映像と同じ工程で作られた 24 kHz のステレオ AAC トラックがあり、プロンプトが音に一度も触れていないクリップも含まれます。
LTX-2 で音付きのプロンプトはどう書きますか?
ショットを4〜8文で描写し、"Audio:" で始まる一文で締めて、それぞれの音を発生源で名指しし、起こる順に並べます。話される言葉は引用符に入れ、短くしてください。
音を生成する AI 動画ジェネレーターはどれで、規制なしはどれですか?
SpicyAPI では、LTX-2 19B が常に音を生成し、Wan 3.0、Seedance 2.0 Fast、MiniMax H3 もクリップと一緒に音を生成します。4つとも当社の指標に Freedom スコア(70.7〜96)があり、価格、映像の品質、どこまで通るかが違います。
AI は音声ファイルから動画を作れますか?
このルートでは作れません。LTX-2 19B が受け取るのはプロンプトか写真です。すでに持っているセリフを顔に言わせるには、声と音楽のガイドのように、完成したクリップにリップシンクをかけてください。
音付きのクリップは何秒まで作れますか?
480p、720p、1080p で、5〜20 の整数秒です。当社の20秒のクリップは全体に音があり、480p の20秒のクリップは $0.288 です。
音を切れますか?
いいえ。動画エディタでクリップの音量を下げるか、ダウンロード後にトラックを外してください。
AI 動画にランダムな字幕が出るのはなぜですか?
モデルは、作り出した文字をフレームに焼き込むことがあり、当社の実行では "no subtitles" と書いても止まりませんでした。seed を変え、影響のある1秒をトリミングし、字幕に関する語句はプロンプトに入れないでください。