Chcesz krótkiego klipu o dorosłej tematyce, który od razu brzmi jak coś: deszcz za oknem, tłum za parą, zdanie powiedziane cicho do kamery. Wiele modeli wideo bez cenzury nadal oddaje niemy plik i zostawia dźwięk drugiemu narzędziu.
LTX-2 19B tworzy obraz i ścieżkę stereo w jednym zapytaniu, bez filtra treści, od 0,0144 USD za sekundę wideo. Wszystkie 55 klipów, które wygenerowaliśmy 5 i 6 października 2026, miały ścieżkę AAC stereo 24 kHz trwającą przez całą długość obrazu, a dźwięk podążał za akcją: gdy w połowie klipu zaczynało się kręcić śmigło, ścieżka do tego momentu pozostawała blisko ciszy. Czego nie dostajesz, to spójności. Głośność wahała się o ponad 30 LU między seedami jednego promptu, a 5 z naszych 15 kontrolowanych klipów wróciło z wymyślonymi napisami wypalonymi w kadrze.
Nie słuchamy tak jak ty, więc każde twierdzenie o dźwięku tutaj jest zmierzone: głośność w czasie, szerokość stereo, długość. Nie oceniliśmy, jak dobrze brzmi głos albo melodia. Osadzone klipy odtwarzają się z dźwiękiem, więc tę część ocenisz sam. Modele są na stronie rodziny LTX-2 19B i stronie rodziny LTX-2 19B LoRA; każdy wydrukowany tu prompt to scena z ubranymi dorosłymi.
W skrócie
| LTX-2 19B z własną ścieżką dźwiękową | |
|---|---|
| Endpointy | Tekst na wideo i obraz na wideo; wersja LoRA dodaje do trzech plików LoRA |
| Dźwięk | AAC stereo 24 kHz w każdym klipie, bez przełącznika do wyłączenia |
| Długość | 5 do 20 pełnych sekund; w 55 klipach długości dźwięku i obrazu zgadzały się z dokładnością do 0,0004 s |
| Rozdzielczość | 480p (832 x 448), 720p (1280 x 704), 1080p (1920 x 1024); 9:16 zamienia boki; obraz na wideo podąża za zdjęciem |
| Cena, aktualny katalog | 0,0144, 0,0192 lub 0,0288 USD za sekundę; wersja LoRA 0,018, 0,024 lub 0,036 USD; dźwięk w cenie |
| Sterowanie dźwiękiem | Zamykające zdanie zaczynające się od „Audio:” |
| Zmierzona głośność | od −42,1 do −8,3 LUFS, mediana −13,2; żaden klip nie przekroczył −1,6 dBTP |
| Co idzie źle | Wahania głośności między seedami, wymyślone napisy, sygnały w czasie, które przychodzą późno albo wcale |
| Treści | Brak filtra treści; tekst na wideo dostarczył 4 z 7 prób drabiny, obraz na wideo 2 z 7, żadna nie została odrzucona |
Jak powstaje ścieżka dźwiękowa
Lightricks opisuje LTX-2 jako jeden model generujący zsynchronizowane wideo i audio. W praktyce:
- Jedno zapytanie, jeden plik. Bez osobnego zadania audio i bez kroku synchronizacji. Pięciosekundowy klip 720p kosztuje 0,096 USD razem z dźwiękiem.
- Wejściem jest tekst albo zdjęcie, nigdy audio. Nie podasz mu pliku głosowego do dopasowania.
- Dźwięku nie da się wyłączyć. Dla klipu bez dźwięku ścisz jego audio w edytorze wideo Studio albo usuń ścieżkę po pobraniu.
Wydawca ostrzega też, że wykonywanie promptu mocno zależy od tego, jak go napiszesz, i że audio bez mowy może wyjść w gorszej jakości.
Napisz linię Audio
Model czyta obraz i dźwięk z tego samego promptu. To, co zadziałało u nas, idzie za przewodnikiem promptowania LTX-2 wydawcy (od czterech do ośmiu zdań w jednym akapicie) i kończy się jednym zdaniem zaczynającym się od „Audio:”, które nazywa każdy dźwięk przez jego źródło. Opublikowany przykład, prom cumujący nocą:
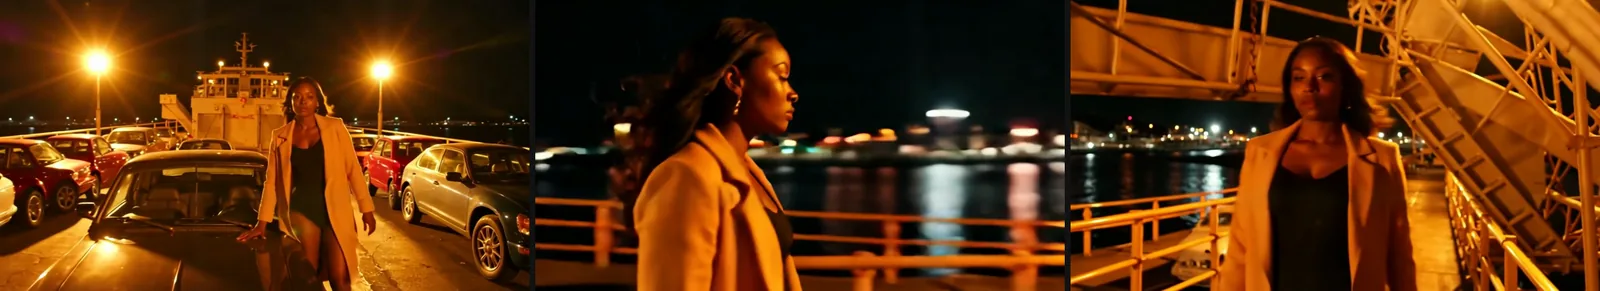
LTX-2 19B, tekst na wideo, 16:9, 720p, 6 sekund, seed 510512. Jego ścieżka dźwiękowa w każdej półsekundzie mieściła się między −12,7 a −10,5 dBFS.
The car deck of a night ferry as it docks. Sodium-vapour lamps turn everything orange and rows of parked cars glint. An adult Black woman in her early thirties in a long camel coat worn open over a fitted black bodysuit leans on the bonnet of a vintage car, her hair whipped by wind from the opening bow. The huge steel ramp lowers with a groan and slams onto the quay, showing the harbour lights beyond; she pushes off the car and walks toward the light, glancing back at the camera. Low-angle wide shot, slow dolly forward, sodium orange against black water, anamorphic flares. Audio: the deep thrum of the engines, chains rattling, the ramp groaning down and landing with a heavy metallic boom that echoes through the hold, then the ship horn.Pięć nawyków, z przewodnika wydawcy i naszych prób:
- Nazwij rzecz, która wydaje dźwięk. „Chains rattling” wskazuje coś w kadrze; „atmospheric audio” nie nazywa żadnego źródła.
- Wymieniaj dźwięki w kolejności, w jakiej się dzieją. Przykład nocnego pociągu na stronie modelu idzie tak: koła, wiatr, dzwon przejazdu, który narasta i cichnie, a potem róg daleko z przodu.
- Niech strój i spojrzenia niosą nastrój, a dźwięk niesie pomieszczenie. Zsuwające się ramiączko, powolny uśmiech, deszcz na szybie i saksofon z płyty wystarczą do sugestywnej sceny.
- Napisz krótką kwestię zamiast opisywać dźwięki. Wstaw słowa w cudzysłów i powiedz jak („says softly”). Wątek społeczności o LTX-2 zgłaszał, że wskazówki odgłosów głosowych wychodziły jako dziwny śmiech; tego nie testowaliśmy, a krótka kwestia jest bardziej przewidywalna.
- W obrazie na wideo przypisz dźwięk temu, co jest na zdjęciu. Zdjęcie ustala osobę i miejsce; opisz, co dzieje się dalej i jak to brzmi. Prompt opisujący inne pomieszczenie może sprawić, że klip ucieknie od twojego zdjęcia.
| Typ sygnału | Sformułowanie, którego użyliśmy | Co pokazały pomiary |
|---|---|---|
| Stałe tło | „the deep thrum of the engines, chains rattling” | Stały poziom przez cały klip |
| Jedno zdarzenie w kadrze | „the engine coughing and catching into a roar” | Prawie cisza, potem ryk, gdy śmigło się kręci (2 z 2 seedów) |
| Muzyka startująca na sygnał | „near silence at first … then … a slow, smoky saxophone ballad starts” | Jeden seed skoczył w 5,0 s z 6; drugi nigdy się nie zmienił |
| Wypowiedziana kwestia w cudzysłowie | says softly, "Stay. The rain isn't stopping tonight." | Dwa głośne wybuchy, między nimi prawie cisza |
| Tłum z muzyką | „a string quartet playing a slow waltz, the murmur of a crowd” | Stały poziom; jeden z dwóch seedów z wypalonymi napisami |
| Słabe, odległe dźwięki | „a faint dance band drifting from a villa along the coast” | Ta sama linia, cztery seedy: od −10,9 do −42,1 LUFS |
Co pokazało 55 ścieżek dźwiękowych
Zmierzyliśmy 40 klipów z przykładowych przebiegów z 5 października (oba endpointy, model bazowy i wersja LoRA) oraz 15 kontrolowanych klipów uruchomionych 6 października w bazowym tekście na wideo. Format i długość pochodziły z ffprobe, głośność zintegrowana i szczyt prawdziwy z miernika EBU R128 w ffmpeg, krzywe niżej z poziomu każdego odcinka 0,1 sekundy, a szerokość stereo z porównania dwóch kanałów.
Dźwięk jest zawsze, tak długi jak obraz
Wszystkie 55 klipów miało ścieżkę AAC stereo 24 kHz, w tym dwa, w których prompt w ogóle nie wspominał o dźwięku. Zapytania na pięć sekund zwracały 5,042 sekundy obrazu i dźwięku, na sześć sekund 6,042, na dwadzieścia sekund 20,042. Żadna ścieżka nie kończyła się przed obrazem.
Dźwięk podąża za akcją
Pilot wsiada do samolotu śmigłowego w deszczu; prompt prosił o jęk rozrusznika, zaskakujący silnik i podmuch od śmigła.
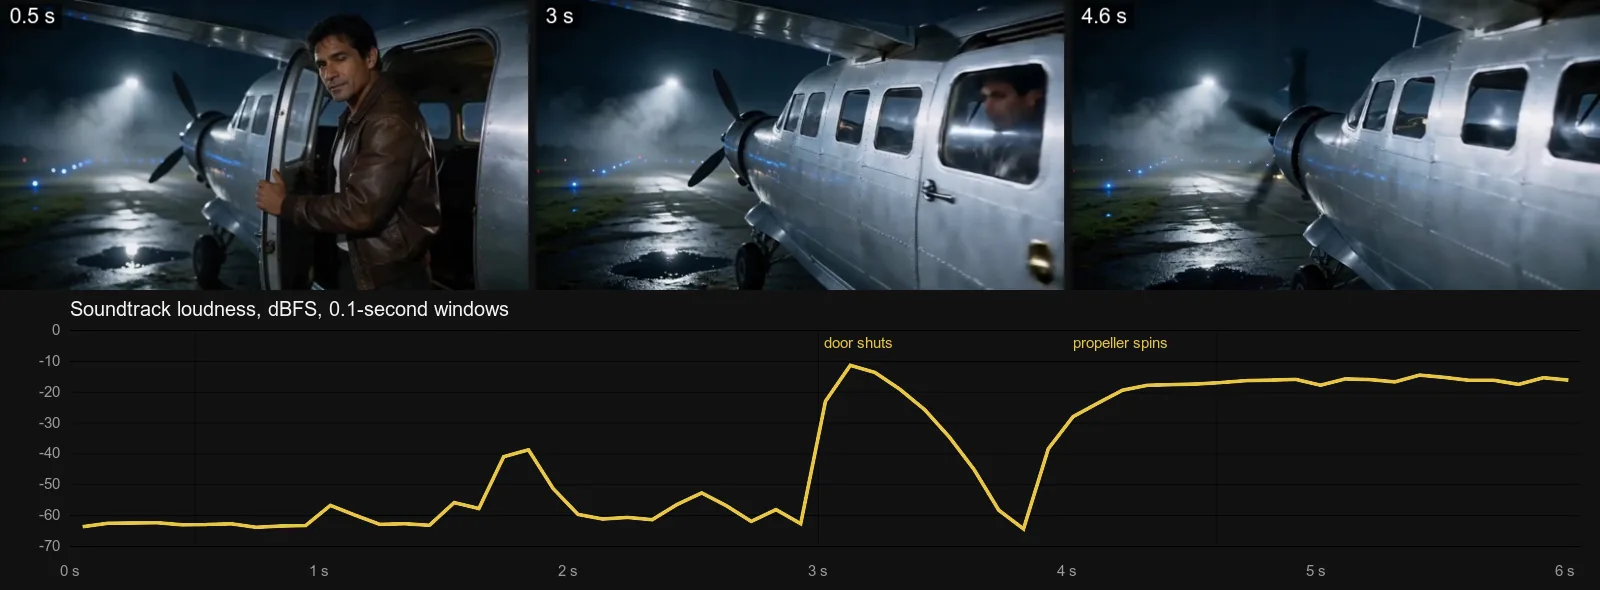
Obraz na wideo, 720p, 6 sekund, seed 510515. Blisko −60 dBFS przez trzy sekundy, skok przy zamknięciu drzwi, a potem około −16 dBFS, gdy śmigło się kręci. Drugi seed też milczał przez trzy sekundy, a potem utrzymywał głośny, stały poziom.
To główny powód, by generować dźwięk razem z obrazem: głośna część ląduje tam, gdzie zmienia się obraz.
Sygnał w czasie to prośba, a nie arkusz sygnałów
Prośba o ciszę na początku i muzykę później jest mniej niezawodna. Ten prompt z loftem prosił o prawie ciszę, a potem opadającą igłę i balladę na saksofonie.
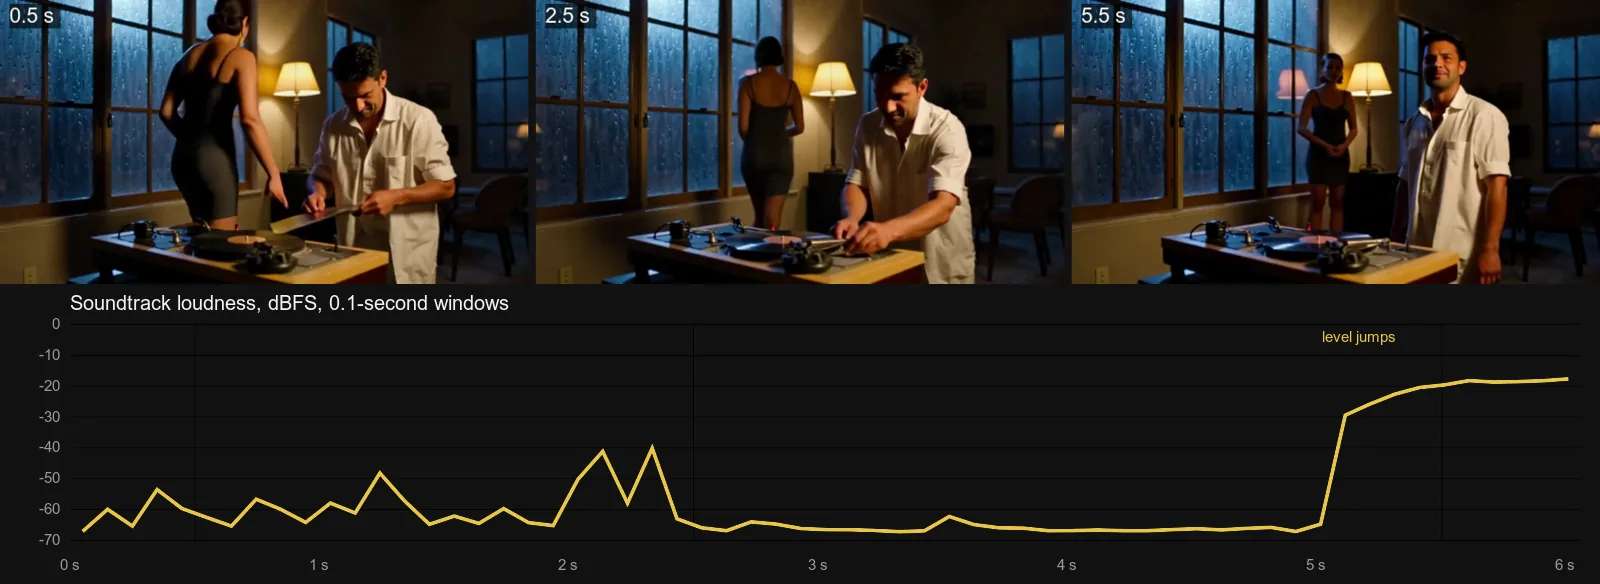
Tekst na wideo, 480p, 6 sekund, seed 610611. Poziom skacze w 5,0 sekundy z 6.
Drugi seed siedział na około −45 dBFS przez wszystkie sześć sekund i nigdy się nie zmienił. Jeśli dźwięk musi wylądować na klatce, opisz czynność, która go wydaje, jak zrobił to prompt z samolotem. Jeśli ma być dokładny, dodaj go potem.
Głośność mocno zmienia się między seedami
Ma to największe znaczenie, gdy łączysz klipy. Scenę tarasu w świetle księżyca uruchomiono cztery razy z tą samą linią Audio:
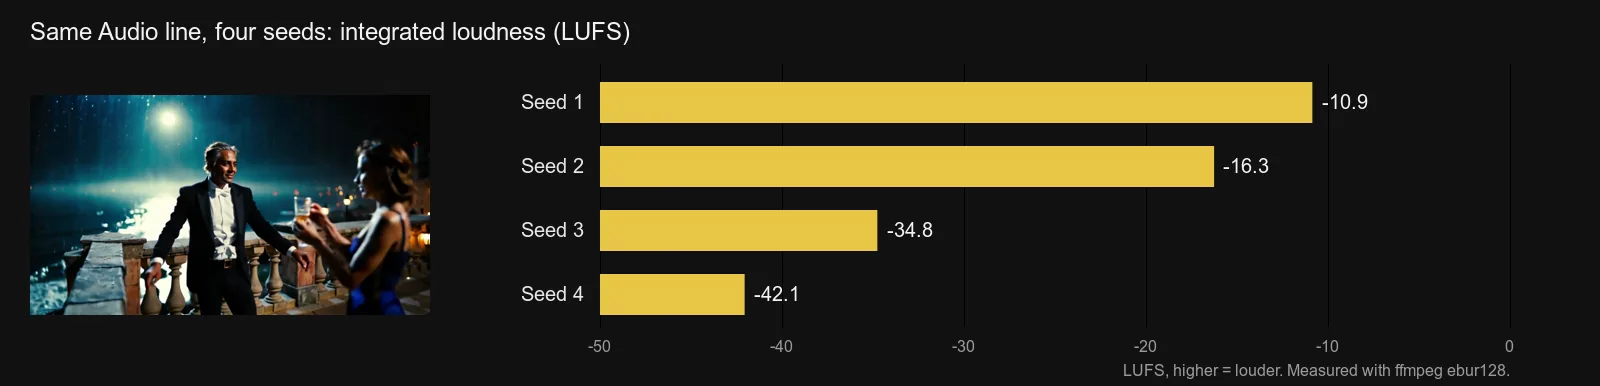
LTX-2 19B LoRA z LoRA kamery Dolly Out, tekst na wideo, 720p, 5 sekund, cztery seedy. Linia Audio była identyczna; dwa ostatnie prompty opisywały też obie stylizacje dokładniej.
We wszystkich 55 klipach głośność zintegrowana wahała się od −42,1 do −8,3 LUFS przy medianie −13,2; 35 mieściło się w granicach 3 LU od mediany, a 7 było cichszych niż −20. Żaden klip nie przekroczył −1,6 dBTP, więc nic nie wróciło przesterowane. Samo sformułowanie tego nie rozstrzyga: najgłośniejszy i najcichszy przebieg tarasu miały tę samą linię Audio, słowo w słowo.
Dlatego wyrównaj głośność, zanim połączysz klipy, w edytorze Studio albo normalizatorem głośności. Sześć z 40 przykładowych klipów kończyło się też co najmniej 15 dB poniżej swojego najgłośniejszego momentu, wszystkie z przebiegów z załadowaną LoRA kamery, więc sprawdź końcówki, zanim zrobisz cięcie.
„Stereo” bywa mono
Każdy plik ma dwa kanały, ale w 14 z 55 kanały były praktycznie identyczne (korelacja 0,99 lub więcej), a w 13 wyraźnie różne (poniżej 0,6). Wszystkie cztery klipy zbudowane wokół jednej wypowiedzianej kwestii były w praktyce mono. Jeśli szerokość ma znaczenie, sprawdź na słuchawkach.
Pominięcie linii Audio nadal daje dźwięk
Scenę balu maskowego uruchomiliśmy dwa razy z linią Audio (kwartet smyczkowy, tłum, kieliszki, jej śmiech) i dwa razy bez, na tych samych seedach.
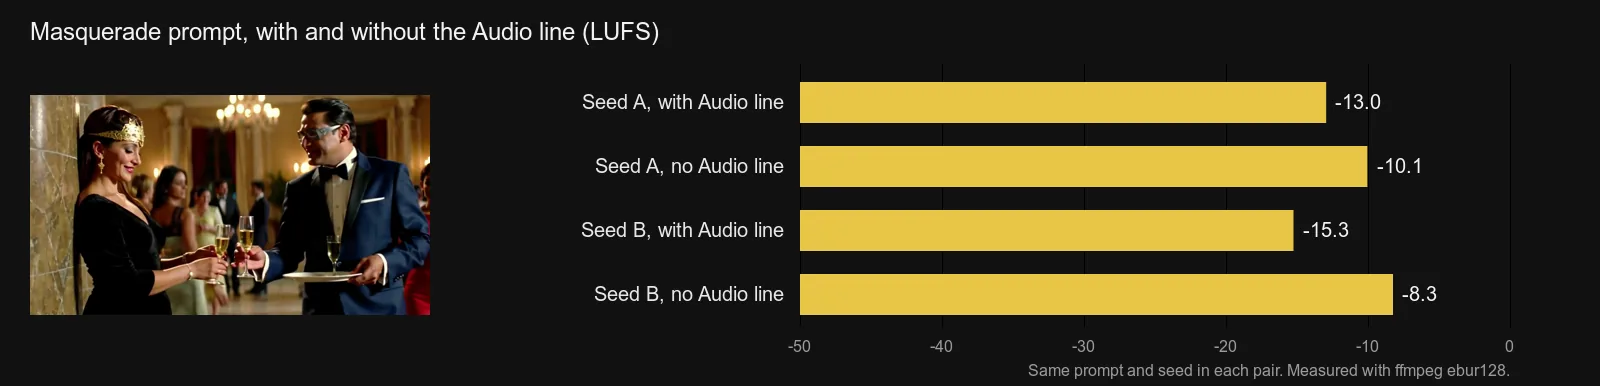
Tekst na wideo, 720p, 5 sekund, seedy 610601 i 610602. Dwa klipy bez linii Audio były głośniejsze.
Bez tej linii nadal dostajesz ścieżkę; po prostu nie wybierasz, co na niej jest. Zostaw linię Audio, nawet gdy dźwięk nie jest sednem.
Dwadzieścia sekund wytrzymało
Długie klipy to miejsce, w którym osobne przejście dźwiękowe robi się żmudne, więc uruchomiliśmy jeden 20-sekundowy klip w 480p.
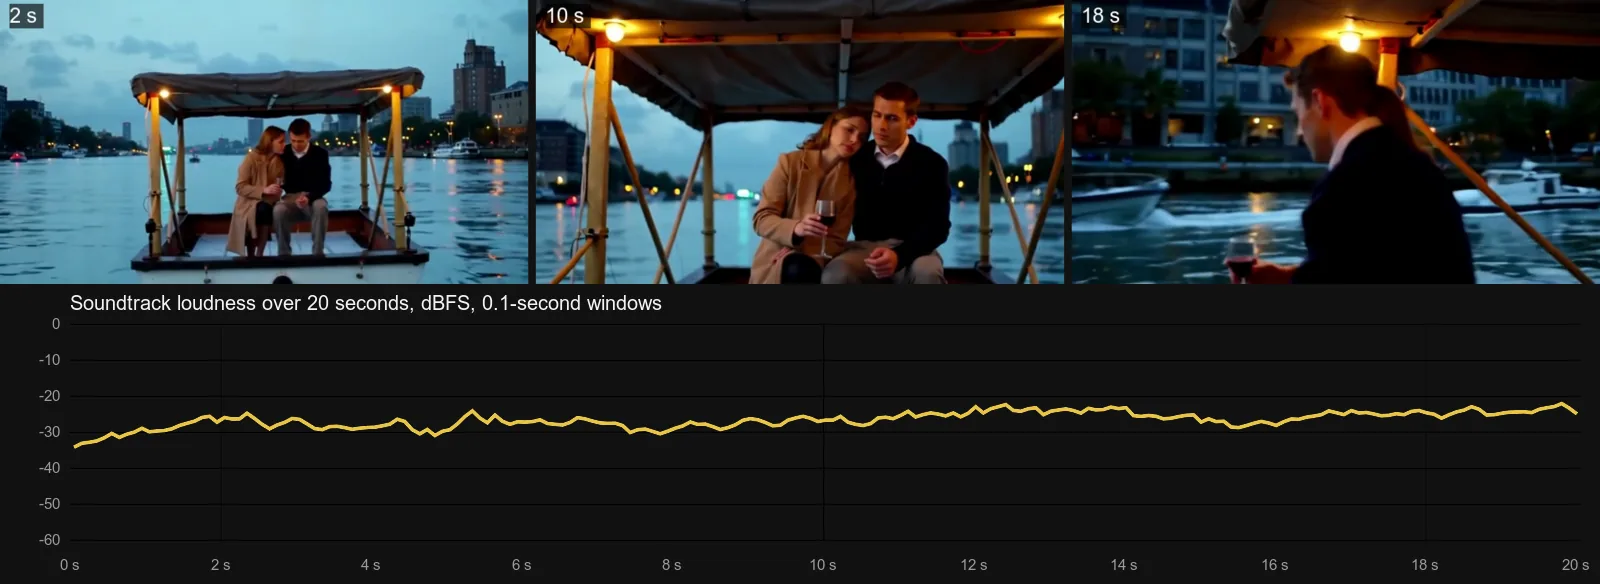
Tekst na wideo, 16:9, 480p, 20 sekund, seed 610631. Każda półsekunda dźwięku mieściła się między −32,6 a −22,9 dBFS.
Wideo: LTX-2 19B tekst na wideo, 480p, 20 sekund, klip z barką mieszkalną zmierzony powyżej
Dźwięk wytrzymał wszystkie dwadzieścia sekund. Dryfował za to obraz: powolny najazd trwał dalej, aż ona w większości zniknęła za nim. Klip kosztował 0,288 USD. Prompt tak, jak go uruchomiliśmy, bez frazy „no on-screen text”, której już nie polecamy (zobacz następną sekcję):
A houseboat on a river at dusk in light rain. An adult couple in their forties, a woman in a long camel coat and a man in a navy wool sweater, sit close under the canvas awning at the stern sharing a blanket, watching the city lights come on along the bank. He refills her glass of red wine; she leans her head on his shoulder; later a tour boat glides past and its wake rocks them gently. Wide shot, slow push-in, blue dusk with warm string lights, film grain. Audio: rain pattering on the canvas, water lapping against the hull, a distant radio playing old jazz, the low rumble of the passing boat and its wake slapping the side.Uruchom ten prompt w LTX-2 19B tekst na wideo →
Wypowiedziane kwestie i napisy, o które nikt nie prosił
Krótka kwestia sprawia, że sugestywny klip wydaje się osobisty. Poprosiliśmy kobietę w kremowym jedwabnym szlafroku, by spojrzała w kamerę i powiedziała cicho: „Stay. The rain isn't stopping tonight.”
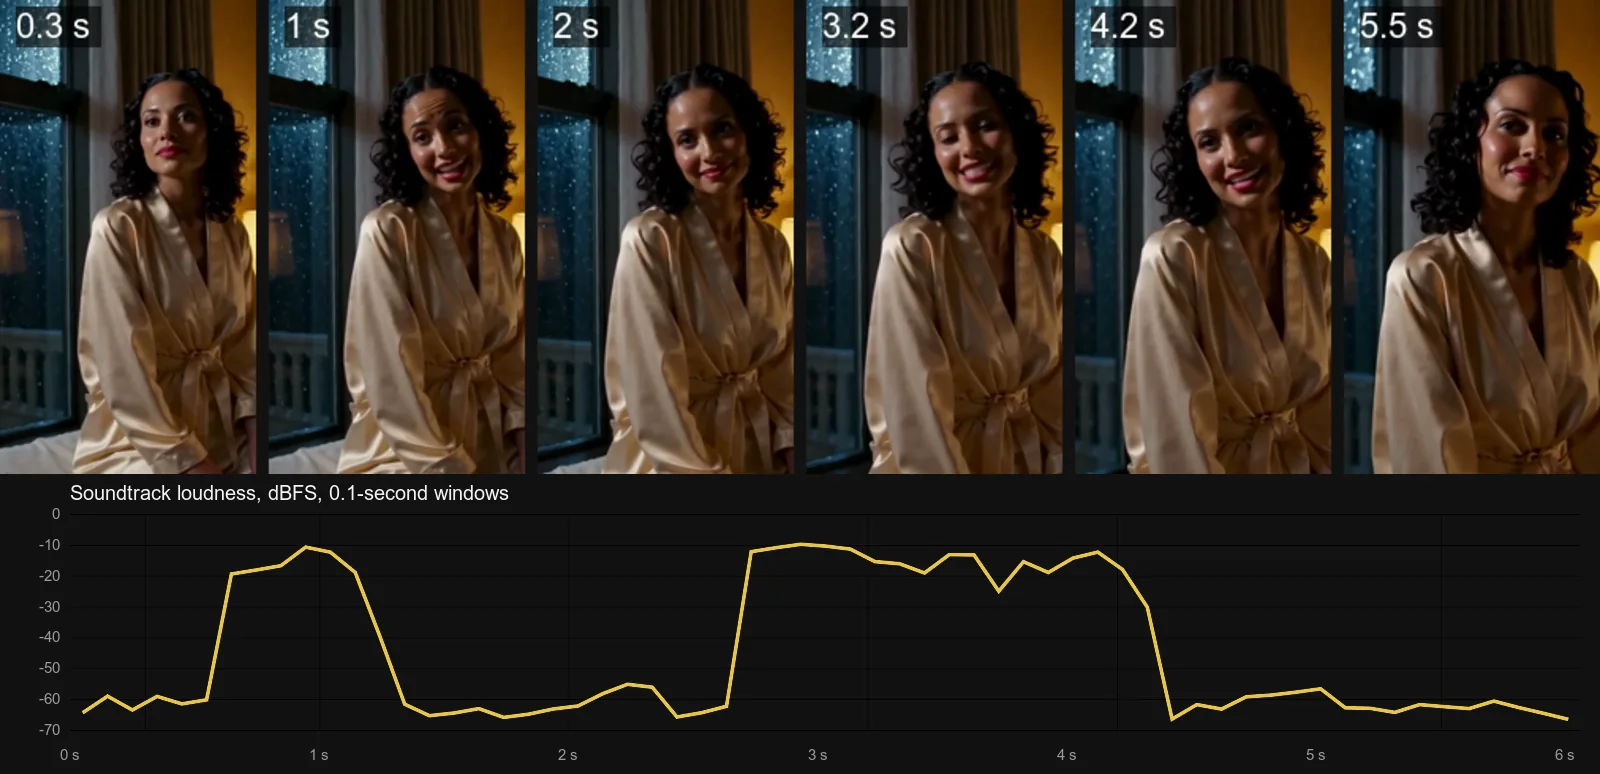
Tekst na wideo, 9:16, 480p, 6 sekund, seed 610622, bez słów o napisach w prompcie.
Dwa głośne odcinki pasują do kwestii wypowiedzianej w dwóch częściach, ale nie sprawdzaliśmy słów, więc posłuchaj, zanim na tym oprzesz pracę. Krzywa pokazuje natomiast, że „steady rain on the glass”, o który prosiliśmy, nie leżało pod spodem: między wybuchami i po nich poziom spadał do około −60 dBFS. Gdy jest głos, może przejąć całą ścieżkę.
Większym zaskoczeniem był tekst w obrazie. Pięć z naszych 15 kontrolowanych klipów miało wypalone wymyślone słowa:
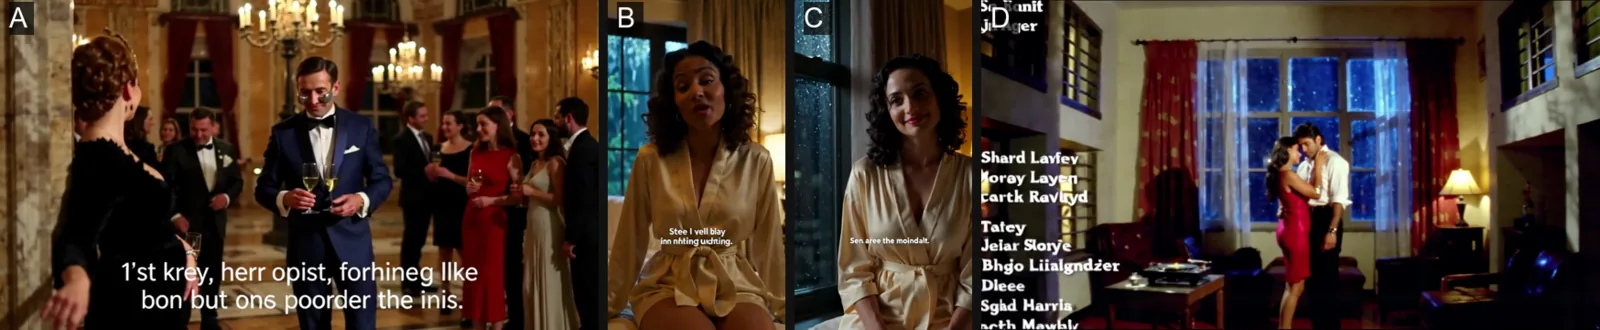
A: prompt balu maskowego z linią Audio, seed 610601, tylko pierwsze 0,8 sekundy. B i C: prompt z wypowiedzianą kwestią z dodanym „no subtitles, no captions, no on-screen text”, oba seedy. D: prompt 1080p o parze tańczącej do płyty; jego drugi seed pokazał zamiast tego słowa do śpiewania.
Jedenaście z 15 promptów kończyło się „no subtitles” albo „no on-screen text”, a wszystkie pięć klipów z napisami było wśród nich; cztery prompty bez takiej frazy wróciły czyste. Ten sam prompt z wypowiedzianą kwestią na tych samych dwóch seedach był czysty bez frazy i z napisami z nią. Sześć z jedenastu też było czystych, a we wcześniejszej partii dwa klipy poziome z „no subtitles” wróciły czyste, więc na tej małej próbce fraza niczego nie chroniła i mogła sprowokować tekst. Tekst to zawsze bełkot, co pasuje do uwagi wydawcy, że LTX-2 nie renderuje czytelnego tekstu.
- Pomiń w prompcie słowa o napisach. W naszych próbach niczemu nie zapobiegały.
- Sprawdź pierwszą i ostatnią sekundę. W klipie A tekst trwał 0,8 sekundy; przycięcie początku to naprawiło.
- Zmień seed. Drugi seed promptu balu maskowego był czysty.
- Przyjrzyj się dwa razy promptom zbudowanym wokół piosenki. Oba klipy 1080p z parą tańczącą do płyty wróciły z napisami końcowymi albo tekstem piosenki.
Dźwięk wbudowany czy niemy model plus przejście dźwiękowe?
Druga droga to niemy klip z efektami, głosem i muzyką dodanymi potem, jak w naszych poradnikach o dodawaniu głosu i muzyki do wideo NSFW AI i przepływie efektów dźwiękowych Foley. Jeden pięciosekundowy klip, ceny z aktualnego katalogu i nasze wyniki indeksu:
| Droga | Dźwięk | 5-sekundowy klip | Freedom Score | Wynik testu w ciemno |
|---|---|---|---|---|
| LTX-2 19B, 720p | Zawsze włączony, stereo | 0,096 USD | 76,1 | 47,5 |
| MiniMax H3, 768p | Generowany z klipem | 0,185 USD | 70,7 | 67,6 |
| Wan 3.0, 720p | Domyślnie włączony, można wyłączyć | 0,45 USD | 96 | 70,9 |
| Seedance 2.0 Fast, 720p | Domyślnie włączony; wyłączenie nie obniża stawki | 0,48 USD | 72,2 | 68,6 |
| HunyuanVideo 1.5, 720p, potem Foley v1 | Niemy klip, efekty dodane potem | 0,24 USD + 0,006 USD | 88,1 | 57,7 |
Freedom to nasz wynik od 0 do 100 mówiący, ile z drabiny treści dla dorosłych model dostarcza; test w ciemno ocenia jakość obrazu z ukrytymi nazwami modeli. Oba pochodzą z naszego aktualnego indeksu z 5 października 2026; dla drogi dwustopniowej to wyniki HunyuanVideo.
- Wybierz LTX-2 19B do wielu tanich szkiców z dźwiękiem. To najtańsza droga w tabeli, a pięciosekundowy klip 720p zajął w naszych próbach od 14 do 25 sekund. Wymianą jest obraz: jego wynik w teście w ciemno jest najniższy z pięciu.
- Wybierz Wan 3.0, gdy jakość obrazu i zakres treści dla dorosłych liczą się bardziej niż cena. Kosztuje kilka razy więcej za sekundę i nadal daje dźwięk.
- Dodaj dźwięk potem, gdy konkretna kwestia musi zostać wypowiedziana albo już lubisz niemy klip. Efekty Foley kosztują 0,0012 USD za sekundę.
Strukturalne ograniczenie drogi wbudowanej: dźwięk jest wpieczony w render, więc złe słowo oznacza płacenie za obraz od nowa.
Jak daleko to sięga
LTX-2 19B niczego nie filtruje w prompcie ani w wyniku. Na naszej drabinie siedmiu prób (L1 Sugestywny, bielizna albo zsuwające się ramiączko; L2 Częściowy; L3 Mocny; L4 Intensywny, intymna scena między dwojgiem dorosłych; L5 Ekstremalny, dobrowolne skrępowanie między dorosłymi albo filmowy gore) tekst na wideo dostarczył L1, L2, L3 i próbę skrępowania zgodnie z opisem, a stonował L4, próbę gore i próbę z mężczyzną w kadrze. Obraz na wideo dostarczył L1 i L3, a resztę stonował. Nic nie zostało odrzucone. Pełne wyniki są w recenzji LTX-2 19B; ruchy kamery i pliki LoRA w naszym poradniku LTX-2 19B LoRA. Drabina nie miała sygnałów specyficznych dla dźwięku i nie drukujemy promptów prób.
Ograniczenia
- Głośność jest nieprzewidywalna. Znormalizuj każdy klip przed połączeniem.
- Mogą pojawić się napisy, z frazą „no subtitles” albo bez niej. Sprawdź pierwszą i ostatnią sekundę każdego zachowanego klipu.
- Sygnały w czasie dryfują albo znikają. Wiąż dźwięki z czynnościami w kadrze.
- Brak przełącznika audio i brak wejścia audio.
- Głosy mogą przejąć ścieżkę. W naszym klipie z wypowiedzianą kwestią brakowało deszczu, o który prosiliśmy.
- Szerokość stereo bywa różna. Niektóre klipy są w praktyce mono.
- Obraz ustępuje droższym modelom. Wynik w teście w ciemno 47,5.
- Dźwięk zmierzyliśmy, nie oceniliśmy. Głosy i muzyka są dla twoich uszu.
FAQ
Czy LTX-2 19B generuje audio?
Tak. Każdy klip ma ścieżkę AAC stereo 24 kHz tworzoną w tym samym przebiegu co obraz, także klipy, w których prompt w ogóle nie wspomina o dźwięku.
Jak napisać prompt do LTX-2 z dźwiękiem?
Opisz ujęcie w czterech do ośmiu zdań, a potem zakończ jednym zdaniem zaczynającym się od „Audio:”, które nazywa każdy dźwięk przez jego źródło, w kolejności, w jakiej się dzieje. Wypowiadane słowa umieść w cudzysłowie i trzymaj je krótko.
Które generatory wideo AI tworzą dźwięk i które są bez cenzury?
W SpicyAPI LTX-2 19B robi to zawsze, a Wan 3.0, Seedance 2.0 Fast i MiniMax H3 też generują dźwięk razem z klipem. Wszystkie cztery mają Freedom Score w naszym indeksie (od 70,7 do 96); różnią się ceną, jakością obrazu i tym, jak daleko sięgają.
Czy AI może zrobić wideo z pliku audio?
Nie tą drogą: LTX-2 19B przyjmuje prompt albo zdjęcie. Żeby twarz powiedziała kwestię, którą już masz, uruchom lip sync na gotowym klipie, jak w naszym poradniku o głosie i muzyce.
Jak długi może być klip z dźwiękiem?
Od 5 do 20 pełnych sekund w 480p, 720p lub 1080p. Nasz 20-sekundowy klip miał dźwięk przez cały czas, a 20-sekundowy klip 480p kosztuje 0,288 USD.
Czy mogę wyłączyć dźwięk?
Nie. Ścisz audio klipu w edytorze wideo albo usuń ścieżkę po pobraniu.
Dlaczego moje wideo AI ma losowe napisy?
Model czasem wypala w kadrze wymyślony tekst, a zapisanie „no subtitles” w naszych próbach go nie zatrzymało. Zmień seed, przytnij zajętą sekundę i pomiń w prompcie słowa o napisach.