Vous voulez un court clip à thème adulte qui sonne déjà comme quelque chose : de la pluie sur la fenêtre, une foule derrière le couple, une phrase dite doucement à la caméra. Bien des modèles vidéo sans censure vous rendent encore un fichier muet et laissent le son à un second outil.
LTX-2 19B produit l’image et une bande-son stéréo en une seule requête, sans filtre de contenu, à partir de 0,0144 $ par seconde de vidéo. Les 55 clips que nous avons générés les 5 et 6 octobre 2026 portaient tous une piste AAC stéréo à 24 kHz qui couvrait toute la durée de l’image, et le son suivait l’action : quand une hélice s’est mise à tourner au milieu d’un clip, la piste est restée proche du silence jusque-là. Ce que vous n’obtenez pas, c’est la régularité. Le volume a varié de plus de 30 LU entre des seeds d’un même prompt, et 5 de nos 15 clips contrôlés sont revenus avec des sous-titres inventés incrustés dans l’image.
Nous ne pouvons pas écouter comme vous : toute affirmation sonore ici est donc mesurée : volume au fil du temps, largeur stéréo, durée. Nous n’avons pas noté la qualité d’une voix ou d’une mélodie. Les clips intégrés se lisent avec le son : vous pouvez juger cette partie. Les modèles sont sur la page de la famille LTX-2 19B et la page de la famille LTX-2 19B LoRA ; chaque prompt reproduit ici est une scène avec des adultes habillés.
En un coup d’œil
| LTX-2 19B avec sa propre bande-son | |
|---|---|
| Points d’accès | Texte vers vidéo et image vers vidéo ; la version LoRA ajoute jusqu’à trois fichiers LoRA |
| Son | AAC stéréo à 24 kHz sur chaque clip, sans interrupteur pour le couper |
| Durée | 5 à 20 secondes entières ; sur 55 clips, les durées du son et de l’image concordaient à 0,0004 s près |
| Résolution | 480p (832 x 448), 720p (1280 x 704), 1080p (1920 x 1024) ; le 9:16 inverse les côtés ; l’image vers vidéo suit la photo |
| Prix, catalogue en direct | 0,0144 $, 0,0192 $ ou 0,0288 $ par seconde ; version LoRA 0,018 $, 0,024 $ ou 0,036 $ ; son inclus |
| Piloter le son | Une phrase de fin qui commence par « Audio: » |
| Volume mesuré | de −42,1 à −8,3 LUFS, médiane −13,2 ; aucun clip n’a dépassé −1,6 dBTP en crête |
| Ce qui se passe mal | Volume qui varie selon les seeds, sous-titres inventés, repères temporels qui arrivent en retard ou jamais |
| Contenu | Aucun filtre de contenu ; le texte vers vidéo a rendu 4 sondes de l’échelle sur 7, l’image vers vidéo 2 sur 7, aucun refus |
Comment la bande-son est produite
Lightricks décrit LTX-2 comme un seul modèle qui génère vidéo et audio synchronisés. En pratique :
- Une requête, un fichier. Pas de tâche audio séparée ni d’étape de synchronisation. Un clip de cinq secondes en 720p coûte 0,096 $ avec son son.
- L’entrée est du texte ou une photo, jamais de l’audio. Vous ne pouvez pas lui donner un fichier de voix à imiter.
- Le son ne peut pas être coupé. Pour un clip muet, baissez l’audio du clip dans l’éditeur vidéo du Studio ou retirez la piste après le téléchargement.
L’éditeur prévient aussi que le respect du prompt dépend beaucoup de la façon dont vous écrivez, et qu’un audio sans parole peut sortir de moindre qualité.
Écrire la ligne Audio
Le modèle lit l’image et le son dans le même prompt. Ce qui a marché pour nous suit le guide de prompts de LTX-2 de l’éditeur (quatre à huit phrases dans un seul paragraphe) et se termine par une phrase qui commence par « Audio: » et nomme chaque son par sa source. Un exemple publié, un ferry qui accoste de nuit :
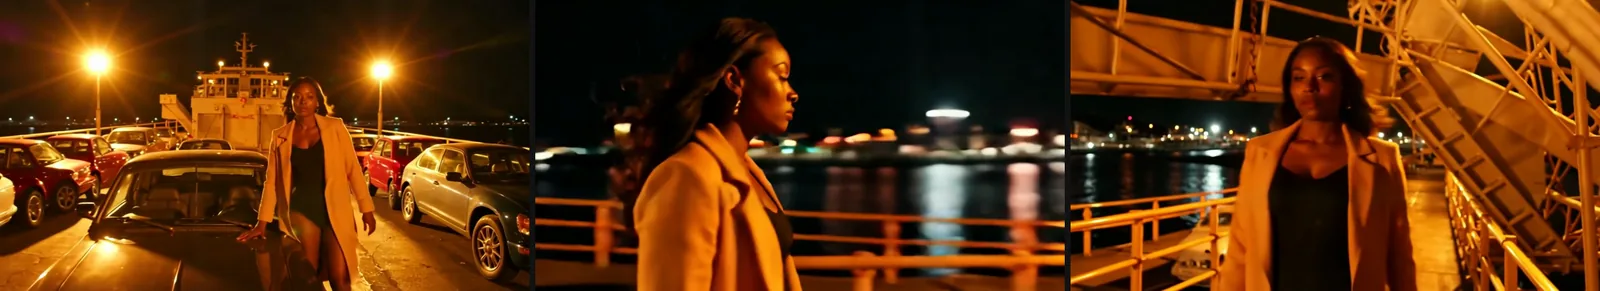
LTX-2 19B, texte vers vidéo, 16:9, 720p, 6 secondes, seed 510512. Sa bande-son est restée entre −12,7 et −10,5 dBFS à chaque demi-seconde.
The car deck of a night ferry as it docks. Sodium-vapour lamps turn everything orange and rows of parked cars glint. An adult Black woman in her early thirties in a long camel coat worn open over a fitted black bodysuit leans on the bonnet of a vintage car, her hair whipped by wind from the opening bow. The huge steel ramp lowers with a groan and slams onto the quay, showing the harbour lights beyond; she pushes off the car and walks toward the light, glancing back at the camera. Low-angle wide shot, slow dolly forward, sodium orange against black water, anamorphic flares. Audio: the deep thrum of the engines, chains rattling, the ramp groaning down and landing with a heavy metallic boom that echoes through the hold, then the ship horn.Cinq habitudes, tirées du guide de l’éditeur et de nos essais :
- Nommez la chose qui fait le son. « Chains rattling » pointe vers quelque chose dans le cadre ; « atmospheric audio » ne nomme aucune source.
- Listez les sons dans l’ordre où ils se produisent. L’exemple du train de nuit sur la page du modèle va des roues au vent, puis à une cloche de passage à niveau qui monte et s’éteint, puis à un klaxon loin devant.
- Laissez la tenue et les regards porter l’ambiance, et le son porter la pièce. Une bretelle qui glisse, un lent sourire, la pluie sur la vitre et un saxophone sur un disque suffisent pour une scène suggestive.
- Dites une courte phrase plutôt que de décrire des bruits. Mettez les mots entre guillemets et dites comment (« says softly »). Un fil de la communauté sur LTX-2 a signalé que des repères de bruits vocaux sortaient en rires étranges ; nous ne les avons pas testés, et une courte phrase est plus prévisible.
- En image vers vidéo, donnez du son à ce qui est dans la photo. La photo fixe la personne et le lieu ; décrivez ce qui se passe ensuite et à quoi cela ressemble au son. Un prompt qui décrit une autre pièce peut faire sortir le clip de votre photo.
| Type de repère | Formulation utilisée | Ce que les mesures ont montré |
|---|---|---|
| Un fond continu | « the deep thrum of the engines, chains rattling » | Niveau stable pendant tout le clip |
| Un événement dans le plan | « the engine coughing and catching into a roar » | Quasi-silence, puis le rugissement quand l’hélice tourne (2 seeds sur 2) |
| Une musique qui démarre sur repère | « near silence at first … then … a slow, smoky saxophone ballad starts » | Une seed a sauté à 5,0 s sur 6 ; l’autre n’a jamais changé |
| Une phrase parlée entre guillemets | says softly, "Stay. The rain isn't stopping tonight." | Deux fortes bouffées, quasi-silence entre elles |
| Une foule avec de la musique | « a string quartet playing a slow waltz, the murmur of a crowd » | Niveau stable ; une seed sur deux a incrusté des sous-titres |
| Des sons faibles et lointains | « a faint dance band drifting from a villa along the coast » | Même ligne, quatre seeds : de −10,9 à −42,1 LUFS |
Ce que 55 bandes-son ont montré
Nous avons mesuré 40 clips issus des essais d’exemples du 5 octobre (les deux points d’accès, modèle de base et version LoRA) et 15 clips contrôlés lancés le 6 octobre en texte vers vidéo de base. Le format et la durée viennent de ffprobe, le volume intégré et la crête vraie du mesureur EBU R128 de ffmpeg, les courbes ci-dessous du niveau de chaque tranche de 0,1 seconde, et la largeur stéréo d’une comparaison des deux canaux.
Le son est toujours là, aussi long que l’image
Les 55 clips avaient une piste AAC stéréo à 24 kHz, y compris deux dont le prompt ne mentionnait jamais le son. Les requêtes de cinq secondes ont rendu 5,042 secondes d’image et de son, celles de six secondes 6,042, celle de vingt secondes 20,042. Aucune piste ne s’est terminée avant l’image.
Le son suit l’action
Un pilote monte dans un avion à hélice sous la pluie ; le prompt demandait le sifflement du démarreur, le moteur qui prend et le souffle de l’hélice.
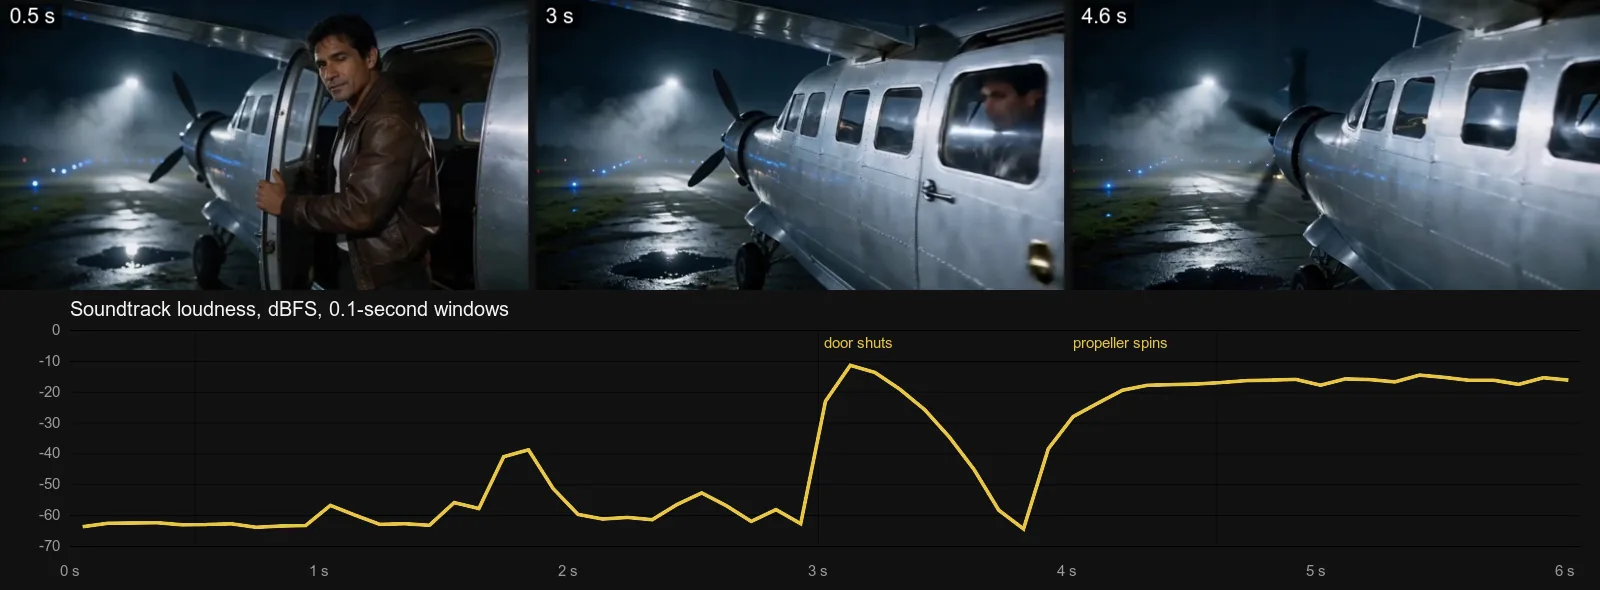
Image vers vidéo, 720p, 6 secondes, seed 510515. Proche de −60 dBFS pendant trois secondes, un saut quand la porte se ferme, puis environ −16 dBFS une fois l’hélice lancée. Une seconde seed est aussi restée silencieuse pendant trois secondes, puis a tenu un niveau fort et stable.
C’est la principale raison de générer le son avec l’image : la partie forte tombe là où l’image change.
Un repère temporel est une demande, pas une feuille de minutage
Demander d’abord le silence, puis de la musique, est moins fiable. Ce prompt de loft demandait un quasi-silence, puis une aiguille qui se pose et une ballade de saxophone.
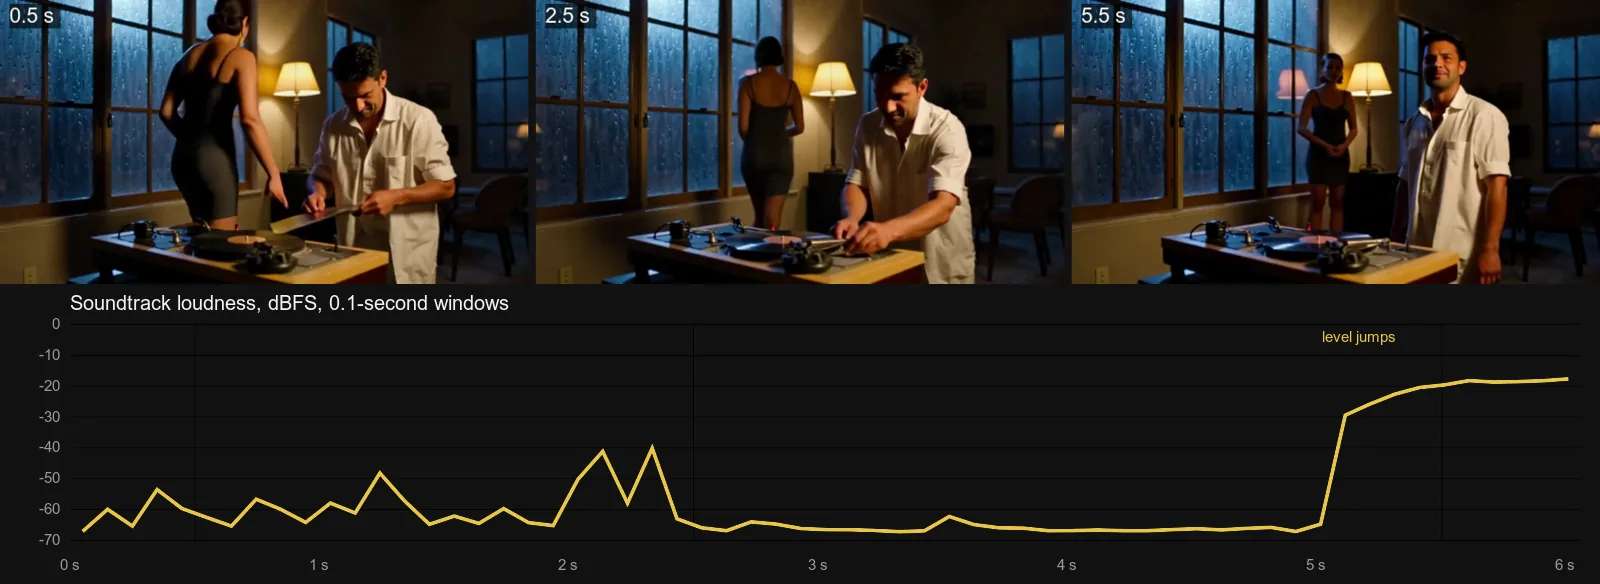
Texte vers vidéo, 480p, 6 secondes, seed 610611. Le niveau saute à 5,0 secondes sur 6.
La seconde seed est restée à environ −45 dBFS pendant les six secondes sans jamais changer. Si un son doit tomber sur une image précise, décrivez l’action qui le produit, comme le prompt de l’avion. S’il doit être exact, ajoutez-le après.
Le volume change beaucoup d’une seed à l’autre
C’est ce qui compte le plus quand vous assemblez des clips. Une scène de terrasse au clair de lune a été lancée quatre fois avec la même ligne Audio :
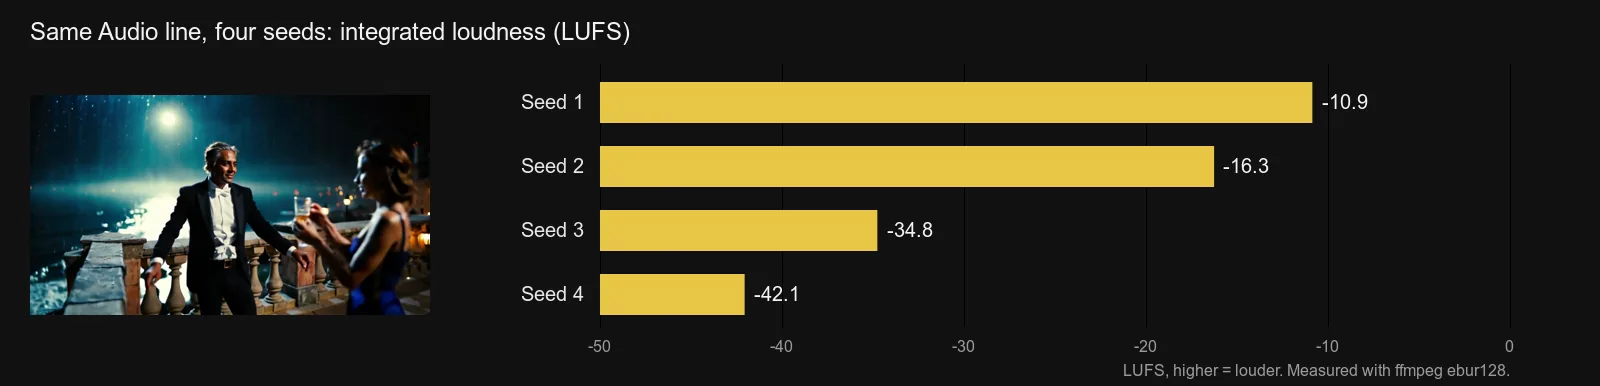
LTX-2 19B LoRA avec la LoRA de caméra Dolly Out, texte vers vidéo, 720p, 5 secondes, quatre seeds. La ligne Audio était identique ; les deux derniers prompts décrivaient aussi les deux tenues plus en détail.
Sur les 55 clips, le volume intégré allait de −42,1 à −8,3 LUFS avec une médiane de −13,2 ; 35 se situaient à moins de 3 LU de la médiane et 7 étaient plus faibles que −20. Aucun clip n’a dépassé −1,6 dBTP en crête : rien n’est donc revenu écrêté. La formulation ne décide pas cela à elle seule : les essais de terrasse les plus forts et les plus faibles avaient la même ligne Audio, mot pour mot.
Égalisez donc le volume avant d’assembler des clips, dans l’éditeur du Studio ou avec un normaliseur de volume. Six des 40 clips d’exemple se terminaient aussi au moins 15 dB sous leur moment le plus fort, tous issus d’essais avec une LoRA de caméra chargée : vérifiez donc les fins avant de couper.
Le « stéréo » est parfois mono
Chaque fichier a deux canaux, mais sur 14 des 55 les canaux étaient pratiquement identiques (corrélation de 0,99 ou plus), et sur 13 ils étaient nettement différents (sous 0,6). Les quatre clips construits autour d’une phrase parlée étaient en fait mono. Si la largeur compte, vérifiez au casque.
Omettre la ligne Audio donne quand même du son
Nous avons lancé deux fois une scène de bal masqué avec une ligne Audio (quatuor à cordes, foule, verres, son rire) et deux fois sans, sur les mêmes seeds.
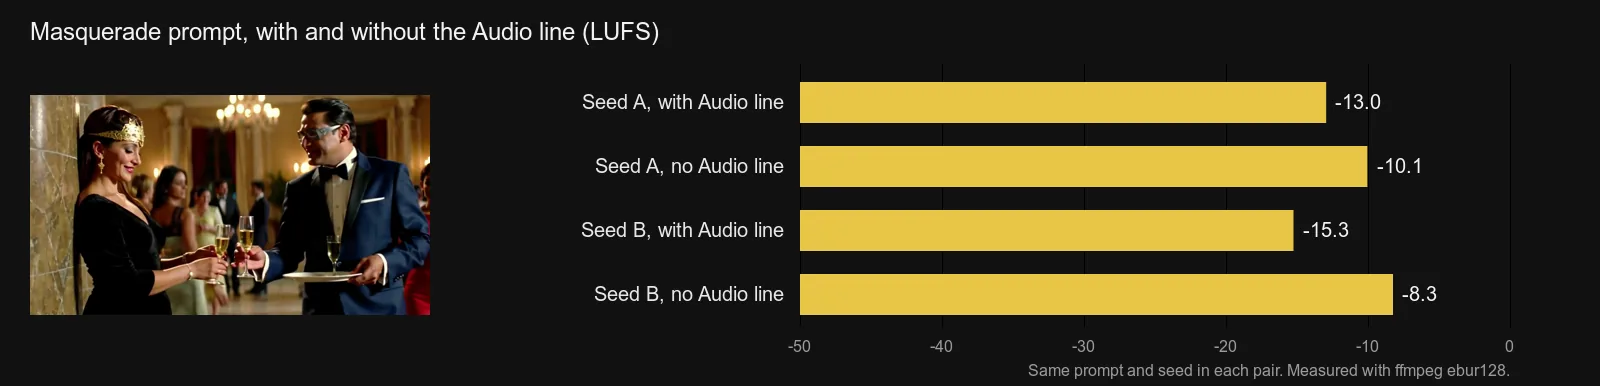
Texte vers vidéo, 720p, 5 secondes, seeds 610601 et 610602. Les deux clips sans ligne Audio étaient les plus forts.
Sans la ligne, vous obtenez quand même une piste ; vous ne choisissez simplement pas ce qu’elle contient. Gardez la ligne Audio même quand le son n’est pas l’enjeu.
Vingt secondes tenues
Les longs clips sont là où une passe de son séparée devient fastidieuse : nous avons donc lancé un clip de 20 secondes en 480p.
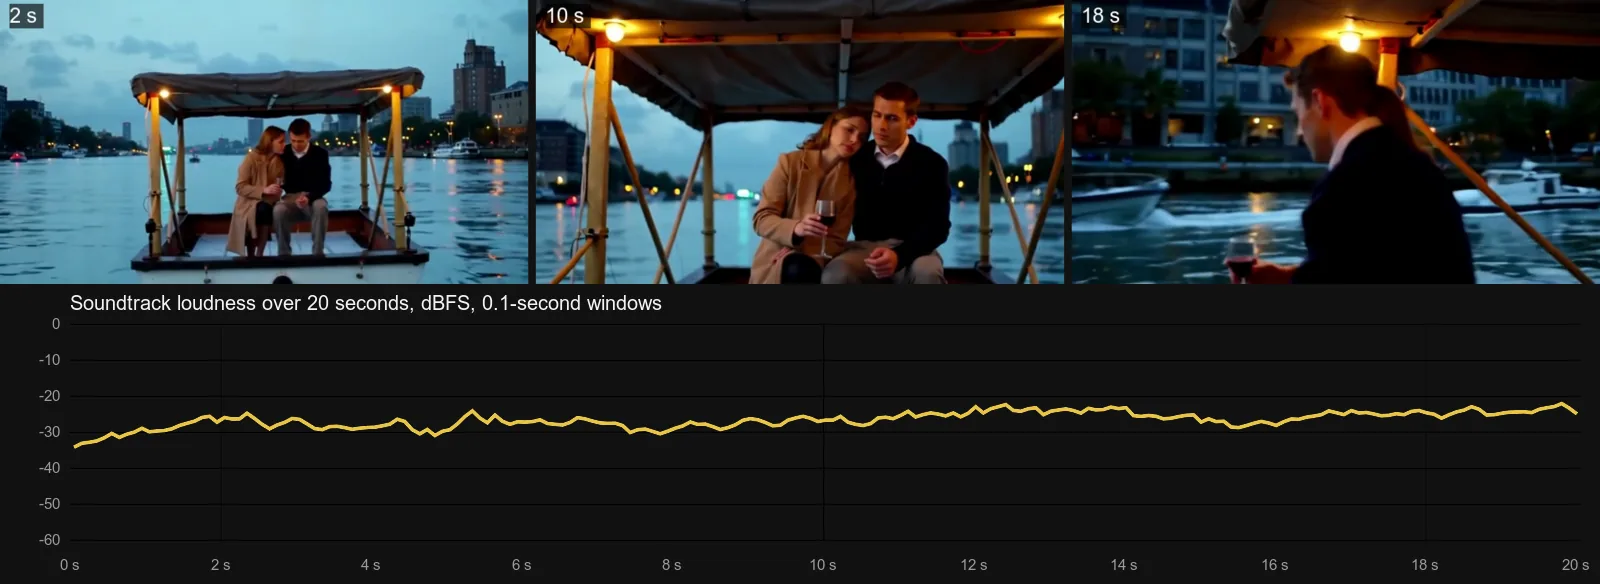
Texte vers vidéo, 16:9, 480p, 20 secondes, seed 610631. Chaque demi-seconde de son est restée entre −32,6 et −22,9 dBFS.
Vidéo : LTX-2 19B texte vers vidéo, 480p, 20 secondes, le clip de la péniche mesuré ci-dessus
Le son a tenu pendant les vingt secondes. C’est l’image qui a dérivé : le lent travelling avant a continué jusqu’à ce qu’elle soit en grande partie cachée derrière lui. Le clip a coûté 0,288 $. Le prompt tel que nous l’avons lancé, moins une expression « no on-screen text » que nous ne recommandons plus (voir la section suivante) :
A houseboat on a river at dusk in light rain. An adult couple in their forties, a woman in a long camel coat and a man in a navy wool sweater, sit close under the canvas awning at the stern sharing a blanket, watching the city lights come on along the bank. He refills her glass of red wine; she leans her head on his shoulder; later a tour boat glides past and its wake rocks them gently. Wide shot, slow push-in, blue dusk with warm string lights, film grain. Audio: rain pattering on the canvas, water lapping against the hull, a distant radio playing old jazz, the low rumble of the passing boat and its wake slapping the side.Lancer ce prompt sur LTX-2 19B texte vers vidéo →
Phrases parlées, et sous-titres que personne n’a demandés
Une courte phrase rend un clip suggestif plus personnel. Nous avons demandé à une femme en peignoir de soie crème de lever les yeux vers la caméra et de dire doucement : « Stay. The rain isn’t stopping tonight. »
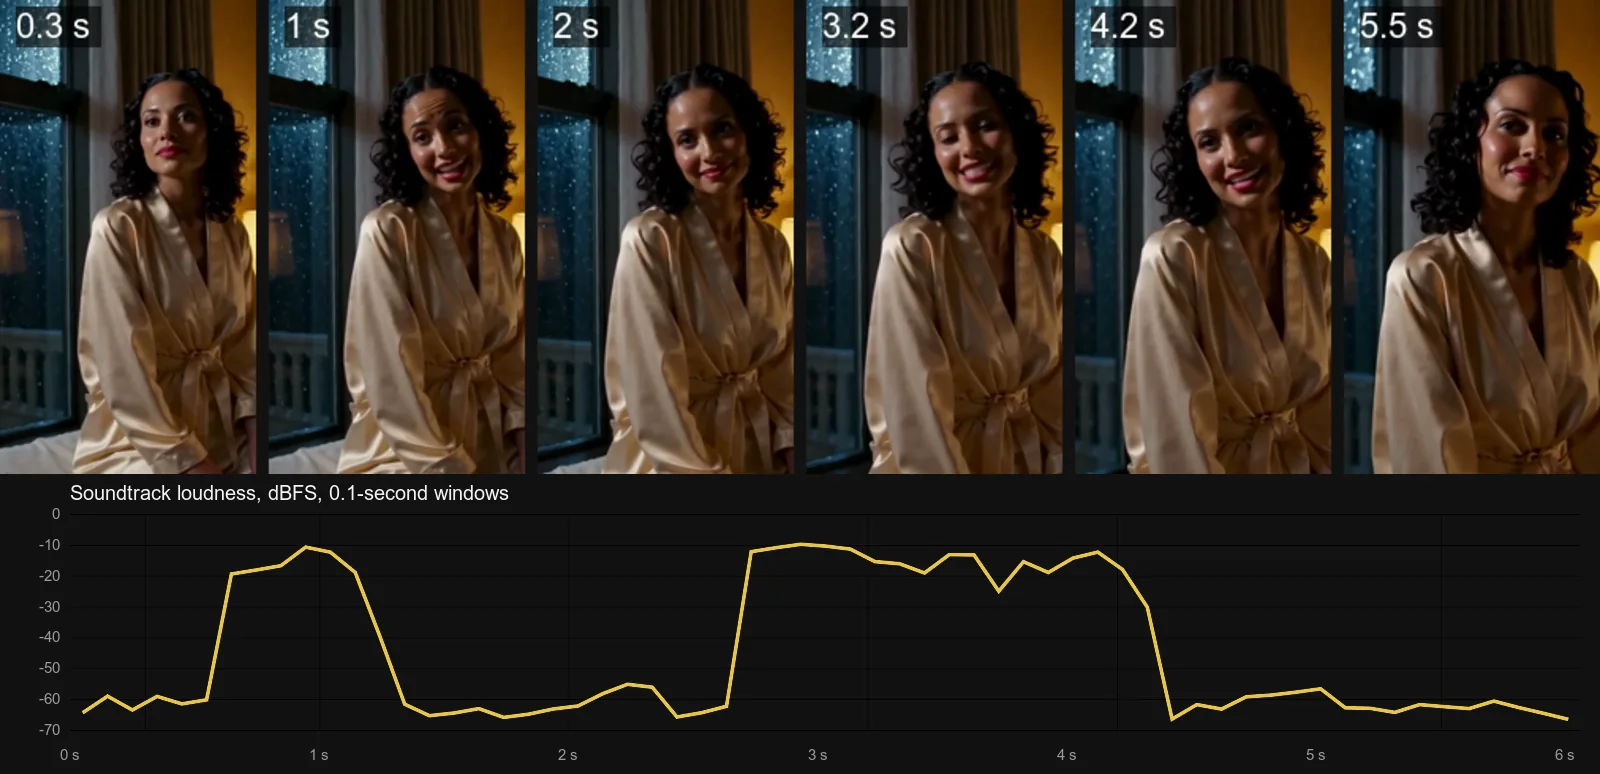
Texte vers vidéo, 9:16, 480p, 6 secondes, seed 610622, sans mot de sous-titre dans le prompt.
Deux passages forts correspondent à une phrase dite en deux parties, mais nous n’avons pas vérifié les mots : écoutez donc avant de vous y fier. Ce que la courbe montre, c’est que la « steady rain on the glass » demandée n’était pas en dessous : entre les bouffées et après, le niveau est tombé à environ −60 dBFS. Quand il y a une voix, elle peut prendre toute la piste.
La plus grosse surprise a été le texte dans l’image. Cinq de nos 15 clips contrôlés avaient des mots inventés incrustés :
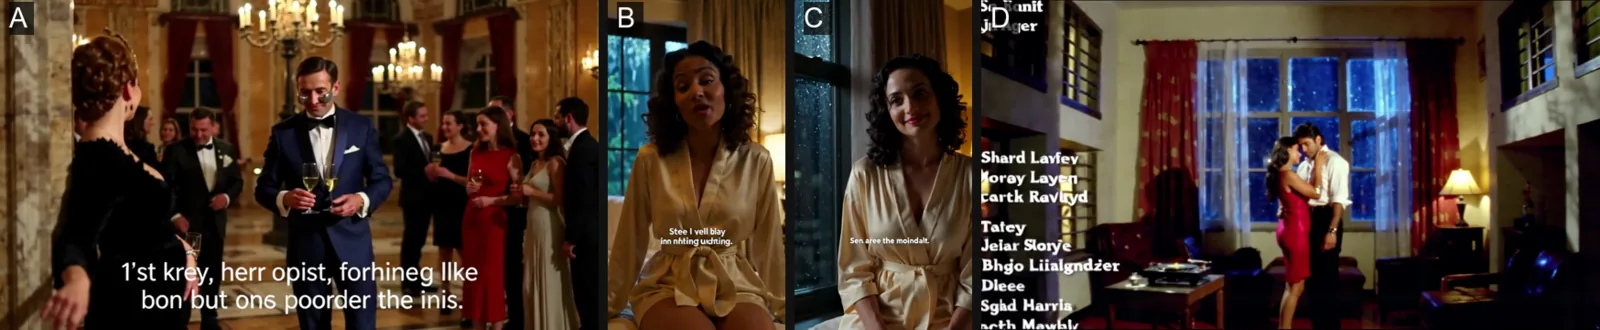
A : le prompt du bal masqué avec sa ligne Audio, seed 610601, premières 0,8 secondes seulement. B et C : le prompt de la phrase parlée avec « no subtitles, no captions, no on-screen text » ajouté, les deux seeds. D : un prompt en 1080p sur un couple qui danse sur un disque ; sa seconde seed montrait à la place des paroles à chanter.
Onze des 15 prompts se terminaient par « no subtitles » ou « no on-screen text », et les cinq clips sous-titrés en faisaient partie ; les quatre prompts sans cette expression sont revenus propres. Le même prompt de phrase parlée, aux deux mêmes seeds, était propre sans l’expression et sous-titré avec elle. Six des onze étaient propres aussi, et dans une série précédente deux clips de paysage avec « no subtitles » sont revenus propres : sur ce petit échantillon, l’expression n’a rien protégé et a peut-être provoqué le texte. Le texte est toujours du charabia, ce qui concorde avec la note de l’éditeur selon laquelle LTX-2 ne rend pas de texte lisible.
- Laissez les mots de sous-titre hors du prompt. Ils n’ont rien empêché dans nos essais.
- Vérifiez la première et la dernière seconde. Dans le clip A, le texte a duré 0,8 seconde ; couper le début l’a réglé.
- Changez de seed. La seconde seed du prompt du bal masqué était propre.
- Regardez à deux fois les prompts construits autour d’une chanson. Les deux clips en 1080p d’un couple qui danse sur un disque sont revenus avec des génériques ou des paroles.
Son intégré, ou modèle muet plus une passe de son ?
L’autre voie est un clip muet auquel on ajoute ensuite bruitages, voix et musique, comme dans nos guides sur l’ajout de voix et de musique à une vidéo IA NSFW et le flux de bruitages Foley. Un clip de cinq secondes, prix du catalogue en direct et scores de notre index :
| Voie | Son | Clip de 5 secondes | Score de liberté | Score au test en aveugle |
|---|---|---|---|---|
| LTX-2 19B, 720p | Toujours actif, stéréo | 0,096 $ | 76,1 | 47,5 |
| MiniMax H3, 768p | Généré avec le clip | 0,185 $ | 70,7 | 67,6 |
| Wan 3.0, 720p | Actif par défaut, peut être coupé | 0,45 $ | 96 | 70,9 |
| Seedance 2.0 Fast, 720p | Actif par défaut ; le couper ne baisse pas le tarif | 0,48 $ | 72,2 | 68,6 |
| HunyuanVideo 1.5, 720p, puis Foley v1 | Clip muet, bruitages ajoutés après | 0,24 $ + 0,006 $ | 88,1 | 57,7 |
La liberté est notre score de 0 à 100 qui mesure la part de l’échelle de contenu pour adultes qu’un modèle rend ; le test en aveugle note la qualité d’image, noms de modèles masqués. Les deux viennent de notre index en direct au 5 octobre 2026 ; pour la voie en deux étapes, ce sont ceux de HunyuanVideo.
- Choisissez LTX-2 19B pour de nombreux brouillons bon marché avec du son. C’est la voie la moins chère du tableau, et un clip de cinq secondes en 720p a pris de 14 à 25 secondes dans nos essais. Le compromis est l’image : son score au test en aveugle est le plus bas des cinq.
- Choisissez Wan 3.0 quand la qualité d’image et l’étendue sur le contenu pour adultes comptent plus que le prix. Il coûte plusieurs fois plus par seconde et vous donne quand même du son.
- Ajoutez le son après quand une phrase précise doit être dite ou que vous aimez déjà un clip muet. Les bruitages Foley coûtent 0,0012 $ par seconde.
La limite structurelle de la voie intégrée : le son est cuit dans le rendu : un mot faux oblige donc à repayer l’image.
Jusqu’où cela va
LTX-2 19B ne filtre rien sur le prompt ni sur le résultat. Sur notre échelle de sept sondes (L1 Suggestif, lingerie ou une bretelle qui glisse ; L2 Partiel ; L3 Fort ; L4 Intense, une scène intime entre deux adultes ; L5 Extrême, contrainte consentie entre adultes ou gore cinématographique), le texte vers vidéo a rendu L1, L2, L3 et la sonde de contrainte comme écrits, et a atténué L4, la sonde de gore et la sonde avec un homme dans le cadre. L’image vers vidéo a rendu L1 et L3 et a atténué le reste. Rien n’a été refusé. Les résultats complets sont dans la critique de LTX-2 19B ; les mouvements de caméra et les fichiers LoRA sont dans notre guide de LTX-2 19B LoRA. L’échelle n’avait aucun repère propre au son, et nous ne reproduisons pas les prompts des sondes.
Limites
- Le volume est imprévisible. Égalisez chaque clip avant de les assembler.
- Des sous-titres peuvent apparaître, avec ou sans expression « no subtitles ». Vérifiez la première et la dernière seconde de chaque clip retenu.
- Les repères temporels dérivent ou disparaissent. Liez les sons à des actions dans le cadre.
- Pas d’interrupteur audio, pas d’entrée audio.
- Les voix peuvent tout prendre. Dans notre clip à phrase parlée, la pluie demandée manquait.
- La largeur stéréo varie. Certains clips sont en fait mono.
- L’image est en retrait par rapport à des modèles plus chers. Score au test en aveugle de 47,5.
- Nous avons mesuré le son ; nous ne l’avons pas jugé. Les voix et la musique, c’est pour vos oreilles.
FAQ
LTX-2 19B génère-t-il de l’audio ?
Oui. Chaque clip a une piste AAC stéréo à 24 kHz produite dans la même passe que l’image, y compris les clips dont le prompt ne mentionne jamais le son.
Comment écrire un prompt pour LTX-2 avec du son ?
Décrivez le plan en quatre à huit phrases, puis terminez par une phrase qui commence par « Audio: » et nomme chaque son par sa source, dans l’ordre où il se produit. Mettez les paroles entre guillemets et gardez-les courtes.
Quels générateurs de vidéo IA font du son, et lesquels sont sans censure ?
Sur SpicyAPI, LTX-2 19B le fait toujours, et Wan 3.0, Seedance 2.0 Fast et MiniMax H3 génèrent aussi du son avec le clip. Les quatre ont un score de liberté dans notre index (de 70,7 à 96) ; ils diffèrent par le prix, la qualité d’image et la distance qu’ils parcourent.
L’IA peut-elle faire une vidéo à partir d’un fichier audio ?
Pas par cette voie : LTX-2 19B prend un prompt ou une photo. Pour faire dire à un visage une phrase que vous avez déjà, lancez la synchronisation labiale sur un clip terminé, comme dans notre guide voix et musique.
Quelle peut être la durée d’un clip avec son ?
De 5 à 20 secondes entières en 480p, 720p ou 1080p. Notre clip de 20 secondes avait du son sur toute la durée, et un clip de 20 secondes en 480p coûte 0,288 $.
Puis-je couper le son ?
Non. Baissez l’audio du clip dans l’éditeur vidéo ou retirez la piste après le téléchargement.
Pourquoi ma vidéo IA a-t-elle des sous-titres aléatoires ?
Le modèle incruste parfois du texte inventé dans l’image, et écrire « no subtitles » ne l’a pas empêché dans nos essais. Changez de seed, coupez la seconde touchée, et laissez les mots de sous-titre hors du prompt.