Você quer um clipe curto de tema adulto que já soe como alguma coisa: chuva na janela, uma multidão atrás do casal, uma frase dita baixinho para a câmera. Muitos modelos de vídeo sem censura ainda entregam um arquivo silencioso e deixam o som para uma segunda ferramenta.
O LTX-2 19B faz a imagem e uma trilha sonora estéreo em uma única requisição, sem filtro de conteúdo, a partir de $0.0144 por segundo de vídeo. Todos os 55 clipes que geramos em 5 e 6 de outubro de 2026 vieram com uma faixa AAC estéreo a 24 kHz que durava o clipe inteiro, e o som acompanhava a ação: quando uma hélice começou a girar no meio de um clipe, a faixa ficou perto do silêncio até aquele momento. O que não se tem é consistência. O volume oscilou mais de 30 LU entre seeds de um mesmo prompt, e 5 dos nossos 15 clipes controlados voltaram com legendas inventadas gravadas no quadro.
Não conseguimos ouvir como você, então toda afirmação sobre áudio aqui é medida: volume ao longo do tempo, largura estéreo, duração. Não avaliamos se uma voz ou uma melodia soa bem. Os clipes incorporados tocam com som, então essa parte fica por sua conta. Os modelos estão na página da família LTX-2 19B e na página da família LTX-2 19B LoRA; todo prompt impresso aqui é uma cena com adultos vestidos.
Em resumo
| LTX-2 19B com trilha sonora própria | |
|---|---|
| Endpoints | Texto para vídeo e imagem para vídeo; a versão LoRA acrescenta até três arquivos LoRA |
| Som | AAC estéreo a 24 kHz em todo clipe, sem chave para desligar |
| Duração | De 5 a 20 segundos inteiros; em 55 clipes, as durações de som e imagem coincidiram em até 0,0004 s |
| Resolução | 480p (832 x 448), 720p (1280 x 704), 1080p (1920 x 1024); 9:16 troca os lados; imagem para vídeo segue a foto |
| Preço, catálogo ao vivo | $0.0144, $0.0192 ou $0.0288 por segundo; versão LoRA $0.018, $0.024 ou $0.036; som incluído |
| Como orientar o som | Uma frase final que começa com "Audio:" |
| Volume que medimos | de −42,1 a −8,3 LUFS, mediana −13,2; nenhum clipe passou de −1,6 dBTP |
| O que dá errado | Oscilação de volume entre seeds, legendas inventadas, sinais cronometrados que chegam tarde ou nunca |
| Conteúdo | Sem filtro de conteúdo; texto para vídeo entregou 4 de 7 sondas da escada, imagem para vídeo 2 de 7, nenhuma recusada |
Como a trilha sonora é feita
A Lightricks descreve o LTX-2 como um único modelo que gera vídeo e áudio sincronizados. Na prática:
- Uma requisição, um arquivo. Sem tarefa de áudio separada e sem etapa de sincronização. Um clipe de cinco segundos em 720p custa $0.096 com o seu som.
- A entrada é texto ou uma foto, nunca áudio. Você não pode dar um arquivo de voz para ele acompanhar.
- O som não pode ser desligado. Para um clipe silencioso, abaixe o áudio do clipe no editor de vídeo do Studio ou retire a faixa depois do download.
Quem publica também avisa que o seguimento do prompt depende muito de como você escreve e que áudio sem fala pode sair com qualidade menor.
Escreva a linha Audio
O modelo lê imagem e som no mesmo prompt. O que funcionou para nós segue o guia de prompts do LTX-2, de quem publica (de quatro a oito frases em um parágrafo), e termina com uma frase que começa com "Audio:" e nomeia cada som pela sua fonte. Um exemplo publicado, uma balsa atracando à noite:
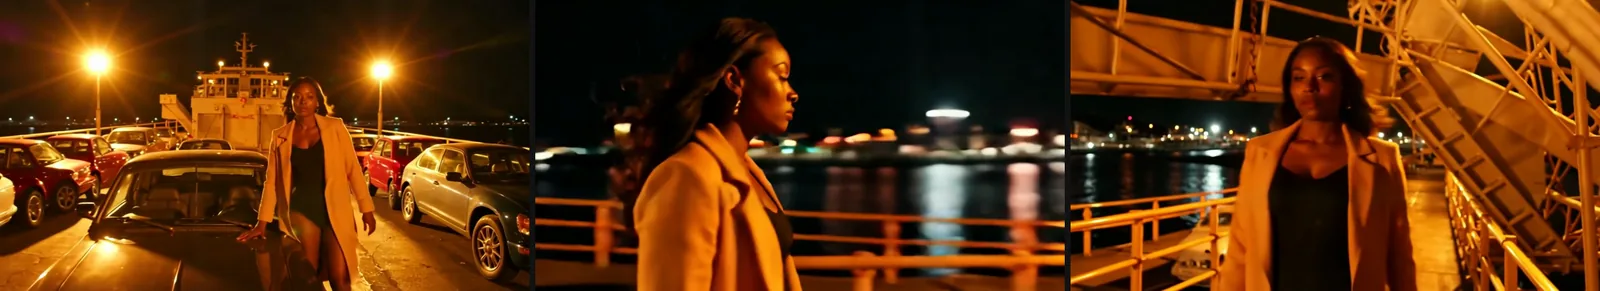
LTX-2 19B, texto para vídeo, 16:9, 720p, 6 segundos, seed 510512. A trilha ficou entre −12,7 e −10,5 dBFS em todos os meios segundos.
The car deck of a night ferry as it docks. Sodium-vapour lamps turn everything orange and rows of parked cars glint. An adult Black woman in her early thirties in a long camel coat worn open over a fitted black bodysuit leans on the bonnet of a vintage car, her hair whipped by wind from the opening bow. The huge steel ramp lowers with a groan and slams onto the quay, showing the harbour lights beyond; she pushes off the car and walks toward the light, glancing back at the camera. Low-angle wide shot, slow dolly forward, sodium orange against black water, anamorphic flares. Audio: the deep thrum of the engines, chains rattling, the ramp groaning down and landing with a heavy metallic boom that echoes through the hold, then the ship horn.Cinco hábitos, do guia de quem publica e das nossas execuções:
- Nomeie o que produz o som. "Chains rattling" aponta para algo no quadro; "atmospheric audio" não nomeia fonte nenhuma.
- Liste os sons na ordem em que acontecem. O exemplo do trem noturno na página do modelo vai de rodas, vento, um sino de passagem de nível que sobe e some, e então uma buzina longe, à frente.
- Deixe o figurino e os olhares levarem o clima, e o som levar o ambiente. Uma alça escorregando, um sorriso lento, chuva no vidro e um saxofone em um disco bastam para uma cena sugestiva.
- Diga uma frase curta em vez de descrever ruídos. Ponha as palavras entre aspas e diga como ("says softly"). Um tópico da comunidade sobre o LTX-2 relatou que sinais de ruído vocal saíam como risadas estranhas; não testamos isso, e uma frase curta é mais previsível.
- Em imagem para vídeo, dê som ao que está na foto. A foto fixa a pessoa e o lugar; descreva o que acontece a seguir e como soa. Um prompt que descreve outro ambiente pode fazer o clipe se afastar da sua foto.
| Tipo de sinal | Formulação que usamos | O que as medições mostraram |
|---|---|---|
| Uma base constante | "the deep thrum of the engines, chains rattling" | Nível estável durante o clipe todo |
| Um evento no plano | "the engine coughing and catching into a roar" | Quase silêncio e depois o rugido quando a hélice gira (2 de 2 seeds) |
| Música começando no momento certo | "near silence at first … then … a slow, smoky saxophone ballad starts" | Um seed saltou aos 5,0 s de 6; o outro nunca mudou |
| Uma fala entre aspas | says softly, "Stay. The rain isn't stopping tonight." | Duas rajadas altas, quase silêncio entre elas |
| Uma multidão com música | "a string quartet playing a slow waltz, the murmur of a crowd" | Nível estável; um de dois seeds gravou legendas |
| Sons fracos e distantes | "a faint dance band drifting from a villa along the coast" | Mesma linha, quatro seeds: de −10,9 a −42,1 LUFS |
O que 55 trilhas sonoras mostraram
Medimos 40 clipes das execuções de exemplo de 5 de outubro (os dois endpoints, modelo base e versão LoRA) e 15 clipes controlados que rodamos em 6 de outubro com o texto para vídeo base. Formato e duração vieram do ffprobe, o volume integrado e o pico verdadeiro do medidor EBU R128 do ffmpeg, as curvas abaixo do nível de cada fatia de 0,1 segundo e a largura estéreo da comparação entre os dois canais.
O som está sempre lá, com a duração da imagem
Os 55 clipes tinham uma faixa AAC estéreo a 24 kHz, inclusive dois cujo prompt nunca mencionava som. Requisições de cinco segundos devolveram 5,042 segundos de imagem e de som, as de seis segundos 6,042, a de vinte segundos 20,042. Nenhuma faixa terminou antes da imagem.
O som acompanha a ação
Um piloto sobe em um avião de hélice na chuva; o prompt pedia o zumbido do motor de partida, o motor pegando e o vento da hélice.
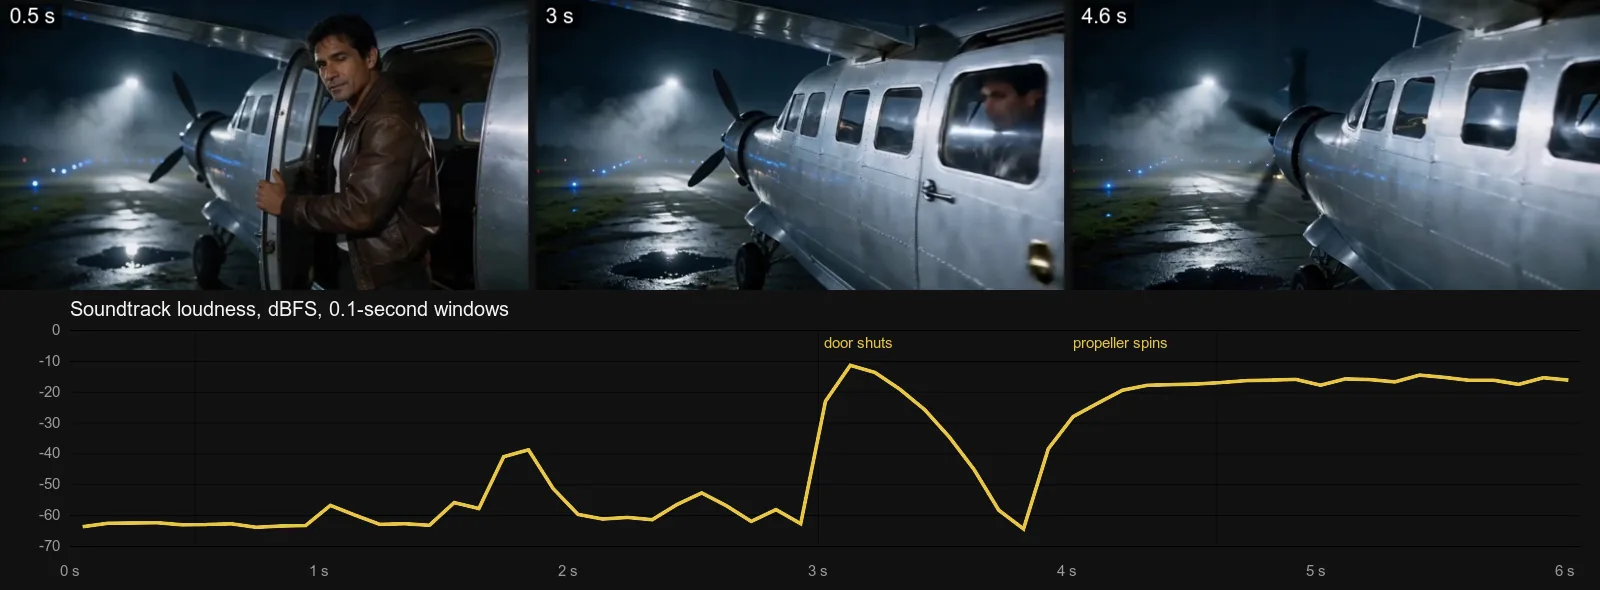
Imagem para vídeo, 720p, 6 segundos, seed 510515. Perto de −60 dBFS por três segundos, um salto quando a porta fecha e depois cerca de −16 dBFS quando a hélice gira. Um segundo seed também ficou em silêncio por três segundos e depois manteve um nível alto e estável.
Essa é a principal razão para gerar o som junto com a imagem: a parte alta cai onde a imagem muda.
Um sinal cronometrado é um pedido, não uma folha de marcação
Pedir silêncio primeiro e música depois é menos confiável. Este prompt de loft pedia quase silêncio, depois uma agulha pousando e uma balada de saxofone.
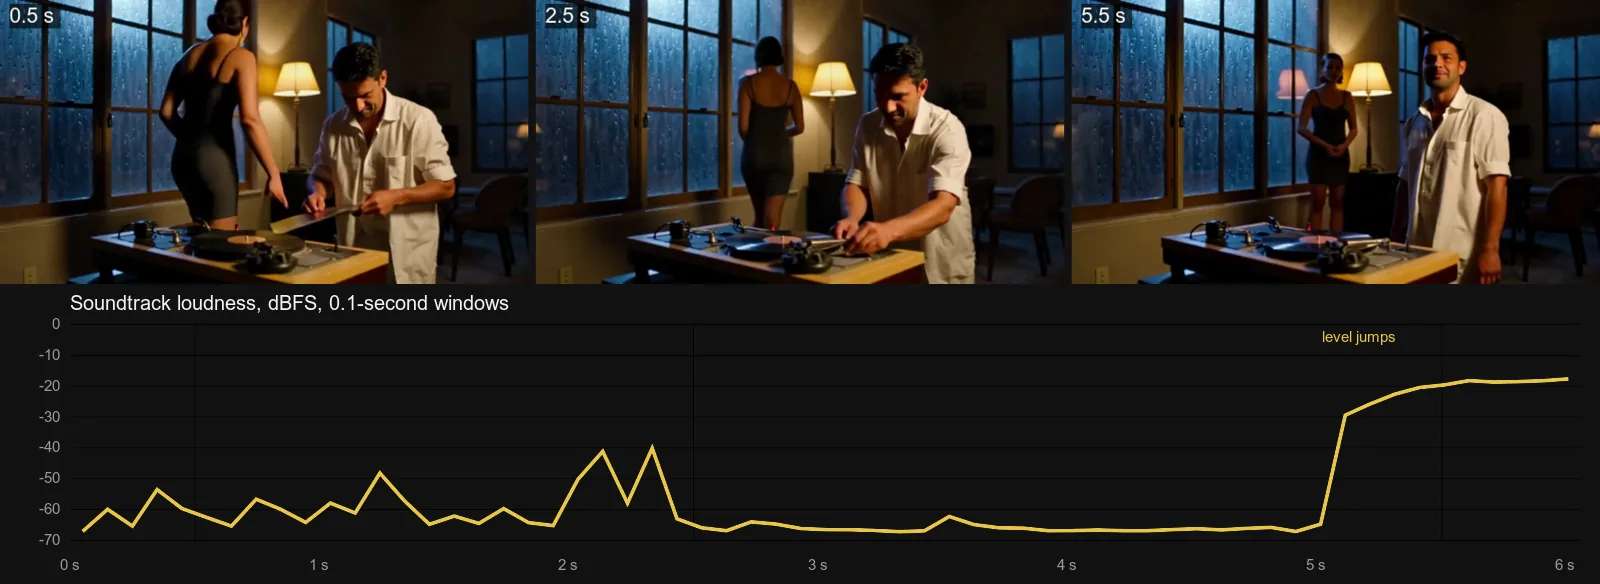
Texto para vídeo, 480p, 6 segundos, seed 610611. O nível salta aos 5,0 segundos de 6.
O segundo seed ficou em cerca de −45 dBFS pelos seis segundos e nunca mudou. Se um som precisa cair em um quadro específico, descreva a ação que o produz, como fez o prompt do avião. Se precisa ser exato, acrescente-o depois.
O volume muda muito de seed para seed
Isso importa mais quando você junta clipes. Uma cena em um terraço ao luar rodou quatro vezes com a mesma linha Audio:
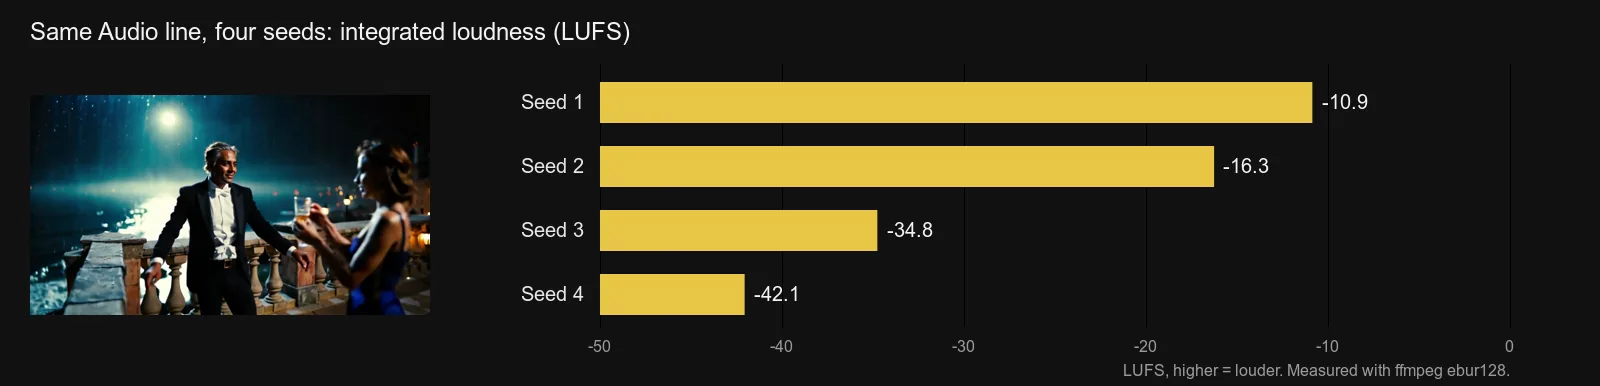
LTX-2 19B LoRA com o LoRA de câmera Dolly Out, texto para vídeo, 720p, 5 segundos, quatro seeds. A linha Audio era idêntica; os dois últimos prompts também descreviam os dois figurinos com mais detalhe.
Nos 55 clipes, o volume integrado foi de −42,1 a −8,3 LUFS, com mediana de −13,2; 35 ficaram a até 3 LU da mediana e 7 ficaram abaixo de −20. Nenhum clipe passou de −1,6 dBTP, então nada voltou saturado. A redação não decide isso sozinha: as execuções mais alta e mais baixa do terraço tinham a mesma linha Audio, palavra por palavra.
Portanto, iguale o volume antes de juntar clipes, no editor do Studio ou com um normalizador de volume. Seis dos 40 clipes de exemplo também terminaram pelo menos 15 dB abaixo do momento mais alto, todos de execuções com um LoRA de câmera carregado; por isso, confira os finais antes de cortar.
"Estéreo" às vezes é mono
Todo arquivo tem dois canais, mas em 14 dos 55 os canais eram praticamente idênticos (correlação de 0,99 ou mais) e em 13 eram claramente diferentes (abaixo de 0,6). Os quatro clipes construídos em torno de uma fala eram, na prática, mono. Se a largura importa, confira com fones de ouvido.
Deixar a linha Audio de fora ainda dá som
Rodamos uma cena de baile de máscaras duas vezes com uma linha Audio (quarteto de cordas, multidão, taças, a risada dela) e duas vezes sem, nos mesmos seeds.
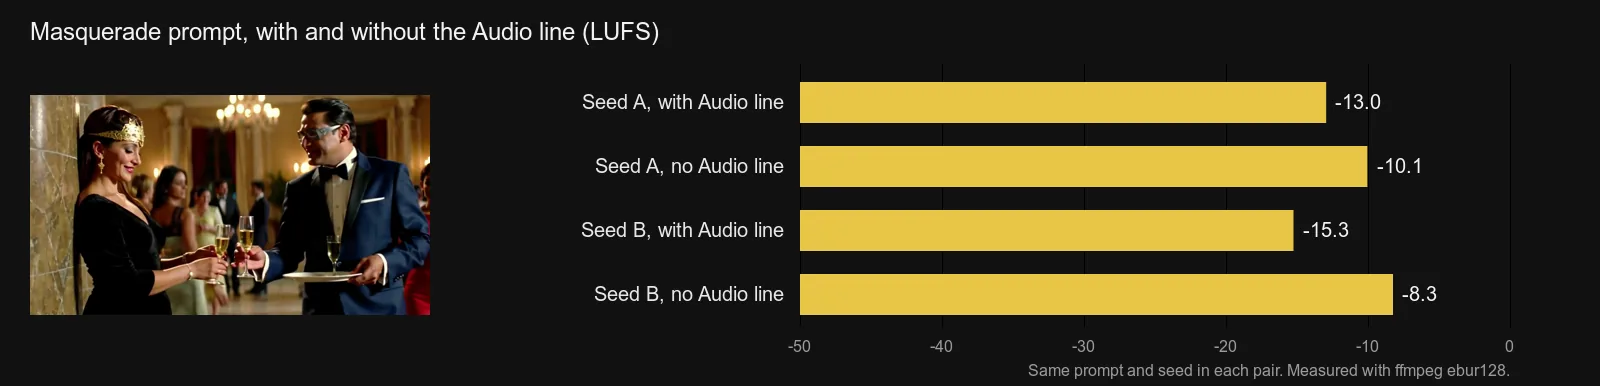
Texto para vídeo, 720p, 5 segundos, seeds 610601 e 610602. Os dois clipes sem linha Audio foram os mais altos.
Sem a linha você ainda recebe uma faixa; só não escolhe o que há nela. Mantenha a linha Audio mesmo quando o som não é o ponto.
Vinte segundos se sustentaram
Clipes longos são onde uma passada de som separada fica tediosa, então rodamos um clipe de 20 segundos em 480p.
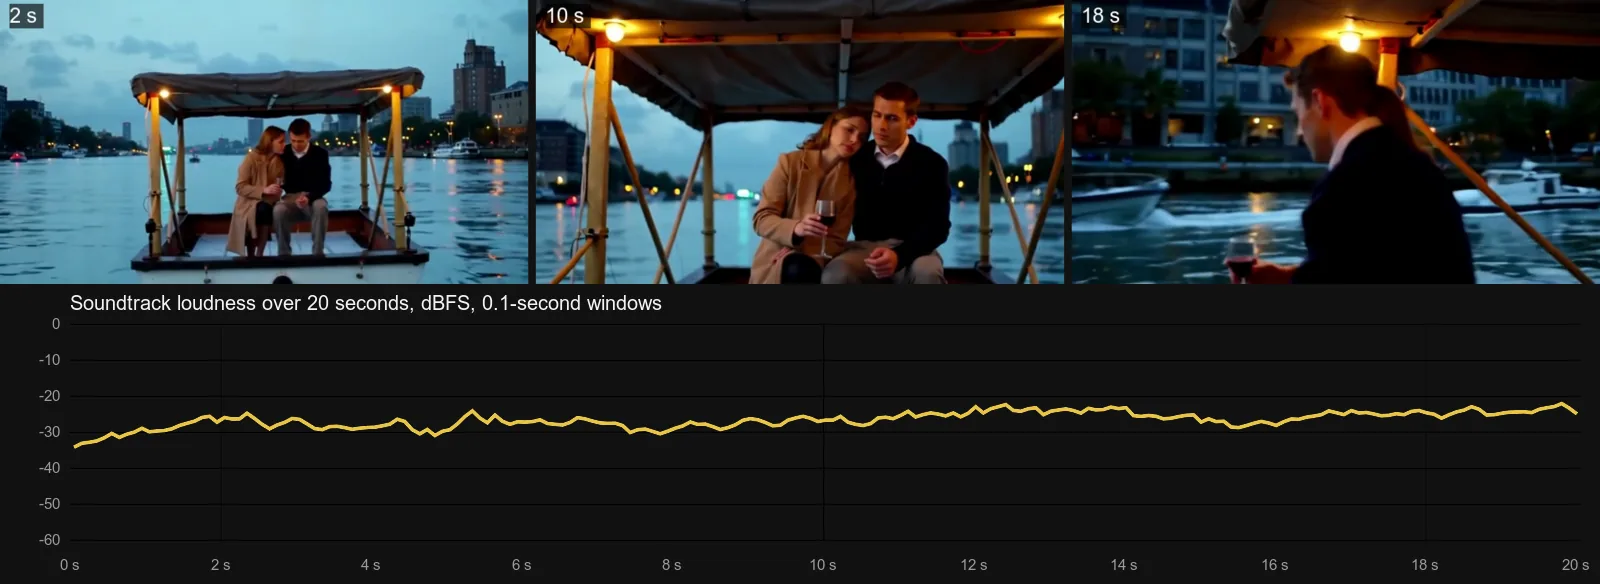
Texto para vídeo, 16:9, 480p, 20 segundos, seed 610631. Todo meio segundo de som ficou entre −32,6 e −22,9 dBFS.
Vídeo: LTX-2 19B texto para vídeo, 480p, 20 segundos, o clipe da casa-barco medido acima
O som se manteve pelos vinte segundos. A imagem foi quem se desviou: a aproximação lenta continuou até ela ficar quase toda escondida atrás dele. O clipe custou $0.288. O prompt como o rodamos, menos uma expressão "no on-screen text" que já não recomendamos (veja a próxima seção):
A houseboat on a river at dusk in light rain. An adult couple in their forties, a woman in a long camel coat and a man in a navy wool sweater, sit close under the canvas awning at the stern sharing a blanket, watching the city lights come on along the bank. He refills her glass of red wine; she leans her head on his shoulder; later a tour boat glides past and its wake rocks them gently. Wide shot, slow push-in, blue dusk with warm string lights, film grain. Audio: rain pattering on the canvas, water lapping against the hull, a distant radio playing old jazz, the low rumble of the passing boat and its wake slapping the side.Rode este prompt no texto para vídeo do LTX-2 19B →
Falas e as legendas que ninguém pediu
Uma frase curta faz um clipe sugestivo parecer pessoal. Pedimos que uma mulher de roupão de seda creme olhasse para a câmera e dissesse, baixinho, "Stay. The rain isn't stopping tonight."
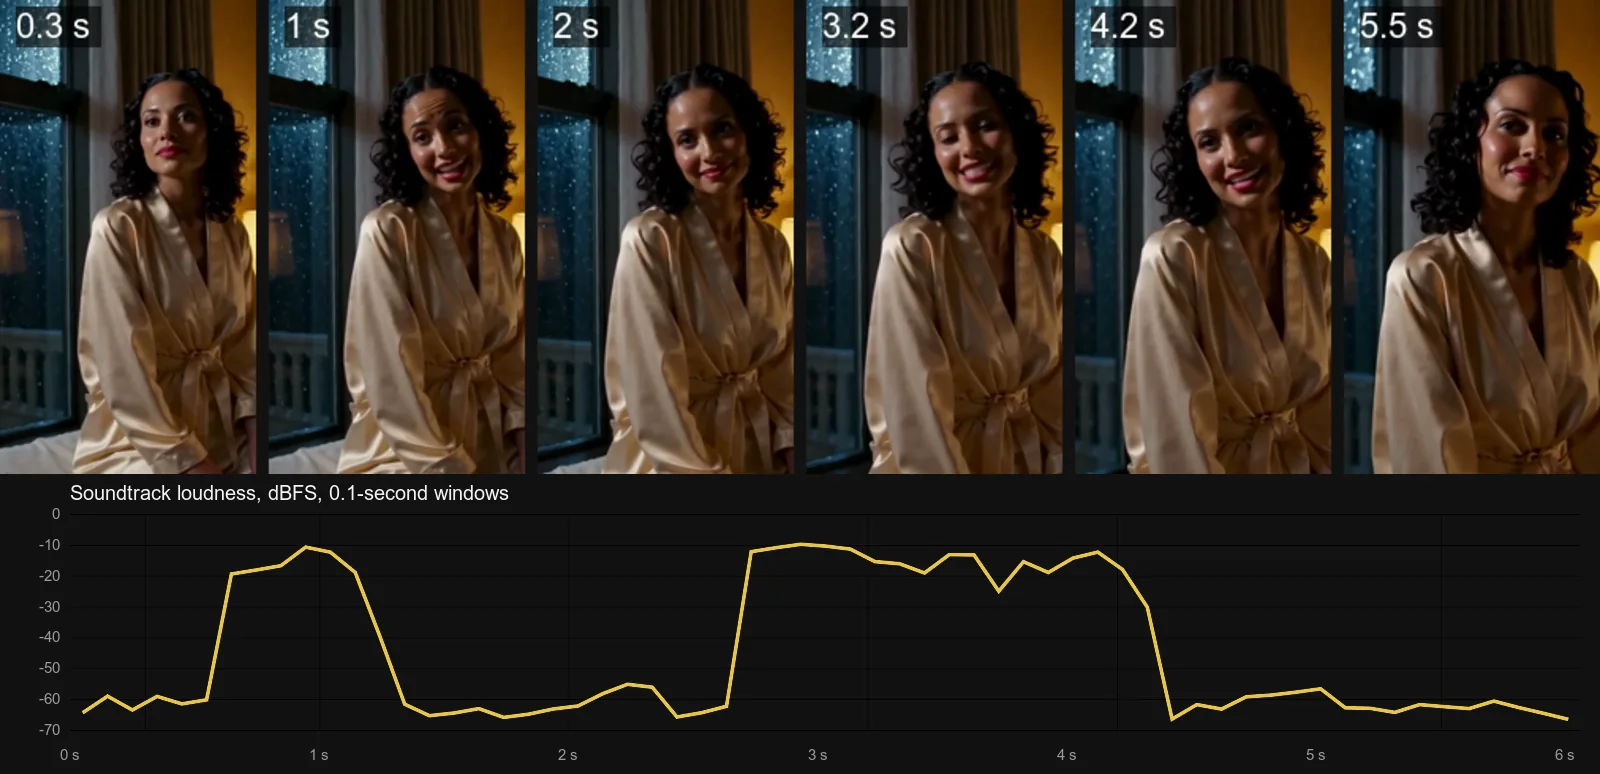
Texto para vídeo, 9:16, 480p, 6 segundos, seed 610622, sem palavras de legenda no prompt.
Dois trechos altos combinam com uma frase falada em duas partes, mas não conferimos as palavras, então ouça antes de confiar. O que a curva mostra é que a "steady rain on the glass" que pedimos não estava por baixo: entre as rajadas e depois delas o nível caiu para cerca de −60 dBFS. Quando há uma voz, ela pode tomar conta da faixa.
A surpresa maior foi o texto na imagem. Cinco dos nossos 15 clipes controlados vieram com palavras inventadas gravadas:
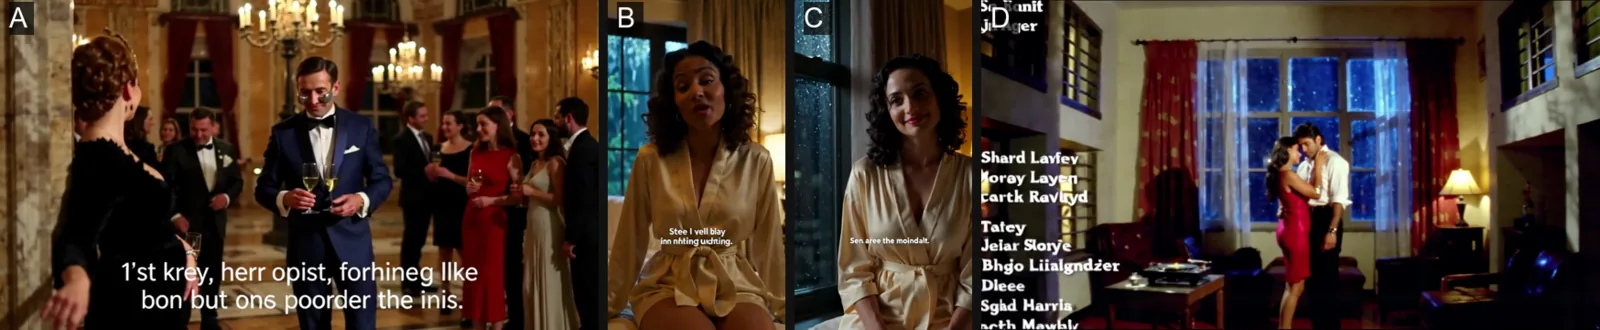
A: prompt do baile de máscaras com a sua linha Audio, seed 610601, só os primeiros 0,8 segundo. B e C: o prompt da fala com "no subtitles, no captions, no on-screen text" acrescentado, os dois seeds. D: um prompt de 1080p sobre um casal dançando ao som de um disco; o segundo seed mostrou letras para cantar junto.
Onze dos 15 prompts terminavam com "no subtitles" ou "no on-screen text", e todos os cinco clipes com legenda estavam entre eles; os quatro prompts sem essa expressão voltaram limpos. O mesmo prompt de fala, nos mesmos dois seeds, saiu limpo sem a expressão e com legenda com ela. Seis dos onze também saíram limpos e, em um lote anterior, dois clipes de paisagem com "no subtitles" saíram limpos; portanto, nessa amostra pequena a expressão não protegeu nada e pode ter provocado o texto. O texto é sempre ininteligível, o que combina com a observação de quem publica de que o LTX-2 não renderiza texto legível.
- Deixe palavras de legenda fora do prompt. Elas não preveniram nada nas nossas execuções.
- Confira o primeiro e o último segundo. No clipe A o texto durou 0,8 segundo; cortar o começo resolveu.
- Troque o seed. O segundo seed do prompt do baile de máscaras saiu limpo.
- Olhe duas vezes os prompts construídos em torno de uma música. Os dois clipes em 1080p de um casal dançando ao som de um disco voltaram com créditos ou letras.
Som embutido ou um modelo silencioso mais uma passada de som?
A outra rota é um clipe silencioso com efeitos, voz e música acrescentados depois, como nos nossos guias sobre como adicionar voz e música a um vídeo NSFW de IA e o fluxo de efeitos sonoros Foley. Um clipe de cinco segundos, preços do catálogo ao vivo e notas do nosso índice:
| Rota | Som | Clipe de 5 segundos | Freedom Score | Nota do teste às cegas |
|---|---|---|---|---|
| LTX-2 19B, 720p | Sempre ligado, estéreo | $0.096 | 76,1 | 47,5 |
| MiniMax H3, 768p | Gerado com o clipe | $0.185 | 70,7 | 67,6 |
| Wan 3.0, 720p | Ligado por padrão, pode ser desligado | $0.45 | 96 | 70,9 |
| Seedance 2.0 Fast, 720p | Ligado por padrão; desligar não baixa a tarifa | $0.48 | 72,2 | 68,6 |
| HunyuanVideo 1.5, 720p, depois Foley v1 | Clipe silencioso, efeitos acrescentados depois | $0.24 + $0.006 | 88,1 | 57,7 |
Freedom é a nossa nota de 0 a 100 de quanto da escada de conteúdo adulto um modelo entrega; o teste às cegas avalia a qualidade da imagem com os nomes dos modelos ocultos. As duas vêm do nosso índice ao vivo em 5 de outubro de 2026; na rota de duas etapas, são as do HunyuanVideo.
- Escolha o LTX-2 19B para muitos rascunhos baratos com som. É a rota mais barata da tabela, e um clipe de cinco segundos em 720p levou de 14 a 25 segundos nas nossas execuções. A troca é a imagem: a nota dele no teste às cegas é a mais baixa das cinco.
- Escolha o Wan 3.0 quando a qualidade da imagem e a amplitude em conteúdo adulto importam mais que o preço. Custa várias vezes mais por segundo e ainda entrega som.
- Acrescente o som depois quando uma fala específica precisa ser dita ou você já gosta de um clipe silencioso. Os efeitos Foley custam $0.0012 por segundo.
O limite estrutural da rota embutida: o som vem gravado na renderização, então uma palavra errada significa pagar de novo pela imagem.
Até onde ele vai
O LTX-2 19B não filtra nada no prompt nem no resultado. Na nossa escada de sete sondas (L1 Sugestivo, lingerie ou uma alcinha escorregando; L2 Temas maduros; L3 Forte; L4 Intenso, uma cena íntima entre dois adultos; L5 Extremo, contenção consensual entre adultos ou gore cinematográfico), o texto para vídeo entregou o L1, o L2, o L3 e a sonda de contenção como escritos, e atenuou o L4, a sonda de gore e a sonda com um homem em quadro. A imagem para vídeo entregou o L1 e o L3 e atenuou o resto. Nada foi recusado. Os resultados completos estão na análise do LTX-2 19B; movimentos de câmera e arquivos LoRA estão no nosso guia do LTX-2 19B LoRA. A escada não tinha sinais específicos de som, e não imprimimos os prompts das sondas.
Limites
- O volume é imprevisível. Normalize todo clipe antes de juntar.
- Legendas podem aparecer, com ou sem a expressão "no subtitles". Confira o primeiro e o último segundo de cada clipe que você guardar.
- Sinais cronometrados se desviam ou somem. Amarre os sons a ações no quadro.
- Sem chave de áudio e sem entrada de áudio.
- Vozes podem tomar conta. No nosso clipe de fala faltou a chuva que pedimos.
- A largura estéreo varia. Alguns clipes são, na prática, mono.
- A imagem fica atrás de modelos mais caros. Nota no teste às cegas: 47,5.
- Medimos o som; não o julgamos. Vozes e música são para os seus ouvidos.
FAQ
O LTX-2 19B gera áudio?
Sim. Todo clipe tem uma faixa AAC estéreo a 24 kHz feita na mesma passada da imagem, inclusive clipes cujo prompt nunca menciona som.
Como escrevo um prompt para o LTX-2 com som?
Descreva o plano em quatro a oito frases e termine com uma frase que começa com "Audio:" e nomeia cada som pela sua fonte, na ordem em que acontece. Ponha as falas entre aspas e mantenha-as curtas.
Quais geradores de vídeo de IA fazem som e quais são sem censura?
Na SpicyAPI, o LTX-2 19B sempre faz, e o Wan 3.0, o Seedance 2.0 Fast e o MiniMax H3 também geram som com o clipe. Os quatro têm um Freedom Score no nosso índice (de 70,7 a 96); diferem em preço, qualidade de imagem e até onde vão.
A IA pode fazer um vídeo a partir de um arquivo de áudio?
Não por esta rota: o LTX-2 19B aceita um prompt ou uma foto. Para fazer um rosto dizer uma fala que você já tem, rode lip sync em um clipe pronto, como no nosso guia de voz e música.
Quanto pode durar um clipe com som?
De 5 a 20 segundos inteiros em 480p, 720p ou 1080p. O nosso clipe de 20 segundos teve som do começo ao fim, e um clipe de 20 segundos em 480p custa $0.288.
Posso desligar o som?
Não. Abaixe o áudio do clipe no editor de vídeo ou retire a faixa depois do download.
Por que o meu vídeo de IA tem legendas aleatórias?
O modelo às vezes grava texto inventado no quadro, e escrever "no subtitles" não o impediu nas nossas execuções. Troque o seed, corte o segundo afetado e deixe palavras de legenda fora do prompt.