Vuoi una breve clip a tema adulto che suoni già come qualcosa: la pioggia sul vetro, una folla alle spalle della coppia, una frase sussurrata alla camera. Molti modelli video senza censura ti consegnano ancora un file muto e lasciano il suono a un secondo strumento.
LTX-2 19B produce l'immagine e una colonna sonora stereo in un'unica richiesta, senza alcun filtro sui contenuti, a partire da $0,0144 al secondo di video. Tutte le 55 clip che abbiamo generato il 5 e 6 ottobre 2026 portavano una traccia AAC stereo a 24 kHz che durava quanto l'immagine, e il suono seguiva l'azione: quando un'elica ha iniziato a girare a metà clip, la traccia è rimasta quasi in silenzio fino a quel punto. Ciò che non ottieni è la coerenza. Il volume variava di più di 30 LU tra i seed di uno stesso prompt, e 5 delle nostre 15 clip controllate sono tornate con didascalie inventate impresse nell'immagine.
Non possiamo ascoltare come fai tu, quindi ogni affermazione sull'audio qui è misurata: volume nel tempo, ampiezza stereo, durata. Non abbiamo valutato quanto suonino bene una voce o una melodia. Le clip incorporate si riproducono con il suono, così puoi giudicare tu questa parte. I modelli sono nella pagina della famiglia LTX-2 19B e nella pagina della famiglia LTX-2 19B LoRA; ogni prompt riportato qui è una scena con adulti vestiti.
In breve
| LTX-2 19B con la sua colonna sonora | |
|---|---|
| Endpoint | Da testo a video e da immagine a video; la versione LoRA aggiunge fino a tre file LoRA |
| Suono | AAC stereo a 24 kHz su ogni clip, nessun interruttore per disattivarlo |
| Durata | Da 5 a 20 secondi interi; in 55 clip, le durate di suono e immagine coincidevano entro 0,0004 s |
| Risoluzione | 480p (832 x 448), 720p (1280 x 704), 1080p (1920 x 1024); 9:16 scambia i lati; da immagine a video segue la foto |
| Prezzo, catalogo attivo | $0,0144, $0,0192 o $0,0288 al secondo; versione LoRA $0,018, $0,024 o $0,036; suono incluso |
| Guidare il suono | Una frase finale che inizia con "Audio:" |
| Volume misurato | Da −42,1 a −8,3 LUFS, mediana −13,2; nessuna clip ha superato i −1,6 dBTP di picco |
| Che cosa va storto | Il volume oscilla tra i seed, didascalie inventate, segnali temporizzati che arrivano in ritardo o mai |
| Contenuti | Nessun filtro sui contenuti; da testo a video ha reso 4 prove su 7 della scala, da immagine a video 2 su 7, nessuna rifiutata |
Come viene prodotta la colonna sonora
Lightricks descrive LTX-2 come un unico modello che genera video e audio sincronizzati. In pratica:
- Una richiesta, un file. Nessun lavoro audio separato e nessun passaggio di sincronizzazione. Una clip di cinque secondi a 720p costa $0,096 con il suo suono.
- L'input è testo o una foto, mai audio. Non puoi dargli un file vocale da seguire.
- Il suono non si può disattivare. Per una clip muta, abbassa l'audio della clip nell'editor video di Studio o rimuovi la traccia dopo il download.
L'editore avverte anche che il rispetto del prompt dipende molto da come lo scrivi, e che l'audio senza parlato può uscire con qualità inferiore.
Scrivi la riga Audio
Il modello legge immagine e suono dallo stesso prompt. Ciò che ha funzionato per noi segue la guida ai prompt di LTX-2 dell'editore (da quattro a otto frasi in un unico paragrafo) e termina con una frase che inizia con "Audio:" e indica ogni suono con la sua sorgente. Un esempio pubblicato, un traghetto che attracca di notte:
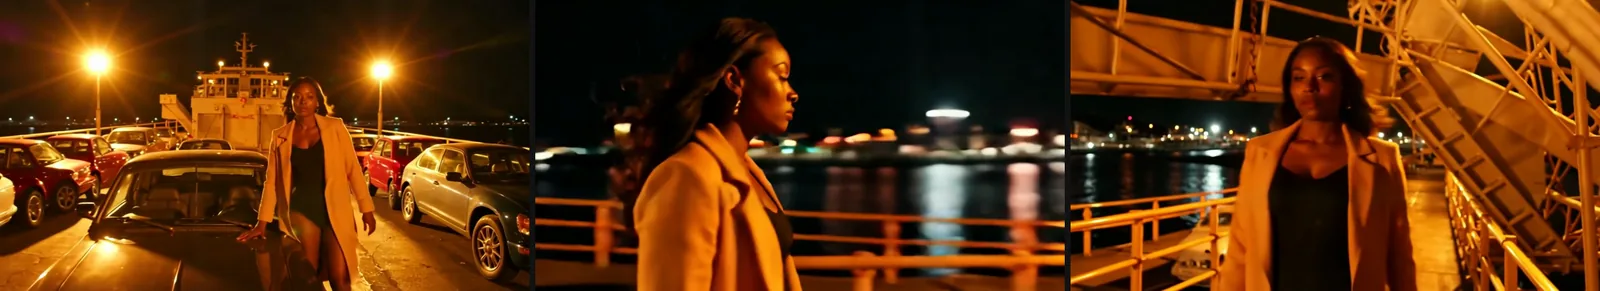
LTX-2 19B, da testo a video, 16:9, 720p, 6 secondi, seed 510512. La sua colonna sonora è rimasta tra −12,7 e −10,5 dBFS in ogni mezzo secondo.
The car deck of a night ferry as it docks. Sodium-vapour lamps turn everything orange and rows of parked cars glint. An adult Black woman in her early thirties in a long camel coat worn open over a fitted black bodysuit leans on the bonnet of a vintage car, her hair whipped by wind from the opening bow. The huge steel ramp lowers with a groan and slams onto the quay, showing the harbour lights beyond; she pushes off the car and walks toward the light, glancing back at the camera. Low-angle wide shot, slow dolly forward, sodium orange against black water, anamorphic flares. Audio: the deep thrum of the engines, chains rattling, the ramp groaning down and landing with a heavy metallic boom that echoes through the hold, then the ship horn.Cinque abitudini, dalla guida dell'editore e dalle nostre prove:
- Nomina ciò che produce il suono. "Chains rattling" indica qualcosa nell'inquadratura; "atmospheric audio" non nomina alcuna sorgente.
- Elenca i suoni nell'ordine in cui avvengono. L'esempio del treno notturno sulla pagina del modello va così: ruote, vento, una campana di passaggio a livello che sale e si spegne, poi un fischio lontano davanti.
- Lascia che l'abbigliamento e gli sguardi portino l'atmosfera, e il suono la stanza. Una spallina che scivola, un lento sorriso, la pioggia sul vetro e un sassofono da un disco bastano per una scena allusiva.
- Scrivi una breve battuta invece di descrivere rumori. Metti le parole tra virgolette e indica come ("says softly"). Un thread della community su LTX-2 segnalava che i segnali di rumori vocali uscivano come risate strane; non li abbiamo testati, e una breve battuta è più prevedibile.
- Da immagine a video, dai un suono a ciò che c'è nella foto. La foto fissa la persona e il luogo; descrivi che cosa succede dopo e che suono ha. Un prompt che descrive un'altra stanza può far staccare la clip dalla tua foto.
| Tipo di segnale | Formulazione usata | Che cosa hanno mostrato le misure |
|---|---|---|
| Un fondo costante | "the deep thrum of the engines, chains rattling" | Livello costante per tutta la clip |
| Un evento nell'inquadratura | "the engine coughing and catching into a roar" | Quasi silenzio, poi il ruggito appena l'elica gira (2 seed su 2) |
| Musica che parte a comando | "near silence at first … then … a slow, smoky saxophone ballad starts" | Un seed è salito a 5,0 s su 6; l'altro non è mai cambiato |
| Una battuta tra virgolette | says softly, "Stay. The rain isn't stopping tonight." | Due raffiche forti, quasi silenzio nel mezzo |
| Una folla con musica | "a string quartet playing a slow waltz, the murmur of a crowd" | Livello costante; uno dei due seed ha impresso delle didascalie |
| Suoni deboli e lontani | "a faint dance band drifting from a villa along the coast" | Stessa riga, quattro seed: da −10,9 a −42,1 LUFS |
Che cosa hanno mostrato 55 colonne sonore
Abbiamo misurato 40 clip dalle esecuzioni di esempio del 5 ottobre (entrambi gli endpoint, modello base e versione LoRA) e 15 clip controllate eseguite il 6 ottobre con il da testo a video base. Formato e durata vengono da ffprobe, volume integrato e picco reale dal misuratore EBU R128 di ffmpeg, le curve qui sotto dal livello di ogni frazione di 0,1 secondi, e l'ampiezza stereo dal confronto tra i due canali.
Il suono c'è sempre, lungo quanto l'immagine
Tutte le 55 clip avevano una traccia AAC stereo a 24 kHz, comprese due il cui prompt non menzionava mai il suono. Le richieste da cinque secondi hanno restituito 5,042 secondi di immagine e di suono, quelle da sei secondi 6,042, una richiesta da venti secondi 20,042. Nessuna traccia è finita prima dell'immagine.
Il suono segue l'azione
Un pilota sale su un aereo a elica sotto la pioggia; il prompt chiedeva il lamento dell'avviamento, il motore che prende e il soffio dell'elica.
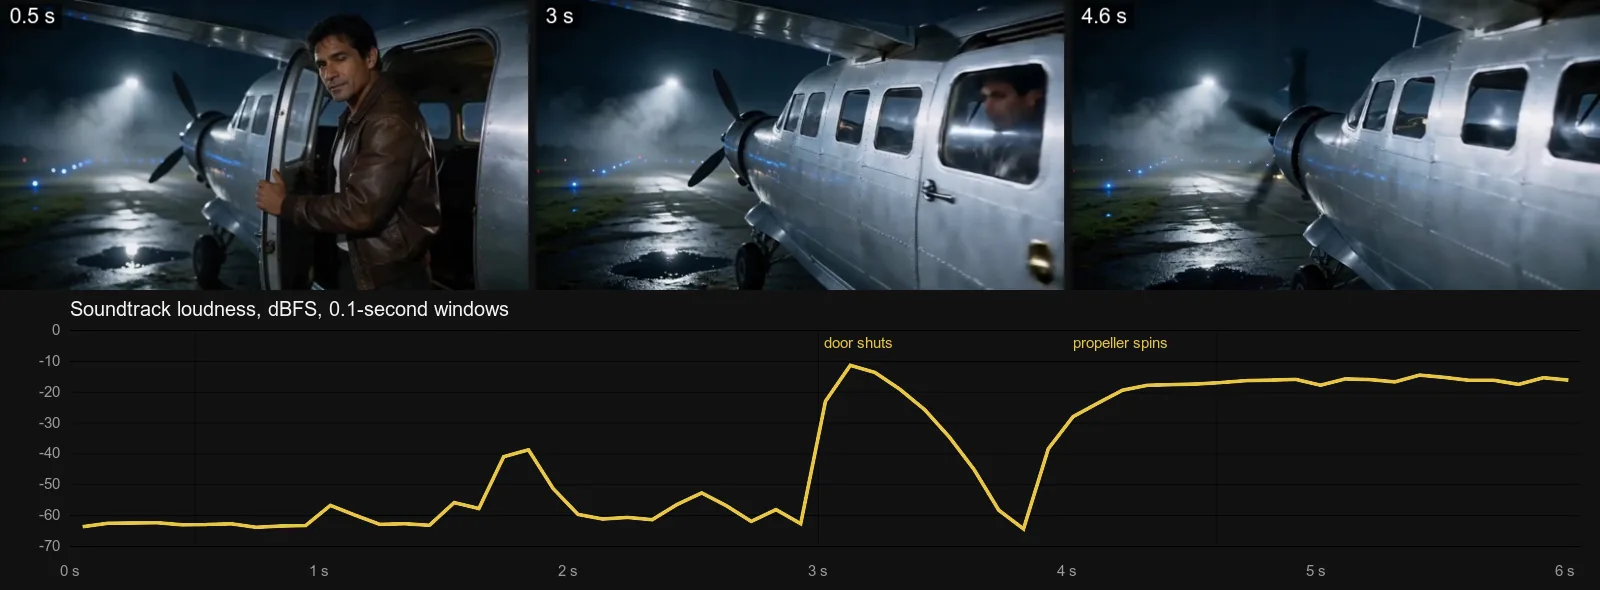
Da immagine a video, 720p, 6 secondi, seed 510515. Attorno a −60 dBFS per tre secondi, un salto quando si chiude la porta, poi circa −16 dBFS appena l'elica gira. Anche un secondo seed è rimasto silenzioso per tre secondi, poi ha mantenuto un livello forte e costante.
È questa la ragione principale per generare il suono insieme all'immagine: la parte forte cade dove cambia l'immagine.
Un segnale temporizzato è una richiesta, non uno spartito
Chiedere prima il silenzio e poi la musica è meno affidabile. Questo prompt del loft chiedeva quasi silenzio, poi una puntina che si posa e una ballata al sassofono.
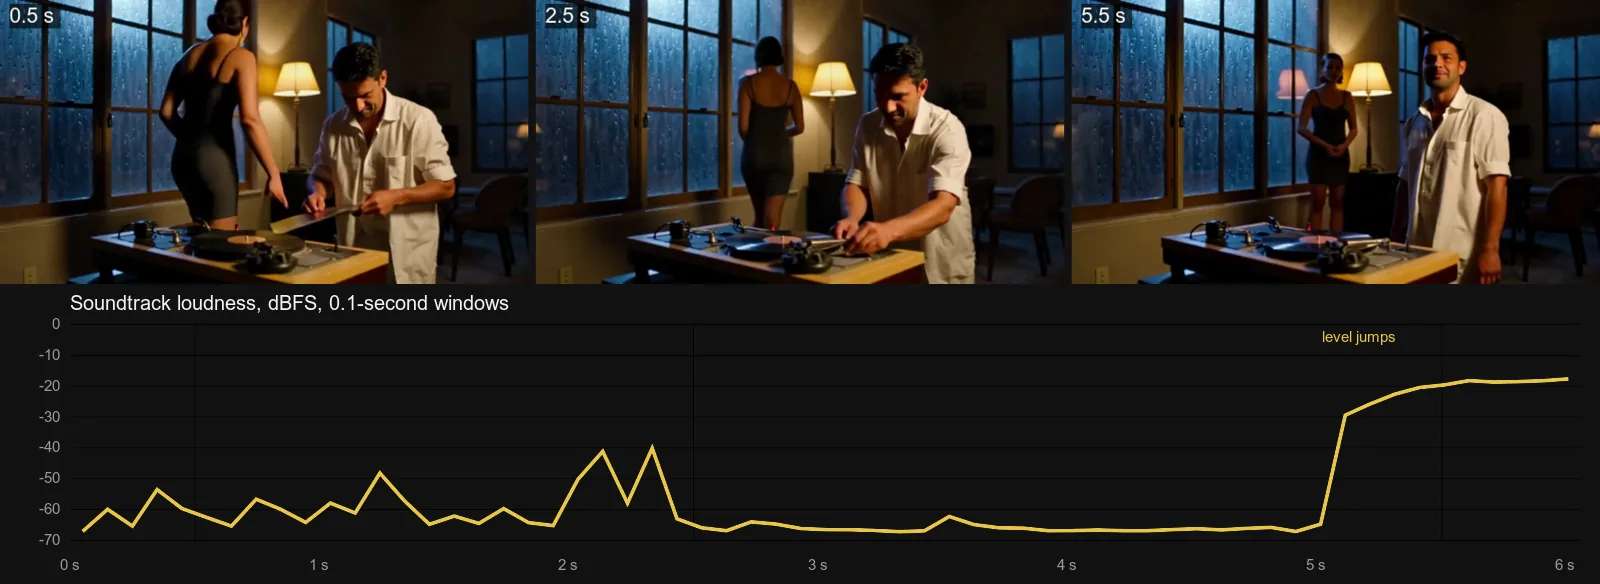
Da testo a video, 480p, 6 secondi, seed 610611. Il livello salta a 5,0 secondi su 6.
Il secondo seed è rimasto attorno a −45 dBFS per tutti e sei i secondi e non è mai cambiato. Se un suono deve cadere su un fotogramma, descrivi l'azione che lo produce, come ha fatto il prompt dell'aereo. Se deve essere esatto, aggiungilo dopo.
Il volume cambia molto da un seed all'altro
Questo conta soprattutto quando unisci le clip. Una scena su una terrazza al chiaro di luna è stata eseguita quattro volte con la stessa riga Audio:
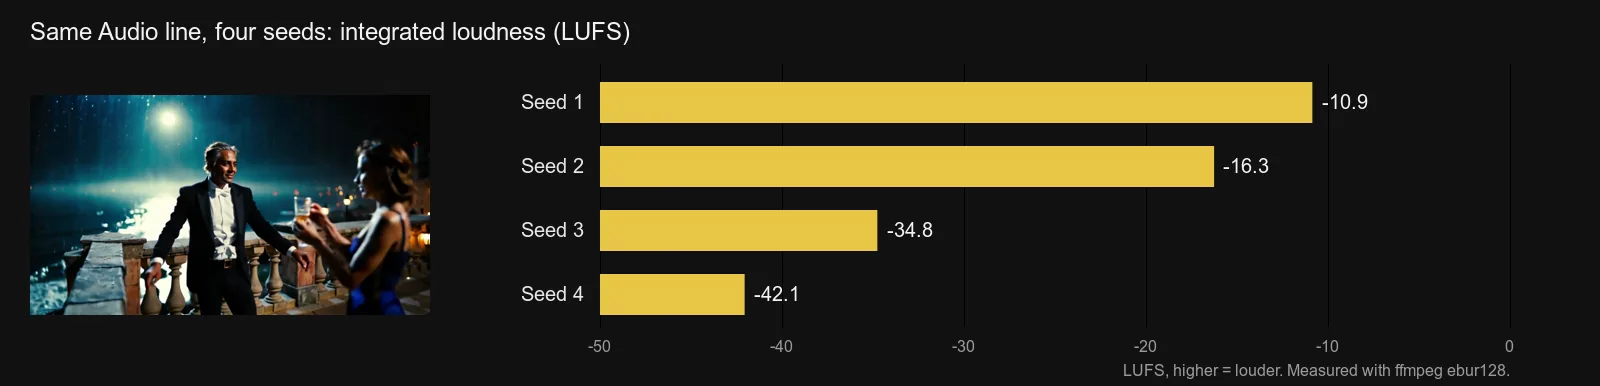
LTX-2 19B LoRA con il LoRA di camera Dolly Out, da testo a video, 720p, 5 secondi, quattro seed. La riga Audio era identica; gli ultimi due prompt descrivevano anche più nel dettaglio entrambi gli abiti.
Su tutte le 55 clip, il volume integrato è andato da −42,1 a −8,3 LUFS con una mediana di −13,2; 35 stavano entro 3 LU dalla mediana e 7 erano più silenziose di −20. Nessuna clip ha superato i −1,6 dBTP di picco, quindi nulla è tornato saturato. Le parole usate non decidono questo da sole: le esecuzioni della terrazza più forte e più debole avevano la stessa riga Audio, parola per parola.
Quindi uniforma il volume prima di unire le clip, nell'editor di Studio o con un normalizzatore di volume. Sei delle 40 clip di esempio sono inoltre finite ad almeno 15 dB sotto il loro momento più forte, tutte da esecuzioni con un LoRA di camera caricato, quindi controlla le code prima di tagliare.
Lo "stereo" a volte è mono
Ogni file ha due canali, ma in 14 delle 55 clip i canali erano praticamente identici (correlazione 0,99 o più), e in 13 chiaramente diversi (sotto 0,6). Tutte e quattro le clip costruite attorno a una sola battuta parlata erano di fatto mono. Se l'ampiezza conta, controlla in cuffia.
Omettere la riga Audio dà comunque il suono
Abbiamo eseguito due volte una scena di ballo in maschera con una riga Audio (quartetto d'archi, folla, bicchieri, la sua risata) e due volte senza, sugli stessi seed.
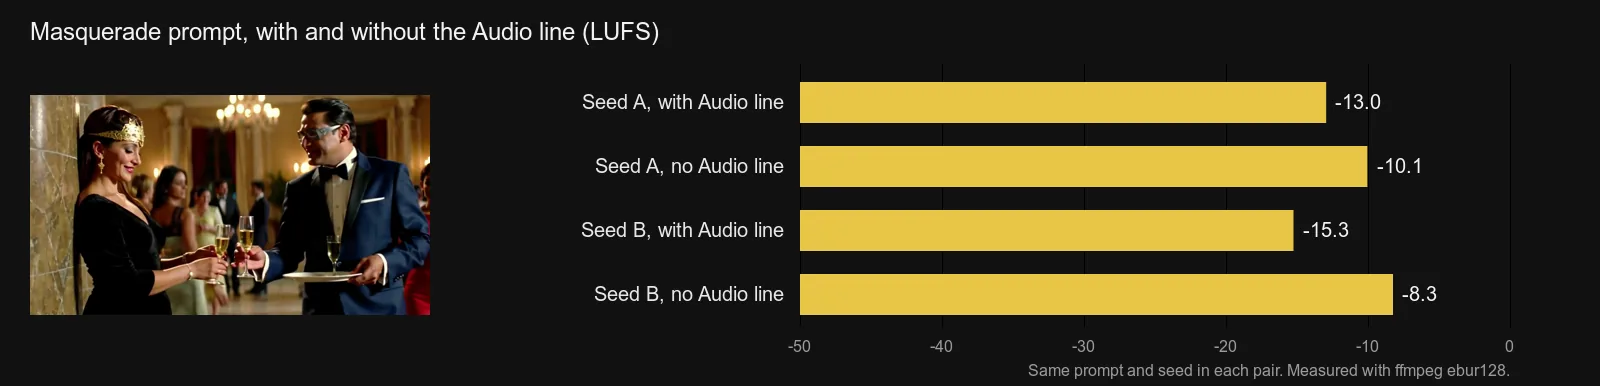
Da testo a video, 720p, 5 secondi, seed 610601 e 610602. Le due clip senza riga Audio erano quelle più forti.
Senza la riga ottieni comunque una traccia; semplicemente non scegli che cosa c'è dentro. Tieni la riga Audio anche quando il suono non è il punto.
Venti secondi tenuti
Nelle clip lunghe un passaggio sonoro separato diventa noioso, quindi abbiamo eseguito una clip da 20 secondi a 480p.
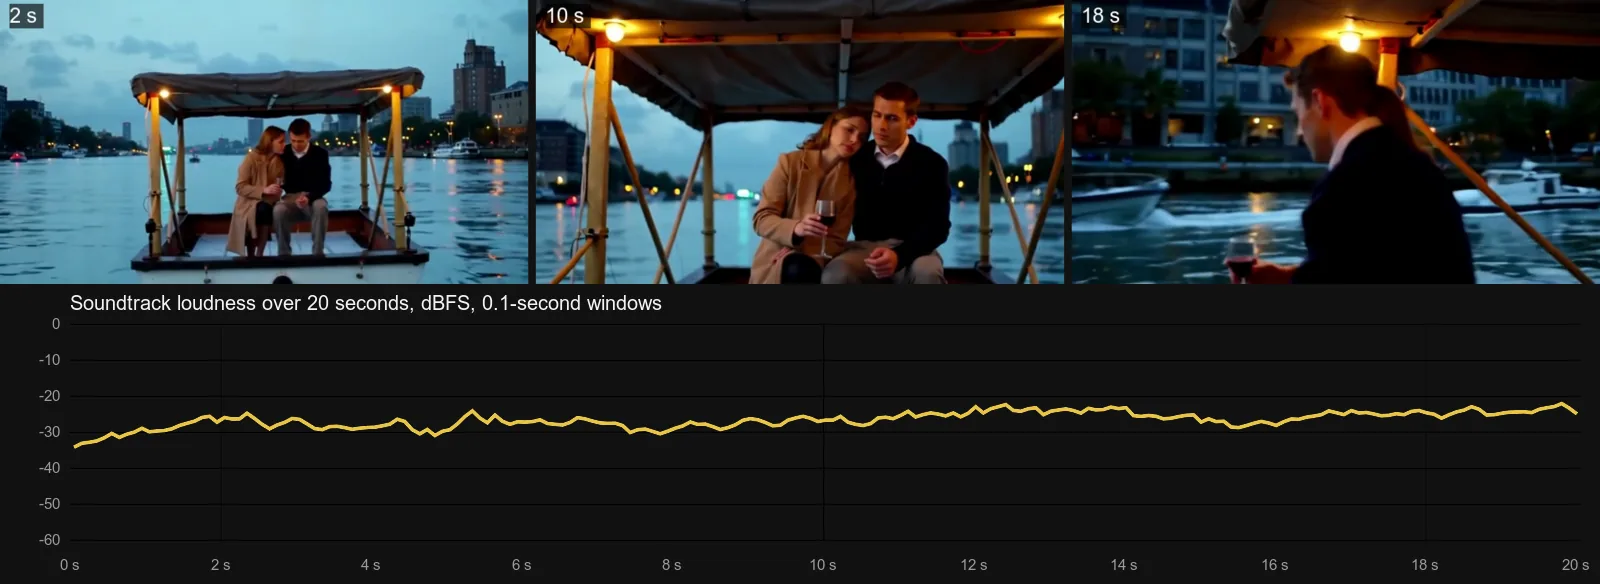
Da testo a video, 16:9, 480p, 20 secondi, seed 610631. Ogni mezzo secondo di suono è rimasto tra −32,6 e −22,9 dBFS.
Il suono ha tenuto per tutti i venti secondi. È l'immagine a essere andata alla deriva: il lento avvicinamento è proseguito finché lei è rimasta in gran parte nascosta dietro di lui. La clip è costata $0,288. Il prompt come l'abbiamo eseguito, meno una frase "no on-screen text" che non consigliamo più (vedi la sezione successiva):
A houseboat on a river at dusk in light rain. An adult couple in their forties, a woman in a long camel coat and a man in a navy wool sweater, sit close under the canvas awning at the stern sharing a blanket, watching the city lights come on along the bank. He refills her glass of red wine; she leans her head on his shoulder; later a tour boat glides past and its wake rocks them gently. Wide shot, slow push-in, blue dusk with warm string lights, film grain. Audio: rain pattering on the canvas, water lapping against the hull, a distant radio playing old jazz, the low rumble of the passing boat and its wake slapping the side.Esegui questo prompt su LTX-2 19B da testo a video →
Battute parlate e le didascalie che nessuno ha chiesto
Una breve battuta rende personale una clip allusiva. Abbiamo chiesto a una donna in un accappatoio di seta color crema di guardare in alto verso la camera e dire, piano, "Stay. The rain isn't stopping tonight."
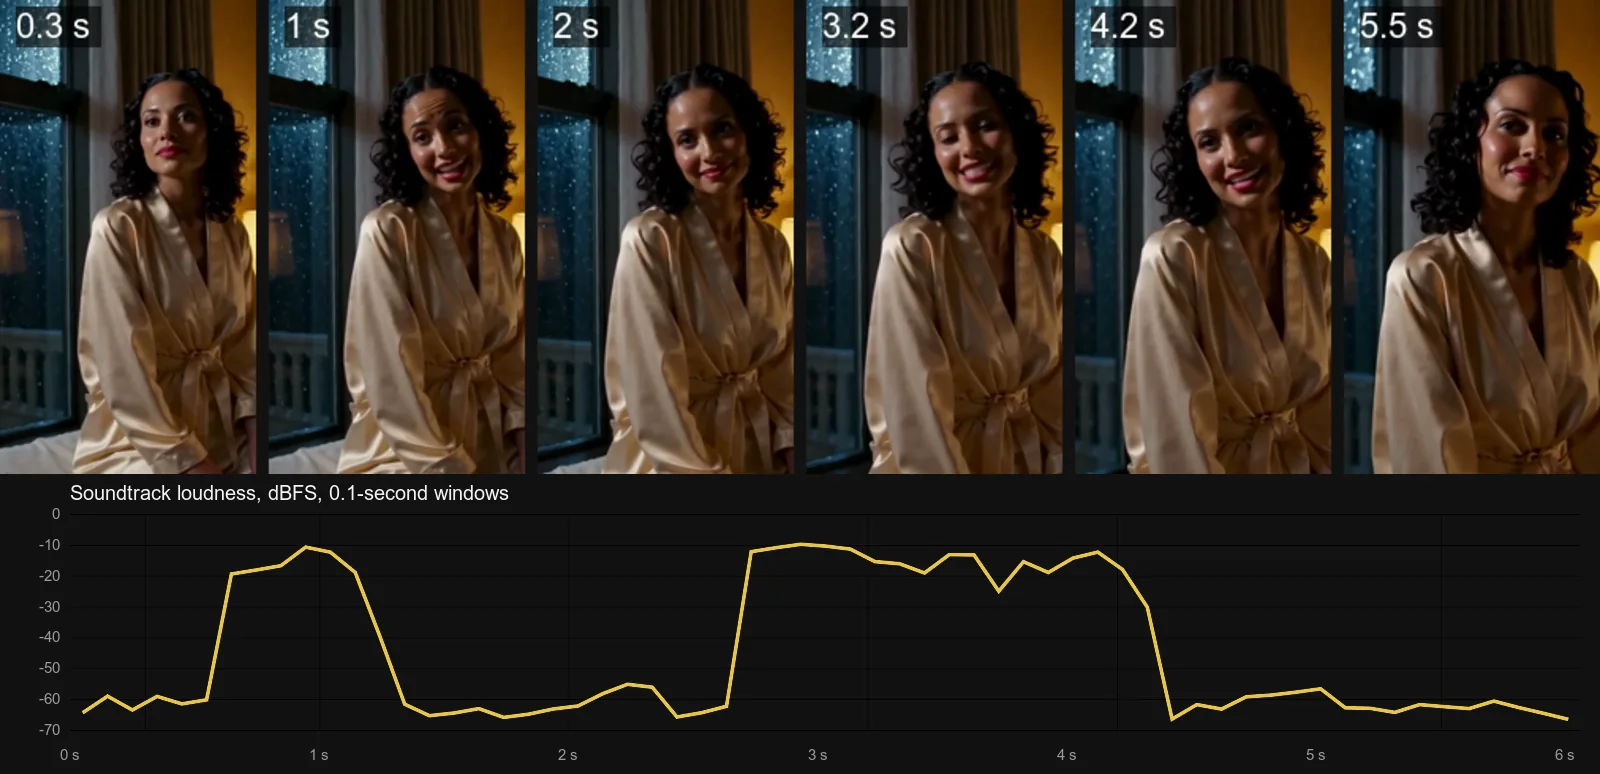
Da testo a video, 9:16, 480p, 6 secondi, seed 610622, nessuna parola relativa alle didascalie nel prompt.
Due tratti forti si adattano a una battuta detta in due parti, ma non abbiamo controllato le parole, quindi ascolta prima di fidarti. Ciò che la curva mostra è che la "steady rain on the glass" che avevamo chiesto non c'era sotto: tra le raffiche e dopo di esse il livello è sceso a circa −60 dBFS. Quando c'è una voce, può prendere il controllo della traccia.
La sorpresa più grande è stata il testo nell'immagine. Cinque delle nostre 15 clip controllate avevano parole inventate impresse:
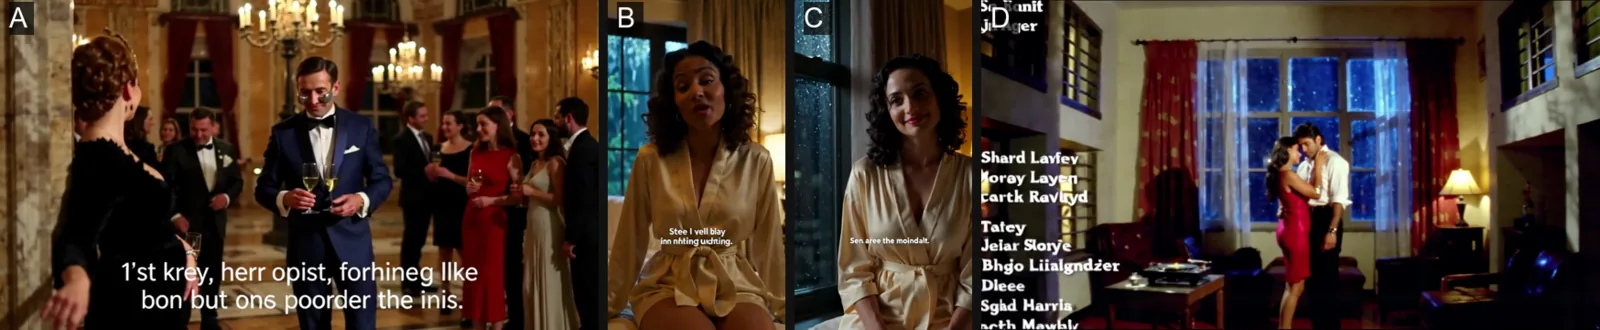
A: il prompt del ballo in maschera con la sua riga Audio, seed 610601, solo i primi 0,8 secondi. B e C: il prompt con la battuta parlata con "no subtitles, no captions, no on-screen text" aggiunto, entrambi i seed. D: un prompt a 1080p su una coppia che balla con un disco; il suo secondo seed mostrava invece testi da cantare insieme.
Undici dei 15 prompt terminavano con "no subtitles" o "no on-screen text", e tutte e cinque le clip con didascalie erano tra questi; i quattro prompt senza una tale frase sono tornati puliti. Lo stesso prompt con la battuta parlata agli stessi due seed era pulito senza la frase e con le didascalie con essa. Anche sei degli undici erano puliti, e in un lotto precedente due clip in orizzontale con "no subtitles" sono tornate pulite, quindi su questo piccolo campione la frase non ha protetto nulla e potrebbe aver provocato il testo. Il testo è sempre illeggibile, il che concorda con la nota dell'editore secondo cui LTX-2 non rende testo leggibile.
- Lascia fuori dal prompt le parole sulle didascalie. Nelle nostre prove non hanno impedito nulla.
- Controlla il primo e l'ultimo secondo. Nella clip A il testo è durato 0,8 secondi; tagliare l'inizio l'ha risolto.
- Cambia il seed. Il secondo seed del prompt del ballo in maschera era pulito.
- Guarda due volte i prompt costruiti attorno a una canzone. Entrambe le clip a 1080p di una coppia che balla con un disco sono tornate con titoli di coda o testi.
Suono integrato o modello muto più un passaggio sonoro?
L'altra strada è una clip muta con effetti, voce e musica aggiunti dopo, come nelle nostre guide per aggiungere voce e musica a un video AI NSFW e il flusso di lavoro con gli effetti sonori Foley. Una clip di cinque secondi, prezzi del catalogo attivo e punteggi del nostro indice:
| Via | Suono | Clip di 5 secondi | Punteggio Freedom | Punteggio test alla cieca |
|---|---|---|---|---|
| LTX-2 19B, 720p | Sempre attivo, stereo | $0,096 | 76,1 | 47,5 |
| MiniMax H3, 768p | Generato con la clip | $0,185 | 70,7 | 67,6 |
| Wan 3.0, 720p | Attivo per impostazione predefinita, si può disattivare | $0,45 | 96 | 70,9 |
| Seedance 2.0 Fast, 720p | Attivo per impostazione predefinita; disattivarlo non abbassa la tariffa | $0,48 | 72,2 | 68,6 |
| HunyuanVideo 1.5, 720p, poi Foley v1 | Clip muta, effetti aggiunti dopo | $0,24 + $0,006 | 88,1 | 57,7 |
Freedom è il nostro punteggio da 0 a 100 di quanta parte della scala dei contenuti per adulti un modello rende; il test alla cieca valuta la qualità dell'immagine con i nomi dei modelli nascosti. Entrambi vengono dal nostro indice attivo al 5 ottobre 2026; per la via in due passaggi sono quelli di HunyuanVideo.
- Scegli LTX-2 19B per molte bozze economiche con il suono. È la via più economica della tabella, e una clip di cinque secondi a 720p ha richiesto da 14 a 25 secondi nelle nostre prove. Il compromesso è l'immagine: il suo punteggio nel test alla cieca è il più basso dei cinque.
- Scegli Wan 3.0 quando contano più la qualità dell'immagine e l'ampiezza sui contenuti per adulti che il prezzo. Costa diverse volte di più al secondo e ti dà comunque il suono.
- Aggiungi il suono dopo quando una battuta specifica deve essere pronunciata o hai già una clip muta che ti piace. Gli effetti Foley costano $0,0012 al secondo.
Il limite strutturale della via integrata: il suono è incorporato nel rendering, quindi una parola sbagliata significa pagare di nuovo l'immagine.
Fin dove arriva
LTX-2 19B non filtra nulla sul prompt né sul risultato. Sulla nostra scala di sette prove (L1 Allusivo, lingerie o una spallina che scivola; L2 Parziale; L3 Forte; L4 Intenso, una scena intima tra due adulti; L5 Estremo, bondage consensuale tra adulti o gore cinematografico), da testo a video ha reso come scritti L1, L2, L3 e la prova di bondage, e ha attenuato L4, la prova di gore e la prova con un uomo in scena. Da immagine a video ha reso L1 e L3 e ha attenuato il resto. Nulla è stato rifiutato. I risultati completi sono nella recensione di LTX-2 19B; i movimenti di camera e i file LoRA sono nella nostra guida a LTX-2 19B LoRA. La scala non aveva segnali specifici per il suono, e non riportiamo i prompt delle prove.
Limiti
- Il volume è imprevedibile. Normalizza ogni clip prima di unirle.
- Possono comparire didascalie, con o senza una frase "no subtitles". Controlla il primo e l'ultimo secondo di ogni clip che tieni.
- I segnali temporizzati slittano o spariscono. Lega i suoni ad azioni nell'inquadratura.
- Nessun interruttore audio, nessun input audio.
- Le voci possono prendere il controllo. Nella nostra clip con la battuta parlata mancava la pioggia che avevamo chiesto.
- L'ampiezza stereo varia. Alcune clip sono di fatto mono.
- L'immagine resta indietro rispetto ai modelli più costosi. Punteggio nel test alla cieca 47,5.
- Abbiamo misurato il suono; non l'abbiamo giudicato. Voci e musica sono per le tue orecchie.
FAQ
LTX-2 19B genera audio?
Sì. Ogni clip ha una traccia AAC stereo a 24 kHz prodotta nello stesso passaggio dell'immagine, comprese le clip il cui prompt non menziona mai il suono.
Come scrivo un prompt per LTX-2 con il suono?
Descrivi l'inquadratura in quattro-otto frasi, poi termina con una frase che inizia con "Audio:" e indica ogni suono con la sua sorgente, nell'ordine in cui avviene. Metti le parole pronunciate tra virgolette e tienile brevi.
Quali generatori video AI producono il suono, e quali sono senza censura?
Su SpicyAPI, LTX-2 19B lo fa sempre, e anche Wan 3.0, Seedance 2.0 Fast e MiniMax H3 generano il suono insieme alla clip. Tutti e quattro hanno un punteggio Freedom nel nostro indice (da 70,7 a 96); differiscono per prezzo, qualità dell'immagine e fin dove arrivano.
L'AI può creare un video da un file audio?
Non su questa via: LTX-2 19B accetta un prompt o una foto. Per far dire a un volto una battuta che hai già, esegui il lip sync su una clip finita, come nella nostra guida a voce e musica.
Quanto può durare una clip con il suono?
Da 5 a 20 secondi interi a 480p, 720p o 1080p. La nostra clip da 20 secondi aveva il suono per tutta la durata, e una clip da 20 secondi a 480p costa $0,288.
Posso disattivare il suono?
No. Abbassa l'audio della clip nell'editor video o rimuovi la traccia dopo il download.
Perché il mio video AI ha sottotitoli casuali?
Il modello a volte imprime nell'immagine testo inventato, e scrivere "no subtitles" non l'ha impedito nelle nostre prove. Cambia il seed, taglia il secondo interessato e lascia fuori dal prompt le parole sulle didascalie.