Sie wollen einen kurzen Clip mit Adult-Thema, der schon nach etwas klingt: Regen am Fenster, eine Menge hinter dem Paar, ein leise zur Kamera gesprochener Satz. Viele unzensierte Videomodelle liefern Ihnen immer noch eine stumme Datei und überlassen den Ton einem zweiten Werkzeug.
LTX-2 19B erzeugt das Bild und eine Stereo-Tonspur in einer Anfrage, ohne Inhaltsfilter, ab 0,0144 $ pro Sekunde Video. Alle 55 Clips, die wir am 5. und 6. Oktober 2026 erzeugt haben, trugen eine AAC-Stereospur mit 24 kHz, die über die volle Länge des Bildes lief, und der Ton folgte der Handlung: Als sich in der Mitte eines Clips ein Propeller zu drehen begann, blieb die Spur bis dahin nahe der Stille. Was Sie nicht bekommen, ist Konstanz. Die Lautheit schwankte zwischen den Seeds eines Prompts um mehr als 30 LU, und 5 unserer 15 kontrollierten Clips kamen mit erfundenen, ins Bild eingebrannten Untertiteln zurück.
Wir können nicht so hören wie Sie, deshalb ist jede Aussage zum Ton hier gemessen: Lautheit über die Zeit, Stereobreite, Länge. Wie gut eine Stimme oder eine Melodie klingt, haben wir nicht bewertet. Die eingebetteten Clips spielen mit Ton, diesen Teil können Sie also selbst beurteilen. Die Modelle finden Sie auf der Familienseite zu LTX-2 19B und der Familienseite zu LTX-2 19B LoRA; jeder hier abgedruckte Prompt ist eine Szene mit bekleideten Erwachsenen.
Auf einen Blick
| LTX-2 19B mit eigener Tonspur | |
|---|---|
| Endpunkte | Text-zu-Video und Bild-zu-Video; der LoRA-Build ergänzt bis zu drei LoRA-Dateien |
| Ton | AAC-Stereo mit 24 kHz bei jedem Clip, kein Schalter zum Ausschalten |
| Länge | 5 bis 20 ganze Sekunden; in 55 Clips stimmten die Längen von Ton und Bild auf 0,0004 s genau überein |
| Auflösung | 480p (832 x 448), 720p (1280 x 704), 1080p (1920 x 1024); 9:16 vertauscht die Seiten; Bild-zu-Video folgt dem Foto |
| Preis, Live-Katalog | 0,0144 $, 0,0192 $ oder 0,0288 $ pro Sekunde; LoRA-Build 0,018 $, 0,024 $ oder 0,036 $; Ton inklusive |
| Den Ton steuern | Ein Schlusssatz, der mit "Audio:" beginnt |
| Gemessene Lautheit | −42,1 bis −8,3 LUFS, Median −13,2; kein Clip erreichte mehr als −1,6 dBTP |
| Was schiefgeht | Lautheit schwankt zwischen Seeds, erfundene Untertitel, zeitlich gesetzte Signale, die spät oder gar nicht kommen |
| Inhalt | Kein Inhaltsfilter; Text-zu-Video lieferte 4 von 7 Leiter-Proben, Bild-zu-Video 2 von 7, keine abgelehnt |
Wie die Tonspur entsteht
Lightricks beschreibt LTX-2 als ein Modell, das synchronisiertes Video und Audio erzeugt. In der Praxis heißt das:
- Eine Anfrage, eine Datei. Kein separater Audio-Auftrag und kein Synchronisierschritt. Ein fünfsekündiger 720p-Clip kostet mit Ton 0,096 $.
- Eingabe ist Text oder ein Foto, nie Audio. Sie können keine Sprachdatei vorgeben, an die es sich anpasst.
- Der Ton lässt sich nicht abschalten. Für einen stummen Clip drehen Sie das Audio des Clips im Video-Editor von Studio herunter oder entfernen die Spur nach dem Download.
Der Herausgeber warnt außerdem, dass das Befolgen des Prompts stark davon abhängt, wie Sie schreiben, und dass Audio ohne Sprache in geringerer Qualität herauskommen kann.
Die Audio-Zeile schreiben
Das Modell liest Bild und Ton aus demselben Prompt. Was bei uns funktionierte, folgt dem Prompting-Leitfaden zu LTX-2 des Herausgebers (vier bis acht Sätze in einem Absatz) und endet mit einem Satz, der mit "Audio:" beginnt und jedes Geräusch nach seiner Quelle benennt. Ein veröffentlichtes Beispiel, eine Fähre beim Anlegen bei Nacht:
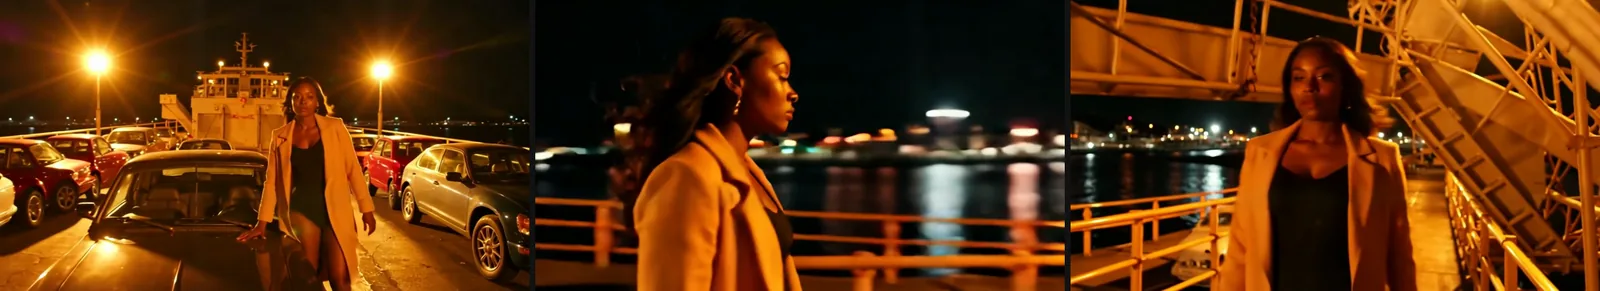
LTX-2 19B, Text-zu-Video, 16:9, 720p, 6 Sekunden, Seed 510512. Seine Tonspur blieb in jeder halben Sekunde zwischen −12,7 und −10,5 dBFS.
The car deck of a night ferry as it docks. Sodium-vapour lamps turn everything orange and rows of parked cars glint. An adult Black woman in her early thirties in a long camel coat worn open over a fitted black bodysuit leans on the bonnet of a vintage car, her hair whipped by wind from the opening bow. The huge steel ramp lowers with a groan and slams onto the quay, showing the harbour lights beyond; she pushes off the car and walks toward the light, glancing back at the camera. Low-angle wide shot, slow dolly forward, sodium orange against black water, anamorphic flares. Audio: the deep thrum of the engines, chains rattling, the ramp groaning down and landing with a heavy metallic boom that echoes through the hold, then the ship horn.Fünf Gewohnheiten, aus dem Leitfaden des Herausgebers und unseren Läufen:
- Nennen Sie, was das Geräusch macht. "Chains rattling" zeigt auf etwas im Bild; "atmospheric audio" nennt gar keine Quelle.
- Listen Sie Geräusche in der Reihenfolge auf, in der sie geschehen. Das Nachtzug-Beispiel auf der Modellseite geht: Räder, Wind, eine Bahnübergangsglocke, die anschwillt und verklingt, dann ein Horn weit voraus.
- Lassen Sie Outfit und Blicke die Stimmung tragen und den Ton den Raum. Ein rutschender Träger, ein langsames Lächeln, Regen am Glas und ein Saxofon auf einer Schallplatte genügen für eine andeutende Szene.
- Schreiben Sie einen kurzen Satz, statt Geräusche zu beschreiben. Setzen Sie die Worte in Anführungszeichen und sagen Sie, wie ("says softly"). Ein Community-Thread zu LTX-2 berichtete, dass Stimmgeräusch-Vorgaben als seltsames Lachen herauskamen; die haben wir nicht getestet, und ein kurzer Satz ist besser vorhersagbar.
- Geben Sie bei Bild-zu-Video dem Ton, was im Foto ist. Das Foto legt Person und Ort fest; beschreiben Sie, was als Nächstes geschieht und wie es klingt. Ein Prompt, der einen anderen Raum beschreibt, kann den Clip von Ihrem Foto wegschneiden lassen.
| Art des Signals | Formulierung, die wir nutzten | Was die Messungen zeigten |
|---|---|---|
| Ein stetiges Klangbett | "the deep thrum of the engines, chains rattling" | Gleichbleibender Pegel für den ganzen Clip |
| Ein Ereignis im Bild | "the engine coughing and catching into a roar" | Nahe Stille, dann das Aufbrüllen, sobald sich der Propeller dreht (2 von 2 Seeds) |
| Musik, die auf Stichwort einsetzt | "near silence at first … then … a slow, smoky saxophone ballad starts" | Ein Seed sprang bei 5,0 s von 6; der andere änderte sich nie |
| Ein gesprochener Satz in Anführungszeichen | says softly, "Stay. The rain isn't stopping tonight." | Zwei laute Ausbrüche, dazwischen nahe Stille |
| Eine Menge mit Musik | "a string quartet playing a slow waltz, the murmur of a crowd" | Gleichbleibender Pegel; einer von zwei Seeds brannte Untertitel ein |
| Leise, ferne Geräusche | "a faint dance band drifting from a villa along the coast" | Gleiche Zeile, vier Seeds: −10,9 bis −42,1 LUFS |
Was 55 Tonspuren zeigten
Wir haben 40 Clips aus den Beispielläufen vom 5. Oktober gemessen (beide Endpunkte, Basismodell und LoRA-Build) und 15 kontrollierte Clips, die wir am 6. Oktober mit Basis-Text-zu-Video fuhren. Format und Länge stammen von ffprobe, integrierte Lautheit und True Peak vom EBU-R128-Messgerät in ffmpeg, die Kurven unten aus dem Pegel jeder 0,1-Sekunden-Scheibe und die Stereobreite aus dem Vergleich der beiden Kanäle.
Der Ton ist immer da, so lang wie das Bild
Alle 55 Clips hatten eine AAC-Stereospur mit 24 kHz, darunter zwei, deren Prompt den Ton nie erwähnte. Anfragen über fünf Sekunden lieferten 5,042 Sekunden Bild und Ton, Anfragen über sechs Sekunden 6,042, eine Anfrage über zwanzig Sekunden 20,042. Keine Spur endete vor dem Bild.
Der Ton folgt der Handlung
Ein Pilot steigt im Regen in ein Propellerflugzeug; der Prompt verlangte das Anlasserjaulen, das Anspringen des Motors und den Propellerwind.
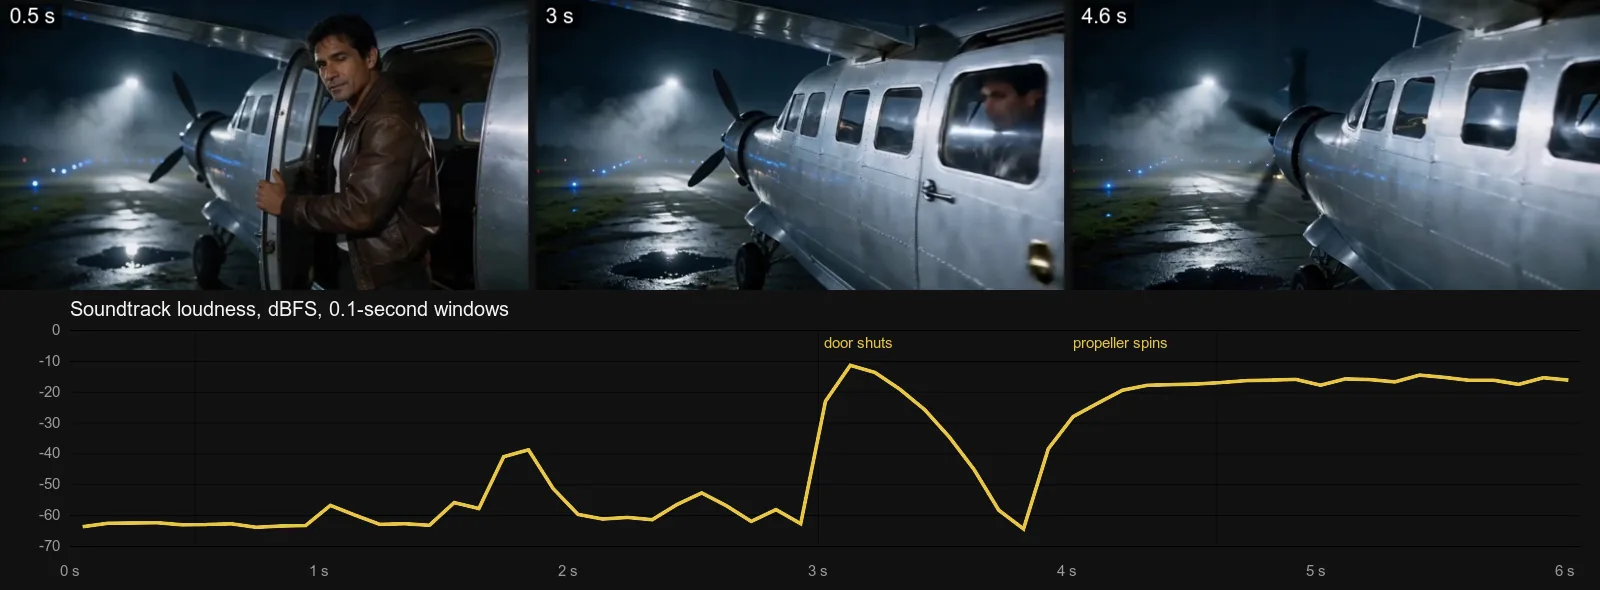
Bild-zu-Video, 720p, 6 Sekunden, Seed 510515. Drei Sekunden nahe −60 dBFS, ein Sprung beim Schließen der Tür, dann etwa −16 dBFS, sobald sich der Propeller dreht. Ein zweiter Seed blieb ebenfalls drei Sekunden still und hielt dann einen lauten, gleichmäßigen Pegel.
Das ist der Hauptgrund, den Ton mit dem Bild zu erzeugen: Der laute Teil landet dort, wo sich das Bild ändert.
Ein zeitlich gesetztes Signal ist eine Bitte, kein Ablaufplan
Erst Stille und später Musik zu verlangen, ist weniger verlässlich. Dieser Loft-Prompt verlangte nahe Stille, dann eine aufsetzende Nadel und eine Saxofon-Ballade.
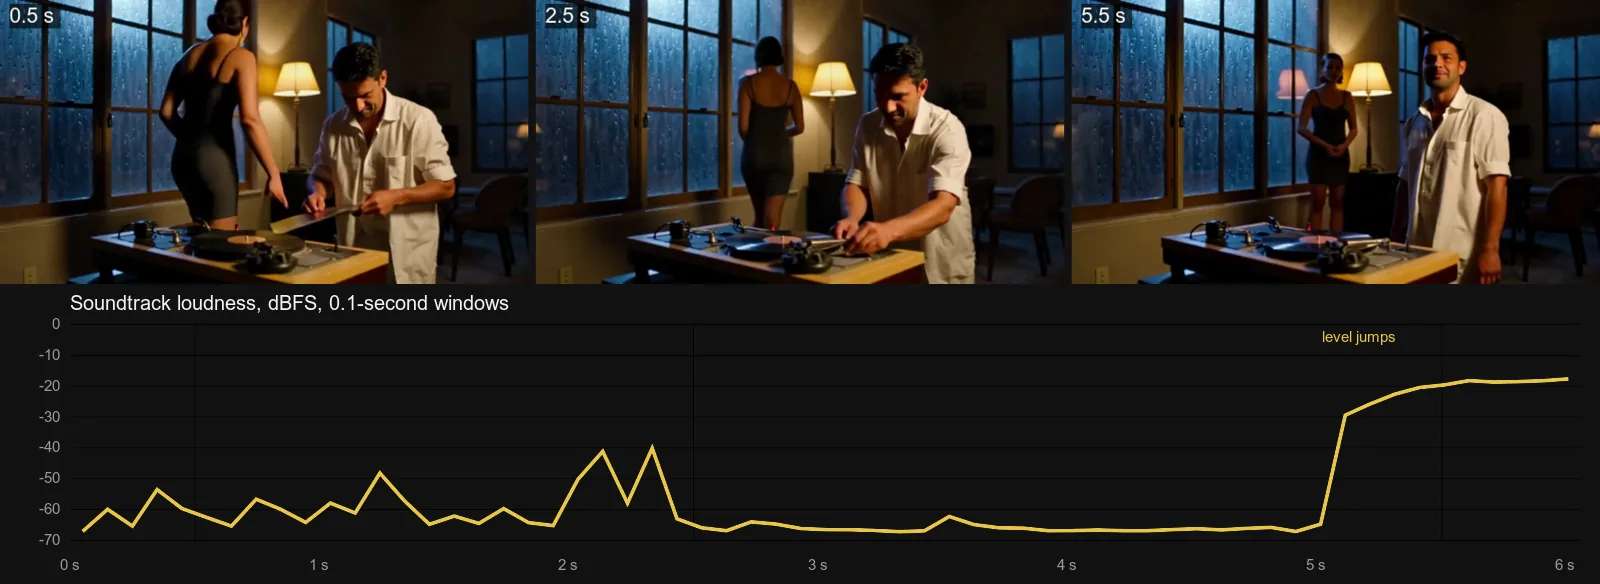
Text-zu-Video, 480p, 6 Sekunden, Seed 610611. Der Pegel springt bei 5,0 Sekunden von 6.
Der zweite Seed lag alle sechs Sekunden bei etwa −45 dBFS und änderte sich nie. Wenn ein Geräusch auf einem Frame landen muss, beschreiben Sie die Handlung, die es erzeugt, wie der Flugzeug-Prompt. Wenn es exakt sein muss, fügen Sie es hinterher hinzu.
Die Lautheit ändert sich von Seed zu Seed stark
Das ist am wichtigsten, wenn Sie Clips zusammenfügen. Eine Szene auf einer mondbeschienenen Terrasse lief viermal mit derselben Audio-Zeile:
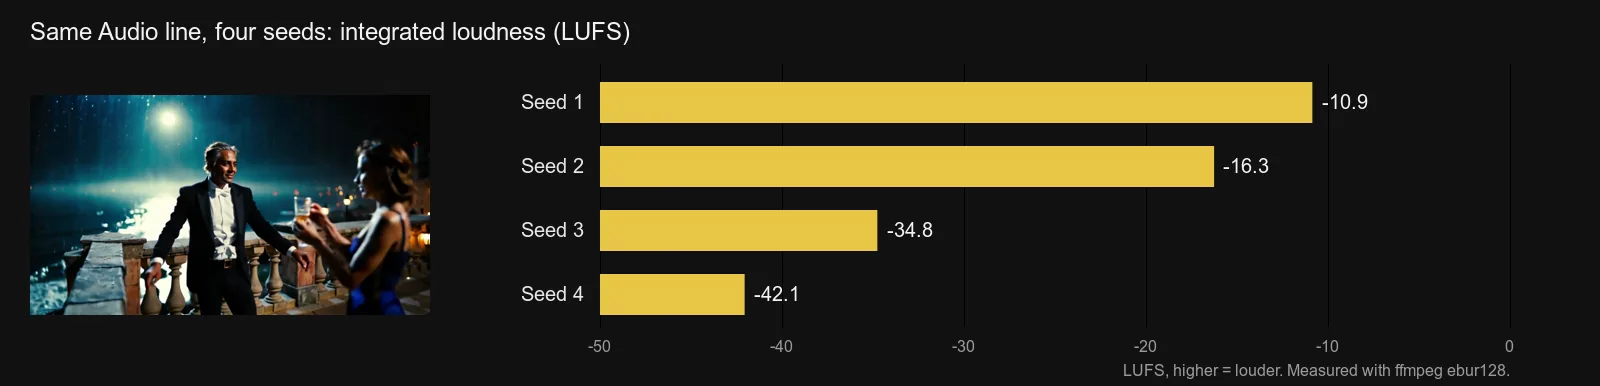
LTX-2 19B LoRA mit der Dolly-Out-Kamera-LoRA, Text-zu-Video, 720p, 5 Sekunden, vier Seeds. Die Audio-Zeile war identisch; die letzten beiden Prompts beschrieben zusätzlich beide Outfits genauer.
Über alle 55 Clips lag die integrierte Lautheit zwischen −42,1 und −8,3 LUFS mit einem Median von −13,2; 35 lagen innerhalb von 3 LU um den Median und 7 waren leiser als −20. Kein Clip erreichte mehr als −1,6 dBTP, nichts kam also übersteuert zurück. Die Formulierung allein entscheidet das nicht: Der lauteste und der leiseste Terrassenlauf hatten dieselbe Audio-Zeile, Wort für Wort.
Gleichen Sie also die Lautheit an, bevor Sie Clips zusammenfügen, im Studio-Editor oder mit einem Lautheits-Normalisierer. Sechs der 40 Beispiel-Clips endeten außerdem mindestens 15 dB unter ihrem lautesten Moment, alle aus Läufen mit geladener Kamera-LoRA. Prüfen Sie die Enden also, bevor Sie schneiden.
"Stereo" ist manchmal Mono
Jede Datei hat zwei Kanäle, aber in 14 der 55 waren die Kanäle praktisch identisch (Korrelation 0,99 oder mehr), und in 13 deutlich verschieden (unter 0,6). Alle vier Clips, die um einen gesprochenen Satz gebaut waren, waren faktisch Mono. Wenn die Breite zählt, prüfen Sie mit Kopfhörern.
Ohne Audio-Zeile bekommen Sie trotzdem Ton
Wir fuhren eine Maskenball-Szene zweimal mit einer Audio-Zeile (Streichquartett, Menge, Gläser, ihr Lachen) und zweimal ohne, auf denselben Seeds.
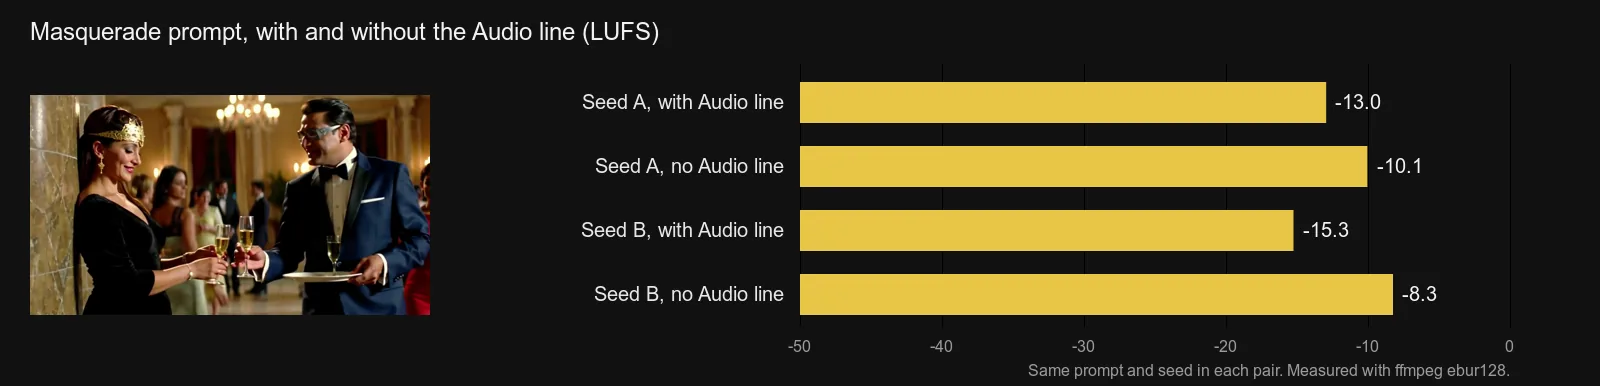
Text-zu-Video, 720p, 5 Sekunden, Seeds 610601 und 610602. Die beiden Clips ohne Audio-Zeile waren die lauteren.
Ohne die Zeile bekommen Sie trotzdem eine Spur; Sie wählen nur nicht, was darauf ist. Behalten Sie die Audio-Zeile, auch wenn der Ton nicht der Punkt ist.
Zwanzig Sekunden gehalten
Bei langen Clips wird ein separater Tondurchgang mühsam, deshalb fuhren wir einen 20-Sekunden-Clip in 480p.
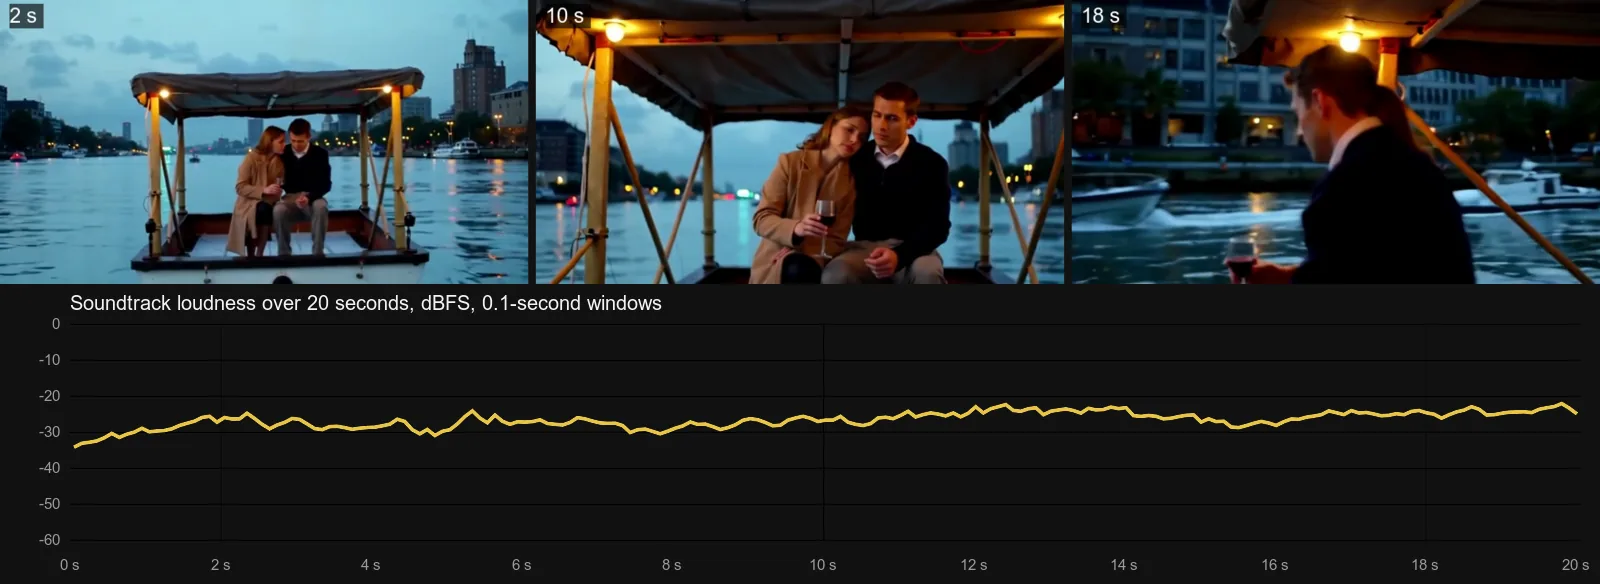
Text-zu-Video, 16:9, 480p, 20 Sekunden, Seed 610631. Jede halbe Sekunde Ton blieb zwischen −32,6 und −22,9 dBFS.
Der Ton hielt alle zwanzig Sekunden. Stattdessen driftete das Bild: Die langsame Annäherung ging weiter, bis sie größtenteils hinter ihm verborgen war. Der Clip kostete 0,288 $. Der Prompt, wie wir ihn fuhren, abzüglich einer Wendung "no on-screen text", die wir nicht mehr empfehlen (siehe nächster Abschnitt):
A houseboat on a river at dusk in light rain. An adult couple in their forties, a woman in a long camel coat and a man in a navy wool sweater, sit close under the canvas awning at the stern sharing a blanket, watching the city lights come on along the bank. He refills her glass of red wine; she leans her head on his shoulder; later a tour boat glides past and its wake rocks them gently. Wide shot, slow push-in, blue dusk with warm string lights, film grain. Audio: rain pattering on the canvas, water lapping against the hull, a distant radio playing old jazz, the low rumble of the passing boat and its wake slapping the side.Diesen Prompt auf LTX-2 19B Text-zu-Video ausführen →
Gesprochene Sätze und die Untertitel, um die niemand gebeten hat
Ein kurzer Satz lässt einen andeutenden Clip persönlich wirken. Wir baten eine Frau im cremefarbenen Seidenmorgenmantel, zur Kamera aufzublicken und leise zu sagen: "Stay. The rain isn't stopping tonight."
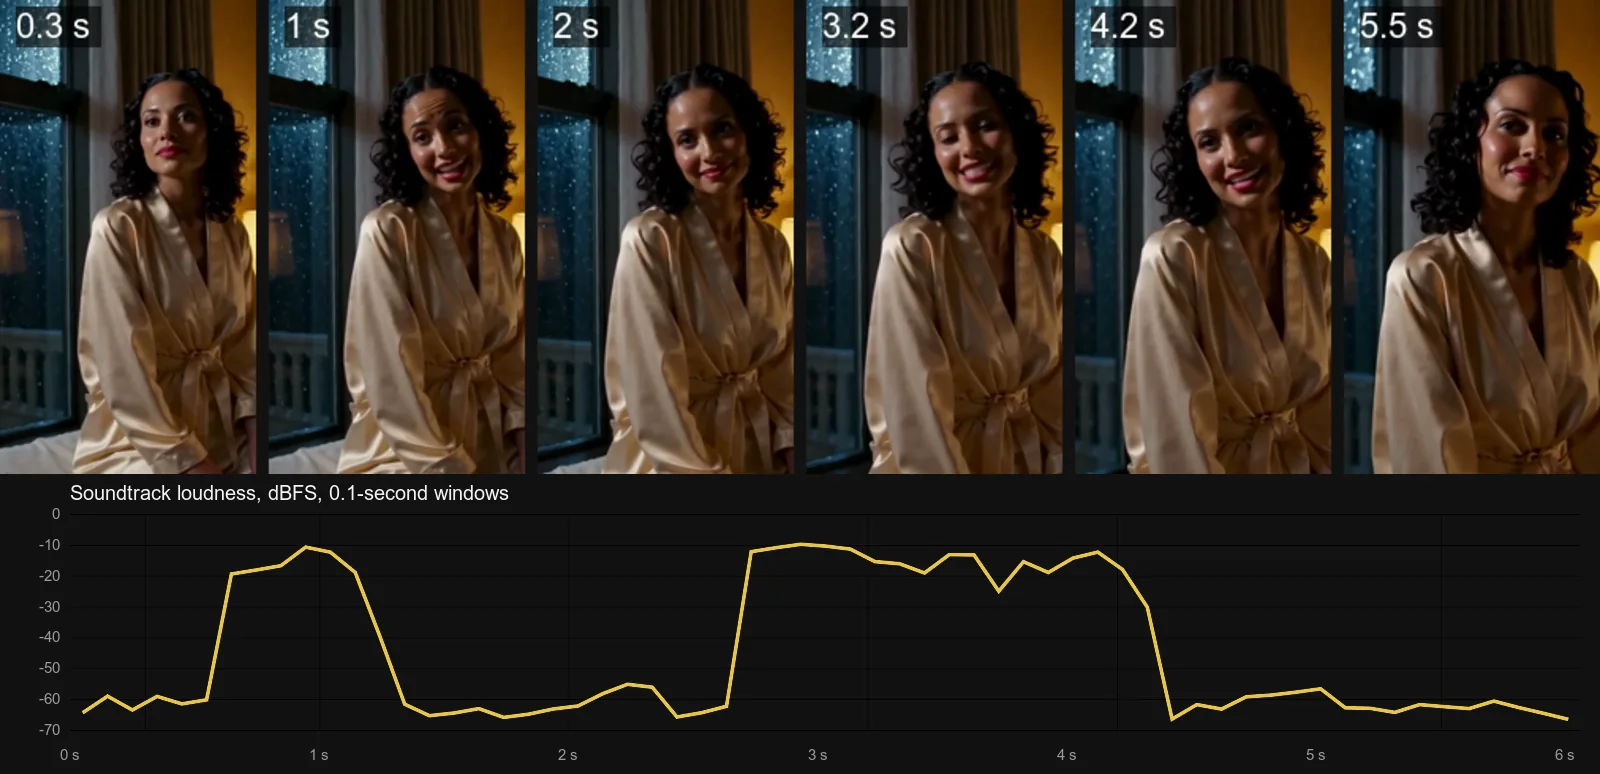
Text-zu-Video, 9:16, 480p, 6 Sekunden, Seed 610622, keine Untertitel-Wörter im Prompt.
Zwei laute Abschnitte passen zu einem in zwei Teilen gesprochenen Satz, aber die Worte haben wir nicht geprüft, hören Sie also hin, bevor Sie sich darauf verlassen. Was die Kurve zeigt: Der "steady rain on the glass", den wir verlangt hatten, lag nicht darunter, zwischen und nach den Ausbrüchen fiel der Pegel auf etwa −60 dBFS. Wenn eine Stimme da ist, kann sie die Spur übernehmen.
Die größere Überraschung war Text im Bild. Fünf unserer 15 kontrollierten Clips hatten erfundene eingebrannte Wörter:
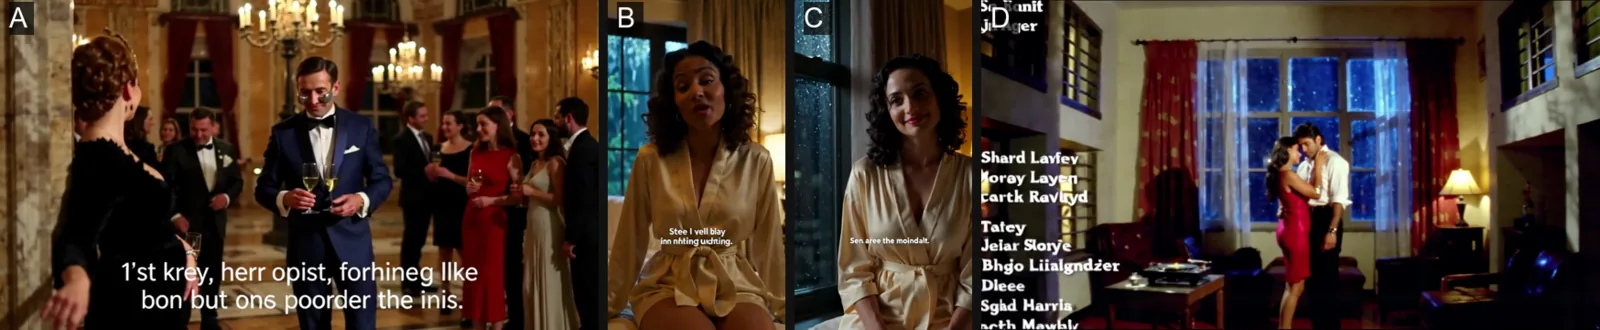
A: Maskenball-Prompt mit seiner Audio-Zeile, Seed 610601, nur die ersten 0,8 Sekunden. B und C: der Prompt mit gesprochenem Satz, ergänzt um "no subtitles, no captions, no on-screen text", beide Seeds. D: ein 1080p-Prompt über ein tanzendes Paar zu einer Schallplatte; sein zweiter Seed zeigte stattdessen Mitsing-Texte.
Elf der 15 Prompts endeten mit "no subtitles" oder "no on-screen text", und alle fünf Clips mit Untertiteln gehörten dazu; die vier Prompts ohne eine solche Wendung kamen sauber zurück. Derselbe Prompt mit gesprochenem Satz auf denselben zwei Seeds war ohne die Wendung sauber und mit ihr untertitelt. Sechs der elf waren ebenfalls sauber, und in einem früheren Durchgang kamen zwei Querformat-Clips mit "no subtitles" sauber zurück, auf dieser kleinen Stichprobe schützte die Wendung also nichts und hat den Text womöglich provoziert. Der Text ist immer Kauderwelsch, was zum Hinweis des Herausgebers passt, dass LTX-2 keinen lesbaren Text rendert.
- Lassen Sie Untertitel-Wörter aus dem Prompt weg. Sie verhinderten in unseren Läufen nichts.
- Prüfen Sie die erste und die letzte Sekunde. In Clip A hielt sich der Text 0,8 Sekunden; das Kürzen des Anfangs behob es.
- Wechseln Sie den Seed. Der zweite Seed des Maskenball-Prompts war sauber.
- Schauen Sie bei Prompts rund um einen Song zweimal hin. Beide 1080p-Clips eines Paares, das zu einer Schallplatte tanzt, kamen mit Credits oder Liedtext zurück.
Eingebauter Ton oder stummes Modell plus Tondurchgang?
Der andere Weg ist ein stummer Clip, zu dem Effekte, Stimme und Musik nachträglich kommen, wie in unseren Leitfäden zu Stimme und Musik für ein NSFW-KI-Video und zum Foley-Workflow für Soundeffekte. Ein fünfsekündiger Clip, Preise aus dem Live-Katalog und unsere Index-Scores:
| Weg | Ton | 5-Sekunden-Clip | Freedom-Score | Blindtest-Score |
|---|---|---|---|---|
| LTX-2 19B, 720p | Immer an, Stereo | 0,096 $ | 76,1 | 47,5 |
| MiniMax H3, 768p | Mit dem Clip erzeugt | 0,185 $ | 70,7 | 67,6 |
| Wan 3.0, 720p | Standardmäßig an, abschaltbar | 0,45 $ | 96 | 70,9 |
| Seedance 2.0 Fast, 720p | Standardmäßig an; aus senkt den Preis nicht | 0,48 $ | 72,2 | 68,6 |
| HunyuanVideo 1.5, 720p, dann Foley v1 | Stummer Clip, Effekte danach | 0,24 $ + 0,006 $ | 88,1 | 57,7 |
Freedom ist unser Score von 0 bis 100 dafür, wie viel der Adult-Inhaltsleiter ein Modell liefert; der Blindtest bewertet die Bildqualität mit verborgenen Modellnamen. Beide stammen aus unserem Live-Index, Stand 5. Oktober 2026; beim Zwei-Schritt-Weg sind es die von HunyuanVideo.
- Wählen Sie LTX-2 19B für viele günstige Entwürfe mit Ton. Es ist der günstigste Weg in der Tabelle, und ein fünfsekündiger 720p-Clip brauchte in unseren Läufen 14 bis 25 Sekunden. Der Preis dafür ist das Bild: Sein Blindtest-Score ist der niedrigste der fünf.
- Wählen Sie Wan 3.0, wenn Bildqualität und Spektrum bei Adult-Inhalten wichtiger sind als der Preis. Es kostet pro Sekunde ein Mehrfaches und liefert trotzdem Ton.
- Fügen Sie Ton nachträglich hinzu, wenn ein bestimmter Satz gesprochen werden muss oder Ihnen ein stummer Clip schon gefällt. Foley-Effekte kosten 0,0012 $ pro Sekunde.
Die strukturelle Grenze des eingebauten Wegs: Der Ton ist ins Rendering eingebacken, ein falsches Wort heißt also, das Bild erneut zu bezahlen.
Wie weit es geht
LTX-2 19B filtert weder Prompt noch Ergebnis. Auf unserer Leiter mit sieben Proben (L1 Andeutung, Dessous oder ein rutschender Träger; L2 Reife Themen; L3 Stark; L4 Intensiv, eine intime Szene zwischen zwei Erwachsenen; L5 Extrem, einvernehmliche Fesselung unter Erwachsenen oder filmisches Gore) lieferte Text-zu-Video L1, L2, L3 und die Fesselungsprobe wie geschrieben und schwächte L4, die Gore-Probe und die Probe mit einem Mann im Bild ab. Bild-zu-Video lieferte L1 und L3 und schwächte den Rest ab. Nichts wurde abgelehnt. Die vollständigen Ergebnisse stehen im Review zu LTX-2 19B; Kamerabewegungen und LoRA-Dateien behandelt unser Leitfaden zu LTX-2 19B LoRA. Die Leiter hatte keine tonspezifischen Signale, und Proben-Prompts drucken wir nicht ab.
Grenzen
- Die Lautheit ist unvorhersehbar. Normalisieren Sie jeden Clip, bevor Sie sie zusammenfügen.
- Untertitel können erscheinen, mit oder ohne die Wendung "no subtitles". Prüfen Sie bei jedem Treffer die erste und die letzte Sekunde.
- Zeitlich gesetzte Signale driften oder verschwinden. Binden Sie Geräusche an Handlungen im Bild.
- Kein Audio-Schalter, keine Audio-Eingabe.
- Stimmen können übernehmen. In unserem Clip mit gesprochenem Satz fehlte der verlangte Regen.
- Die Stereobreite schwankt. Manche Clips sind faktisch Mono.
- Das Bild liegt hinter teureren Modellen. Blindtest-Score 47,5.
- Wir haben den Ton gemessen, nicht beurteilt. Stimmen und Musik sind Sache Ihrer Ohren.
FAQ
Erzeugt LTX-2 19B Audio?
Ja. Jeder Clip hat eine AAC-Stereospur mit 24 kHz, die im selben Durchgang wie das Bild entsteht, auch bei Clips, deren Prompt den Ton nie erwähnt.
Wie schreibe ich einen Prompt für LTX-2 mit Ton?
Beschreiben Sie die Einstellung in vier bis acht Sätzen und beenden Sie mit einem Satz, der mit "Audio:" beginnt und jedes Geräusch nach seiner Quelle in der Reihenfolge benennt, in der es geschieht. Setzen Sie gesprochene Worte in Anführungszeichen und halten Sie sie kurz.
Welche KI-Videogeneratoren erzeugen Ton, und welche sind unzensiert?
Auf SpicyAPI tut es LTX-2 19B immer, und auch Wan 3.0, Seedance 2.0 Fast und MiniMax H3 erzeugen Ton mit dem Clip. Alle vier haben in unserem Index einen Freedom-Score (70,7 bis 96); sie unterscheiden sich bei Preis, Bildqualität und darin, wie weit sie gehen.
Kann KI aus einer Audiodatei ein Video machen?
Auf diesem Weg nicht: LTX-2 19B nimmt einen Prompt oder ein Foto. Um ein Gesicht einen Satz sagen zu lassen, den Sie schon haben, nutzen Sie Lippensynchronisation auf einem fertigen Clip, wie in unserem Leitfaden zu Stimme und Musik.
Wie lang kann ein Clip mit Ton sein?
5 bis 20 ganze Sekunden bei 480p, 720p oder 1080p. Unser 20-Sekunden-Clip hatte durchgehend Ton, und ein 20-Sekunden-Clip in 480p kostet 0,288 $.
Kann ich den Ton ausschalten?
Nein. Drehen Sie das Audio des Clips im Video-Editor herunter oder entfernen Sie die Spur nach dem Download.
Warum hat mein KI-Video zufällige Untertitel?
Das Modell brennt manchmal erfundenen Text ins Bild ein, und "no subtitles" zu schreiben, verhinderte es in unseren Läufen nicht. Wechseln Sie den Seed, kürzen Sie die betroffene Sekunde und lassen Sie Untertitel-Wörter aus dem Prompt weg.