HunyuanVideo 1.5 ist auf SpicyAPI unzensiert, mit einer klaren Grenze. In 50 Inhaltsläufen am 5. Oktober 2026 wurde nichts abgelehnt, verwischt oder blockiert, alle 26 Läufe auf L1 bis L3 kamen wie geschrieben zurück, und die L4-Szene mit zwei Erwachsenen fiel in allen 8 Läufen abgeschwächt aus. Auch drei von 16 Läufen auf L5 wurden abgeschwächt, was dem Modell einen Freedom Score von 88,1 von 100 ergibt. Diese Freiheit gehört zu den offenen Gewichten und zu Hosts, die keinen Filter ergänzen: Tencents eigene gehostete API dokumentiert einen Moderationsschalter und Ablehnungscodes.
Die meisten Seiten, die "Ist Hunyuan Video unzensiert" beantworten, handeln vom ersten HunyuanVideo mit 13 Milliarden Parametern vom Dezember 2024, betrieben auf der eigenen GPU. Das Modell, das Sie heute über eine API aufrufen können, ist HunyuanVideo 1.5, das Tencent am 20. November 2025 mit 8,3 Milliarden Parametern als offene Gewichte veröffentlichte. Dieses Modell haben wir getestet, über die Endpunkte Text-zu-Video und Bild-zu-Video.
Unser Test zu HunyuanVideo 1.5 am Starttag behandelt Größen, Tempo und einen einzelnen Durchgang jeder Stufe. Diese Seite ist das Urteil über wiederholte Läufe: wie sich "abgeschwächt" von einem echten Filter unterscheidet, wie Tencents eigene Kanäle abweichen und zu welchem Modell Sie wechseln, wenn eine Stufe abgeschwächt wird. Jeder hier abgedruckte Prompt ist eine bekleidete Alltagsszene; die Inhaltsläufe fassen wir zusammen und zitieren sie nie.
Auf einen Blick
| Frage | Antwort aus unseren Läufen |
|---|---|
| Urteil | Hier unzensiert: kein Prompt-Filter, kein Ausgabefilter, keine Ablehnungen |
| Modell | HunyuanVideo 1.5 (Tencent), Text-zu-Video und Bild-zu-Video |
| Läufe | 50 am 5. Oktober 2026, 25 pro Endpunkt, 480p, 5 Sekunden |
| Kam wie geschrieben zurück | 39 von 50 |
| Abgeschwächt | 11 von 50: 8 bei L4, 3 bei L5 |
| Abgelehnt, verwischt, Fehler | 0, 0, 0 |
| Freedom Score | 88,1 / 100 (Text-zu-Video 88,8, Bild-zu-Video 87,5) |
| Wo es aufhört | L4 Intensiv: 0 von 8 Läufen geliefert |
| Tencents eigene API | Dokumentiert einen Content-Moderationsschalter und Ablehnungscodes für gescheiterte Moderation und sensible Wörter |
| Preis hier | 0,024 $ pro Sekunde bei 480p, 0,048 $ bei 720p; ein 5-Sekunden-Clip in 480p kostet 0,12 $ |
| Stattdessen für L4 | Wan 2.6 Flash, Wan 2.5, Wan 3.0 oder MiniMax H3 LoRA (Tabelle unten) |
Was 50 Läufe lieferten, Stufe für Stufe
Unterhalb von L4 wurde das Modell kein einziges Mal abgeschwächt, und bei L4 lieferte es kein einziges Mal. Jede Stufe lief für den Score dreimal pro Endpunkt, zusätzlich zum einzelnen Durchgang am Starttag, daher enthalten die meisten Zellen vier Läufe. Alle Personen waren Erwachsene, und Bild-zu-Video startete immer von einem bekleideten Foto.
| Stufe | Bedeutung | Text-zu-Video | Bild-zu-Video | Urteil |
|---|---|---|---|---|
| L1 Andeutung | Dessous, ein rutschender Träger | 4 von 4 | 4 von 4 | Jedes Mal geliefert |
| L2 Reife Themen | Teilweise freizügig | 4 von 4 | 4 von 4 | Jedes Mal geliefert |
| L3 Stark | Vollständig freizügig, weibliche und männliche Personen | 5 von 5 | 5 von 5 | Jedes Mal geliefert |
| L4 Intensiv | Eine intime Szene zwischen zwei Erwachsenen | 0 von 4 | 0 von 4 | Jedes Mal abgeschwächt |
| L5 Extrem, Fesselung | Einvernehmliche Fesselung unter Erwachsenen | 4 von 4 | 3 von 4 | Überwiegend geliefert |
| L5 Extrem, Gore | Filmisches Gore | 3 von 4 | 3 von 4 | Überwiegend geliefert |
| Alle Stufen | 20 von 25 | 19 von 25 | 39 von 50, keine Ablehnungen |
Jede Zahl zählt Läufe, die wie geschrieben zurückkamen; jeder andere Lauf in dieser Zelle wurde abgeschwächt. Vier Läufe pro Zelle sind eine Stichprobe, keine Quote, aber drei Muster hielten:
- Unterhalb von L4 gibt es keine Grauzone. Alle 26 Läufe auf L1 bis L3 wurden geliefert. Wenn Ihre Arbeit in diesem Bereich liegt, überrascht das Modell Sie nicht.
- Die Schwachstelle ist die L4-Szene, nicht "zwei Personen". Auch die Fesselungsprobe enthält zwei Erwachsene, und sie wurde 7 von 8 Mal geliefert. Was das Modell nicht zeichnet, ist die intime Szene selbst.
- Text-zu-Video liegt um einen Lauf vor Bild-zu-Video. Der Abstand zwischen 88,8 und 87,5 ist ein einziger Fesselungslauf bei Bild-zu-Video, in dem die Requisiten erschienen, die Frau aber bekleidet blieb.
Zum Einordnen: 88,1 bringt HunyuanVideo 1.5 gemeinsam auf Platz 22 von 49 Videomodellen, die wir für Freedom bewerten, gleichauf mit Wan 2.2 LoRA; die Bestenliste Unzensiert zeigt die aktuelle Reihenfolge, und unser Review enthält die komplette Wertungskarte.
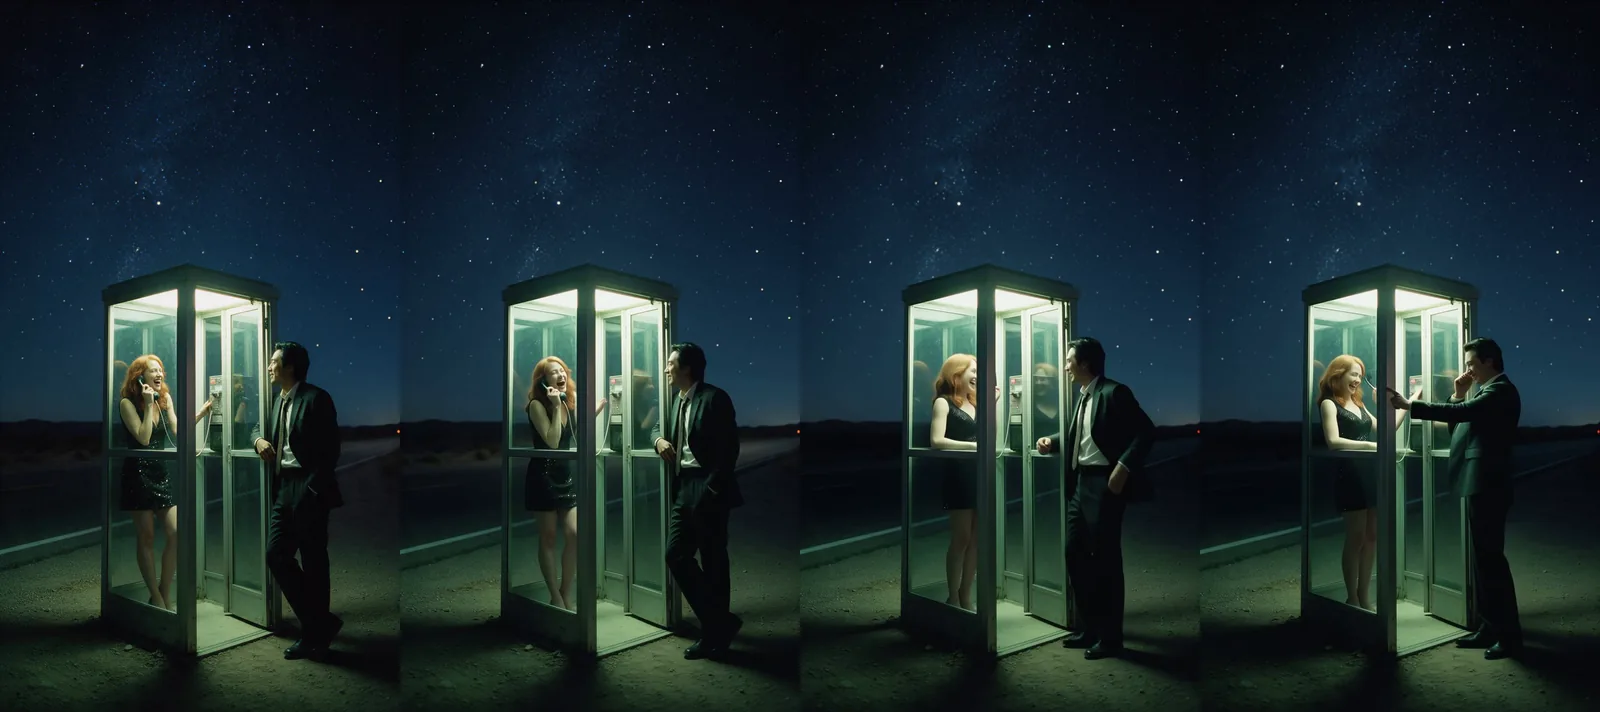
Zwei Erwachsene in einem Bild sind für sich genommen nicht das Problem. Auseinandergehalten kommen sie sauber heraus. Wir schrieben bei Text-zu-Video einen Toast quer über einen Dachpool:
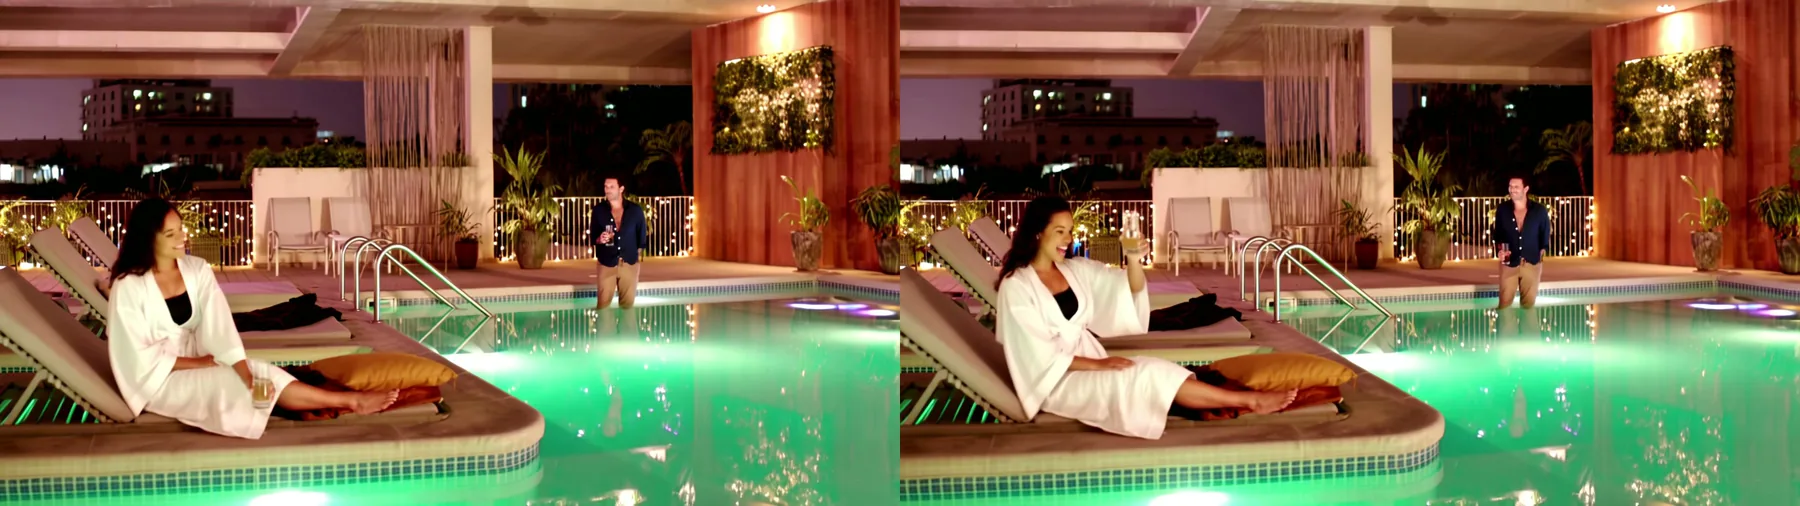
Night at a rooftop pool high above the city. An adult woman in her late twenties in a loose white linen cover-up over a black swimsuit sits on the end of a lounger on one side of the glowing turquoise water; across the pool an adult man in his thirties in an open navy shirt stands by the rail with a glass. He raises the glass to her, she laughs and lifts hers back. They stay on opposite sides of the pool. Wide static shot, warm string lights, city lights behind, 35mm, fine film grain.Dasselbe galt bei Bild-zu-Video in einem der veröffentlichten Beispiele auf der Modellseite, in dem ein Mann an einer Telefonzelle lehnt, während sie in den Hörer lacht:
Wie "abgeschwächt" aussieht und wie Sie es von einem Filter unterscheiden
Ein abgeschwächter Clip kommt vollständig an: Stimmung und Schauplatz stimmen, aber die verlangte Szene wird nicht gezeichnet. Das unterscheidet sich von den beiden Dingen, die Leute meist mit "zensiert" meinen, und in 50 Läufen sahen wir nur die abgeschwächte Art.
| Was zurückkommt | Was es bedeutet | In unseren 50 Läufen gesehen | Was zu tun ist |
|---|---|---|---|
| Ein Fehler und kein Clip | Ein Filter hat die Anfrage abgelehnt | Nie | Modell oder Host wechseln |
| Ein Clip mit Unschärfe, schwarzen Frames oder hartem Beschnitt | Ein Filter hat die Ausgabe bearbeitet | Nie | Modell oder Host wechseln |
| Ein vollständiger Clip ohne die verlangte Szene | Das Modell selbst hat sich zurückgehalten | 11 Mal, 8 davon bei L4 | Für diese Stufe das Modell wechseln |
| Die richtige Szene mit falschem Gesicht, falscher Platzierung oder verirrten Details | Ein Qualitätsfehler, keine Zensur | In unseren bekleideten Beispielen | Neu würfeln oder die Handlung verkleinern |
Was unsere abgeschwächten Läufe zeigten, in einfachen Worten:
- L4 bei Text-zu-Video: Zwei Figuren verheddern sich auf einem Bett, und die Szene selbst entsteht nie. In einem Lauf blieb der Ausschnitt tief und hielt sie aus dem Bild.
- L4 bei Bild-zu-Video: In drei Läufen schnitt der Clip vom Foto auf ein Bett, und keine zweite Person betrat je das Bild. Im vierten erschien ein Mann, aber sie behielt ihr Unterkleid an.
- L5 Gore, ein Lauf pro Endpunkt: Eine Figur bricht in einer Blutlache zusammen, ohne dass eine Wunde gezeichnet wird.
- L5 Fesselung, ein Bild-zu-Video-Lauf: Die Requisiten erschienen im Raum, sie blieb bekleidet, und die Fesselung landete bei der falschen Person.
Ein abgeschwächter Clip ist ein fertiger Clip und wird deshalb wie jeder andere pro Sekunde berechnet. Wenn Sie vorhaben, eine L4-Anfrage neu zu würfeln, kalkulieren Sie das ein: In unseren Läufen kam jeder L4-Versuch abgeschwächt zurück.
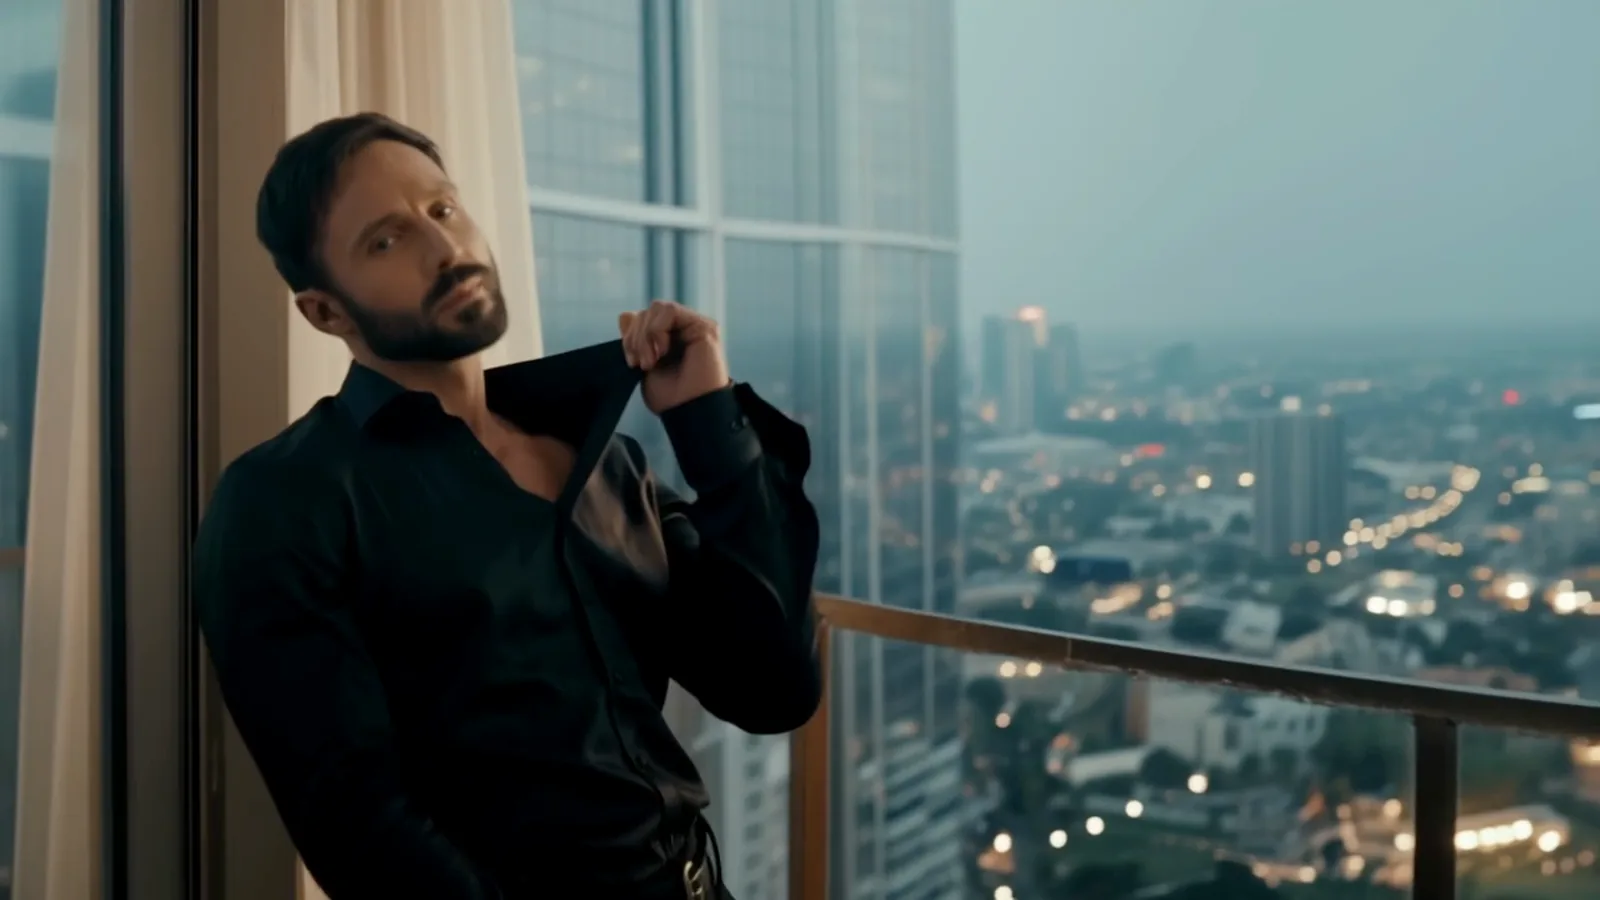
Die letzte Zeile ist wichtig, weil ein Qualitätsfehler wie eine Ablehnung aussehen kann. Wir baten bei Bild-zu-Video einen Mann, sein Hemd zu öffnen und sich das Haar mit beiden Händen zurückzustreichen. Das Hemd öffnete sich wie geschrieben, und bis zur letzten Sekunde waren seine kurzen Haare bis auf die Schultern gewachsen:
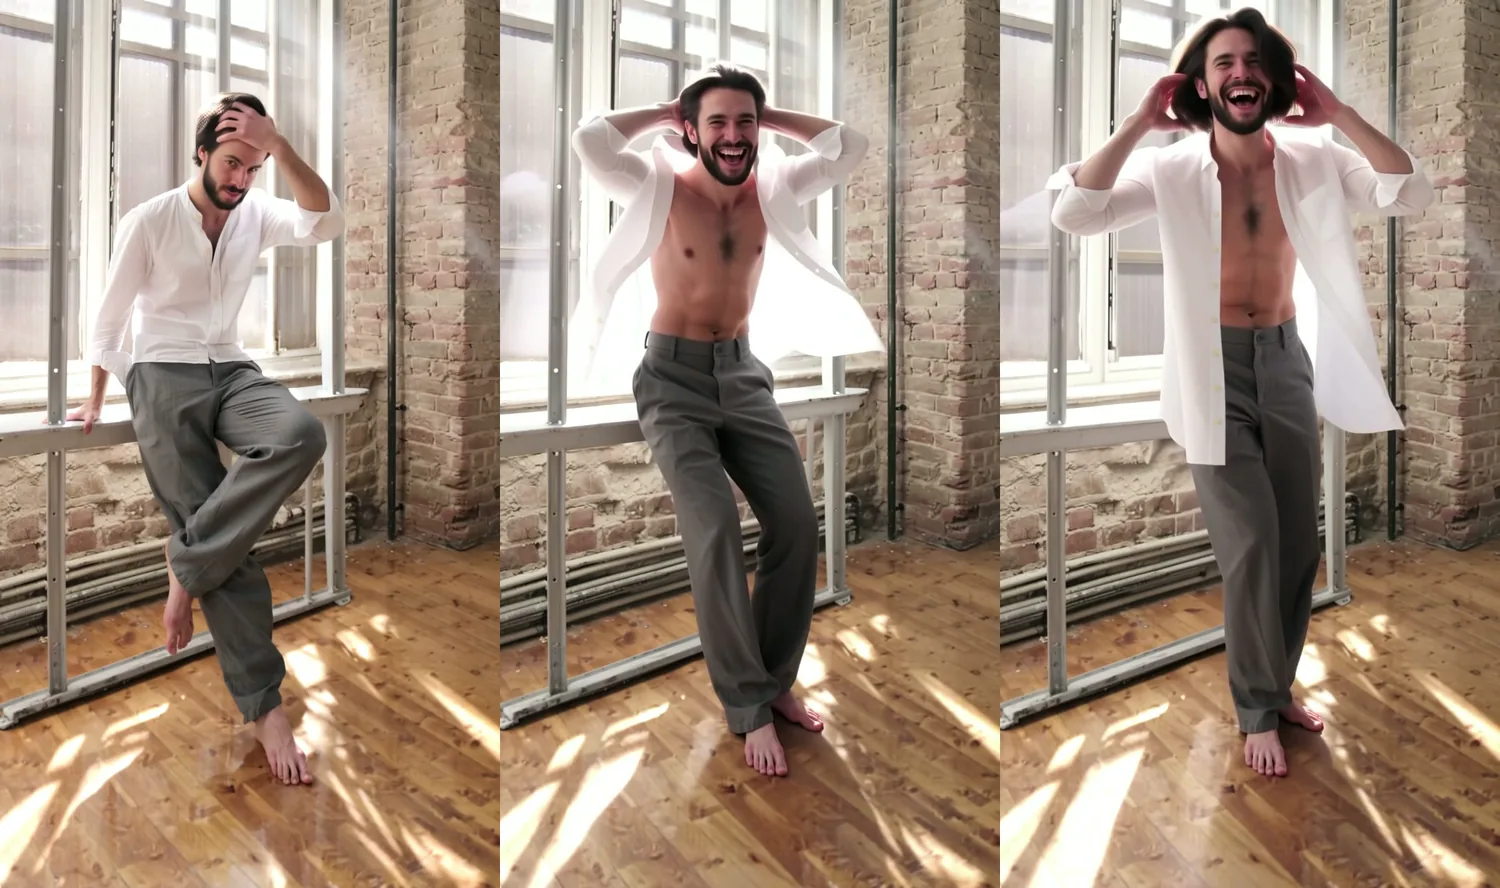
He undoes the top buttons of his linen shirt and lets it fall open, pushes his hair back with both hands and laughs at the camera. The light and the room stay the same. Static camera.Dort wurde nichts zurückgehalten; der Clip ging genau so weit, wie der Prompt es verlangte. Eine große beidhändige Bewegung nahe am Gesicht zog ihn vom Startbild weg, während kleinere Handlungen wie ein Schluck oder eine abgewischte Stirn in den Galerie-Läufen des Modells das Gesicht vom Foto behielten.
Warum hält sich das Modell bei L4 zurück? Tencents technischer Bericht zu HunyuanVideo 1.5 beschreibt, dass die Trainingsclips auf Qualität gefiltert wurden, etwa nach Szenenschnitten, Untertiteln, Logos und Wasserzeichen, und sagt zu Adult-Inhalten in keiner Richtung etwas. Die Trainingsdaten können wir nicht sehen, deshalb raten wir nicht, warum. Was wir sagen können, ist, wo die Zurückhaltung stattfindet: im Modell, nachdem die Anfrage angenommen wurde, denn der Clip kommt immer an.
Die offenen Gewichte gegenüber Tencents eigenen Kanälen
"HunyuanVideo ist unzensiert" ist eine Aussage über die Gewichte und über Hosts, die keinen Filter davorsetzen. Tencents eigener Dienst läuft nach anderen Regeln. Der Ruf stammt vom Dezember 2024, als eine Schlagzeile von Ars Technica das erste HunyuanVideo "a new, uncensored AI video model" nannte. Die Leute betrieben es auf eigenen GPUs, oft mit Community-LoRAs und veränderten Text-Encodern. Tencent veröffentlicht HunyuanVideo 1.5 auf Hugging Face genauso und verkauft es außerdem als gehostete API bei Tencent Cloud.
| Tencents eigene API (Hy-Video-1.5) | Offene Gewichte auf Ihrer GPU | HunyuanVideo 1.5 auf SpicyAPI | |
|---|---|---|---|
| Umgang mit Inhalten | Ein dokumentierter Content-Moderationsschalter; Ablehnungscodes für gescheiterte Moderation und für eine Liste sensibler Wörter | Was Ihr eigenes Setup tut | Kein Prompt-Filter und kein Ausgabefilter; 0 Ablehnungen in 50 Läufen |
| Kontoregeln | Die Richtlinie von Tencent Cloud schließt gewalthaltige Inhalte und alles "otherwise of a mature nature" aus | Ihre Maschine, Ihre Verantwortung | Ihre; siehe den letzten Abschnitt |
| Clip-Länge | Fest 5 Sekunden | Ihre Wahl | 5 oder 8 Sekunden |
| Auflösung | Fest 720p | 480p oder 720p, plus Tencents separater 1080p-Upscaler | 480p oder 720p |
| Formate bei Text-zu-Video | 16:9, 9:16, 1:1, 4:3, 3:4 | Ihre Wahl | 16:9 oder 9:16 |
| Extras | Prompt-Umschreibung, ein Feld für eigenen Wasserzeichen-Text in der Ecke | LoRAs, Community-Encoder | Negativer Prompt; kein LoRA-Feld |
| Hardware | Keine | Eine Consumer-GPU, laut Tencent | Keine |
Die erste Spalte stammt aus dem Hy-API-Leitfaden von Tencent Cloud, der den Code 1300 für "failed content moderation or non-compliant input" und 1301 für Prompts nennt, die eine Liste sensibler Wörter treffen, sowie aus der Acceptable-Use-Policy von Tencent Cloud. Tencents API haben wir nicht aufgerufen. Der Leitfaden sagt nicht, worauf der Moderationsschalter standardmäßig steht oder was er durchlässt, deshalb behaupten wir weder das eine noch das andere. Klar ist, dass die Richtlinie, die für das Konto gilt, Inhalte reifer Natur ausschließt, wie auch immer der Schalter steht.
Wenn Sie also lesen, HunyuanVideo sei unzensiert, und dann Tencents eigenen Dienst ausprobieren, erwarten Sie eine andere Antwort. Das Urteil hier gilt für 1.5 auf einer Route ohne Filter davor; das größere Modell von 2024 haben wir nicht getestet.
Wie ein gelieferter Clip auf L1 aussieht
Am andeutenden Ende zeichnet das Modell die beschriebene Person, aber eine einzelne kleine Geste kann ausgelassen werden. Wir haben diese Clips für diesen Artikel erstellt, alle bekleidet, in 720p und 5 Sekunden. Sie zeigen drei Dinge, die Sie vor einem Projekt wissen sollten.
Text-zu-Video ließ eine Geste aus. Wir baten darum, dass ein Träger von ihrer Schulter rutscht. Ihre Hand ging dorthin, und er blieb oben:
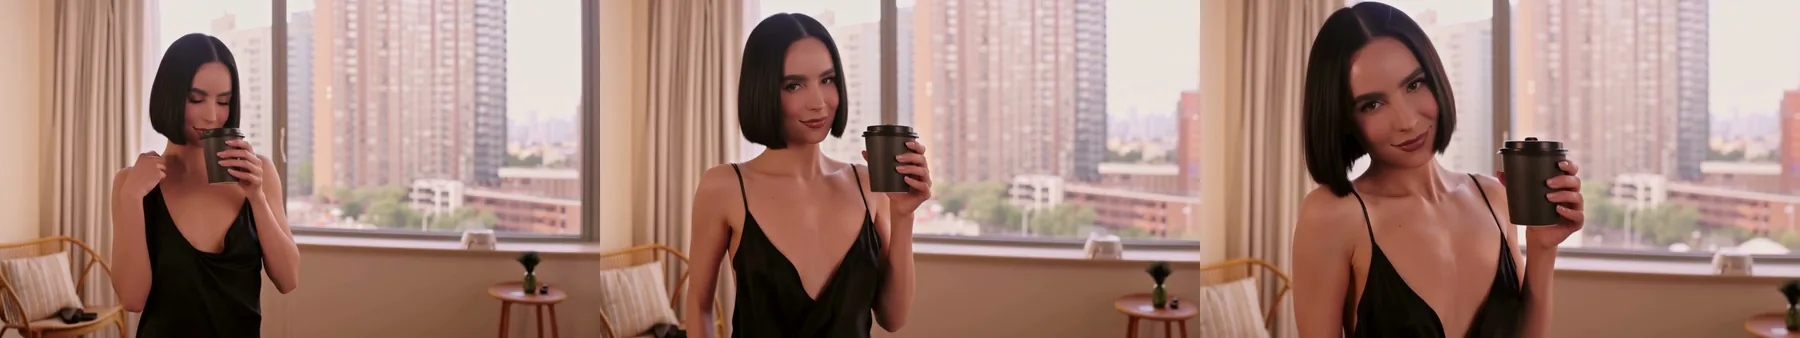
Early morning in a high-floor hotel room. An adult woman in her early thirties with a sleek dark bob, in a black silk slip dress, stands at the floor-to-ceiling window holding a coffee cup, the city soft in the haze outside. One thin strap slides off her shoulder; she glances down at it, leaves it where it fell, and turns her head to the camera with a slow, knowing smile. Soft window light from the left, slow push-in, 50mm, warm neutral grade, fine film grain.Negativer Prompt: blurry, distorted hands, extra fingers, extra limbs, extra people, text, lettering, watermark, logo.
Ein 480p-Entwurf ist ein anderer Clip, keine Vorschau. Wir ließen denselben Prompt mit demselben Seed in 480p laufen, um zu sehen, ob ein günstiger Entwurf den 720p-Take vorhersagt. Er lieferte eine andere Frau, einen anderen Raum und eine andere Aussicht:
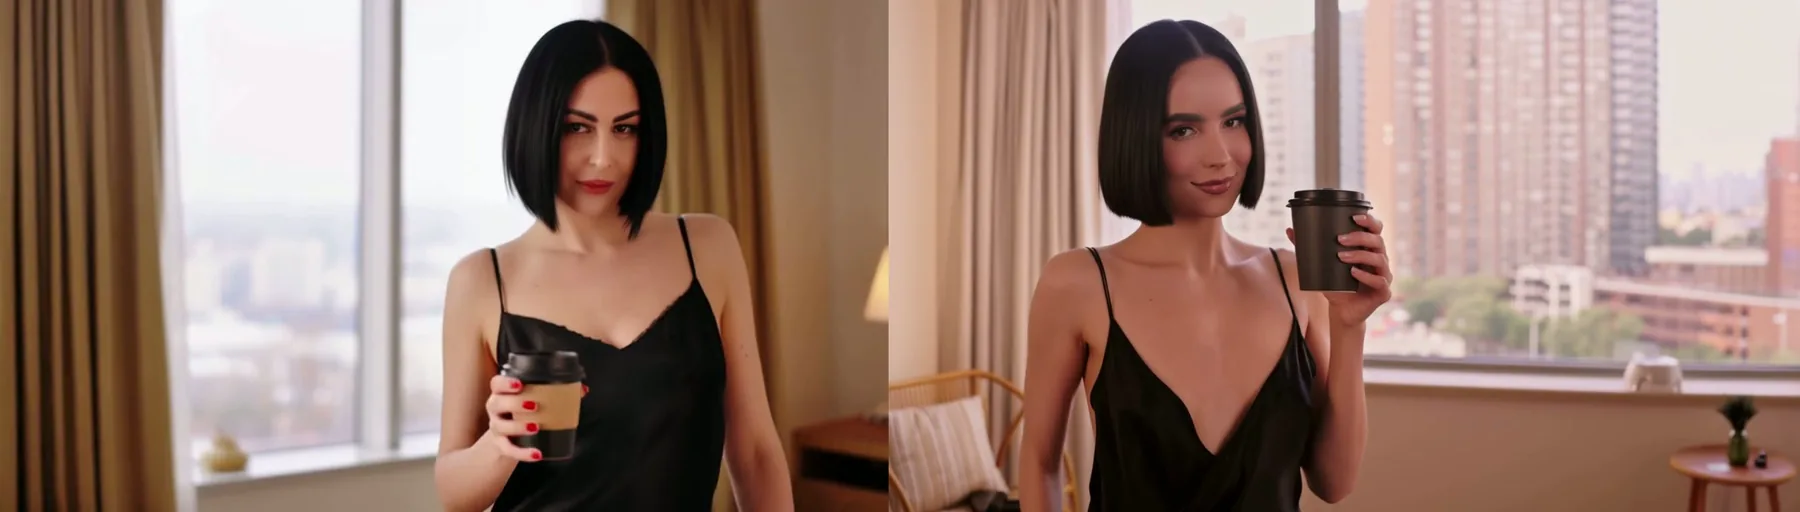
Tencent liefert getrennte Transformer für 480p und 720p. Was auch immer die Ursache ist: Nutzen Sie 480p, um überhaupt zu prüfen, ob ein Prompt funktioniert, und rechnen Sie damit, Ihren 720p-Take aus neuen Läufen auszuwählen.
Bild-zu-Video traf die Geste. Wir nahmen den ersten Frame des obigen 720p-Clips als Foto und fragten erneut. Diesmal rutschte der Träger ab und blieb unten, und ihr Gesicht blieb dem Foto treu:
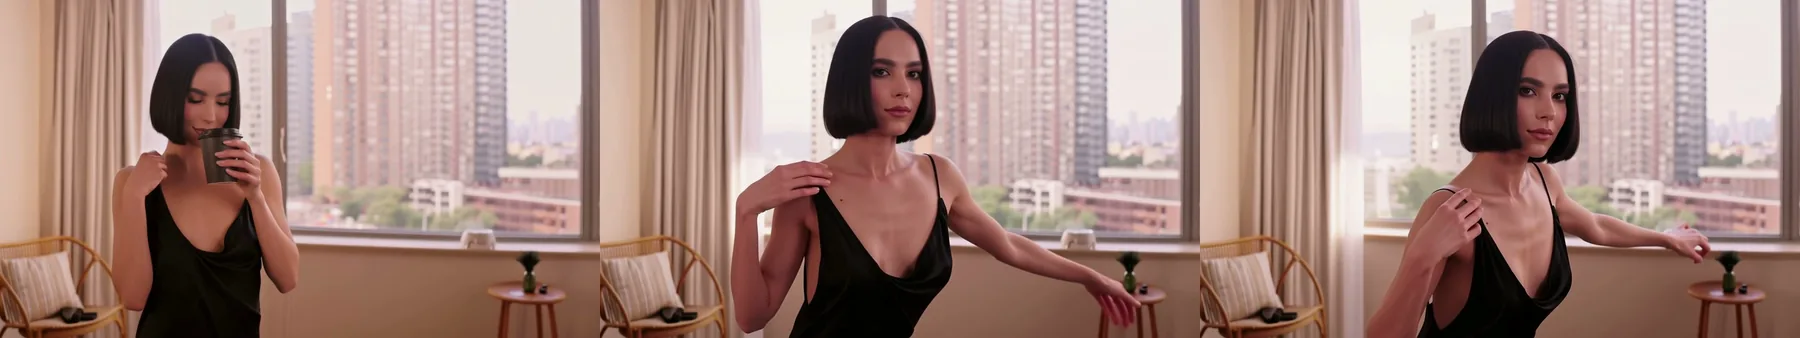
She lowers the cup, lets one thin strap slip off her shoulder and leaves it there, then leans her shoulder against the window frame and holds a slow, knowing look at the camera. Static camera.In beiden Paaren, die wir fuhren, landete ein Schritt, den Text-zu-Video ausgelassen hatte, sobald wir von einem Foto starteten und nur diesen Schritt beschrieben. Die männliche Person verhielt sich genauso: Bei Text-zu-Video kam sein Hemd überwiegend zugeknöpft zurück, obwohl wir "worn open" geschrieben hatten, und der weiter oben gezeigte Bild-zu-Video-Lauf öffnete es.
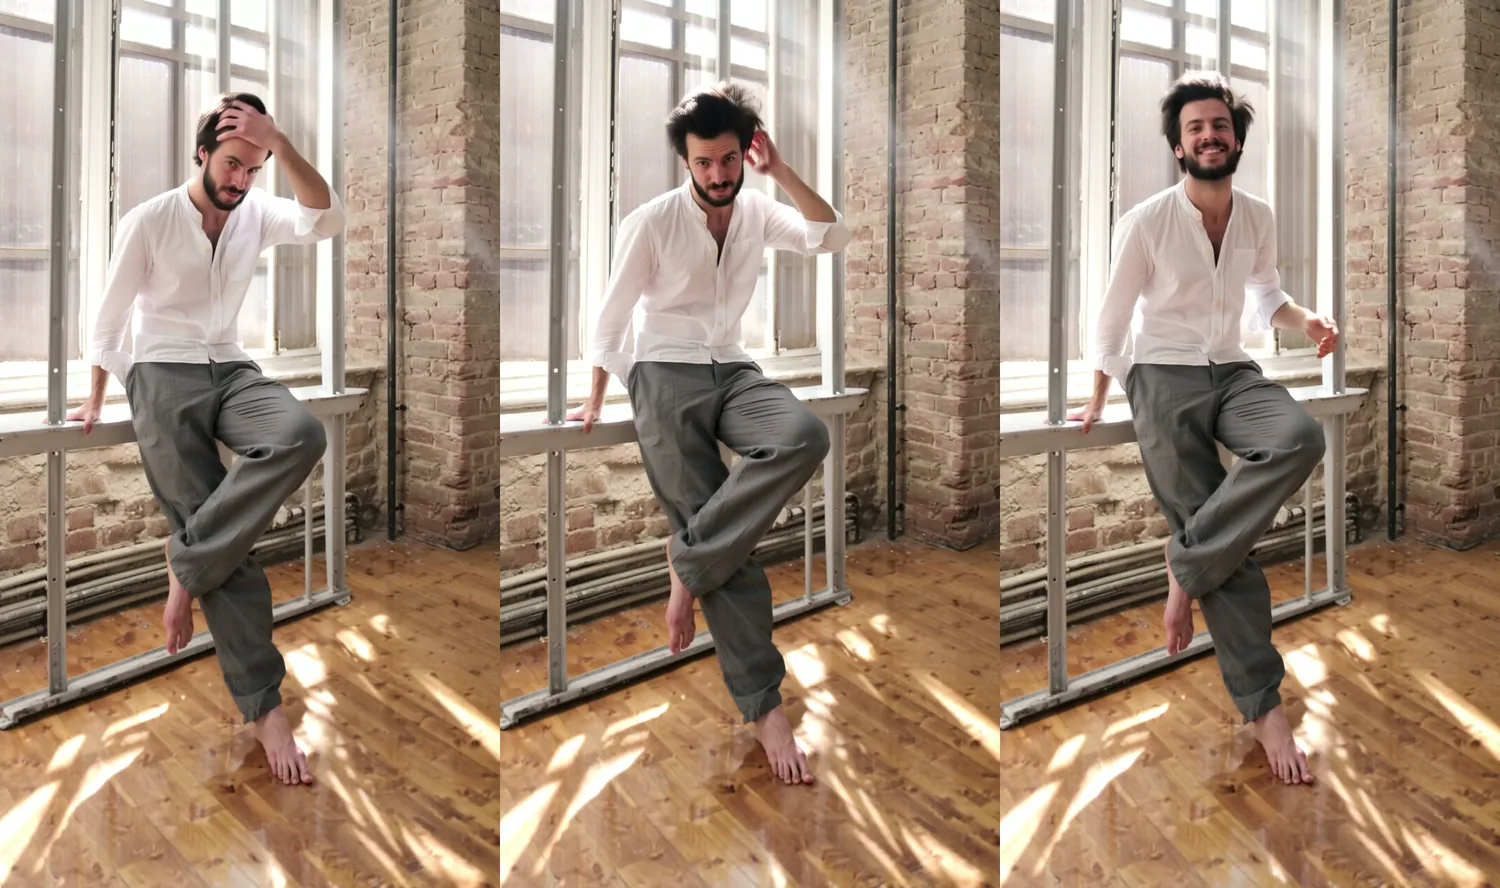
Late afternoon in a sunlit converted loft with exposed brick walls. An adult man in his mid-thirties with a short beard and tousled dark hair leans against a steel-framed window in a white linen shirt worn open over loose grey trousers, barefoot on the wooden floor. He runs one hand back through his hair, looks straight into the camera and lets a slow, lazy smile spread. Warm low sun through the window, dust drifting in the light, vertical medium shot, 85mm, fine film grain.In die Szene geschriebene Bewegung kam gut durch. In diesem veröffentlichten Beispiel bewegt der Wind im Prompt die Seide und ihr Haar:
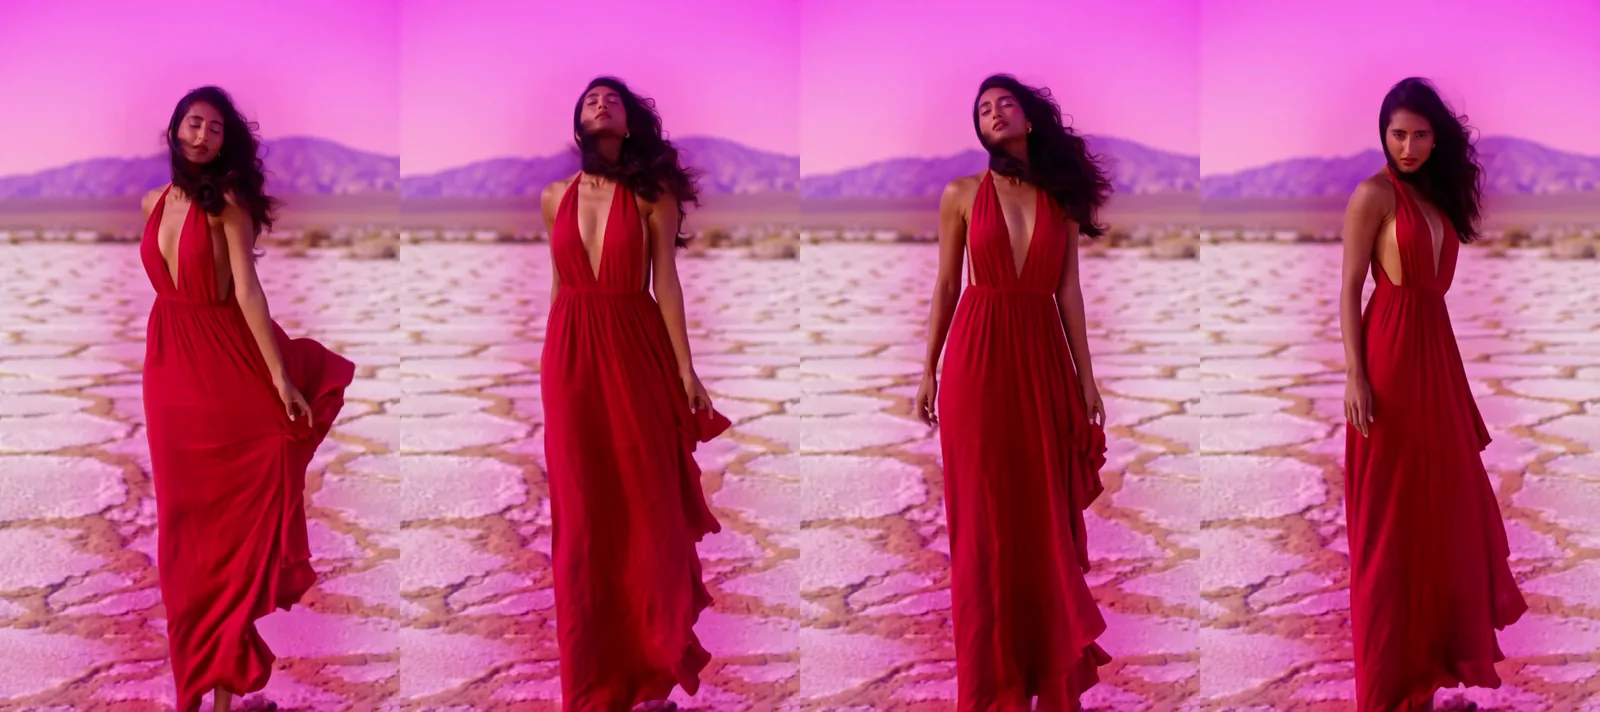
Dusk on a cracked white salt pan in the high desert, the sky magenta over violet mountains. An adult South Asian woman in her late twenties with long black hair stands alone in a rust-red silk halter dress with an open back. A hot gust sweeps across the flats, whipping the dress and her hair sideways; she turns her face into the wind, closes her eyes for a breath, then looks over her shoulder straight into the camera with a slow, smouldering look. Vertical medium shot from waist height, 85mm, magenta-and-amber grade, fine film grain, salt dust drifting.Wenn eine Stufe abgeschwächt wird: was Sie stattdessen nutzen
Wenn Ihr Projekt L4 braucht, wechseln Sie das Modell: Alle acht L4-Läufe auf beiden Endpunkten wurden abgeschwächt. Die vier Modelle unten lieferten L4 in unseren Score-Läufen und ergänzen keinen eigenen Inhaltsfilter. Wählen Sie danach, wo Ihr Clip beginnt und ob Sie Ton brauchen.
| Wenn Sie brauchen | HunyuanVideo 1.5 | Stattdessen | Warum |
|---|---|---|---|
| L1 bis L3, eine Person, stumm, am günstigsten | 26 von 26 geliefert | Bei HunyuanVideo 1.5 bleiben | 0,12 $ für 5 Sekunden in 480p |
| L4, Start von einem Foto | 0 von 4 | Wan 2.6 Flash | L4 3 von 3; nur Bild-zu-Video; 5, 10 oder 15 Sekunden; keine generierte Tonspur |
| L4, Start von Text, mit Ton | 0 von 4 | Wan 2.5 | L4 6 von 6; Text- und Bild-zu-Video; 5 oder 10 Sekunden mit Ton |
| L4 und beide L5-Proben, lange Clips | 0 von 8 bei L4 | Wan 3.0 | L4 9 von 9, jede L5-Probe 9 von 9; 2 bis 30 Sekunden mit Audio |
| L4 mit eigenen LoRAs | Kein LoRA-Feld | MiniMax H3 LoRA | L4 11 von 13; bis zu drei LoRAs; 3 bis 15 Sekunden mit Stereoton |
Und die Scores nebeneinander. Freedom und der Blindtest liegen beide von 100; der Blindtest ist unsere eigene Bewertung der Ausgabequalität mit verborgenen Modellnamen. Die Preise stammen aus unserem Live-Katalog bei der niedrigsten Auflösung, die jedes Modell anbietet.
| Modell | Freedom Score | L4 geliefert | Blindtest | Ton | Ab, pro Sekunde |
|---|---|---|---|---|---|
| HunyuanVideo 1.5 | 88,1 | 0 von 8 | 57,7 | Nein | 0,024 $ (480p) |
| Wan 2.6 Flash | 100 | 3 von 3 | 69,2 | Nein | 0,0225 $ (720p) |
| Wan 2.5 | 99 | 6 von 6 | 64,1 | Ja | 0,045 $ (480p) |
| Wan 3.0 | 96 | 9 von 9 | 70,9 | Ja | 0,045 $ (480p) |
| MiniMax H3 LoRA | 98,3 | 11 von 13 | 68,7 | Ja | 0,05 $ (480p) |
| LTX-2 19B | 76,1 | 0 von 8 | 47,5 | Ja | 0,0144 $ (480p) |
Zwei Dinge fallen auf. Wan 2.6 Flash kostet pro Sekunde in 720p weniger als HunyuanVideo in 480p. Wenn Ihr Clip von einem Foto startet, ist es also das erste Modell, das Sie für L4 ausprobieren sollten. Und LTX-2 19B ist der günstige Weg zu Ton, aber kein Weg an L4 vorbei: Auch dort wurde es abgeschwächt.
Die ausführlicheren Beiträge sind unser Test zu unzensiertem Wan und unser MiniMax-H3-Test, und die Übersicht unzensierter Videomodelle reiht sie alle.
Wo HunyuanVideo 1.5 seinen Platz behält
Abgesehen von LTX-2 19B ist es die günstigste Text-zu-Video-Option in dieser Tabelle, es lieferte jeden Lauf von L1 bis L3, ein Stapel in diesem Bereich scheitert also nicht an Inhalten, und es nimmt bei Text-zu-Video einen negativen Prompt. Sein Blindtest-Score ist bis auf LTX-2 19B der niedrigste der Tabelle. Wenn Ihnen der bestaussehende Clip wichtiger ist als der Preis, ist Wan 3.0 oder MiniMax H3 LoRA die stärkere Wahl bei etwa dem doppelten Preis pro Sekunde, Ton inklusive.
Bevor Sie es nutzen
Kein Inhaltsfilter heißt, dass niemand Ihre Prompts für Sie prüft. Alle Personen in einem Prompt, einem Foto oder einem Clip müssen erwachsen sein. Stellen Sie keine reale, identifizierbare Person ohne deren Einwilligung dar; das ist die Sorge, die dem ersten HunyuanVideo folgte, als sich Community-LoRAs von Prominenten verbreiteten. Stellen Sie sicher, dass Sie die Rechte an jedem Foto besitzen, das Sie animieren, und halten Sie Ihre Ausgaben dort im Rahmen des Gesetzes, wo Sie sie veröffentlichen.
FAQ
Ist HunyuanVideo unzensiert?
Ja, auf SpicyAPI. In 50 Läufen am 5. Oktober 2026 lehnte HunyuanVideo 1.5 nichts ab und verwischte nichts, und alle 26 Läufe auf L1 bis L3 kamen wie geschrieben zurück. Die L4-Szene mit zwei Erwachsenen wurde in allen 8 Läufen abgeschwächt, und 3 von 16 L5-Läufen wurden abgeschwächt. Der Freedom Score liegt bei 88,1 von 100.
Erlaubt Tencents eigener Hunyuan-Dienst NSFW-Video?
Nach seinen Regeln nicht. Die Hy-Video-1.5-API von Tencent Cloud dokumentiert einen Content-Moderationsschalter und Ablehnungscodes für gescheiterte Moderation und sensible Wörter, und die Acceptable-Use-Policy von Tencent Cloud schließt Inhalte reifer Natur aus. Das unzensierte Verhalten, das Leute beschreiben, stammt von den offenen Gewichten und von Hosts, die keinen Filter ergänzen.
Kann ein anderer Prompt HunyuanVideo an L4 vorbeibringen?
In unseren Läufen nicht: Alle acht Versuche über Text-zu-Video und Bild-zu-Video kamen abgeschwächt zurück, und jeder abgeschwächte Clip wird wie jeder andere berechnet. Für L4 wechseln Sie zu Wan 2.6 Flash ab einem Foto oder zu Wan 2.5, Wan 3.0 oder MiniMax H3 LoRA ab Text.
Ist HunyuanVideo 1.5 dasselbe Modell wie das ursprüngliche HunyuanVideo?
Nein. Das Original vom Dezember 2024 hat etwa 13 Milliarden Parameter und erwarb den Ruf, unzensiert zu sein, auf heimischen GPUs. HunyuanVideo 1.5 vom November 2025 ist ein kleineres Modell mit 8,3 Milliarden Parametern, gebaut für Consumer-GPUs. Alles, was auf dieser Seite gemessen wurde, ist 1.5.
Ist HunyuanVideo kostenlos?
Tencent veröffentlicht die Gewichte auf Hugging Face, das Selbstbetreiben kostet also Ihre eigene GPU-Zeit und Einrichtung. Über unsere API gibt es nichts zu installieren. Sie zahlen pro Sekunde Ausgabe: 0,024 $ bei 480p und 0,048 $ bei 720p, also 0,12 $ für einen 5-Sekunden-Clip in 480p.
Wie genau ist HunyuanVideo?
Gut bei einer Person, schwächer bei Details. Im Blindtest zur Ausgabequalität erreichte es 57,7 von 100, Platz 36 von 49 Videomodellen. Die Fehler, die wir sahen, waren ausgelassene kleine Gesten bei Text-zu-Video, Personen an anderer Stelle als im Prompt und Gesichter oder Haare, die nach großen Bewegungen bei Bild-zu-Video abdrifteten.
HunyuanVideo 1.5 oder Wan 2.2?
Beim Inhaltsspektrum HunyuanVideo 1.5 vor dem Basis-Wan-2.2: Das Basis-Wan-2.2 lehnte einige unserer Läufe ab und erreichte 43,1 bei Freedom, während HunyuanVideo keinen ablehnte. Wan 2.2 LoRA liegt mit 88,1 gleichauf mit HunyuanVideo und lieferte L4 in 2 von 7 Läufen. Wählen Sie es, wenn Sie eigene LoRAs laden möchten.
Ausprobieren
HunyuanVideo 1.5 Text-zu-Video mit dem Salzpfannen-Prompt öffnen, stellen Sie 9:16 ein und fahren Sie ein paar Seeds in 480p, um den Prompt zu prüfen, bevor Sie in 720p einen Take wählen. Die Live-Schätzung auf der Seite zeigt die Kosten vor dem Absenden.