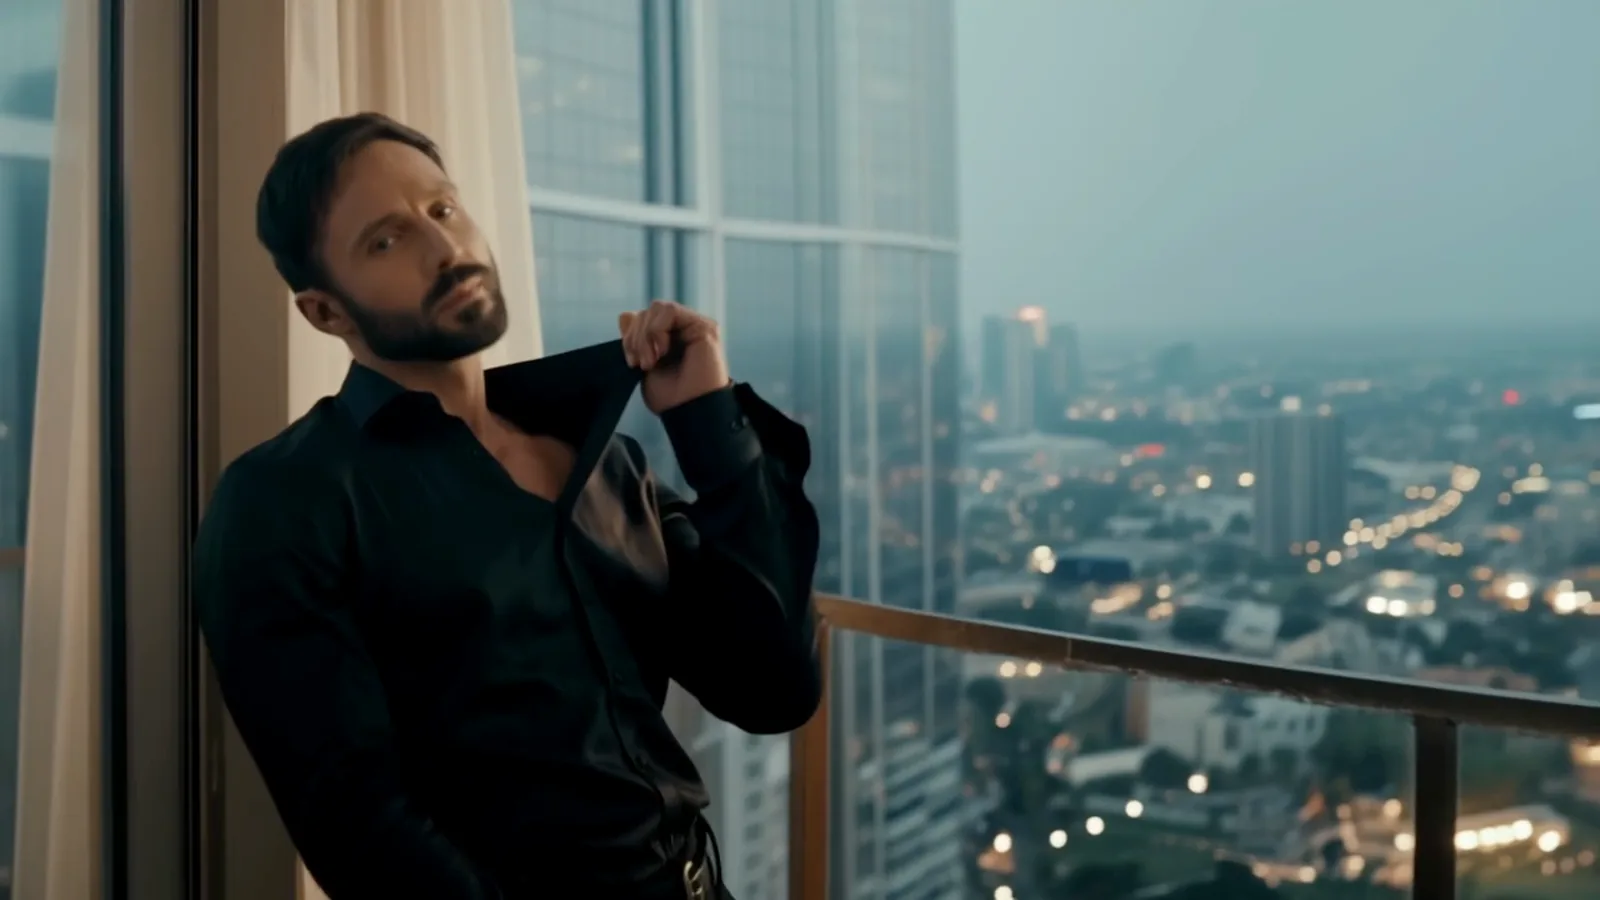
HunyuanVideo 1.5 befolgt einen Prompt am besten, wenn er wie eine Einstellungsliste klingt: ein Erwachsener, was er trägt, zwei oder drei kleine Handlungen in Reihenfolge, eine Kamerabewegung und das Licht. In 50 Läufen mit Adult-Inhalten am 5. Oktober 2026 kam jede Anfrage von L1 bis L3 wie geschrieben zurück (26 von 26), während alle 8 intimen Szenen zwischen zwei Erwachsenen abgeschwächt ausfielen. Dort lohnt sich ein Umformulieren also nicht mehr. Bei Bild-zu-Video leistet das Startbild die meiste Arbeit: Kleine Handlungen behielten das Gesicht vom Foto, und die Bitte um einen neuen Ort ersetzte es.
Die komplette Inhaltsleiter, Größen, Geschwindigkeiten und den Vergleich mit LTX-2 finden Sie in unserem NSFW-Test zu HunyuanVideo 1.5. Dieser Guide dreht sich um den Prompt: welche Formulierungen das Modell befolgt und welche es ignoriert, gezeigt an Clips nebeneinander, die wir für diesen Guide gefahren haben. Jeder hier abgedruckte Prompt ist eine Szene mit bekleideten Erwachsenen am andeutenden Ende, und Sie können sie auf der Familienseite zu HunyuanVideo 1.5 selbst ausführen.
Auf einen Blick
| Prompten von HunyuanVideo 1.5, aus unseren Läufen | |
|---|---|
| Prompt-Form, die funktionierte | Motiv, Garderobe, zwei oder drei Handlungsschritte in Reihenfolge, eine Kamerabewegung, Licht und Look |
| Stimmungsadjektive ("sultry", "seductive") | Ein gestellter Blick und wenig Bewegung, in beiden Test-Seeds |
| L1 bis L3 | 26 von 26 geliefert, beide Endpunkte |
| L4, zwei Erwachsene | 0 von 8 geliefert: alle abgeschwächt, keiner abgelehnt |
| L5 | Fesselung 7 von 8 geliefert, filmisches Gore 6 von 8 |
| Negativer Prompt | Nur bei Text-zu-Video. Verringert Artefakte, nie eine Garantie |
| Prompt bei Bild-zu-Video | Optional. Beschreiben Sie den nächsten Moment am selben Ort |
| Einstellungen | 480p oder 720p, 5 oder 8 Sekunden, stumm; 16:9 oder 9:16 bei Text-zu-Video; Bild-zu-Video behält die Form des Fotos |
| Preis | 0,024 $ pro Sekunde bei 480p, 0,048 $ bei 720p (0,12 $ für einen 5-Sekunden-Entwurf) |
Die fünf Slots, die HunyuanVideo 1.5 liest
Tencents Prompt-Handbuch zu HunyuanVideo 1.5 baut einen Text-zu-Video-Prompt aus Motiv, Bewegung und Szene auf, mit Einstellung, Kamera, Licht, Stil und Atmosphäre als Extras. Es verlangt Handlungen in zeitlicher Reihenfolge ("first… then… finally") und Emotionen als kleine körperliche Details. Für Adult-Clips teilen wir das Motiv in zwei, denn in der Garderobenzeile entscheidet sich die Stufe der Szene.
| Slot | Was Sie schreiben | Unser Beispiel |
|---|---|---|
| 1. Motiv | Ein Erwachsener: Altersspanne, Haare, ein prägendes Detail | An adult woman in her early thirties |
| 2. Garderobe | Kleidungsstück, Stoff, Farbe und sein Zustand | in a black satin slip dress |
| 3. Handlungsschritte | Zwei oder drei kleine Handlungen mit "first", "then", "finally" | slides one strap back onto her shoulder, glances back at the camera, smiles |
| 4. Kamera | Eine Bewegung: Annäherung, Orbit, fest, Handkamera | Slow push-in |
| 5. Licht und Look | Die Lichtquelle plus ein kurzes Stil-Tag | warm lamp light, cinematic, photorealistic |
Der Ort steht zwischen Motiv und Handlung. Der vollständige Prompt:
An adult woman in her early thirties in a black satin slip dress stands by the window of a dim hotel room at night, city lights behind her. First she slides one strap back onto her shoulder, then she glances over her shoulder at the camera, and finally she lets a slow, knowing smile break. Slow push-in, warm lamp light, cinematic, photorealistic.Diesen Prompt in HunyuanVideo 1.5 Text-zu-Video öffnen →
Drei Gewohnheiten machten in unseren Läufen den größten Unterschied:
- Ein Erwachsener pro Clip, sofern die Szene nicht zwei braucht.
- Benennen Sie den Raum über das, was darin steht. In beiden Zweipersonen-Clips auf Seed 62001 (siehe unten) kam "hotel bar" als Hotelzimmer mit Bett zurück. Wenn der Ort zählt, nennen Sie Tresen, Hocker und Flaschen.
- Halten Sie die Motivzeile fest, während Sie iterieren. Wer einen Satz ändert, zeichnet die ganze Person neu, selbst bei gleichem Seed.
Stimmungswörter oder Handlungsdetails
Adult-Prompts neigen dazu, Stimmungswörter zu häufen. Wir ließen den obigen Prompt gegen denselben Prompt laufen, bei dem der Handlungssatz durch "She is sultry, seductive and sensual, radiating desire." ersetzt war. Gleicher Seed, gleicher negativer Prompt, 480p, 5 Sekunden, je zwei Seeds.
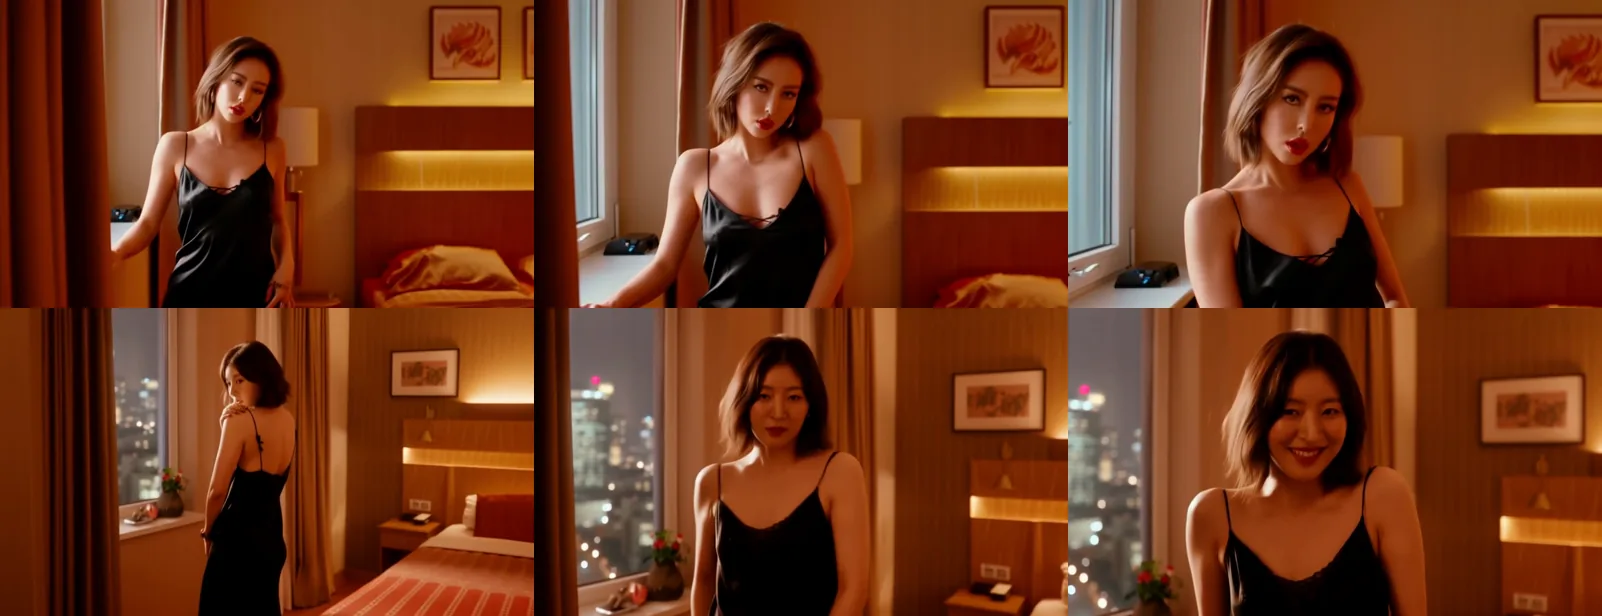
Text-zu-Video, 480p, Seed 61002, Anfang, Mitte und Ende jedes Clips. Oben: der Prompt mit Stimmungswörtern. Unten: der Prompt mit Handlungsschritten. Seed 61001 verhielt sich genauso.
Die Adjektive ergaben eine Modeshooting-Pose: leicht geöffnete Lippen, ein starrer Blick, eine stillgehaltene Hand, und die Annäherung der Kamera übernahm die gesamte Bewegung. In diesem Seed verschwand zudem die nächtliche Stadt hinter ihr. Die Handlungsversion durchlief in beiden Seeds alle drei Schritte und endete auf dem Lächeln, auch wenn die ersten beiden Schritte ineinanderliefen (sie blickte schon zurück, als ihre Hand zum Träger ging). Das ist der übliche Preis für drei Handlungen in fünf Sekunden.
Die Regel: Schreiben Sie, was die Zuschauenden geschehen sehen sollen, nicht, wie es sich anfühlen soll. "A slow, knowing smile" leistet die Arbeit von "seductive", und das Modell kann es zeichnen.
Wählen Sie Gesten, die das Modell kennt
Der Prompt hinter dem Cover dieses Guides bat einen Mann auf einem Hotelbalkon, "loosen one cuff", dann einen Blick in die Kamera zu halten und schließlich halb zu lächeln. In beiden Seeds bewegte sich die Manschette nie: Der eine Mann zog den Kragen auf, der andere legte eine Hand an Kragen und Kinn. Der Blick kam beide Male durch.
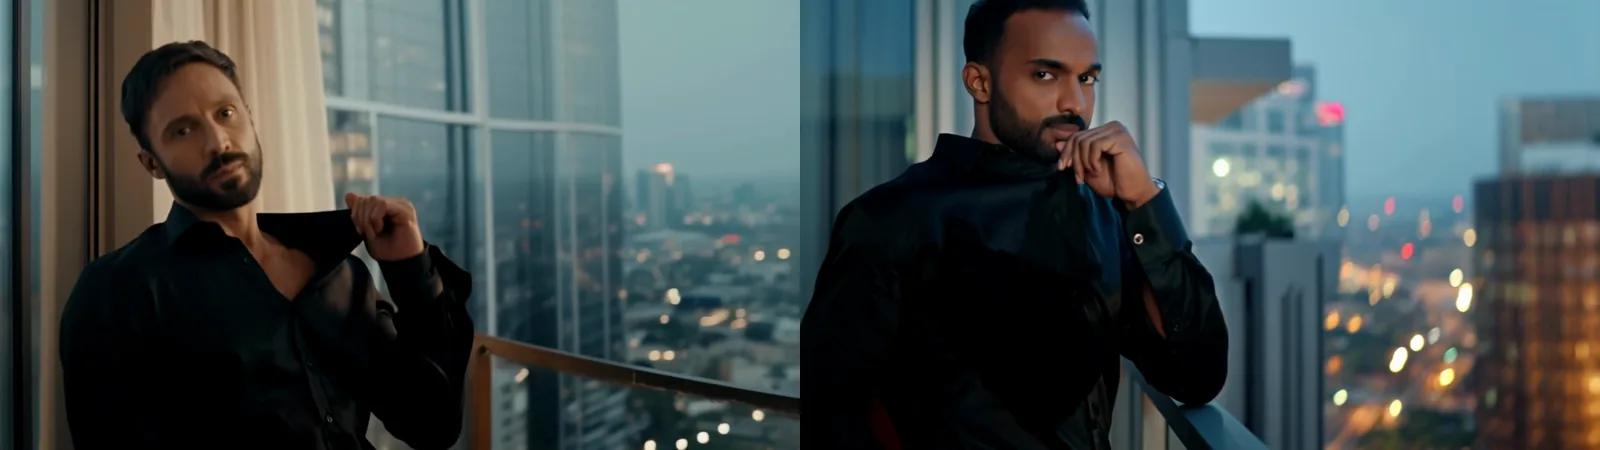
Text-zu-Video, 720p, derselbe Prompt auf den Seeds 64001 (links) und 64002 (rechts). Der Prompt bat ihn, eine Manschette zu lockern.
Ungewöhnliche kleine Gesten werden gegen vertraute ausgetauscht. Wenn eine Geste zählt, wählen Sie eine, die das Modell offensichtlich oft gesehen hat (eine Hand durchs Haar, ein rutschender Träger, ein gerichteter Kragen), und prüfen Sie sie zuerst in einem 480p-Entwurf.
Wie weit Sie gehen können, Stufe für Stufe
Auf unserer Seite filtert nichts den Prompt, das Foto oder das Ergebnis. Was sich zwischen den Stufen ändert, ist die Reaktion des Modells selbst, und sie entscheidet, ob sich ein weiteres Umformulieren lohnt. Diese Zahlen fassen beide Endpunkte über 50 Läufe am 5. Oktober 2026 zusammen, bei 480p und 5 Sekunden, alle Personen erwachsen. Prompts oberhalb von L1 drucken wir nicht ab.
| Stufe | Bedeutung | Geliefert | Für Ihren Prompt |
|---|---|---|---|
| L1 Andeutung | Dessous, ein rutschender Träger | 8 von 8 | Nennen Sie das Kleidungsstück und das eine, was damit geschieht |
| L2 Reife Themen | Teilweise Freizügigkeit | 8 von 8 | Dieselben fünf Slots; Garderobenzeile und eine Handlung tragen die Stufe |
| L3 Stark | Starke Freizügigkeit | 10 von 10 | Dasselbe; eine Person, eine Handlung |
| L4 Intensiv | Eine intime Szene zwischen zwei Erwachsenen | 0 von 8 | Jedes Mal abgeschwächt. Verschwenden Sie hier keine Wiederholungen |
| L5 Extrem | Einvernehmliche Fesselung unter Erwachsenen oder filmisches Gore | 7 von 8 und 6 von 8 | Die Fehlversuche behielten die Requisiten oder das Blut, ließen aber einen Teil der Szene aus |
Kein Lauf wurde abgelehnt oder verwischt. Bei L4 lieferte Text-zu-Video in allen vier Läufen zwei verheddert oder angeschnitten wirkende Figuren auf einem Bett, ohne die Szene zu zeichnen, und Bild-zu-Video schnitt vom Startbild auf eine neue Schlafzimmeraufnahme ohne weitere Person (alle drei Proben in unserem zweiten Lauf). Wir sahen weder eine Ablehnung noch ein Verwischen, das wirkt also wie die eigene Zurückhaltung des Modells, nicht wie ein Filter. Die praktische Obergrenze für Adult-Arbeit ist ein Erwachsener pro Clip, wo jeder Lauf von L1 bis L3 durchkam. Das Review zu HunyuanVideo 1.5 nennt einen Freedom Score von 88,1.
Zwei Erwachsene in einem Clip: ein Berührungspunkt
Zwei Personen in engem Kontakt sind die Schwäche dieses Modells. Wir schrieben einen Moment auf zwei Arten: als volle Umarmung ("They wrap their arms around each other and sway pressed close together, her face buried in his neck") und als einzelnen Berührungspunkt mit Abstand dazwischen:
An adult couple in their thirties in a dim hotel bar at night, she in a dark green satin dress on the left, he in a white shirt with rolled sleeves on the right. They stand a hand's width apart; her palm rests flat on his chest and his hand rests at her waist. She leans in until her forehead touches his, then they both smile. Warm amber light, slow push-in, cinematic, photorealistic.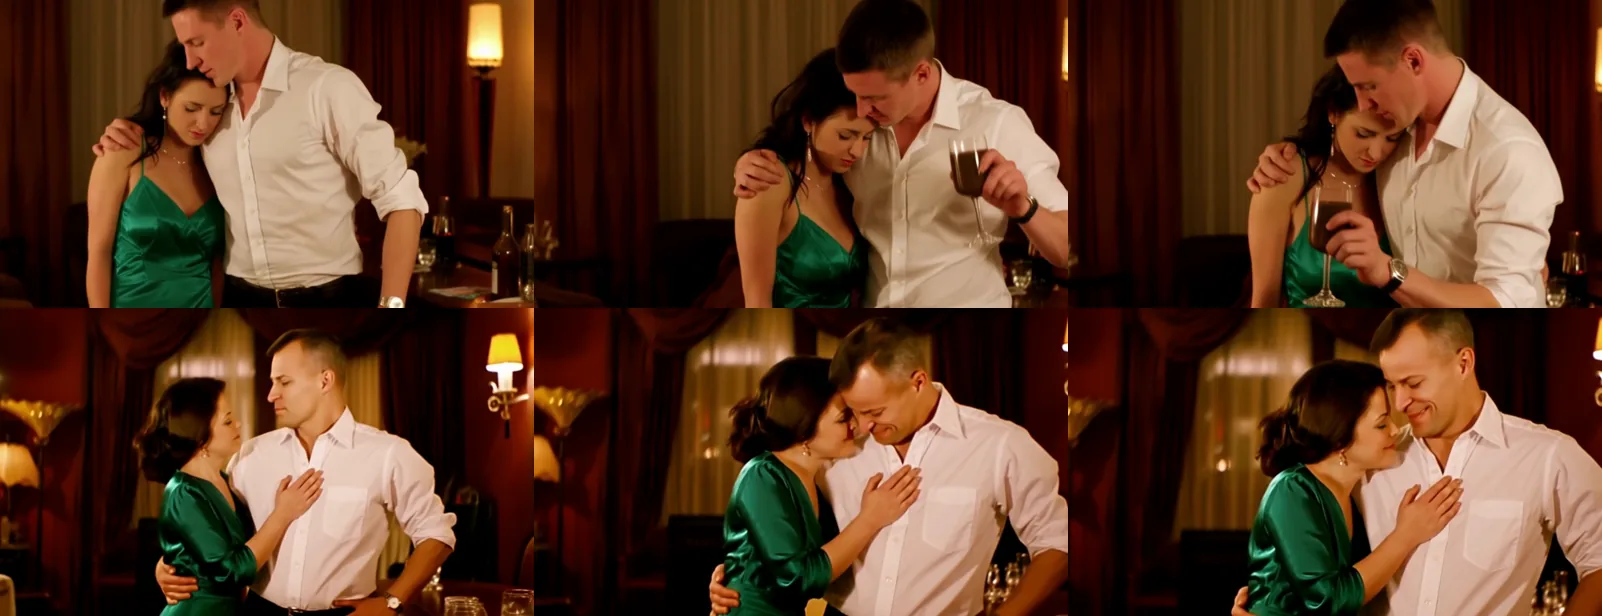
Text-zu-Video, 480p, Seed 62002. Oben: der Prompt mit voller Umarmung. Unten: der Prompt mit Berührungspunkt.
Die Umarmung geschah nie wie geschrieben. In diesem Seed wurde sie zu einer seitlichen Umarmung, während er aus einem Glas trank, um das niemand gebeten hatte; im anderen verschwammen ihre Hände an ihrer Schulter. Die Berührungspunkt-Version lieferte in beiden Seeds jeden Schritt: Handfläche auf der Brust, Hand an der Taille, Stirnen aneinander, zwei Lächeln. Links und rechts wurden in einem Seed befolgt und im anderen vertauscht, behandeln Sie Positionen also als Hinweis.
Für zwei Personen: Geben Sie jeder ein eigenes Outfit, beschreiben Sie ein oder zwei Berührungspunkte und den Abstand dazwischen, und enden Sie auf einem Gesichtsmoment.
Der negative Prompt: wofür er da ist
Text-zu-Video nimmt einen negative_prompt; Bild-zu-Video nicht. Der Code des Anbieters lässt ihn standardmäßig leer, und sein Handbuch erwähnt ihn nicht. Behandeln Sie ihn also als Liste dessen, was Sie nie im Bild haben wollen. Unsere Starter-Liste:
blurry, distorted hands, extra fingers, extra limbs, text, watermarkWas er in unseren Beispielläufen vom 5. Oktober verhinderte und was nicht:
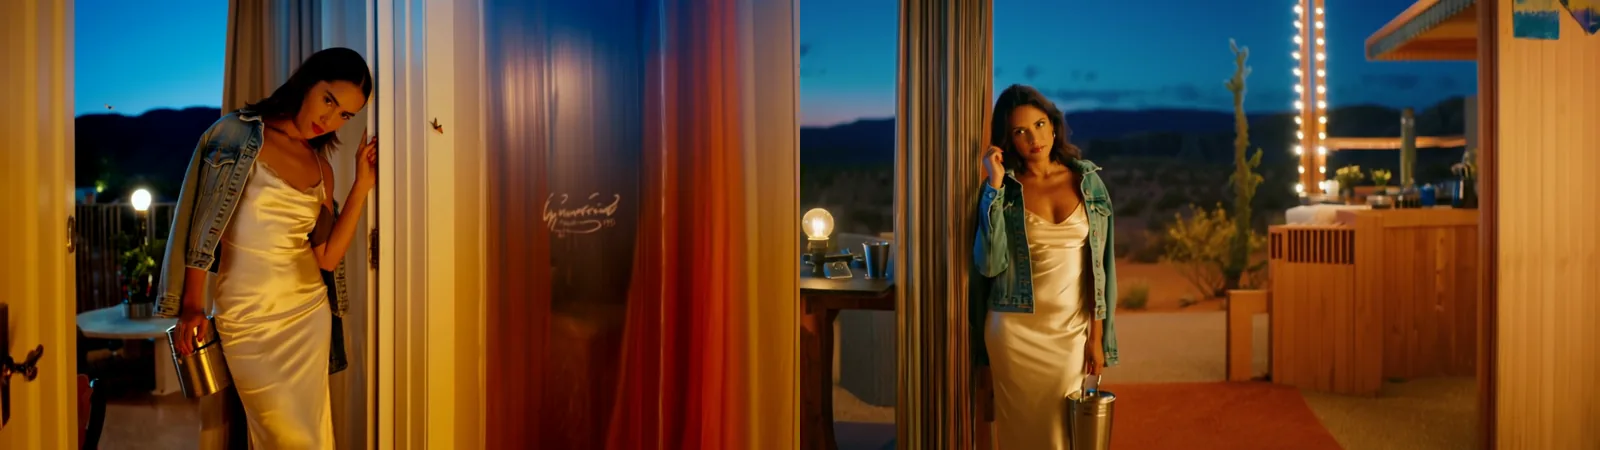
Text-zu-Video, 720p, derselbe Prompt und negative Prompt (der "text, lettering, logo" aufführt) auf zwei Seeds. Der linke Clip zeichnete trotzdem Schrift auf den Vorhang.
Dieser Prompt sagte außerdem "no signs or lettering anywhere". HunyuanVideo 1.5 ist darauf ausgelegt, Text zu rendern (sein Handbuch zeigt, wie es zitierte Wörter in Szenen schreibt), und in unseren Läufen erfand es Schriftzüge auf Vorhängen, Nummernschildern und Autoemblemen. Der negative Prompt senkt die Wahrscheinlichkeit; ein neuer Seed ist der günstigste Wiederholungsversuch für das, was durchrutscht.
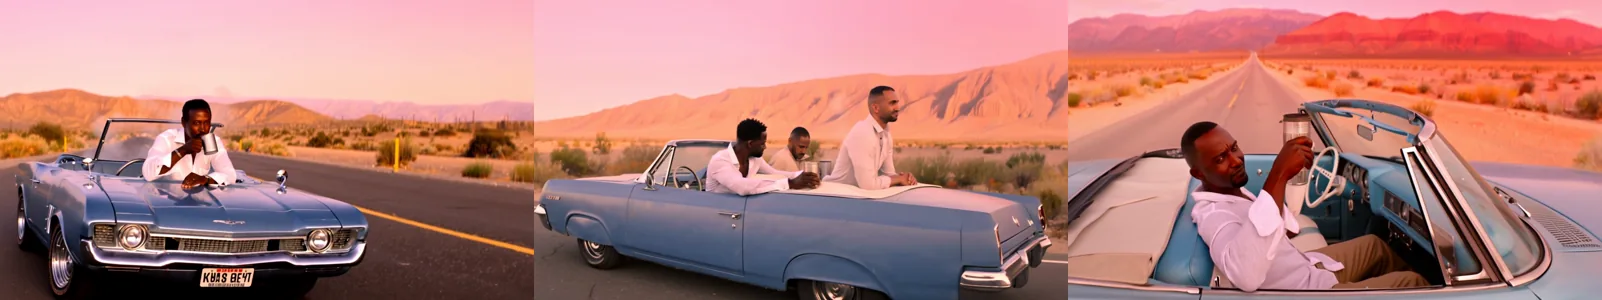
Text-zu-Video, 720p, drei Versionen einer Einstellung. Links: "no number plate, no lettering" im Prompt, kein negativer Prompt. Mitte: ein negativer Prompt ohne "extra people". Rechts: "extra people" ergänzt und die Kamera nah herangefahren.
Zwei Lehren. Der negative Prompt deckt nur ab, was Sie benennen: Der mittlere Clip sollte einen Mann zeigen und lieferte drei, und "extra people" behob es. Und der Bildausschnitt ist die stärkere Lösung als die Liste: Totalen gaben dem Modell Raum, Nummernschilder, Embleme und Beifahrer zu erfinden, während die Nahaufnahme nur ein kleines Chromzeichen in der ersten Sekunde übrig ließ. Achten Sie in Adult-Szenen genauso auf Spiegel, Poster und Bildschirme im Hintergrund.
Bild-zu-Video: Das Startbild leistet die Hauptarbeit
Beim Bild-zu-Video-Endpunkt legt das Foto Gesicht, Garderobe, Licht, Bildform und die Ausgangsstufe der Szene fest. Der Prompt sagt nur, was als Nächstes geschieht, in der Reihenfolge des Anbieters: Bewegung des Motivs, Bewegung der Szene, Kamera. Er ist optional, und ein Feld für einen negativen Prompt gibt es nicht.
Wir gaben einem Startbild zwei Prompts, je zwei Seeds: einen, der im Foto bleibt, und einen, der daraus hinausgeht. Das Bild ist ein 3:4-Standbild, erstellt mit dem Bildmodell Jib Mix Qwen, ein gängiger Weg, eine Figur aufzubauen, bevor man sie animiert.
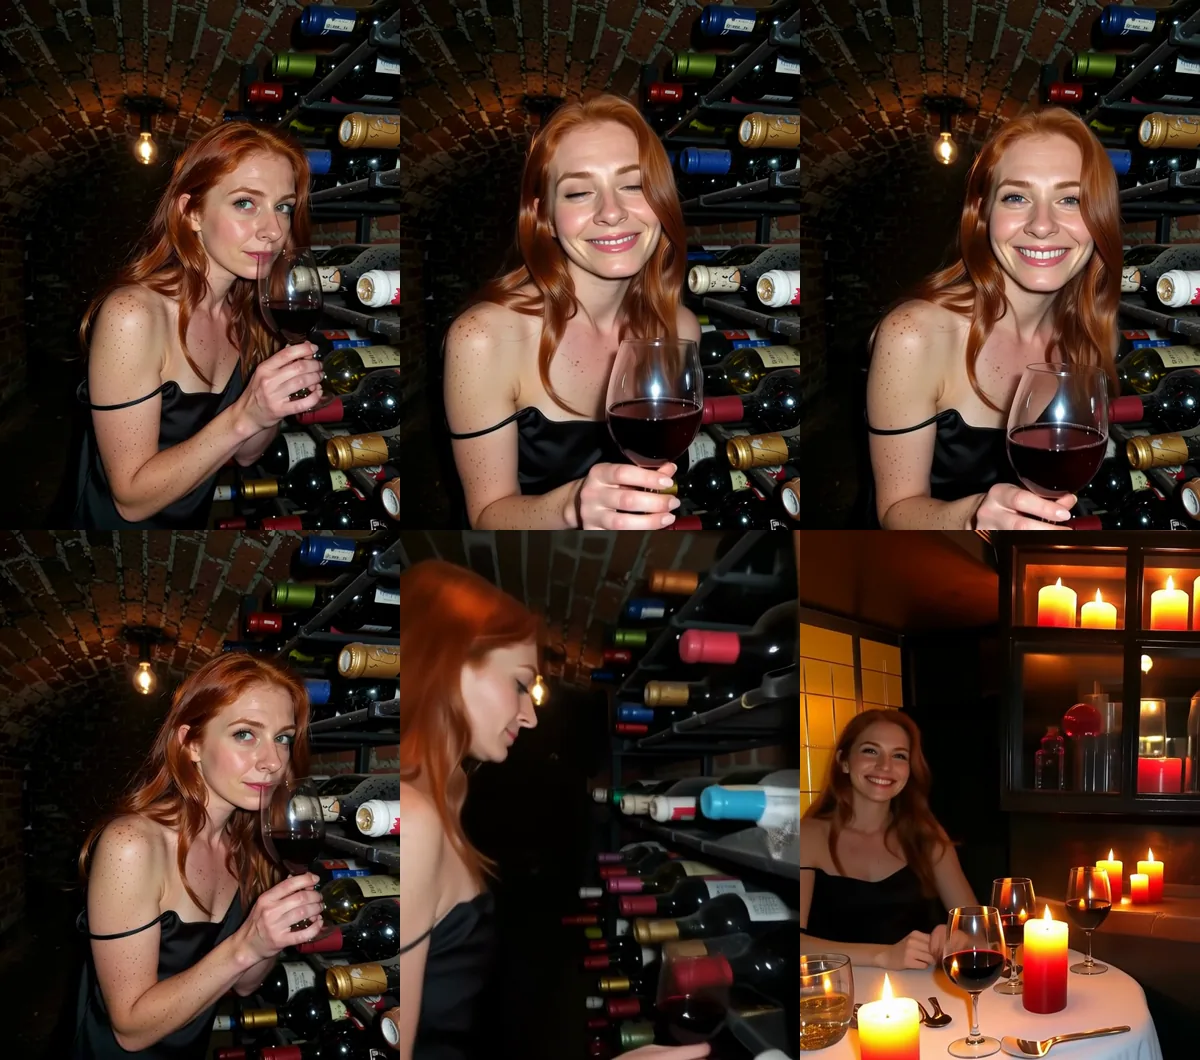
Bild-zu-Video, 480p, Seed 63001; der Clip kam in 544 x 720 zurück. Oben: "She lowers the wine glass, turns her head toward the camera and holds the look, then lets a slow smile spread. The light bulb above her sways slightly. The camera holds still." Unten: "She sets the wine glass down, walks up the cellar stairs into a candlelit restaurant upstairs, sits at a table by the window and smiles at the camera." Seed 63002 verhielt sich gleich.
Im Keller zu bleiben, behielt in beiden Seeds Gesicht, Sommersprossen und den rutschenden Träger. Hinauszugehen schnitt in beiden Seeds in einen neuen Raum, und nach dem Schnitt änderten sich Gesicht, Kleid und Träger. Wenn die Szene einen zweiten Ort braucht, erstellen Sie ein zweites Startbild.
Auch die Größe der Bewegung spielt eine Rolle, wie zwei unserer Läufe vom 5. Oktober in 720p nahelegen:
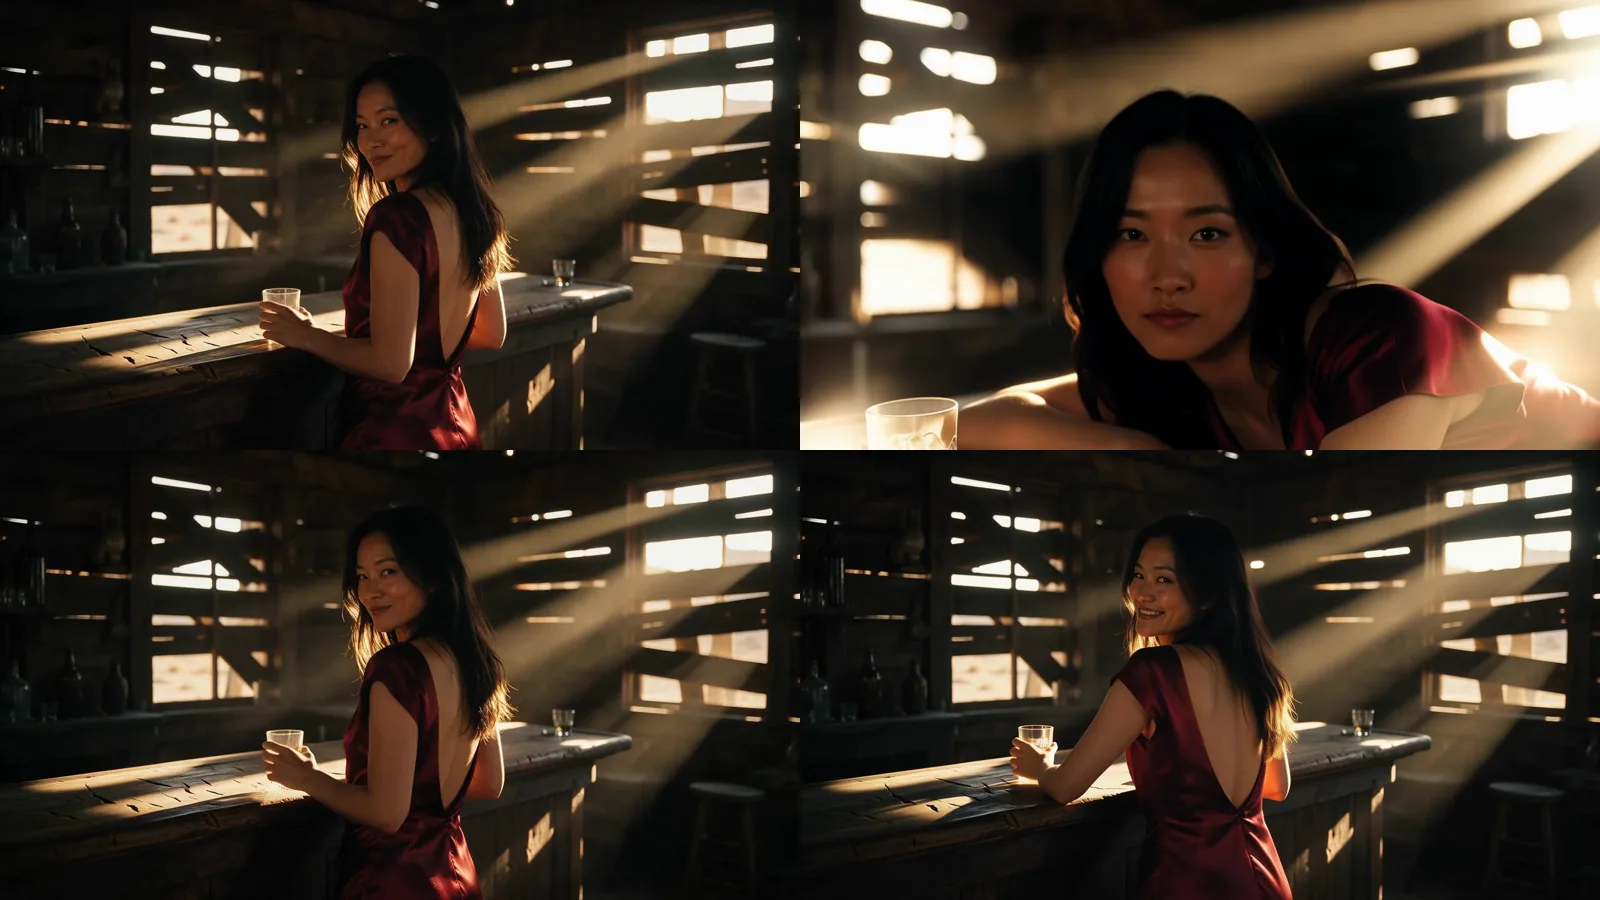
Bild-zu-Video, ein Startbild, Anfang und Ende zweier Clips auf verschiedenen Seeds. Oben: "turns slowly to face the camera and leans back on her elbows", leichte Annäherung. Unten: "takes a slow sip… lets a slow, amused smile spread", feste Kamera.
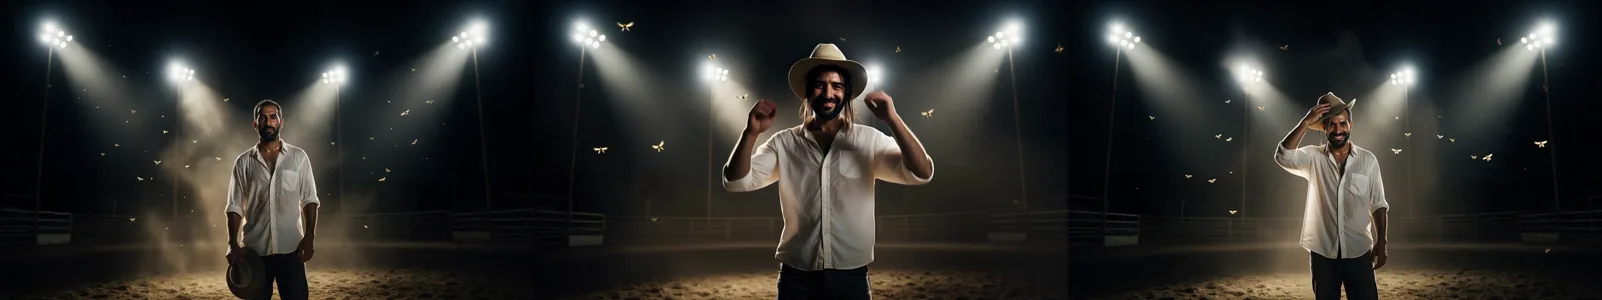
Bild-zu-Video, ein Startbild. Mitte: Er sollte den Staub vom Hut klopfen, sich mit der Hand durchs Haar fahren und den Hut aufsetzen. Rechts: Er sollte sich nur die Stirn wischen; das Modell setzte den Hut von selbst auf, und das Gesicht blieb.
In beiden Fehlschlägen kreuzten Hände das Gesicht oder das Gesicht rückte näher an die Linse als im Foto, das Modell musste es also wohl neu zeichnen und zeichnete jemand anderen. Halten Sie die Schritte klein (ein Schluck, ein Blick, ein Lächeln), die Kamera fest oder langsam und alles, was das Gesicht verdeckt, auf eine Geste.
Das Startbild legt auch die Ausgangsstufe fest: Von bekleideten Fotos brachten unsere Leiter-Prompts eine einzelne Figur bis L3, und zwar mit Gesicht und Raum, aber eine Zweipersonen-Szene aus einem Foto mit einer Person entstand nie.
Auflösung, Länge und Seitenverhältnis
| Wahl | Unsere Empfehlung | Warum |
|---|---|---|
| 480p oder 720p | 480p für Entwürfe, 720p für den Treffer | Halber Preis; 480p brauchte in den Läufen dieses Guides 39 bis 73 Sekunden Modellzeit, 720p zwei bis vier Minuten |
| 5 oder 8 Sekunden | 5, außer Sie haben vier oder mehr Schritte | Drei Schritte füllten 5 Sekunden; 8 Sekunden kosten 60 % mehr |
| 16:9 oder 9:16 | 9:16 für Smartphone-Feeds | Schreiben Sie den Bildausschnitt passend zur Form, etwa "vertical medium shot from waist height" |
| Form bei Bild-zu-Video | Foto vorher zuschneiden | Der Clip folgt dem Foto |
| Seed | Fest, während Sie bearbeiten | Gleicher Seed verspricht keinen identischen Clip |
Ein 5-Sekunden-Entwurf in 480p kostet 0,12 $, ein 5-Sekunden-Final in 720p 0,24 $ und ein 8-Sekunden-Clip in 720p 0,384 $, auf beiden Endpunkten. Die Clips sind stumm, planen Sie den Ton also im Schnitt ein: Stimme und Musik zu einem NSFW-KI-Video hinzufügen.
Muster, die abdrifteten, und was Sie stattdessen schreiben
| Muster | Was wir sahen | Stattdessen |
|---|---|---|
| Stimmungsadjektive | Gestellter Blick, Szenendetails fallen weg | Zwei oder drei sichtbare Schritte |
| Volle Umarmung zwischen zwei Erwachsenen | Eine Umarmung, verschwommene Hände, ein erfundenes Requisit | Ein oder zwei Berührungspunkte |
| Eine seltene Geste ("loosens one cuff") | Gegen eine Hand am Kragen getauscht | Eine gängige Geste |
| "No lettering" im Haupt-Prompt | Ein erfundenes Nummernschild | Negativer Prompt und engerer Ausschnitt |
| Totale mit Autos oder Schildern | Erfundener Text und zusätzliche Personen | Kamera näher heranfahren |
| Liegende Ganzkörperpose | Ein zusätzlicher Fuß; eine verlangte Nahaufnahme ignoriert | Ab der Taille aufwärts einrahmen |
| Bild-zu-Video: ein neuer Ort oder ein Lehnen zur Linse | Ein neues Gesicht | Zweites Startbild, kleine Bewegungen |
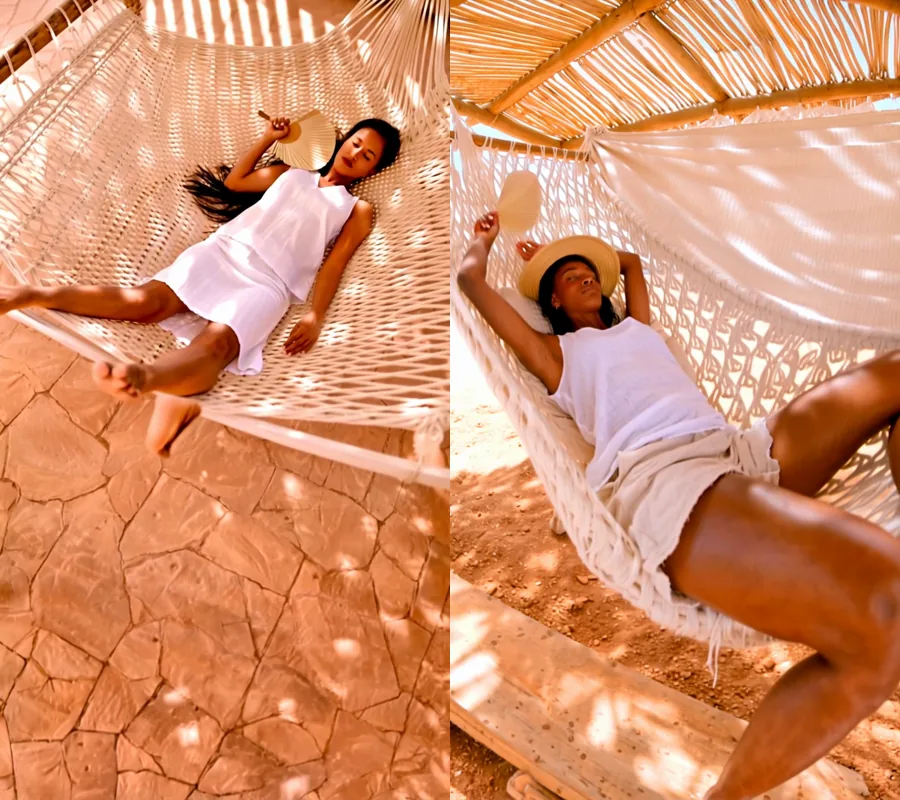
Text-zu-Video, 720p, 9:16, zwei Takes derselben liegenden Einstellung aus unseren Läufen vom 5. Oktober. Der Prompt rechts verlangte ihr Gesicht und ihre Schultern in der Nahaufnahme. Keines von beiden kam.
Prompt-Checkliste
Bevor Sie für einen 720p-Take zahlen:
- Die Motivzeile sagt "adult" und nennt eine Altersspanne; die Garderobenzeile nennt Kleidungsstück, Stoff, Farbe und Zustand.
- Zwei oder drei sichtbare Handlungsschritte in Reihenfolge, mit gängigen Gesten und ohne Stimmungsadjektive als Ersatz.
- Eine Kamerabewegung, so eng gerahmt, dass Schilder, Nummernschilder, Bildschirme und zusätzliche Personen draußen bleiben; der Ort über seine Objekte beschrieben.
- Zwei Personen nur, wenn nötig: eigene Outfits, ein oder zwei Berührungspunkte, ein Gesichtsmoment zum Schluss.
- Text-zu-Video: ein kurzer negativer Prompt, der Ihre tatsächlichen Probleme nennt. Bild-zu-Video: ein zugeschnittenes Foto, derselbe Raum, kleine Schritte.
- Ein Entwurf in 480p und 5 Sekunden auf festem Seed, dann 720p für den Treffer.
Wenn Sie Ton zum Bild brauchen: LTX-2 19B fügt jedem Clip eine Tonspur hinzu, und unser Prompt-Guide für unzensierte KI-Videos vergleicht, wie sich ein Prompt über Modelle hinweg verhält.
FAQ
Wie schreibe ich NSFW-Prompts für HunyuanVideo 1.5?
Schreiben Sie eine Einstellungsliste: ein Erwachsener, die Garderobe, zwei oder drei kleine Handlungen in Reihenfolge, eine Kamerabewegung, dann Licht und ein kurzes Stil-Tag. In unseren 50 Läufen kam jede Anfrage von L1 bis L3 wie geschrieben zurück, während intime Zweipersonen-Szenen jedes Mal abgeschwächt wurden. Halten Sie Adult-Arbeit also bei einer Person pro Clip.
Wie mache ich aus einem Bild ein Video per Prompt?
Nutzen Sie den Bild-zu-Video-Endpunkt und beschreiben Sie nur, was am selben Ort als Nächstes geschieht: eine kleine Handlung, einen Gesichtsmoment und die Kamera. Das Foto legt Gesicht, Outfit und Licht schon fest. Prompts, die die Person woandershin schickten, schnitten in beiden unserer Seeds auf eine neue Einstellung mit anderem Gesicht.
Hat Hunyuan Bild-zu-Video?
Ja. HunyuanVideo 1.5 hat einen Text-zu-Video-Endpunkt und einen Bild-zu-Video-Endpunkt. Der Bild-zu-Video-Clip behält die Form Ihres Fotos, und sein Prompt ist optional.
Nutzt HunyuanVideo 1.5 einen negativen Prompt?
Bei Text-zu-Video ja. Er wurde in jedem Lauf akzeptiert, in dem wir einen übergaben, und ein konkret benanntes Problem ("extra people") verschwand, aber erfundene Schrift kam einmal trotzdem durch. Bild-zu-Video hat kein Feld für einen negativen Prompt.
Warum kam mein HunyuanVideo-Clip abgeschwächt zurück?
Wenn es eine intime Szene zwischen zwei Erwachsenen war, ist das die eigene Grenze des Modells: Alle 8 unserer Läufe auf dieser Stufe kamen abgeschwächt zurück, ohne Ablehnung. Wenn es ein Erwachsener war, machen Sie die Handlungen konkret; Stimmungswörter lieferten uns gestellte, statische Clips, die zahm wirkten.
Warum läuft mein Bild-zu-Video-Clip in Zeitlupe?
Das haben wir nicht selbst gemessen. Als ein Nutzer im GitHub-Issue-Tracker des Anbieters Zeitlupe meldete, rieten die Maintainer, im Prompt schnellere Handlungen zu beschreiben, etwa "turns quickly and laughs" statt "slowly turns".