HunyuanVideo 1.5 najlepiej wykonuje prompt, który brzmi jak lista ujęć: jedna dorosła osoba, jej ubiór, dwie lub trzy małe czynności po kolei, jeden ruch kamery i światło. W 50 próbach treści dla dorosłych z 5 października 2026 każde zapytanie od L1 do L3 wróciło zgodnie z opisem (26 z 26), a wszystkie 8 intymnych scen między dwojgiem dorosłych wróciło złagodzonych, więc właśnie tam przepisywanie promptu przestaje się opłacać. W obrazie na wideo większość pracy robi kadr startowy: małe czynności zachowywały twarz ze zdjęcia, a prośba o nowe miejsce ją wymieniała.
Pełna drabina treści, rozmiary, szybkość i porównanie z LTX-2 są w naszym teście NSFW HunyuanVideo 1.5. Ten poradnik dotyczy promptu: jakie sformułowania model wykonuje, a jakie ignoruje, pokazane na klipach obok siebie, które uruchomiliśmy specjalnie do tego poradnika. Każdy wydrukowany tu prompt to scena z ubranym dorosłym na sugestywnym końcu skali, a uruchomisz je ze strony rodziny HunyuanVideo 1.5.
W skrócie
| Prompty do HunyuanVideo 1.5, z naszych prób | |
|---|---|
| Kształt promptu, który działał | Podmiot, ubiór, dwa lub trzy kroki akcji po kolei, jeden ruch kamery, światło i wygląd |
| Przymiotniki nastroju („sultry”, „seductive”) | Pozowane spojrzenie i mało ruchu, w obu seedach testowych |
| L1 do L3 | 26 z 26 dostarczone, oba endpointy |
| L4, dwoje dorosłych | 0 z 8 dostarczonych: wszystkie złagodzone, żadne nie odrzucone |
| L5 | Skrępowanie 7 z 8 dostarczone, filmowy gore 6 z 8 |
| Prompt negatywny | Tylko tekst na wideo. Ogranicza artefakty, nigdy nie jest gwarancją |
| Prompt w obrazie na wideo | Opcjonalny. Opisz następną chwilę w tym samym miejscu |
| Ustawienia | 480p lub 720p, 5 lub 8 sekund, bez dźwięku; 16:9 lub 9:16 w tekście na wideo; obraz na wideo zachowuje kształt zdjęcia |
| Cena | 0,024 USD za sekundę w 480p, 0,048 USD w 720p (0,12 USD za 5-sekundowy szkic) |
Pięć slotów, które czyta HunyuanVideo 1.5
Podręcznik promptów HunyuanVideo 1.5 firmy Tencent buduje prompt tekst-na-wideo z podmiotu, ruchu i sceny, a ujęcie, kamerę, światło, styl i atmosferę traktuje jako dodatki. Prosi o czynności w porządku czasowym („first… then… finally”) i o emocje zapisane jako drobne fizyczne szczegóły. W klipach dla dorosłych dzielimy podmiot na dwie części, bo to linia o ubiorze niesie poziom sceny.
| Slot | Co napisać | Nasz przykład |
|---|---|---|
| 1. Podmiot | Jedna dorosła osoba: przedział wiekowy, włosy, jeden wyróżniający szczegół | Dorosła kobieta po trzydziestce |
| 2. Ubiór | Część garderoby, tkanina, kolor i jej stan | w czarnej satynowej halce |
| 3. Kroki akcji | Dwie lub trzy małe czynności z „first”, „then”, „finally” | wsuwa jedno ramiączko z powrotem na ramię, zerka w kamerę, uśmiecha się |
| 4. Kamera | Jeden ruch: najazd, orbita, nieruchoma, z ręki | Powolny najazd |
| 5. Światło i wygląd | Źródło światła i krótki tag stylu | ciepłe światło lampy, cinematic, photorealistic |
Miejsce idzie między podmiot a akcję. Pełny prompt:
An adult woman in her early thirties in a black satin slip dress stands by the window of a dim hotel room at night, city lights behind her. First she slides one strap back onto her shoulder, then she glances over her shoulder at the camera, and finally she lets a slow, knowing smile break. Slow push-in, warm lamp light, cinematic, photorealistic.Otwórz ten prompt w tekście na wideo HunyuanVideo 1.5 →
Trzy nawyki zrobiły w naszych próbach największą różnicę:
- Jedna dorosła osoba na klip, chyba że scena wymaga dwóch.
- Nazywaj pomieszczenie tym, co w nim jest. W obu klipach z dwiema osobami na seedzie 62001 (zobacz niżej) „hotel bar” wrócił jako pokój hotelowy z łóżkiem. Jeśli miejsce ma znaczenie, wymień ladę, stołki i butelki.
- Trzymaj linię podmiotu bez zmian, gdy iterujesz. Zmiana jednego zdania przerysowuje całą osobę, nawet na tym samym seedzie.
Słowa o nastroju czy szczegóły akcji
Prompty dla dorosłych mają skłonność do gromadzenia słów o nastroju. Uruchomiliśmy powyższy prompt i ten sam prompt z zdaniem o akcji zastąpionym przez „She is sultry, seductive and sensual, radiating desire.” Ten sam seed, ten sam prompt negatywny, 480p, 5 sekund, po dwa seedy.
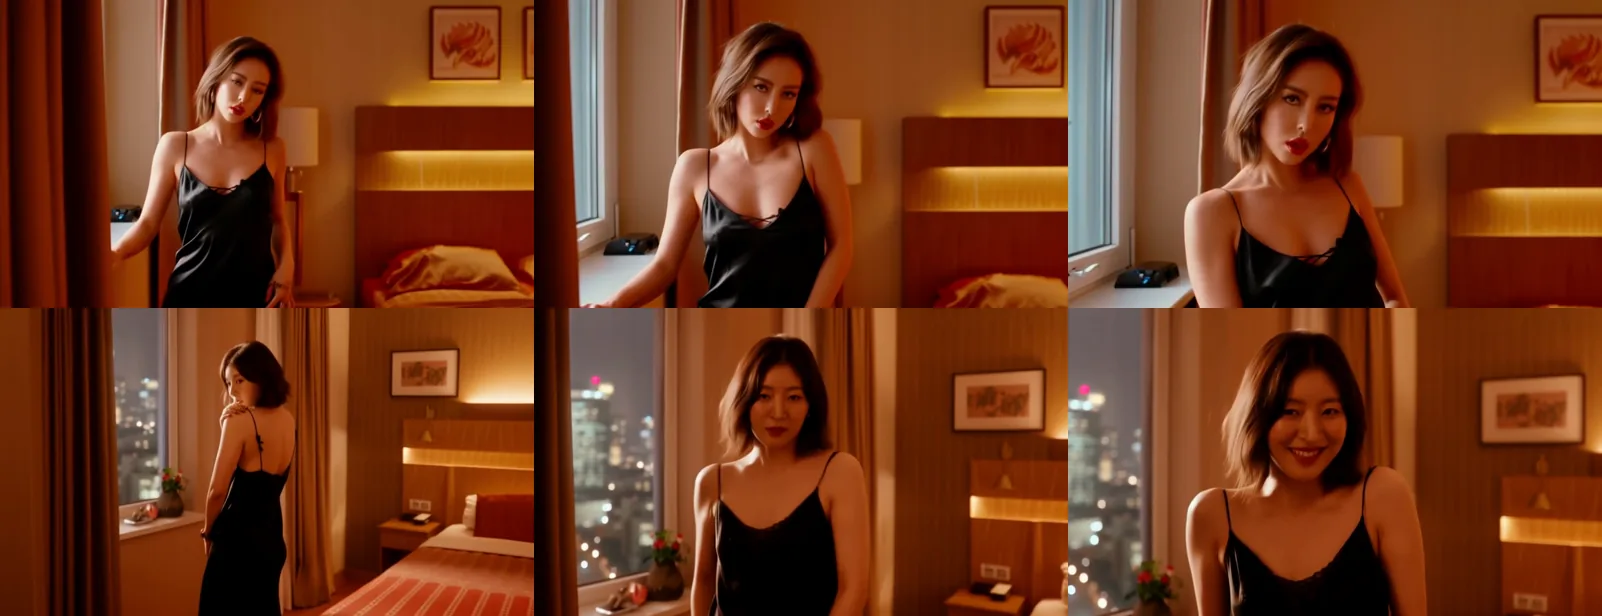
Tekst na wideo, 480p, seed 61002, początek, środek i koniec każdego klipu. Góra: prompt ze słowami o nastroju. Dół: prompt z krokami akcji. Seed 61001 zachował się tak samo.
Przymiotniki dały pozę z sesji modowej: rozchylone usta, nieruchome spojrzenie, nieruchomo trzymana dłoń, a cały ruch robił najazd kamery. W tym seedzie zniknęło też nocne miasto za jej plecami. Wersja z akcją przeszła przez wszystkie trzy kroki w obu seedach i zakończyła się uśmiechem, choć pierwsze dwa kroki zlały się w jeden (patrzyła już przez ramię, gdy dłoń szła do ramiączka). To zwykły koszt trzech czynności w pięciu sekundach.
Reguła: pisz, co widz ma zobaczyć, a nie jak ma się czuć. „A slow, knowing smile” robi robotę „seductive”, a model potrafi to narysować.
Wybieraj gesty, które model zna
Prompt za okładką tego poradnika prosił mężczyznę na hotelowym balkonie, żeby „loosen one cuff”, potem przytrzymał spojrzenie w kamerę, a potem półuśmiechnął się. W obu seedach mankiet się nie ruszył: jeden mężczyzna rozchylił kołnierzyk, drugi oparł dłoń przy kołnierzyku i brodzie. Spojrzenie wyszło za każdym razem.
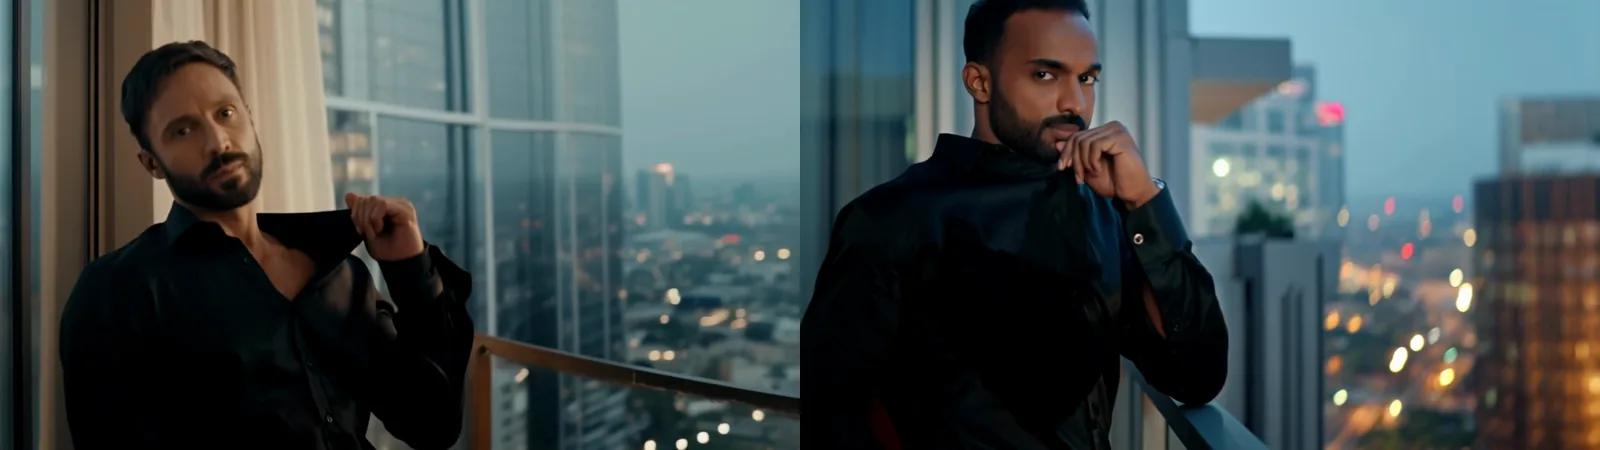
Tekst na wideo, 720p, ten sam prompt na seedach 64001 (lewa) i 64002 (prawa). Prompt prosił, by poluzował jeden mankiet.
Nietypowe drobne gesty są podmieniane na znane. Jeśli gest ma znaczenie, wybierz taki, który model ewidentnie widział wiele razy (dłoń we włosach, zsuwające się ramiączko, poprawiany kołnierzyk) i najpierw sprawdź go w szkicu 480p.
Jak daleko sięgać, poziom po poziomie
Nic po naszej stronie nie filtruje promptu, zdjęcia ani wyniku. Między poziomami zmienia się to, jak reaguje sam model, a to decyduje, czy kolejne przepisanie jest warte opłaty. Te liczby łączą oba endpointy w 50 próbach z 5 października 2026, w 480p i 5 sekundach, wszystkie postacie dorosłe. Nie drukujemy promptów powyżej L1.
| Poziom | Co oznacza | Dostarczone | Dla twojego promptu |
|---|---|---|---|
| L1 Sugestywny | Bielizna, zsuwające się ramiączko | 8 z 8 | Nazwij część garderoby i jedną rzecz, która się z nią dzieje |
| L2 Częściowy | Toples | 8 z 8 | Te same pięć slotów; linia o ubiorze i jedna akcja niosą poziom |
| L3 Mocny | Mocne treści | 10 z 10 | To samo; jedna osoba, jedna akcja |
| L4 Intensywny | Intymna scena między dwojgiem dorosłych | 0 z 8 | Za każdym razem złagodzone. Nie wydawaj tu powtórek |
| L5 Ekstremalny | Dobrowolne skrępowanie między dorosłymi albo filmowy gore | 7 z 8 i 6 z 8 | Chybienia zachowały rekwizyty albo krew, ale pominęły część sceny |
Żadna próba nie została odrzucona ani zamazana. Na L4 tekst na wideo dał w czterech próbach dwie splątane albo przycięte postacie na łóżku bez narysowania sceny, a obraz na wideo odcinał się od kadru startowego do nowego ujęcia sypialni, w którym nie było nikogo więcej (wszystkie trzy próby w naszym drugim przebiegu). Nie widzieliśmy odmowy ani zamazania, więc wygląda to na własną powściągliwość modelu, a nie filtr. Praktyczny pułap pracy z treściami dla dorosłych to jedna dorosła osoba na klip, gdzie przeszła każda próba od L1 do L3. Recenzja HunyuanVideo 1.5 podaje jego Freedom Score na poziomie 88,1.
Dwie dorosłe osoby w jednym klipie: jeden punkt kontaktu
Dwoje ludzi w bliskim kontakcie to słabe miejsce tego modelu. Napisaliśmy jedną chwilę na dwa sposoby: pełne objęcie („They wrap their arms around each other and sway pressed close together, her face buried in his neck”) i pojedynczy punkt kontaktu z przestrzenią między nimi:
An adult couple in their thirties in a dim hotel bar at night, she in a dark green satin dress on the left, he in a white shirt with rolled sleeves on the right. They stand a hand's width apart; her palm rests flat on his chest and his hand rests at her waist. She leans in until her forehead touches his, then they both smile. Warm amber light, slow push-in, cinematic, photorealistic.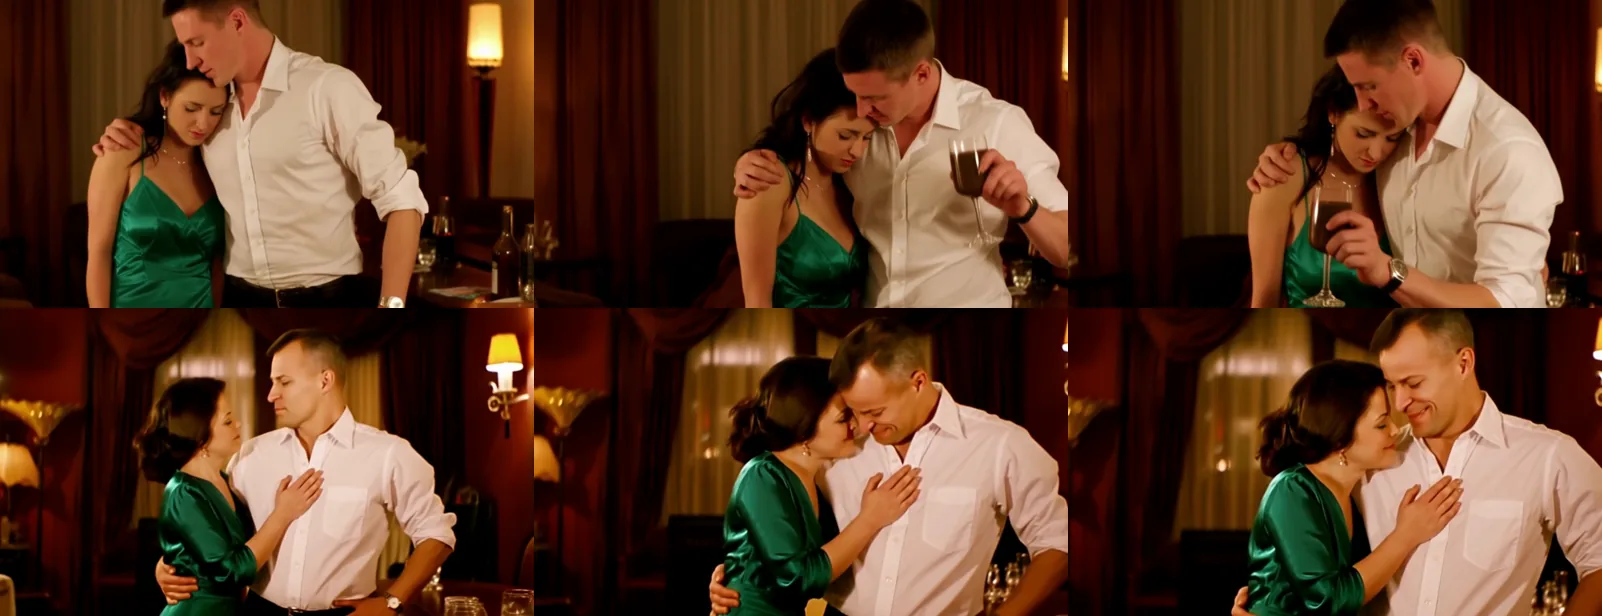
Tekst na wideo, 480p, seed 62002. Góra: prompt z pełnym objęciem. Dół: prompt z punktem kontaktu.
Objęcie nigdy nie wyszło tak, jak napisano. W tym seedzie zamieniło się w uścisk bokiem, podczas gdy on pił z kieliszka, o który nikt nie prosił; w drugim dłonie rozmazały się razem na jej ramieniu. Wersja z punktem kontaktu dostarczyła każdy krok w obu seedach: dłoń na piersi, dłoń w talii, czoła razem, dwa uśmiechy. Lewa i prawa strona zostały zachowane w jednym seedzie, a w drugim zamienione, więc pozycje traktuj jak wskazówkę.
Dla dwóch osób: nadaj każdej wyraźny strój, opisz jeden lub dwa punkty kontaktu i przestrzeń między nimi, a zakończ krokiem na twarzy.
Prompt negatywny: do czego służy
Tekst na wideo przyjmuje negative_prompt; obraz na wideo nie. Własny kod wydawcy zostawia go domyślnie pustym, a jego podręcznik go nie wspomina, więc traktuj go jak listę rzeczy, których nigdy nie chcesz w kadrze. Nasza startowa lista:
blurry, distorted hands, extra fingers, extra limbs, text, watermarkCo zatrzymał, a czego nie, w naszych przykładowych przebiegach z 5 października:
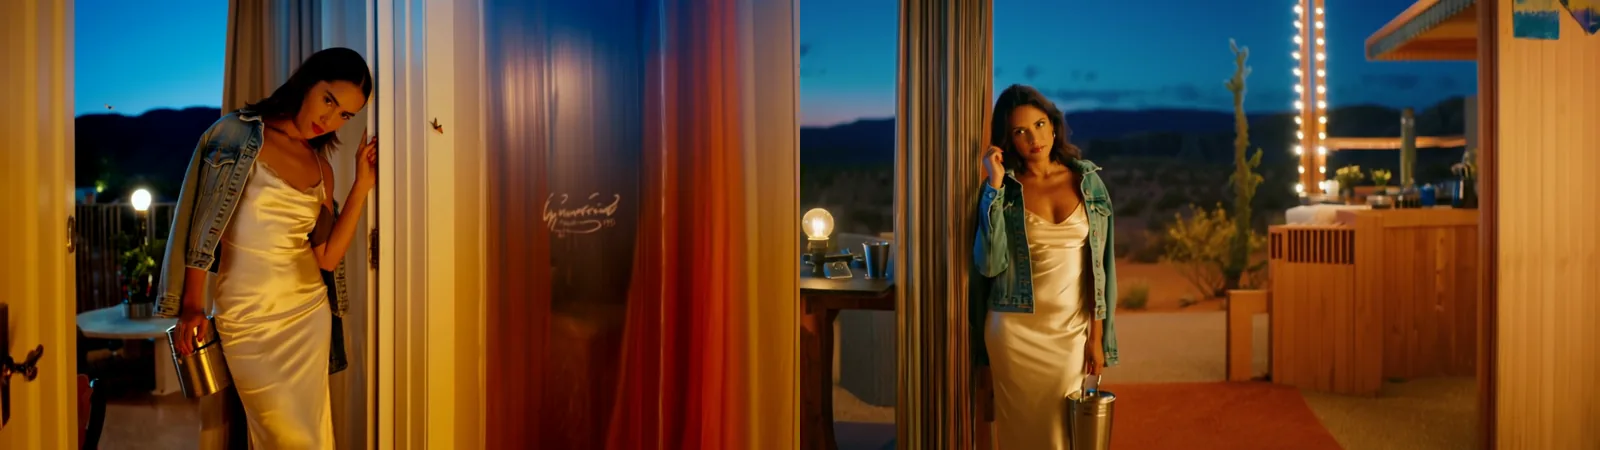
Tekst na wideo, 720p, ten sam prompt i prompt negatywny (który wymienia „text, lettering, logo”) na dwóch seedach. Lewy klip nadal narysował pismo na zasłonie.
Ten prompt mówił też „no signs or lettering anywhere”. HunyuanVideo 1.5 jest zbudowany tak, by renderować tekst (jego podręcznik pokazuje, jak wpisuje cytowane słowa w sceny), a w naszych próbach wymyślał napisy na zasłonach, tablicach rejestracyjnych i znaczkach samochodów. Prompt negatywny obniża szansę; nowy seed to najtańsza powtórka dla tego, co się prześliźnie.
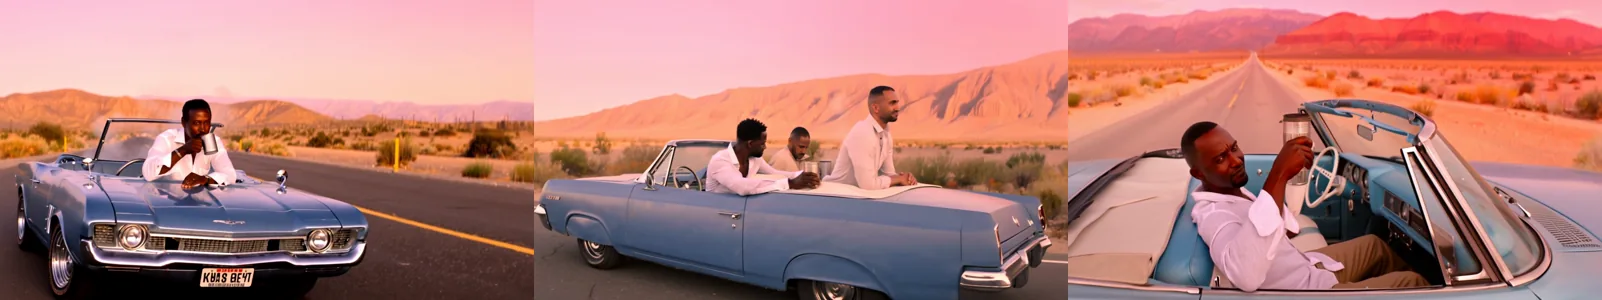
Tekst na wideo, 720p, trzy wersje jednego ujęcia. Lewa: „no number plate, no lettering” w prompcie, bez promptu negatywnego. Środkowa: prompt negatywny bez „extra people”. Prawa: dodane „extra people” i kamera przysunięta blisko.
Dwie lekcje. Prompt negatywny obejmuje tylko to, co nazwiesz: środkowy klip prosił o jednego mężczyznę i dostał trzech, a dodanie „extra people” to naprawiło. Po drugie, kadr jest silniejszą poprawką niż lista: szerokie ujęcia dawały modelowi miejsce na wymyślanie tablic, znaczków i pasażerów, a zbliżenie zostawiło tylko mały chromowany znaczek w pierwszej sekundzie. W scenach dla dorosłych tak samo pilnuj luster, plakatów i ekranów w tle.
Obraz na wideo: kadr startowy wykonuje ciężką pracę
W endpoincie obraz-na-wideo zdjęcie ustala twarz, ubiór, światło, kształt kadru i początkowy poziom sceny. Prompt mówi tylko, co dzieje się dalej, w kolejności wydawcy: ruch podmiotu, ruch sceny, kamera. Jest opcjonalny i nie ma pola promptu negatywnego.
Jednemu kadrowi startowemu dawaliśmy dwa prompty, po dwa seedy każdy: jeden, który zostaje w zdjęciu, i drugi, który z niego wychodzi. Kadr to nieruchomy obraz 3:4 stworzony modelem obrazu Jib Mix Qwen, częstym sposobem na przygotowanie postaci przed animacją.
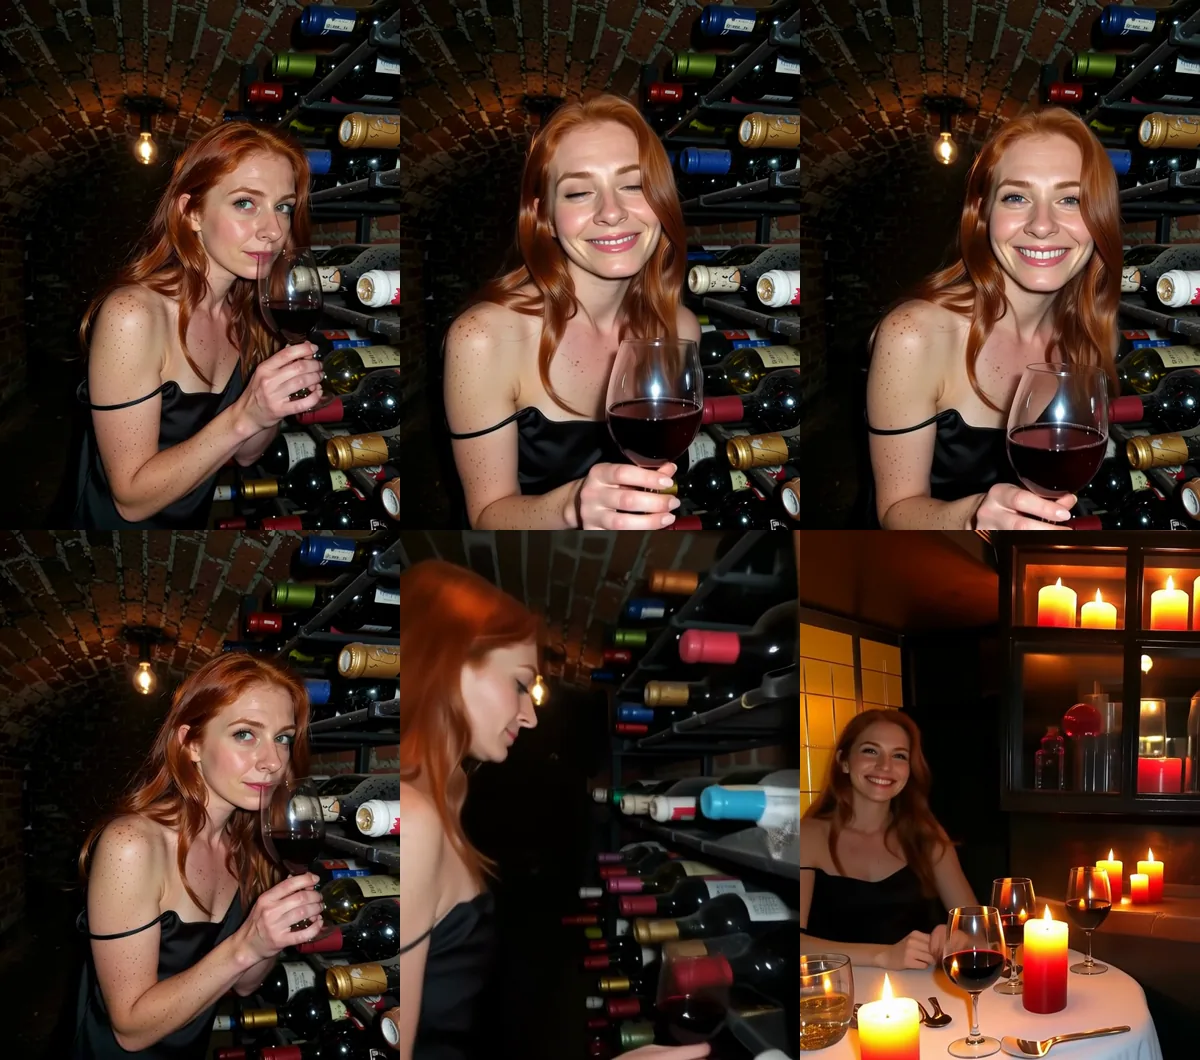
Obraz na wideo, 480p, seed 63001; klip wrócił w 544 x 720. Góra: „She lowers the wine glass, turns her head toward the camera and holds the look, then lets a slow smile spread. The light bulb above her sways slightly. The camera holds still.” Dół: „She sets the wine glass down, walks up the cellar stairs into a candlelit restaurant upstairs, sits at a table by the window and smiles at the camera.” Seed 63002 dał to samo.
Pozostanie w piwnicy zachowało jej twarz, piegi i zsuwające się ramiączko w obu seedach. Wyjście z niej dało cięcie do nowego pomieszczenia w obu seedach, a po cięciu zmieniły się twarz, suknia i ramiączko. Jeśli scena potrzebuje drugiego miejsca, zrób drugi kadr startowy.
Znaczenie ma też rozmiar ruchu, na co wskazują dwa nasze przebiegi z 5 października w 720p:
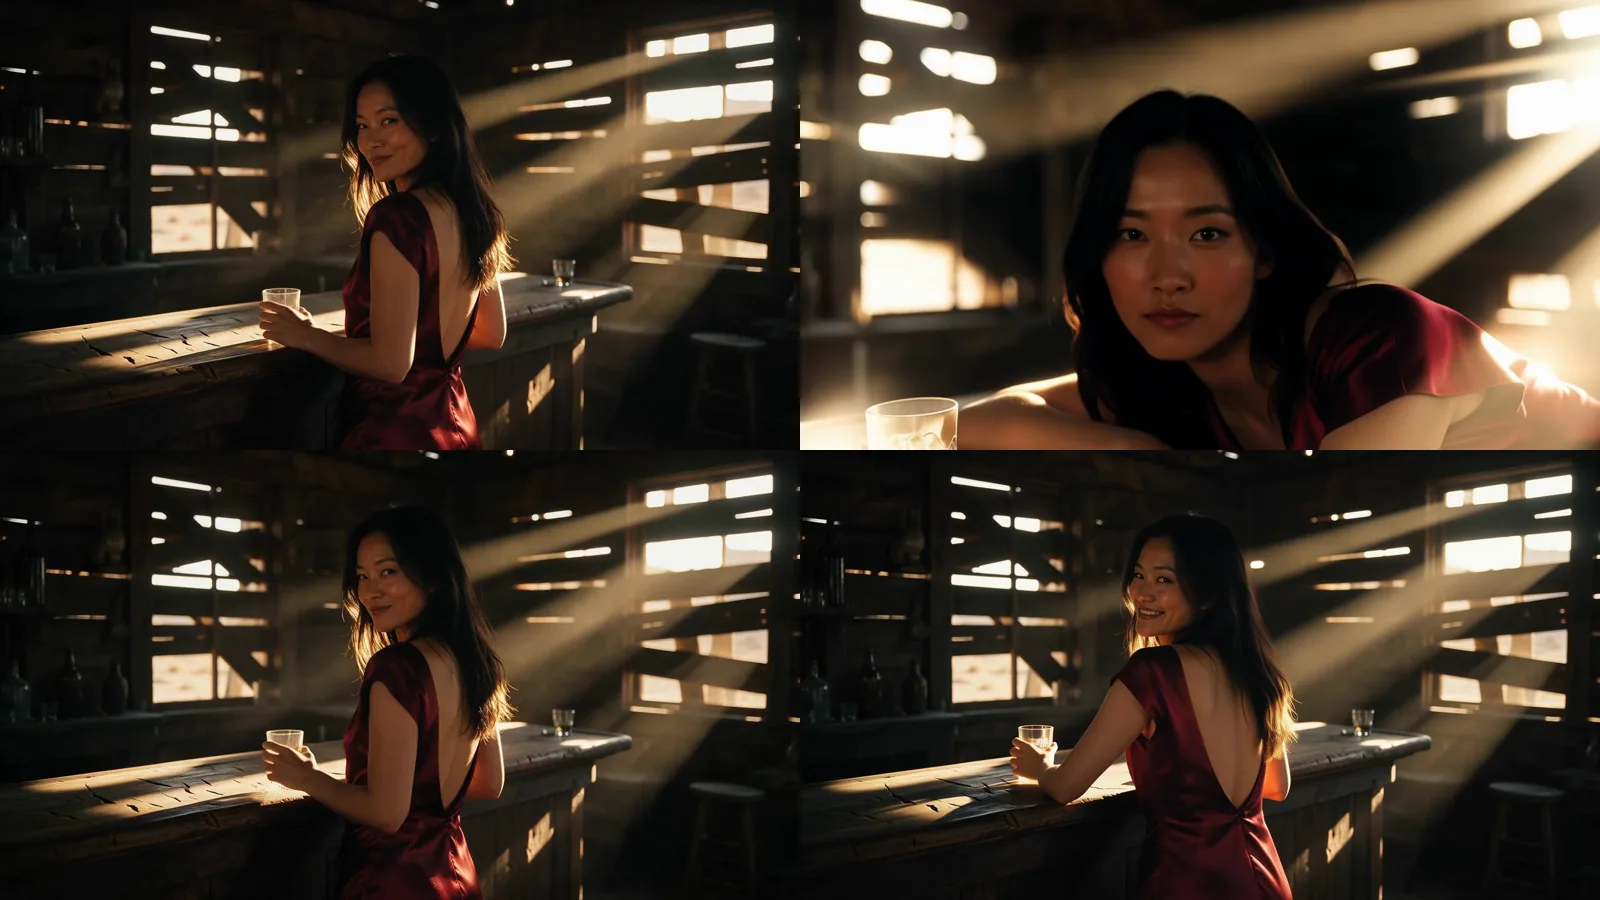
Obraz na wideo, jeden kadr startowy, początek i koniec dwóch klipów na różnych seedach. Góra: „turns slowly to face the camera and leans back on her elbows”, lekki najazd. Dół: „takes a slow sip… lets a slow, amused smile spread”, kamera nieruchoma.
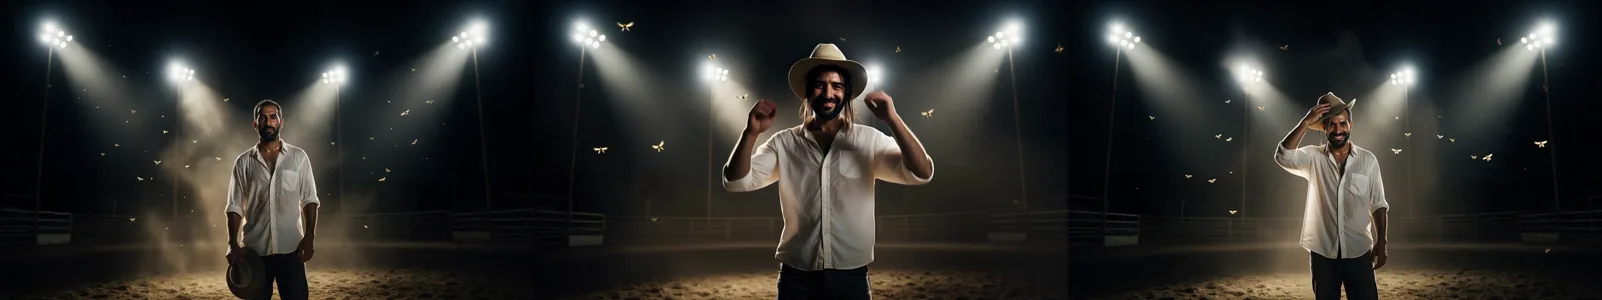
Obraz na wideo, jeden kadr startowy. Środek: poproszony o otrzepanie kapelusza z kurzu, przeczesanie włosów dłonią i włożenie kapelusza. Prawa: poproszony tylko o otarcie czoła; model sam włożył kapelusz, a twarz została.
W obu porażkach dłonie przecinały twarz albo twarz zbliżała się do obiektywu bardziej niż na zdjęciu, więc model prawdopodobnie musiał ją przerysować i narysował kogoś innego. Trzymaj kroki małe (łyk, spojrzenie, uśmiech), kamerę nieruchomą albo wolną, a wszystko, co zasłania twarz, ogranicz do jednego gestu.
Kadr startowy ustala też poziom wyjściowy: z ubranych zdjęć nasze prompty z drabiny doprowadziły pojedynczą postać aż do L3 przy zachowaniu twarzy i pomieszczenia, ale scena z dwiema osobami ze zdjęcia jednej osoby nigdy się nie pojawiła.
Rozdzielczość, długość i proporcje
| Wybór | Nasz typ | Dlaczego |
|---|---|---|
| 480p czy 720p | Szkice w 480p, 720p dla wybranego | Połowa ceny; 480p zajęło 39 do 73 sekund czasu modelu w przebiegach tego poradnika, 720p od dwóch do czterech minut |
| 5 czy 8 sekund | 5, chyba że masz cztery kroki lub więcej | Trzy kroki wypełniły 5 sekund; 8 sekund kosztuje o 60% więcej |
| 16:9 czy 9:16 | 9:16 dla feedów w telefonie | Pisz kadrowanie pod kształt, na przykład „vertical medium shot from waist height” |
| Kształt w obrazie na wideo | Najpierw przytnij zdjęcie | Klip podąża za zdjęciem |
| Seed | Stały, gdy edytujesz | Ten sam seed nie obiecuje identycznego klipu |
5-sekundowy szkic 480p kosztuje 0,12 USD, 5-sekundowy finał 720p 0,24 USD, a 8-sekundowy klip 720p 0,384 USD, na każdym z endpointów. Klipy są nieme, więc zaplanuj dźwięk w montażu: dodawanie głosu i muzyki do wideo NSFW AI.
Wzorce, które dryfowały, i co pisać zamiast nich
| Wzorzec | Co widzieliśmy | Zamiast tego |
|---|---|---|
| Przymiotniki nastroju | Pozowane spojrzenie, szczegóły sceny pominięte | Dwa lub trzy widoczne kroki |
| Pełne objęcie dwojga dorosłych | Uścisk, rozmazane dłonie, wymyślony rekwizyt | Jeden lub dwa punkty kontaktu |
| Rzadki gest („loosens one cuff”) | Podmieniony na dłoń przy kołnierzyku | Częsty gest |
| „No lettering” w głównym prompcie | Wymyślona tablica rejestracyjna | Prompt negatywny i ciaśniejszy kadr |
| Szerokie ujęcie z samochodami albo szyldami | Wymyślony tekst i dodatkowe osoby | Przysuń kamerę |
| Leżąca poza całą sylwetką | Dodatkowa stopa; zignorowane żądane zbliżenie | Kadruj od pasa w górę |
| Obraz na wideo: nowe miejsce albo pochylenie ku obiektywowi | Nowa twarz | Drugi kadr startowy, małe ruchy |
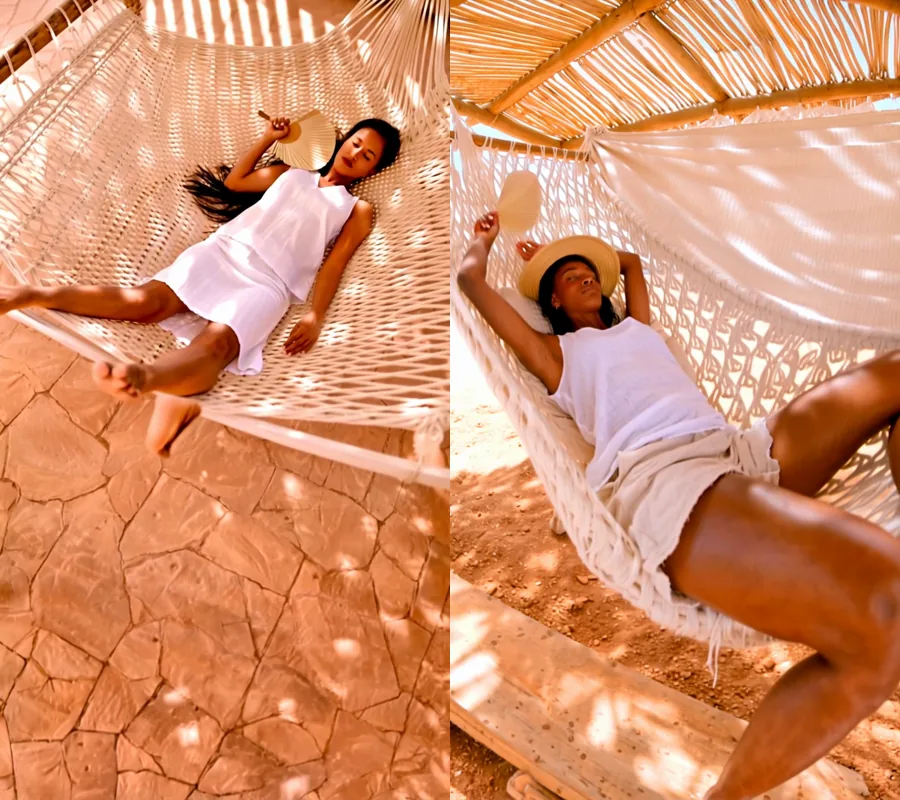
Tekst na wideo, 720p, 9:16, dwa podejścia do jednego leżącego ujęcia z naszych przebiegów z 5 października. Prompt po prawej prosił o zbliżenie jej twarzy i ramion. Żadne nie zostało zachowane.
Lista kontrolna promptu
Zanim zapłacisz za podejście w 720p:
- Linia podmiotu mówi „adult” i podaje przedział wiekowy; linia ubioru podaje część garderoby, tkaninę, kolor i stan.
- Dwa lub trzy widoczne kroki akcji po kolei, z częstymi gestami i bez przymiotników nastroju w ich miejsce.
- Jeden ruch kamery, kadr dość ciasny, by pominąć szyldy, tablice, ekrany i dodatkowe osoby; miejsce opisane przez jego przedmioty.
- Dwie osoby tylko w razie potrzeby: wyraźne stroje, jeden lub dwa punkty kontaktu, krok na twarzy na koniec.
- Tekst na wideo: krótki prompt negatywny nazywający twoje faktyczne problemy. Obraz na wideo: przycięte zdjęcie, to samo pomieszczenie, małe kroki.
- Szkic 480p na 5 sekund na stałym seedzie, potem 720p dla wybranego.
Jeśli chcesz dźwięku z obrazem, LTX-2 19B dodaje ścieżkę audio do każdego klipu, a nasz poradnik promptów do niecenzurowanego wideo AI porównuje, jak jeden prompt zachowuje się w różnych modelach.
FAQ
Jak pisać prompty NSFW do HunyuanVideo 1.5?
Napisz listę ujęć: jedna dorosła osoba, ubiór, dwie lub trzy małe czynności po kolei, jeden ruch kamery, potem światło i krótki tag stylu. W naszych 50 próbach każde zapytanie od L1 do L3 wróciło zgodnie z opisem, a intymne sceny z dwiema osobami były za każdym razem złagodzone, więc w pracy z treściami dla dorosłych trzymaj się jednej osoby na klip.
Jak zamienić obraz w wideo promptem?
Użyj endpointu obraz-na-wideo i opisz tylko to, co dzieje się dalej w tym samym miejscu: małą czynność, krok na twarzy i kamerę. Zdjęcie już ustala twarz, strój i światło. Prompty, które wysyłały osobę gdzieś indziej, w obu naszych seedach ucinały się do nowego ujęcia z inną twarzą.
Czy Hunyuan ma obraz na wideo?
Tak. HunyuanVideo 1.5 ma endpoint tekst-na-wideo i endpoint obraz-na-wideo. Klip z obrazu na wideo zachowuje kształt twojego zdjęcia, a jego prompt jest opcjonalny.
Czy HunyuanVideo 1.5 używa promptu negatywnego?
W tekście na wideo tak. Został przyjęty w każdym przebiegu, w którym go podaliśmy, a nazwanie konkretnego problemu („extra people”) go usunęło, ale wymyślony napis raz się jednak przedostał. Obraz na wideo nie ma pola promptu negatywnego.
Dlaczego mój klip HunyuanVideo wrócił stonowany?
Jeśli to była intymna scena między dwojgiem dorosłych, to własny limit modelu: wszystkie 8 naszych prób na tym poziomie wróciło złagodzonych, bez odmowy. Jeśli to była jedna dorosła osoba, zapisz czynności konkretnie; słowa o nastroju dawały nam pozowane, statyczne klipy, które wyglądały grzecznie.
Dlaczego mój klip z obrazu na wideo jest w zwolnionym tempie?
Sami tego nie mierzyliśmy. Gdy użytkownik zgłosił zwolnione tempo w śledzeniu zgłoszeń na GitHubie wydawcy, opiekunowie poradzili, by opisać w prompcie szybsze czynności, na przykład „turns quickly and laughs” zamiast „slowly turns”.