W przypadku powracającej dorosłej postaci zacznij od obrazu na wideo, gdy twarz, ubranie i ujęcie otwierające są zatwierdzone. Zacznij od tekstu na wideo, gdy dopiero wybierasz postać lub odkrywasz scenę. Obraz daje konkretne otwarcie, a prompt tekstowy pozostawia jego wymyślenie modelowi. Żaden rodzaj wejścia nie gwarantuje stabilnej twarzy po rozpoczęciu ruchu.
Poniższe porównanie wykorzystuje MiniMax H3, ponieważ SpicyAPI udostępnia oba zadania w tych samych cenach za sekundę. Wybór zależy więc od tego, co już masz i co wymaga poprawy, a nie od zniżki dla jednej ścieżki. Przykładowe prompty dotyczą w pełni ubranej, fikcyjnej osoby dorosłej.
Ta sama rodzina, dwa różne wejścia
| Aktualna specyfikacja MiniMax H3 | Tekst na wideo | Obraz na wideo |
|---|---|---|
| Wymagane dane | prompt | prompt i image_url |
| Czas trwania | 5–15 pełnych sekund | 4–15 pełnych sekund; 2k wymaga co najmniej 5 |
| Rozdzielczości | 768p, 2k | 768p, 2k |
| Format klatki | aspect_ratio: 16:9, 9:16, 1:1, 4:3, 3:4, 21:9 | Określony przez obraz otwierający; brak pola proporcji |
| Opcjonalny obraz końcowy | Niedostępny | last_image_url |
| seed | Niedostępny | Niedostępny |
Szczegóły zadań znajdziesz na stronach tekst na wideo i obraz na wideo.
Oba zadania generują dźwięk wraz z filmem. Opisz dźwięk w prompcie, nawet jeśli to tylko deszcz i odgłosy pomieszczenia; obraz nie wskaże, jaka ścieżka dźwiękowa pasuje do sceny.
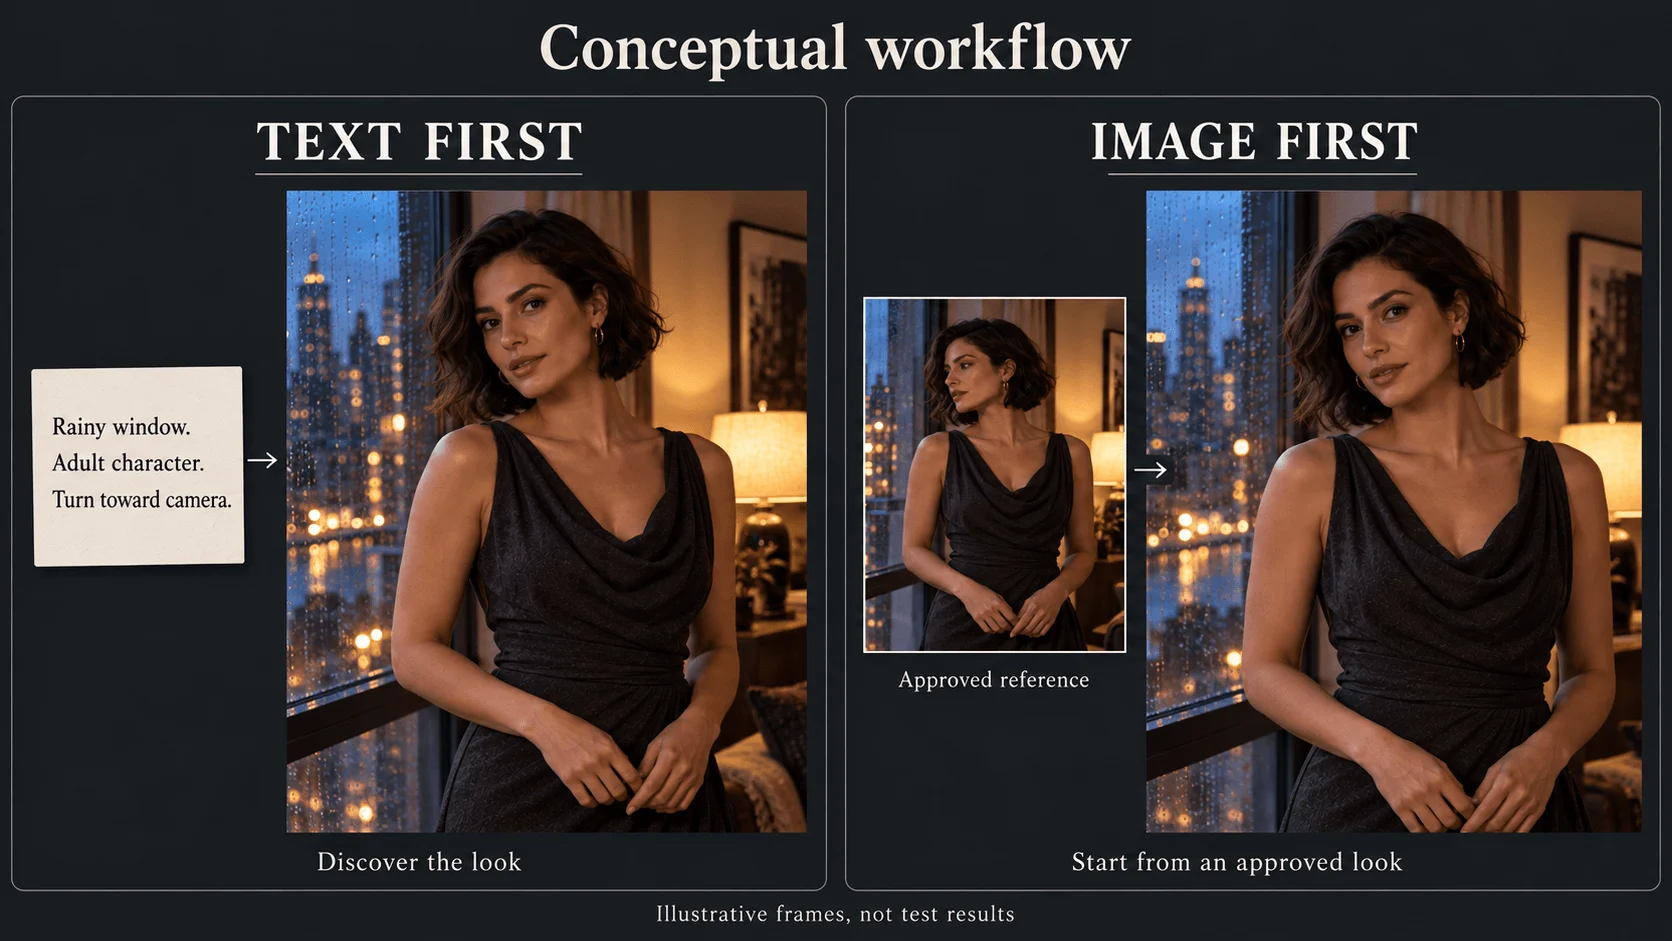
Tekst pozwala odkryć wygląd; obraz zapewnia zatwierdzony wygląd początkowy. To ilustracje, nie wyniki MiniMax.
Co to oznacza dla twórcy NSFW
W naszych testach z września 2026 oba zadania H3 przyjmowały żądania dotyczące treści dla dorosłych do najmocniejszego sprawdzonego poziomu: tekst na wideo z pisemnego opisu oraz obraz na wideo z obrazów początkowych wygenerowanych przez AI. Oba są oznaczone jako bez ograniczeń, więc ścieżka nie zmienia tego, co jest dozwolone, lecz zakres Twojej kontroli.
Akceptacja i tożsamość to odrębne kwestie. Model może przyjąć temat, a mimo to zmienić twarz w połowie obrotu. Dobierz więc ścieżkę do ujęcia i oceniaj wynik według tego, czy postać pozostaje rozpoznawalna.
MiniMax H3 Spicy to osobna rodzina obraz na wideo, a nie tryb wejścia obrazowego zwykłego H3. Przy 768p obecna cena wynosi 0,084 $ za sekundę, wobec 0,037 $ dla zwykłego H3 w 768p. Nie porównuj tej wyższej ceny ze zwykłym H3 tekst na wideo, nazywając różnicę „dopłatą za obraz na wideo”. Podobnie H3 LoRA to osobna rodzina dla zgodnych wag LoRA, a nie przełącznik w tych dwóch formularzach.
Ścieżka A: odkryj ujęcie z tekstu
Użyj jej dla nowej fikcyjnej postaci lub samodzielnego teasera, gdy dokładna twarz nie jest jeszcze ustalona. Przykładowy opis obejmuje jedną czynność: Mara, w wieku 30 lat, odwraca się od okna ze smugami deszczu w stronę widza. Grafitowa suknia wieczorowa pozostaje na niej; kamera się nie rusza.
- Otwórz MiniMax H3 tekst na wideo.
- W formularzu ustaw Aspect ratio na 9:16, Resolution na 768p i Duration na 5.
- Wklej poniższy prompt ujęcia do Prompt i sprawdź wycenę przed uruchomieniem.
Vertical medium shot of Mara, a fictional 30-year-old woman with a short dark bob, wearing a charcoal evening dress beside a rain-streaked window. Cool window light illuminates her face; a warm lamp glows behind her. She begins looking toward the window, slowly turns her head toward the camera, then holds eye contact. Her face and upper body stay in frame. Static camera. The dress remains unchanged. Audio: soft rain against the glass and quiet room tone, no speech or music.
Wybierz ją, gdy: postać nie jest jeszcze ustalona, chcesz poznawać różne wyglądy i scenerie albo jeden samodzielny klip stanowi całą pracę. Wybierz inną ścieżkę, gdy: twarz lub strój są już ustalone; skorzystaj ze ścieżki B.
Oceń pierwszy wynik jako dobór postaci i inscenizację. Jeśli twarz jest atrakcyjna, lecz różni się od ustalonej postaci, wejście wyłącznie tekstowe nie dostarczyło tej ustalonej twarzy. Powtarzanie imienia i opisu włosów nie zamienia nowej generacji w referencję tożsamości.
Po zatwierdzeniu wyglądu zapisz go przed zmianą promptu. “Keep everything, only change the lamp” nadal oznacza w tym zadaniu nową generację, a nie lokalną edycję obrazu. Jeśli lampa jest ważna, przygotuj zatwierdzony obraz otwierający z właściwą lampą i przejdź do drugiej ścieżki.
Ścieżka B: animuj zatwierdzone otwarcie
Użyj obrazu na wideo, gdy widzowie już rozpoznają Marę lub ujęcie musi pasować do zatwierdzonego obrazu kampanii. Obraz powinien pokazywać początek czynności, a nie być po prostu najlepszym portretem postaci.
Dla obrotu przy oknie przygotuj pionowe ujęcie średnie z głową skierowaną ku oknu, dostatecznie widoczną twarzą do oceny i miejscem wokół ramion. Ciasno przycięte zbliżenie twarzy słabo nadaje się na początek dużego obrotu w jedną stronę i z powrotem. Najpierw zmień kompozycję, zamiast żądać, by prompt ruchu jednocześnie rozwiązał kadrowanie, tożsamość i działanie.
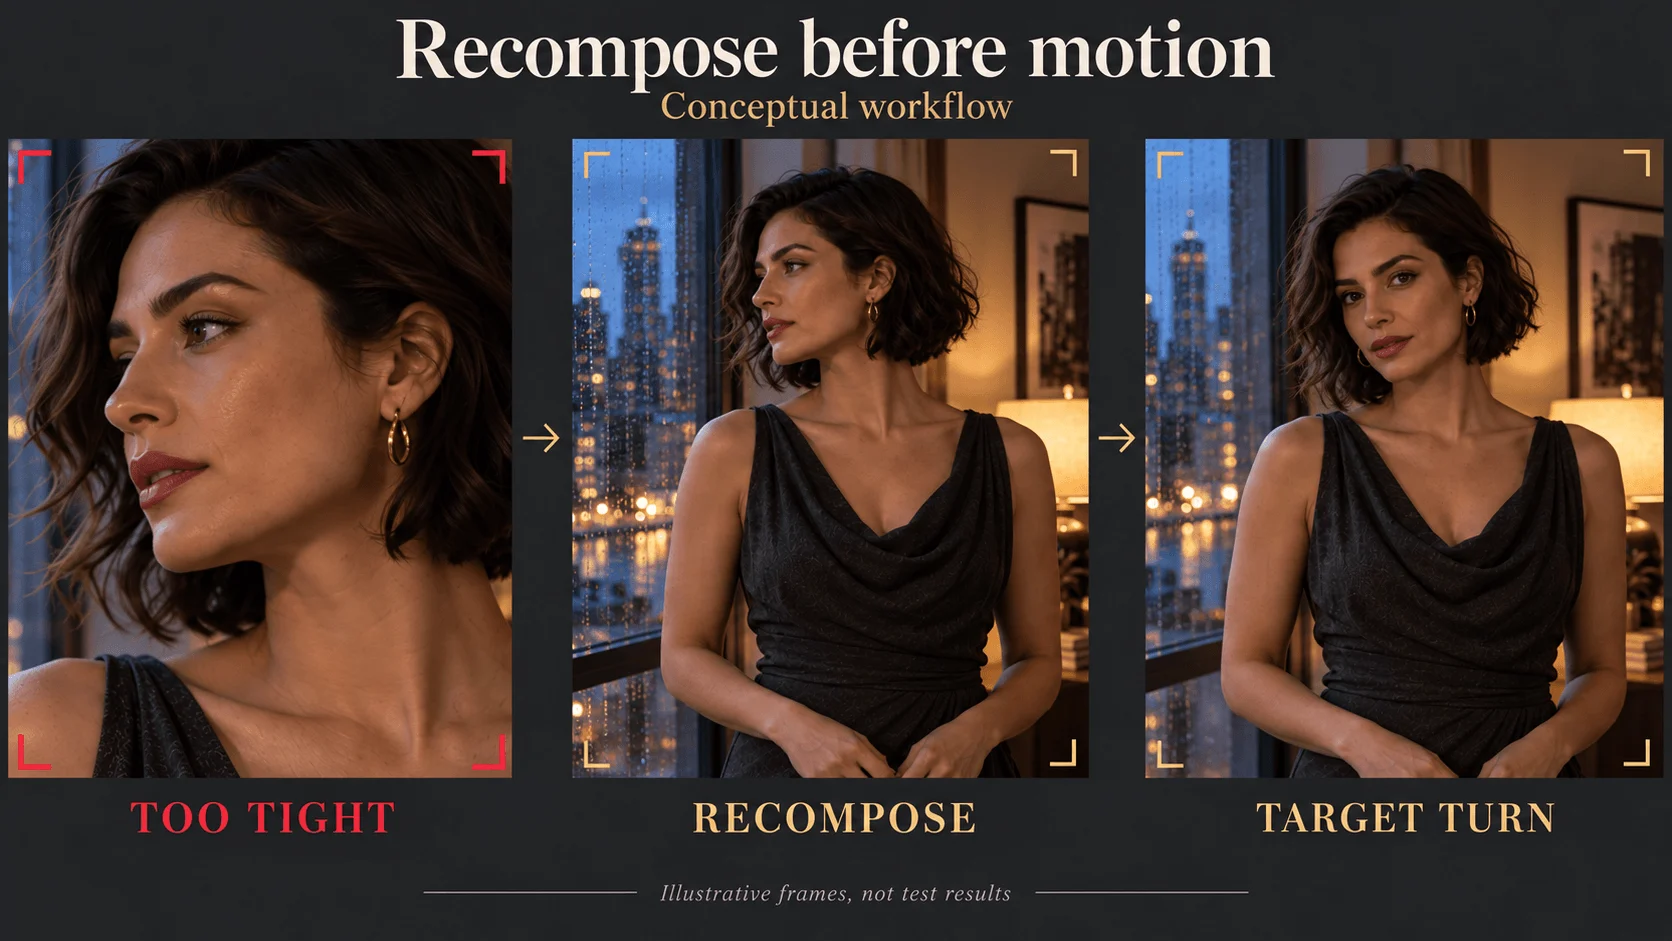
Popraw ograniczające kadrowanie, zanim poprosisz o ruch.
- Otwórz MiniMax H3 obraz na wideo.
- Dodaj zatwierdzone pionowe otwarcie w Input image. Każdy bok musi mieć 256–5 760 pikseli, proporcje mieścić się między 2:5 a 5:2, a plik mieć mniej niż 10 MB (limit Playground).
- Ustaw Resolution na 768p i Duration na 5. Obraz określa proporcje; to zadanie nie ma pola Aspect ratio.
- Wklej poniższy prompt ruchu do Prompt. Przy pierwszym prostym obrocie pozostaw Closing frame puste.
She slowly turns her head from the window toward the camera, then holds direct eye contact. Her shoulders stay relaxed. The camera remains fixed. Audio: soft rain against the glass and quiet room tone, no speech or music.
Obraz już pokazuje twarz, suknię i pokój, więc prompt opisuje tylko zmiany.
Sprawdź początek, środek i utrzymaną pozycję końcową. Zgodna pierwsza klatka może ukrywać późniejszą zmianę twarzy. Jeśli obrót ujawnia słaby profil, spróbuj kąta początkowego pokazującego więcej odpowiedniej części twarzy lub poproś o mniejszy obrót. Jeśli bezpośredni kontakt wzrokowy jest niezbędny, zachowaj to zakończenie zamiast ograniczać ruch, aż postać prawie nic nie robi.
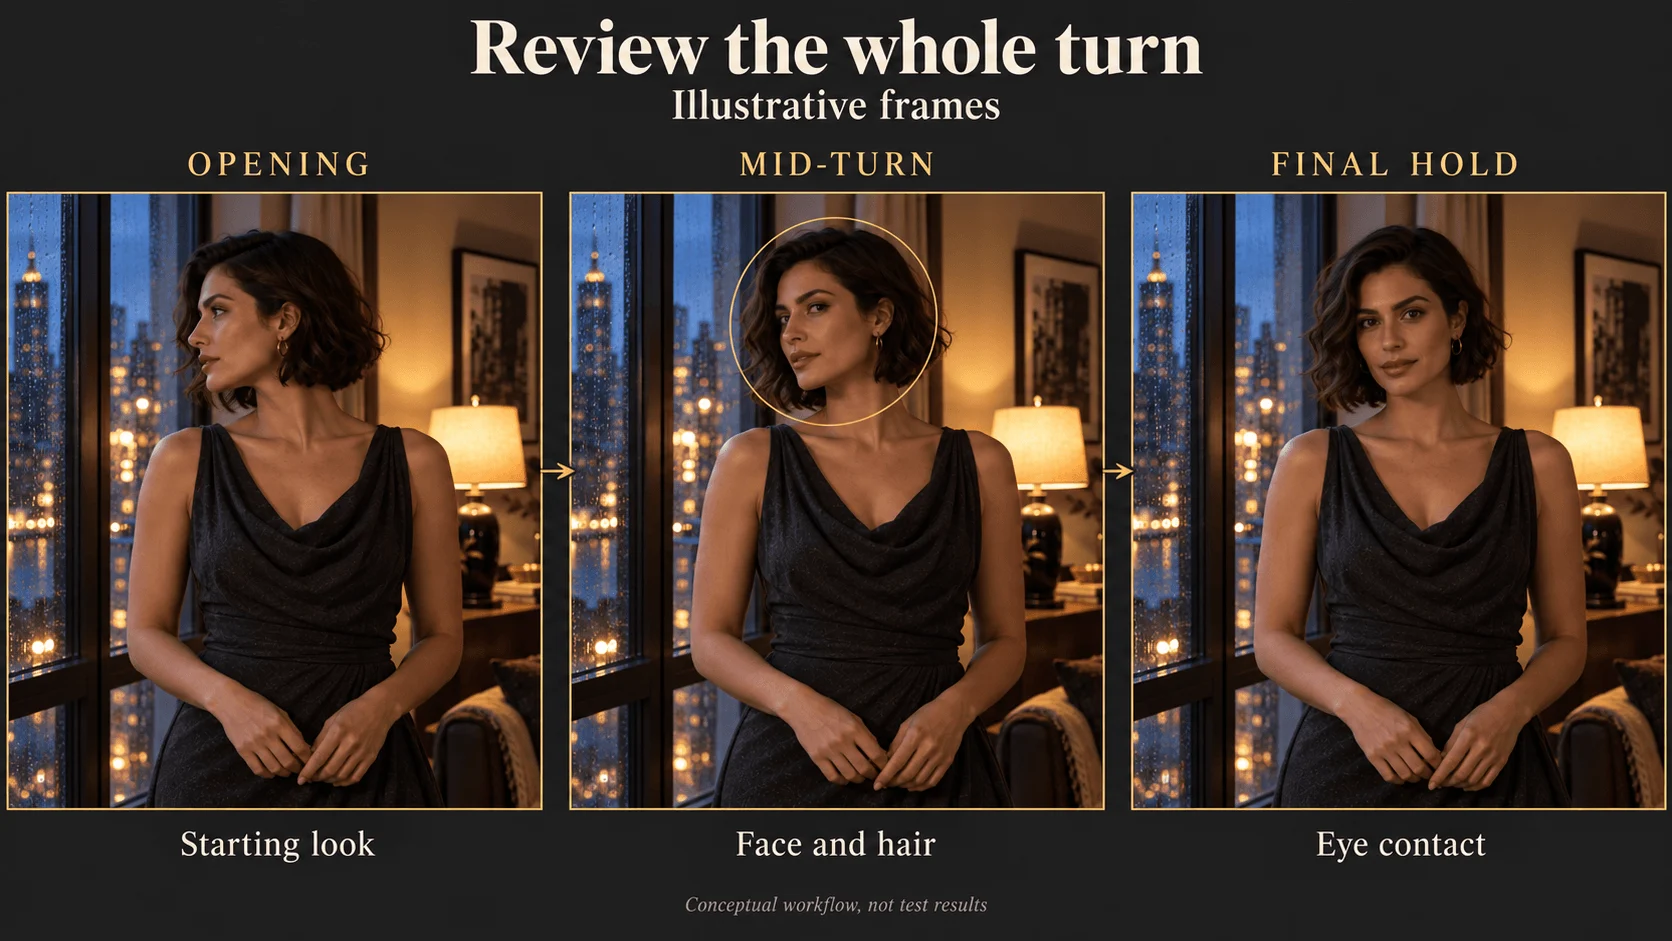
Sprawdzaj początek, obrót i utrzymaną pozycję końcową jako osobne kryteria akceptacji.
Wybierz ją, gdy: postać powraca, ujęcie musi pasować do zatwierdzonego obrazu lub twarz i strój są już ustalone. Wybierz inną ścieżkę, gdy: nadal szukasz wyglądu, ponieważ obraz utrwala również własne słabe strony.
Opcjonalna klatka końcowa (last_image_url w API) przydaje się, gdy zatwierdzona jest także końcowa kompozycja. Przygotuj ją z tą samą postacią, strojem i oświetleniem, prosząc o czynność wiarygodnie łączącą klatki. Ogranicza punkt docelowy; nie dostarcza każdej pośredniej pozycji dłoni ani nie gwarantuje poprawnego przejścia.
Ile kosztuje pięć sekund
Obecne ceny zwykłego H3 są identyczne dla obu zadań:
| Rozdzielczość | USD za sekundę | Generacja pięciu sekund |
|---|---|---|
| 768p | 0,037 $ | 0,185 $ |
| 2k | 0,058 $ | 0,290 $ |
Tworzenie obrazu kosztuje dodatkowo. Jeśli masz zatwierdzony obraz statyczny, przygotowanie może kosztować niemal nic; jeśli najpierw generujesz i odrzucasz wiele obrazów, uwzględnij te wydatki. Przy 768p trzy próby tekst na wideo kosztują 0,555 $, a jedna próba obraz na wideo 0,185 $ plus obraz. Ścieżka obrazowa wygrywa więc tylko wtedy, gdy zatwierdzony obraz kosztuje mniej niż 0,37 $. Jeśli obie udają się za pierwszym razem, tekst na wideo jest tańszy, bo ścieżka obrazowa dodaje koszt obrazu statycznego.
Szkic w 768p i finalizacja w 2k to tani schemat, ale uruchomienie w 2k jest nowym dublem, nie skalowaniem szkicu w górę: H3 nie udostępnia seed, więc nawet identyczne żądanie zwraca inny ruch. Jeśli zaakceptowany ruch musi pozostać dokładnie taki sam, użyj osobnego zadania skalowania. Rodziny udostępniające seed, takie jak H3 Spicy obraz na wideo lub Seedance 2.5, pozwalają powtarzać żądanie w bardziej odtwarzalny sposób.
Napraw najwcześniejszy widoczny defekt
| Co widzisz | Następne działanie |
|---|---|
| Niewłaściwa suknia na obrazie otwierającym | Popraw obraz statyczny przed kolejną generacją wideo |
| Początkowo właściwa twarz, inna podczas obrotu | Ogranicz obrót lub przygotuj bardziej informacyjny kąt otwarcia |
| Dobry portret, ale za mało miejsca na gest | Poszerz obraz początkowy lub zmień kompozycję |
| Kamera zbliża się mimo opisu nieruchomej kamery | Usuń konkurujące instrukcje kamery i zostaw jedno polecenie ruchu |
| Żądany obrót nigdy się nie kończy | Usuń działania poboczne lub wydłuż czas |
| Masz portret postaci, ale potrzebujesz nowego pokoju i pozy | Przygotuj nowe otwarcie lub użyj osobnego zadania referencja na wideo |
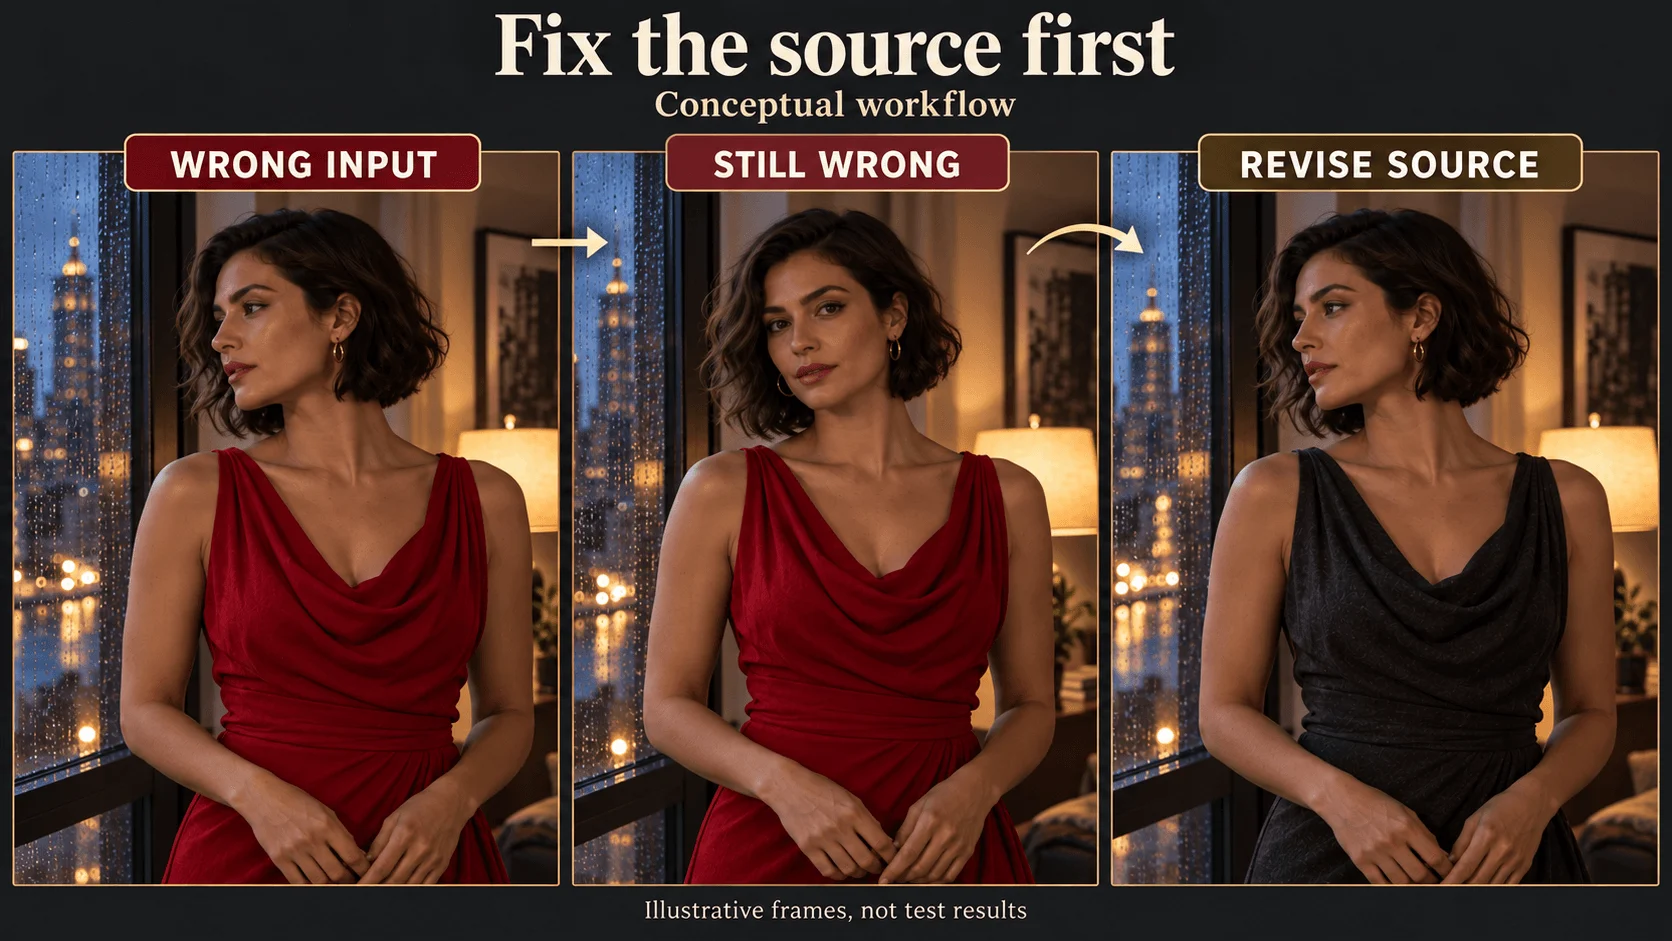
Gdy strój otwierający jest błędny, popraw źródło przed kolejną próbą ruchu.
Referencja tożsamości i klatka otwierająca to różne materiały. Jeśli chcesz Marę siedzącą przy stole, nie przesyłaj jej portretu przy oknie jako dosłownego otwarcia, oczekując, że posłuży wyłącznie jako referencja twarzy. H3 referencja na wideo jest osobnym zadaniem przyjmującym od jednego do dziewięciu obrazów referencyjnych; sprawdź oddzielnie dodatkowe wejścia i wycenę.
Uruchom przez API
Gdy wynik z Playground wygląda dobrze, to samo żądanie działa z kodu. To przykład tekst na wideo; dla obrazu na wideo zmień model na minimax/h3/image-to-video, usuń aspect_ratio i dodaj image_url.
import os
import uuid

import requests

response = requests.post(
    "https://api.spicyapi.ai/api/v1/jobs/createTask",
    headers={
        "Authorization": f"Bearer {os.environ['SPICY_API_KEY']}",
        "Idempotency-Key": str(uuid.uuid4()),  # new key for each new request
    },
    json={
        "model": "minimax/h3/text-to-video",
        "input": {
            "prompt": "Vertical medium shot of Mara, a fictional 30-year-old woman with a short dark bob, wearing a charcoal evening dress beside a rain-streaked window. She slowly turns her head toward the camera, then holds eye contact. Static camera. Audio: soft rain, quiet room tone.",
            "aspect_ratio": "9:16",
            "resolution": "768p",
            "duration_seconds": 5,
        },
    },
)
print(response.json())
Pola, wyniki i błędy znajdziesz w dokumentacji API.
Możesz też zlecić wykonanie Agentowi. Agent może wykonać to samo wywołanie przez CLI, serwer MCP lub Agent Skill. Wszystkie trzy odczytują aktualny schemat modelu, a CLI i MCP pokazują cenę i proszą o potwierdzenie przed utworzeniem zadania.
# CLI
npx @spicyapi/cli tasks create --model minimax/h3/text-to-video \
  --input-json '{"prompt": "Mara turns from a rain-streaked window toward the camera and holds eye contact. Static camera. Audio: soft rain.", "aspect_ratio": "9:16", "resolution": "768p", "duration_seconds": 5}' --wait

# MCP server: the command your assistant's MCP config runs
npx --yes --package=@spicyapi/mcp spicyapi-mcp

# Agent Skill
npx skills add spicyapi-ai/spicy-skill
Stwórz scenę dłuższą niż 15 sekund
Jedno żądanie H3 ma limit 15 sekund i nie istnieje zadanie przedłużenia. Zatwierdź klip, pobierz jego ostatnią klatkę i użyj jej jako obrazu otwierającego następne ujęcie obraz na wideo. Każdy prompt opisuje wtedy tylko to, co następuje dalej. Przenosisz wygląd poprzedniego ujęcia do następnej klatki otwierającej zamiast za każdym razem dobierać postać tekstem.
Którą ścieżkę wybrać
Dla cotygodniowej serii z postacią zatwierdź obraz otwierający dla każdego ujęcia i animuj go. Dla nowej scenerii bez ustalonej obsady zacznij od tekstu i traktuj wynik jako eksplorację. Zmień ścieżkę, gdy twarz i kompozycja staną się wymaganiami wartymi zachowania.