Para un personaje adulto recurrente, empiece con imagen a vídeo cuando el rostro, la ropa y el plano inicial estén aprobados. Empiece con texto a vídeo cuando aún esté eligiendo al personaje o explorando la escena. Una imagen aporta un inicio concreto; un prompt de texto deja que el modelo lo invente. Ninguna entrada garantiza que el rostro se mantenga estable cuando el personaje se mueve.
La comparación utiliza MiniMax H3 porque SpicyAPI ofrece ambas tareas a los mismos precios por segundo. La elección depende de lo que ya tenga y de lo que necesite corregir, no de un descuento por elegir una vía. Los prompts de ejemplo utilizan una persona adulta ficticia completamente vestida.
La misma familia, dos entradas diferentes
| Especificación actual de MiniMax H3 | Texto a vídeo | Imagen a vídeo |
|---|---|---|
| Entrada obligatoria | prompt | prompt e image_url |
| Duración | 5–15 segundos enteros | 4–15 segundos enteros; 2k requiere al menos 5 |
| Resoluciones | 768p, 2k | 768p, 2k |
| Formato del fotograma | aspect_ratio: 16:9, 9:16, 1:1, 4:3, 3:4, 21:9 | Lo determina la imagen inicial; sin campo de relación de aspecto |
| Imagen final opcional | No disponible | last_image_url |
| seed | No disponible | No disponible |
Los detalles de cada tarea están en las páginas de texto a vídeo e imagen a vídeo.
Ambas tareas generan sonido junto con el vídeo. Describa el sonido en el prompt, aunque solo sea lluvia y ambiente de la habitación; una imagen no puede indicar qué banda sonora corresponde a la escena.
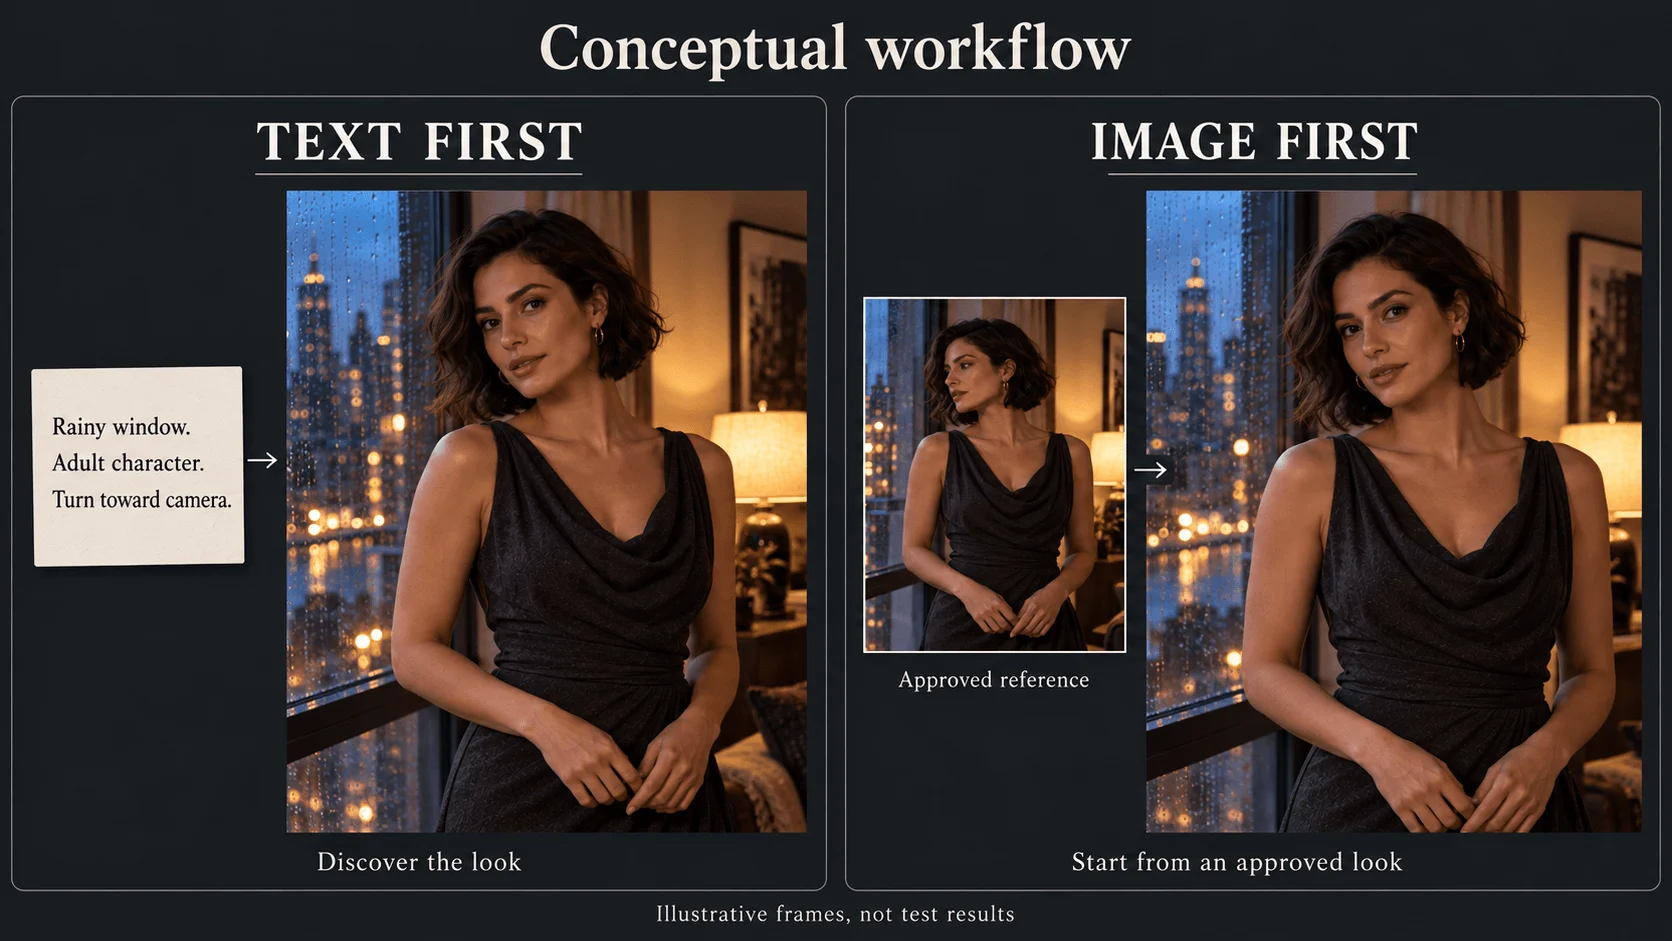
Empezar por texto permite descubrir la apariencia; empezar por imagen aporta un aspecto inicial aprobado. Son ilustraciones, no resultados de MiniMax.
Qué significa para un creador de NSFW
Según nuestras pruebas de septiembre de 2026, ambas tareas H3 aceptaron solicitudes de contenido adulto hasta el nivel más intenso que comprobamos: texto a vídeo desde una descripción escrita e imagen a vídeo desde imágenes iniciales generadas por IA. Ambas figuran como sin restricciones; la vía no cambia lo permitido, sino el control del que dispone.
La aceptación y la identidad son cuestiones distintas. Un modelo puede aceptar el tema y aun así cambiar el rostro a mitad de un giro. Elija la vía según el plano y evalúe si el personaje sigue siendo reconocible.
MiniMax H3 Spicy es una familia independiente de imagen a vídeo, no el modo de entrada de imagen de H3 normal. En 768p, su precio actual es de $0.084 por segundo, frente a $0.037 de H3 normal en 768p. No compare ese precio superior con texto a vídeo de H3 normal para llamar a la diferencia «recargo de imagen a vídeo». Asimismo, H3 LoRA es una familia independiente para pesos LoRA compatibles, no un interruptor de estos dos formularios.
Vía A: descubrir el plano a partir del texto
Utilice esta vía para un personaje ficticio nuevo o un avance independiente cuyo rostro exacto aún no esté fijado. La descripción de ejemplo contiene una acción: Mara, de 30 años, se vuelve desde una ventana cubierta de lluvia hacia el espectador. Su vestido de noche color carbón permanece puesto; la cámara sigue fija.
- Abra MiniMax H3 texto a vídeo.
- En el formulario, ajuste Aspect ratio a 9:16, Resolution a 768p y Duration a 5.
- Pegue el prompt del plano que aparece debajo en Prompt y revise la estimación antes de ejecutarlo.
Vertical medium shot of Mara, a fictional 30-year-old woman with a short dark bob, wearing a charcoal evening dress beside a rain-streaked window. Cool window light illuminates her face; a warm lamp glows behind her. She begins looking toward the window, slowly turns her head toward the camera, then holds eye contact. Her face and upper body stay in frame. Static camera. The dress remains unchanged. Audio: soft rain against the glass and quiet room tone, no speech or music.
Elíjala cuando: el personaje aún no esté definido, quiera explorar aspectos y escenarios, o un único clip independiente sea todo el trabajo. Busque otra vía cuando: el rostro o el vestuario ya estén fijados; utilice la vía B.
Evalúe el primer resultado como selección del personaje y puesta en escena. Si el rostro resulta atractivo pero difiere de un personaje establecido, la entrada de texto no ha aportado ese rostro establecido. Repetir el nombre y la descripción del pelo no convierte una generación nueva en una referencia de identidad.
Cuando apruebe un aspecto, guárdelo antes de cambiar el prompt. “Keep everything, only change the lamp” sigue siendo una generación nueva en esta tarea; no es una edición local de imagen. Si la lámpara importa, prepare una imagen inicial aprobada con la lámpara correcta y pase a la segunda vía.
Vía B: animar un inicio aprobado
Utilice imagen a vídeo cuando el público ya reconozca a Mara o el plano deba coincidir con una imagen de campaña aprobada. La imagen debe mostrar el inicio de la acción, no simplemente ser su mejor retrato del personaje.
Para el giro junto a la ventana, prepare un plano medio vertical con la cabeza orientada hacia la ventana, suficiente rostro visible para revisarlo y espacio alrededor de los hombros. Un primer plano del rostro muy recortado es un mal punto de partida para un giro amplio de ida y vuelta. Recomponga primero la imagen, en lugar de pedir al prompt de movimiento que resuelva simultáneamente encuadre, identidad y acción.
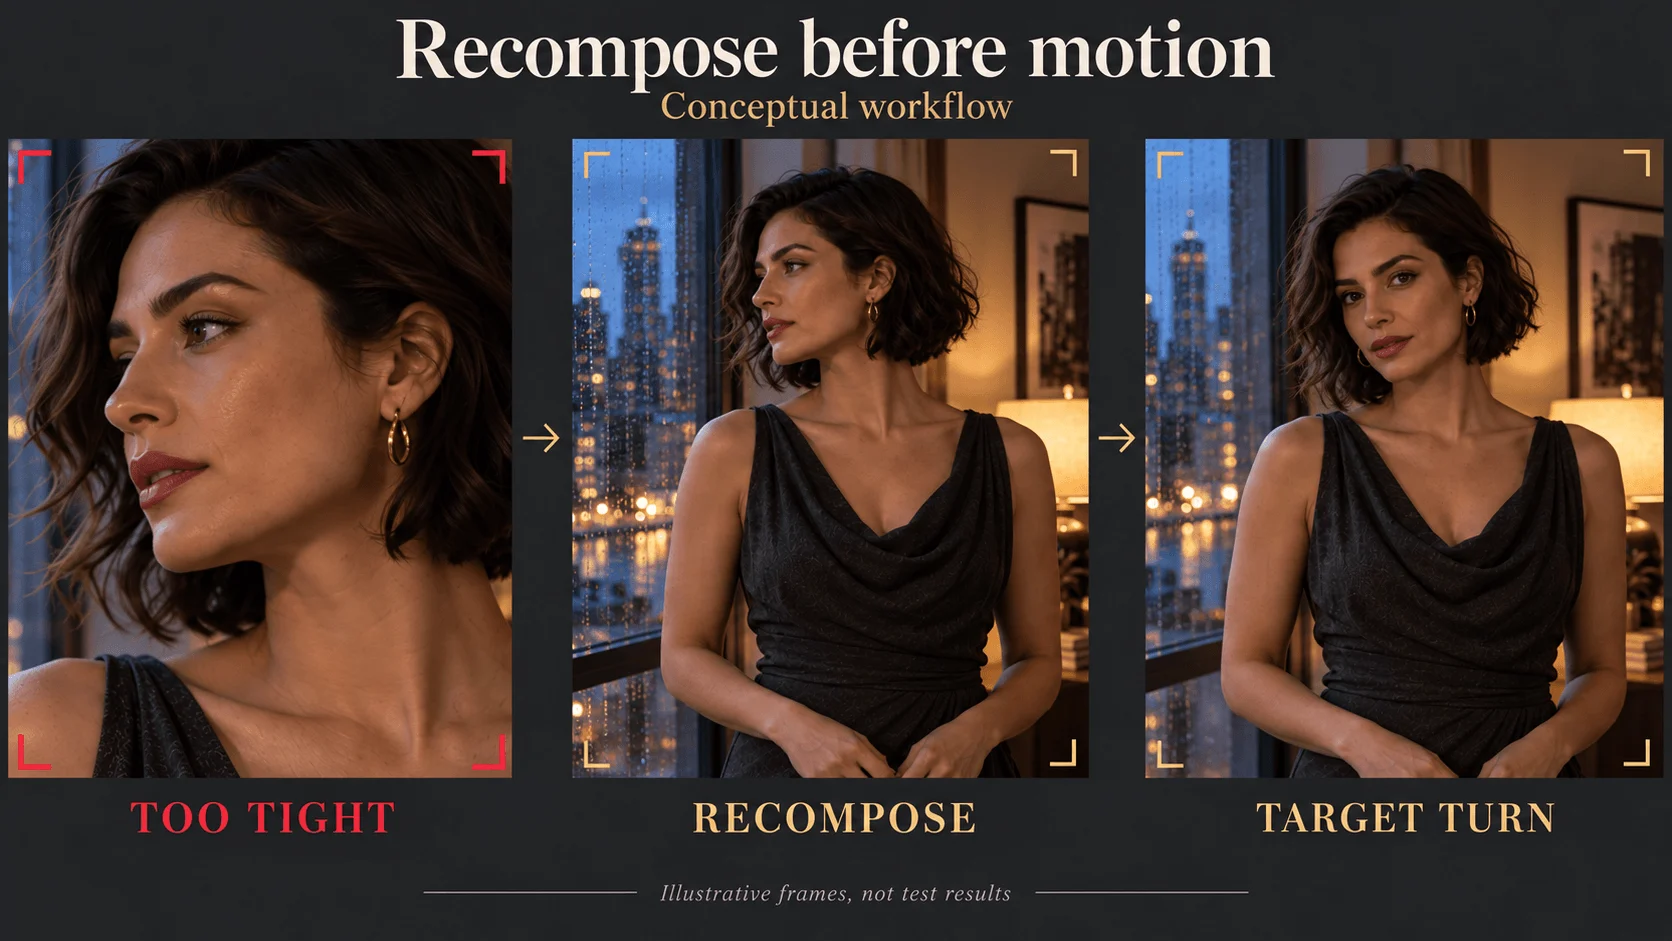
Corrija un encuadre restrictivo antes de pedir movimiento.
- Abra MiniMax H3 imagen a vídeo.
- Añada el inicio vertical aprobado en Input image. Cada lado debe medir 256–5.760 píxeles, la proporción debe estar entre 2:5 y 5:2, y el archivo debe ocupar menos de 10 MB (el límite de Playground).
- Ajuste Resolution a 768p y Duration a 5. La imagen determina la proporción; esta tarea no tiene campo Aspect ratio.
- Pegue el siguiente prompt de movimiento en Prompt. Deje Closing frame vacío para el primer giro sencillo.
She slowly turns her head from the window toward the camera, then holds direct eye contact. Her shoulders stay relaxed. The camera remains fixed. Audio: soft rain against the glass and quiet room tone, no speech or music.
La imagen ya muestra el rostro, el vestido y la habitación, por lo que el prompt solo indica qué cambia.
Revise el inicio, el punto medio y la pausa final. Un primer fotograma coincidente puede ocultar cambios posteriores del rostro. Si el giro revela un perfil poco convincente, pruebe un ángulo inicial que muestre más de la parte relevante del rostro o pida un giro menor. Si el contacto visual directo es esencial, conserve ese final en lugar de reducir el movimiento hasta que el personaje apenas actúe.
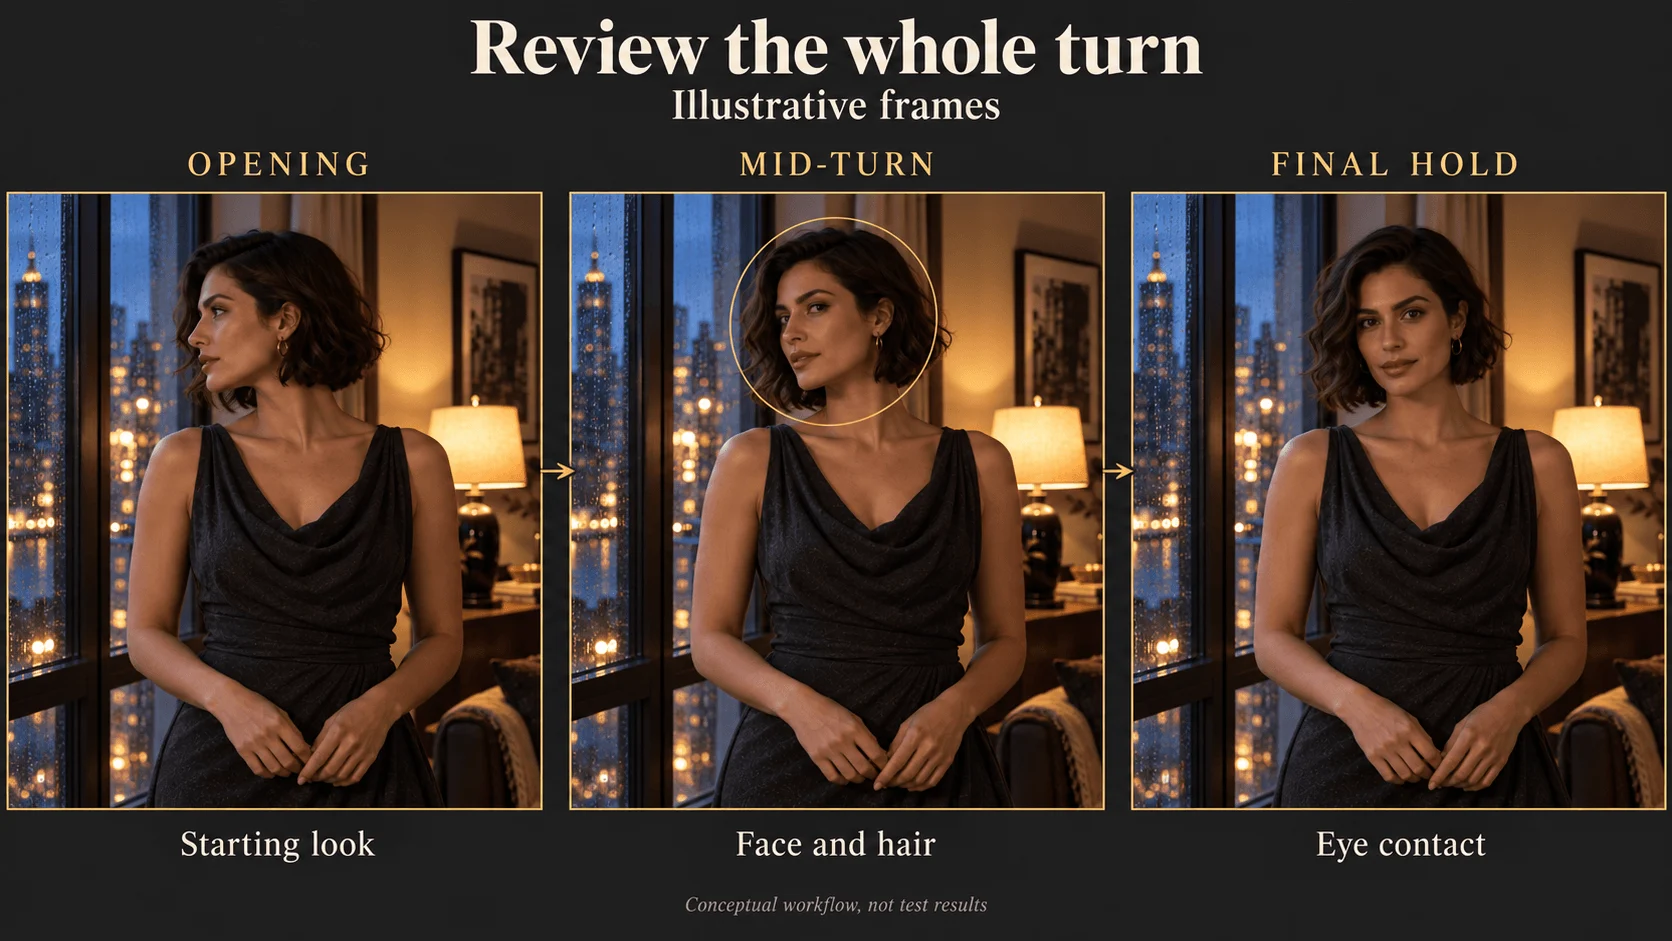
Revise el inicio, el giro y la pausa final como comprobaciones de aceptación independientes.
Elíjala cuando: el personaje sea recurrente, el plano deba coincidir con una imagen aprobada o ya haya fijado rostro y vestuario. Busque otra vía cuando: todavía necesite encontrar el aspecto, ya que una imagen también fija sus puntos débiles.
El fotograma final opcional (last_image_url en la API) es útil cuando también ha aprobado la composición final. Prepárelo con el mismo personaje, vestuario e iluminación, y pida una acción que conecte los fotogramas de forma plausible. Limita el destino; no aporta cada posición intermedia de las manos ni garantiza una transición correcta.
Cuánto cuestan cinco segundos
Los precios actuales de H3 normal son idénticos para ambas tareas:
| Resolución | USD por segundo | Generación de cinco segundos |
|---|---|---|
| 768p | $0.037 | $0.185 |
| 2k | $0.058 | $0.290 |
Crear la imagen tiene un coste adicional. Si ya dispone de una imagen fija aprobada, la preparación puede costar casi nada; si primero genera y descarta muchas imágenes, cuente ese gasto. En 768p, tres intentos de texto a vídeo cuestan $0.555, mientras que un intento de imagen a vídeo cuesta $0.185 más la imagen. Por tanto, la vía de imagen solo resulta más barata si la imagen fija aprobada cuesta menos de $0.37. Si ambas funcionan al primer intento, texto a vídeo es más barato porque la vía de imagen añade el coste de la imagen fija.
Bocetar en 768p y finalizar en 2k es la estrategia económica, pero la ejecución en 2k es una toma nueva, no un aumento de resolución del borrador: H3 no ofrece seed, así que incluso una solicitud idéntica produce un movimiento distinto. Si el movimiento aceptado debe conservarse exactamente, utilice una tarea independiente de aumento de resolución. Las familias que sí ofrecen seed, como H3 Spicy imagen a vídeo o Seedance 2.5, permiten repetir una solicitud de forma más reproducible.
Corrija el primer defecto visible
| Lo que observa | Próxima acción |
|---|---|
| Vestido incorrecto en la imagen inicial | Corregir la imagen fija antes de generar otro vídeo |
| Rostro correcto al principio, distinto durante el giro | Reducir el giro o preparar un ángulo inicial más informativo |
| Buen retrato, pero sin espacio suficiente para el gesto | Ampliar o recomponer la imagen inicial |
| La cámara se acerca pese a la indicación de cámara fija | Quitar instrucciones de cámara contrapuestas y mantener una orden de movimiento |
| El giro solicitado nunca termina | Quitar acciones secundarias o permitir más duración |
| Tiene un retrato del personaje, pero necesita otra habitación y pose | Preparar el nuevo inicio o utilizar la tarea independiente de referencia a vídeo |
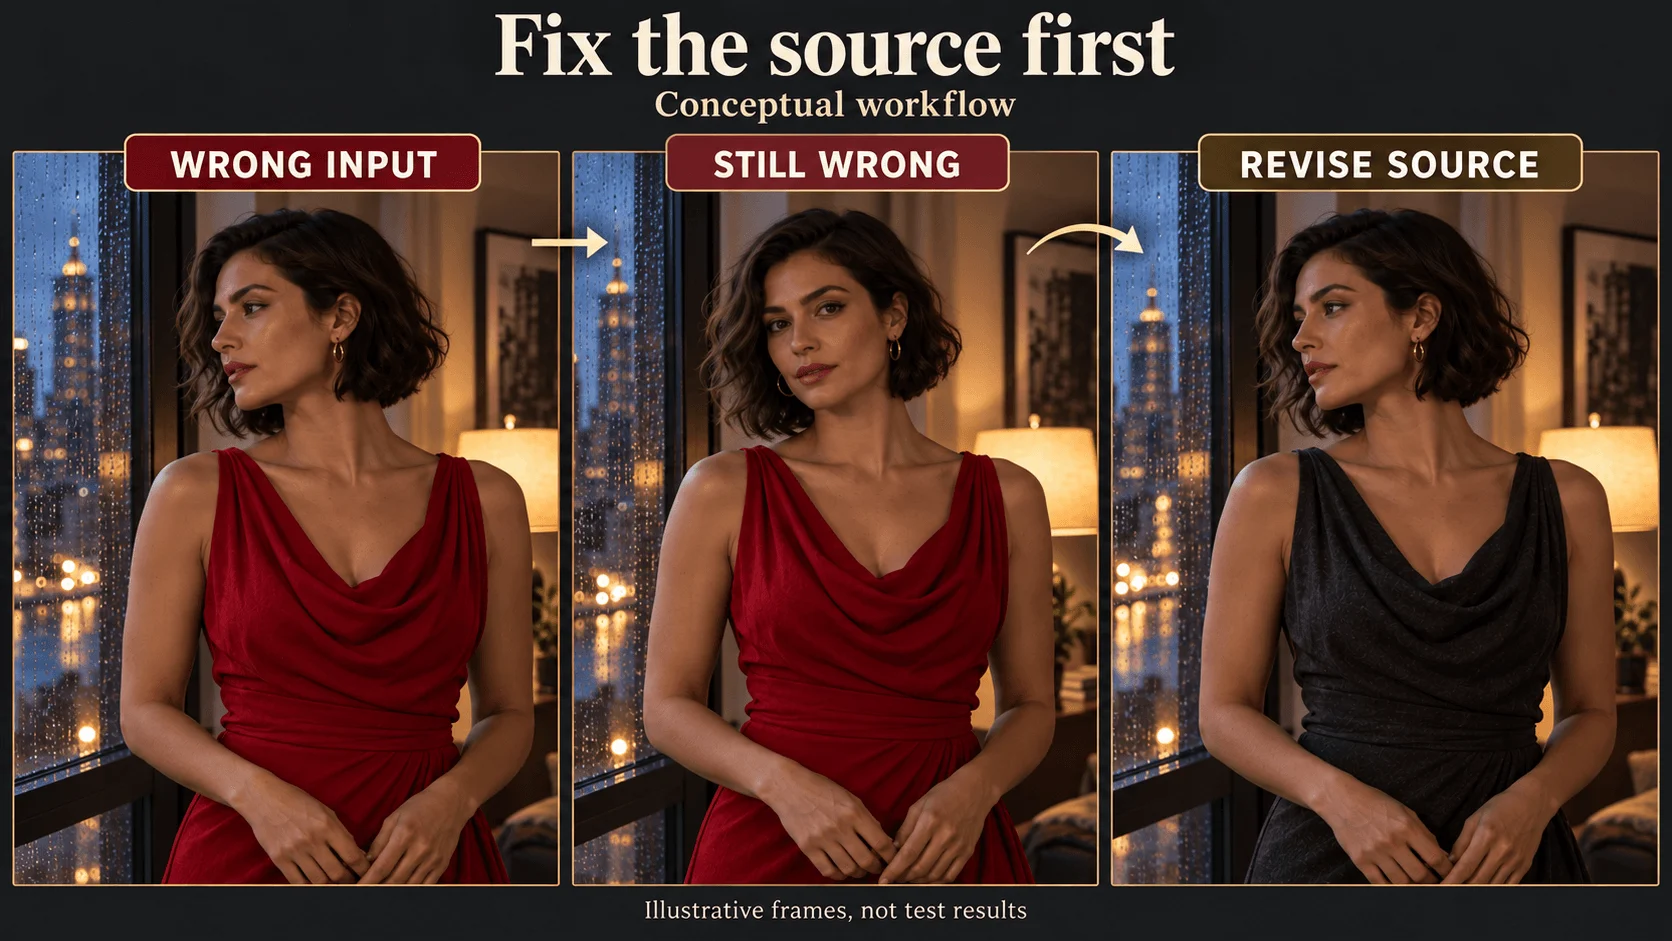
Si el vestuario inicial es incorrecto, revise la fuente antes de otro intento de movimiento.
Una referencia de identidad y un fotograma inicial son recursos distintos. Si quiere a Mara sentada a una mesa, no suba su retrato junto a la ventana como inicio literal esperando que sirva solo como referencia del rostro. H3 referencia a vídeo es una tarea independiente que acepta de una a nueve imágenes de referencia; sus entradas adicionales y su estimación deben revisarse por separado.
Ejecutarlo desde la API
Cuando una ejecución en Playground se vea bien, la misma solicitud funciona desde el código. Este es el ejemplo de texto a vídeo; para imagen a vídeo, cambie el modelo a minimax/h3/image-to-video, quite aspect_ratio y añada image_url.
import os
import uuid

import requests

response = requests.post(
    "https://api.spicyapi.ai/api/v1/jobs/createTask",
    headers={
        "Authorization": f"Bearer {os.environ['SPICY_API_KEY']}",
        "Idempotency-Key": str(uuid.uuid4()),  # new key for each new request
    },
    json={
        "model": "minimax/h3/text-to-video",
        "input": {
            "prompt": "Vertical medium shot of Mara, a fictional 30-year-old woman with a short dark bob, wearing a charcoal evening dress beside a rain-streaked window. She slowly turns her head toward the camera, then holds eye contact. Static camera. Audio: soft rain, quiet room tone.",
            "aspect_ratio": "9:16",
            "resolution": "768p",
            "duration_seconds": 5,
        },
    },
)
print(response.json())
Los campos, resultados y errores están en la referencia de la API.
O deje que lo ejecute un Agent. Un agente puede hacer la misma llamada mediante la CLI, el servidor MCP o el Agent Skill. Los tres leen el esquema actual del modelo; la CLI y MCP muestran el precio y piden confirmación antes de crear una tarea.
# CLI
npx @spicyapi/cli tasks create --model minimax/h3/text-to-video \
  --input-json '{"prompt": "Mara turns from a rain-streaked window toward the camera and holds eye contact. Static camera. Audio: soft rain.", "aspect_ratio": "9:16", "resolution": "768p", "duration_seconds": 5}' --wait

# MCP server: the command your assistant's MCP config runs
npx --yes --package=@spicyapi/mcp spicyapi-mcp

# Agent Skill
npx skills add spicyapi-ai/spicy-skill
Crear una escena de más de 15 segundos
Una solicitud H3 tiene un máximo de 15 segundos y no hay tarea de extensión. Apruebe el clip, extraiga su fotograma final y utilícelo como imagen inicial del siguiente plano de imagen a vídeo; cada prompt describe solo lo que sucede después. Así lleva el aspecto del plano anterior al siguiente fotograma inicial, en lugar de pedir al texto que vuelva a elegir al personaje cada vez.
Qué vía elegir
Para una serie semanal de un personaje, apruebe una imagen inicial por plano y anímela. Para un escenario nuevo sin reparto fijo, empiece con texto y trate el resultado como exploración. Cambie cuando el rostro y la composición se conviertan en requisitos que merezca la pena conservar.