Pour un personnage adulte récurrent, partez de l’image vers vidéo dès que le visage, les vêtements et le plan d’ouverture sont approuvés. Partez du texte vers vidéo si vous choisissez encore le personnage ou découvrez la scène. Une image fournit une ouverture précise ; un prompt textuel laisse le modèle l’inventer. Aucune entrée ne garantit la stabilité du visage lorsque le personnage bouge.
Cette comparaison utilise MiniMax H3, car SpicyAPI propose les deux tâches aux mêmes tarifs par seconde. Le choix dépend donc de ce que vous avez déjà et de ce qu’il faut corriger, pas d’une réduction liée au parcours. Les exemples de prompts mettent en scène une personne adulte fictive entièrement vêtue.
Une même famille, deux entrées différentes
| Spécification actuelle de MiniMax H3 | Texte vers vidéo | Image vers vidéo |
|---|---|---|
| Entrée requise | prompt | prompt et image_url |
| Durée | 5–15 secondes entières | 4–15 secondes entières ; au moins 5 en 2k |
| Résolutions | 768p, 2k | 768p, 2k |
| Format de l’image | aspect_ratio : 16:9, 9:16, 1:1, 4:3, 3:4, 21:9 | Déterminé par l’image d’ouverture ; aucun champ de rapport d’aspect |
| Image finale facultative | Non disponible | last_image_url |
| seed | Non disponible | Non disponible |
Les détails figurent sur les pages texte vers vidéo et image vers vidéo.
Les deux tâches génèrent le son avec la vidéo. Décrivez-le dans le prompt, même s’il se limite à la pluie et à l’ambiance de la pièce ; une image ne peut pas indiquer quelle bande-son accompagne la scène.
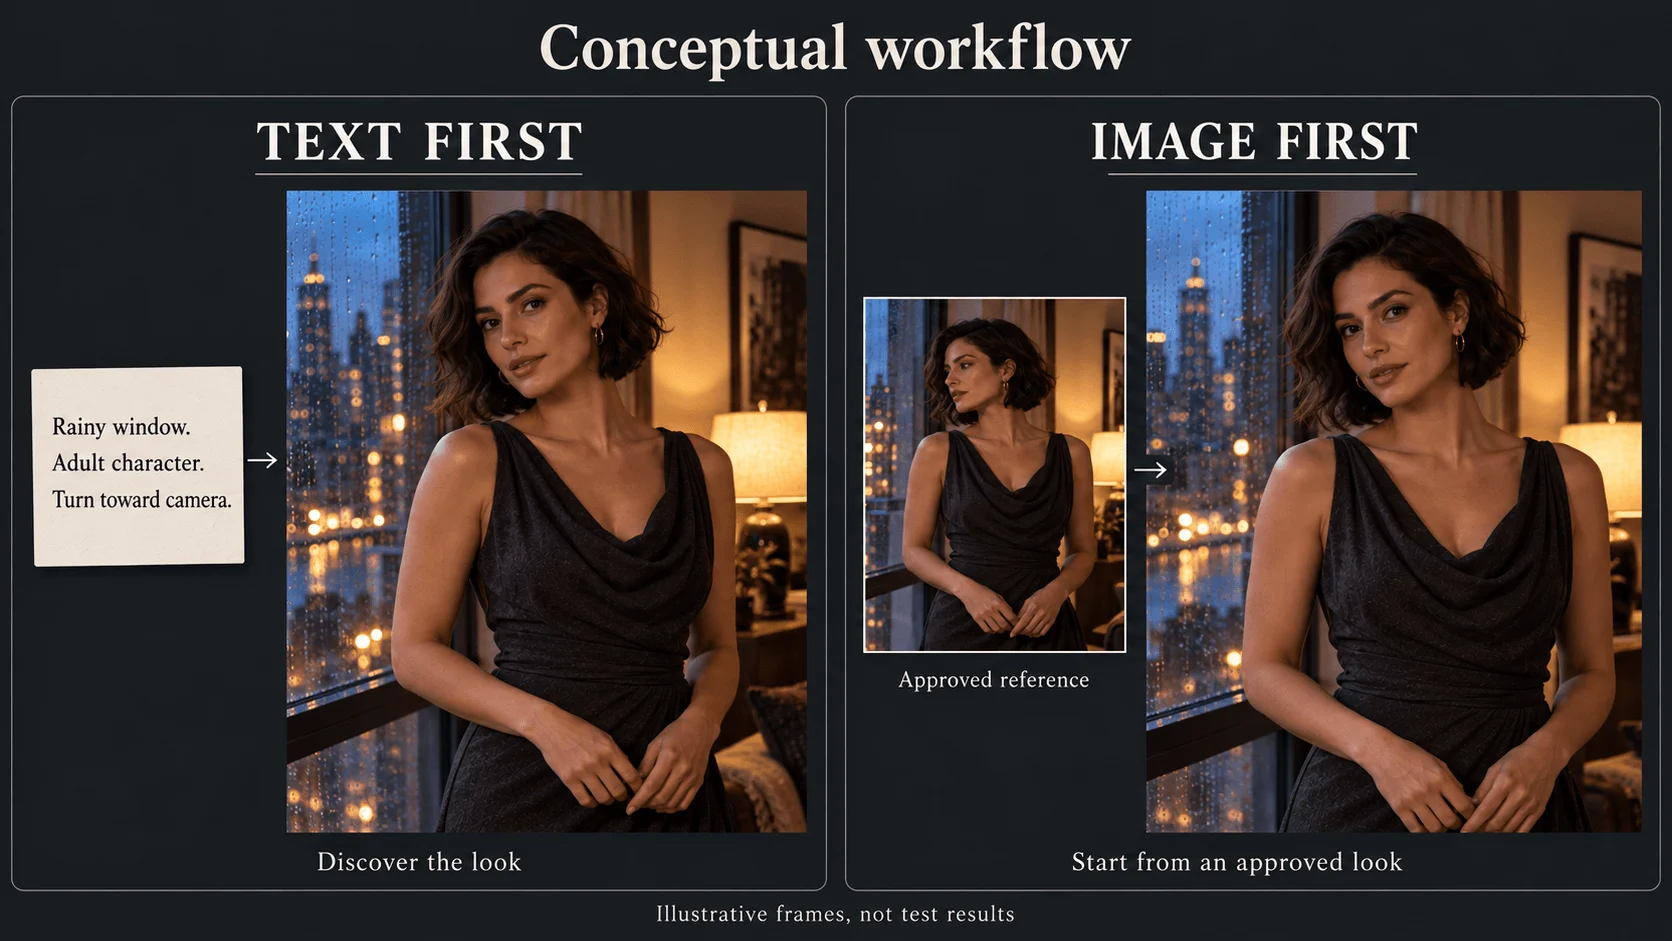
Le texte permet de découvrir l’apparence ; l’image fournit une apparence initiale approuvée. Illustrations, et non résultats de MiniMax.
Ce que cela signifie pour un créateur NSFW
D’après nos tests de septembre 2026, les deux tâches H3 ont accepté les requêtes pour adultes jusqu’au niveau le plus intense que nous avons vérifié : texte vers vidéo à partir d’une description écrite, et image vers vidéo à partir d’images initiales générées par IA. Toutes deux sont présentées comme sans restrictions : le parcours ne change pas ce qui est permis, mais votre degré de contrôle.
L’acceptation et l’identité sont deux questions distinctes. Un modèle peut accepter le sujet et changer malgré tout le visage au milieu d’une rotation. Choisissez donc le parcours selon le plan et jugez le résultat sur la reconnaissance du personnage.
MiniMax H3 Spicy est une famille distincte d’image vers vidéo, pas le mode à entrée image de H3 ordinaire. En 768p, son tarif actuel est de $0.084 par seconde, contre $0.037 pour H3 ordinaire en 768p. Ne comparez pas ce tarif supérieur au texte vers vidéo de H3 ordinaire en qualifiant la différence de « supplément image vers vidéo ». De même, H3 LoRA est une famille distincte pour les poids LoRA compatibles, pas une option de ces deux formulaires.
Parcours A : découvrir le plan à partir du texte
Utilisez ce parcours pour un nouveau personnage fictif ou un teaser autonome dont le visage exact n’est pas encore fixé. La description d’exemple comporte une action : Mara, âgée de 30 ans, se détourne d’une fenêtre striée de pluie vers le spectateur. Sa robe de soirée anthracite reste en place ; la caméra reste fixe.
- Ouvrez MiniMax H3 texte vers vidéo.
- Réglez Aspect ratio sur 9:16, Resolution sur 768p et Duration sur 5.
- Collez le prompt ci-dessous dans Prompt et vérifiez l’estimation avant de lancer la génération.
Vertical medium shot of Mara, a fictional 30-year-old woman with a short dark bob, wearing a charcoal evening dress beside a rain-streaked window. Cool window light illuminates her face; a warm lamp glows behind her. She begins looking toward the window, slowly turns her head toward the camera, then holds eye contact. Her face and upper body stay in frame. Static camera. The dress remains unchanged. Audio: soft rain against the glass and quiet room tone, no speech or music.
Choisissez ce parcours si : le personnage reste à définir, vous explorez des apparences et des décors, ou un seul clip autonome constitue tout le travail. Choisissez un autre parcours si : le visage ou les vêtements sont déjà fixés ; utilisez le parcours B.
Jugez le premier résultat comme un choix de personnage et une mise en scène. Si le visage est séduisant mais différent d’un personnage établi, l’entrée textuelle seule n’a pas fourni ce visage établi. Répéter le même nom et la description des cheveux ne transforme pas une nouvelle génération en référence d’identité.
Dès que vous approuvez une apparence, enregistrez-la avant de modifier le prompt. “Keep everything, only change the lamp” reste une nouvelle génération dans cette tâche, pas une retouche locale. Si la lampe compte, préparez une image d’ouverture approuvée avec la bonne lampe et passez au second parcours.
Parcours B : animer une ouverture approuvée
Utilisez l’image vers vidéo lorsque le public reconnaît déjà Mara ou que le plan doit correspondre à une image de campagne approuvée. L’image doit montrer le début de l’action, pas simplement être votre meilleur portrait du personnage.
Pour la rotation près de la fenêtre, préparez un plan moyen vertical, la tête tournée vers la fenêtre, avec assez de visage visible pour l’inspecter et de l’espace autour des épaules. Un gros plan très serré du visage convient mal à une grande rotation aller-retour. Recomposez d’abord l’image, au lieu de demander au prompt de mouvement de résoudre simultanément le cadrage, l’identité et l’action.
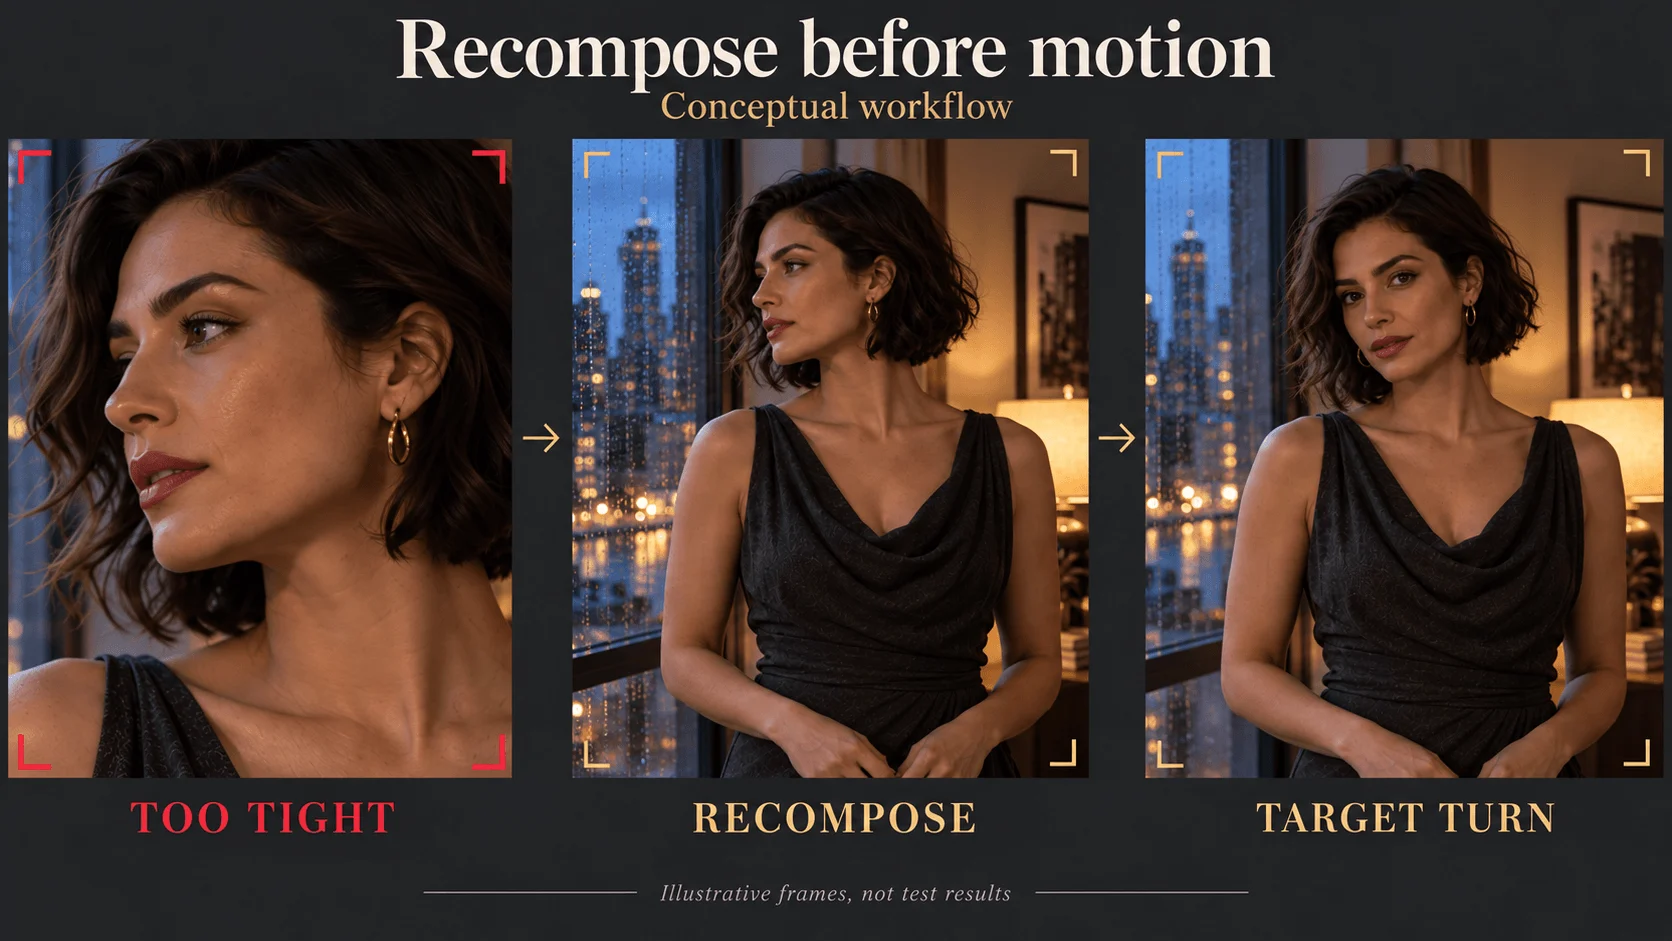
Corrigez un cadrage trop restrictif avant de demander du mouvement.
- Ouvrez MiniMax H3 image vers vidéo.
- Ajoutez l’ouverture verticale approuvée dans Input image. Chaque côté doit mesurer 256–5 760 pixels, le rapport être compris entre 2:5 et 5:2, et le fichier faire moins de 10 MB (limite de Playground).
- Réglez Resolution sur 768p et Duration sur 5. L’image fournit le rapport ; cette tâche n’a pas de champ Aspect ratio.
- Collez le prompt de mouvement ci-dessous dans Prompt. Laissez Closing frame vide pour cette première rotation simple.
She slowly turns her head from the window toward the camera, then holds direct eye contact. Her shoulders stay relaxed. The camera remains fixed. Audio: soft rain against the glass and quiet room tone, no speech or music.
L’image montre déjà le visage, la robe et la pièce : le prompt indique uniquement ce qui change.
Inspectez l’ouverture, le milieu et la pose finale maintenue. Une première image conforme peut masquer un visage qui change ensuite. Si la rotation révèle un profil peu convaincant, essayez un angle initial qui montre davantage la partie pertinente du visage, ou demandez une rotation plus petite. Si le contact visuel direct est essentiel, conservez cette fin plutôt que de réduire le mouvement jusqu’à ce que le personnage agisse à peine.
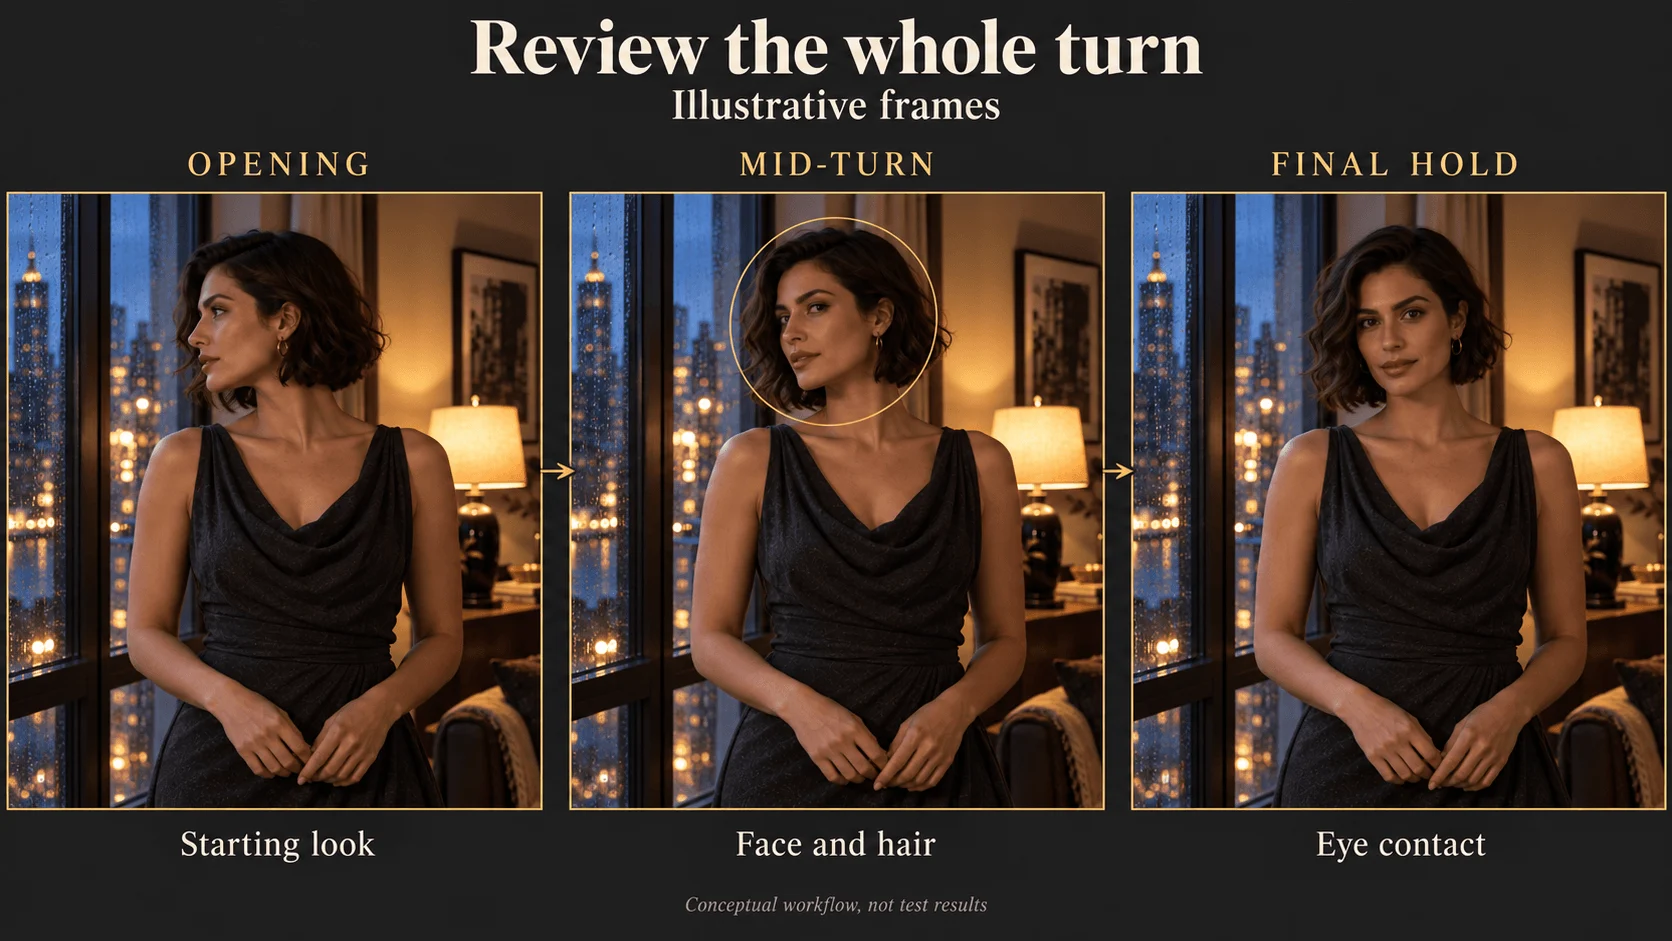
Vérifiez séparément l’ouverture, la rotation et la pose finale maintenue pour accepter le résultat.
Choisissez ce parcours si : le personnage revient, le plan doit correspondre à une image approuvée, ou le visage et les vêtements sont déjà fixés. Choisissez un autre parcours si : vous cherchez encore l’apparence, car une image fige aussi ses points faibles.
L’image finale facultative (last_image_url dans l’API) est utile si la composition finale est également approuvée. Préparez-la avec le même personnage, les mêmes vêtements et le même éclairage, puis demandez une action qui relie plausiblement les images. Elle contraint la destination ; elle ne fournit pas chaque position intermédiaire des mains et ne garantit pas une transition correcte.
Le coût de cinq secondes
Les tarifs actuels de H3 ordinaire sont identiques pour les deux tâches :
| Résolution | USD par seconde | Génération de cinq secondes |
|---|---|---|
| 768p | $0.037 | $0.185 |
| 2k | $0.058 | $0.290 |
La création d’image coûte en plus. Si vous avez déjà une image fixe approuvée, la préparation peut ne presque rien coûter ; si vous générez puis rejetez de nombreuses images, comptez cette dépense. En 768p, trois essais texte vers vidéo coûtent $0.555, contre $0.185 plus l’image pour un essai image vers vidéo. Ce dernier parcours n’est donc avantageux que si l’image approuvée coûte moins de $0.37. Si les deux réussissent du premier coup, le texte vers vidéo est moins cher, car le parcours image ajoute le coût de l’image fixe.
Ébaucher en 768p puis finaliser en 2k est la méthode économique, mais l’exécution en 2k est une nouvelle prise, pas une mise à l’échelle de l’ébauche : H3 n’expose aucun seed, donc même une requête identique produit un mouvement différent. Si le mouvement accepté doit rester exactement le même, utilisez une tâche séparée de mise à l’échelle. Les familles qui exposent un seed, comme H3 Spicy image vers vidéo ou Seedance 2.5, permettent de répéter une requête de manière plus reproductible.
Corriger le premier défaut visible
| Ce que vous voyez | Action suivante |
|---|---|
| Mauvaise robe dans l’image d’ouverture | Corriger l’image fixe avant une autre génération vidéo |
| Visage correct au début, différent pendant la rotation | Réduire la rotation ou préparer un angle initial plus informatif |
| Bon portrait, mais trop peu d’espace pour le geste | Élargir ou recomposer l’image initiale |
| La caméra avance malgré la consigne de caméra fixe | Supprimer les consignes de caméra concurrentes et garder une instruction de mouvement |
| La rotation demandée ne se termine jamais | Supprimer les actions secondaires ou prévoir une durée plus longue |
| Vous avez un portrait, mais il faut une nouvelle pièce et une nouvelle pose | Préparer la nouvelle ouverture ou utiliser la tâche séparée de référence vers vidéo |
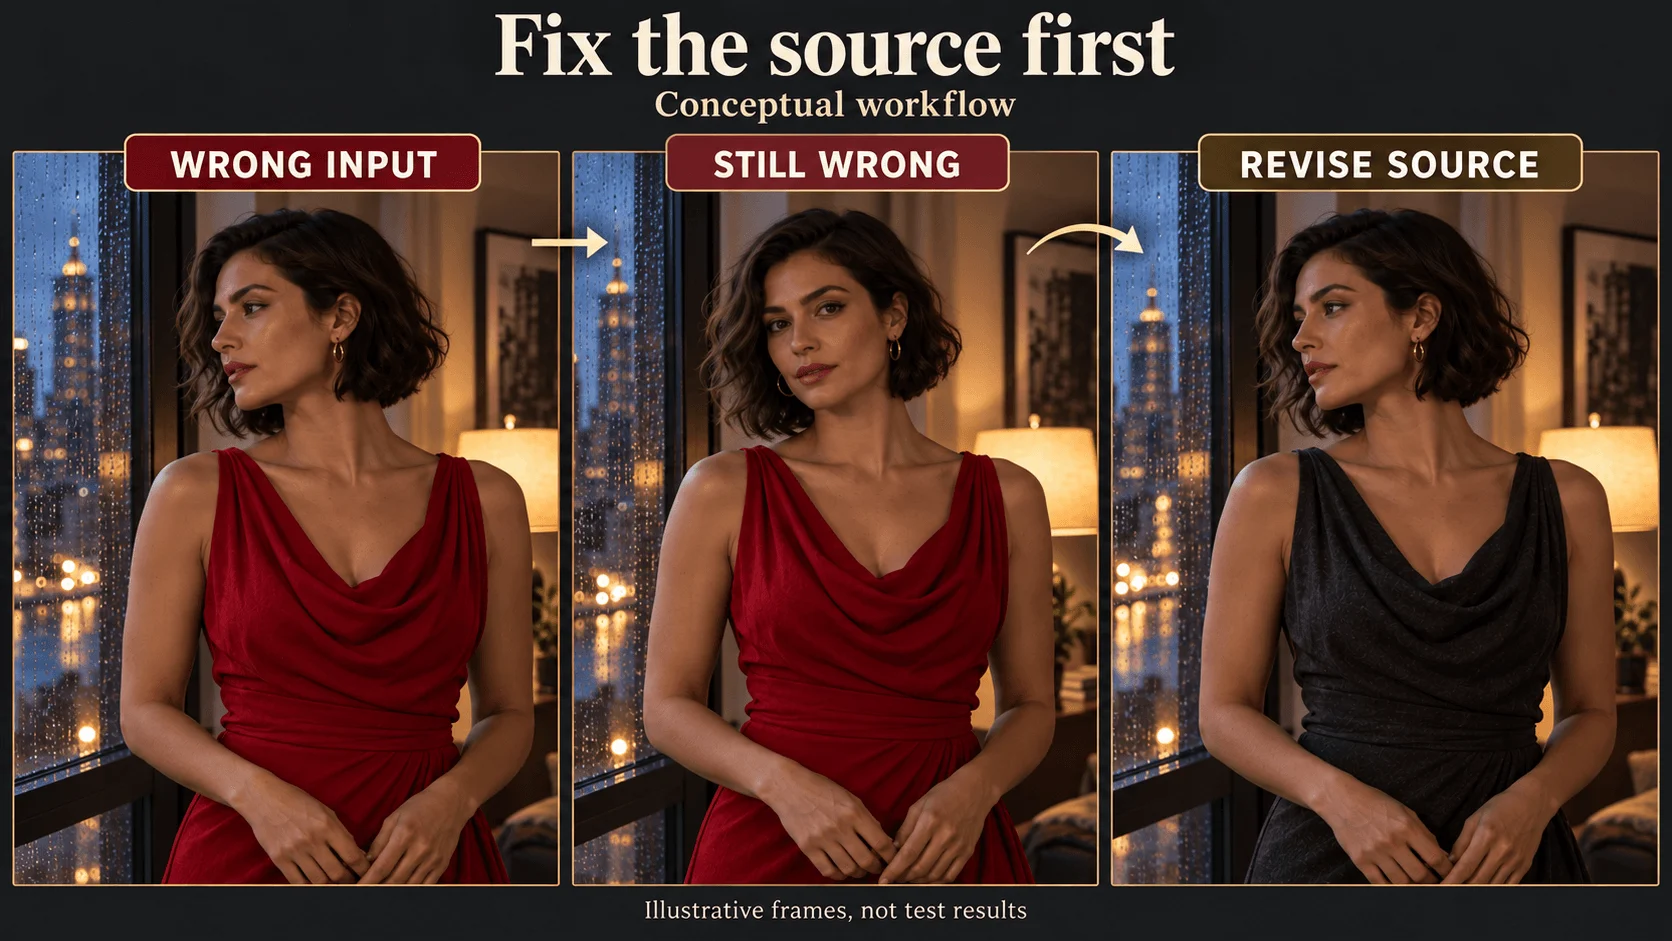
Si les vêtements d’ouverture sont incorrects, révisez la source avant un nouvel essai de mouvement.
Une référence d’identité et une image d’ouverture sont deux ressources différentes. Pour montrer Mara assise à une table, ne téléversez pas son portrait près de la fenêtre comme ouverture littérale en espérant qu’il serve seulement de référence faciale. H3 référence vers vidéo est une tâche distincte acceptant une à neuf images de référence ; vérifiez séparément ses entrées supplémentaires et son estimation.
Lancer depuis l’API
Lorsqu’un résultat Playground convient, la même requête fonctionne depuis le code. Voici l’exemple texte vers vidéo ; pour l’image vers vidéo, remplacez le modèle par minimax/h3/image-to-video, supprimez aspect_ratio et ajoutez image_url.
import os
import uuid

import requests

response = requests.post(
    "https://api.spicyapi.ai/api/v1/jobs/createTask",
    headers={
        "Authorization": f"Bearer {os.environ['SPICY_API_KEY']}",
        "Idempotency-Key": str(uuid.uuid4()),  # new key for each new request
    },
    json={
        "model": "minimax/h3/text-to-video",
        "input": {
            "prompt": "Vertical medium shot of Mara, a fictional 30-year-old woman with a short dark bob, wearing a charcoal evening dress beside a rain-streaked window. She slowly turns her head toward the camera, then holds eye contact. Static camera. Audio: soft rain, quiet room tone.",
            "aspect_ratio": "9:16",
            "resolution": "768p",
            "duration_seconds": 5,
        },
    },
)
print(response.json())
Les champs, résultats et erreurs figurent dans la référence API.
Ou laissez un Agent s’en charger. Un agent peut effectuer le même appel via la CLI, le serveur MCP ou l’Agent Skill. Tous trois lisent le schéma actuel du modèle ; la CLI et MCP affichent le prix et demandent confirmation avant de créer une tâche.
# CLI
npx @spicyapi/cli tasks create --model minimax/h3/text-to-video \
  --input-json '{"prompt": "Mara turns from a rain-streaked window toward the camera and holds eye contact. Static camera. Audio: soft rain.", "aspect_ratio": "9:16", "resolution": "768p", "duration_seconds": 5}' --wait

# MCP server: the command your assistant's MCP config runs
npx --yes --package=@spicyapi/mcp spicyapi-mcp

# Agent Skill
npx skills add spicyapi-ai/spicy-skill
Créer une scène de plus de 15 secondes
Une requête H3 est limitée à 15 secondes et aucune tâche de prolongation n’existe. Approuvez le clip, extrayez sa dernière image et utilisez-la comme ouverture du plan suivant en image vers vidéo ; chaque prompt décrit alors uniquement la suite de l’action. Vous transmettez ainsi l’apparence du plan précédent à l’ouverture suivante, plutôt que de demander au texte de redéfinir le personnage à chaque fois.
Quel parcours choisir
Pour une série hebdomadaire avec un personnage récurrent, approuvez une image d’ouverture par plan et animez-la. Pour un nouveau décor sans personnages fixés, partez du texte et considérez le résultat comme une exploration. Changez de parcours lorsque le visage et la composition deviennent des exigences à préserver.