Vous avez une image fixe de votre personnage adulte récurrent, une courte scène en tête et une file de clips à produire. Un workflow MiniMax H3 à quatre étapes semble évident. Puis le visage s’adoucit pendant une rotation, le modèle ajoute une action jamais demandée, ou l’image fonctionne mais pas la voix. Ici, Turbo désigne la LoRA communautaire d’accélération H3, pas le produit commercial distinct H3 Max Turbo.
Choisissez Turbo pour des plans simples, bien délimités et une exploration rapide. Pour une nouvelle configuration texte/images clés en 768p, FL2VA 8-step v1.0 768p est un point de départ documenté, car c’est la configuration Studio actuelle de l’auteur. Gardez un workflow de base sans Turbo pour un plan dont l’action indispensable disparaît à répétition. Ce choix Studio et l’affirmation de l’auteur sur l’amélioration audio/vidéo ne prouvent pas que huit étapes donnent généralement de meilleurs dialogues ou détails de tissu.
Le sacrifice n’est pas un pourcentage de qualité documenté. Vous choisissez un modèle adapté à un schéma d’échantillonnage bien plus court, avec ses propres hypothèses de tâche et de résolution. Le coût potentiel est une exécution moins fiable des détails précis nécessaires à votre scène. La version de base ne promet pas non plus un clip parfait.
Nous n’avons pas fait passer les mêmes scènes adultes dans Turbo et base ; cette comparaison ne peut donc pas classer les refus, le contenu atténué ni la conservation des détails du personnage. Elle explique les versions publiées, les conseils de l’auteur et les échecs rapportés dans la communauté, puis en tire des choix pratiques de workflow.
| Ce que vous devez produire | Point de départ | Pourquoi |
|---|---|---|
| Un court teaser de portrait depuis une image initiale validée | FL2VA Turbo correspondant à la tâche | Apparence et composition disposent déjà d’un départ visuel |
| Un nouveau workflow local texte/images clés en 768p | FL2VA 8-step v1.0 768p | La configuration Studio actuelle de l’auteur fournit une recette initiale documentée |
| Un nouveau plan assemblé depuis des références distinctes de personnage, tenue et pièce | Ref2VA avec son checkpoint propre | Le conditionnement par références est une autre tâche ; les réglages FL2VA ne sont pas interchangeables |
| Une scène de référence omettant sans cesse une action indispensable | Ref2VA sans Turbo, avec une séquence d’actions plus simple | Éviter de dépenser davantage sur la même approximation rapide |
| Des clips occasionnels sans installation locale à maintenir | H3 hébergé, avec la tâche réellement nécessaire | Vous achetez une génération terminée au tarif affiché plutôt que gérer un sampler |
Identifiez d’abord de quel « H3 Turbo » il s’agit
Cette comparaison concerne les LoRA Turbo ModelTC / LightX2V pour le modèle ouvert H3 de base. Ici, « base » désigne H3 sans cette LoRA d’accélération. Un produit commercial H3 Max Turbo, l’adaptateur d’accélération d’un autre créateur et un endpoint H3 hébergé sont des choix distincts. Un nom contenant « H3 » ou « Turbo » ne rend pas leurs qualités, réglages ou prix interchangeables.
Une LoRA Turbo a aussi un autre rôle qu’une LoRA de personnage. La première change la manière dont H3 atteint un résultat avec moins d’évaluations du modèle ; la seconde adapte un modèle à une personne, un style ou un concept. Ajouter un adaptateur d’accélération n’apprend pas au modèle l’identité de votre personnage fictif récurrent. Inversement, charger une LoRA de personnage n’établit pas une recette de génération à quatre étapes.
Le tableau de checkpoints de l’auteur distingue ces versions :
| Checkpoint Turbo | Tâches | Taille d’entraînement | Évaluations recommandées | Décalage vidéo / audio |
|---|---|---|---|---|
| FL2VA 4-step v0.1 | Texte ou images clés | 544p, formes mixtes | 4 | 12 / 3 |
| FL2VA 8-step v1.0 | Texte ou images clés | 544p, formes mixtes | 8 ou 4 | 12 / 3 |
| FL2VA 4-step v1.0 768p | Texte ou images clés | 1344 × 768 | 4 | 6 / 3 |
| FL2VA 8-step v1.0 768p | Texte ou images clés | 1344 × 768 | 8 | 6 / 3 |
| Ref2VA 4-step v0.1 | Références | 544p, formes mixtes | 4 | 12 / 3 |
FL2VA couvre la génération depuis le texte seul et le conditionnement par première/dernière image. Ref2VA est la branche conditionnée par références. « VA » renvoie à la vidéo et à l’audio.
La différence pratique est immédiate : un workflow de références à quatre étapes n’est pas l’alternative à quatre étapes de tous les workflows d’image à huit étapes. Animer un portrait initial et construire une scène depuis trois images de référence imposent des exigences différentes à H3. Choisissez d’abord la tâche, puis le checkpoint d’accélération compatible.
La fiche de modèle LightX2V identifie le modèle actuel du Studio comme FL2VA huit étapes v1.0 768p et décrit des améliorations vidéo et audio. C’est une affirmation de publication de l’auteur. Elle fournit un départ raisonnable pour un nouveau workflow texte/images clés ; elle ne prouve pas que ce réglage gagne sur chaque scène adulte ou ancien fine-tuning communautaire.
Ce que change un nombre réduit d’étapes, et ce qu’il ne change pas
Une étape d’échantillonnage de diffusion est une évaluation supplémentaire qui rapproche le résultat en formation de l’image, du mouvement et du son demandés. La distillation d’étapes entraîne un adaptateur pour un chemin plus court dans ce processus. Cela ne revient pas à prendre un workflow de base ordinaire, changer « 50 » en « 4 » et attendre le même résultat.
H3 génère l’image et la bande-son ensemble. La documentation de l’implémentation Diffusers décrit des schémas de débruitage distincts pour la vidéo et l’audio dans une boucle commune. Elle distingue aussi le transformer d’images clés du transformer de références. Ces différences expliquent pourquoi un petit décalage de réglages en apparence peut affecter mouvement et son.
Deux conséquences sont utiles pour les créateurs.
Premièrement, le nombre d’étapes n’est qu’une partie d’une recette. Un adaptateur, un schéma d’échantillonnage et une tâche conçus ensemble fournissent un meilleur départ qu’une liste de réglages populaires pris dans des workflows sans rapport. Une capture visuellement impressionnante ne dit pas si son auteur a aussi changé les poids de base, la quantification, la taille d’entrée ou le chemin audio.
Deuxièmement, un échantillonnage plus rapide ne diminue pas l’importance de l’entrée. Une main coupée dans l’image initiale reste une information manquante. Un profil contradictoire avec le portrait de face reste une référence conflictuelle. Une consigne de cinq secondes contenant entrée, rotation, ajustement de tenue, phrase parlée et orbite de caméra demande toujours plusieurs événements dans un petit intervalle.
La manière la plus utile de considérer ce compromis est la tolérance aux erreurs de ce plan précis. Si le livrable est une boucle silencieuse d’ambiance, une bande-son générée imparfaite peut ne rien coûter, puisque vous aviez prévu de la remplacer. S’il s’agit d’un salut personnel d’un personnage récurrent, des mots incorrects peuvent rendre inutilisable un clip autrement séduisant.
Un résultat à huit étapes peut être le résultat final. Un résultat de base peut échouer. Aucune étiquette ne devrait décider cela à l’avance. Choisir une route sert à éviter de payer pour des capacités ou compromis dont votre plan n’a pas besoin.
Quand Turbo est utile pour un personnage adulte
Un teaser de portrait avec une seule action visible
Imaginez une femme fictive d’une trentaine d’années portant une robe de soirée dans un appartement doucement éclairé. Le portrait initial est validé : visage, cheveux, tenue et pièce sont déjà bons. La vidéo doit la montrer se tournant légèrement vers la caméra puis souriant.
C’est une tâche Turbo raisonnable, car le brief comporte un changement principal. Le spectateur doit reconnaître le personnage et lire son expression ; le clip n’a pas besoin d’introduire une autre personne, de reconstruire une pièce invisible ou de synchroniser une conversation. L’image-vidéo donne à ce mouvement une composition initiale explicite.
Laissez l’image initiale porter les détails d’apparence. Placez action, caméra et son dans le prompt de mouvement. Répéter une longue description physique peut introduire des différences avec l’image : un nouvel adjectif de coiffure ou une couleur de robe légèrement différente devient une instruction supplémentaire à concilier.
Pour une série adulte privée, la même approche vaut si l’image source est plus mature. Le choix d’accélération concerne la quantité de mouvement et de continuité que le clip doit produire. Le mot « Turbo » seul ne fournit aucune preuve qu’un service hébergé précis accepte le contenu demandé.
Une scène terminée avec dialogue
Pour un court salut, utilisez une recette d’auteur correspondant à la tâche, une courte phrase et assez de temps pour la prononcer. Gardez le mouvement modeste. Une orbite de caméra, une rotation complète du corps et une phrase dirigée vers le spectateur imposent des exigences concurrentes d’orientation du visage et de timing.
Si la phrase prononcée constitue le produit, l’intelligibilité est essentielle. Un clip avec la bonne expression et les mauvais mots n’est pas un salut moins cher. Si la parole reste peu fiable avec le workflow actuel, un essai de base ou une voix produite séparément est une prochaine étape plus utile que cinq synonymes de « voix claire ».
Un audio séparé est particulièrement pratique pour une narration hors champ ou un montage de portraits silencieux. Il l’est moins si la bouche visible du personnage doit correspondre à une phrase précise. Cette distinction doit influencer le plan avant le rendu.
Deux personnages ou plusieurs rôles de référence
Un couple récurrent dans une pièce familière exige plus que deux beaux visages. La scène peut devoir conserver qui porte quelle tenue, où chacun se tient, qui bouge en premier et qui parle. Si les références attribuent ces rôles, choisissez Ref2VA et indiquez explicitement les fonctions des entrées.
Une récente discussion communautaire sur les réglages H3 sans Turbo comprend le témoignage d’un créateur : Turbo traitait les demandes simples, mais omettait des instructions ou inventait des événements dans des scènes de référence complexes. Ce témoignage ne mesure pas un taux d’échec universel. Il constitue un avertissement utile pour la situation précise où une relation ou une action manquante invalide le clip.
Si une action complexe est indispensable et la route rapide l’omet sans cesse, un workflow de références sans Turbo est une branche suivante raisonnable. Si vous voulez seulement un bref teaser, simplifiez plutôt le plan : un personnage réagit pendant que l’autre reste en place, ou divisez la séquence en deux plans courts. C’est une décision éditoriale sur le récit, pas une affirmation selon laquelle davantage d’étapes garantit une interaction correcte.
Une séquence exploratoire que vous pensez écarter
Turbo a aussi un intérêt si le clip sert à répondre à une question créative approximative : le personnage se tourne-t-il vers la fenêtre ou vers le spectateur ; la caméra reste-t-elle proche ou recule-t-elle ; l’ambiance fonctionne-t-elle mieux avant ou après qu’il s’assoie ?
La sortie temporaire peut ici être utile malgré des défauts de texture qui l’excluraient comme vidéo terminée. Gardez le choix créatif réussi, puis générez le plan final avec la route et la résolution adaptées à la livraison. Ne supposez pas qu’un nouveau rendu de base reproduira exactement la prise Turbo. Si une image précise compte, gardez-la comme entrée du plan suivant plutôt que traiter un seed comme un storyboard portable.
Utilisez les réglages du checkpoint
Les instructions ComfyUI de l’auteur exigent ComfyUI 0.31.0 ou plus récent, utilisent les nœuds H3 du cœur et choisissent Euler par défaut. Elles demandent explicitement de régler ensemble adaptateur, nombre d’étapes et les deux décalages. Les dimensions d’image doivent être des multiples de 32.
C’est la recette initiale. C’est aussi une base de dépannage plus utile que supposer qu’un ancien workflow partagé correspond toujours au dernier fichier de modèle.
Pour un plan FL2VA en 768p, sélectionnez l’adaptateur 768p et ses réglages correspondants dans le tableau. Augmenter simplement la toile de l’ancien workflow 544p n’en fait pas la version entraînée en 768p. Pour une scène de références, utilisez l’adaptateur et le workflow de références. Le guide Diffusers avertit de ne pas placer un adaptateur FL2VA sur le transformer de références à moins qu’il ait été spécialement entraîné pour cela ; son exemple Ref2VA sans Turbo utilise 50 évaluations.
Cinquante est une base fournie par l’auteur, pas la preuve que chaque scène exige exactement cinquante. De même, huit n’est pas un réglage universel de réparation pour tout fichier dont le nom contient « 4-step ». Utilisez le nombre recommandé pour la version choisie avant d’explorer des schémas d’échantillonnage personnalisés.
Un détail technique compte entre les tutoriels : NFE désigne les évaluations du modèle, et les interfaces ne comptent pas toujours les « étapes » de façon identique. Le script d’inférence ModelTC définit son argument d’étapes en évaluations et ajoute le point terminal du schéma d’échantillonnage nécessaire à Diffusers. Copier le même nombre dans un autre wrapper peut donc définir un autre schéma d’échantillonnage. Suivez le sens documenté du wrapper plutôt que corriger le graphe fonctionnel d’un auteur parce qu’un autre écran affiche un point supplémentaire.
Ne traitez pas la force de la LoRA d’accélération comme un curseur d’intensité du contenu adulte. Elle contrôle l’influence de l’adaptateur sur le modèle. La réduire change la recette d’accélération ; l’augmenter ne prouve pas un comportement de contenu plus permissif. Si vous utilisez aussi une LoRA de personnage ou de style, gardez-la conceptuellement et dans le workflow séparée du réglage Turbo.
La résolution modifie le compromis
Un portrait rapproché et une composition en pied peuvent avoir les mêmes dimensions de sortie et des besoins très différents de détail facial. Dans le portrait, le visage occupe une grande part de l’image. Dans le cadre en pied, il peut être assez petit pour qu’un léger mouvement efface les distinctions utiles autour des yeux ou de la bouche.
Pour un personnage adulte récurrent, le cadrage est donc un choix créatif autant qu’un coût de rendu. Si la reconnaissance compte plus que montrer la pièce, rapprochez la composition initiale. Consacrer plus de pixels à un mur vide remplace mal un espace suffisant pour le visage.
Les versions Turbo 544p et 768p rendent ce choix plus explicite. Utilisez une résolution adaptée au checkpoint au lieu de supposer qu’un adaptateur se comporte pareil à toutes les tailles de toile. Les créateurs de portraits doivent aussi noter que la toile d’entraînement 768p indiquée est en paysage. Le workflow permet de choisir d’autres formes prises en charge, mais la spécification publiée ne prouve pas une qualité égale à tous les ratios.
Le redimensionnement des références est un contrôle distinct. ModelTC recommande sa politique match pour l’inférence de références distillée, car elle suit celle de l’entraînement. Elle préserve la forme, suit le budget de pixels cible et n’agrandit pas une petite entrée. Cela diffère d’imposer à toutes les références un petit côté de 2048 pixels. Des dimensions de référence plus grandes ne justifient pas à elles seules d’attendre une meilleure identité ou une génération plus rapide.
La préparation utile reste simple : fournissez une référence claire dont les détails importants sont visibles avant redimensionnement. Évitez un visage dans un minuscule coin d’un grand collage. Si la source a des mains ambiguës, des bijoux élaborés ou un motif de robe brouillé par la compression, corrigez cette image fixe avant de demander à l’une ou l’autre route de l’animer.
Les détails fins ont aussi une exigence temporelle. Un motif ressemblant à de la dentelle, séduisant dans une image mais changeant de forme toutes les quelques images, distrait pendant le mouvement. Augmenter les dimensions de sortie peut rendre cette instabilité plus visible. Un upscaler agrandit un fichier ; il n’établit pas quel motif variable était voulu.
Si mouvement et identité conviennent déjà, un agrandissement peut servir à la livraison. Si l’identité change ou le tissu se transforme, régénérez ou simplifiez d’abord le plan. Vous éviterez de payer pour rendre une erreur plus nette.
Les plaintes audio nécessitent un diagnostic plus précis
La principale raison de rester prudent sur l’audio Turbo est la variété des symptômes rapportés, pas l’affirmation que tous les clips H3 rapides sonnent mal.
Dans une discussion LightX2V sur les effets sonores, un créateur signalait des effets absents ou faibles ; un autre décrivait une légère distorsion ou un écho tout en appréciant l’image. Ailleurs, le premier fil du mainteneur sur la conversion ComfyUI signalait une différence audio entre implémentations, suivie d’une réponse communautaire pointant un correctif audio. Ces observations dépendent de la configuration et de la version ; ce n’est pas un benchmark actuel de chaque publication.
La distinction compte parce que les remèdes diffèrent.
Un effet discret de pièce manque. Si le clip convient par ailleurs, ajoutez l’effet au montage. Un bref froissement de tissu ou une ambiance de pièce ne justifie généralement pas de régénérer toute une prestation de personnage. Si le son doit coïncider avec une action visible, placez-le au moment de l’action dans le montage.
Le personnage parle alors que la scène devrait être silencieuse. Précisez le son voulu et retirez le langage suggérant une conversation. Si la bouche reste immobile, remplacer l’audio peut terminer le plan. Si elle forme visiblement une parole inventée, couper la piste laisse un problème visuel ; raccourcissez la partie utilisable ou régénérez en retirant le dialogue de la scène.
Les mots indispensables sont incorrects. Gardez un seul locuteur, une courte phrase et assez de temps autour. Utilisez la syntaxe de dialogue documentée pour le workflow choisi. Si la phrase reste mauvaise, changez de route ou produisez la voix séparément ; accumuler parole, musique et effets dans le prompt ajoute des sources d’erreur.
Toute la bande-son est déformée ou instable. Revenez au workflow actuel de l’auteur et aux schémas de débruitage appariés vidéo/audio avant de décider que davantage d’étapes résoudra le problème. Un problème d’implémentation et un problème de demande créative ne doivent pas provoquer la même boucle de rendus.
En fiction adulte, un son discret peut contribuer fortement à l’ambiance. Vous pouvez néanmoins juger l’image générée utile et finir le son séparément. Faites-en un choix de production volontaire, afin d’inclure le temps de montage audio dans le coût du clip.
Un plan utilisable de personnage en cinq secondes
Voici un exemple de planification pour le personnage fictif récurrent d’un créateur adulte. C’est un prompt adaptable, pas le récit d’un résultat généré.
L’image source montre une femme fictive d’une trentaine d’années, en robe de soirée rouge foncé, près de la fenêtre d’une suite d’hôtel. Son visage est clair, une main repose sur le rebord de fenêtre et l’autre est visible près de sa taille. Une lampe dans la pièce fournit une lumière chaude. Aucun miroir, légende ni autre personne.
Le plan demandé est volontairement limité : elle tourne la tête vers le spectateur, garde le contact visuel et sourit légèrement. Cela suffit pour un teaser de personnage. Il conserve le contexte adulte sans imposer plusieurs événements sans rapport à un clip de cinq secondes.
Dans un workflow local acceptant le format de prompt structuré, utilisez :
integratedmultimodaldescription : Utilisez Picture 1 comme composition initiale. [Shot 1] La femme fictive d’une trentaine d’années reste près de la fenêtre dans la même robe de soirée rouge foncé. Elle tourne lentement la tête vers la caméra, garde le contact visuel et sourit légèrement. Ses deux mains restent à leur position initiale. La caméra reste fixe. Conservez visage, coiffure, robe, fenêtre et lumière chaude de la lampe pendant tout ce plan unique.
overall_soundscape : Ambiance intérieure calme avec un léger et bref mouvement de tissu. Aucun dialogue.
nondiegeticmusic : N/A.
La structure reprend la séparation des visuels, de l’ambiance et de la musique dans le guide de prompts MiniMax. La scène et la formulation sont originales. Dans un Playground hébergé, placez les mêmes consignes visuelles et sonores dans son champ de prompt et téléversez l’image initiale dans l’entrée d’image ; ces étiquettes sont du texte de prompt, pas des champs API supplémentaires.
Pourquoi ces instructions sont utiles
L’image initiale détermine l’apparence. « Tourne la tête » définit un changement plus petit que « se tourne vers la caméra », qui peut être interprété comme une rotation complète du corps. Garder les mains en place retire une action inutile. Une caméra fixe évite de changer l’échelle du visage pendant le mouvement. « Plan unique » précise que vous ne voulez pas de coupe vers un autre angle.
Cela ne garantit pas le respect des consignes. Cela facilite l’identification et la correction d’un mouvement indésirable parce que le brief est sans ambiguïté.
Si vous voulez un peu plus d’énergie, changez une seule exigence créative : remplacez la rotation de tête par une légère inclinaison vers la caméra en gardant le reste. C’est une nouvelle idée de plan, pas un test de qualité. Si vous voulez plutôt un mouvement de caméra, gardez le personnage presque immobile et demandez un court rapprochement lent. Combiner immédiatement les deux complique la conservation du portrait rapproché déjà choisi.
Ajoutez un salut parlé seulement si nécessaire
Pour une variante de salut, retirez « Aucun dialogue » et ajoutez une courte phrase après le sourire. Dans un workflow local utilisant les balises de dialogue MiniMax, elle peut prendre cette forme : She says <d>[English] I saved this moment for you.</d> Gardez une diction naturelle et du temps pour l’expression avant et après.
N’ajoutez pas de deuxième locuteur ni de chant de fond à la même demande courte. Cette variante vise à livrer cette phrase dans la voix du personnage ; tout élément concurrent doit donc avoir une raison d’être.
Utilisez des références pour une nouvelle composition
Supposons que l’épisode suivant nécessite la même femme assise sur un canapé dans la même suite. Le portrait près de la fenêtre devient une référence d’identité, pas nécessairement l’image de départ de la vidéo. Cela change la tâche.
Utilisez une image claire du personnage, une image de tenue si nécessaire et une image établissant la pièce. Indiquez au workflow de références que la première définit la femme, la deuxième la tenue et la troisième la pièce. Décrivez ensuite le plan assis. Évitez de demander aux trois images de déterminer simultanément la composition initiale.
Si vous avez besoin d’une composition assise précise, créez et validez d’abord cette image fixe, puis animez-la en image-vidéo. Vous avez déplacé une décision de composition difficile vers l’étape d’image fixe, où elle est plus facile à voir et corriger. Cela peut être plus précieux que changer le sampler vidéo.
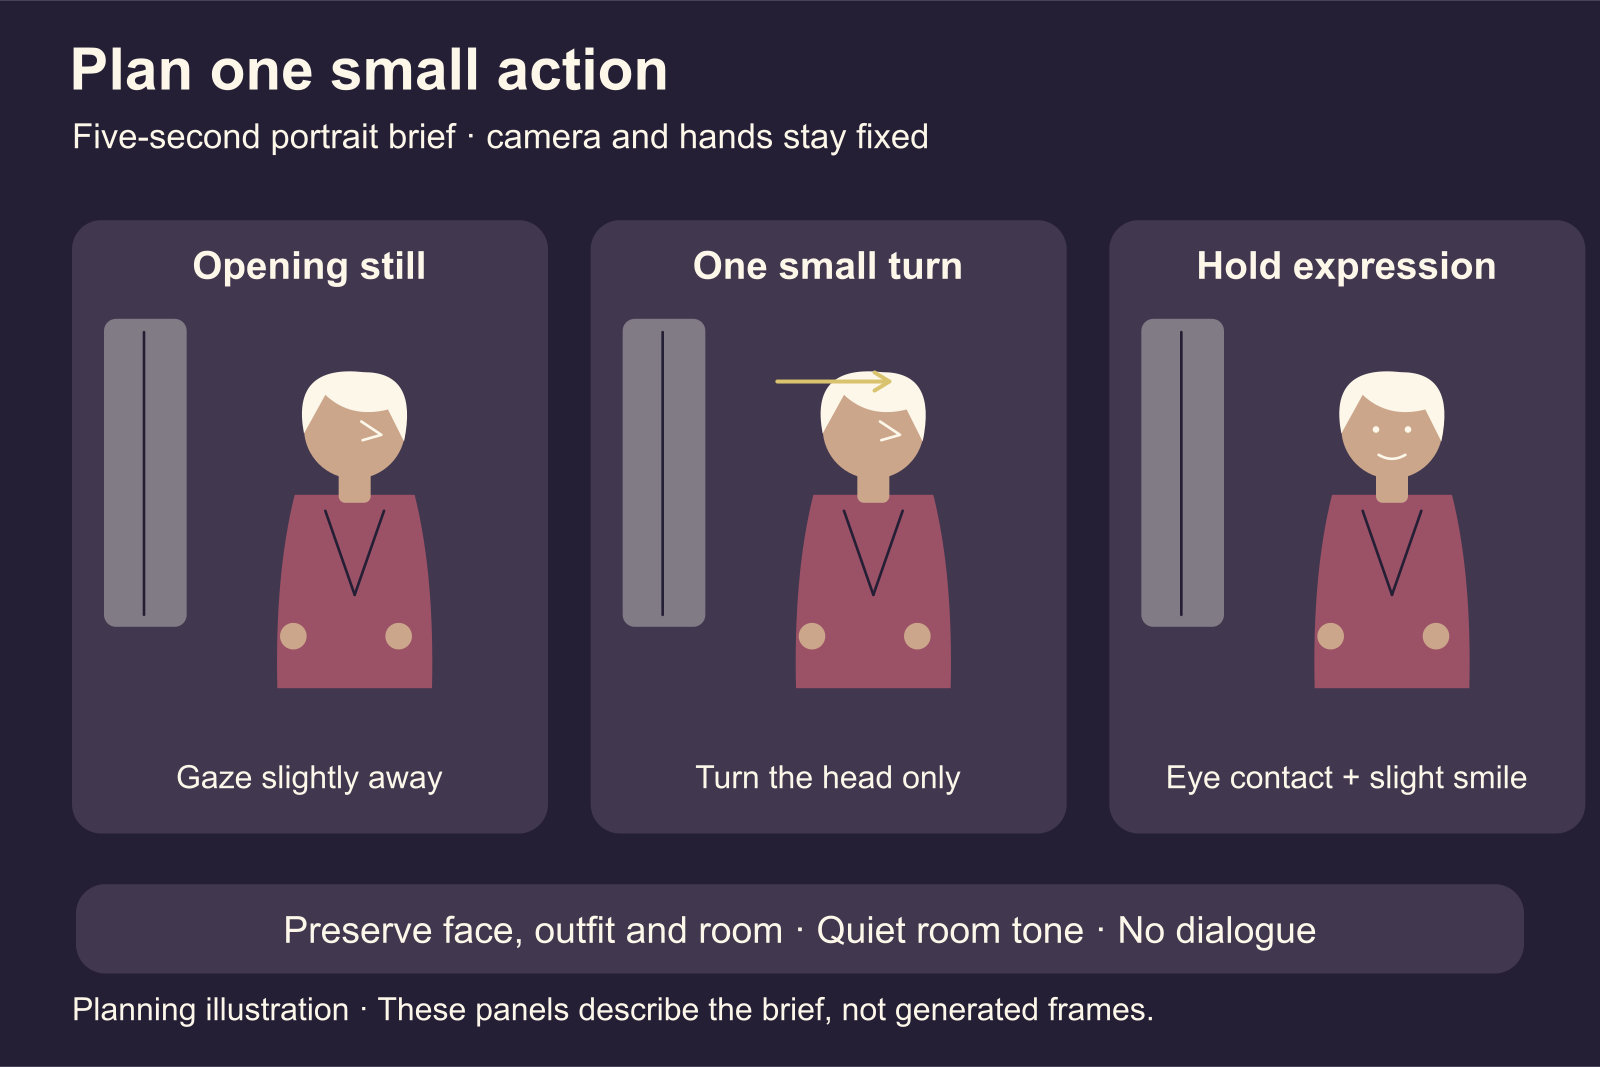
Illustration de préparation : gardez caméra et mains immobiles en demandant une seule petite rotation de tête.
Quand un résultat échoue, changez l’élément qui a échoué
Un clip rapide décevant est un symptôme. Il n’identifie pas automatiquement Turbo comme cause.
| Ce que vous voyez ou entendez | Changement suivant utile | Pourquoi avant un autre essai aléatoire |
|---|---|---|
| Le visage est déjà peu clair dans l’image initiale | Améliorer ou recadrer l’image avant animation | La vidéo a besoin d’une source reconnaissable |
| Le visage change surtout pendant une grande rotation | Réduire la rotation ou fournir une vue adaptée avec la tâche de références | L’intervalle difficile est le nouvel angle révélé |
| Le modèle ajoute marche, geste ou deuxième action | Remplacer les termes larges par une action visible et des éléments explicitement immobiles | Le mouvement demandé peut être ambigu |
| Plusieurs consignes essentielles de références disparaissent sans cesse | Utiliser Ref2VA sans Turbo ou diviser la scène en plans plus simples | Répéter la route rapide ne change pas l’exigence difficile |
| Mains ou cheveux deviennent flous en mouvement | Utiliser la recette de la tâche, puis réduire les mouvements inutiles | Configuration et complexité du mouvement peuvent contribuer |
| L’image fonctionne mais pas un bref effet sonore | Ajouter l’effet au montage | Conserver une prestation visuelle utile |
| La phrase est brouillée et la bouche bouge incorrectement | Raccourcir la phrase ou changer de route de génération | Remplacer uniquement la piste ne corrige pas la parole visible |
| Toute l’image se dégrade après ajout de Turbo | Rétablir adaptateur, schéma d’échantillonnage, tâche et résolution correspondants | Une recette incompatible n’est pas une comparaison base/Turbo pertinente |
Une discussion de LoRA de références sur Hugging Face contient des signalements de mains floues et de détails de cheveux perdus en mouvement, ainsi que des suggestions de changement d’adaptateurs et de samplers. Traitez-les comme des indices sur les problèmes rencontrés. Certaines suggestions mélangent les adaptateurs de tâches, contrairement aux recommandations de compatibilité actuelles de l’auteur ; elles ne sont pas un correctif universel fiable.
Il existe un point d’arrêt pratique. Si la source est claire, la recette correspond et la même action indispensable disparaît encore, passez à base ou réécrivez le plan. La question utile n’est plus de trouver un résultat rapide chanceux, mais de savoir si cette recherche coûte moins que changer d’approche.
Rendu plus rapide et clips terminés moins chers sont deux chiffres différents
Quatre contre huit évaluations renseigne sur le travail répété du modèle. Cela ne dit pas que le job entier prend exactement deux fois moins de temps. Chargement, traitement des entrées, décodage, transfert des poids et sauvegarde prennent aussi du temps. Un premier job à froid et un job ultérieur dont les composants sont déjà disponibles peuvent sembler très différents.
En local, il y a aussi deux horloges. Le GPU peut travailler pendant que vous faites autre chose, mais dépanner un graphe ou inspecter des prises ratées à répétition demande votre attention. Une route réduisant le rendu sans surveillance mais ajoutant des retouches manuelles peut être un mauvais compromis pour quelques clips seulement.
Pour l’hébergement payant, utilisez le tarif réellement affiché. Le tableau suivant ne contient aucun prix Turbo. Il s’agit des prix publics de la tâche H3 image-vidéo standard de SpicyAPI, avec une image initiale. Ses entrées publiques n’exposent ni étapes d’échantillonnage locales ni adaptateur Turbo ModelTC.
| Résolution H3 hébergée standard | Par seconde de sortie | Un clip de 5 secondes | Dix générations de 5 secondes |
|---|---|---|---|
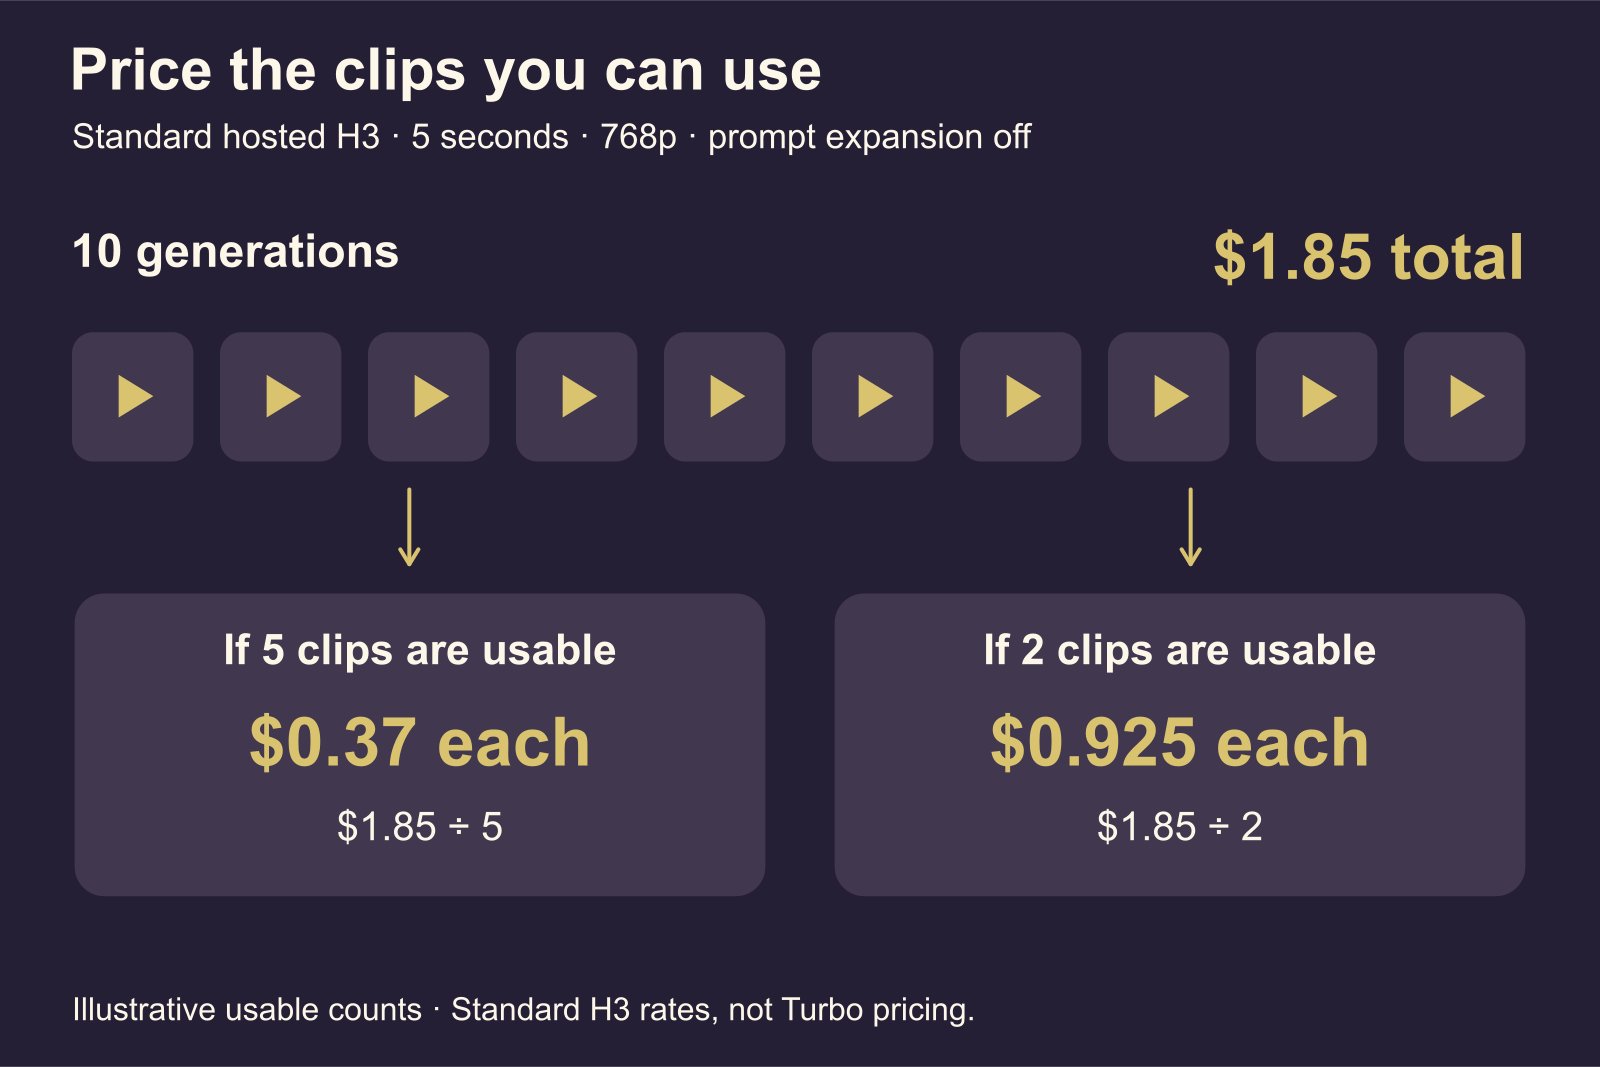
| 768p | $0.037 | $0.185 | $1.85 |
| 2k | $0.058 | $0.290 | $2.90 |
Le calcul est tarif × secondes de sortie demandées × générations. La référence-vidéo a ses propres frais de références : n’appliquez donc pas ce tableau image-vidéo tel quel à une requête multi-références.
Ces nombres donnent une alternative réelle à la maintenance d’un workflow local. Ils n’indiquent pas le nombre d’essais nécessaire et ne définissent pas une comparaison de vitesse avec votre GPU.
Le chiffre qui comprend les prises écartées
Supposons dix clips de cinq secondes en 768p à $0.185 chacun. Les générations terminées coûtent $1.85. Si cinq conviennent à votre projet, le coût de génération par clip utilisable est $1.85 ÷ 5 = $0.37. Si deux conviennent, il est de $1.85 ÷ 2 = $0.925. Ce sont des nombres d’acceptations illustratifs appliqués à des tarifs hébergés réels, pas des taux de réussite H3 observés.
Une génération réussie écartée pour mauvaise expression, mouvement ou voix appartient toujours à ce calcul. Elle diffère d’une tâche qui échoue à générer. Le temps de montage, une voix externe et l’agrandissement s’ajouteraient au coût du clip terminé.
Le même raisonnement vaut pour Turbo local. Supposons qu’un essai rapide prenne la moitié du temps d’un essai de base. Si la route rapide exige deux fois plus d’essais pour un résultat acceptable, l’avantage de rendu disparaît avant même de compter revue et retouche. C’est un exemple de seuil de rentabilité, pas une affirmation sur les temps ou taux d’acceptation de H3.
Plus généralement, Turbo économise du temps de rendu par clip utilisable si son temps par essai divisé par sa part de résultats utilisables est inférieur à l’équivalent de base. Un taux d’acceptation un peu moindre peut rester intéressant si le gain de vitesse est grand ; une forte baisse peut l’effacer. Un benchmark universel n’est pas nécessaire pour comprendre ce compromis.
Nombres d’acceptations illustratifs appliqués au tarif H3 hébergé standard ; ni taux de réussite mesurés ni prix Turbo.
L’argent des aperçus peut aussi être gaspillé
Quatre essais de cinq secondes en 768p et un essai de cinq secondes en 2k sur la tâche hébergée standard coûtent 4 × $0.185 + $0.29 = $1.03. Cela peut permettre de choisir à faible coût action et composition.
Mais l’essai final est une nouvelle génération, pas une copie haute résolution garantie du brouillon choisi. Si les quatre aperçus servaient à juger de fins détails de visage, la basse résolution peut ne pas avoir répondu à la question nécessaire. Commencez à la résolution de livraison prévue si la décision concerne précisément de petits traits, du tissu ou le visage d’un personnage en pied.
En local, appliquez le même principe aux aperçus Turbo. Utilisez-les pour choisir ce qu’un aperçu peut montrer : rythme, cadrage approximatif et adéquation d’une action au personnage. Ne supposez pas qu’ils prouvent déjà qu’un autre rendu de base ou une autre toile conservera chaque expression.
Le prochain choix des créateurs NSFW
Pour un teaser simple, silencieux ou légèrement ambiant, commencez par le workflow Turbo adapté et une bonne image initiale. Utilisez le tableau de checkpoints pour choisir une recette prise en charge pour la tâche et la toile. Gardez un résultat Turbo conforme au brief ; son étiquette ne réduit pas un plan terminé à un simple brouillon.
Pour une scène dirigée par références avec plusieurs relations indispensables, utilisez la route dédiée. Gardez base disponible si la version rapide perd régulièrement ces relations. Pour le dialogue, décidez tôt si la parole générée est essentielle ou si vous pouvez finir le son séparément.
La capacité de contenu reste propre à la route. La page H3 image-vidéo standard de SpicyAPI rapporte les résultats de tests adultes de cette tâche ; ils n’établissent pas le comportement d’une installation Turbo locale ni d’un autre service. L’accélération n’est pas une promesse de prise en charge NSFW. Pour distinguer les familles H3 hébergées, consultez le comparatif H3, Spicy, LoRA et Singularity.
L’action suivante utile est de choisir un plan réellement nécessaire, de l’attribuer aux images clés ou aux références et d’utiliser la recette publiée correspondante. Pour un workflow hébergé à image initiale, portez le brief de cinq secondes ci-dessus sur la page H3 image-vidéo standard, téléversez votre image validée et examinez l’estimation. Jugez l’achat selon la scène terminée utilisable : bon personnage, mouvement requis et son au service du clip.