Você tem uma imagem estática do seu personagem adulto recorrente, uma cena curta em mente e uma fila de clipes para fazer. Um fluxo MiniMax H3 de quatro passos parece a escolha óbvia. Até o rosto perder detalhes durante uma virada, o modelo acrescentar uma ação que você nunca pediu ou a imagem funcionar, mas a voz não. Aqui, Turbo significa o LoRA comunitário de aceleração para H3, não o produto comercial separado H3 Max Turbo.
Escolha Turbo para tomadas simples e delimitadas e para exploração rápida. Para uma nova configuração de texto/quadros-chave em 768p, FL2VA 8-step v1.0 768p é um ponto de partida documentado porque é a configuração atual do Studio do autor. Mantenha um fluxo-base sem Turbo para uma tomada cuja ação necessária desapareça repetidamente. A escolha do Studio e a alegação do autor de melhorias de áudio/vídeo não comprovam que oito passos geralmente produzam diálogo ou detalhes de tecido melhores.
O que você perde não é uma porcentagem documentada de qualidade. Você escolhe um modelo adaptado a um cronograma de amostragem muito mais curto, com suas próprias premissas de tarefa e resolução. O custo potencial é uma execução menos confiável dos detalhes específicos exigidos pela cena. Base também não promete um clipe perfeito.
Não executamos cenas adultas com entradas equivalentes em Turbo e base, portanto esta comparação não classifica recusas, conteúdo suavizado nem retenção de detalhes do personagem. Ela explica versões lançadas, orientações do autor e relatos de falhas da comunidade, transformando essas diferenças em escolhas práticas de fluxo.
| O que precisa criar | Por onde começar | Por quê |
|---|---|---|
| Uma prévia curta de retrato a partir de uma imagem inicial aprovada | FL2VA Turbo compatível com a tarefa | Aparência e composição já têm um ponto de partida visual |
| Um novo fluxo local de texto/quadros-chave em 768p | FL2VA 8-step v1.0 768p | A configuração atual do Studio do autor fornece uma receita inicial documentada |
| Uma nova tomada montada com referências separadas de personagem, roupa e cômodo | Ref2VA, usando seu próprio checkpoint | Condicionamento por referência é outra tarefa; configurações FL2VA não são intercambiáveis |
| Uma cena com referência que continua omitindo uma ação necessária | Ref2VA sem Turbo, com sequência de ações mais simples | Evite gastar mais tentativas na mesma aproximação rápida |
| Clipes ocasionais sem manter uma instalação local | H3 hospedado, na tarefa de que realmente precisa | Você compra uma geração concluída pela tarifa exibida, em vez de gerenciar um amostrador |
Primeiro, identifique qual “H3 Turbo” você quer dizer
Esta comparação trata dos LoRAs Turbo ModelTC / LightX2V para o modelo-base H3 aberto. Aqui, “base” significa H3 sem esse LoRA de aceleração. Um produto comercial chamado H3 Max Turbo, o adaptador de aceleração de outro criador e um endpoint H3 hospedado são escolhas separadas. Compartilhar “H3” ou “Turbo” no nome não torna qualidade, configurações ou preços intercambiáveis.
Um LoRA Turbo também tem propósito diferente de um LoRA de personagem. Um altera como H3 chega ao resultado com menos avaliações do modelo; o outro adapta o modelo a uma pessoa, estilo ou conceito. Adicionar um adaptador de aceleração não ensina quem é seu personagem fictício recorrente. Da mesma forma, carregar um LoRA de personagem não estabelece uma receita de geração de quatro passos.
A tabela de checkpoints do autor distingue estes lançamentos:
| Checkpoint Turbo | Tarefas | Tamanho de treinamento | Avaliações recomendadas | Shift de vídeo / áudio |
|---|---|---|---|---|
| FL2VA 4-step v0.1 | Texto ou quadros-chave | 544p, proporções variadas | 4 | 12 / 3 |
| FL2VA 8-step v1.0 | Texto ou quadros-chave | 544p, proporções variadas | 8 ou 4 | 12 / 3 |
| FL2VA 4-step v1.0 768p | Texto ou quadros-chave | 1344 × 768 | 4 | 6 / 3 |
| FL2VA 8-step v1.0 768p | Texto ou quadros-chave | 1344 × 768 | 8 | 6 / 3 |
| Ref2VA 4-step v0.1 | Referências | 544p, proporções variadas | 4 | 12 / 3 |
FL2VA cobre geração só por texto e condicionamento por quadro inicial/final. Ref2VA é a ramificação condicionada por referências. “VA” se refere a vídeo e áudio.
A diferença prática é imediata: um fluxo de referência de quatro passos não é a alternativa de quatro passos para todo fluxo de imagem de oito passos. Animar um retrato inicial e montar uma cena com três imagens de referência exigem coisas diferentes do H3. Escolha a tarefa primeiro e depois o checkpoint de aceleração compatível.
O model card do LightX2V identifica o modelo atual do Studio como FL2VA eight-step v1.0 768p e descreve melhorias em vídeo e áudio. Essa é uma alegação de lançamento do autor. Oferece um ponto de partida razoável para um novo fluxo de texto/quadros-chave; não comprova que a mesma configuração vença em toda cena adulta ou ajuste comunitário mais antigo.
O que menos passos alteram — e o que mantêm
Um passo de amostragem de difusão é mais uma avaliação para aproximar o resultado em formação da imagem, do movimento e do som solicitados. A destilação de passos treina um adaptador para uma rota mais curta nesse processo. Não equivale a pegar um fluxo-base comum, trocar “50” por “4” e esperar o mesmo resultado.
H3 gera imagem e trilha sonora juntas. A documentação da implementação Diffusers descreve cronogramas separados de vídeo e áudio dentro de um loop de remoção de ruído. Também distingue o transformer de quadros-chave do transformer de referências. Essas diferenças explicam por que uma incompatibilidade aparentemente pequena de configuração pode afetar movimento e som.
Há duas consequências úteis para criadores.
Primeiro, a contagem de passos é apenas parte da receita. Um adaptador, cronograma e tarefa projetados em conjunto são um ponto de partida mais sólido que uma lista de configurações populares coletadas de fluxos sem relação entre si. Uma captura de tela impressionante não informa se o autor também mudou pesos-base, quantização, tamanho de entrada ou caminho de áudio.
Segundo, amostragem mais rápida não reduz a importância da entrada. Uma mão cortada no quadro inicial continua sendo informação ausente. Um perfil lateral que contradiz o retrato frontal continua sendo uma referência conflitante. Uma instrução de cinco segundos com entrada em cena, virada, ajuste de roupa, fala e órbita de câmera continua pedindo vários eventos num intervalo pequeno.
A maneira mais útil de pensar nessa troca é a tolerância a erros nesta tomada específica. Se a entrega é um loop silencioso de atmosfera, uma trilha gerada imperfeita talvez não custe nada porque você já pretendia substituí-la. Se a entrega é uma saudação pessoal de um personagem recorrente, palavras incorretas podem tornar inútil um clipe atraente.
Um resultado de oito passos pode ser o resultado final. Um resultado-base pode falhar. Nenhum rótulo deve decidir isso antecipadamente. Escolher uma rota serve para evitar pagar por capacidades ou concessões de que a tomada não precisa.
Quando Turbo é útil para trabalhos de personagens adultos
Uma prévia de retrato com uma ação visível
Considere uma mulher fictícia na faixa dos trinta anos, usando vestido de noite num apartamento suavemente iluminado. O retrato inicial está aprovado: rosto, cabelo, roupa e cômodo já estão certos. O vídeo precisa que ela se vire um pouco para a câmera e termine com um sorriso.
É uma tarefa sensata para Turbo porque o briefing tem uma mudança principal. O espectador precisa reconhecer a personagem e perceber a expressão; o clipe não precisa introduzir outra pessoa, reconstruir um cômodo não mostrado nem sincronizar uma conversa. Imagem para vídeo dá ao movimento uma composição inicial explícita.
Use a imagem inicial para fornecer os detalhes de aparência. Coloque ação, câmera e som no prompt de movimento. Repetir uma longa descrição física pode introduzir diferenças em relação à imagem: um novo adjetivo de penteado ou uma cor de vestido ligeiramente diferente vira outra instrução que o modelo precisa conciliar.
Para uma série adulta privada, a mesma abordagem se aplica quando a imagem de origem é mais adulta. A decisão de aceleração trata da quantidade de movimento e continuidade que o clipe precisa entregar. A palavra “Turbo”, sozinha, não fornece evidência de que determinado serviço hospedado aceite o conteúdo solicitado.
Uma cena finalizada com diálogo
Para uma saudação curta, use uma receita do autor compatível com a tarefa, uma frase breve e tempo suficiente para a personagem falar. Mantenha o movimento modesto. Uma órbita de câmera, uma virada completa do corpo e uma fala dirigida ao espectador criam demandas concorrentes de orientação do rosto e ritmo.
Se a frase falada é o produto, a inteligibilidade é essencial. Um clipe com expressão correta e palavras erradas não é uma saudação mais barata. Se a fala continuar pouco confiável com o fluxo atual, uma tentativa-base ou uma faixa de voz produzida separadamente é um próximo passo mais objetivo que acrescentar cinco sinônimos de “voz clara”.
Áudio separado é especialmente prático para narração fora de quadro ou uma montagem silenciosa de retratos. É menos simples quando a boca visível da personagem precisa corresponder a uma frase exata. Essa diferença deve influenciar a tomada antes da renderização.
Dois personagens ou várias funções de referência
Um casal recorrente num cômodo conhecido precisa de mais que dois rostos bonitos. A cena pode precisar preservar quem usa cada roupa, onde cada pessoa fica, quem se move primeiro e quem fala. Se as referências atribuem essas funções, escolha Ref2VA e nomeie explicitamente a função das entradas.
Uma discussão recente da comunidade sobre configurações H3 sem Turbo inclui o relato de um criador de que Turbo lidou com pedidos simples, mas omitiu instruções ou inventou eventos em cenas de referência mais complexas. O relato não mede uma taxa universal de falha. É um alerta útil exatamente quando uma relação ou ação ausente invalida o clipe.
Se uma ação complexa é essencial e a rota rápida continua omitindo-a, um fluxo de referência sem Turbo é uma ramificação razoável a tentar. Se você só precisa de uma prévia breve, simplifique a tomada: um personagem reage enquanto o outro fica parado ou divida a sequência em duas tomadas curtas. É uma decisão editorial sobre como contar a cena, não uma afirmação de que passos extras garantem interação correta.
Uma sequência exploratória que você espera descartar
Turbo também faz sentido quando o clipe serve para responder a uma pergunta criativa inicial: o personagem se vira para a janela ou para o espectador; a câmera fica perto ou se afasta; a atmosfera funciona melhor antes ou depois de o personagem se sentar?
Nesse caso, a saída temporária pode ser útil apesar de defeitos de textura que a descartariam como vídeo finalizado. Guarde a escolha criativa que funcionou e gere a tomada final com a rota e a resolução apropriadas à entrega. Não suponha que uma nova renderização-base reproduza exatamente a tomada Turbo. Se um quadro específico importar, preserve-o como imagem de entrada para a próxima tomada, em vez de tratar uma seed como storyboard portátil.
Use as configurações que pertencem ao checkpoint
As instruções de ComfyUI do autor exigem ComfyUI 0.31.0 ou mais recente, usam nós H3 nativos e adotam amostragem Euler por padrão. Elas orientam explicitamente configurar juntos adaptador, contagem de passos e os dois shifts. As dimensões da imagem devem ser múltiplas de 32.
Essa é a receita inicial. Também é uma base mais útil para solucionar problemas que presumir que um fluxo antigo compartilhado ainda corresponde ao arquivo de modelo mais recente.
Para uma tomada FL2VA em 768p, selecione o adaptador 768p e suas configurações correspondentes na tabela. Apenas aumentar a tela do fluxo antigo 544p não o transforma na versão treinada em 768p. Para uma cena de referência, use o adaptador e o fluxo de referência. O guia de configuração Diffusers alerta contra colocar um adaptador FL2VA no transformer de referência, a menos que tenha sido treinado especificamente para isso; seu exemplo Ref2VA sem Turbo usa 50 avaliações.
Cinquenta é uma base fornecida pelo autor, não uma conclusão de que toda cena precise de exatamente cinquenta. Da mesma forma, oito não é uma configuração universal de reparo para todo arquivo com “4-step” no nome. Use a contagem recomendada para a versão selecionada antes de explorar cronogramas personalizados.
Um detalhe técnico importa ao seguir tutoriais diferentes: NFE significa avaliações do modelo, e as interfaces nem sempre contam “passos” da mesma forma. O script de inferência ModelTC define seu argumento de passos como avaliações e adiciona o ponto terminal do cronograma exigido por Diffusers. Copiar o mesmo número para outro wrapper pode, portanto, descrever outro cronograma. Use o significado documentado daquele wrapper, em vez de corrigir um grafo funcional do autor porque outra tela mostra um ponto a mais.
Não trate a intensidade do LoRA de aceleração como controle de intensidade de conteúdo adulto. Ela controla como o adaptador influencia o modelo. Reduzi-la muda a receita de aceleração; aumentá-la não estabelece comportamento de conteúdo mais permissivo. Se também usar LoRA de personagem ou estilo, mantenha isso separado da configuração Turbo, tanto no raciocínio quanto no fluxo.
A resolução muda a troca que você faz
Um retrato fechado e uma composição de corpo inteiro podem ter as mesmas dimensões de saída e exigências muito diferentes de detalhe facial. No retrato, o rosto ocupa grande parte da imagem. No quadro de corpo inteiro, ele pode ser pequeno o suficiente para um leve movimento apagar distinções úteis ao redor dos olhos ou da boca.
Para um personagem adulto recorrente, o tamanho no enquadramento é, portanto, uma escolha criativa e um custo de renderização. Se reconhecimento importa mais que mostrar o cômodo, aproxime a composição inicial. Gastar mais pixels numa parede vazia não substitui dar espaço suficiente ao rosto.
Os lançamentos Turbo 544p e 768p tornam essa escolha mais explícita. Use a resolução apropriada ao checkpoint, em vez de presumir que um adaptador se comporte igual em qualquer tamanho de tela. Criadores de retratos também devem observar que a tela de treinamento 768p listada é horizontal. Você pode escolher outras proporções suportadas no fluxo, mas a especificação de treinamento publicada não comprova qualidade igual em todas as proporções.
Redimensionar referências é outro controle distinto. ModelTC recomenda sua política match para inferência destilada com referências porque segue a política de treinamento. Ela preserva a proporção, segue o orçamento-alvo de pixels e não amplia uma entrada menor. Isso é diferente de forçar toda referência a ter 2048 pixels na borda curta. Dimensões maiores de referência, sozinhas, não são motivo para esperar identidade melhor ou geração mais rápida.
Para o criador, a preparação útil é simples: forneça uma referência clara cujos detalhes importantes estejam visíveis antes do redimensionamento. Evite um rosto num canto minúsculo de uma colagem muito grande. Se a fonte tiver mãos ambíguas, joias elaboradas ou um padrão de vestido borrado pela compressão, corrija a imagem estática antes de pedir animação em qualquer rota.
Detalhes finos também têm uma exigência temporal. Um padrão semelhante a renda que parece bonito num quadro, mas muda de forma a cada poucos quadros, distrai em movimento. Aumentar as dimensões de saída pode tornar essa instabilidade mais visível. Um ampliador pode aumentar o arquivo; não consegue estabelecer qual padrão em transformação era o pretendido.
Se movimento e identidade já forem úteis, a ampliação pode servir à entrega. Se a identidade mudar ou o tecido se transformar, gere de novo ou simplifique a tomada primeiro. Isso evita pagar para deixar um erro mais nítido.
Problemas de áudio precisam de diagnóstico mais específico
A razão mais forte para ter cuidado com áudio Turbo é a variedade de sintomas relatados, não a alegação de que todos os clipes H3 rápidos soem mal.
Numa discussão LightX2V sobre efeitos sonoros, um criador relatou efeitos ausentes ou fracos; outro descreveu leve distorção ou eco, ao mesmo tempo que elogiava a imagem. Em outro lugar, o tópico inicial do mantenedor sobre conversão para ComfyUI relatou diferença de áudio entre implementações, seguido por uma resposta comunitária apontando uma correção de áudio. São observações sensíveis a configuração e versão, não um benchmark atual de todo lançamento.
A diferença importa porque as soluções são diferentes.
Falta um efeito discreto do cômodo. Se o restante do clipe estiver certo, adicione o efeito na edição. Um breve som de tecido ou ambiente do cômodo normalmente não justifica gerar novamente toda a atuação do personagem. Se o som precisar coincidir com uma ação visível, posicione-o na ação durante a edição.
A personagem fala quando a cena deveria ser silenciosa. Torne explícito o som pretendido e remova linguagem que sugira conversa. Se a boca permanecer parada, substituir o áudio pode finalizar a tomada. Se a boca formar visivelmente uma fala inventada, silenciar a faixa deixa um problema visual; encurte a parte utilizável ou gere de novo com o diálogo removido da cena.
As palavras necessárias estão erradas. Mantenha um falante, uma frase curta e tempo suficiente ao redor dela. Use a sintaxe de diálogo documentada para o fluxo escolhido. Se a frase ainda estiver errada, mude a rota ou produza a voz separadamente; amontoar fala, música e efeitos no prompt acrescenta mais coisas que podem dar errado.
Toda a trilha sonora está distorcida ou instável. Volte ao fluxo atual do autor e aos cronogramas pareados de vídeo/áudio antes de decidir que mais passos são a solução. Um problema de implementação e um problema de solicitação criativa não devem levar ao mesmo ciclo de novas renderizações.
Na ficção adulta, sons discretos podem compor grande parte da atmosfera. Você ainda pode decidir que a imagem gerada vale a pena e finalizar a trilha separadamente. Faça disso uma escolha intencional de produção, incluindo o tempo de edição de áudio no custo do clipe.
Uma tomada utilizável de personagem com cinco segundos
Aqui está um exemplo de planejamento para o personagem fictício recorrente de um criador adulto. É um prompt que você pode adaptar, não um relato de resultado gerado.
A imagem de origem mostra uma mulher fictícia na faixa dos trinta anos usando vestido de noite vermelho-escuro junto à janela de uma suíte de hotel. Seu rosto é claro, uma mão repousa no peitoril e a outra está visível perto da cintura. Uma luminária dentro do cômodo fornece luz quente. Não há espelhos, legendas nem pessoas adicionais.
A tomada solicitada é deliberadamente pequena: ela vira a cabeça para o espectador, mantém contato visual e dá um sorriso leve. Isso basta para uma prévia de personagem. Preserva o contexto voltado ao público adulto sem pedir a um clipe de cinco segundos vários eventos sem relação entre si.
Para um fluxo local que aceite o formato estruturado de prompt, use:
integratedmultimodaldescription: Use Picture 1 como composição inicial. [Shot 1] A mulher fictícia na faixa dos trinta anos permanece junto à janela com o mesmo vestido de noite vermelho-escuro. Ela vira lentamente a cabeça para a câmera, mantém contato visual e dá um pequeno sorriso. As duas mãos permanecem nas posições iniciais. A câmera fica parada. Preserve rosto, penteado, vestido, janela e iluminação quente da luminária durante toda esta tomada única.
overall_soundscape: Ambiente interno silencioso, com um movimento fraco e breve de tecido. Sem diálogo.
nondiegeticmusic: N/A.
A estrutura segue a separação de visual, ambiente e trilha do guia de prompts da MiniMax. A cena e o texto aqui são originais. Num Playground hospedado, coloque as mesmas instruções visuais e sonoras no campo de prompt e envie o quadro inicial para a entrada de imagem; esses rótulos são texto de prompt, não campos extras da API.
Por que essas instruções ajudam
A imagem inicial determina a aparência. “Vira a cabeça” define uma mudança menor que “se vira para a câmera”, que poderia ser interpretada como virada do corpo inteiro. Manter as duas mãos no lugar elimina uma ação desnecessária. Uma câmera parada evita alterar a escala do rosto enquanto a personagem se move. “Tomada única” deixa claro que você não quer um corte para outro ângulo.
Isso não garante obediência. Torna um movimento indesejado mais fácil de identificar e corrigir porque o briefing é inequívoco.
Se quiser um pouco mais de energia, altere um requisito criativo: substitua a virada de cabeça por uma leve inclinação para a câmera, mantendo o restante. É outra ideia de tomada, não um teste de qualidade. Se quiser movimento de câmera, mantenha a personagem quase parada e peça uma aproximação curta e lenta. Combinar ambos imediatamente dificulta preservar a composição de retrato próximo que você já escolheu.
Acrescente uma saudação falada apenas se precisar
Para uma variante de saudação, remova “Sem diálogo” e adicione uma frase curta depois do sorriso. Num fluxo local que use as tags de diálogo MiniMax, uma frase pode ter esta forma: She says <d>[English] I saved this moment for you.</d> Mantenha a interpretação natural e deixe tempo para a expressão antes e depois da fala.
Não acrescente um segundo falante nem canto de fundo na mesma solicitação curta. O objetivo desta variante é entregar aquela frase na voz da personagem; qualquer elemento concorrente precisa justificar seu lugar.
Use referências quando precisar de uma composição nova
Suponha que o próximo episódio precise da mesma mulher sentada num sofá na mesma suíte. O retrato original na janela agora é referência de identidade, não necessariamente o quadro em que o vídeo deve começar. Isso muda a tarefa.
Use uma imagem clara da personagem, uma imagem de roupa se necessário e uma imagem que estabeleça o cômodo. Diga ao fluxo de referência que a primeira define a mulher, a segunda a roupa e a terceira o cômodo. Depois descreva a tomada sentada. Evite pedir que as três imagens determinem o quadro inicial simultaneamente.
Se precisar exatamente da composição sentada, crie e aprove essa imagem estática primeiro, depois anime com imagem para vídeo. Você transferiu uma decisão difícil de composição para a etapa de imagem estática, onde é mais fácil ver e corrigir. Isso pode valer mais que mudar o amostrador de vídeo.
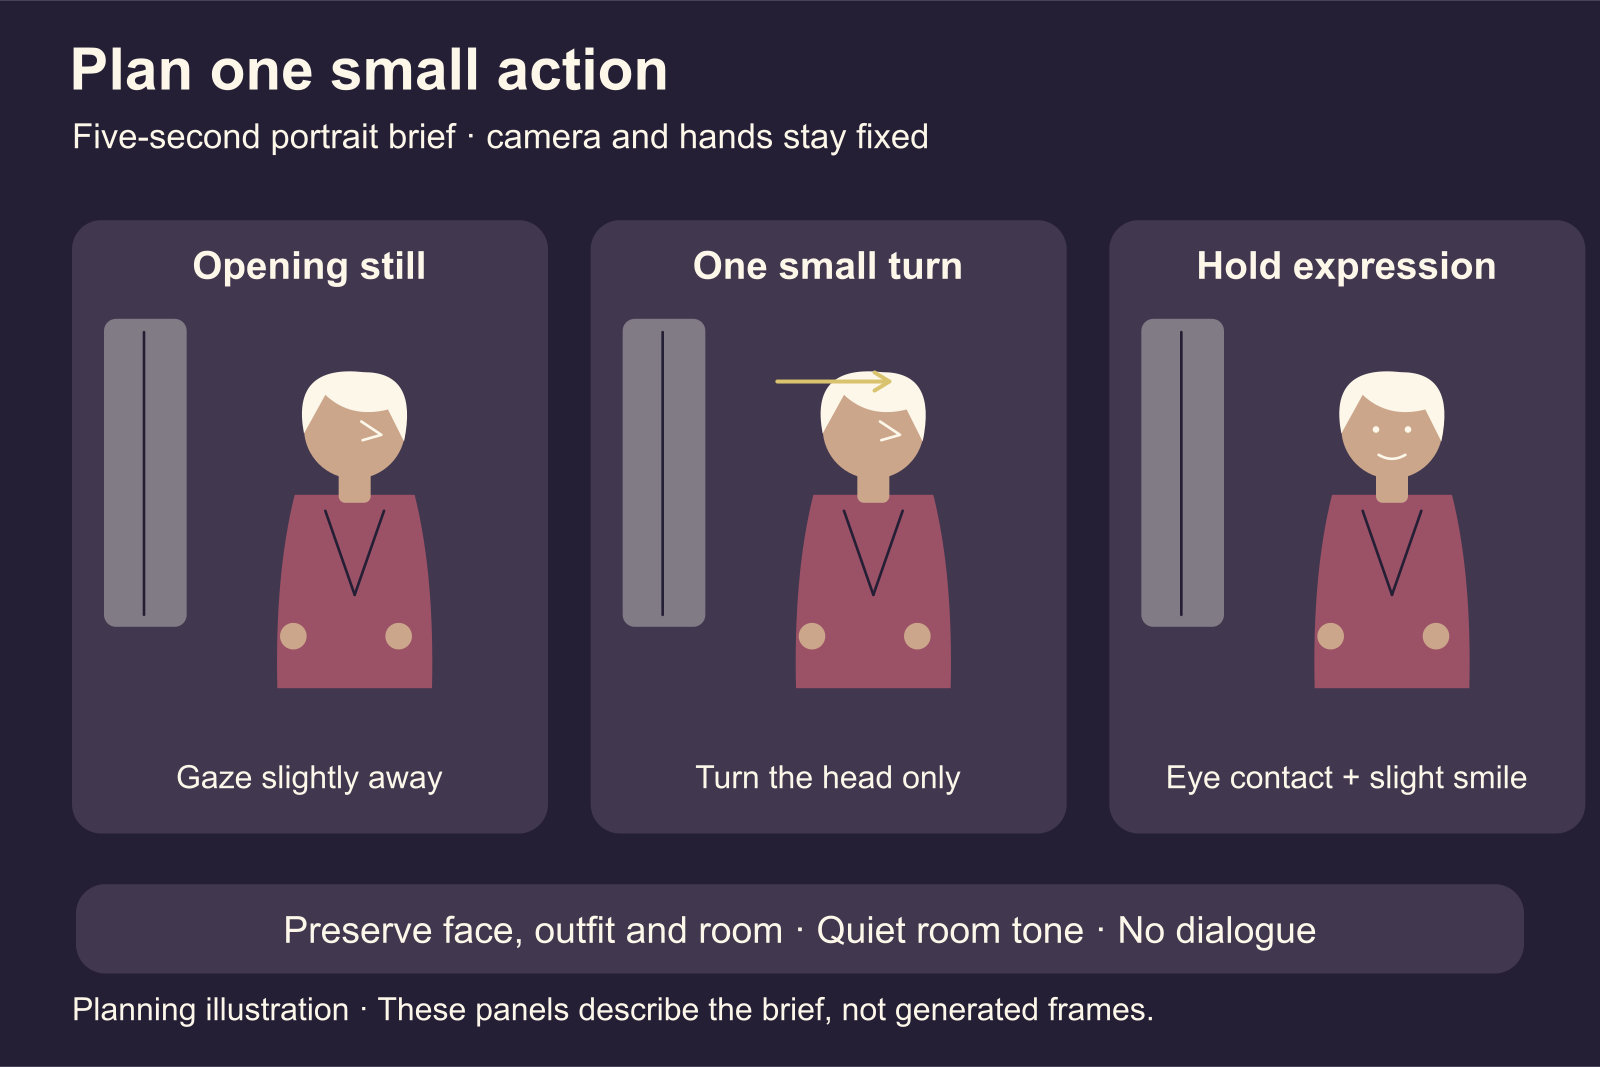
Ilustração de planejamento: mantenha câmera e mãos paradas enquanto pede uma pequena virada de cabeça.
Quando um resultado falhar, altere a parte que falhou
Um clipe rápido decepcionante é um sintoma. Não identifica automaticamente Turbo como a causa.
| O que você vê ou ouve | Próxima alteração útil | Por que vem antes de outra tentativa aleatória |
|---|---|---|
| O rosto está pouco claro até na imagem inicial | Melhore ou recorte a imagem estática antes de animar | O vídeo precisa de uma fonte reconhecível |
| O rosto muda principalmente numa virada grande | Reduza a virada ou forneça uma vista adequada pela tarefa de referência | O intervalo difícil é o ângulo recém-revelado |
| O modelo acrescenta uma caminhada, gesto ou segunda ação | Substitua linguagem ampla por uma ação visível e elementos explicitamente parados | O movimento pedido pode ser ambíguo |
| Várias instruções essenciais de referência continuam desaparecendo | Use Ref2VA sem Turbo ou divida a cena em tomadas mais simples | Repetir a rota rápida não altera o requisito difícil |
| Mãos ou cabelo borram em movimento | Use a receita compatível com a tarefa e reduza movimento desnecessário | Configuração e complexidade de movimento podem contribuir |
| A imagem funciona, mas um efeito sonoro breve não | Acrescente o efeito na edição | Preserve uma atuação visual útil |
| A fala está embaralhada e a boca se move incorretamente | Encurte a frase ou mude a rota de geração | Substituir apenas a faixa não corrige a fala visível |
| Toda a imagem piora após adicionar Turbo | Restaure adaptador, cronograma, tarefa e resolução compatíveis | Uma receita incompatível não é uma comparação significativa entre base e Turbo |
Uma discussão de LoRA de referência no Hugging Face inclui relatos de mãos borradas e perda de detalhes de cabelo em movimento, junto a sugestões de trocar adaptadores e amostradores. Trate-os como pistas dos problemas encontrados. Algumas sugestões misturam adaptadores de tarefas, contrariando a orientação atual de compatibilidade do autor; não são uma correção universal confiável.
Há um ponto prático para parar. Se a fonte estática é clara, a receita é compatível e a mesma ação necessária continua desaparecendo, passe para base ou reescreva a tomada. A pergunta útil já não é se você pode encontrar um resultado rápido por sorte. É se essa busca custa menos que mudar de abordagem.
Renderização mais rápida e clipes finalizados mais baratos são números diferentes
Quatro contra oito avaliações diz algo sobre trabalho repetido do modelo. Não diz que um trabalho inteiro demora exatamente a metade. Carregamento, processamento de entrada, decodificação, transferência de pesos e salvamento também levam tempo. Uma primeira tarefa sem componentes carregados e outra posterior com componentes já disponíveis podem parecer muito diferentes.
No trabalho local, também há dois relógios. A GPU pode trabalhar enquanto você faz outra coisa, mas solucionar um grafo ou examinar repetidamente tomadas malsucedidas exige sua atenção. Uma rota que reduz renderização sem supervisão, mas acrescenta reparos manuais, pode ser uma troca ruim para um criador de poucos clipes.
Na hospedagem paga, use a tarifa realmente exibida. Não há preço Turbo na tabela seguinte. São preços públicos da tarefa padrão H3 de imagem para vídeo da SpicyAPI, usando imagem inicial. Suas entradas públicas não expõem passos locais de amostragem nem o adaptador ModelTC Turbo.
| Resolução H3 padrão hospedada | Por segundo de saída | Um clipe de 5 segundos | Dez gerações de 5 segundos |
|---|---|---|---|
| 768p | $0.037 | $0.185 | $1.85 |
| 2k | $0.058 | $0.290 | $2.90 |
A conta é tarifa × segundos solicitados de saída × gerações. Referência para vídeo tem suas próprias cobranças de referência, então não aplique esta tabela de imagem para vídeo sem alterações a uma solicitação com múltiplas referências.
Esses valores oferecem uma alternativa real a manter um fluxo local. Não informam quantas tentativas serão necessárias nem estabelecem uma comparação de velocidade com sua GPU.
O número que inclui tomadas descartadas
Suponha que você gere dez clipes de cinco segundos em 768p por $0.185 cada. O gasto de geração concluída é $1.85. Se cinco forem úteis para o projeto, o custo de geração por clipe aproveitável será $1.85 ÷ 5 = $0.37. Se dois forem úteis, será $1.85 ÷ 2 = $0.925. São contagens ilustrativas de aprovação aplicadas a tarifas reais hospedadas, não taxas de sucesso observadas do H3.
Uma geração bem-sucedida que você descarta porque expressão, movimento ou voz estão errados ainda entra nessa conta. É diferente de uma tarefa que não gera resultado. Tempo de edição, voz externa e ampliação acrescentariam custo ao clipe finalizado.
O mesmo raciocínio vale para Turbo local. Suponha que uma tentativa rápida consuma metade do tempo de uma tentativa-base. Se a rota rápida precisar de duas vezes mais tentativas para um resultado aceitável, a vantagem de renderização desaparece antes mesmo de contar revisão e reparo. É um exemplo de equilíbrio, não uma afirmação de que H3 tenha esses tempos ou taxas de aprovação.
De modo geral, Turbo economiza tempo de renderização por clipe utilizável quando o tempo por tentativa dividido pela proporção de resultados utilizáveis é menor que o equivalente da base. Uma taxa de aprovação um pouco pior ainda pode valer a pena se o ganho de velocidade for grande; uma queda grande na aprovação pode anulá-lo. Não precisa de um benchmark universal para entender essa troca.
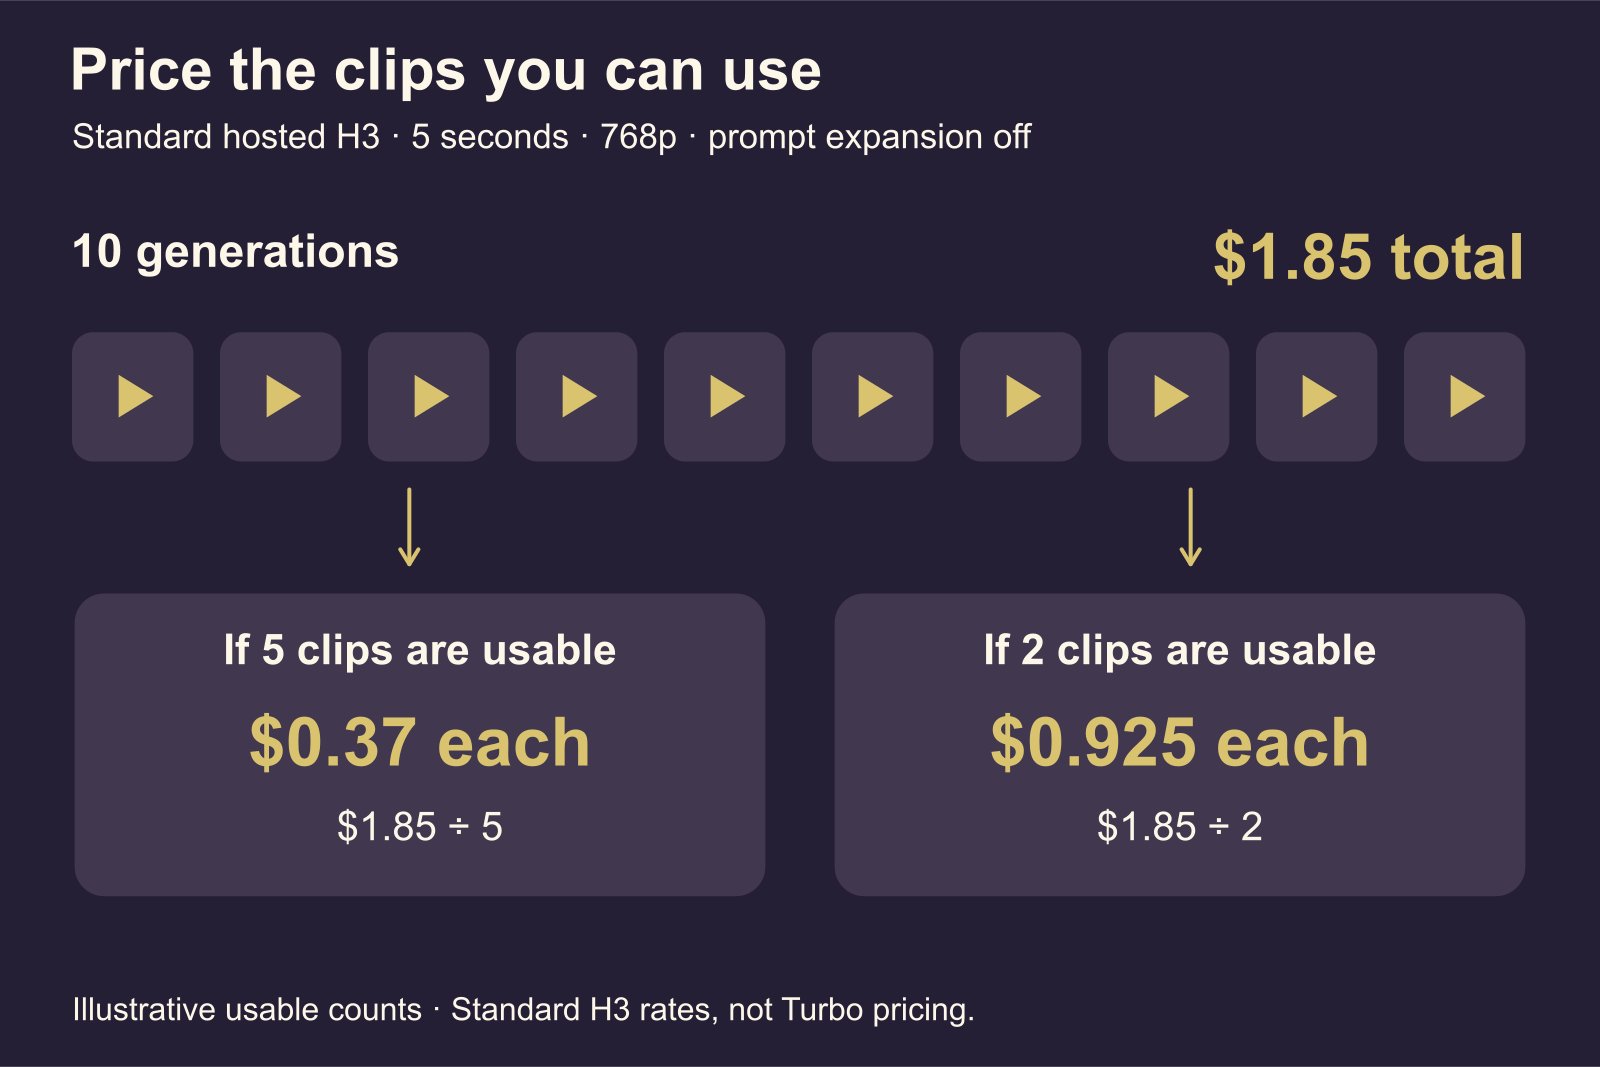
Contagens ilustrativas de aprovação aplicadas à tarifa H3 padrão hospedada; não são taxas de sucesso medidas nem preços Turbo.
Dinheiro de prévias também pode ser desperdiçado
Quatro tentativas de cinco segundos em 768p e uma de cinco segundos em 2k na tarefa hospedada padrão com imagem custam 4 × $0.185 + $0.29 = $1.03. Isso pode ajudar a escolher economicamente ação e composição da tomada.
Mas a tentativa final é uma geração nova, não uma cópia garantida de alta resolução do rascunho escolhido. Se as quatro prévias tentavam avaliar detalhes delicados do rosto, a etapa de baixa resolução talvez não tenha respondido à pergunta necessária. Comece na resolução pretendida de entrega quando a decisão tratar especificamente de detalhes pequenos, tecido ou rosto de um personagem em corpo inteiro.
No trabalho local, aplique o mesmo princípio às prévias Turbo. Use-as para escolher o que uma prévia mostra: ritmo, enquadramento aproximado e se a ação combina com o personagem. Não suponha que elas já comprovem que outra renderização-base ou tela preserve toda expressão.
O que criadores NSFW devem escolher agora
Para uma prévia de personagem simples, silenciosa ou com ambiente leve, comece pelo fluxo Turbo apropriado e por uma boa imagem inicial. Use a tabela de checkpoints para escolher uma receita suportada para tarefa e tela. Guarde um resultado Turbo que atenda ao briefing; o rótulo não transforma uma tomada pronta em mero rascunho.
Para uma cena guiada por referências com várias relações essenciais, use a rota dedicada de referência. Mantenha base disponível quando a versão rápida perder essas relações repetidamente. Para diálogo, decida cedo se a fala gerada é essencial ou se você pode finalizar o som separadamente.
A capacidade de conteúdo continua específica da rota. A página padrão H3 de imagem para vídeo da SpicyAPI informa resultados de testes adultos daquela tarefa; eles não estabelecem o comportamento de uma configuração Turbo local nem de outro serviço. Aceleração não é uma alegação de suporte NSFW. Para as diferenças entre famílias H3 hospedadas, use a comparação H3, Spicy, LoRA e Singularity.
O próximo passo útil é escolher uma tomada de que realmente precisa, atribuí-la a quadros-chave ou referências e usar a receita lançada compatível. Se quiser um fluxo hospedado com quadro inicial, leve o briefing de cinco segundos acima à página padrão H3 de imagem para vídeo, envie a imagem aprovada e examine a estimativa. Julgue a compra pela cena finalizada que pode usar: personagem certo, movimento necessário e som que sirva ao clipe.