Tienes una imagen de tu personaje adulto recurrente, una escena breve en mente y una cola de clips pendientes. Un flujo de MiniMax H3 de cuatro pasos parece la elección evidente. Después, el rostro pierde definición al girar, el modelo añade una acción que nunca pediste o la imagen funciona pero la voz no. Aquí Turbo significa el LoRA comunitario de aceleración para H3, no el producto comercial independiente H3 Max Turbo.
Elige Turbo para planos sencillos y acotados y para explorar con rapidez. Si estrenas una configuración de texto/fotogramas clave a 768p, FL2VA 8-step v1.0 768p es un punto de partida documentado porque es la configuración actual del Studio del autor. Conserva un flujo base sin Turbo para un plano cuya acción necesaria desaparezca una y otra vez. La elección del Studio y la mejora de audio/video declarada por el autor no demuestran que ocho pasos produzcan en general mejores diálogos o detalles de tejido.
Lo que sacrificas no es un porcentaje de calidad documentado. Eliges un modelo adaptado a un proceso de muestreo mucho más corto, con sus propios supuestos sobre tarea y resolución. El posible costo es una ejecución menos fiable de los detalles concretos que exige la escena. La versión base tampoco promete un clip perfecto.
No hemos ejecutado escenas adultas con las mismas entradas en Turbo y base, por lo que esta comparación no puede clasificar negativas, contenido suavizado ni conservación de detalles del personaje. Explica las versiones publicadas, las indicaciones del autor y los fallos comunicados por la comunidad, y los convierte en decisiones prácticas de flujo.
| Qué necesitas producir | Por dónde empezar | Por qué |
|---|---|---|
| Un teaser breve de retrato desde una imagen inicial aprobada | FL2VA Turbo correspondiente a la tarea | La apariencia y la composición ya tienen un punto de partida visual |
| Un nuevo flujo local de texto/fotogramas clave a 768p | FL2VA 8-step v1.0 768p | La configuración actual del Studio del autor aporta una receta inicial documentada |
| Un plano nuevo con referencias separadas de personaje, vestuario y habitación | Ref2VA, con su propio checkpoint | El condicionamiento por referencias es otra tarea; los ajustes FL2VA no son intercambiables |
| Una escena de referencias que sigue omitiendo una acción necesaria | Ref2VA sin Turbo y una secuencia más sencilla | Evita gastar más intentos en la misma aproximación rápida |
| Clips ocasionales sin mantener una instalación local | H3 alojado, con la tarea que necesites | Compras una generación completada al precio mostrado en lugar de gestionar un sampler |
Primero identifica a qué «H3 Turbo» te refieres
Esta comparación trata los LoRA Turbo de ModelTC / LightX2V para el modelo base abierto H3. Aquí «base» significa H3 sin ese LoRA de aceleración. Un producto comercial llamado H3 Max Turbo, un adaptador de aceleración de otro creador y un endpoint H3 alojado son opciones distintas. Compartir «H3» o «Turbo» en el nombre no hace intercambiables su calidad, ajustes ni precios.
Un LoRA Turbo también cumple otra función que un LoRA de personaje. Uno cambia cómo H3 llega al resultado con menos evaluaciones del modelo; el otro adapta el modelo hacia una persona, estilo o concepto. Añadir aceleración no le enseña quién es tu personaje ficticio recurrente. A la inversa, cargar un LoRA de personaje no establece una receta de generación de cuatro pasos.
La tabla de checkpoints del autor distingue estas versiones:
| Checkpoint Turbo | Tareas | Tamaño de entrenamiento | Evaluaciones recomendadas | Shift de video / audio |
|---|---|---|---|---|
| FL2VA 4-step v0.1 | Texto o fotogramas clave | 544p, formas variadas | 4 | 12 / 3 |
| FL2VA 8-step v1.0 | Texto o fotogramas clave | 544p, formas variadas | 8 o 4 | 12 / 3 |
| FL2VA 4-step v1.0 768p | Texto o fotogramas clave | 1344 × 768 | 4 | 6 / 3 |
| FL2VA 8-step v1.0 768p | Texto o fotogramas clave | 1344 × 768 | 8 | 6 / 3 |
| Ref2VA 4-step v0.1 | Referencias | 544p, formas variadas | 4 | 12 / 3 |
FL2VA incluye generación solo desde texto y condicionamiento con primer/último fotograma. Ref2VA es la rama condicionada por referencias. «VA» se refiere a video y audio.
La diferencia práctica es inmediata: un flujo de referencias de cuatro pasos no es la alternativa de cuatro pasos a cualquier flujo de imagen de ocho. Animar un retrato inicial y construir una escena desde tres referencias exigen cosas distintas a H3. Elige primero la tarea y después el checkpoint de aceleración compatible.
La ficha de LightX2V identifica el modelo actual del Studio como FL2VA eight-step v1.0 768p y describe mejoras en video y audio. Es una afirmación del autor sobre la versión. Da un inicio razonable para un nuevo flujo de texto/fotogramas clave; no demuestra que gane en todas las escenas adultas o ajustes comunitarios anteriores.
Qué cambia al reducir los pasos y qué permanece igual
Un paso de muestreo por difusión es otra evaluación que acerca el resultado en desarrollo a la imagen, movimiento y sonido pedidos. La destilación de pasos entrena un adaptador para recorrer ese proceso de forma más breve. No equivale a tomar un flujo base ordinario, cambiar «50» por «4» y esperar lo mismo.
H3 genera conjuntamente imagen y banda sonora. La documentación de implementación de Diffusers describe programas separados de video y audio dentro de un mismo bucle de eliminación de ruido. También distingue el transformer de fotogramas clave del de referencias. Esas diferencias explican por qué un pequeño desajuste aparente puede afectar al movimiento y al sonido.
Hay dos consecuencias útiles para los creadores.
Primero, el número de pasos es solo parte de una receta. Un adaptador, un programa de muestreo y una tarea diseñados conjuntamente son una base más sólida que una lista de ajustes populares recogidos de flujos sin relación. Una captura visualmente espectacular no indica si el autor también cambió pesos base, cuantización, tamaño de entrada o ruta de audio.
Segundo, acelerar el muestreo no resta importancia a la entrada. Una mano recortada en el primer fotograma sigue siendo información ausente. Un perfil que contradice al retrato frontal sigue siendo una referencia conflictiva. Una indicación de cinco segundos que incluye entrar, girar, ajustar el vestuario, pronunciar una frase y una órbita de cámara sigue pidiendo varios eventos en poco tiempo.
La forma más útil de entender la contrapartida es cuánto toleras los errores en ese plano concreto. Si entregas un bucle de ambiente silencioso, una banda sonora generada imperfecta quizá no cueste nada porque pensabas reemplazarla. Si entregas un saludo personal de un personaje recurrente, unas palabras incorrectas pueden invalidar un clip atractivo.
Un resultado de ocho pasos puede ser definitivo. Uno de base puede fallar. Ninguna etiqueta debe decidirlo de antemano. Elegir una ruta sirve para evitar pagar por funciones o aceptar compromisos que tu plano no necesita.
Dónde resulta útil Turbo para personajes adultos
Un teaser de retrato con una acción visible
Imagina una mujer ficticia de treinta y tantos años con vestido de noche en un apartamento de luz suave. El retrato inicial está aprobado: rostro, pelo, conjunto y habitación ya son correctos. El video necesita que gire un poco hacia la cámara y termine sonriendo.
Es una tarea razonable para Turbo porque hay un cambio principal. El espectador necesita reconocer al personaje y leer su expresión; el clip no tiene que introducir a otra persona, reconstruir una habitación que no se ve ni sincronizar una conversación. Imagen a video aporta una composición inicial explícita para ese movimiento.
Deja los detalles de apariencia en la imagen inicial. Incluye acción, cámara y sonido en el prompt de movimiento. Repetir una descripción física larga puede introducir diferencias respecto a la imagen: otro adjetivo de peinado o un color de vestido algo distinto se convierten en nuevas instrucciones que el modelo debe reconciliar.
En una serie adulta privada se aplica lo mismo cuando la imagen de origen es más sugerente. La decisión de acelerar trata de cuánto movimiento y continuidad debe ofrecer el clip. «Turbo» por sí solo no demuestra que un servicio alojado concreto acepte el contenido pedido.
Una escena terminada con diálogo
Para un saludo breve, usa una receta del autor correspondiente a la tarea, una frase corta y tiempo suficiente para decirla. Mantén el movimiento moderado. Una órbita de cámara, un giro completo del cuerpo y una frase dirigida al espectador imponen exigencias que compiten por la orientación del rostro y el tiempo.
Si el producto es la frase hablada, la inteligibilidad es esencial. Un clip con expresión correcta y palabras incorrectas no es un saludo más barato. Si la voz sigue siendo poco fiable con el flujo actual, probar base o producir la voz por separado es un paso más útil que añadir cinco sinónimos de «voz clara».
El audio separado resulta especialmente práctico para narración fuera de plano o un montaje de retratos silencioso. Es menos sencillo cuando la boca visible del personaje debe coincidir con una frase precisa. Esa diferencia debería determinar el plano antes de renderizarlo.
Dos personajes o varias funciones de referencia
Una pareja recurrente en una habitación conocida necesita algo más que dos rostros atractivos. Quizá haya que conservar quién lleva cada conjunto, dónde se coloca, quién se mueve primero y quién habla. Si las referencias asignan esos papeles, elige Ref2VA y especifica la función de cada entrada.
Una conversación reciente sobre ajustes de H3 sin Turbo recoge la experiencia de un creador: Turbo resolvía solicitudes sencillas, pero omitía instrucciones o inventaba eventos en escenas complejas con referencias. No mide una tasa universal de fallos. Sí advierte de la situación concreta en la que omitir una relación o acción invalida el clip.
Si la acción compleja es esencial y la ruta rápida sigue omitiéndola, un flujo de referencias sin Turbo es una rama razonable que probar. Si solo necesitas un teaser breve, simplifica el plano: un personaje reacciona mientras el otro permanece quieto, o divide la secuencia en dos planos cortos. Es una decisión editorial para contar la escena, no una afirmación de que más pasos garanticen una interacción correcta.
Una secuencia exploratoria que esperas descartar
Turbo también encaja cuando el clip debe responder a una pregunta creativa aproximada: si el personaje gira hacia la ventana o el espectador, si la cámara se queda cerca o se aleja, si el ambiente se entiende mejor antes o después de que se siente.
La salida provisional puede ser útil pese a defectos de textura que la descartarían como video final. Conserva la decisión creativa acertada y genera el plano final con la ruta y resolución adecuadas para entregarlo. No supongas que una nueva generación con base reproducirá exactamente la toma Turbo. Si importa un fotograma concreto, guárdalo como entrada de imagen para el siguiente plano en vez de tratar una semilla como un guion gráfico portátil.
Utiliza los ajustes del checkpoint elegido
Las instrucciones ComfyUI del autor requieren ComfyUI 0.31.0 o posterior, usan los nodos H3 del núcleo y muestreo Euler por defecto. Indican explícitamente configurar juntos el adaptador, el número de pasos y ambos shifts. Las dimensiones deben ser múltiplos de 32.
Esa es la receta inicial. También resulta una base más útil para diagnosticar problemas que asumir que un flujo compartido antiguo todavía corresponde al archivo más nuevo del modelo.
Para un plano FL2VA a 768p, selecciona el adaptador 768p y sus ajustes de la tabla. Aumentar el lienzo del flujo antiguo 544p no lo convierte en la versión entrenada a 768p. Para una escena de referencias, usa el adaptador y flujo de referencias. La guía de configuración de Diffusers advierte que no se debe poner un adaptador FL2VA sobre el transformer de referencias salvo que se haya entrenado específicamente para ello; su ejemplo Ref2VA sin Turbo utiliza 50 evaluaciones.
Cincuenta es una base proporcionada por el autor, no un hallazgo de que todas las escenas necesiten exactamente cincuenta. Del mismo modo, ocho no arregla universalmente cualquier archivo cuyo nombre contenga «4-step». Usa el número recomendado para la versión antes de explorar programas personalizados.
Un detalle técnico importa al seguir tutoriales distintos: NFE significa evaluaciones del modelo, y las interfaces no siempre cuentan los «pasos» igual. El script de inferencia de ModelTC define su argumento de pasos como evaluaciones y añade el punto terminal que necesita Diffusers. Copiar el mismo número en otro envoltorio puede describir un programa diferente. Sigue el significado documentado en ese envoltorio en vez de corregir un grafo funcional del autor porque otra pantalla muestre un punto adicional.
No interpretes la fuerza del LoRA de aceleración como un control de intensidad adulta. Determina cómo influye el adaptador sobre el modelo. Reducirla modifica la receta de aceleración; aumentarla no establece más permisividad de contenido. Si también usas un LoRA de personaje o estilo, sepáralo del ajuste Turbo tanto conceptualmente como en el flujo.
La resolución cambia la contrapartida
Un retrato cercano y una composición de cuerpo entero pueden tener las mismas dimensiones de salida y exigencias muy distintas de detalle facial. En el retrato, el rostro ocupa gran parte de la imagen. En cuerpo entero puede ser tan pequeño que un movimiento leve borre distinciones útiles alrededor de ojos o boca.
Para un personaje adulto recurrente, el tamaño en el encuadre es una elección creativa además de un costo de renderizado. Si reconocerlo importa más que mostrar la habitación, acerca la composición inicial. Gastar más píxeles en una pared vacía sustituye mal a dar espacio al rostro.
Las versiones Turbo 544p y 768p hacen más explícita esta elección. Usa la resolución correspondiente al checkpoint en vez de asumir que un adaptador se comporta igual con cualquier lienzo. Quien crea retratos también debe observar que el lienzo de entrenamiento 768p publicado es horizontal. Puedes escoger otras formas admitidas en el flujo, pero la especificación de entrenamiento no demuestra calidad equivalente en todas las relaciones de aspecto.
El redimensionado de referencias es otro control independiente. ModelTC recomienda su política match para inferencia de referencias destilada porque sigue la política de entrenamiento. Conserva la forma, se ajusta al presupuesto de píxeles y no amplía una entrada pequeña. Es diferente de forzar el lado corto de todas las referencias a 2048 píxeles. Aumentar sus dimensiones no basta para esperar mejor identidad o generación más rápida.
La preparación útil es sencilla: proporciona una referencia clara cuyos detalles importantes sean visibles antes de redimensionarla. Evita un rostro en una esquina diminuta de un collage enorme. Si la imagen tiene manos ambiguas, joyería complicada o un patrón del vestido emborronado por compresión, corrígela antes de pedir a cualquiera de las rutas que la anime.
Los detalles finos también deben mantenerse en el tiempo. Un patrón parecido al encaje que luce bien en un fotograma, pero cambia de forma cada pocos fotogramas, distrae al moverse. Aumentar las dimensiones puede hacer más visible esa inestabilidad. Un ampliador puede agrandar el archivo; no establece cuál de los patrones cambiantes era el deseado.
Si el movimiento y la identidad ya sirven, ampliar puede facilitar la entrega. Si cambia la identidad o se transforma el tejido, regenera o simplifica primero el plano. Así evitas pagar por dar nitidez a un error.
Los problemas de audio necesitan un diagnóstico más concreto
El motivo más sólido para ser prudente con el audio Turbo es la variedad de síntomas descritos, no afirmar que todos los clips rápidos H3 suenan mal.
En una conversación de efectos sonoros de LightX2V, un creador describió efectos ausentes o débiles; otro, una pequeña distorsión o eco mientras elogiaba la imagen. En otro lugar, el hilo temprano de conversión a ComfyUI del responsable registró una diferencia de audio entre implementaciones, seguida de una respuesta que señalaba una corrección. Son observaciones sensibles a la versión y configuración, no un benchmark actual de todas las versiones.
La diferencia importa porque las soluciones no son las mismas.
Falta un efecto tenue de la habitación. Si el resto del clip es correcto, añade el efecto en edición. Un roce breve de tejido o ambiente de habitación no suele justificar regenerar toda la interpretación del personaje. Si debe coincidir con una acción visible, colócalo en esa acción al editar.
El personaje habla cuando la escena debería ser silenciosa. Explicita el sonido deseado y elimina expresiones que sugieran conversación. Si la boca permanece quieta, cambiar el audio puede terminar el plano. Si forma palabras inventadas de manera visible, silenciar la pista deja un problema visual: recorta el tramo útil o regenera quitando el diálogo de la escena.
Las palabras necesarias son incorrectas. Mantén un hablante, una frase breve y tiempo suficiente alrededor. Usa la sintaxis de diálogo documentada para ese flujo. Si sigue fallando, cambia de ruta o produce la voz por separado; acumular voz, música y efectos en el prompt añade más posibilidades de error.
Toda la banda sonora está distorsionada o es inestable. Vuelve al flujo actual del autor y al programa emparejado de video/audio antes de concluir que la respuesta son más pasos. Un problema de implementación y otro de encargo creativo no deberían llevarte al mismo bucle de nuevas generaciones.
En ficción adulta, los sonidos discretos pueden aportar mucho al ambiente. Aun así, puedes decidir que la imagen generada tiene valor y terminar el sonido aparte. Hazlo como una decisión de producción consciente, incluyendo ese tiempo de edición en el costo del clip.
Un plano útil de personaje de cinco segundos
Este es un ejemplo de planificación para un personaje adulto ficticio recurrente. Es un prompt adaptable, no un informe de un resultado generado.
La imagen de origen muestra a una mujer ficticia de treinta y tantos años con vestido de noche rojo oscuro junto a la ventana de una suite de hotel. El rostro se ve claro; una mano descansa en el alféizar y la otra aparece cerca de la cintura. Una lámpara interior aporta luz cálida. No hay espejos, subtítulos ni otras personas.
El plano pedido es deliberadamente pequeño: gira la cabeza hacia el espectador, mantiene contacto visual y esboza una sonrisa. Basta para un teaser de personaje. Conserva el contexto adulto sin pedir varios eventos sin relación a un clip de cinco segundos.
En un flujo local que acepte el formato de prompt estructurado, utiliza:
integratedmultimodaldescription: Usa Picture 1 como composición inicial. [Shot 1] La mujer ficticia de treinta y tantos años permanece junto a la ventana con el mismo vestido de noche rojo oscuro. Gira lentamente la cabeza hacia la cámara, mantiene contacto visual y esboza una sonrisa. Ambas manos permanecen en sus posiciones iniciales. La cámara está fija. Conserva el rostro, el peinado, el vestido, la ventana y la luz cálida de lámpara durante este único plano.
overall_soundscape: Ambiente interior tranquilo con un movimiento de tejido leve y breve. Sin diálogo.
nondiegeticmusic: N/A.
La estructura sigue la separación entre imagen, ambiente y música de la guía de prompts de MiniMax. La escena y la redacción de aquí son originales. En un Playground alojado, pon las mismas instrucciones visuales y sonoras en el campo de prompt y sube la imagen inicial a la entrada de imagen; estas etiquetas son texto del prompt, no campos adicionales de API.
Por qué estas instrucciones ayudan
La imagen inicial determina la apariencia. «Gira la cabeza» define un cambio menor que «gira hacia la cámara», que podría interpretarse como un giro completo del cuerpo. Mantener las manos en su sitio elimina una acción innecesaria. Una cámara fija evita modificar la escala del rostro mientras el personaje se mueve. «Único plano» aclara que no quieres un corte a otro ángulo.
No garantiza que lo cumpla. Hace más fácil identificar y corregir un movimiento no deseado porque el encargo es inequívoco.
Para darle algo más de energía, cambia un requisito creativo: sustituye el giro de cabeza por una ligera inclinación hacia la cámara y conserva el resto. Es otra idea de plano, no una prueba de calidad. Si prefieres mover la cámara, mantén al personaje casi quieto y pide un acercamiento corto y lento. Combinar ambos de inmediato dificulta conservar la composición de retrato cercano ya elegida.
Añade un saludo hablado solo si lo necesitas
Para una variante de saludo, elimina «Sin diálogo» y añade una frase breve después de la sonrisa. En un flujo local con etiquetas de diálogo de MiniMax, puede adoptar esta forma: She says <d>[English] I saved this moment for you.</d> Mantén una interpretación natural y deja tiempo para la expresión antes y después.
No añadas un segundo hablante ni canto de fondo a la misma solicitud breve. Esta variante debe transmitir esa frase con la voz del personaje, así que cualquier elemento que compita con ella debe justificar su presencia.
Usa referencias cuando necesites otra composición
Supongamos que el siguiente episodio necesita a la misma mujer sentada en un sofá de la suite. El retrato original junto a la ventana pasa a ser una referencia de identidad, no necesariamente el fotograma de inicio del video. Eso cambia la tarea.
Usa una imagen clara del personaje, otra de vestuario si hace falta y otra que establezca la habitación. Indica al flujo de referencias que la primera define a la mujer, la segunda el conjunto y la tercera el entorno. Después describe el plano sentado. Evita pedir que las tres imágenes determinen simultáneamente el fotograma inicial.
Si necesitas exactamente la composición sentada, crea y aprueba primero esa imagen y luego anímala con imagen a video. Trasladas una decisión difícil de composición a la fase de imagen fija, donde es más fácil verla y corregirla. Puede aportar más que cambiar el sampler de video.
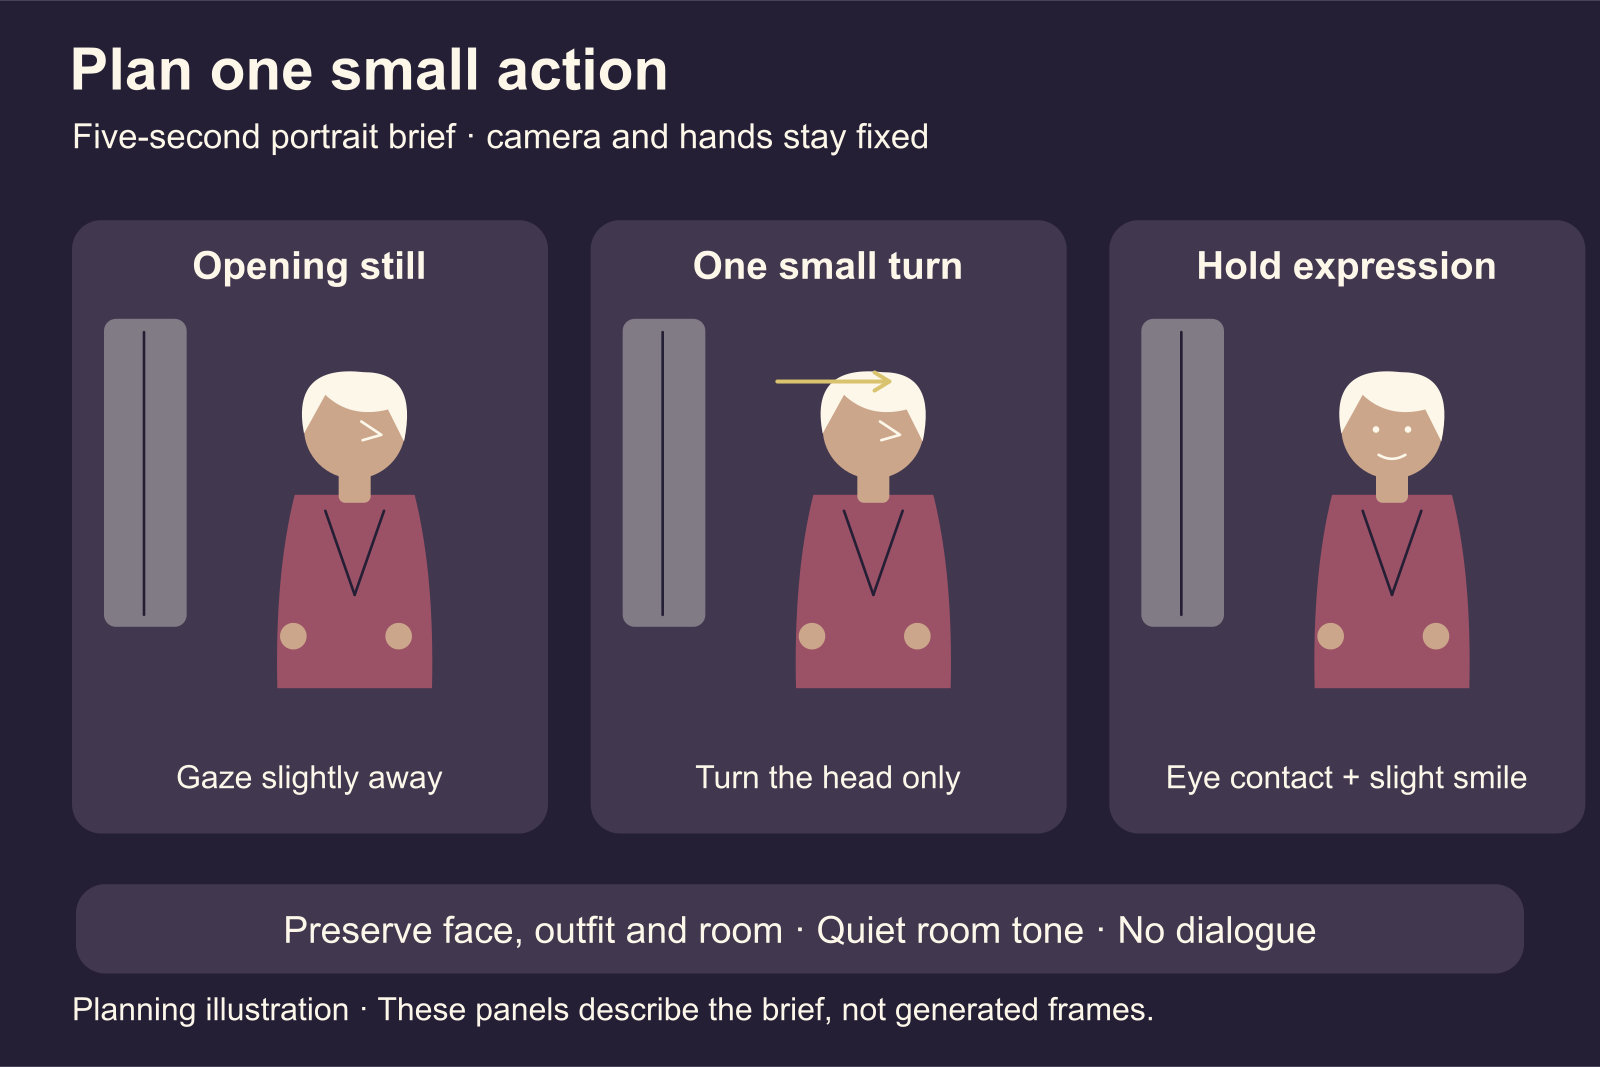
Ilustración de planificación: mantén cámara y manos quietas mientras pides un pequeño giro de cabeza.
Si falla el resultado, cambia la parte que ha fallado
Un clip rápido decepcionante es un síntoma. No identifica automáticamente a Turbo como causa.
| Qué ves u oyes | Siguiente cambio útil | Por qué hacerlo antes de otro intento aleatorio |
|---|---|---|
| El rostro ya es poco claro en la imagen inicial | Mejora o recorta la imagen antes de animarla | El video necesita un origen reconocible |
| El rostro cambia principalmente en un giro grande | Reduce el giro o aporta una vista adecuada mediante referencias | El intervalo difícil es el ángulo recién revelado |
| El modelo añade un paseo, gesto o segunda acción | Sustituye indicaciones generales por una acción visible y elementos inmóviles explícitos | El movimiento solicitado puede ser ambiguo |
| Desaparecen repetidamente instrucciones esenciales de referencias | Usa Ref2VA sin Turbo o divide la escena en planos sencillos | Repetir la misma ruta rápida no cambia la exigencia difícil |
| Manos o pelo se emborronan al moverse | Usa la receta de la tarea y reduce movimiento innecesario | Pueden influir tanto la configuración como la complejidad del movimiento |
| La imagen funciona, pero un efecto sonoro breve no | Añade ese efecto en edición | Conserva una interpretación visual útil |
| La frase es confusa y la boca se mueve mal | Acorta la frase o cambia la ruta de generación | Sustituir la pista no corrige el habla visible |
| Toda la imagen empeora al añadir Turbo | Restablece adaptador, programa, tarea y resolución compatibles | Una receta incompatible no compara base y Turbo de forma significativa |
Una conversación de LoRA de referencias en Hugging Face incluye manos borrosas y pérdida de detalle del pelo en movimiento, junto a sugerencias de cambiar adaptadores y samplers. Trátalas como pistas de los problemas encontrados. Algunas mezclan adaptadores de tareas, en contra de las indicaciones actuales de compatibilidad del autor; no son una solución universal fiable.
Hay un punto práctico para detenerse. Si la imagen de origen es clara, la receta corresponde y la misma acción necesaria sigue desapareciendo, pasa a base o reformula el plano. La pregunta útil ya no es si puedes encontrar un resultado rápido por suerte, sino si buscarlo cuesta menos que cambiar el enfoque.
Renderizar más rápido y terminar clips más baratos son cifras distintas
Cuatro frente a ocho evaluaciones indica algo del trabajo repetido del modelo. No significa que la tarea completa tarde exactamente la mitad. Cargar, procesar entradas, decodificar, transferir pesos y guardar también lleva tiempo. El primer trabajo en frío y otro con los componentes ya disponibles pueden sentirse muy distintos.
En local hay además dos relojes. La GPU puede trabajar mientras haces otra cosa, pero resolver un grafo o revisar repetidamente tomas fallidas exige atención. Una ruta que reduzca renderizado desatendido y añada reparaciones manuales puede ser un mal intercambio para quien solo hace unos clips.
En alojamiento de pago, usa la tarifa real mostrada. La tabla siguiente no contiene un precio de Turbo. Son precios públicos de la tarea estándar H3 de imagen a video de SpicyAPI, con imagen inicial. Sus entradas públicas no exponen pasos locales ni el adaptador Turbo de ModelTC.
| Resolución H3 alojada estándar | Por segundo de salida | Un clip de 5 segundos | Diez generaciones de 5 segundos |
|---|---|---|---|
| 768p | $0.037 | $0.185 | $1.85 |
| 2k | $0.058 | $0.290 | $2.90 |
El cálculo es tarifa × segundos de salida solicitados × generaciones. Referencia a video tiene sus propios cargos de referencias, por lo que no apliques esta tabla sin cambios a una solicitud con varias referencias.
Estas cifras ofrecen una alternativa real a mantener un flujo local. No indican cuántos intentos necesitarás ni establecen una comparación de velocidad con tu GPU.
La cifra que incluye las tomas descartadas
Supón que generas diez clips de cinco segundos a 768p, a $0.185 cada uno. El gasto de generaciones completadas es $1.85. Si cinco sirven para el proyecto, el costo de generación por clip útil es $1.85 ÷ 5 = $0.37. Si sirven dos, es $1.85 ÷ 2 = $0.925. Son cantidades ilustrativas de aceptación aplicadas a tarifas alojadas reales, no tasas de éxito observadas de H3.
Una generación completada que descartas por expresión, movimiento o voz incorrectos también entra en el cálculo. Es diferente de una tarea que no consigue generar. La edición, una pista de voz externa y la ampliación aumentarían el costo del clip terminado.
El mismo razonamiento sirve para Turbo local. Supón que un intento rápido consume la mitad de tiempo que uno base. Si necesita el doble de intentos para lograr algo aceptable, la ventaja de renderizado desaparece antes de contar revisión y reparación. Es un ejemplo de equilibrio, no una afirmación de que H3 tenga esos tiempos o tasas de aceptación.
En general, Turbo ahorra renderizado por clip útil cuando su tiempo por intento dividido entre su proporción útil es menor que el equivalente de base. Una aceptación algo peor puede compensar si la ganancia de velocidad es grande; una caída importante puede borrarla. No necesitas un benchmark universal para entender esa contrapartida.
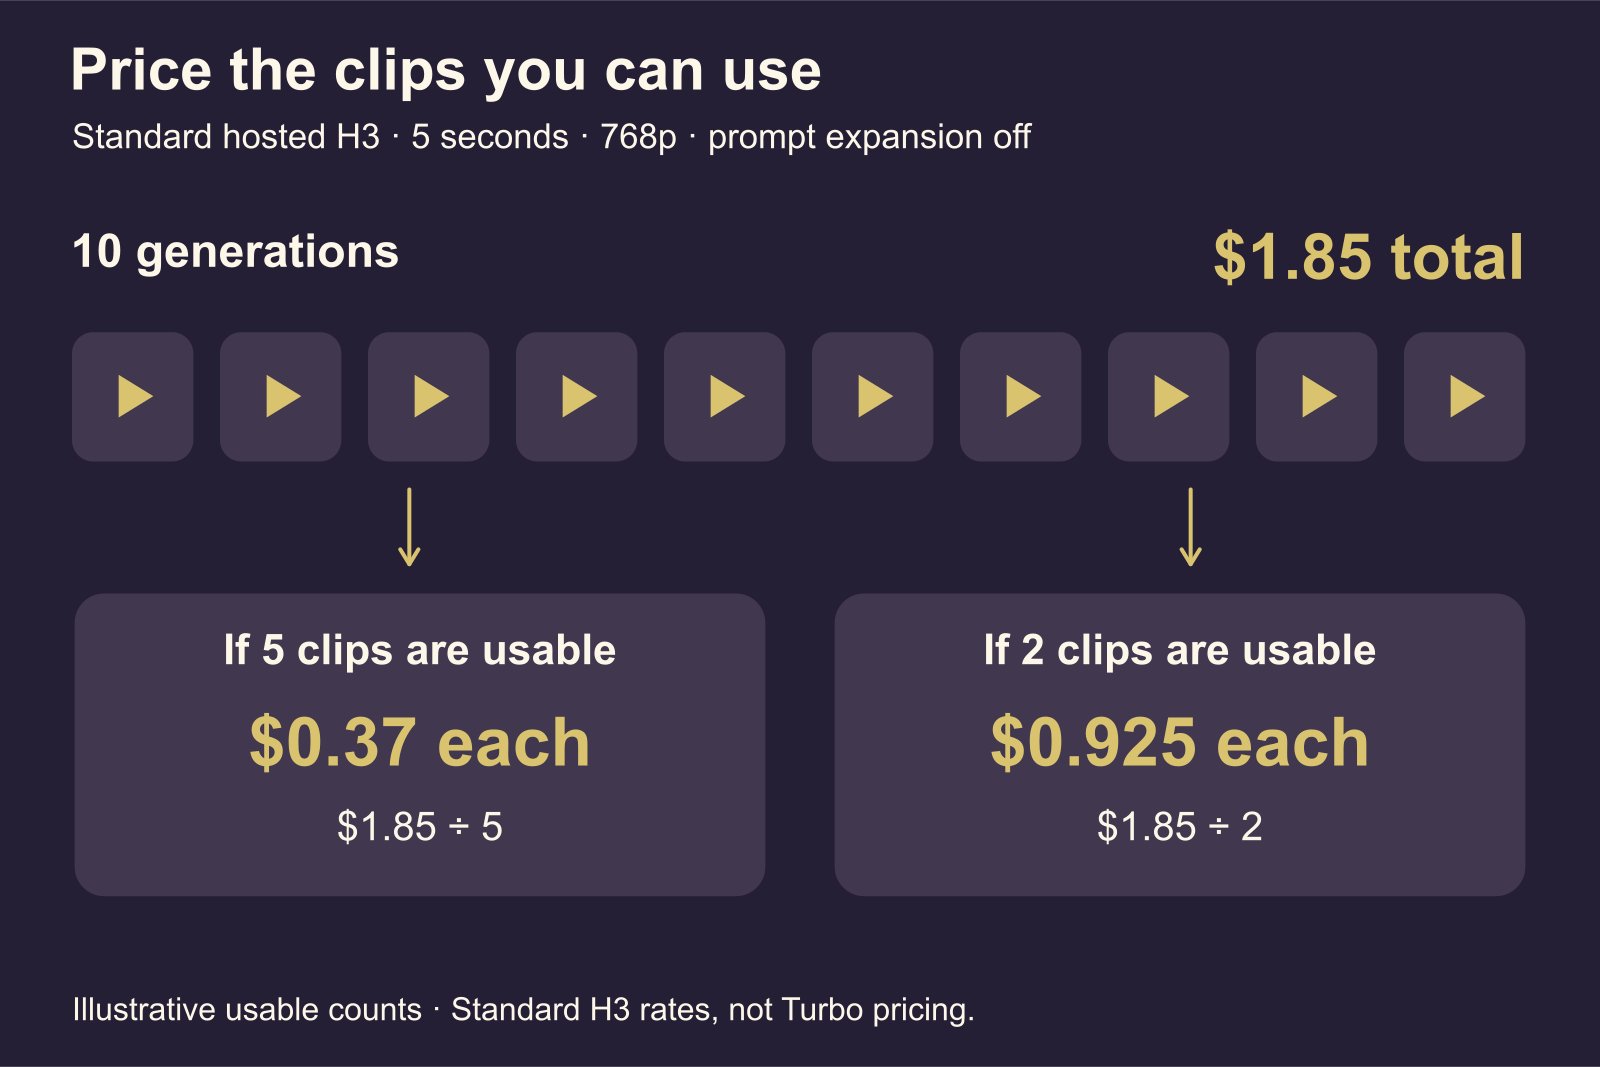
Cantidades ilustrativas de aceptación aplicadas a la tarifa H3 alojada estándar; no son tasas de éxito medidas ni precios Turbo.
El dinero de las vistas previas también puede desperdiciarse
Cuatro intentos de cinco segundos a 768p y uno de cinco segundos a 2k en la tarea alojada estándar cuestan 4 × $0.185 + $0.29 = $1.03. Puede ser una forma económica de elegir acción y composición.
Pero el intento final es una generación nueva, no una copia garantizada a mayor resolución del borrador elegido. Si los cuatro avances trataban de valorar detalles faciales delicados, quizá la fase de baja resolución no respondiera a la pregunta necesaria. Empieza en la resolución de entrega cuando la decisión trate específicamente de rasgos pequeños, tejido o el rostro de un personaje de cuerpo entero.
En local, aplica el mismo principio a las vistas previas Turbo. Úsalas para decidir lo que pueden mostrar: ritmo, encuadre aproximado y si la acción encaja con el personaje. No asumas que ya demuestran que otro renderizado base o lienzo conservará todas las expresiones.
Qué deberían elegir después los creadores NSFW
Para un teaser sencillo de personaje, silencioso o con ambiente ligero, empieza con el flujo Turbo apropiado y una buena imagen inicial. Usa la tabla para seleccionar una receta compatible con tarea y lienzo. Conserva un resultado Turbo que cumpla el encargo; su etiqueta no convierte un plano terminado en mero borrador.
Para escenas dirigidas por referencias con varias relaciones esenciales, utiliza la ruta dedicada. Mantén base disponible cuando la versión rápida pierda esas relaciones repetidamente. En diálogos, decide pronto si el habla generada es esencial o si puedes terminar el sonido aparte.
La capacidad de contenido sigue dependiendo de la ruta. La página estándar de H3 de imagen a video de SpicyAPI informa de las pruebas adultas de esa tarea; no establecen el comportamiento de un Turbo local u otro servicio. Acelerar no demuestra compatibilidad NSFW. Para distinguir las familias H3 alojadas, consulta la comparación H3, Spicy, LoRA y Singularity.
El siguiente paso útil es elegir un plano que necesites realmente, asignarlo a fotogramas clave o referencias y usar la receta publicada correspondiente. Si quieres un flujo alojado con fotograma inicial, lleva el encargo de cinco segundos de arriba a la página estándar H3, sube tu imagen aprobada y revisa la estimación. Valora la compra por la escena terminada que puedas usar: personaje correcto, movimiento requerido y sonido al servicio del clip.