Masz nieruchomy obraz powracającej dorosłej postaci, pomysł na krótką scenę i kolejkę klipów do zrobienia. Czterokrokowy proces MiniMax H3 wydaje się oczywistym wyborem. Potem twarz mięknie podczas obrotu, model dodaje działanie, o które nie prosiłeś, albo obraz działa, lecz głos nie. Tutaj Turbo oznacza społecznościową LoRA przyspieszającą H3, a nie osobny komercyjny produkt H3 Max Turbo.
Wybierz Turbo dla prostych, ograniczonych ujęć i szybkiej eksploracji. Dla nowej konfiguracji tekstu/klatek kluczowych w 768p FL2VA 8-step v1.0 768p jest udokumentowanym punktem wyjścia, ponieważ to obecna konfiguracja Studio autora. Zachowaj bazowy proces bez Turbo dla ujęcia, w którym wymagane działanie ciągle znika. Wybór Studio i deklaracja autora o poprawie audio/wideo nie dowodzą, że osiem kroków ogólnie daje lepsze dialogi lub detale tkaniny.
Nie oddajesz udokumentowanego procentu jakości. Wybierasz model dostosowany do znacznie krótszego harmonogramu próbkowania, z własnymi założeniami zadania i rozdzielczości. Potencjalnym kosztem jest mniej niezawodna realizacja konkretnych szczegółów potrzebnych scenie. Base również nie obiecuje idealnego klipu.
Nie uruchomiliśmy scen dla dorosłych z tymi samymi wejściami przez Turbo i base, więc porównanie nie może oceniać odmów, złagodzonych treści ani zachowania detali postaci. Wyjaśnia wydane wersje, wskazówki autora i zgłoszenia błędów społeczności, a potem przekłada te różnice na praktyczne wybory procesu.
| Co chcesz stworzyć | Od czego zacząć | Dlaczego |
|---|---|---|
| Krótka zapowiedź portretowa z zatwierdzonego obrazu początkowego | FL2VA Turbo dopasowane do zadania | Wygląd i kompozycja mają już wizualny punkt wyjścia |
| Nowy lokalny proces tekstu/klatek kluczowych w 768p | FL2VA 8-step v1.0 768p | Obecna konfiguracja Studio autora daje udokumentowaną instrukcję początkową |
| Nowe ujęcie złożone z osobnych referencji postaci, garderoby i pokoju | Ref2VA z własnym checkpointem | Warunkowanie referencjami jest innym zadaniem; ustawienia FL2VA nie są zamienne |
| Scena referencyjna ciągle pomijająca wymagane działanie | Ref2VA bez Turbo, z prostszą sekwencją działań | Unikasz dalszych wydatków na tę samą szybką aproksymację |
| Sporadyczne klipy bez utrzymywania lokalnej konfiguracji | Hostowane H3 z rzeczywiście potrzebnym zadaniem | Kupujesz ukończone generowanie po widocznej stawce, zamiast zarządzać samplerem |
Najpierw ustal, które „H3 Turbo” masz na myśli
Porównanie dotyczy LoRA Turbo ModelTC / LightX2V dla otwartego modelu bazowego H3. „Base” oznacza tutaj H3 bez tej LoRA przyspieszającej. Komercyjny produkt H3 Max Turbo, adapter przyspieszający innego twórcy i hostowany endpoint H3 to osobne wybory. Wspólne „H3” lub „Turbo” w nazwie nie czyni jakości, ustawień i cen zamiennymi.
LoRA Turbo służy też innemu celowi niż LoRA postaci. Jedna zmienia sposób osiągania wyniku przez H3 przy mniejszej liczbie ewaluacji modelu; druga dostosowuje model do osoby, stylu lub koncepcji. Dodanie adaptera przyspieszającego nie uczy modelu, kim jest powracająca fikcyjna postać. Z kolei załadowanie LoRA postaci nie ustanawia instrukcji generowania w czterech krokach.
Tabela checkpointów autora rozróżnia te wydania:
| Checkpoint Turbo | Zadania | Rozmiar treningowy | Zalecane ewaluacje | Shift wideo / audio |
|---|---|---|---|---|
| FL2VA 4-step v0.1 | Tekst lub klatki kluczowe | 544p, mieszane kształty | 4 | 12 / 3 |
| FL2VA 8-step v1.0 | Tekst lub klatki kluczowe | 544p, mieszane kształty | 8 lub 4 | 12 / 3 |
| FL2VA 4-step v1.0 768p | Tekst lub klatki kluczowe | 1344 × 768 | 4 | 6 / 3 |
| FL2VA 8-step v1.0 768p | Tekst lub klatki kluczowe | 1344 × 768 | 8 | 6 / 3 |
| Ref2VA 4-step v0.1 | Referencje | 544p, mieszane kształty | 4 | 12 / 3 |
FL2VA obejmuje generowanie z samego tekstu i warunkowanie pierwszą/ostatnią klatką. Ref2VA jest gałęzią warunkowaną referencjami. „VA” odnosi się do wideo i audio.
Praktyczna różnica jest natychmiastowa: czterokrokowy proces referencyjny nie jest czterokrokową alternatywą każdego ośmiokrokowego procesu obrazu. Animowanie portretu początkowego i budowa sceny z trzech referencji stawiają H3 różne wymagania. Wybierz najpierw zadanie, a potem zgodny checkpoint przyspieszający.
Karta modelu LightX2V wskazuje obecny model Studio jako FL2VA eight-step v1.0 768p i opisuje poprawę wideo i audio. To deklaracja wydania autora. Daje rozsądny punkt wyjścia dla nowego procesu tekstu/klatek kluczowych; nie dowodzi przewagi ustawienia w każdej scenie dla dorosłych lub starszym społecznościowym fine-tune.
Co zmienia mniej kroków i czego nie zmienia
Krok próbkowania dyfuzji to kolejna ewaluacja używana do zbliżenia powstającego wyniku do żądanego obrazu, ruchu i dźwięku. Destylacja kroków trenuje adapter na krótszą drogę przez ten proces. Nie jest równoważna wzięciu zwykłego procesu base, zmianie „50” na „4” i oczekiwaniu tego samego wyniku.
H3 generuje obraz i ścieżkę dźwiękową razem. Dokumentacja implementacji Diffusers opisuje osobne harmonogramy wideo i audio w jednej pętli odszumiania. Rozróżnia też transformer klatek kluczowych i transformer referencyjny. Wyjaśnia to, dlaczego pozornie mała niezgodność ustawień może wpływać na ruch i dźwięk.
Dla twórców wynikają z tego dwa użyteczne wnioski.
Po pierwsze, liczba kroków jest tylko częścią konfiguracji. Adapter, harmonogram i zadanie zaprojektowane razem stanowią mocniejszy punkt wyjścia niż lista osobno popularnych ustawień z niepowiązanych procesów. Efektowny zrzut nie powie, czy autor zmienił również wagi bazowe, kwantyzację, rozmiar wejścia lub ścieżkę audio.
Po drugie, szybsze próbkowanie nie zmniejsza znaczenia wejścia. Przycięta dłoń na klatce początkowej nadal oznacza brak informacji. Profil sprzeczny z portretem na wprost nadal jest konfliktową referencją. Pięciosekundowa instrukcja zawierająca wejście, obrót, poprawienie garderoby, wypowiedź i orbitę aparatu nadal wymaga kilku wydarzeń w małym przedziale.
Najprzydatniej myśleć o kompromisie jako tolerancji na błędy w tym konkretnym ujęciu. Jeśli dostarczasz niemą pętlę nastroju, niedoskonała generowana ścieżka może nic nie kosztować, bo planowałeś ją zastąpić. Jeśli dostarczasz osobiste powitanie powracającej postaci, niewłaściwe słowa mogą uczynić atrakcyjny klip nieużytecznym.
Wynik ośmiokrokowy może być finalny. Wynik base może zawieść. Żadna etykieta nie powinna rozstrzygać tego wcześniej. Wybór ścieżki ma unikać płacenia za możliwości lub kompromisy niepotrzebne ujęciu.
Gdzie Turbo jest użyteczne w pracy z dorosłymi postaciami
Zapowiedź portretowa z jednym widocznym działaniem
Rozważ fikcyjną kobietę po trzydziestce w sukni wieczorowej w delikatnie oświetlonym mieszkaniu. Portret początkowy jest zatwierdzony: twarz, włosy, strój i pokój już są właściwe. Wideo ma pokazać niewielki obrót ku aparatowi i przejście w uśmiech.
To sensowne zadanie Turbo, ponieważ założenie zawiera jedną główną zmianę. Widz potrzebuje rozpoznania postaci i odczytania wyrazu twarzy; klip nie musi wprowadzać kolejnej osoby, rekonstruować niewidocznego pokoju ani synchronizować rozmowy. Image-to-video daje ruchowi wyraźną kompozycję początkową.
Niech obraz początkowy niesie szczegóły wyglądu. Umieść działanie, aparat i dźwięk w prompcie ruchu. Powtarzanie długiego opisu fizycznego może wprowadzać różnice wobec obrazu: nowy przymiotnik fryzury lub trochę inny kolor sukni staje się kolejną instrukcją do pogodzenia.
Dla prywatnej serii dla dorosłych to samo podejście obowiązuje przy bardziej dojrzałym źródle. Decyzja o przyspieszaniu dotyczy potrzebnego ruchu i ciągłości klipu. Samo słowo „Turbo” nie dostarcza dowodów, czy konkretna hostowana usługa akceptuje zamówioną treść.
Gotowa scena z dialogiem
Dla krótkiego powitania użyj konfiguracji autora dopasowanej do zadania, krótkiej wypowiedzi i dość czasu na mówienie. Ogranicz ruch. Orbita aparatu, pełny obrót ciała i zdanie kierowane do widza tworzą konkurujące wymagania orientacji twarzy i czasu.
Jeśli wypowiedziane zdanie jest produktem, zrozumiałość traktuj jako kluczową. Klip z właściwą miną i niewłaściwymi słowami nie jest tańszym powitaniem. Jeśli mowa pozostaje zawodna po zastosowaniu bieżącego procesu, próba base lub osobno stworzona ścieżka głosu jest bardziej celowym kolejnym krokiem niż pięć synonimów „wyraźnego głosu”.
Oddzielne audio jest szczególnie praktyczne dla narracji spoza kadru lub niemego montażu portretów. Jest mniej proste, gdy widoczne usta postaci muszą pasować do dokładnego zdania. To rozróżnienie powinno wpływać na ujęcie przed renderowaniem.
Dwie postacie lub kilka ról referencji
Powracająca para w znanym pokoju potrzebuje więcej niż dwóch ładnych twarzy. Scena może wymagać zachowania, kto ma który strój, gdzie stoi, kto porusza się pierwszy i kto mówi. Jeśli referencje przypisują te role, wybierz Ref2VA i wyraźnie nazwij zadania wejść.
Niedawna dyskusja społeczności o ustawieniach H3 bez Turbo zawiera relację twórcy, że Turbo radził sobie z prostymi prośbami, ale pomijał instrukcje lub wymyślał wydarzenia w bardziej złożonych scenach referencyjnych. Relacja nie mierzy uniwersalnego wskaźnika niepowodzeń. To przydatne ostrzeżenie dokładnie dla sytuacji, w której brak relacji lub działania unieważnia klip.
Jeśli złożone działanie jest konieczne, a szybka ścieżka ciągle je pomija, proces referencyjny bez Turbo jest rozsądną następną gałęzią. Jeśli potrzebujesz krótkiej zapowiedzi, uprość ujęcie: jedna postać reaguje, druga pozostaje na miejscu, lub podziel sekwencję na dwa krótkie ujęcia. To decyzja redakcyjna o opowiadaniu sceny, a nie twierdzenie, że dodatkowe kroki gwarantują poprawną interakcję.
Eksploracyjna sekwencja, którą planujesz odrzucić
Turbo ma też sens, gdy klip ma odpowiedzieć na przybliżone pytanie kreatywne: czy postać obraca się ku oknu czy widzowi; czy aparat zostaje blisko czy odjeżdża; czy nastrój lepiej czyta się przed siadaniem czy po nim?
Tymczasowy wynik może być wtedy przydatny mimo defektów faktury dyskwalifikujących go jako gotowe wideo. Zachowaj udany wybór kreatywny, a potem wygeneruj finalne ujęcie ścieżką i rozdzielczością odpowiednią do dostarczenia. Nie zakładaj, że ponowny render base dokładnie odtworzy próbę Turbo. Jeśli konkretna klatka ma znaczenie, zachowaj ją jako obraz wejściowy następnego ujęcia, zamiast traktować seed jako przenośny storyboard.
Używaj ustawień należących do checkpointu
Instrukcje ComfyUI autora wymagają ComfyUI 0.31.0 lub nowszego, używają podstawowych węzłów H3 i domyślnie próbkowania Euler. Wyraźnie nakazują ustawić razem adapter, liczbę kroków i oba shifty. Wymiary obrazu muszą być wielokrotnościami 32.
To konfiguracja początkowa. Jest też użyteczniejszą bazą diagnostyczną niż założenie, że stary udostępniony proces nadal pasuje do najnowszego pliku modelu.
Dla ujęcia FL2VA 768p wybierz adapter 768p i odpowiadające ustawienia z tabeli. Samo zwiększenie płótna starszego procesu 544p nie czyni go wersją trenowaną w 768p. Dla sceny referencyjnej użyj adaptera i procesu referencyjnego. Poradnik konfiguracji Diffusers ostrzega przed umieszczaniem adaptera FL2VA na transformerze referencyjnym, chyba że specjalnie go do tego wytrenowano; przykład Ref2VA bez Turbo używa 50 ewaluacji.
Pięćdziesiąt to baza dostarczona przez autora, a nie ustalenie, że każda scena potrzebuje dokładnie pięćdziesięciu. Podobnie osiem nie jest uniwersalnym ustawieniem naprawczym dla każdego pliku z „4-step” w nazwie. Użyj zalecanej liczby dla wybranego wydania przed eksploracją własnych harmonogramów.
Jeden szczegół techniczny ma znaczenie przy różnych poradnikach: NFE oznacza ewaluacje modelu, a interfejsy nie zawsze identycznie liczą „kroki”. Skrypt inferencji ModelTC definiuje argument kroków jako ewaluacje i dodaje końcowy punkt harmonogramu wymagany przez Diffusers. Skopiowanie tej samej liczby do innego wrappera może więc opisywać inny harmonogram. Użyj udokumentowanego znaczenia tego wrappera, zamiast poprawiać działający graf autora dlatego, że inny ekran pokazuje jeden punkt więcej.
Nie traktuj siły LoRA przyspieszającej jako suwaka intensywności treści dla dorosłych. Kontroluje wpływ adaptera na model. Zmniejszenie zmienia konfigurację przyspieszania; zwiększenie nie ustanawia bardziej swobodnego zachowania treści. Jeśli używasz też LoRA postaci lub stylu, oddziel ją od ustawienia Turbo zarówno w myśleniu, jak i procesie.
Rozdzielczość zmienia podejmowany kompromis
Bliski portret i kompozycja pełnej sylwetki mogą mieć identyczne wymiary wyniku i bardzo różne wymagania wobec szczegółów twarzy. W portrecie twarz zajmuje dużą część obrazu. W pełnej sylwetce może być na tyle mała, że niewielki ruch usuwa użyteczne różnice wokół oczu lub ust.
Dla powracającej dorosłej postaci wielkość kadru jest więc wyborem kreatywnym i kosztem renderowania. Jeśli rozpoznanie znaczy więcej niż pokazanie pokoju, przybliż kompozycję początkową. Wydanie większej liczby pikseli na pustą ścianę słabo zastępuje dość miejsca dla twarzy.
Wydania Turbo 544p i 768p czynią wybór bardziej wyraźnym. Używaj rozdzielczości właściwej dla checkpointu, zamiast zakładać identyczne zachowanie adaptera na każdym płótnie. Twórcy portretów powinni też zauważyć, że wymienione treningowe płótno 768p jest poziome. Możesz wybrać inne obsługiwane kształty w procesie, ale opublikowana specyfikacja treningu nie dowodzi identycznej jakości przy każdych proporcjach.
Zmiana rozmiaru referencji to kolejna osobna kontrolka. ModelTC zaleca politykę match dla destylowanej inferencji referencyjnej, ponieważ odpowiada polityce treningu. Zachowuje kształt, stosuje docelowy budżet pikseli i nie powiększa mniejszego wejścia. Różni się od wymuszania krótszej krawędzi 2048 pikseli dla każdej referencji. Większe wymiary referencji same nie uzasadniają oczekiwania lepszej tożsamości lub szybszego generowania.
Dla twórcy przydatne przygotowanie jest proste: dostarcz wyraźną referencję z widocznymi ważnymi szczegółami przed zmianą rozmiaru. Unikaj twarzy w maleńkim rogu ogromnego kolażu. Jeśli źródło ma niejasne dłonie, złożoną biżuterię lub wzór sukni rozmazany kompresją, napraw obraz przed prośbą do dowolnej ścieżki o animację.
Drobne detale mają też wymiar czasowy. Koronkowy wzór atrakcyjny w jednej klatce, ale zmieniający kształt co kilka klatek, rozprasza w ruchu. Wyższe wymiary mogą uwidocznić niestabilność. Upscaler powiększy plik; nie ustali, który zmieniający się wzór był zamierzony.
Jeśli ruch i tożsamość są już użyteczne, powiększenie może pasować do dostarczenia. Jeśli tożsamość lub tkanina się zmienia, najpierw wygeneruj ponownie lub uprość ujęcie. Unikniesz płacenia za wyostrzanie błędu.
Skargi na audio potrzebują dokładniejszej diagnozy
Najmocniejszym powodem ostrożności wobec audio Turbo jest zakres zgłaszanych objawów, a nie twierdzenie, że wszystkie szybkie klipy H3 źle brzmią.
W dyskusji LightX2V o efektach dźwiękowych twórca zgłaszał brakujące lub ciche efekty; inny opisywał lekkie zniekształcenie lub echo, chwaląc obraz. Gdzie indziej wczesny wątek opiekuna o konwersji ComfyUI zgłosił różnicę audio między implementacjami, po czym odpowiedź społeczności wskazała poprawkę audio. To obserwacje zależne od konfiguracji i wersji, a nie bieżący benchmark każdego wydania.
Rozróżnienie ma znaczenie, ponieważ sposoby naprawy są różne.
Brakuje cichego efektu pokoju. Jeśli klip poza tym jest właściwy, dodaj efekt w montażu. Krótki szelest tkaniny lub odgłosy pokoju zwykle nie uzasadniają ponownego generowania całego występu postaci. Jeśli dźwięk musi zbiec się z widocznym działaniem, umieść go przy działaniu w montażu.
Postać mówi, choć scena powinna być niema. Wyraźnie określ zamierzony dźwięk i usuń język sugerujący rozmowę. Jeśli usta pozostają nieruchome, wymiana audio może dokończyć ujęcie. Jeśli usta widocznie formują wymyśloną mowę, wyciszenie pozostawia problem wizualny; skróć użyteczny fragment lub wygeneruj ponownie bez dialogu w scenie.
Wymagane słowa są niewłaściwe. Zachowaj jednego mówcę, jedno krótkie zdanie i dość czasu wokół niego. Użyj składni dialogu udokumentowanej dla wybranego procesu. Jeśli wypowiedź nadal jest błędna, zmień ścieżkę lub stwórz głos osobno; spiętrzanie mowy, muzyki i efektów w prompcie dodaje więcej rzeczy, które mogą zawieść.
Cała ścieżka jest zniekształcona lub niestabilna. Wróć do bieżącego procesu autora i sparowanego harmonogramu wideo/audio, zanim uznasz więcej kroków za odpowiedź. Problem implementacji i problem prośby kreatywnej nie powinny prowadzić do tej samej pętli ponownego renderowania.
W fikcji dla dorosłych cichy dźwięk może stanowić dużą część nastroju. Nadal możesz uznać generowany obraz za wartościowy i wykończyć dźwięk osobno. Podejmij to świadomie, aby czas montażu audio był uwzględniony w koszcie klipu.
Użyteczne pięciosekundowe ujęcie postaci
Oto przykład planowania dla powracającej fikcyjnej postaci twórcy dla dorosłych. To prompt do dostosowania, a nie raport wygenerowanego wyniku.
Obraz źródłowy pokazuje fikcyjną kobietę po trzydziestce w ciemnoczerwonej sukni wieczorowej obok okna hotelowego apartamentu. Twarz jest wyraźna, jedna dłoń spoczywa na parapecie, a druga jest widoczna blisko talii. Ciepłe światło pochodzi z lampy w pokoju. Nie ma luster, podpisów ani dodatkowych osób.
Zamówione ujęcie jest celowo niewielkie: obraca głowę ku widzowi, utrzymuje kontakt wzrokowy i lekko się uśmiecha. To wystarczy dla zapowiedzi postaci. Zachowuje kontekst dla dorosłych bez wymagania kilku niepowiązanych wydarzeń w pięciosekundowym klipie.
Dla lokalnego procesu przyjmującego ustrukturyzowany format promptu użyj:
integratedmultimodaldescription: Użyj Picture 1 jako kompozycji początkowej. [Shot 1] Fikcyjna kobieta po trzydziestce pozostaje obok okna w tej samej ciemnoczerwonej sukni wieczorowej. Powoli obraca głowę ku aparatowi, utrzymuje kontakt wzrokowy i lekko się uśmiecha. Obie dłonie pozostają w pozycjach początkowych. Aparat jest nieruchomy. Zachowaj twarz, fryzurę, suknię, okno i ciepłe światło lampy przez całe pojedyncze ujęcie.
overall_soundscape: Ciche odgłosy wnętrza z delikatnym, krótkim szelestem tkaniny. Bez dialogu.
nondiegeticmusic: N/A.
Struktura odpowiada podziałowi obrazu, otoczenia dźwiękowego i muzyki w poradniku promptów MiniMax. Scena i sformułowania tutaj są oryginalne. W hostowanym Playground umieść te same instrukcje obrazu i dźwięku w polu promptu, a obraz początkowy prześlij do wejścia obrazu; te etykiety są tekstem promptu, a nie dodatkowymi polami API.
Dlaczego te instrukcje wykonują użyteczną pracę
Obraz początkowy określa wygląd. „Obraca głowę” definiuje mniejszą zmianę niż „obraca się ku aparatowi”, co można zinterpretować jako obrót całego ciała. Zachowanie obu dłoni na miejscu usuwa niepotrzebne działanie. Nieruchomy aparat unika zmiany skali twarzy podczas ruchu postaci. „Pojedyncze ujęcie” jasno mówi, że nie chcesz cięcia do innego kąta.
Nie gwarantuje to zgodności. Ułatwia rozpoznanie i poprawienie niechcianego ruchu, ponieważ założenie jest jednoznaczne.
Jeśli chcesz trochę więcej energii, zmień jedno wymaganie kreatywne: zastąp obrót głowy małym pochyleniem ku aparatowi, zachowując resztę. To nowy pomysł ujęcia, a nie test jakości. Jeśli zamiast tego chcesz ruchu aparatu, pozostaw postać niemal nieruchomą i poproś o krótkie powolne zbliżenie. Natychmiastowe połączenie obu utrudnia zachowanie wybranej kompozycji bliskiego portretu.
Dodaj mówione powitanie tylko wtedy, gdy jest potrzebne
Dla wariantu powitania usuń „Bez dialogu” i dodaj jedno krótkie zdanie po uśmiechu. W lokalnym procesie używającym tagów dialogu MiniMax zdanie może wyglądać tak: She says <d>[English] I saved this moment for you.</d> Zachowaj naturalną wypowiedź i czas na wyraz twarzy przed nią i po niej.
Nie dodawaj drugiego mówcy ani śpiewu w tle do tej samej krótkiej prośby. Celem wariantu jest przekazanie tego zdania głosem postaci, więc każdy konkurujący element powinien uzasadniać obecność.
Użyj referencji, gdy potrzebujesz nowej kompozycji
Załóżmy, że kolejny odcinek potrzebuje tej samej kobiety siedzącej na sofie w tym samym apartamencie. Oryginalny portret przy oknie jest teraz referencją tożsamości, a nie koniecznie klatką początkową wideo. To zmienia zadanie.
Użyj jednego wyraźnego obrazu postaci, jednego obrazu stroju, jeśli potrzebny, i jednego obrazu określającego pokój. Powiedz procesowi referencyjnemu, że pierwszy definiuje kobietę, drugi strój, a trzeci pokój. Potem opisz ujęcie siedzące. Unikaj wymagania, by wszystkie trzy obrazy jednocześnie określały klatkę początkową.
Jeśli potrzebujesz dokładnie siedzącej kompozycji, najpierw stwórz i zatwierdź obraz, a potem animuj go przez image-to-video. Przenosisz trudną decyzję kompozycji do etapu nieruchomego obrazu, gdzie łatwiej ją zobaczyć i poprawić. Może to być wartościowsze niż zmiana samplera wideo.
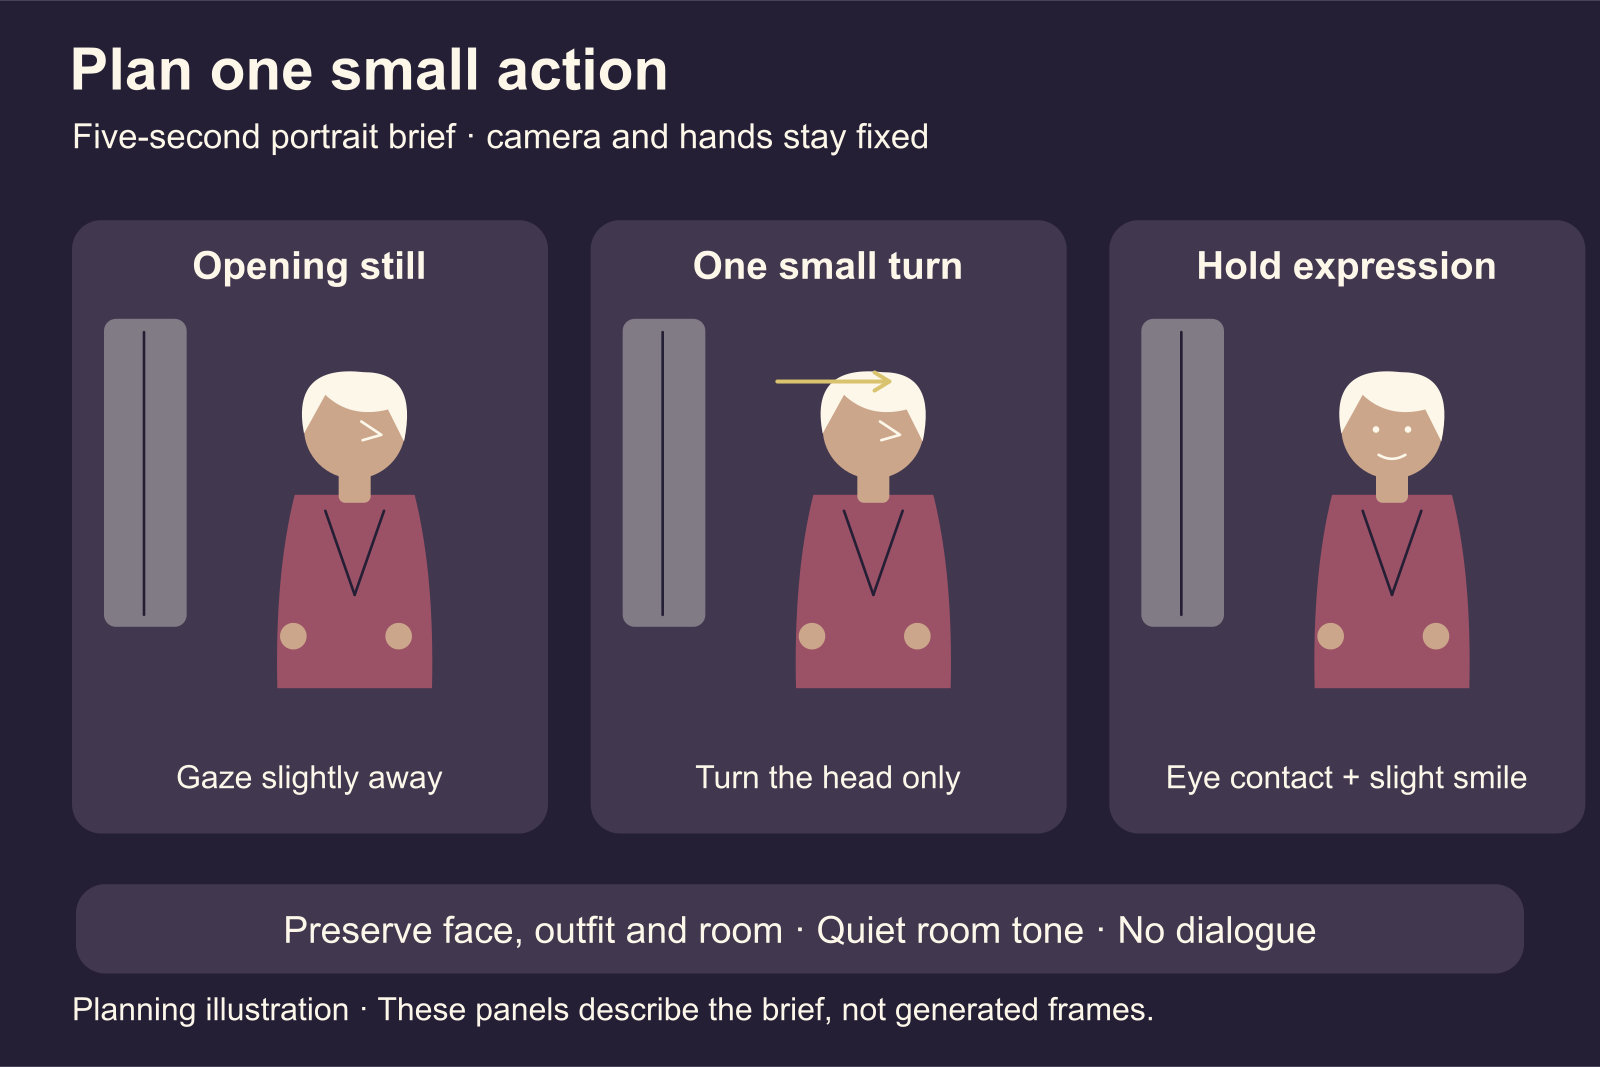
Ilustracja planowania: zachowaj nieruchomy aparat i dłonie, prosząc o jeden mały obrót głowy.
Gdy wynik zawodzi, zmień element, który zawiódł
Rozczarowujący szybki klip jest objawem. Nie wskazuje automatycznie Turbo jako przyczyny.
| Co widzisz lub słyszysz | Przydatna następna zmiana | Dlaczego przed kolejną losową próbą |
|---|---|---|
| Twarz jest niewyraźna już na obrazie początkowym | Popraw lub przytnij obraz przed animacją | Wideo potrzebuje rozpoznawalnego źródła |
| Twarz zmienia się głównie przy dużym obrocie | Zmniejsz obrót lub dostarcz właściwe ujęcie w zadaniu referencyjnym | Trudny przedział to nowo ujawniony kąt |
| Model dodaje spacer, gest lub drugie działanie | Zastąp ogólny język jednym widocznym działaniem i wyraźnie nieruchomymi elementami | Zamówiony ruch może być niejasny |
| Kilka koniecznych instrukcji referencyjnych ciągle znika | Użyj Ref2VA bez Turbo lub podziel scenę na prostsze ujęcia | Powtarzanie szybkiej ścieżki nie zmienia trudnego wymagania |
| Dłonie lub włosy rozmywają się w ruchu | Użyj konfiguracji dopasowanej do zadania, potem ogranicz zbędny ruch | Konfiguracja i złożoność ruchu mogą się przyczyniać |
| Obraz działa, ale krótki efekt dźwiękowy nie | Dodaj efekt podczas montażu | Zachowaj użyteczny występ wizualny |
| Wypowiedź jest zniekształcona, a usta poruszają się błędnie | Skróć zdanie lub zmień ścieżkę generowania | Sama wymiana ścieżki nie poprawi widocznej mowy |
| Cały obraz pogarsza się po dodaniu Turbo | Przywróć zgodny adapter, harmonogram, zadanie i rozdzielczość | Niezgodna konfiguracja nie jest sensownym porównaniem base i Turbo |
Dyskusja o referencyjnej LoRA na Hugging Face zawiera zgłoszenia rozmytych dłoni i utraty detali poruszających się włosów oraz sugestie wymiany adapterów i samplerów. Traktuj je jako wskazówki problemów napotkanych przez ludzi. Część sugestii miesza adaptery zadań, co jest sprzeczne z obecną kompatybilnością podawaną przez autora; nie są niezawodną uniwersalną naprawą.
Istnieje praktyczny punkt zatrzymania. Jeśli obraz źródłowy jest wyraźny, konfiguracja pasuje, a to samo konieczne działanie wciąż znika, przejdź do base lub przepisz ujęcie. Przydatne pytanie nie dotyczy już znalezienia szczęśliwego szybkiego wyniku. Dotyczy tego, czy poszukiwanie jest tańsze niż zmiana podejścia.
Szybszy render i tańsze gotowe klipy to różne liczby
Cztery kontra osiem ewaluacji mówi coś o powtarzanej pracy modelu. Nie mówi, że całe zadanie trwa dokładnie połowę czasu. Ładowanie, przetwarzanie wejścia, dekodowanie, przesyłanie wag i zapis wyniku też trwają. Pierwsze zadanie na zimno i późniejsze z dostępnymi już komponentami mogą dawać bardzo różne odczucia.
Dla lokalnej pracy istnieją też dwa zegary. GPU może pracować, gdy robisz coś innego, ale diagnozowanie grafu i ciągłe sprawdzanie nieudanych prób wymaga uwagi. Ścieżka ograniczająca renderowanie bez nadzoru, lecz dodająca ręczne naprawy może być słabym kompromisem dla twórcy robiącego tylko kilka klipów.
Dla płatnego hostingu użyj rzeczywistej widocznej stawki. W poniższej tabeli nie ma ceny Turbo. To publiczne ceny standardowego zadania H3 image-to-video SpicyAPI, z obrazem początkowym. Publiczne wejścia nie udostępniają lokalnych kroków próbkowania ani adaptera ModelTC Turbo.
| Rozdzielczość standardowego hostowanego H3 | Za sekundę wyniku | Jeden klip 5 sekund | Dziesięć generowań po 5 sekund |
|---|---|---|---|
| 768p | $0.037 | $0.185 | $1.85 |
| 2k | $0.058 | $0.290 | $2.90 |
Obliczenie to stawka × zamówione sekundy wyniku × liczba generowań. Reference-to-video ma własne opłaty referencji, więc nie stosuj bez zmian tabeli image-to-video do żądania z wieloma referencjami.
Liczby dają rzeczywistą alternatywę wobec utrzymywania lokalnego procesu. Nie mówią, ilu prób potrzebujesz, i nie ustalają porównania szybkości z twoim GPU.
Liczba uwzględniająca odrzucone ujęcia
Załóżmy, że generujesz dziesięć klipów po pięć sekund w 768p po $0.185 każdy. Wydatek ukończonego generowania to $1.85. Jeśli pięć jest użytecznych w projekcie, koszt generowania użytecznego klipu wynosi $1.85 ÷ 5 = $0.37. Jeśli dwa są użyteczne, to $1.85 ÷ 2 = $0.925. To ilustracyjne liczby akceptacji zastosowane do rzeczywistych stawek hostowanych, a nie obserwowane wskaźniki powodzenia H3.
Udane generowanie odrzucone z powodu niewłaściwej miny, ruchu lub głosu nadal należy do obliczenia. Różni się od zadania, które nie wygenerowało wyniku. Czas montażu, zewnętrzny głos i powiększenie dodałyby się do kosztu gotowego klipu.
Ta sama logika działa dla lokalnego Turbo. Załóż, że szybka próba zajmuje połowę czasu próby base. Jeśli szybka ścieżka wymaga dwa razy więcej prób akceptowalnego wyniku, przewaga renderowania znika przed uwzględnieniem przeglądu i napraw. To przykład progu opłacalności, a nie deklaracja tych czasów lub wskaźników akceptacji H3.
Ogólniej Turbo oszczędza czas renderowania użytecznego klipu, gdy czas jego próby podzielony przez udział użytecznych wyników jest niższy niż odpowiednik base. Trochę gorsza akceptacja nadal może być opłacalna przy dużym zysku szybkości; duży spadek akceptacji może go wymazać. Nie potrzebujesz uniwersalnego benchmarku, by zrozumieć kompromis.
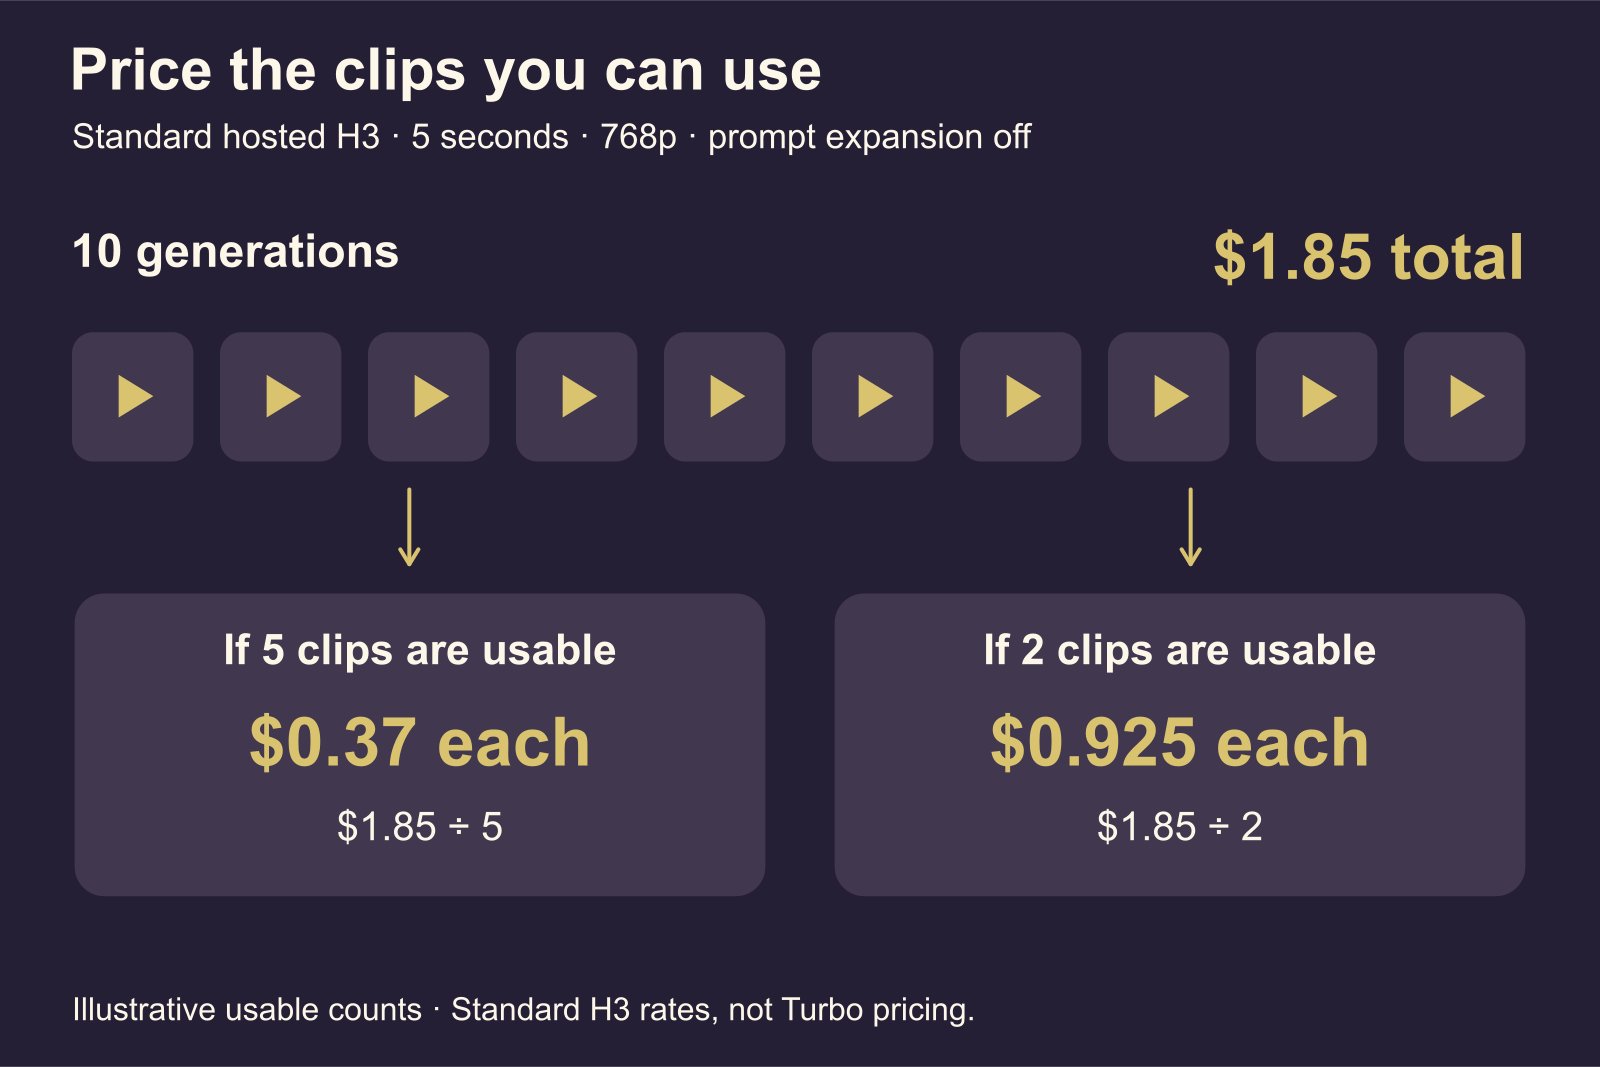
Ilustracyjne liczby akceptacji zastosowane do standardowej hostowanej stawki H3; to nie zmierzone wskaźniki powodzenia ani ceny Turbo.
Pieniądze na podglądy też mogą się zmarnować
Cztery próby po pięć sekund w 768p plus jedna po pięć sekund w 2k w standardowym hostowanym zadaniu obrazu kosztują 4 × $0.185 + $0.29 = $1.03. To może być przydatny tani sposób wyboru działania i kompozycji ujęcia.
Finalna próba jest jednak nowym generowaniem, a nie gwarantowaną kopią wybranej wersji roboczej w wysokiej rozdzielczości. Jeśli wszystkie cztery podglądy miały oceniać subtelne detale twarzy, niski poziom mógł nie odpowiedzieć na potrzebne pytanie. Zacznij od docelowej rozdzielczości dostarczenia, gdy decyzja dotyczy małych cech, tkaniny lub twarzy w pełnej sylwetce.
Dla lokalnej pracy zastosuj tę samą zasadę do podglądów Turbo. Wybieraj nimi to, co podgląd potrafi pokazać: tempo, przybliżony kadr i dopasowanie działania do postaci. Nie zakładaj, że dowiodły już zachowania każdego wyrazu twarzy w innym renderze base lub na innym płótnie.
Co twórcy NSFW powinni wybrać dalej
Dla prostej niemej lub lekko udźwiękowionej zapowiedzi postaci zacznij od odpowiedniego procesu Turbo i mocnego obrazu początkowego. Użyj tabeli checkpointów do wyboru obsługiwanej konfiguracji zadania i płótna. Zachowaj wynik Turbo spełniający założenia; etykieta nie czyni gotowego ujęcia jedynie wersją roboczą.
Dla sceny kierowanej referencjami z kilkoma koniecznymi relacjami użyj dedykowanej ścieżki referencyjnej. Zachowaj base jako opcję, gdy szybka wersja ciągle gubi te relacje. Dla dialogu wcześnie zdecyduj, czy generowana mowa jest konieczna, czy dźwięk można wykończyć osobno.
Możliwości treści pozostają specyficzne dla ścieżki. Standardowa strona H3 image-to-video SpicyAPI raportuje wyniki testów dla dorosłych tego zadania; nie określają zachowania lokalnej konfiguracji Turbo ani innej usługi. Przyspieszanie nie jest deklaracją obsługi NSFW. Różnice między hostowanymi rodzinami H3 opisuje porównanie H3, Spicy, LoRA i Singularity.
Przydatny następny krok to wybór naprawdę potrzebnego ujęcia, przypisanie go do klatek kluczowych lub referencji i użycie pasującej wydanej konfiguracji. Jeśli chcesz hostowanego procesu klatki początkowej, przenieś powyższy opis pięciu sekund na standardową stronę H3 image-to-video, prześlij zatwierdzony obraz i sprawdź szacunek. Oceniaj zakup po gotowej scenie, której możesz użyć: właściwej postaci, wymaganym ruchu i dźwięku służącym klipowi.