Quieres un clip corto de temática adulta que ya suene a algo: lluvia en la ventana, una multitud detrás de la pareja, una frase dicha en voz baja a la cámara. Muchos modelos de video sin censura siguen entregándote un archivo mudo y dejan el sonido a una segunda herramienta.
LTX-2 19B genera la imagen y una banda sonora estéreo en una sola solicitud, sin filtro de contenido, desde $0.0144 por segundo de video. Los 55 clips que generamos el 5 y 6 de octubre de 2026 llevaban una pista AAC estéreo a 24 kHz que duraba lo mismo que la imagen, y el sonido se movía con la acción: cuando una hélice empezó a girar a mitad de un clip, la pista se mantuvo casi en silencio hasta ese momento. Lo que no obtienes es consistencia. La sonoridad varió más de 30 LU entre seeds de un mismo prompt, y 5 de nuestros 15 clips controlados volvieron con subtítulos inventados grabados en el cuadro.
No podemos escuchar como tú, así que cada afirmación sobre el audio está medida: sonoridad a lo largo del tiempo, anchura estéreo, duración. No puntuamos qué tan bien suena una voz o una melodía. Los clips incrustados se reproducen con sonido, así que esa parte la juzgas tú. Los modelos están en la página de la familia LTX-2 19B y en la página de la familia LTX-2 19B LoRA; todos los prompts que se imprimen aquí son escenas con adultos vestidos.
De un vistazo
| LTX-2 19B con su propia banda sonora | |
|---|---|
| Endpoints | Texto a video e imagen a video; la versión LoRA añade hasta tres archivos LoRA |
| Sonido | AAC estéreo a 24 kHz en cada clip, sin interruptor para apagarlo |
| Duración | De 5 a 20 segundos enteros; en 55 clips, la duración del sonido y de la imagen coincidieron con una diferencia de 0.0004 s |
| Resolución | 480p (832 x 448), 720p (1280 x 704), 1080p (1920 x 1024); 9:16 intercambia los lados; imagen a video sigue la foto |
| Precio, catálogo en vivo | $0.0144, $0.0192 o $0.0288 por segundo; versión LoRA $0.018, $0.024 o $0.036; sonido incluido |
| Cómo dirigir el sonido | Una frase final que empieza con "Audio:" |
| Sonoridad que medimos | De −42.1 a −8.3 LUFS, mediana −13.2; ningún clip superó −1.6 dBTP de pico |
| Qué sale mal | La sonoridad varía entre seeds, subtítulos inventados, indicaciones temporizadas que llegan tarde o nunca |
| Contenido | Sin filtro de contenido; texto a video entregó 4 de 7 sondas de la escala, imagen a video 2 de 7, ninguna rechazada |
Cómo se hace la banda sonora
Lightricks describe LTX-2 como un solo modelo que genera video y audio sincronizados. En la práctica:
- Una solicitud, un archivo. Sin un trabajo de audio aparte y sin paso de sincronización. Un clip de cinco segundos a 720p cuesta $0.096 con su sonido.
- La entrada es texto o una foto, nunca audio. No puedes darle un archivo de voz para que lo siga.
- El sonido no se puede apagar. Para un clip sin sonido, baja el audio del clip en el editor de video de Studio o quita la pista después de descargarlo.
El publicador también advierte que el seguimiento del prompt depende mucho de cómo lo escribas, y que el audio sin voz puede salir con menor calidad.
Escribe la línea Audio
El modelo lee la imagen y el sonido del mismo prompt. Lo que nos funcionó sigue la guía de prompts de LTX-2 del publicador (de cuatro a ocho frases en un solo párrafo) y termina con una frase que empieza con "Audio:" y nombra cada sonido por su fuente. Un ejemplo publicado, un ferry atracando de noche:
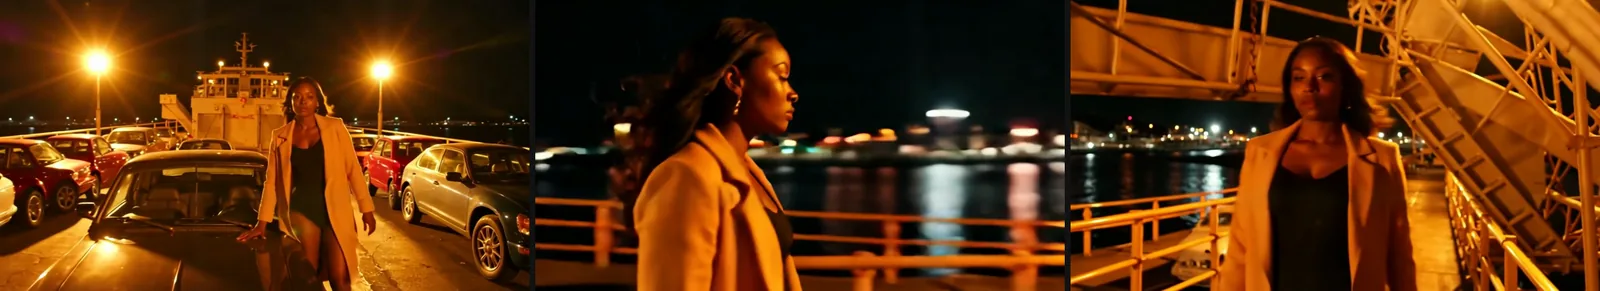
LTX-2 19B, texto a video, 16:9, 720p, 6 segundos, seed 510512. Su banda sonora se mantuvo entre −12.7 y −10.5 dBFS en cada medio segundo.
The car deck of a night ferry as it docks. Sodium-vapour lamps turn everything orange and rows of parked cars glint. An adult Black woman in her early thirties in a long camel coat worn open over a fitted black bodysuit leans on the bonnet of a vintage car, her hair whipped by wind from the opening bow. The huge steel ramp lowers with a groan and slams onto the quay, showing the harbour lights beyond; she pushes off the car and walks toward the light, glancing back at the camera. Low-angle wide shot, slow dolly forward, sodium orange against black water, anamorphic flares. Audio: the deep thrum of the engines, chains rattling, the ramp groaning down and landing with a heavy metallic boom that echoes through the hold, then the ship horn.Cinco hábitos, de la guía del publicador y de nuestras pruebas:
- Nombra lo que produce el sonido. "Chains rattling" apunta a algo en el cuadro; "atmospheric audio" no nombra ninguna fuente.
- Enumera los sonidos en el orden en que ocurren. El ejemplo del tren nocturno de la página del modelo va: ruedas, viento, una campana de cruce que sube y se apaga, y luego una bocina a lo lejos.
- Deja que el atuendo y las miradas lleven el ambiente, y el sonido la habitación. Un tirante que se desliza, una sonrisa lenta, lluvia en el vidrio y un saxofón en un disco bastan para una escena sugerente.
- Escribe una frase corta en vez de describir ruidos. Pon las palabras entre comillas y di cómo ("says softly"). Un hilo de la comunidad sobre LTX-2 reportó que las indicaciones de ruidos vocales salían como risas extrañas; no las probamos, y una frase corta es más predecible.
- En imagen a video, da sonido a lo que está en la foto. La foto fija a la persona y el lugar; describe qué pasa después y cómo suena. Un prompt que describe otra habitación puede hacer que el clip se aparte de tu foto.
| Tipo de indicación | Redacción que usamos | Qué mostraron las mediciones |
|---|---|---|
| Una base constante | "the deep thrum of the engines, chains rattling" | Nivel estable durante todo el clip |
| Un evento en la toma | "the engine coughing and catching into a roar" | Casi silencio, luego el rugido cuando gira la hélice (2 de 2 seeds) |
| Música que empieza en el momento justo | "near silence at first … then … a slow, smoky saxophone ballad starts" | Un seed saltó a los 5.0 s de 6; el otro nunca cambió |
| Una frase hablada entre comillas | says softly, "Stay. The rain isn't stopping tonight." | Dos ráfagas fuertes, casi silencio entre ellas |
| Una multitud con música | "a string quartet playing a slow waltz, the murmur of a crowd" | Nivel estable; uno de dos seeds grabó subtítulos |
| Sonidos tenues y lejanos | "a faint dance band drifting from a villa along the coast" | La misma línea, cuatro seeds: de −10.9 a −42.1 LUFS |
Qué mostraron 55 bandas sonoras
Medimos 40 clips de las pruebas de ejemplo del 5 de octubre (ambos endpoints, modelo base y versión LoRA) y 15 clips controlados que corrimos el 6 de octubre con texto a video base. El formato y la duración salieron de ffprobe, la sonoridad integrada y el pico real del medidor EBU R128 de ffmpeg, las curvas de abajo del nivel de cada fragmento de 0.1 segundo, y la anchura estéreo de comparar los dos canales.
El sonido siempre está, tan largo como la imagen
Los 55 clips tenían una pista AAC estéreo a 24 kHz, incluidos dos cuyo prompt nunca mencionó el sonido. Las solicitudes de cinco segundos devolvieron 5.042 segundos de imagen y de sonido, las de seis segundos 6.042, la de veinte segundos 20.042. Ninguna pista terminó antes que la imagen.
El sonido sigue la acción
Un piloto sube a un avión de hélice bajo la lluvia; el prompt pedía el quejido del arranque, el motor que prende y el viento de la hélice.
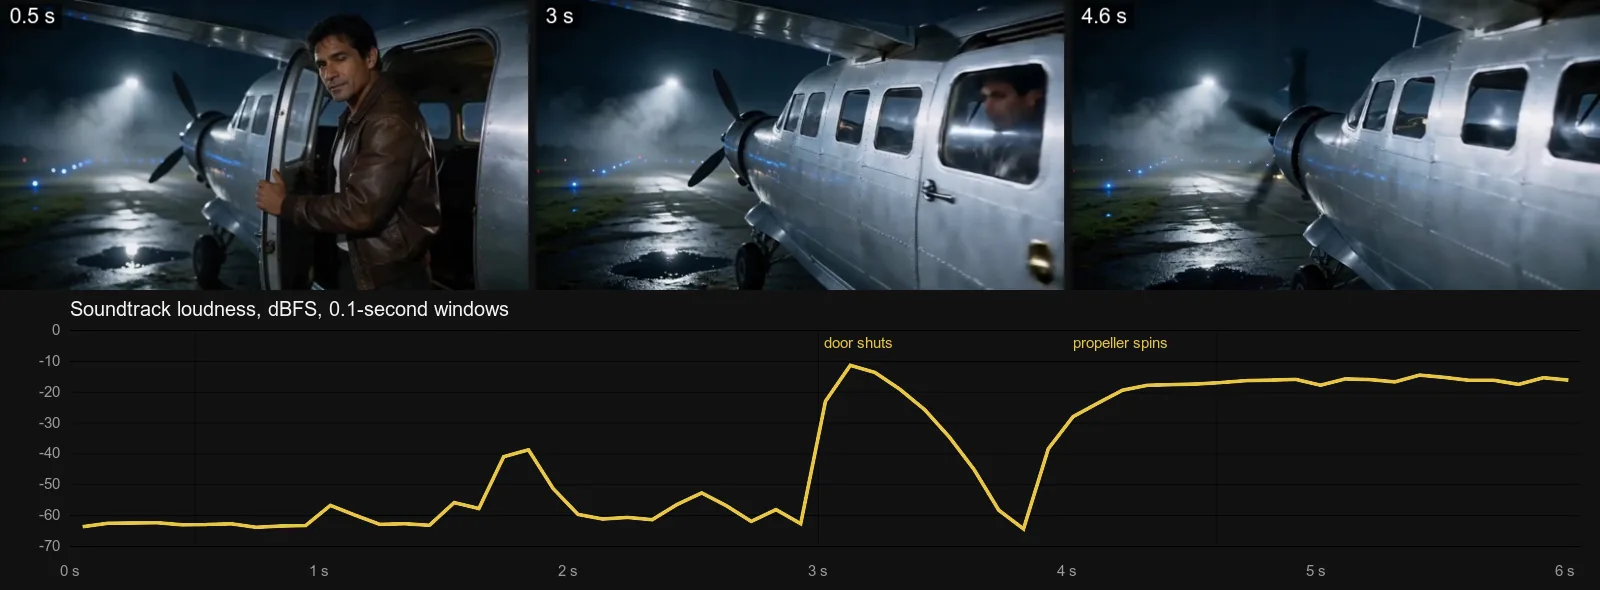
Imagen a video, 720p, 6 segundos, seed 510515. Cerca de −60 dBFS durante tres segundos, un salto al cerrarse la puerta, y luego unos −16 dBFS cuando gira la hélice. Un segundo seed también se mantuvo en silencio durante tres segundos y luego sostuvo un nivel alto y estable.
Esa es la razón principal para generar el sonido junto con la imagen: la parte fuerte cae donde cambia la imagen.
Una indicación temporizada es una petición, no una hoja de señales
Pedir silencio primero y música después es menos fiable. Este prompt del loft pedía casi silencio, luego una aguja que aterriza y una balada de saxofón.
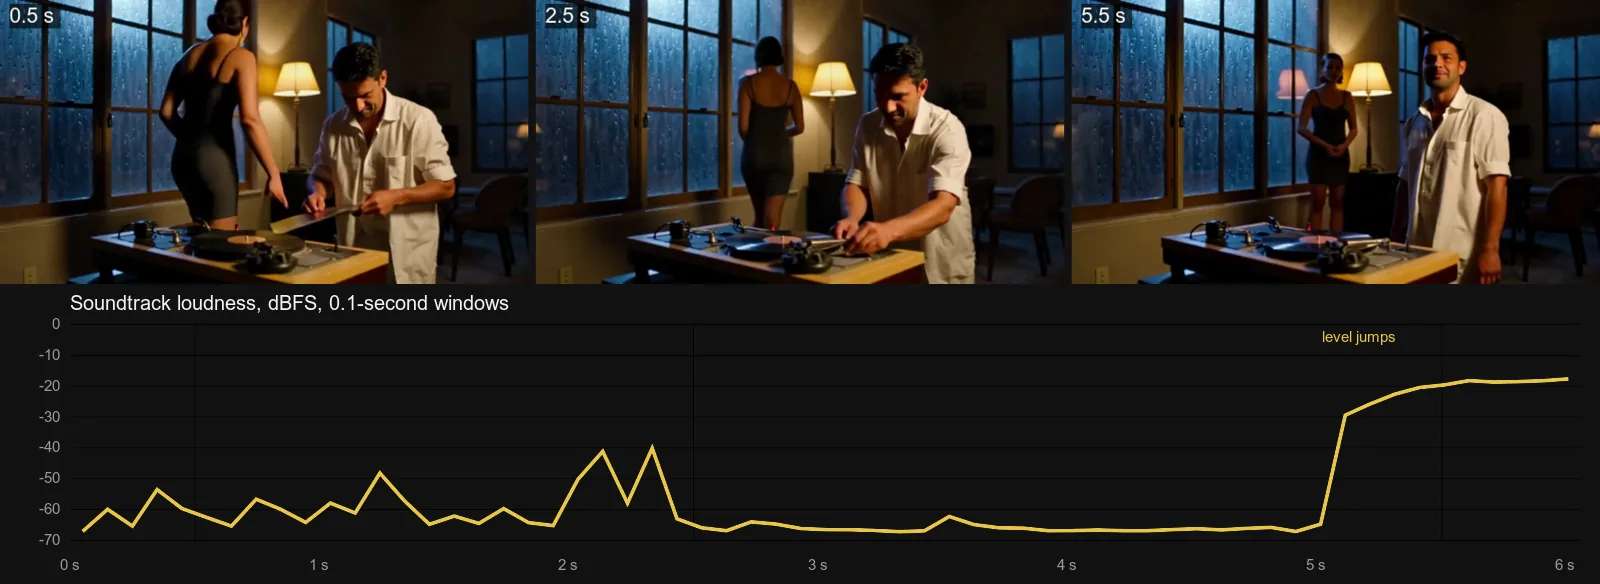
Texto a video, 480p, 6 segundos, seed 610611. El nivel salta a los 5.0 segundos de 6.
El segundo seed se quedó en unos −45 dBFS durante los seis segundos y nunca cambió. Si un sonido debe caer en un fotograma, describe la acción que lo produce, como hizo el prompt del avión. Si debe ser exacto, añádelo después.
La sonoridad cambia mucho de un seed a otro
Esto importa sobre todo cuando unes clips. Una escena en una terraza a la luz de la luna se corrió cuatro veces con la misma línea Audio:
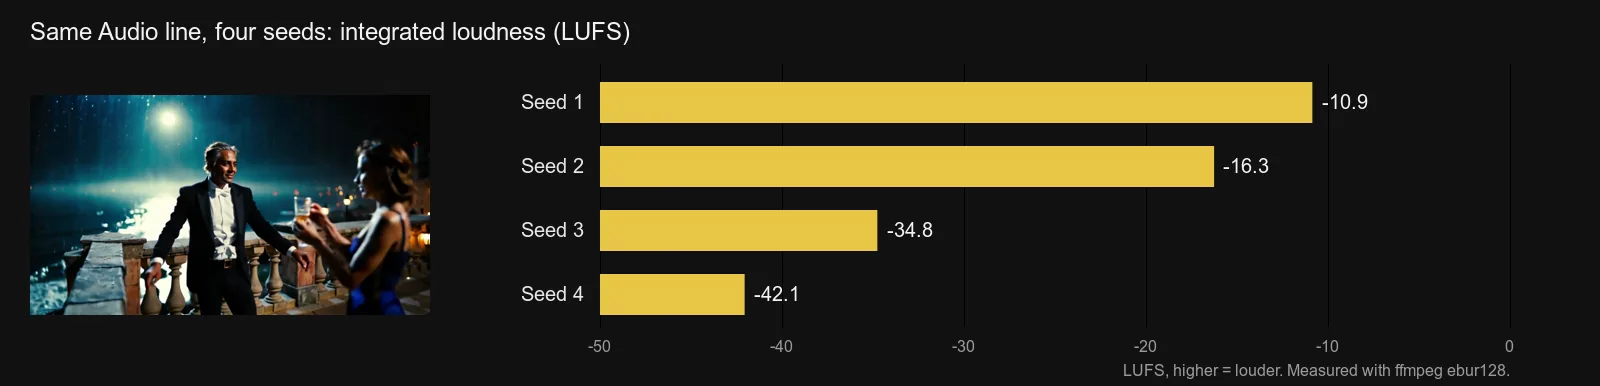
LTX-2 19B LoRA con la LoRA de cámara Dolly Out, texto a video, 720p, 5 segundos, cuatro seeds. La línea Audio era idéntica; los dos últimos prompts además describían con más detalle ambos atuendos.
En los 55 clips, la sonoridad integrada fue de −42.1 a −8.3 LUFS con una mediana de −13.2; 35 estuvieron a menos de 3 LU de la mediana y 7 fueron más silenciosos que −20. Ningún clip superó −1.6 dBTP de pico, así que nada volvió recortado. La redacción no decide esto por sí sola: las pruebas más fuertes y más débiles de la terraza tenían la misma línea Audio, palabra por palabra.
Así que iguala la sonoridad antes de unir clips, en el editor de Studio o con un normalizador de sonoridad. Seis de los 40 clips de ejemplo también terminaron al menos 15 dB por debajo de su momento más fuerte, todos de pruebas con una LoRA de cámara cargada, así que revisa los finales antes de cortar.
"Estéreo" a veces es mono
Cada archivo tiene dos canales, pero en 14 de los 55 los canales eran prácticamente idénticos (correlación de 0.99 o más), y en 13 eran claramente distintos (por debajo de 0.6). Los cuatro clips construidos en torno a una frase hablada eran en la práctica mono. Si la anchura importa, comprueba con audífonos.
Omitir la línea Audio igual da sonido
Corrimos una escena de baile de máscaras dos veces con una línea Audio (cuarteto de cuerdas, multitud, copas, su risa) y dos veces sin ella, con los mismos seeds.
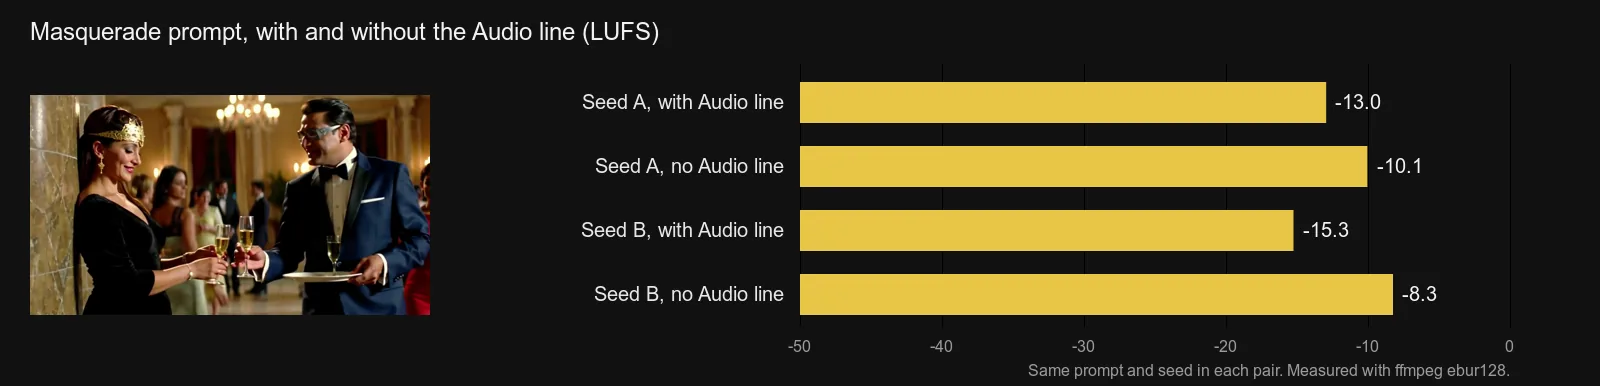
Texto a video, 720p, 5 segundos, seeds 610601 y 610602. Los dos clips sin línea Audio fueron los más fuertes.
Sin la línea igual obtienes una pista; simplemente no eliges qué lleva. Conserva la línea Audio incluso cuando el sonido no sea lo principal.
Veinte segundos aguantaron
Los clips largos son donde una pasada de sonido aparte se vuelve tediosa, así que corrimos un clip de 20 segundos a 480p.
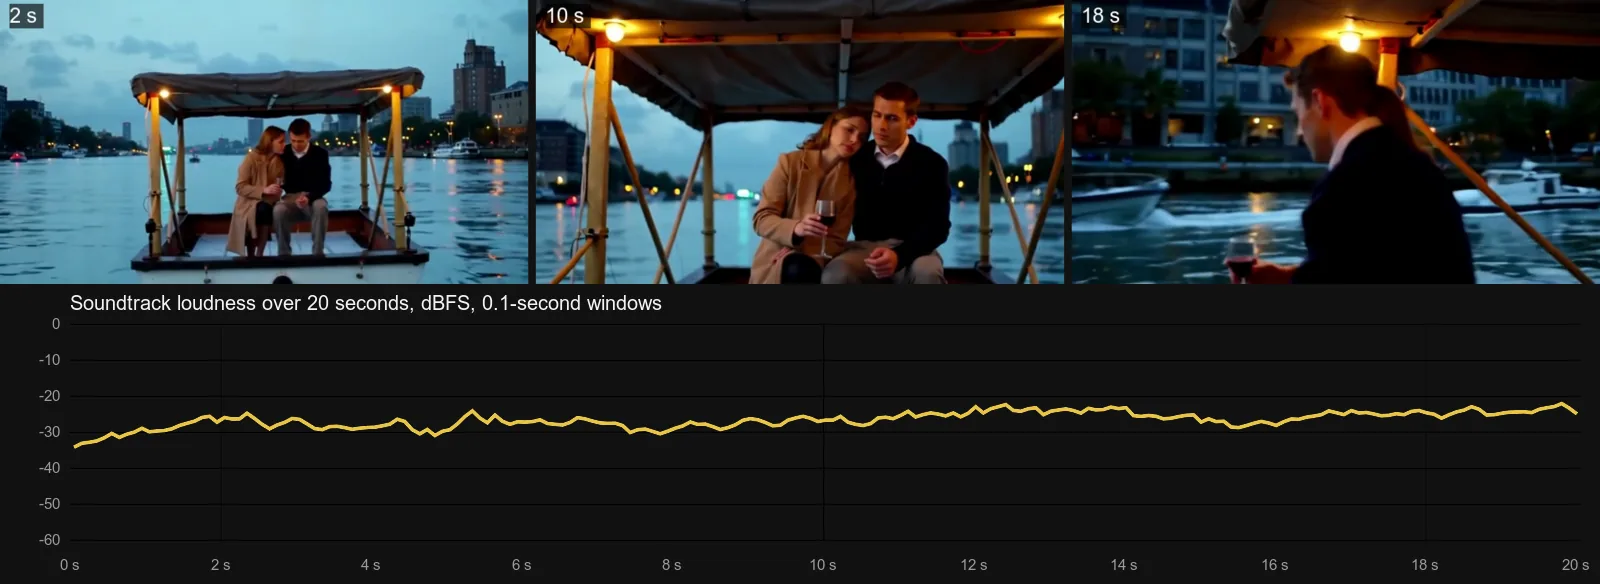
Texto a video, 16:9, 480p, 20 segundos, seed 610631. Cada medio segundo de sonido se mantuvo entre −32.6 y −22.9 dBFS.
El sonido se sostuvo durante los veinte segundos. En cambio se desvió la imagen: el avance lento de cámara siguió hasta que ella quedó casi oculta detrás de él. El clip costó $0.288. El prompt tal como lo corrimos, menos una frase "no on-screen text" que ya no recomendamos (ver la sección siguiente):
A houseboat on a river at dusk in light rain. An adult couple in their forties, a woman in a long camel coat and a man in a navy wool sweater, sit close under the canvas awning at the stern sharing a blanket, watching the city lights come on along the bank. He refills her glass of red wine; she leans her head on his shoulder; later a tour boat glides past and its wake rocks them gently. Wide shot, slow push-in, blue dusk with warm string lights, film grain. Audio: rain pattering on the canvas, water lapping against the hull, a distant radio playing old jazz, the low rumble of the passing boat and its wake slapping the side.Corre este prompt en texto a video de LTX-2 19B →
Frases habladas y los subtítulos que nadie pidió
Una frase corta hace que un clip sugerente se sienta personal. Le pedimos a una mujer con una bata de seda crema que mirara a la cámara y dijera, en voz baja, "Stay. The rain isn't stopping tonight."
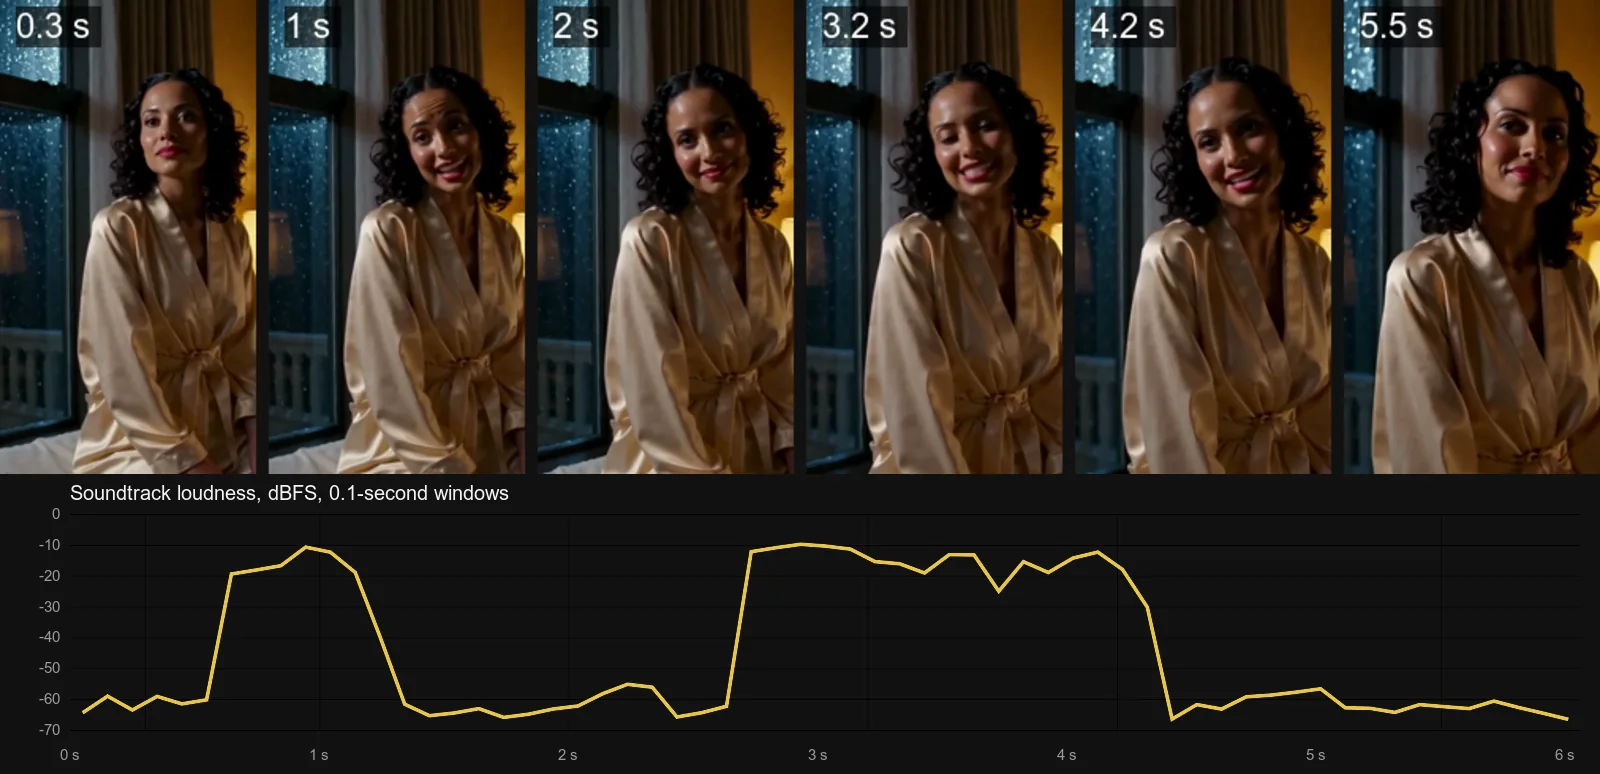
Texto a video, 9:16, 480p, 6 segundos, seed 610622, sin palabras sobre subtítulos en el prompt.
Dos tramos fuertes encajan con una frase dicha en dos partes, pero no comprobamos las palabras, así que escucha antes de fiarte. Lo que sí muestra la curva es que la "steady rain on the glass" que pedimos no estaba debajo: entre las ráfagas y después de ellas el nivel cayó a unos −60 dBFS. Cuando hay una voz, puede apoderarse de la pista.
La sorpresa mayor fue el texto en la imagen. Cinco de nuestros 15 clips controlados tenían palabras inventadas grabadas:
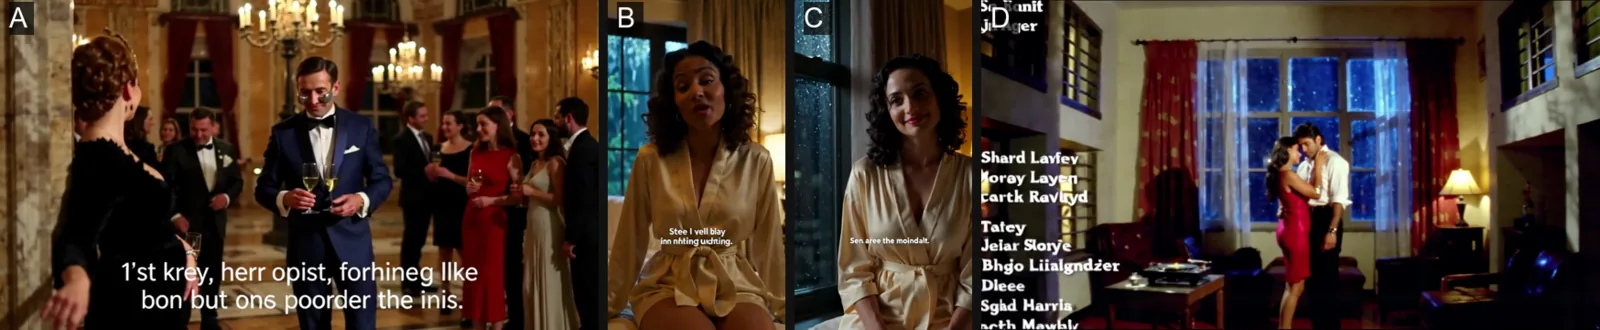
A: el prompt del baile de máscaras con su línea Audio, seed 610601, solo los primeros 0.8 segundos. B y C: el prompt de la frase hablada con "no subtitles, no captions, no on-screen text" añadido, ambos seeds. D: un prompt a 1080p de una pareja bailando con un disco; su segundo seed mostró letras para cantar en su lugar.
Once de los 15 prompts terminaban con "no subtitles" o "no on-screen text", y los cinco clips con subtítulos estaban entre ellos; los cuatro prompts sin esa frase volvieron limpios. El mismo prompt de la frase hablada con los mismos dos seeds salió limpio sin la frase y con subtítulos con ella. Seis de los once también salieron limpios, y en un lote anterior dos clips de paisaje con "no subtitles" volvieron limpios, así que en esta muestra pequeña la frase no protegió nada y puede haber provocado el texto. El texto es siempre ininteligible, lo que concuerda con la nota del publicador de que LTX-2 no renderiza texto legible.
- Deja fuera del prompt las palabras sobre subtítulos. No evitaron nada en nuestras pruebas.
- Revisa el primer y el último segundo. En el clip A el texto duró 0.8 segundos; recortar el inicio lo resolvió.
- Cambia el seed. El segundo seed del prompt del baile de máscaras salió limpio.
- Mira dos veces los prompts construidos en torno a una canción. Los dos clips a 1080p de una pareja bailando con un disco volvieron con créditos o letras.
¿Sonido integrado o un modelo sin sonido más una pasada de sonido?
La otra ruta es un clip sin sonido con efectos, voz y música añadidos después, como en nuestras guías sobre cómo agregar voz y música a un video NSFW con IA y el flujo de efectos de sonido Foley. Un clip de cinco segundos, precios del catálogo en vivo y nuestros puntajes del índice:
| Ruta | Sonido | Clip de 5 segundos | Puntaje Freedom | Puntaje en prueba a ciegas |
|---|---|---|---|---|
| LTX-2 19B, 720p | Siempre activo, estéreo | $0.096 | 76.1 | 47.5 |
| MiniMax H3, 768p | Generado con el clip | $0.185 | 70.7 | 67.6 |
| Wan 3.0, 720p | Activo por defecto, se puede apagar | $0.45 | 96 | 70.9 |
| Seedance 2.0 Fast, 720p | Activo por defecto; apagarlo no baja la tarifa | $0.48 | 72.2 | 68.6 |
| HunyuanVideo 1.5, 720p, y luego Foley v1 | Clip sin sonido, efectos añadidos después | $0.24 + $0.006 | 88.1 | 57.7 |
Freedom es nuestro puntaje de 0 a 100 de cuánto de la escala de contenido para adultos entrega un modelo; la prueba a ciegas puntúa la calidad de imagen con los nombres de los modelos ocultos. Ambos provienen de nuestro índice en vivo al 5 de octubre de 2026; para la ruta de dos pasos son los de HunyuanVideo.
- Elige LTX-2 19B para muchos borradores baratos con sonido. Es la ruta más barata de la tabla, y un clip de cinco segundos a 720p tardó de 14 a 25 segundos en nuestras pruebas. El costo es la imagen: su puntaje en la prueba a ciegas es el más bajo de los cinco.
- Elige Wan 3.0 cuando la calidad de imagen y el rango en contenido para adultos importan más que el precio. Cuesta varias veces más por segundo y aun así te da sonido.
- Añade el sonido después cuando una frase concreta deba pronunciarse o ya te guste un clip sin sonido. Los efectos Foley cuestan $0.0012 por segundo.
El límite estructural de la ruta integrada: el sonido queda incorporado en el render, así que una palabra equivocada significa pagar otra vez por la imagen.
Hasta dónde llega
LTX-2 19B no filtra nada en el prompt ni en el resultado. En nuestra escala de siete sondas (L1 Sugerente, lencería o un tirante que se desliza; L2 Temas maduros; L3 Fuerte; L4 Intenso, una escena íntima entre dos adultos; L5 Extremo, ataduras consentidas entre adultos o gore cinematográfico), texto a video entregó L1, L2, L3 y la sonda de ataduras tal como se escribieron, y atenuó L4, la sonda de gore y la sonda con un hombre en cuadro. Imagen a video entregó L1 y L3 y atenuó el resto. Nada fue rechazado. Los resultados completos están en la reseña de LTX-2 19B; los movimientos de cámara y los archivos LoRA están en nuestra guía de LTX-2 19B LoRA. La escala no tenía indicaciones específicas de sonido, y no imprimimos los prompts de las sondas.
Límites
- La sonoridad es impredecible. Normaliza cada clip antes de unirlos.
- Pueden aparecer subtítulos, con o sin una frase "no subtitles". Revisa el primer y el último segundo de cada toma que conserves.
- Las indicaciones temporizadas se desvían o desaparecen. Ata los sonidos a acciones en el cuadro.
- Sin interruptor de audio, sin entrada de audio.
- Las voces pueden apoderarse del sonido. En nuestro clip de la frase hablada faltaba la lluvia que pedimos.
- La anchura estéreo varía. Algunos clips son en la práctica mono.
- La imagen queda por detrás de los modelos más caros. Puntaje en la prueba a ciegas 47.5.
- Medimos el sonido; no lo juzgamos. Las voces y la música son para tus oídos.
Preguntas frecuentes
¿LTX-2 19B genera audio?
Sí. Cada clip tiene una pista AAC estéreo a 24 kHz hecha en la misma pasada que la imagen, incluidos los clips cuyo prompt nunca menciona el sonido.
¿Cómo escribo un prompt para LTX-2 con sonido?
Describe la toma en cuatro a ocho frases y termina con una frase que empiece con "Audio:" y nombre cada sonido por su fuente, en el orden en que ocurre. Pon las palabras habladas entre comillas y mantenlas cortas.
¿Qué generadores de video con IA producen sonido y cuáles no tienen censura?
En SpicyAPI, LTX-2 19B siempre lo hace, y Wan 3.0, Seedance 2.0 Fast y MiniMax H3 también generan sonido con el clip. Los cuatro tienen un puntaje Freedom en nuestro índice (de 70.7 a 96); se diferencian en precio, calidad de imagen y hasta dónde llegan.
¿Puede la IA hacer un video a partir de un archivo de audio?
No por esta ruta: LTX-2 19B toma un prompt o una foto. Para que un rostro diga una frase que ya tienes, aplica sincronización labial a un clip terminado, como en nuestra guía de voz y música.
¿Cuánto puede durar un clip con sonido?
De 5 a 20 segundos enteros a 480p, 720p o 1080p. Nuestro clip de 20 segundos tuvo sonido durante la totalidad de su duración, y un clip de 20 segundos a 480p cuesta $0.288.
¿Puedo apagar el sonido?
No. Baja el audio del clip en el editor de video o quita la pista después de descargarlo.
¿Por qué mi video con IA tiene subtítulos aleatorios?
El modelo a veces graba texto inventado en el cuadro, y escribir "no subtitles" no lo evitó en nuestras pruebas. Cambia el seed, recorta el segundo afectado y deja fuera del prompt las palabras sobre subtítulos.