짧은 성인 대상 클립이 이미 소리를 갖고 있기를 바라실 겁니다. 창문을 두드리는 빗소리, 커플 뒤의 군중, 카메라에 대고 부드럽게 건네는 한마디. 그런데 많은 무검열 영상 모델은 여전히 무음 파일을 건네고 소리는 두 번째 도구에 맡깁니다.
LTX-2 19B는 콘텐츠 필터 없이, 영상 초당 $0.0144부터, 한 번의 요청으로 영상과 스테레오 사운드트랙을 함께 만듭니다. 2026년 10월 5일과 6일에 생성한 55개 클립은 모두 24 kHz AAC 스테레오 트랙을 갖고 있었고 그 길이가 영상 전체와 같았으며, 소리는 동작을 따라 움직였습니다. 클립 중간에 프로펠러가 돌기 시작하면 그때까지 트랙은 거의 무음이었습니다. 얻지 못하는 것은 일관성입니다. 같은 프롬프트의 seed 사이에서 음량이 30 LU 넘게 흔들렸고, 통제된 클립 15개 중 5개는 화면에 지어낸 자막이 박혀 나왔습니다.
저희는 여러분처럼 들을 수 없으므로 이 글의 모든 오디오 관련 주장은 측정값입니다. 시간에 따른 음량, 스테레오 폭, 길이입니다. 목소리나 멜로디가 얼마나 좋은지는 채점하지 않았습니다. 삽입된 클립은 소리와 함께 재생되므로 그 부분은 직접 판단하십시오. 모델은 LTX-2 19B 계열 페이지와 LTX-2 19B LoRA 계열 페이지에 있으며, 여기에 실린 프롬프트는 모두 옷을 입은 성인이 나오는 장면입니다.
한눈에 보기
| 자체 사운드트랙이 있는 LTX-2 19B | |
|---|---|
| 엔드포인트 | 텍스트 투 비디오와 이미지 투 비디오; LoRA 빌드는 LoRA 파일을 최대 세 개 추가 |
| 소리 | 모든 클립에 24 kHz AAC 스테레오, 끄는 스위치 없음 |
| 길이 | 5~20초의 정수 초; 55개 클립에서 소리와 영상의 길이가 0.0004초 이내로 일치 |
| 해상도 | 480p (832 x 448), 720p (1280 x 704), 1080p (1920 x 1024); 9:16은 가로세로가 바뀜; 이미지 투 비디오는 사진을 따름 |
| 가격, 실시간 카탈로그 | 초당 $0.0144, $0.0192 또는 $0.0288; LoRA 빌드는 $0.018, $0.024 또는 $0.036; 소리 포함 |
| 소리 제어 | "Audio:"로 시작하는 마무리 문장 |
| 측정한 음량 | −42.1~−8.3 LUFS, 중앙값 −13.2; −1.6 dBTP를 넘은 클립 없음 |
| 어긋나는 것 | seed 사이의 음량 변동, 지어낸 자막, 늦게 오거나 오지 않는 타이밍 큐 |
| 콘텐츠 | 콘텐츠 필터 없음; 텍스트 투 비디오는 사다리 프로브 7개 중 4개, 이미지 투 비디오는 7개 중 2개 구현, 거부 없음 |
사운드트랙이 만들어지는 방식
Lightricks는 LTX-2를 동기화된 영상과 오디오를 생성하는 하나의 모델로 설명합니다. 실제로는 이렇습니다.
- 요청 하나, 파일 하나. 별도의 오디오 작업도 싱크 맞추기 단계도 없습니다. 5초 720p 클립은 소리를 포함해 $0.096입니다.
- 입력은 텍스트나 사진이며, 오디오는 아닙니다. 맞춰 달라고 음성 파일을 줄 수는 없습니다.
- 소리를 끌 수 없습니다. 무음 클립이 필요하면 Studio 비디오 에디터에서 클립의 오디오를 낮추거나 다운로드 후 트랙을 제거하십시오.
제공처는 프롬프트를 따르는 정도가 쓰는 방식에 크게 좌우되며, 음성이 없는 오디오는 품질이 낮게 나올 수 있다고도 경고합니다.
Audio 줄을 쓰십시오
모델은 영상과 소리를 같은 프롬프트에서 읽습니다. 저희에게 통한 방식은 제공처의 LTX-2 프롬프트 가이드(한 문단에 네 문장에서 여덟 문장)를 따르고, "Audio:"로 시작하는 문장 하나로 끝내면서 각 소리를 그 출처로 지명하는 것입니다. 게시된 예시, 밤에 입항하는 페리입니다.
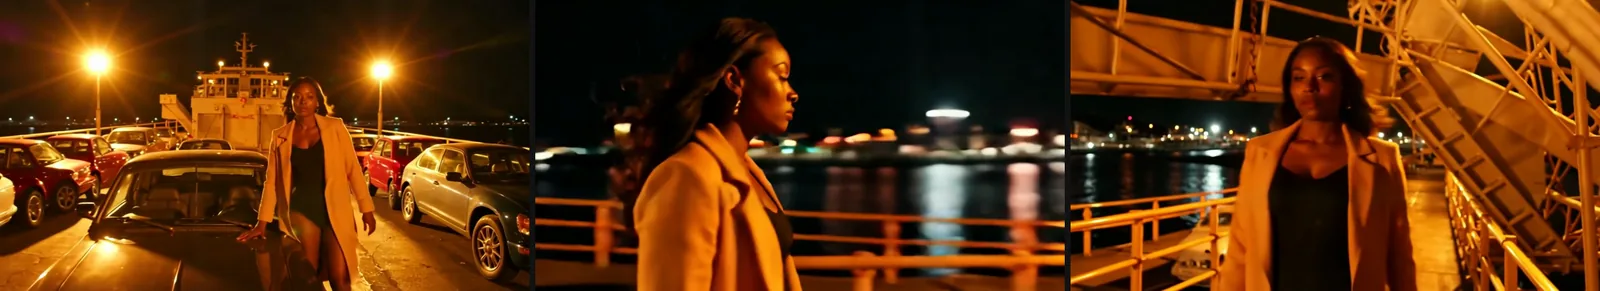
LTX-2 19B, 텍스트 투 비디오, 16:9, 720p, 6초, seed 510512. 사운드트랙은 매 0.5초마다 −12.7~−10.5 dBFS 사이에 머물렀습니다.
The car deck of a night ferry as it docks. Sodium-vapour lamps turn everything orange and rows of parked cars glint. An adult Black woman in her early thirties in a long camel coat worn open over a fitted black bodysuit leans on the bonnet of a vintage car, her hair whipped by wind from the opening bow. The huge steel ramp lowers with a groan and slams onto the quay, showing the harbour lights beyond; she pushes off the car and walks toward the light, glancing back at the camera. Low-angle wide shot, slow dolly forward, sodium orange against black water, anamorphic flares. Audio: the deep thrum of the engines, chains rattling, the ramp groaning down and landing with a heavy metallic boom that echoes through the hold, then the ship horn.제공처 가이드와 저희 실행에서 얻은 다섯 가지 습관입니다.
- 소리를 내는 것의 이름을 쓰십시오. "Chains rattling"은 프레임 속의 무언가를 가리키지만, "atmospheric audio"는 출처가 전혀 없습니다.
- 소리는 일어나는 순서대로 나열하십시오. 모델 페이지의 야간열차 예시는 바퀴 소리, 바람, 올라갔다 사라지는 건널목 종, 멀리 앞쪽의 경적 순서입니다.
- 분위기는 의상과 표정이, 공간은 소리가 맡게 하십시오. 흘러내리는 어깨끈, 느린 미소, 유리창의 빗소리, 레코드에서 나오는 색소폰이면 암시적인 장면에 충분합니다.
- 소리를 묘사하는 대신 짧은 대사를 말하게 하십시오. 말을 따옴표에 넣고 어떻게 말하는지("says softly")를 쓰십시오. LTX-2에 관한 한 커뮤니티 스레드는 음성 소리 큐가 이상한 웃음으로 나온다고 보고했습니다. 저희는 그것을 테스트하지 않았고, 짧은 대사가 더 예측 가능합니다.
- 이미지 투 비디오에서는 사진 속에 있는 것에 소리를 주십시오. 사진이 인물과 장소를 정하니, 다음에 일어날 일과 그 소리를 서술하십시오. 다른 방을 서술하는 프롬프트는 클립이 사진에서 벗어나 화면이 전환되게 만들 수 있습니다.
| 큐 유형 | 저희가 쓴 표현 | 측정이 보여 준 것 |
|---|---|---|
| 일정한 바탕음 | "the deep thrum of the engines, chains rattling" | 클립 전체에서 일정한 레벨 |
| 샷 안의 한 사건 | "the engine coughing and catching into a roar" | 거의 무음이다가 프로펠러가 돌자 굉음 (seed 2개 중 2개) |
| 신호에 맞춰 시작하는 음악 | "near silence at first … then … a slow, smoky saxophone ballad starts" | 한 seed는 6초 중 5.0초에 점프, 다른 seed는 변화 없음 |
| 따옴표 안의 대사 | says softly, "Stay. The rain isn't stopping tonight." | 큰 소리 두 번, 그 사이는 거의 무음 |
| 음악이 있는 군중 | "a string quartet playing a slow waltz, the murmur of a crowd" | 일정한 레벨; seed 2개 중 하나에 자막이 박힘 |
| 희미하고 먼 소리 | "a faint dance band drifting from a villa along the coast" | 같은 줄, seed 4개: −10.9~−42.1 LUFS |
사운드트랙 55개가 보여 준 것
10월 5일 예시 실행의 클립 40개(두 엔드포인트, 기본 모델과 LoRA 빌드)와 10월 6일에 기본 텍스트 투 비디오로 돌린 통제 클립 15개를 측정했습니다. 형식과 길이는 ffprobe로, 통합 음량과 트루 피크는 ffmpeg의 EBU R128 미터로, 아래 곡선은 0.1초 조각마다의 레벨로, 스테레오 폭은 두 채널을 비교해서 얻었습니다.
소리는 항상 있고, 영상과 같은 길이입니다
55개 클립 모두 24 kHz AAC 스테레오 트랙이 있었으며, 프롬프트에 소리를 언급하지 않은 두 개도 포함됩니다. 5초 요청은 영상과 소리 모두 5.042초, 6초 요청은 6.042초, 20초 요청은 20.042초로 돌아왔습니다. 영상보다 먼저 끝난 트랙은 없었습니다.
소리는 동작을 따릅니다
비 오는 날 조종사가 프로펠러 비행기에 올라탑니다. 프롬프트는 시동 모터의 윙 소리, 엔진이 걸리는 소리, 프로펠러 바람을 요청했습니다.
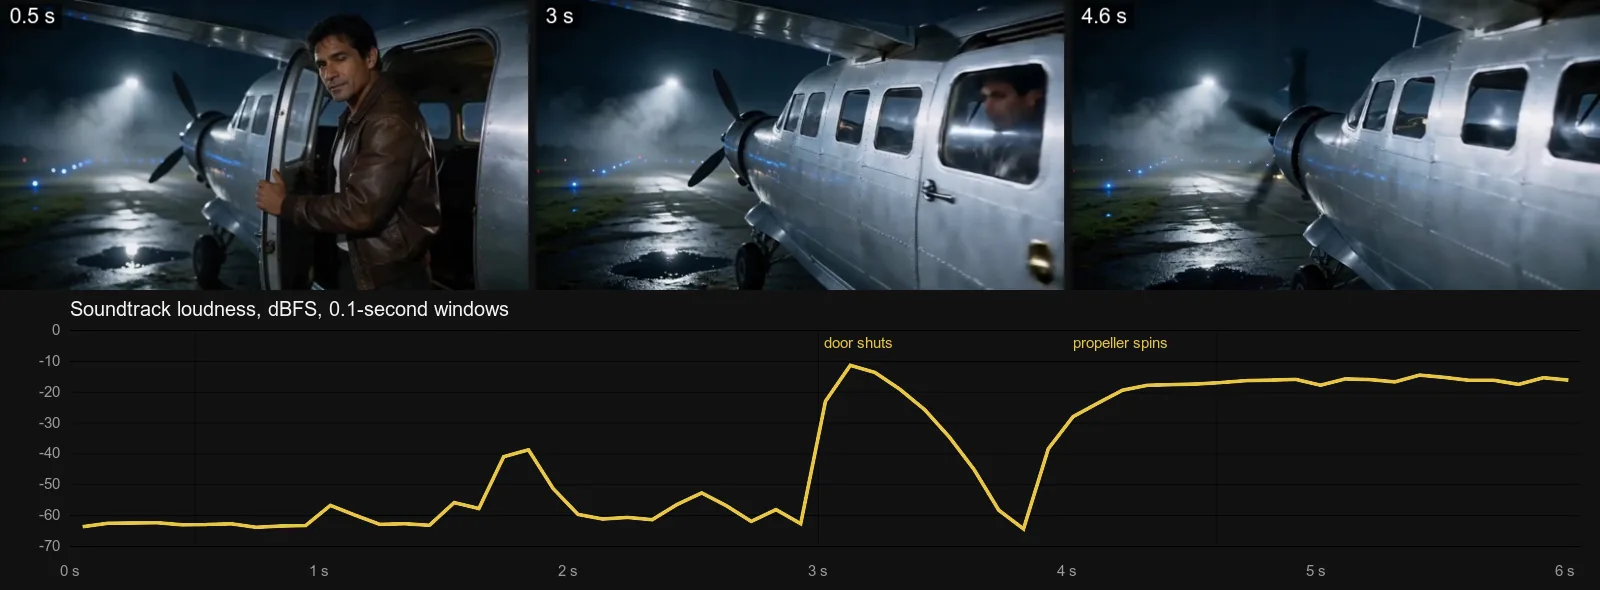
이미지 투 비디오, 720p, 6초, seed 510515. 3초 동안 −60 dBFS 부근, 문이 닫히며 점프, 프로펠러가 돌자 약 −16 dBFS. 두 번째 seed도 3초간 무음이다가 크고 일정한 레벨을 유지했습니다.
영상: LTX-2 19B 이미지 투 비디오, 720p, 6초, 위에서 측정한 프로펠러 비행기 클립과 생성된 사운드트랙
영상과 함께 소리를 생성하는 가장 큰 이유가 이것입니다. 큰 소리가 화면이 바뀌는 곳에 떨어집니다.
타이밍 큐는 요청이지 큐 시트가 아닙니다
먼저 정적, 나중에 음악을 요청하는 것은 덜 믿을 만합니다. 이 로프트 프롬프트는 거의 무음으로 시작해 바늘이 내려앉고 색소폰 발라드가 나오라고 요청했습니다.
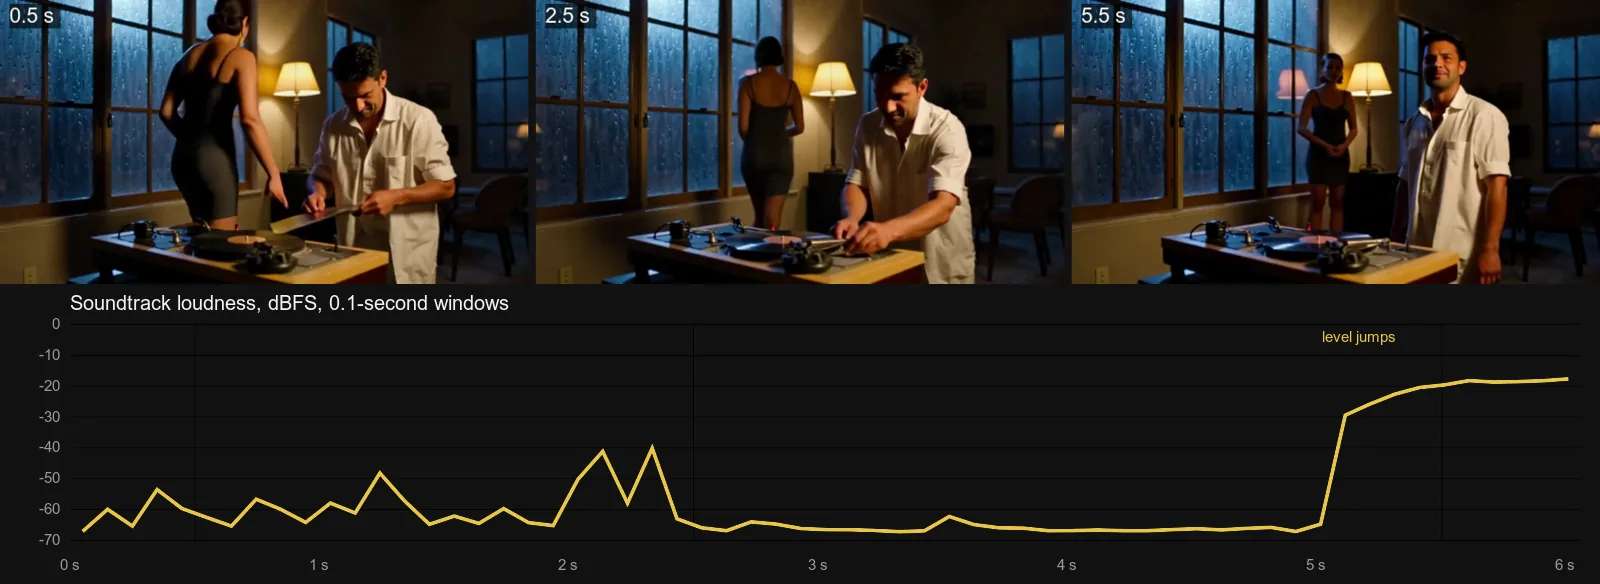
텍스트 투 비디오, 480p, 6초, seed 610611. 6초 중 5.0초에 레벨이 점프합니다.
두 번째 seed는 6초 내내 약 −45 dBFS에 머물렀고 전혀 변하지 않았습니다. 소리가 어느 프레임에 떨어져야 한다면 프로펠러 프롬프트처럼 그 소리를 내는 동작을 서술하십시오. 정확해야 한다면 나중에 더하십시오.
음량은 seed마다 크게 바뀝니다
클립을 이어 붙일 때 가장 중요한 점입니다. 달빛 비치는 테라스 장면을 같은 Audio 줄로 네 번 돌렸습니다.
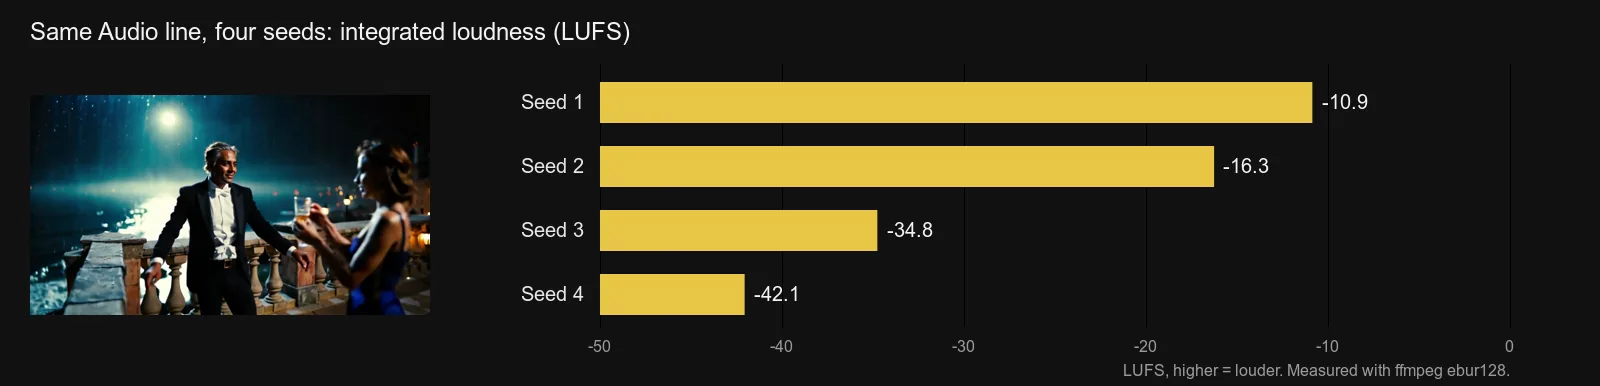
Dolly Out 카메라 LoRA를 쓴 LTX-2 19B LoRA, 텍스트 투 비디오, 720p, 5초, seed 네 개. Audio 줄은 동일했고, 마지막 두 프롬프트는 두 사람의 의상도 더 자세히 서술했습니다.
55개 클립 전체에서 통합 음량은 −42.1~−8.3 LUFS, 중앙값은 −13.2였습니다. 35개가 중앙값에서 3 LU 이내였고 7개는 −20보다 조용했습니다. −1.6 dBTP를 넘은 클립은 없으므로 클리핑되어 돌아온 것은 없습니다. 이 차이를 표현만으로 정할 수는 없습니다. 가장 큰 테라스 실행과 가장 조용한 테라스 실행은 Audio 줄이 한 글자도 다르지 않았습니다.
그러니 클립을 잇기 전에 Studio 에디터나 음량 노멀라이저로 음량을 맞추십시오. 예시 클립 40개 중 6개는 가장 큰 순간보다 최소 15 dB 낮은 상태로 끝났는데, 모두 카메라 LoRA를 적용한 실행이었으므로 자르기 전에 끝부분을 확인하십시오.
"스테레오"가 사실상 모노일 때도 있습니다
모든 파일에 채널이 두 개 있지만, 55개 중 14개에서는 두 채널이 사실상 동일했고(상관 0.99 이상), 13개에서는 뚜렷이 달랐습니다(0.6 미만). 대사 한 줄을 중심으로 만든 클립 네 개는 모두 사실상 모노였습니다. 폭이 중요하다면 헤드폰으로 확인하십시오.
Audio 줄을 빼도 소리는 나옵니다
가면무도회 장면을 Audio 줄(현악 사중주, 군중, 잔 부딪히는 소리, 그녀의 웃음)을 넣어 두 번, 빼고 두 번, 같은 seed로 돌렸습니다.
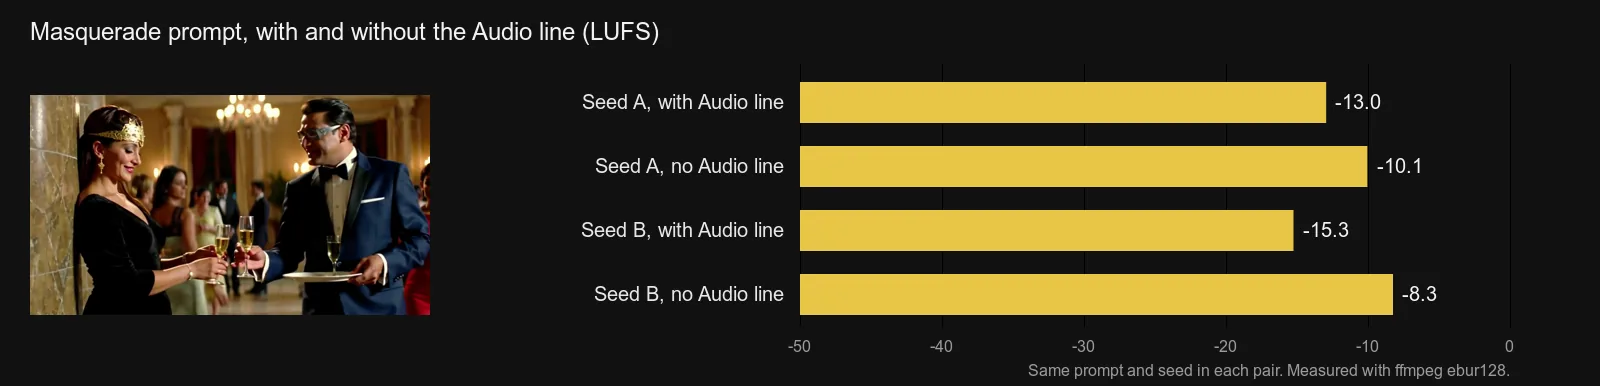
텍스트 투 비디오, 720p, 5초, seed 610601과 610602. Audio 줄이 없는 두 클립이 더 컸습니다.
줄이 없어도 트랙은 나옵니다. 다만 거기에 무엇이 담길지 고를 수 없을 뿐입니다. 소리가 요점이 아니더라도 Audio 줄은 유지하십시오.
20초도 유지되었습니다
긴 클립은 별도의 소리 작업이 번거로워지는 곳이므로, 480p로 20초 클립을 하나 돌렸습니다.
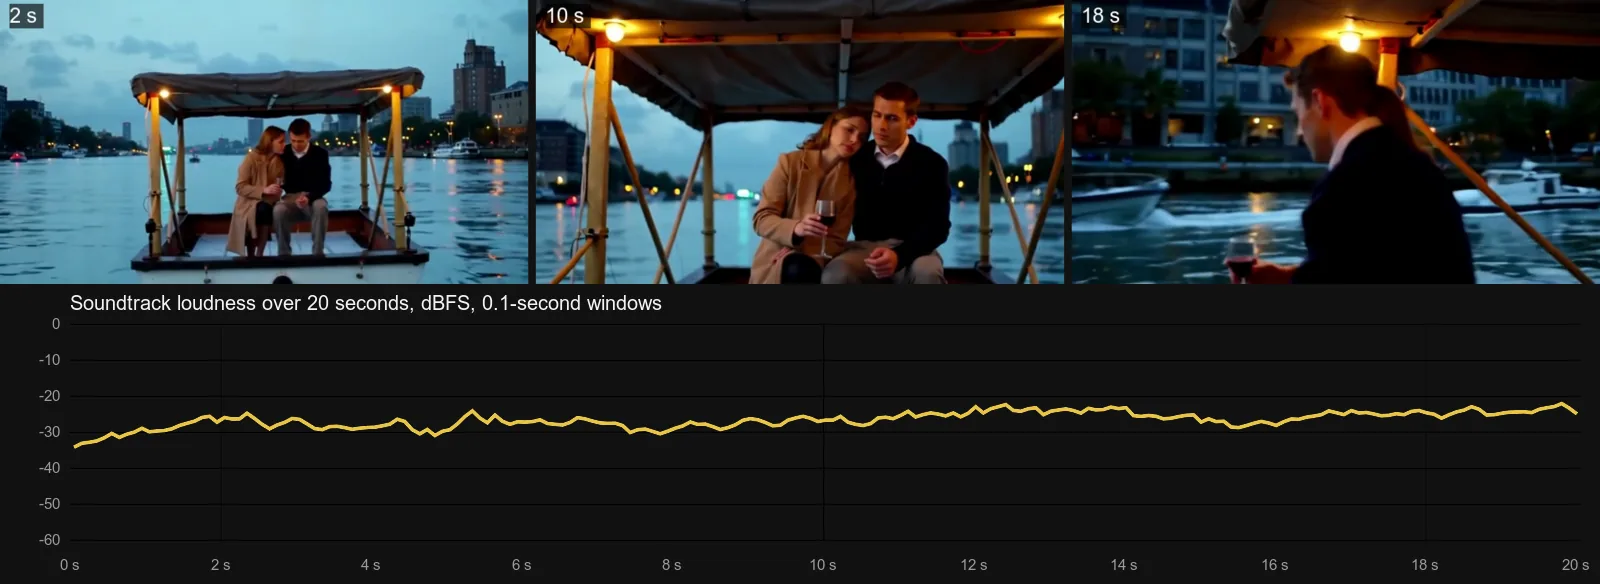
텍스트 투 비디오, 16:9, 480p, 20초, seed 610631. 소리는 매 0.5초마다 −32.6~−22.9 dBFS 사이에 머물렀습니다.
영상: LTX-2 19B 텍스트 투 비디오, 480p, 20초, 위에서 측정한 하우스보트 클립
소리는 20초 내내 유지되었습니다. 대신 영상이 어긋났습니다. 느린 푸시인이 계속되어 그녀가 대부분 그의 뒤에 가려졌습니다. 이 클립은 $0.288였습니다. 저희가 돌린 그대로의 프롬프트입니다. 이제 권장하지 않는 "no on-screen text" 문구(다음 섹션 참고)만 뺐습니다.
A houseboat on a river at dusk in light rain. An adult couple in their forties, a woman in a long camel coat and a man in a navy wool sweater, sit close under the canvas awning at the stern sharing a blanket, watching the city lights come on along the bank. He refills her glass of red wine; she leans her head on his shoulder; later a tour boat glides past and its wake rocks them gently. Wide shot, slow push-in, blue dusk with warm string lights, film grain. Audio: rain pattering on the canvas, water lapping against the hull, a distant radio playing old jazz, the low rumble of the passing boat and its wake slapping the side.이 프롬프트를 LTX-2 19B 텍스트 투 비디오에서 실행 →
대사, 그리고 아무도 요청하지 않은 자막
짧은 대사 한 줄은 암시적인 클립을 개인적으로 느끼게 합니다. 크림색 실크 가운 차림의 여성에게 카메라를 올려다보며 부드럽게 "Stay. The rain isn't stopping tonight."라고 말하게 했습니다.
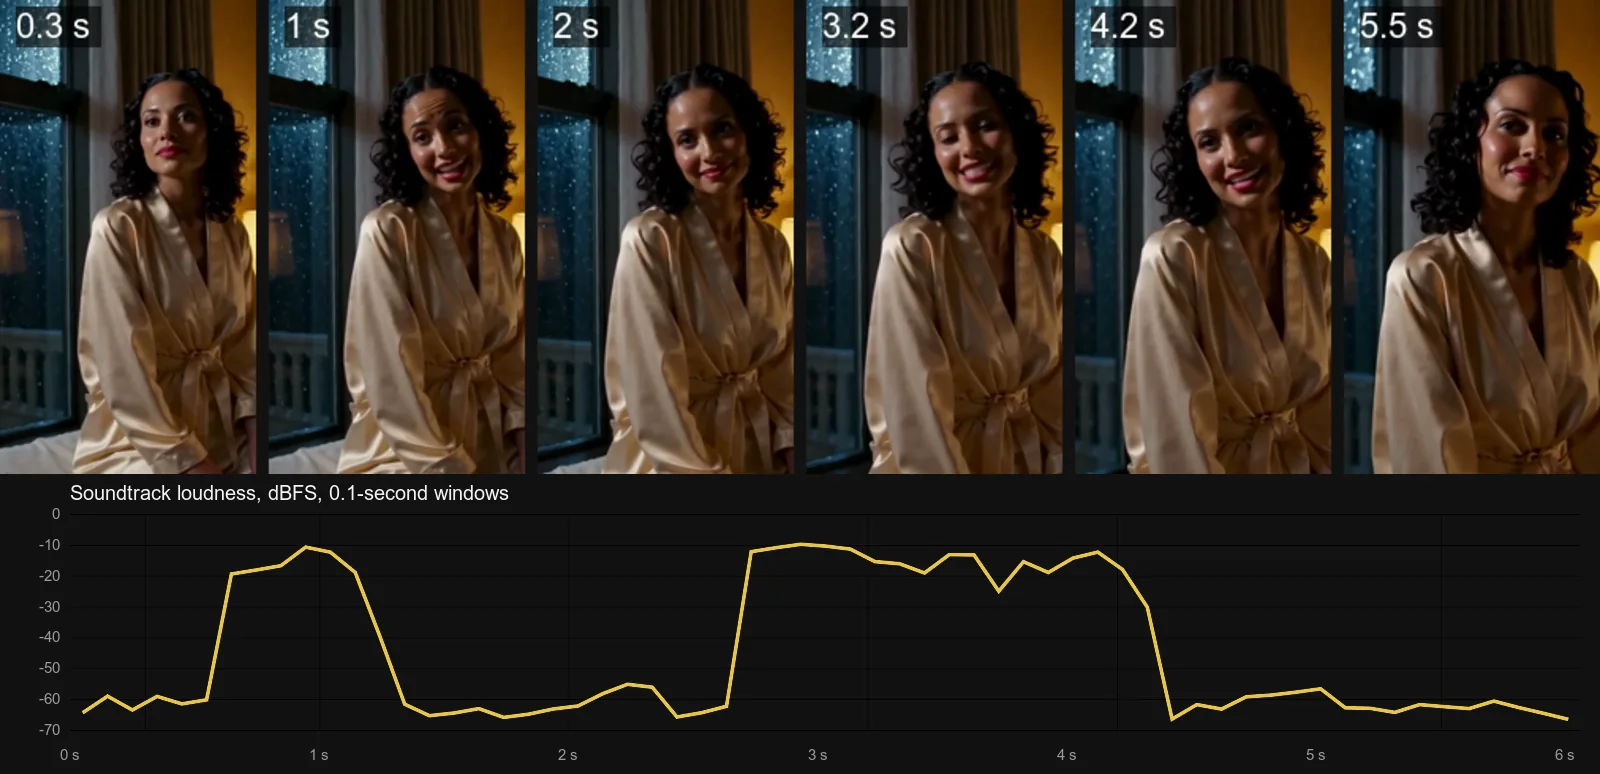
텍스트 투 비디오, 9:16, 480p, 6초, seed 610622, 프롬프트에 자막 관련 단어 없음.
영상: LTX-2 19B 텍스트 투 비디오, 9:16, 480p, 6초, 위에서 측정한 대사 클립; 말이 맞는지 직접 들어 보십시오
큰 구간 두 곳은 두 번에 나눠 말한 대사와 맞지만, 단어는 확인하지 않았으므로 의지하기 전에 직접 들어 보십시오. 곡선이 분명히 보여 주는 것은 요청했던 "유리창에 내리는 일정한 빗소리"가 바탕에 깔려 있지 않았다는 점입니다. 큰 구간 사이와 이후에 레벨이 약 −60 dBFS로 떨어졌습니다. 목소리가 있으면 트랙을 장악할 수 있습니다.
더 큰 놀라움은 화면 속 글자였습니다. 통제 클립 15개 중 5개에 지어낸 글자가 박혀 있었습니다.
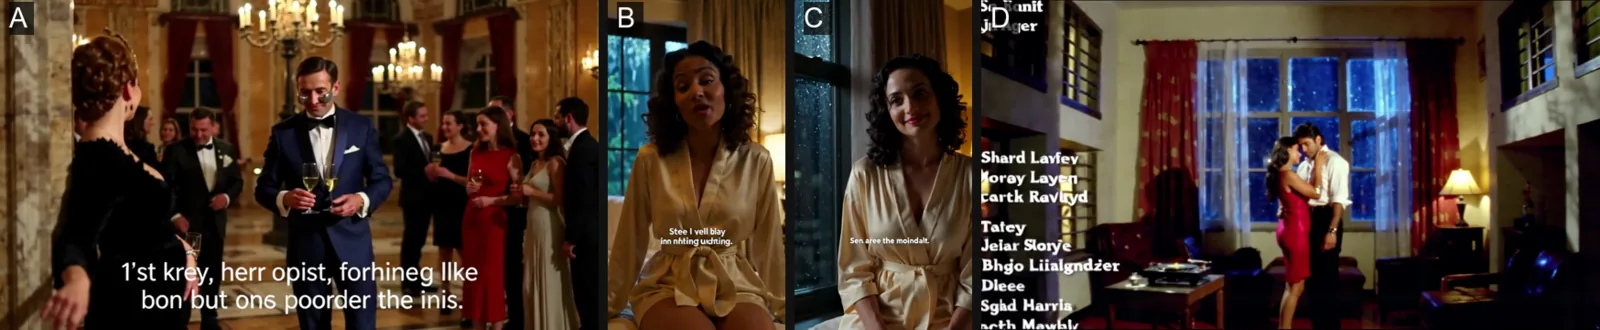
A: Audio 줄이 있는 가면무도회 프롬프트, seed 610601, 처음 0.8초만. B와 C: "no subtitles, no captions, no on-screen text"를 추가한 대사 프롬프트, 두 seed 모두. D: 레코드에 맞춰 춤추는 커플의 1080p 프롬프트; 두 번째 seed에서는 따라 부르는 가사가 나왔습니다.
프롬프트 15개 중 11개가 "no subtitles"나 "no on-screen text"로 끝났고, 자막이 박힌 클립 다섯 개가 모두 그 안에 있었습니다. 그런 문구가 없는 네 개의 프롬프트는 깨끗하게 나왔습니다. 같은 대사 프롬프트를 같은 두 seed로 돌렸을 때 문구가 없으면 깨끗했고 있으면 자막이 박혔습니다. 열하나 중 여섯 개도 깨끗했고, 이전 배치에서는 "no subtitles"를 넣은 가로 클립 두 개가 깨끗하게 나왔으니, 이 작은 표본에서는 그 문구가 아무것도 막지 못했고 오히려 글자를 유발했을 수도 있습니다. 글자는 항상 의미 없는 횡설수설이며, LTX-2가 읽을 수 있는 글자를 렌더링하지 않는다는 제공처의 설명과 맞습니다.
- 프롬프트에 자막 관련 단어를 넣지 마십시오. 저희 실행에서는 아무것도 막지 못했습니다.
- 첫 1초와 마지막 1초를 확인하십시오. 클립 A에서는 글자가 0.8초 동안 있었고, 앞부분을 잘라 내자 해결되었습니다.
- seed를 바꾸십시오. 가면무도회 프롬프트의 두 번째 seed는 깨끗했습니다.
- 노래를 중심으로 만든 프롬프트는 두 번 보십시오. 레코드에 맞춰 춤추는 커플의 1080p 클립 두 개 모두 크레딧이나 가사가 박혀 나왔습니다.
내장 사운드, 아니면 무음 모델 + 소리 후작업?
다른 길은 무음 클립에 효과음, 음성, 음악을 나중에 더하는 것으로, NSFW AI 영상에 음성과 음악 추가하기와 Foley 효과음 워크플로 가이드에서 다룹니다. 5초 클립 하나 기준, 실시간 카탈로그 가격과 저희 지수 점수입니다.
| 경로 | 소리 | 5초 클립 | Freedom 점수 | 블라인드 테스트 점수 |
|---|---|---|---|---|
| LTX-2 19B, 720p | 항상 켜짐, 스테레오 | $0.096 | 76.1 | 47.5 |
| MiniMax H3, 768p | 클립과 함께 생성 | $0.185 | 70.7 | 67.6 |
| Wan 3.0, 720p | 기본 켜짐, 끌 수 있음 | $0.45 | 96 | 70.9 |
| Seedance 2.0 Fast, 720p | 기본 켜짐; 꺼도 요금은 내려가지 않음 | $0.48 | 72.2 | 68.6 |
| HunyuanVideo 1.5, 720p, 이후 Foley v1 | 무음 클립, 효과음은 나중에 추가 | $0.24 + $0.006 | 88.1 | 57.7 |
Freedom은 모델이 성인 콘텐츠 사다리를 얼마나 구현하는지를 나타내는 저희의 0~100점 점수이고, 블라인드 테스트는 모델 이름을 가린 채 화질을 채점합니다. 둘 다 2026년 10월 5일 기준 저희 실시간 지수에서 가져왔으며, 두 단계 경로의 점수는 HunyuanVideo의 것입니다.
- LTX-2 19B를 고르십시오. 소리가 있는 저렴한 초안을 많이 만들 때입니다. 표에서 가장 저렴한 경로이며, 저희 실행에서 5초 720p 클립이 14~25초 걸렸습니다. 대가는 화면입니다. 블라인드 테스트 점수가 다섯 개 중 가장 낮습니다.
- Wan 3.0을 고르십시오. 가격보다 화질과 성인 콘텐츠의 범위가 중요할 때입니다. 초당 몇 배 비싸지만 그래도 소리가 나옵니다.
- 소리를 나중에 더하십시오. 특정 대사를 말해야 하거나 이미 마음에 드는 무음 클립이 있을 때입니다. Foley 효과음은 초당 $0.0012입니다.
내장 경로의 구조적 한계는 소리가 렌더링에 구워져 있어서 단어 하나가 틀리면 영상을 다시 결제해야 한다는 점입니다.
어디까지 가는가
LTX-2 19B는 프롬프트도 결과도 필터링하지 않습니다. 저희 7개 프로브 사다리(L1 암시, 란제리 또는 흘러내리는 어깨끈; L2 성숙한 주제; L3 강함; L4 고강도, 성인 두 사람 사이의 친밀한 장면; L5 극한, 성인 간 합의된 결박 또는 영화적인 고어)에서 텍스트 투 비디오는 L1, L2, L3, 결박 프로브를 적은 그대로 구현했고, L4, 고어 프로브, 남성이 프레임에 있는 프로브는 약화했습니다. 이미지 투 비디오는 L1과 L3를 구현하고 나머지를 약화했습니다. 거부된 것은 없습니다. 전체 결과는 LTX-2 19B 리뷰에, 카메라 무브와 LoRA 파일은 LTX-2 19B LoRA 가이드에 있습니다. 사다리에는 소리 전용 큐가 없었고, 프로브 프롬프트는 싣지 않습니다.
한계
- 음량을 예측할 수 없습니다. 이어 붙이기 전에 모든 클립을 노멀라이즈하십시오.
- 자막이 나타날 수 있으며, "no subtitles" 문구가 있어도 마찬가지입니다. 남길 클립은 모두 첫 1초와 마지막 1초를 확인하십시오.
- 타이밍 큐는 어긋나거나 사라집니다. 소리를 프레임 속 동작에 묶으십시오.
- 오디오 스위치도, 오디오 입력도 없습니다.
- 목소리가 트랙을 장악할 수 있습니다. 대사 클립에서는 요청한 빗소리가 빠졌습니다.
- 스테레오 폭은 제각각입니다. 일부 클립은 사실상 모노입니다.
- 화면은 더 비싼 모델에 뒤처집니다. 블라인드 테스트 점수 47.5.
- 소리는 측정했을 뿐 평가하지는 않았습니다. 목소리와 음악은 여러분의 귀가 판단할 몫입니다.
FAQ
LTX-2 19B는 오디오를 생성하나요?
네. 모든 클립에는 영상과 같은 패스에서 만들어진 24 kHz AAC 스테레오 트랙이 있으며, 프롬프트에 소리를 언급하지 않은 클립도 마찬가지입니다.
소리가 있는 LTX-2 프롬프트는 어떻게 쓰나요?
샷을 네 문장에서 여덟 문장으로 서술한 뒤, "Audio:"로 시작하는 문장 하나로 끝내면서 각 소리를 출처로 지명하고 일어나는 순서대로 쓰십시오. 말하는 내용은 따옴표 안에 짧게 넣으십시오.
소리를 만드는 AI 영상 생성기는 어디이고, 어느 것이 무검열인가요?
SpicyAPI에서는 LTX-2 19B가 항상 소리를 만들고, Wan 3.0, Seedance 2.0 Fast, MiniMax H3도 클립과 함께 소리를 생성합니다. 넷 모두 저희 지수에 Freedom 점수(70.7~96)가 있으며, 가격, 화질, 어디까지 가는지가 다릅니다.
AI가 오디오 파일로 영상을 만들 수 있나요?
이 경로로는 안 됩니다. LTX-2 19B는 프롬프트나 사진을 받습니다. 이미 가진 대사를 얼굴이 말하게 하려면 음성과 음악 가이드처럼 완성된 클립에 립싱크를 돌리십시오.
소리가 있는 클립은 얼마나 길 수 있나요?
480p, 720p, 1080p에서 5~20초의 정수 초입니다. 저희 20초 클립은 처음부터 끝까지 소리가 있었고, 20초 480p 클립은 $0.288입니다.
소리를 끌 수 있나요?
아니요. 비디오 에디터에서 클립의 오디오를 낮추거나 다운로드 후 트랙을 제거하십시오.
제 AI 영상에 왜 이상한 자막이 나오나요?
모델이 가끔 지어낸 글자를 프레임에 박아 넣으며, 저희 실행에서는 "no subtitles"라고 써도 막지 못했습니다. seed를 바꾸고, 영향받은 1초를 잘라 내고, 프롬프트에 자막 관련 단어를 넣지 마십시오.