繰り返し登場する成人キャラクターなら、顔、衣装、冒頭のショットが承認された段階で画像から動画を始めましょう。キャラクターの配役やシーンをまだ探っているなら、テキストから動画を始めましょう。 画像は具体的な冒頭を与えますが、文章のプロンプトではモデルが冒頭を考えます。どちらの入力でも、動き始めた後の顔の安定は保証されません。
以下ではMiniMax H3を使って比較します。SpicyAPIでは両タスクの1秒あたりの料金が同じなので、選択の基準は一方の割引ではなく、手元に何があり、何を直す必要があるかです。プロンプト例では、衣服をすべて着用した架空の成人を使います。
同じファミリー、異なる2つの入力
| MiniMax H3の現在の仕様 | テキストから動画 | 画像から動画 |
|---|---|---|
| 必須入力 | prompt | promptとimage_url |
| 長さ | 5–15秒の整数 | 4–15秒の整数。2kでは最低5秒 |
| 解像度 | 768p, 2k | 768p, 2k |
| フレームの形 | aspect_ratio: 16:9, 9:16, 1:1, 4:3, 3:4, 21:9 | 冒頭画像で決まります。アスペクト比の項目はありません |
| 任意の終了画像 | 提供されていません | last_image_url |
| シード | 提供されていません | 提供されていません |
各タスクの詳細はテキストから動画と画像から動画のページにあります。
どちらのタスクも動画とともに音を生成します。雨音と室内の環境音だけでも、音をプロンプトに書いてください。画像だけでは、その場面にどんな音を合わせるか伝えられません。
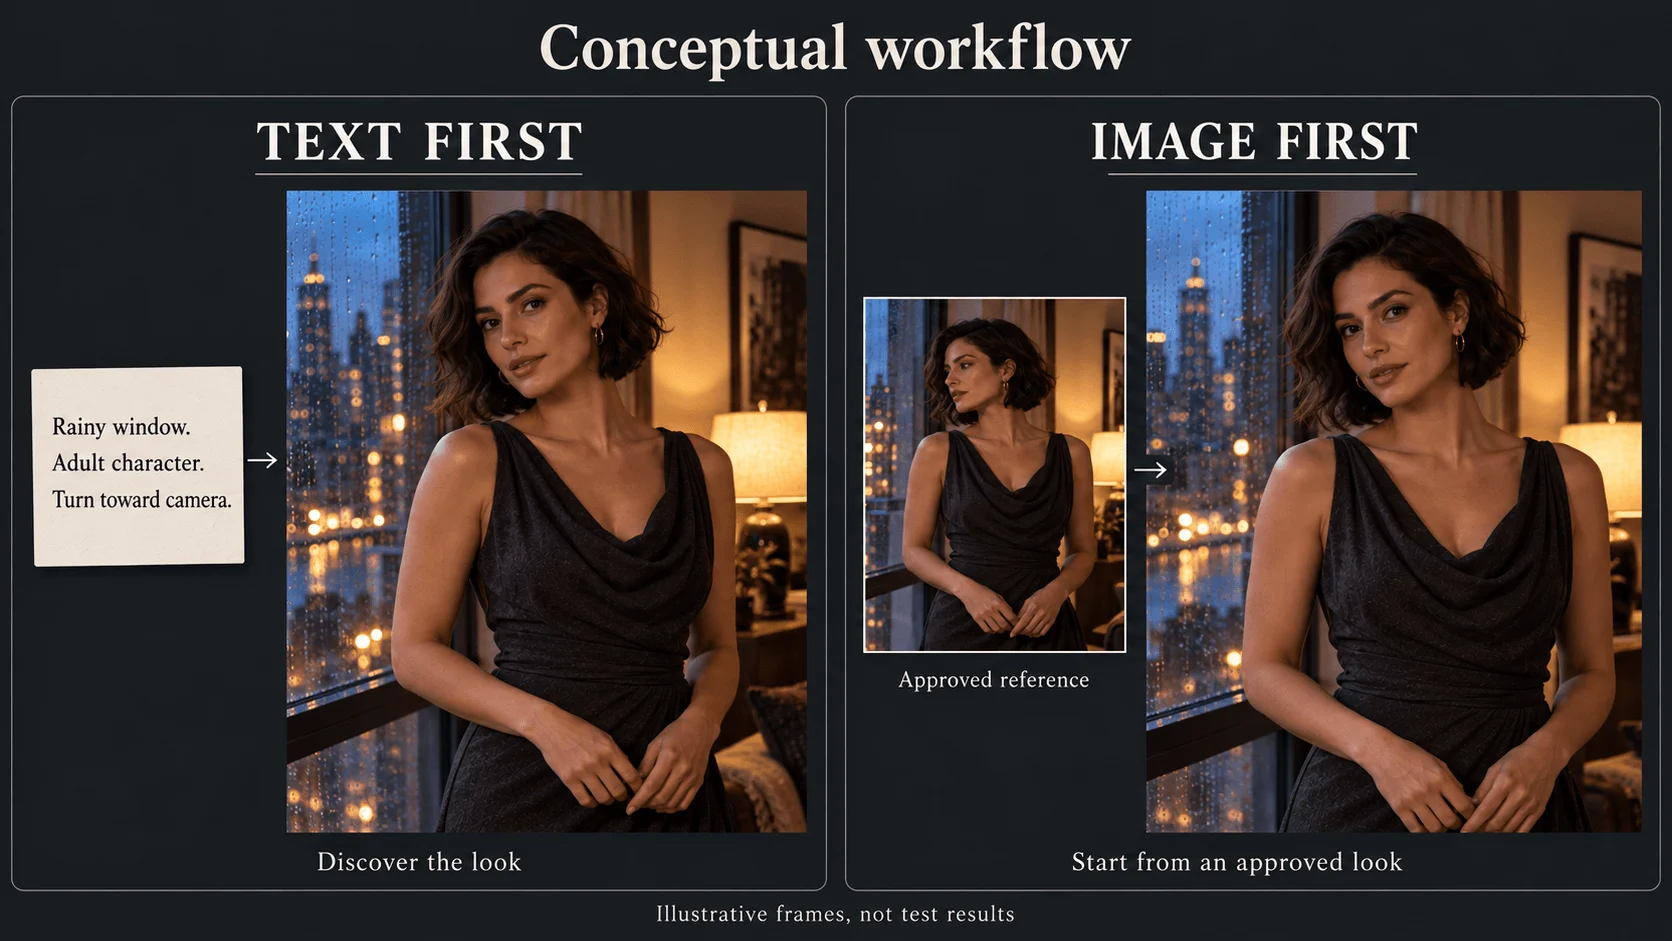
文章から始めると外見を探れます。画像から始めると承認済みの外見を冒頭に使えます。これは説明用のイラストで、MiniMaxの生成結果ではありません。
NSFW制作者にとっての意味
2026年9月の当社テストでは、両H3タスクとも、確認した最も強い段階まで成人向けリクエストを受け付けました。テキストから動画は書面の説明から、画像から動画はAI生成の開始画像から実行しました。どちらも制限なしとして掲載されているため、経路で変わるのは許容範囲ではなく、制御できる範囲です。
受け付けられるかどうかと、同じ人物に見えるかどうかは別の問題です。題材が受け付けられても、振り向きの途中で顔が変わることがあります。ショットに合わせて経路を選び、キャラクターを見分けられる状態が続くかで結果を判断してください。
MiniMax H3 Spicyは独立した画像から動画のファミリーで、通常のH3の画像入力モードではありません。768pでの現在の料金は1秒あたり$0.084で、通常のH3は768pで$0.037です。この高い料金を通常のH3のテキストから動画と比較して、その差を「画像から動画の追加料金」と呼ばないでください。同様にH3 LoRAも、互換性のあるLoRAウェイト用の独立したファミリーで、この2つのフォームの切り替え項目ではありません。
経路A:文章からショットを探る
顔がまだ決まっていない新しい架空のキャラクターや、単独の予告クリップに使います。例の説明は1つの動作です。30歳のMaraが雨の筋がついた窓から視聴者の方へ振り向きます。チャコール色のイブニングドレスは着たままで、カメラは固定します。
- MiniMax H3のテキストから動画を開きます。
- フォームでAspect ratioを9:16、Resolutionを768p、Durationを5に設定します。
- 以下のショット用プロンプトをPromptに貼り付け、実行前に見積もりを確認します。
Vertical medium shot of Mara, a fictional 30-year-old woman with a short dark bob, wearing a charcoal evening dress beside a rain-streaked window. Cool window light illuminates her face; a warm lamp glows behind her. She begins looking toward the window, slowly turns her head toward the camera, then holds eye contact. Her face and upper body stay in frame. Static camera. The dress remains unchanged. Audio: soft rain against the glass and quiet room tone, no speech or music.
選ぶ場面: キャラクターがまだ未確定、外見や舞台を探りたい、または単独のクリップだけで仕事が完結する場合です。別の経路を選ぶ場面: 顔や衣装が決まっている場合は、経路Bを使います。
最初の結果は、配役と演出の両面で判断しましょう。魅力的な顔でも既存キャラクターと違うなら、文章だけの入力ではその既存の顔を与えていません。同じ名前と髪の説明を繰り返しても、新規生成が人物の同一性を示す参照に変わるわけではありません。
外見を承認したら、プロンプトを変える前に保存してください。“Keep everything, only change the lamp”も、このタスクでは新規生成であり、局所的な画像編集ではありません。ランプが重要なら、正しいランプを含む承認済みの冒頭画像を用意して、2つ目の経路に移ります。
経路B:承認済みの冒頭を動かす
視聴者がMaraをすでに知っている場合や、承認済みキャンペーン画像にショットを合わせる必要がある場合は、画像から動画を使います。画像は単に一番よいポートレートではなく、動作の始まりを示すものにしてください。
窓辺での振り向きでは、頭を窓に向けた縦長のミディアムショットを用意します。確認できる程度に顔を見せ、肩の周囲には余白を残します。顔を狭く切り取ったクローズアップは、大きく背けて戻る動作の開始画像には不向きです。動作プロンプトに構図、同一性、動作を同時に解決させず、先に構図を調整しましょう。
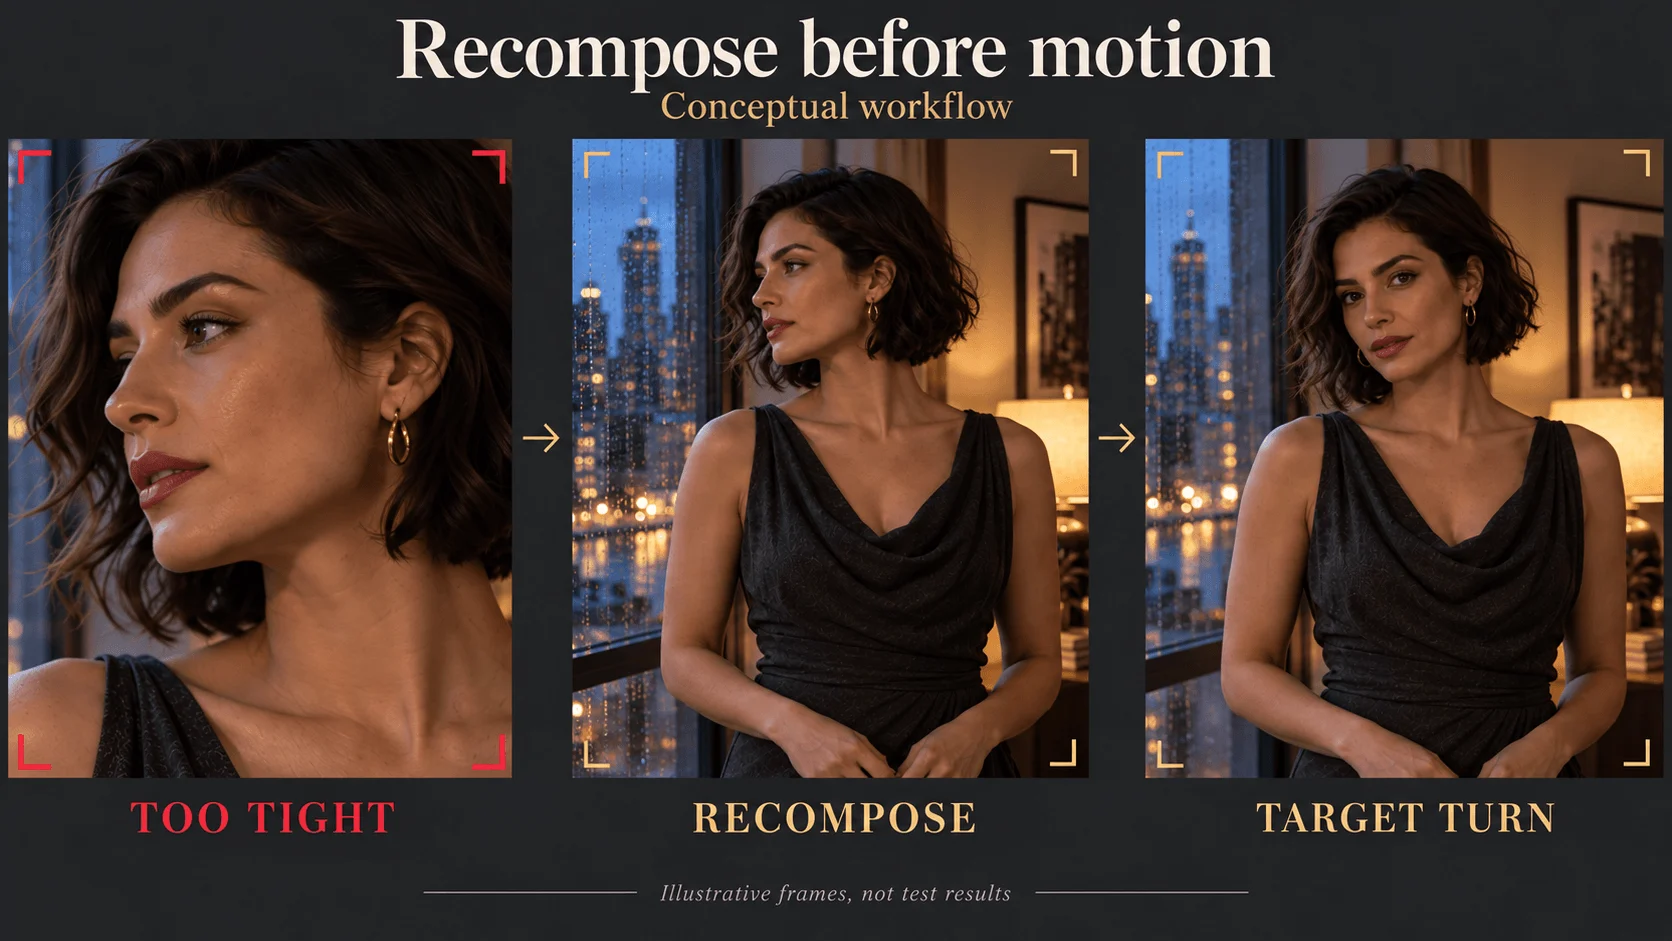
動きを求める前に、窮屈な切り取りを直しましょう。
- MiniMax H3の画像から動画を開きます。
- Input imageに承認済みの縦長の冒頭画像を追加します。各辺は256–5,760ピクセル、比率は2:5から5:2の範囲で、ファイルは10 MB未満である必要があります(Playgroundの上限)。
- Resolutionを768p、Durationを5にします。比率は画像で決まり、このタスクにAspect ratioの項目はありません。
- 以下の動作用プロンプトをPromptに貼り付けます。最初の単純な振り向きではClosing frameを空欄にします。
She slowly turns her head from the window toward the camera, then holds direct eye contact. Her shoulders stay relaxed. The camera remains fixed. Audio: soft rain against the glass and quiet room tone, no speech or music.
画像にはすでに顔、ドレス、部屋があるため、プロンプトには変化する内容だけを書きます。
冒頭、中間、最後に視線を保つ場面を確認してください。最初のフレームが一致していても、その後の顔の変化が隠れている場合があります。振り向きで横顔が不自然になるなら、顔の必要な部分をより見せる開始角度を試すか、回転を小さくします。直接のアイコンタクトが不可欠なら、その終わり方を残してください。ほとんど演技しなくなるまで動きを減らすのは避けましょう。
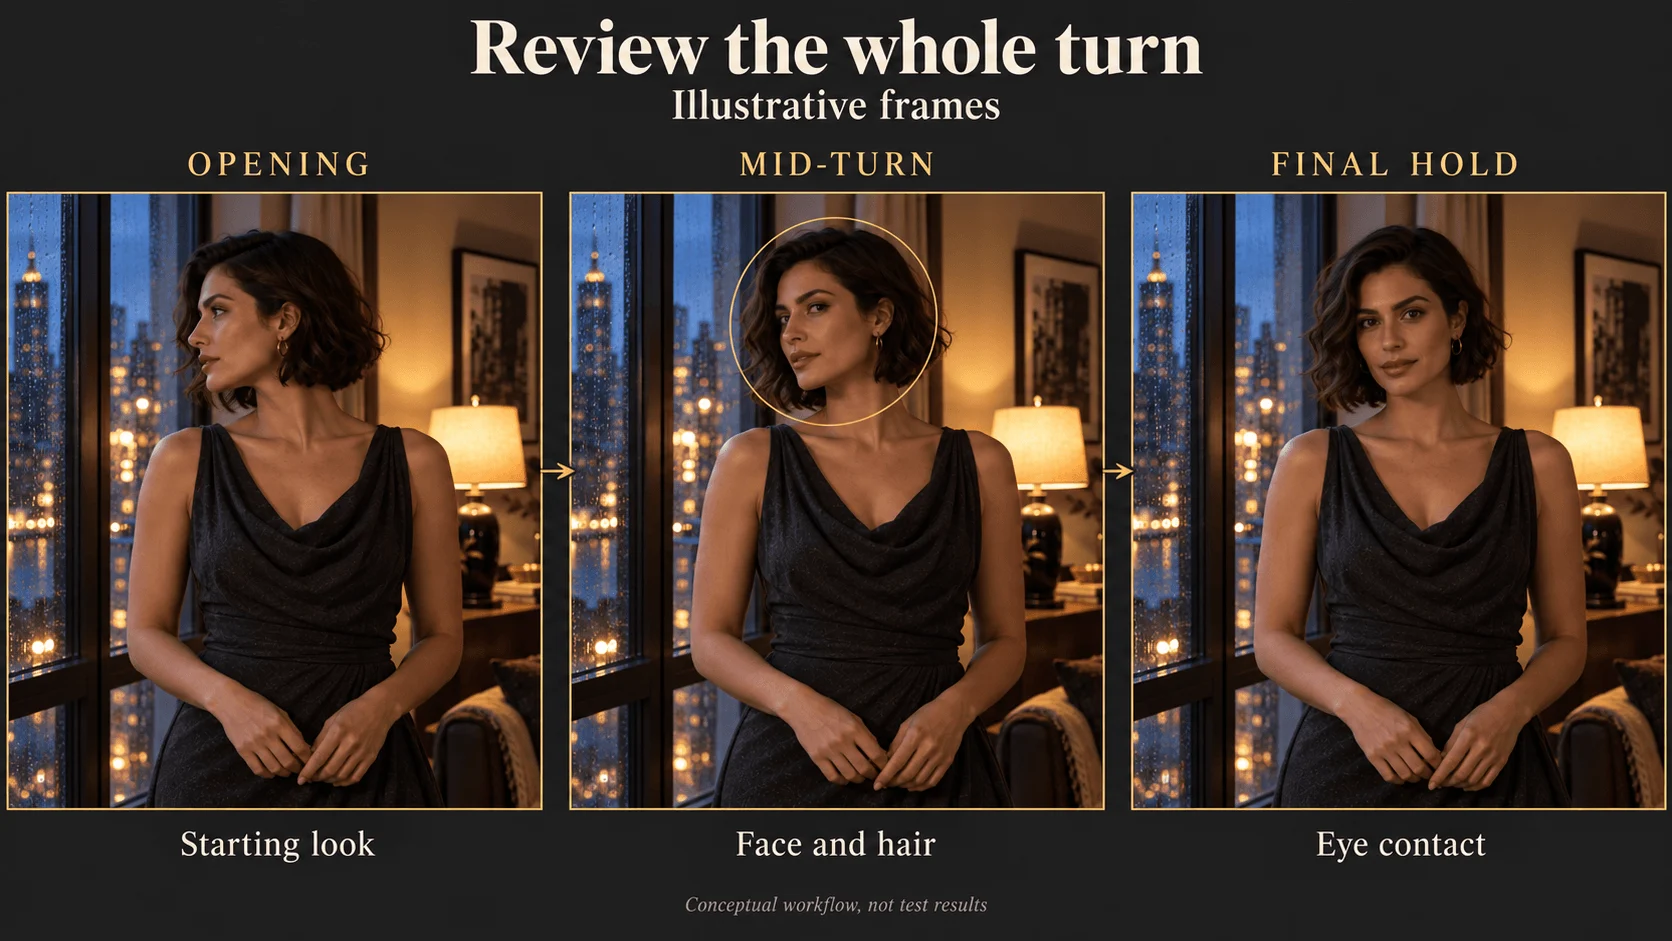
冒頭、振り向き、最後に視線を保つ場面を、それぞれ別の合格条件として確認します。
選ぶ場面: 繰り返し登場するキャラクター、承認済み画像に合わせる必要があるショット、または顔と衣装がすでに決まっている場合です。別の経路を選ぶ場面: 外見をまだ探す必要がある場合です。画像は弱点も固定してしまいます。
任意の終了フレーム(APIのlast_image_url)は、最後の構図も承認済みのときに役立ちます。同じキャラクター、衣装、照明で用意し、両フレームを自然につなぐ動作を求めましょう。終了地点は制約できますが、途中の手の位置をすべて指定したり、正しいつながりを保証したりはできません。
5秒の費用
通常のH3の現在の料金は両タスクで同じです。
| 解像度 | 1秒あたりのUSD | 5秒の生成 |
|---|---|---|
| 768p | $0.037 | $0.185 |
| 2k | $0.058 | $0.290 |
画像作成には別途費用がかかります。承認済みの静止画があれば準備費用はほぼ不要かもしれませんが、先に多くの静止画を生成して却下するなら、その支出も数えてください。768pの場合、テキストから動画を3回試すと$0.555、画像から動画を1回試すと$0.185と画像の費用です。画像の経路が安くなるのは、承認済み静止画が$0.37未満の場合だけです。どちらも初回で成功するなら、画像の経路には静止画費用が加わるため、テキストから動画の方が安くなります。
768pで下書きを作り、2kで仕上げるのは安価な方法ですが、2kの実行は下書きの高解像度化ではなく、新しいテイクです。H3はシードを提供していないので、同じリクエストでも動きが変わります。合格した動きを完全に維持する必要があるなら、別の高解像度化タスクを使いましょう。H3 Spicyの画像から動画やSeedance 2.5のようにシードを提供するファミリーでは、同じリクエストをより再現しやすくなります。
最初に見える欠点を直す
| 見える問題 | 次の対応 |
|---|---|
| 冒頭画像のドレスが違う | 再度動画を生成する前に静止画を修正する |
| 初めは正しい顔でも、振り向き中に別の顔になる | 回転を小さくするか、情報がより伝わる開始角度を用意する |
| よいポートレートだが、身振りの余白が足りない | 開始画像を広げるか、構図を調整する |
| 固定カメラの指定にもかかわらずカメラが寄る | 競合するカメラ指示を除き、動作の指示を1つにする |
| 指定した振り向きが終わらない | 副次的な動作を除くか、時間を増やす |
| キャラクターのポートレートはあるが、新しい部屋とポーズが必要 | 新しい冒頭を用意するか、別の参照から動画タスクを使う |
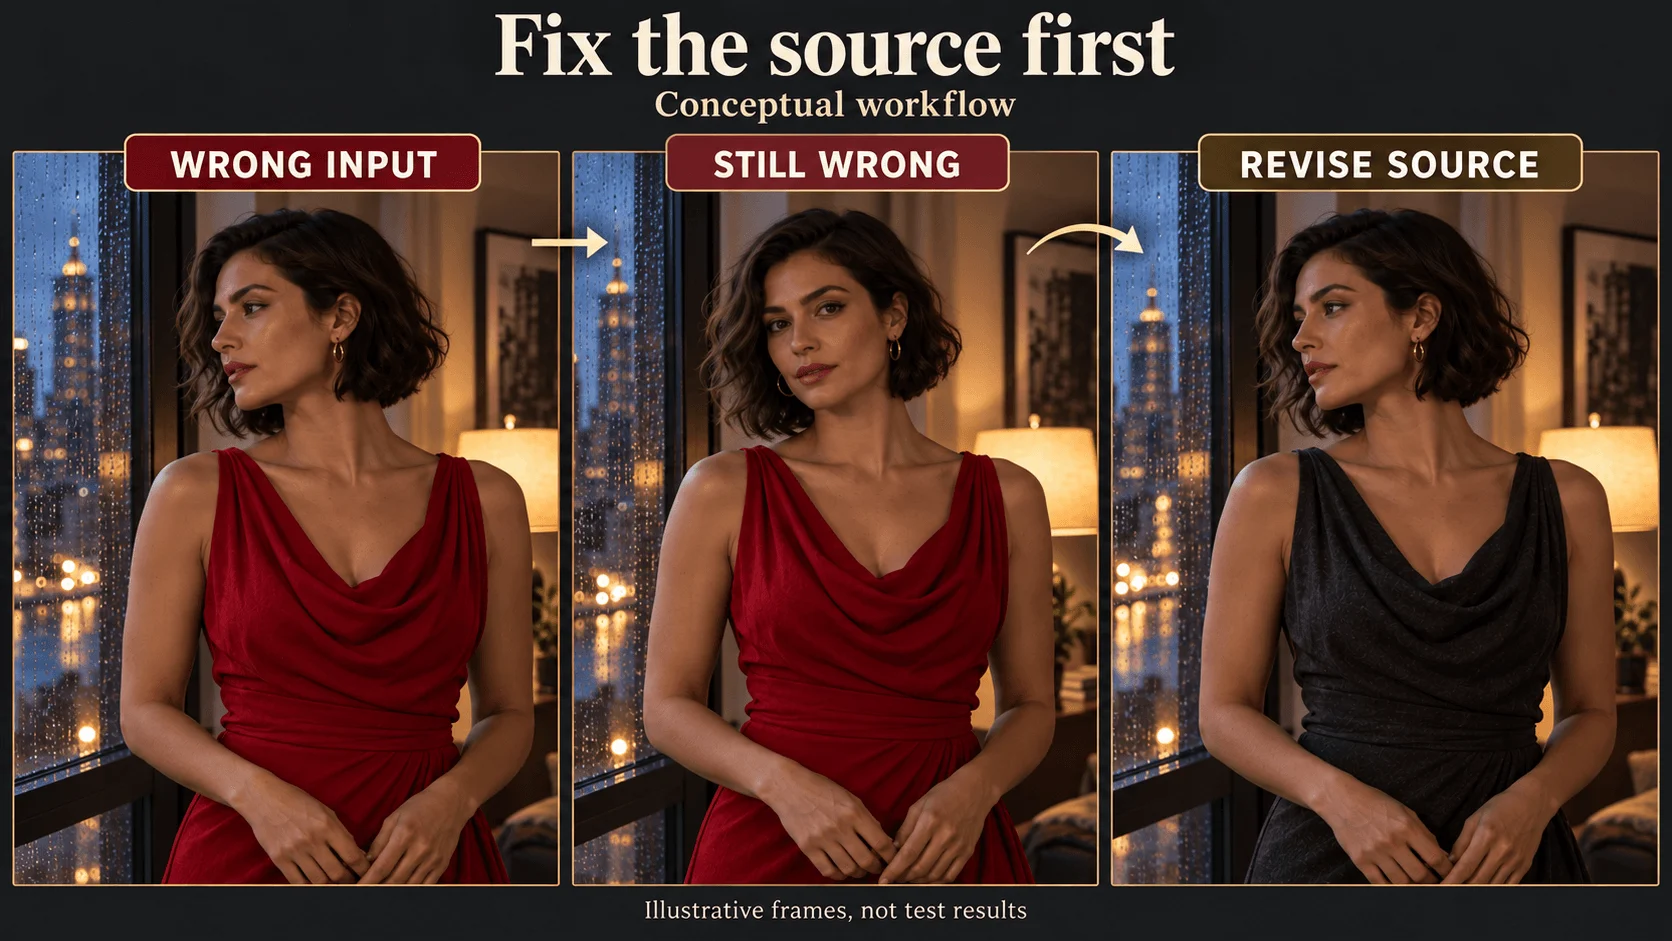
冒頭の衣装が違うなら、次の動作生成を試す前に元画像を直しましょう。
人物の同一性を示す参照と冒頭フレームは異なる素材です。Maraをテーブルに座らせたい場合、窓辺のポートレートを文字どおりの冒頭としてアップロードし、顔の参照としてだけ働くことを期待しないでください。H3の参照から動画は1~9枚の参照画像を受け付ける独立したタスクです。追加の入力と見積もりは別途確認してください。
APIから実行する
Playgroundで納得できる結果が出たら、同じリクエストをコードから使えます。これはテキストから動画の例です。画像から動画では、モデルをminimax/h3/image-to-videoに変更し、aspect_ratioを除いてimage_urlを追加します。
import os
import uuid

import requests

response = requests.post(
    "https://api.spicyapi.ai/api/v1/jobs/createTask",
    headers={
        "Authorization": f"Bearer {os.environ['SPICY_API_KEY']}",
        "Idempotency-Key": str(uuid.uuid4()),  # new key for each new request
    },
    json={
        "model": "minimax/h3/text-to-video",
        "input": {
            "prompt": "Vertical medium shot of Mara, a fictional 30-year-old woman with a short dark bob, wearing a charcoal evening dress beside a rain-streaked window. She slowly turns her head toward the camera, then holds eye contact. Static camera. Audio: soft rain, quiet room tone.",
            "aspect_ratio": "9:16",
            "resolution": "768p",
            "duration_seconds": 5,
        },
    },
)
print(response.json())フィールド、結果、エラーはAPIリファレンスにあります。
Agentに実行を任せることもできます。 エージェントはCLI、MCPサーバー、Agent Skillから同じ呼び出しを実行できます。3つとも最新のモデルスキーマを読み、CLIとMCPは料金を表示してタスク作成前に確認を求めます。
# CLI
npx @spicyapi/cli tasks create --model minimax/h3/text-to-video \
  --input-json '{"prompt": "Mara turns from a rain-streaked window toward the camera and holds eye contact. Static camera. Audio: soft rain.", "aspect_ratio": "9:16", "resolution": "768p", "duration_seconds": 5}' --wait

# MCP server: the command your assistant's MCP config runs
npx --yes --package=@spicyapi/mcp spicyapi-mcp

# Agent Skill
npx skills add spicyapi-ai/spicy-skill
15秒より長いシーンを作る
H3の1回のリクエストは最大15秒で、延長タスクはありません。クリップを承認し、最後のフレームを取り出して、次の画像から動画ショットの冒頭画像に使います。各プロンプトでは次に起こることだけを説明します。毎回文章でキャラクターを再び選ばせる代わりに、前のショットの外見を次の冒頭フレームへ引き継げます。
どの経路を選ぶか
毎週のキャラクターシリーズなら、ショットごとに冒頭画像を承認して動かします。配役が決まっていない新しい舞台なら、文章から始めて結果を探索として扱います。顔と構図が維持すべき要件になったら、経路を切り替えましょう。