はじめに
MiniMax H3 参照から動画 は、1〜9 枚の参照画像と、それらを Picture 1、Picture 2 のように番号で呼ぶプロンプトから 1 つのショットを生成します。長さは 4〜15 秒の整数、解像度は 768p・2k、アスペクト比は 6 種類で、音声も一緒に生成されます。画像に加えて、参照動画を最大 3 本、参照音声を最大 3 本(それぞれ合計 15 秒まで)送れます。
開始素材に応じてモードを選ぶ
| 開始素材 | モード |
|---|---|
| 書いた場面やスクリプト | MiniMax H3 テキストから動画 |
| 承認済みの開始画像 | MiniMax H3 画像から動画 |
| 1〜9 枚の参照画像 | MiniMax H3 参照から動画 |
主な機能とハイライト
番号付きの画像枠が最大 9 つ
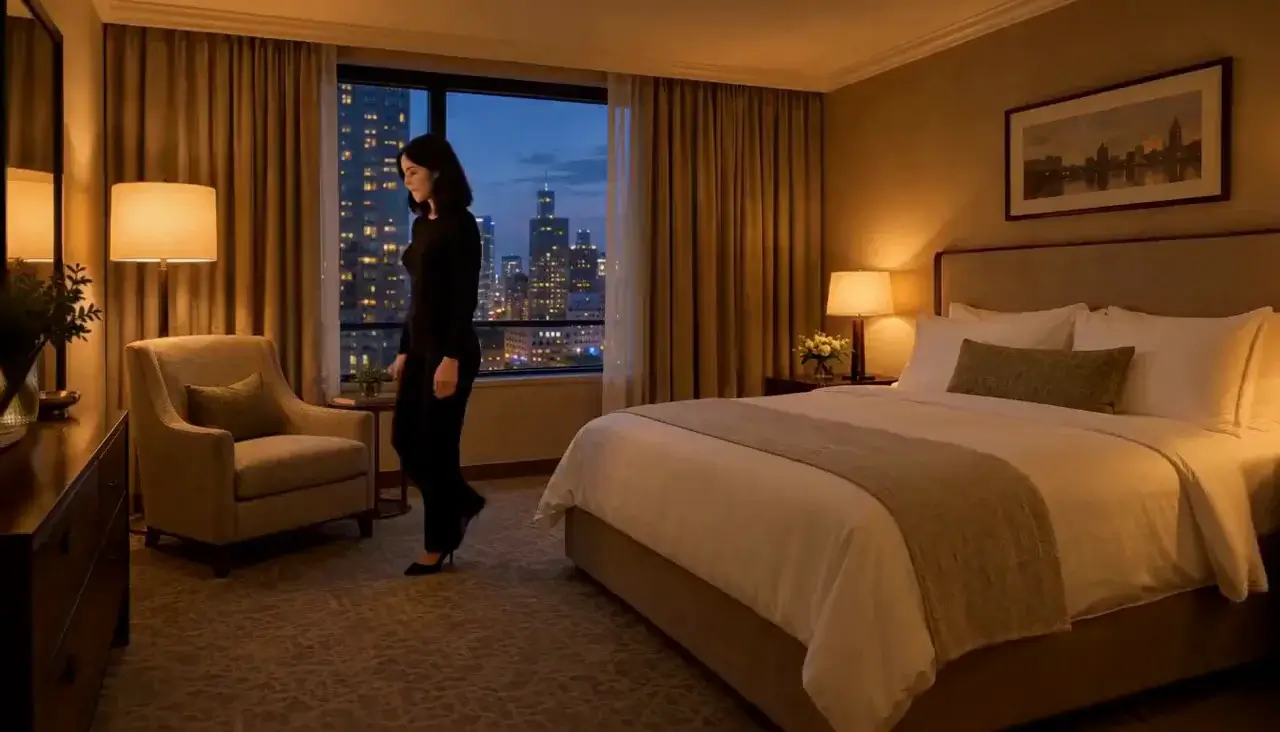
reference_image_urls は 1〜9 枚の画像を受け取り、プロンプトはそれを位置で呼び分けます。1 枚目に顔、2 枚目に衣装、3 枚目に部屋を担わせる、といった使い方ができます。character-continuity の例がまさにそうで、Picture 1 の女性を Picture 2 の衣装のまま、Picture 3 のホテルの部屋に保ちます。
既存のセットを新しいアングルで
カメラを新しい位置に動かしても、参照があれば制作全体の見た目がそろいます。red-dress-theatre-three-angles の例は、3 枚の静止画で演者、衣装、舞台を固定したうえで 3 つ目のカメラアングルを求めているので、新しい位置が別の作品になってしまうことがありません。3:4、5 秒で生成されています。
動きと音はプロンプトで書く
動きと音声は、文章で指示することも参照で渡すこともできます。voice-and-room の例は演者と舞台照明の 2 枚を送り、クラブの響きは言葉で書いています(温かい残響と観客のざわめき)。参照動画は動きを運び、<Video 1> のように指します。参照音声は声や音を決めます。参照画像は 5 枚目まで料金に含まれ、6 枚目からは 1 枚ごとに加算されます。参照動画の秒数は出力秒より安い専用の秒単価で課金され、参照音声は無料です。送信前のライブ見積もりにすべて反映されます。
リクエストパラメーター
| パラメーター | 必須 | 説明 |
|---|---|---|
prompt | はい | 参照を <Picture 1>、<Picture 2> と番号で呼び、それぞれの担当を書いたうえで、動きと音を書いてください。 1 文字以上 · 7000 文字以内 |
reference_image_urls | はい | 画像 1〜9 枚。5 枚目までは料金に含まれ、6 枚目からは 1 枚ごとに加算されます。 1 件以上 · 9 件以内 |
reference_video_urls | いいえ | 動き、カメラワーク、動いている人物の参照に使う動画を最大 3 本(1 本 2〜15 秒、合計 15 秒まで)。プロンプトではアップロード順に <Video 1>、<Video 2>、<Video 3> と指してください。 1 件以上 · 3 件以内 |
reference_audio_urls | いいえ | クリップが従うべき声や音の参照音声を最大 3 本(WAV または MP3、1 本 2〜15 秒、合計 15 秒まで)。参照音声は無料です。 1 件以上 · 3 件以内 |
aspect_ratio | いいえ | 16:9、9:16、1:1、4:3、3:4、21:9。21:9 でアナモルフィックの帯になります。 |
resolution | いいえ | 768p と 2k がこのエンドポイントでもネイティブに使えます。下書きは 768p、納品は 2k で。 |
duration_seconds | いいえ | 4〜15 の整数秒。4 秒は 768p でのみ利用できます。 |
料金
参照画像は 5 枚目まで料金に含まれ、6 枚目からは 1 枚ごとに加算されます。参照動画の秒数は出力秒より安い専用の秒単価で課金され、1 本ごとに秒単位で切り上げ、合計 15 秒までです。参照音声は無料です。
| 仕様 | 料金 |
|---|---|
| $0.037 / 秒 |
| $0.058 / 秒 |
ユースケース
ショットをまたいで同じキャラクターを保つ
シーケンスのどのショットでも同じ参照画像のセットを使い、プロンプトでは動作と場所の行だけを変えます。このエンドポイントは seed を受け取らないため、テイク間で人物を安定させるのは参照画像です。文章だけでは人物がぶれていきます。
演者を特定の空間に置く
人物の画像と空間の画像を別々に用意し、そこで起きることを書きます。voice-and-room では、演者がマイクに身を寄せて台詞を 1 つ言い、微笑みます。2 枚目の画像が舞台照明を、プロンプトが部屋の音を担っています。
衣装や小道具を動きの中で保つ
衣装や物には専用の枠を与え、人物写真の中で残ってくれることに期待しないようにします。red-dress の例では、ドレスの形と色が参照で決まっているため、プロンプトは動いたときのドレスの様子(プロセニアムへ歩くたびにスリットが開く)だけを書いています。
プロンプトガイドと実践のヒント
画像ごとに役割を 1 つ割り当てる
character-continuity のように、プロンプトの冒頭で対応関係を示します。「Keep the woman from Picture 1 and the black lace slip from Picture 2, in the hotel room from Picture 3.」そのあとに動作を書きます。重なり合う 9 枚よりも、役割がはっきり分かれた 3〜4 枚のほうがうまくいきます。同じ被写体を写した画像が複数あると、モデルはどれかを選ばずに平均化してしまいます。
参照で補えない部分だけを書く
人物、衣装、場所が画像でそろったら、プロンプトは動き、カメラ、音に使います。「She sits on the arm of the chair, crosses her legs and looks up at camera. Slow handheld drift, warm lamp, quiet room tone.」顔を言葉でもう一度描写すると、画像と一致しないかもしれない 2 つ目の説明をモデルに渡すことになります。
小さく試してから仕上げる
長さは 4〜15 秒で、4 秒は 768p でのみ選べます。使う予定の参照セットで低い解像度の下書きを作り、それから 2k で再実行します。テイクがぶれたら、参照か指示のどちらか 1 つだけを入れ替え、どの変更が効いたのかを追えるようにしてください。
API クイックスタート
# Generate the idempotency key once; reuse it when retrying after a lost response.
export SPICY_IDEMPOTENCY_KEY="${SPICY_IDEMPOTENCY_KEY:-$(uuidgen)}"
curl -X POST https://api.spicyapi.ai/api/v1/jobs/createTask \
  -H "Authorization: Bearer $SPICY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Idempotency-Key: $SPICY_IDEMPOTENCY_KEY" \
  -d '{
  "model": "minimax/h3/reference-to-video",
  "input": {
    "aspect_ratio": "16:9",
    "duration_seconds": 5,
    "enable_prompt_expansion": false,
    "prompt": "A slow aerial shot drifting over a misty pine forest at sunrise",
    "reference_image_urls": [
      "https://example.com/reference.png"
    ],
    "resolution": "768p"
  }
}'

# Copy data.taskId from the response into TASK_ID, then poll the status.
TASK_ID="TASK_ID_FROM_RESPONSE"
curl "https://api.spicyapi.ai/api/v1/jobs/recordInfo?taskId=$TASK_ID" \
  -H "Authorization: Bearer $SPICY_API_KEY"
認証、完全なスキーマ、ポーリング、エラー処理は API リファレンスを参照してください。