継続する成人キャラクターは、紹介したポートレートだけでなく次の回でも同じキャラクターと分かる必要があります。気に入った顔ができたら、MiniMax H3 RefModsとLoRAの判断は、服、カメラ角度、相手が変わるたびに、どれだけ作業を繰り返したいかという問題です。
通常の参照画像から始めます。ComfyUIを使っていて同じ画像を反復するならRefModを保存します。参照処理で効率よく得られない、学習した人物やスタイルが必要ならLoRA学習を検討します。RefModは参照情報をまとめるもので、H3へ人物を学習させません。LoRAは学習が必要で、追加投資が自動的に再現度を改善するわけではありません。
新しい架空の成人なら、一貫した少数の視点を準備するのが通常は有用な最初の投資です。確立した週次シリーズなら、参照集で反復準備を減らせます。人物が安定し、解きたい具体的な限界を説明できるようになると、学習費用が合理的になります。
NSFWシリーズのキャラクターを識別する特徴は、合う顔以上のものです。近い親密な場面や広い成人向け場面でも、比率、肌色、特徴的な印を認識できる必要があるかもしれません。ここでの参照から動画は、内容テストの公開履歴が異なります。通常H3には中程度のNSFW画像の生成記録、H3 LoRAには強度の高い成人向け場面の生成記録があります。タスク固有の観察であり、RefMods比較やすべての場面の保証ではありません。外見保持の方法と内容能力は別に選びます。
| 状況 | 出発点 | 理由 |
|---|---|---|
| 完成場面1枚から短い動画が欲しい | 画像から動画 | 開始に構図と衣装がある |
| 同じ人物を新部屋や新衣装にしたい | 通常の参照から動画 | 保存素材を作り直さず材料を替えられる |
| ComfyUIで同じ参照を繰り返し読み込む | RefMod | 整理した参照集を再利用 |
| 互換H3処理で文章から人物を使いたい | 学習した人物LoRA | 学習したキャラクターの外見をアダプターへ入れられる |
| 1ショットで名前のある2人が必要 | 各人の別参照 | 複雑にする前に外見と画面位置を明示 |
| 特徴的な反復スタイルや動作が必要 | 適切なLoRAか関連参照 | 人物アダプターが動作アダプターとは限らない |
以下は成人向け写真・動画シリーズの架空の32歳Irisです。実践的な開始指示で、新しく生成した比較結果ではありません。
各方法が実際に省く作業
通常参照は生成に渡す画像などの対応素材です。次のショットでも選ぶか、保存処理から読み込みます。モデルの永久の知識にはなりません。10プロンプトで「Iris」と名付けても、キャラクターの外見が永続的に保存されるわけではありません。
RefModは互換H3処理向けの再利用ファイルに変えます。元のRefModプロジェクトは、抽出でVAE参照表現を保存し、H3重みは学習しないと説明します。Fullは多い情報、Compressedは少ない参照トークンと引き換えに細部を減らします。歴史的な内部名trainingは圧縮latentの調整で、LoRA学習ではありません。服、キャラクターの外見、背景も一緒に運ばれ得ます。
LoRAは学習したアダプターで、ベースと一緒に使う変更の重みです。元のLoRA論文は低ランク適応を説明します。H3では、学習例を準備し、実際に読める重みを作る必要があります。RefModへ写真を保存することとLoRAを学習することは、両方.safetensorsでも別の問題を解きます。
| 問い | 通常参照 | RefMod | 学習LoRA |
|---|---|---|---|
| 準備するもの | 選んだ画像や対応素材 | 素材と互換の抽出処理 | 選定したデータセットとtrainer |
| 再利用するもの | 原本とプロンプトの役割 | 保存参照表現 | 学習アダプター重み |
| 悪い参照1つを替える方法 | 画像を替える | 参照集を編集・作り直す | 学習した問題ならデータを直し再学習 |
| 参照なしで生成できるか | いいえ | いいえ。保存参照が条件になる | アダプターとタスクによっては可能 |
| 同じ人を保証するか | いいえ | いいえ | いいえ |
| 共通H3アップロード形式か | 対応する素材だけ | いいえ | loaderに対応するLoRA重みだけ |
期待外れの素材で違いが重要になります。RefModに矛盾する横顔があれば、良い名前を付けても直りません。LoRAが特定衣装と一緒にIrisを学習したなら、新衣装はその結び付きと競合します。準備が結果を変え、修復する段階は異なります。
RefLoRAも見かけます。プロジェクトはLoRA重みとRefModを1ファイルにまとめます。通常loaderは重み、対応する複合loaderは両方を使えます。まとめても学習は不要にならず、ホスト型が参照半分を自動的に読めるわけでもありません。拡張子で選ばず、中身とloaderを特定します。
最初に同じままにするものを決める
Irisの固定する外見の特徴は、32歳の成人女性、短い赤褐色のボブ、広い眉、真っすぐな鼻、分かる顔形に絞ります。黒の夜の服、クリームの部屋着、寝室の照明、カメラ距離はショットの選択です。
シリーズが変更を必要とするのに最初の画像全体を保つ、というコストのかかる失敗を避けられます。参照写真は人、服、ポーズ、光、部屋の全場面です。「Irisを一貫させる」は人には分かっても、キャラクターの固定特徴に属する部分と今回に属する部分を入力で明確にします。
成人向けシリーズでは、異なる認識問題に別の参照を使います。
| 見る人が認識するもの | 有用な参照 | 場面で変えてよいもの |
|---|---|---|
| 顔、眉、生え際 | 明瞭な顔と承認した回転角度 | 表情、視線、メイク |
| 体格、相対比率 | 肩、腰、立ち方の読める広い視点 | ポーズ、距離、服 |
| 肩の小さい反復タトゥー | 実際のデザインと位置の明瞭な視点 | 照明、枠に見えるか |
| 特定セットのスタイル | 選んだ衣装と髪 | 次回のスタイル |
顔の切り抜きは広い場面の身体比率を定めません。遠い全身は姿勢を示しても顔は不足します。肩の印が変形するなら全参照強度を上げず、細部の明瞭な参照を足します。正確な位置が必須なら開始静止画で決めます。人物集、ラウンジ、より成熟した場面でも同じ分け方で、ショットが必要情報を決めます。
小さいフォルダーに3種類を用意します。
- キャラクターの参照視点:同じ人と承認した顔、斜め、横。
- 衣装例:各反復衣装。可能なら外見の参照の選択と分ける。
- 場面画像:無人の部屋か、特定ショットの承認済み開始。
作業の整理であり、必須のデータ数ではありません。静かな顔は1枚だけでもよく、回転には見せる特徴の承認角度が役立ちます。部屋が毎週変わる近い顔に、部屋画像の仕事はありません。
美しさより先に、あご、鼻、眉、生え際を比べます。より魅力的でも別人の場合があります。今不採用にする方が、矛盾する顔で素材を組むより手間が少なくなります。
永久の特徴とスタイルも分けます。髪を留める回があっても、ボブ輪郭だけに依存せず顔で認識できるようにします。服で替えるアクセサリーを、別人と分ける唯一の特徴にしません。
大人向け画像でも同じです。参照で将来の全場面の強度や構図を再現する必要はありません。読めるキャラクターの参照と、場面に合う生成経路を選びます。まとめ方や人物学習は、特定エンドポイントが満たす成人向け要求を定めません。
通常参照:新シリーズの最適な出発点
人物をまだ決めている、服が頻繁に変わる、ComfyUIを保守せずホスト型Playgroundを使いたい場合に役立ちます。
誤りも見やすくなります。渡した画像を見て、矛盾する1つを外し次を作れます。人物を定める前の単純さには価値があります。複雑な保存集では弱い画像を見落としやすくなります。
キャラクターの2視点から5秒を作る
Picture 1はIrisの正面、Picture 2は承認済み斜めです。最初は場所を文章にし、両参照を人物だけに使います。
ホスト型H3参照から動画は最大9画像、4〜15秒です。5秒、768p、縦9:16から始め、2画像で$0.1986です。ショットの方向に残す価値ができてから大きくできます。
Picture 1とPicture 2は同じ架空の32歳成人女性Irisです。顔、短い赤褐色のボブ、比率に使います。チャコールのサテンイブニングドレスを着用。静かなアパートの暖かいベッドサイドランプ横に座り、斜めからカメラへゆっくり顔を向けます。中距離の近い構図、目の高さ、穏やかな表情、安定した枠。回転中も顔を明瞭にします。音:柔らかな部屋の環境音。
参照と文章へ別の仕事を与えます。古い背景と服を保ち、新しい部屋も作るという矛盾を求めません。控えめな回転で、複数ポーズなしに動作が明確になります。
参照がすでにそのドレスで保ちたいなら、そう書きます。1枚がジャケットなら、出力の服はドレスと明示します。ジャケットが戻り続けるなら、説明を増やすより参照の交換・切り抜きが役立ちます。
場面が正しければ開始画像を使う
クリームの部屋着でランプの横に座り、表情と部屋が正しい画像があるなら、画像から動画が直接の次段階です。参照から動画は材料から新しく構成します。
動作指示の例です。
開始フレームの架空の成人女性Irisが、穏やかに視線をカメラへ上げ、小さく自然に笑います。肩は同じ位置。カメラはゆっくりわずかに寄ります。ランプは安定。音:静かな室内環境音。
構図をまだ作るなら参照、すでにできて残る仕事が動きなら開始画像です。完成画像1枚を動かすだけのために人物LoRAを学習すると、直近の仕事の前に別制作を加えます。
開始画像も全後続フレームの完璧さは保証しません。長い回転で未知の横顔が出るなら、回転を短くするか良い開始角度にします。外見を保持する方法全体を失敗とする前に、ショット設計を解決します。
RefMods:参照準備が反復になるとき
人物が気に入り、ComfyUIを使い、同じ集を作り直すなら魅力的です。計算だけでなく整理も省け、名前付き素材で反復選択・準備を替えられます。
保存ファイルと、読む処理は違います。H3ノードで見せ方が異なり、ある制作者のグラフの良い結果が全loaderの同じ外見を証明しません。
AdudeguymanのFantastic H3 Prompt Builderは、参照管理とプロンプト編集を加えます。参照mapは実際の入力に結び付くラベルを示します。新しい版はencoder framesを保存でき、text encoderに見せる画像数を実験的に選べます。増やすとメモリと時間が増える場合があります。処理設定であり、外見の再現度が改善する保証ではありません。
再利用するIris素材を作る
RefModの手順にインストールとノード別の説明があります。人物では次が有用です。
- 動くH3参照処理と対応VAEから始める。
- ライブラリーの作成画面で承認Iris画像を追加。
- 切り抜きを確認。最初の画像が全体の形を決めるため、顔や髪が消える参照を直す。
- 外見の基準にFullを選び、名前を付けて作成。
- stackへ入れ、promptの役割を書く前に参照mapを読む。
原本も残します。便利な保存参照に対し、悪い視点の除去、別切り抜き、他アプリへの移動を可能にするのは原本フォルダーです。
全履歴を1つのmasterへ入れません。「Irisの承認視点」と説明しやすい素材にします。「3部屋、4衣装、古い髪、1回だけ出た別人」まで意味するものにしません。
生成を疑う前に保存結果を読む
切り抜きと圧縮で、保持したい特徴が消えます。ファイル閲覧の顔サムネイルは、期待する細部で顔全体を保てた証拠ではありません。
元は明瞭でも保存プレビューが柔らかい、狭い、切れているなら素材を先に改善します。人物シリーズでは、大きすぎて細部を削った集より、少数の明瞭な視点が合理的です。
FullとCompressedは便利ですが、小さいファイルは無料の条件付けではありません。小さくても生成へ参照情報を加えます。多い細部では不要な部屋や服も顔と残ります。強度を調整する前に情報を選びます。
Irisではキャラクターの参照素材と任意の部屋素材を分けます。今回必要なものだけ読み込みます。別アパートなら古い部屋を外します。役割のない部屋の強度を下げるのは間接的な修正です。
コミュニティの結果が矛盾して見える理由
H3人物学習の議論では、RTX 5090で約5時間学習しても満足する再現度でなかったと投稿されました。RefModsを評価する返信も、通常参照より似ない・遅いという報告もあります。画像を1ファイルへ詰めると新しいキャラクターの外見を学習するという考えも疑問視されています。
便利さ、速度、再現度は別の利点です。RefModが便利でもグラフで速いとは限らず、準備を省けても特定の顔が改善するとは限りません。checkpoint、切り抜き、参照の見せ方、promptも結果に関わります。
Prompt Builder作者の更新は、text encoderへの渡し方で人物の混合が減り、時間とメモリは増えたとしています。声の交換は残りました。問題の残る具体的な実装結果であり、全員の人物LoRAがRefModへ置き換わった証拠ではありません。
人物を変えずに着替える
成人の繰り返す人物には、認識と新しさの両方が必要です。顔は見慣れたまま、スタイルは人物集、ラウンジ、夜の衣装で変わります。便利な集が広すぎることもあります。
全参照が濃いサテンドレスなら、服が強い指示になります。無関係な衣装5枚を加えると、情報と同時に競合する服の証拠も増えます。
実践的な整理です。
| 素材 | 含めるもの | 使うとき |
|---|---|---|
| Irisの外見 | 一貫した顔の承認視点 | 確立した外見が必要な毎ショット |
| 夜の衣装 | 目的のドレスとスタイルの明瞭な1視点 | 夜の場面 |
| 部屋着 | クリームの服の明瞭な1視点 | ラウンジ場面 |
| アパート | 競合する人物のない部屋 | その部屋が必要なショット |
| 承認開始フレーム | Iris、服、最終構図を一緒に | その構成の画像から動画 |
通常ファイルで構いません。互換のローカルで繰り返す部分だけRefModにします。1回限りの小物に永久の集を作る利点はありません。
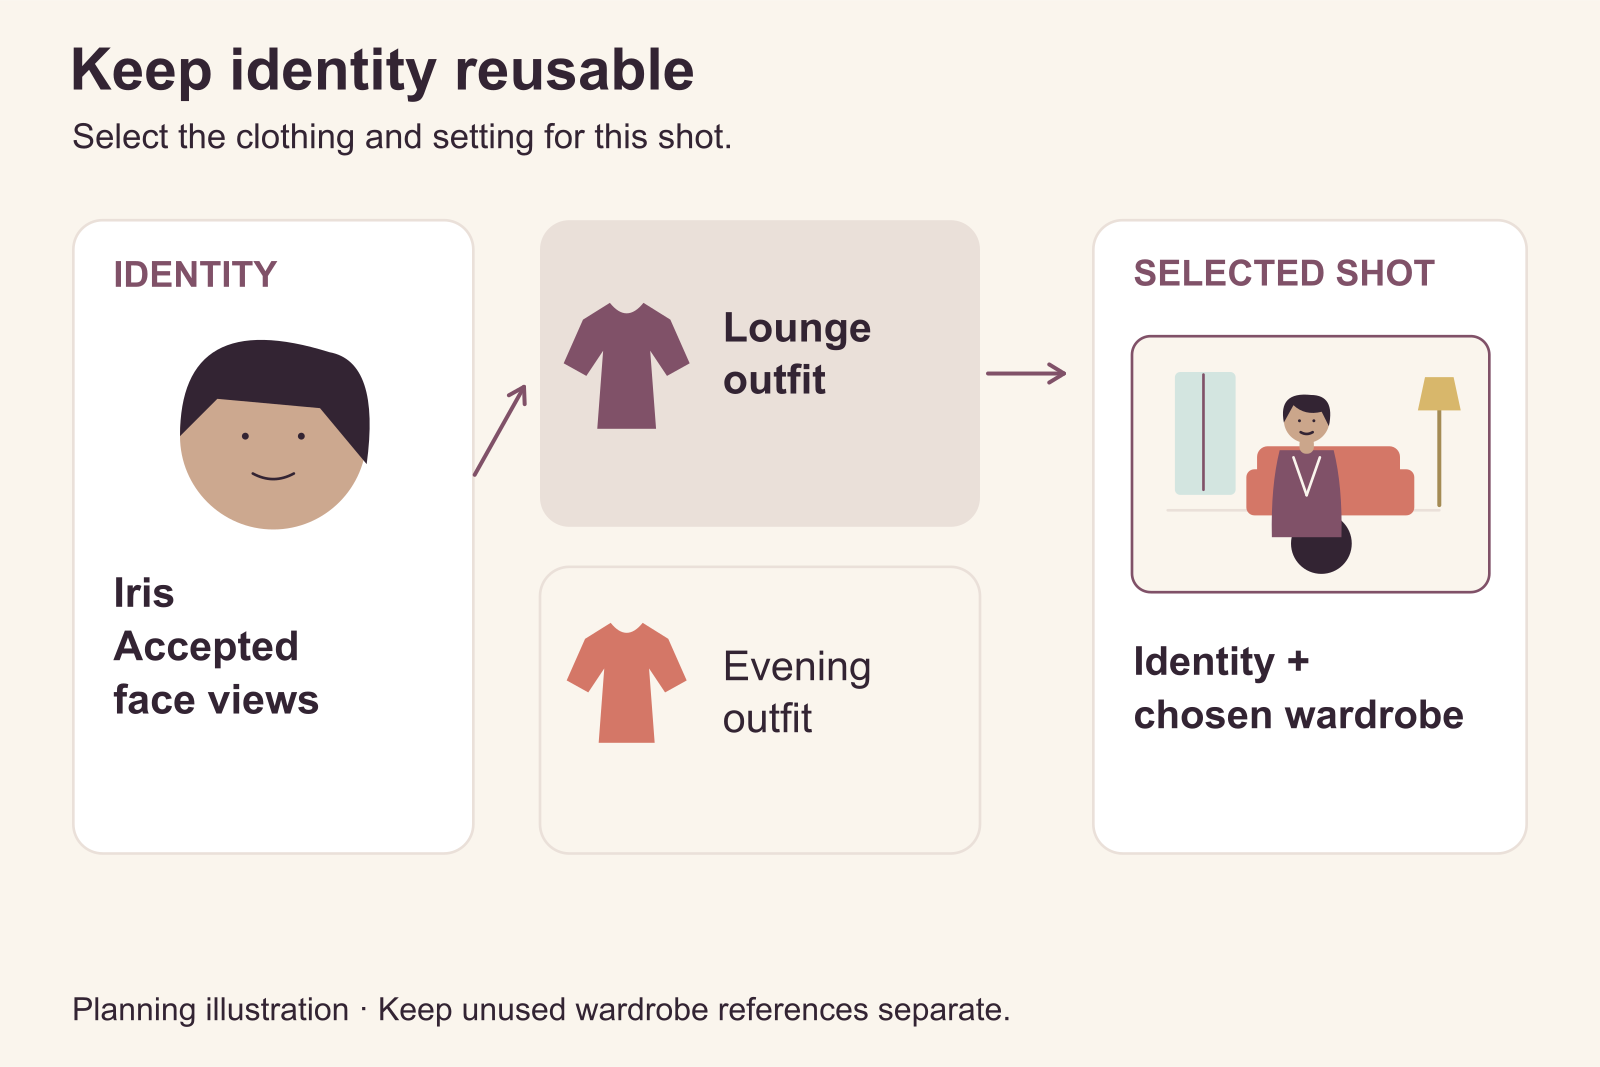
図解:外見の参照を再利用し、服と場所はショットごとに選びます。
新衣装に明瞭な参照を与える
同じ外見2枚を保ち、Picture 3に服を加えます。服だけの画像か、別人の顔が競合せず、服が分かる切り抜きを選びます。
Picture 1とPicture 2は同じ架空の32歳成人Irisを定め、Picture 3は今回のクリームの部屋着です。暖かいランプ横の椅子に、その服でIrisを座らせます。顔は1と2から保ちます。片手を肘掛けに置き、ゆっくり窓へ視線を向けます。顔が見える中距離。音:静かな室内音。
服画像に別人がいれば、目的を特に明確にします。細部を失わず可能なら、その顔を除く方がよい方法です。
古い衣装が戻るなら、新しい服の静止画を先に編集します。顔と服が正しく一緒になれば、それを動かします。争点を直接確認できる静止画へ移せます。
5秒にキャラクターの外見、衣装構造、動作を毎回解かせるより管理が速い場合があります。同じ衣装の短い複数ショットに再利用できる開始にもなります。
永久の再設計には新しい承認参照を作り、旧版と分けて古い回も再現できるようにします。外見の改訂はLoRA再学習の理由になり得ます。新しいドレスは通常、先に服参照か準備開始画像を使います。
2人には明示した役割が必要
RefMod2つで独立に調整できる2人が自動的に作られるわけではありません。人物LoRA2つも、各々へ画面半分を自動的に予約しません。
誰がいるか、どの情報が誰に属すか、各人が何をするかを解く必要があります。同じ髪、服、顔説明や、「彼女が彼女へ向く」という曖昧なpromptで難しくなります。
2人目の架空の成人Alex、35歳を加えます。異なる短い髪と別参照を使います。説明に便利な差ですが、妥当なキャラクターの参照の代わりではありません。
通常参照の最初の簡単な構成です。
- Pictures 1・2:Irisの正面と斜め。
- Pictures 3・4:Alexの対応視点。
- 部屋と服:別参照が必要でなければ文章。
関係を次のように書きます。
Pictures 1と2は架空の32歳成人女性Iris、3と4は架空の35歳成人男性Alexです。Irisは左でチャコールのイブニングドレス、Alexは右で濃い色の襟を開けたシャツです。アパートの窓横で静かに笑みを交わします。IrisがAlexへ向き、AlexはIrisを見たままです。両顔の見える中距離2人構図、固定カメラ。音:柔らかな夜の室内環境音。
左右で曖昧さを減らし、動作は代名詞でなく名前を使います。最初から交差、位置交換、一緒の振り向きも要求せず、カメラを固定します。
ローカルRefModsは現在の参照mapのラベルを使います。複数画像のRefModがpictureでなくvideo参照になる場合もあります。ファイル名から番号を推測したり、並べ替えた後に古いpromptの番号をコピーしたりしません。
公式H3参照promptガイドは、見える対象と、その素材を分けます。Irisは対象、写真や動画はIrisの情報源です。原本の場面全体を再現させず、新ショットでの位置を説明できます。
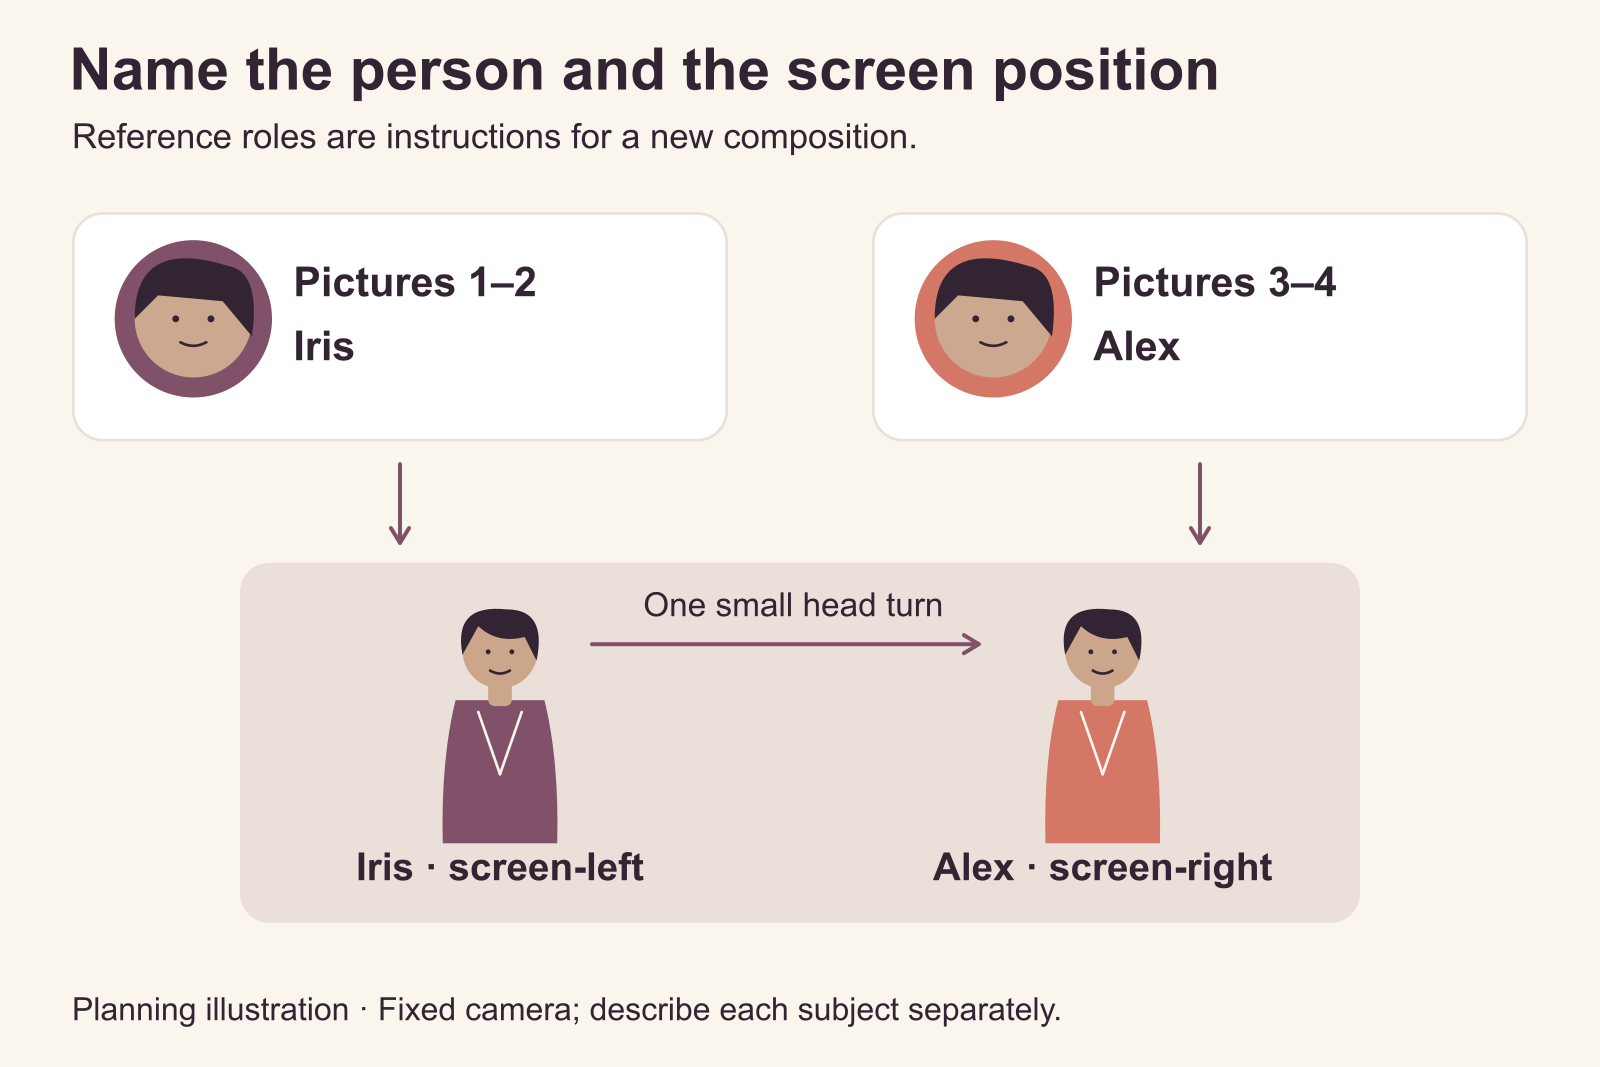
図解:原画像、人物、画面位置を別々に割り当てます。
顔が混ざるなら先に構図を簡単にする
AlexにIrisの髪、IrisにAlexの顔形が出たら、参照とpromptのラベルを確認します。誤った画像の割り当ては外見の再現品質の失敗に見えます。
正しければ、顔を両方見せ、画面位置を分け、最初の共有ショットで交差しません。3人目の顔の衣装参照を外します。個別は正しく共有で混ざるなら、両キャラクターの外見を承認した2人開始画像を準備し、控えめな相互作用を動かします。
編集も変えられます。動く2人構図へすべてを強制せず、1人ずつと肩越しを交互にします。両顔の連続表示より自然なつながりが重要な場面で実用的です。
難しい相互作用の保証ではありません。素材をさらに作る前に、具体的な曖昧さへ対処します。
声の一貫性を外見と分ける
外見が同じでも毎回声が変われば別人に感じます。ただし視覚RefModへ音を保存しても、その声と顔の信頼できる接続は確立しません。
RefModの検証メモには話者の転送失敗と、不完全な生成検証が記録されています。実際に使う処理で、音声参照は別能力として評価します。
Irisの最初の映像場面は環境音で足ります。固定の発話声が必須なら、複合ファイルで解決済みと仮定せず、別の声と会話処理を計画します。学習した視覚人物LoRAも、学習した声の証拠ではありません。
人物LoRAの学習に価値が生まれるとき
外見が定まり、参照選択の簡略化より具体的なものが必要なら、学習は合理的です。
検討に値する状況は3つです。
- 毎回多い参照を渡さず、互換アダプターでテキストから動画に人物を使いたい。
- 通常参照では十分に表せない、反復する学習スタイルや挙動が必要。
- LoRAを使う制作環境が動いていて、そこにこの人物を加えたい。
「シリーズを作る」だけでは不足します。丁寧な顔10本は採用開始画像で十分な場合があります。大きいシリーズで学習を正当化しても、実作業を減らすか必要な能力を加える場合です。
実際に動かす処理へ学習する
H3は交換可能な単一重みではありません。FL2VAとRef2VAは互換性を意図して選びます。AI Toolkit Ref2VA文書は専用重みと学習アダプターを示します。H3という名前だけで全ホスト型タスクやローカルcheckpointに合うと考えません。
学習前に、主出力をテキストから動画、開始画像の動作、参照付き動画のどれにするか決め、trainer担当へ伝えます。1グラフで印象的な学習例も、別環境へ単純に移るとは限りません。
Wanや画像モデルの成功例からlearning rateとstepをコピーせず、現在のH3手順を使います。Musubi H3文書は複数タスクとベース挙動を保つ異なる方法を扱います。何を学び、何を崩すかに影響します。
1写真ではなく人物を教えるデータを作る
Irisでは、シリーズが必要とする変化の中でキャラクターの外見を見せます。関連角度の読み取れる顔、比率が重要なら広い構図、複数の服と照明を含めます。
矛盾するIrisで変化を作りません。同じ承認した外見20画像は、鼻とあごが徐々に変わる美しい20画像より一貫します。似た顔の切り抜きを何十枚作っても、不足する横は供給しません。
服、枠、表情、場面の変わるものをcaptionにします。trainerの方法に合うキャラクター名を一貫させます。trigger型なら簡単な例です。
irisvale、架空の32歳成人女性、斜めのポートレート、クリームのニットトップス、自然な表情、柔らかな窓の光、無地の室内背景。
caption例で、万能のH3学習命令ではありません。方法によってキャラクターの外見情報の扱いは違います。互換しない助言を組み合わせず、選んだ方法に従います。
顔が目的なら、trainerが動画対応というだけで無関係な動作動画を加えません。固有動作が重要ならキャラクターを認識でき、その動きを明瞭に示す動画を選びます。静止と動画は別情報で、動画は準備と学習作業も増やします。
間違った成功に注意する
Irisに似ても制作向けではない場合があります。無関係なpromptで同じ背景、強度を上げると戻る旧服、硬い動き、新しいカメラ指示に従わないなどが兆候です。
追加学習だけが修正ではありません。後のcheckpointで認識しやすくても柔軟性が減るなら、以前の方が有用かもしれません。全部同じ背景ならデータが限定的すぎる場合があります。どの適度な強度でも無変化なら、captionへもう一晩使う前に互換性と読み込みを調べます。
別のH3人物学習の議論にもこの交換条件があります。再現度が弱い報告、強い再現度と引き換えに動き、乱れ、指示追従が悪化した報告、良いRefMod、悪い参照結果が混在します。正直に万能の勝者は決められません。
互換LoRAと通常参照は組み合わせられます。アダプターは学習傾向、採用画像は今の顔、服、構図を供給します。役割が明確なら有用で、全強度を上げる理由ではありません。
準備時間と実際に払うもの
原画像があれば通常参照の準備は最小で、一貫したファイルと役割を選びます。RefModsはインストールと抽出を足し、反復操作を減らします。LoRAはデータ、学習、checkpoint選定、互換性確認を加えます。
時間は機材、数、解像度、方法で変わります。上の5時間は特定実行です。予定するtrainerと機材で予算を組みます。
| 費用 | 通常参照 | RefMod | 学習LoRA |
|---|---|---|---|
| 最初の制作 | キャラクターの参照画像と有用な視点 | 同じ原本準備 | より多い変化を含む選定データ |
| 追加準備 | 選択と順番 | インストール、エンコード、確認 | 学習設定・実行、使えるcheckpoint選定 |
| 反復作業 | ファイルやpresetを読む | 保存集を読む | 互換重みとtrigger・設定を読む |
| 生成費用 | endpointと参照料金 | ローカルか借りた計算資源。保存参照にも費用がある | 生成費用とホスト固有の方針 |
| 改訂費用 | 参照交換 | 素材更新 | 学習したキャラクターの外見を変えるなら再学習の可能性 |
ホスト型料金とローカルRefMod費用は別
現在のSpicyAPI H3は通常参照、LoRAページは互換重みも受け付けます。RefModアップロード欄はありません。RefModの.safetensorsをlorasへ入れてLoRAの代わりにはできません。ホスト型で同じ人物を使うなら原本を残します。
承認開始画像なら、H3 LoRA画像から動画は1秒480pで$0.05、768pで$0.10、5秒は$0.25か$0.50です。LoRA読み込みの別料金はありません。5秒4回は$1.00か$2.00、4出力であり採用品4本の保証ではありません。
参照から動画は別です。通常H3は出力秒へ画像1枚$0.0068、H3 LoRAは$0.02を加えます。静止参照だけの5秒の完全な見積もりです。通常H3は480pの提供を終えたため、該当セルはダッシュです。
| 5秒の要求 | 480p | 768p |
|---|---|---|
| H3、キャラクター参照2画像 | — | $0.1986 |
| H3、キャラクター参照2画像と服1枚 | — | $0.2054 |
| H3 LoRA、キャラクター参照2画像 | $0.34 | $0.715 |
| H3 LoRA、キャラクター参照2画像と服1枚 | $0.36 | $0.735 |
通常H3の768p・2枚は5 × $0.037 + 2 × $0.0068 = $0.1986、10回は$1.986です。対応するLoRA参照は768pで$7.15です。内容記録、必要入力、互換重みで選びます。複数回の登場だけでLoRA経路が必要にはなりません。
LoRA参照では、参照動画秒も課金秒に入り、音声は参照ごとの別料金です。保存したローカルRefModは、ホスト型入力や料金を回避しません。動作参照は短くし、静止とpromptにない貢献があるときだけ使います。
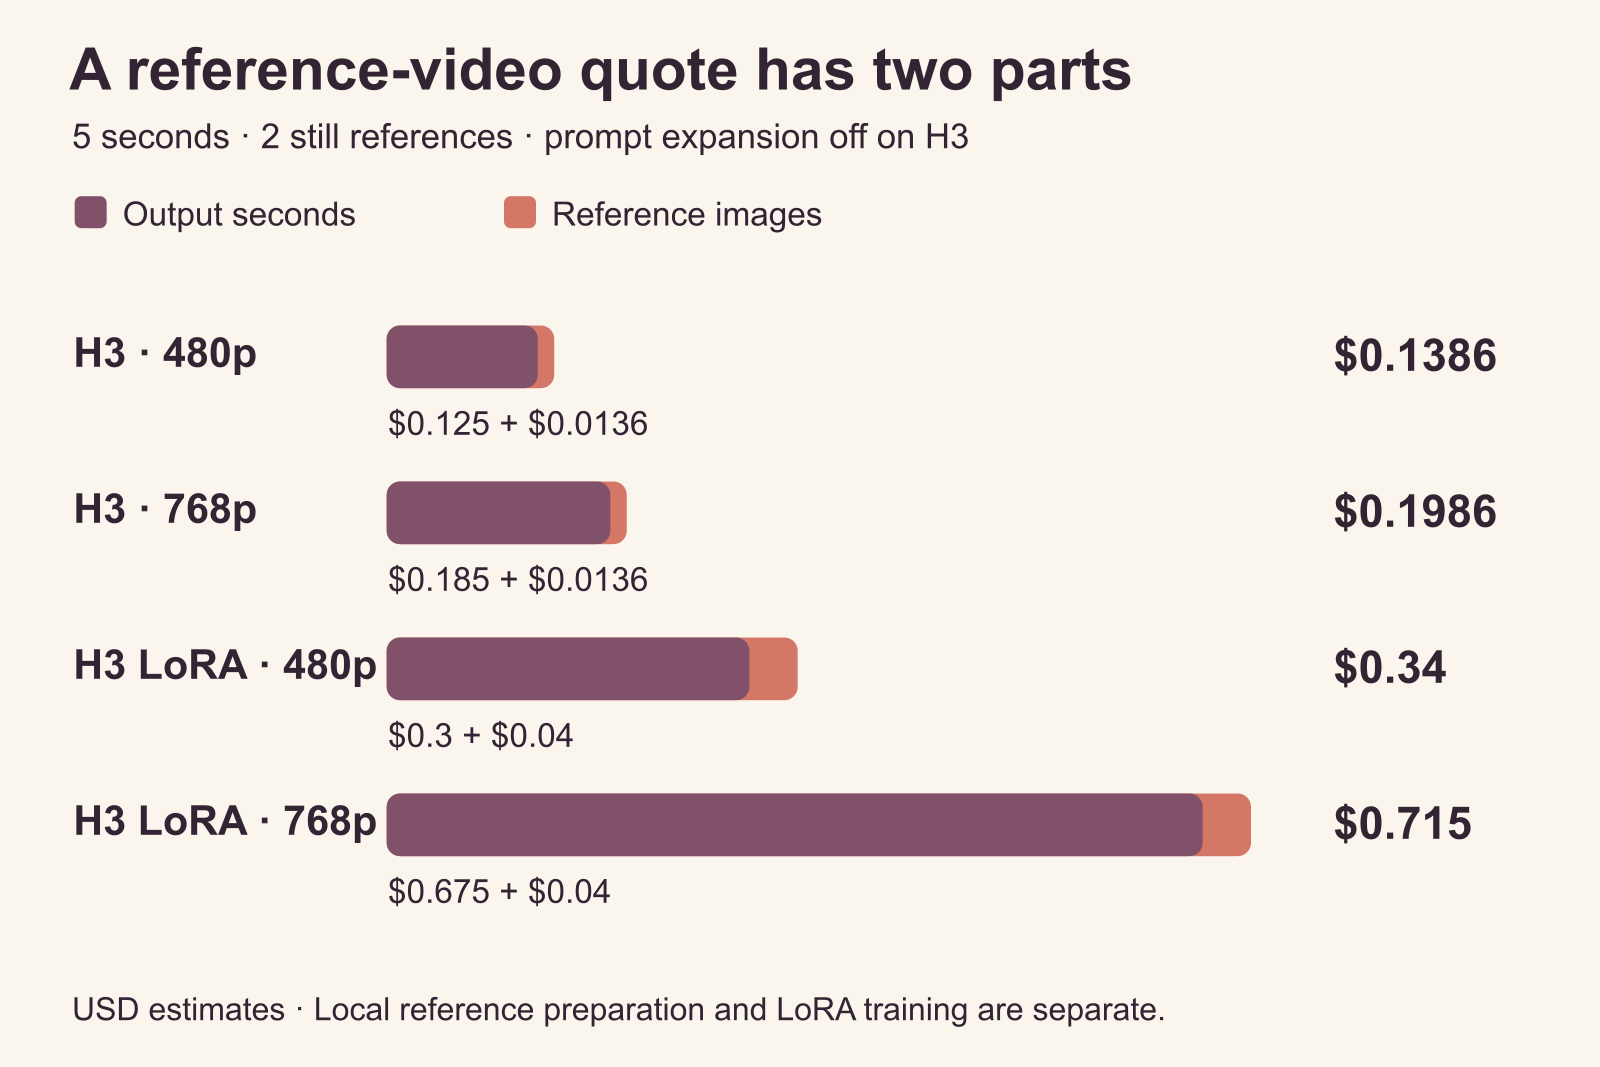
5秒の生成見積もりは静止参照2枚を含みます。準備とLoRA学習は別費用です。
学習で反復作業を十分減らせるか判断する
学習請求は判断の一部です。原本準備、GPUレンタル、中間例、互換しない出力を直す時間も含めます。使える人物が得られなければ、安いGPUも得ではありません。
数本なら適切な既存アダプターがない限り参照を使います。頻繁なら、減らす費用を特定します。反復選択、反復画像料金、遅い参照多用推論、特定の学習した外見に届かないことなどです。
RefModsは主に選択と準備を解きます。LoRAは他を解く可能性がありますが、意図した経路で実際に動いた後です。保存presetで解ける整理問題のために、学習を買いません。
成功出力も正直に数えます。完了6回で2本使えば、採用1本の生成費は単価の3倍です。3方法すべてに当てはまり、安い秒単価より、良い準備や簡単なショットが重要な場合があります。
よくある誤りと次の有用な変更
| 見えるもの | 最初の確認 | 変更 |
|---|---|---|
| 正面は同じキャラクター、回転で別人 | 見せる角度の参照があるか | 採用横を足すか回転を減らす |
| 古い服が戻る | キャラクターの参照すべてにその服があるか | 交換、衣装分離、新開始画像 |
| サムネイルは正しく顔の細部は弱い | 保存した切り抜きと表現 | 明瞭な切り抜きとFull基準で再作成 |
| 保存人物が名前を無視 | 実際のmedia labelを参照しているか | 現mapのlabelへ人物を割り当てる |
| 2人が混ざる | 順番、役割、余分な顔 | label修正、競合顔除去、静かな2人構図 |
| LoRAは読むが有用な違いなし | ベース、タスク、loader互換性 | 再学習前に経路確認 |
| 似るほど動きが崩れる | 強度とcheckpoint | 影響を下げるか以前の使える版 |
| 新部屋が古い部屋になる | 古い部屋を読み込んでいないか | 完全に外す |
| 顔は同じで声が変わる | 別の声処理があるか | 声の一貫性を別制作として扱う |
不要な特徴に最も直接結び付く入力を変えます。服の問題では、checkpoint、sampler、全参照を替える前に衣装参照を直します。
続きにはH3 LoRA APIガイドで既存アダプターとタスク選択、H3版比較で製品の違いを扱います。人物に学習が必要かとは別の判断です。
次の回のために選ぶ
Irisの次回には、承認顔と必要な別視点を選び、意図する成人向け場面に適したタスクで5秒1本を作ります。準備の反復が問題になったらRefModを保存します。参照で供給できない学習能力や配置経路が必要なら互換LoRAを学習します。次の実際の制作の必要性で投資を決めます。