Powracająca dorosła postać musi być rozpoznawalna w następnym odcinku, a nie tylko w portrecie, który ją przedstawił. Gdy masz już lubianą twarz, decyzja MiniMax H3 RefMods kontra LoRA dotyczy ilości pracy powtarzanej po zmianie stroju, kąta aparatu lub drugiej osoby.
Zacznij od zwykłych referencji obrazów. Zapisz RefMod, jeśli już pracujesz w ComfyUI i wielokrotnie używasz tych obrazów. Rozważ trenowanie LoRA, gdy potrzebujesz wyuczonej postaci lub stylu, którego proces referencji nie zapewnia efektywnie. RefMod pakuje informacje referencyjne; nie trenuje postaci w H3. LoRA wymaga treningu, a dodatkowa inwestycja nie daje automatycznie lepszego podobieństwa.
Dla nowej fikcyjnej dorosłej persony przygotowanie kilku spójnych widoków zwykle jest przydatną pierwszą inwestycją. Dla ustalonej cotygodniowej serii biblioteka referencji oszczędza powtarzaną konfigurację. Trening staje się rozsądniejszy, gdy postać jest stabilna i potrafisz nazwać konkretny problem do rozwiązania.
W serii NSFW tożsamość sięga poza pasujący portret: proporcje, cera i charakterystyczne znaki mogą wymagać rozpoznawalności w intymnych zbliżeniach i szerszych scenach dla dorosłych. Omawiane reference-to-video mają różne opublikowane zapisy testów treści: zwykłe H3 dokumentuje wygenerowane umiarkowane obrazy NSFW, a H3 LoRA intensywniejsze sceny dla dorosłych. Obserwacje konkretnych zadań nie porównują RefMods i nie gwarantują każdej sceny; wybieraj obsługę tożsamości i możliwości treści osobno.
| Sytuacja | Od czego zacząć | Powód |
|---|---|---|
| Masz gotowy obraz sceny i chcesz krótki klip | Image-to-video | Kompozycja i strój już istnieją w pierwszej klatce |
| Potrzebujesz tej samej postaci w nowym pokoju lub stroju | Zwykłe reference-to-video | Zmieniasz składniki bez odbudowy zapisanych zasobów |
| Wciąż ładujesz te same referencje w ComfyUI | RefMod | Używasz ponownie zorganizowanego pakietu |
| Chcesz postaci z tekstowego promptu w zgodnym procesie H3 | Trenowana LoRA postaci | Trening może umieścić wyuczoną tożsamość w adapterze |
| Potrzebujesz dwóch nazwanych postaci w ujęciu | Osobne referencje każdej osoby | Jawnie przypisz tożsamości i pozycje przed złożonością |
| Potrzebujesz charakterystycznego powracającego stylu lub ruchu | Odpowiednia LoRA lub referencja | Wybieraj dla zadania; adapter postaci nie jest automatycznie adapterem ruchu |
Poniższe przykłady wykorzystują Iris, fikcyjną postać w wieku 32 lat w serii portretów i wideo dla dorosłych. To praktyczne początkowe opisy, a nie nowo wygenerowane porównania.
Co faktycznie oszczędza każda metoda
Zwykła referencja to obraz lub inne akceptowane medium dostarczone do generowania. Wybierasz je ponownie lub wczytujesz przez zapisany proces narzędzia przy następnym ujęciu. Referencja nie staje się trwałą wiedzą modelu. Nazwanie postaci „Iris” w dziesięciu promptach też nie tworzy trwałej tożsamości.
RefMod zamienia media referencyjne w wielorazowy plik dla zgodnych procesów H3. Oryginalny projekt RefMod wyjaśnia, że ekstrakcja zapisuje reprezentacje referencji VAE bez trenowania wag H3. Tryb Full zachowuje więcej informacji; Compressed wymienia detal na mniej tokenów referencyjnych. Historyczna wewnętrzna nazwa training dotyczy dopracowania skompresowanego latentu, a nie treningu LoRA. Ubranie, tożsamość i tło nadal mogą podróżować razem.
LoRA jest trenowanym adapterem: zbiorem wyuczonych zmian używanych obok modelu bazowego. Oryginalna praca LoRA opisuje zasadę adaptacji niskiego rzędu. W H3 praktycznie musisz przygotować przykłady treningowe i wagi możliwe do załadowania w procesie generowania. Zapis zdjęć w RefMod i dopasowanie LoRA rozwiązują różne problemy, nawet jeśli oba pliki kończą się .safetensors.
| Pytanie | Zwykłe referencje | RefMod | Trenowana LoRA |
|---|---|---|---|
| Co przygotowujesz? | Wybrane obrazy lub akceptowane media | Wybrane media i zgodny proces ekstrakcji | Kuratorowany zbiór treningowy i trener |
| Co wykorzystujesz ponownie? | Oryginalne pliki i ich role w prompcie | Zapisane reprezentacje referencyjne | Wyuczone wagi adaptera |
| Czy wymienisz złe źródło? | Wymieniasz obraz | Odbudowujesz lub edytujesz pakiet | Poprawiasz zbiór i trenujesz ponownie, jeśli problem się wyuczył |
| Czy generowanie jest niezależne od referencji? | Nie | Nie; zapisane referencje nadal warunkują generowanie | Potencjalnie, zależnie od adaptera i zadania |
| Czy gwarantuje tę samą osobę? | Nie | Nie | Nie |
| Czy jest uniwersalnym formatem uploadu H3? | Tylko typy mediów akceptowane przez endpoint | Nie | Tylko zgodne wagi LoRA akceptowane przez loader |
To rozróżnienie jest ważne przy rozczarowaniu zasobem. Jeśli RefMod zawiera niespójny profil, lepsza nazwa pliku nie naprawia twarzy. Jeśli LoRA nauczyła się Iris z jednym kostiumem, nowy kostium może konkurować z wyuczonym związkiem. W obu przypadkach przygotowanie wpływa na wynik; naprawa odbywa się na innym etapie.
Możesz spotkać RefLoRA. Projekt RefLoRA pakuje trenowane wagi LoRA i referencje RefMod w jednym pliku. Zwykły loader używa wag; zgodny łączony może użyć obu. Wspólne pakowanie nie usuwa treningu LoRA, a hostowana usługa nie potrafi automatycznie odczytać części referencyjnej. Ustal zawartość pliku i konsumujący loader zamiast wyboru po rozszerzeniu.
Najpierw ustal, co musi pozostać takie samo
Dla Iris wąsko zdefiniuj powracającą tożsamość: dorosła kobieta w wieku 32 lat, krótki kasztanowy bob, szerokie brwi, prosty nos i rozpoznawalny kształt twarzy. To stałe serii. Czarny strój wieczorowy, kremowy zestaw domowy, światło sypialni i odległość aparatu są wyborami ujęcia.
Oddzielenie zapobiega kosztownemu błędowi zachowywania całego pierwszego obrazu, gdy seria wymaga zmian. Fotografia referencyjna jest kompletną sceną. Zawiera osobę, ubranie, pozę, światło i pokój. „Zachowaj spójność Iris” łatwo rozumie człowiek, ale wejścia nadal muszą wskazać, co należy do Iris, a co do odcinka.
W serii dla dorosłych różne referencje rozwiązują różne problemy rozpoznania:
| Co rozpoznaje odbiorca | Przydatne źródło | Co może zmieniać się ze sceną |
|---|---|---|
| Twarz, brwi i linia włosów | Wyraźny portret i zatwierdzony kąt obrotu | Wyraz twarzy, spojrzenie i makijaż |
| Budowa i względne proporcje | Zatwierdzony szerszy widok z ramionami, talią i postawą | Poza, aparat i strój |
| Mały powracający tatuaż ramienia | Wyraźny rzeczywisty projekt i położenie | Światło i widoczność w kadrze |
| Stylizacja konkretnego zestawu | Wybrany strój i ułożenie włosów | Stylizacja następnego odcinka |
Kadr twarzy nie ustala proporcji Iris w szerszej scenie. Odległa pełna sylwetka może pokazać postawę z małą ilością użytecznych detali twarzy. Jeśli tatuaż zmienia kształt, dodaj wyraźne źródło tego detalu zamiast siły każdej referencji. Gdy położenie jest kluczowe, ustal je w obrazie początkowym przed animacją. Podział zasobów działa dla portretów, salonu lub dojrzalszej sceny; ujęcie określa, które informacje muszą być widoczne.
Przygotuj mały folder trzech typów materiałów:
- Widoki tożsamości: wyraźny portret, trzy czwarte i profil zaakceptowane jako ta sama osoba.
- Przykłady garderoby: obraz każdego powracającego stroju, w miarę możliwości osobno od wyboru tożsamości.
- Obrazy sceny: pusty pokój lub zatwierdzona klatka początkowa konkretnego ujęcia.
To organizacja pracy, a nie wymagana wielkość zbioru. Spokojny portret może potrzebować pierwszego obrazu. Obrót korzysta z zatwierdzonego widoku ujawnianych cech. Pokój nie ma użytecznej roli w bliskiej referencji twarzy, jeśli co tydzień się zmienia.
Przy wyborze tożsamości porównuj szczękę, nos, brwi i linię włosów przed urodą. Atrakcyjniejszy portret nadal może być niewłaściwą osobą. Odrzucenie teraz kosztuje mniej wysiłku niż pakiet sprzecznych twarzy.
Oddziel trwałą cechę od stylizacji. Jeśli Iris czasem spina włosy, zestaw powinien rozpoznawać twarz bez pełnej zależności od boba. Jeśli dodatek zmienia się ze strojem, nie czyń go jedyną cechą oddzielającą Iris od innej postaci.
To samo dotyczy dojrzałych obrazów postaci. Źródło nie musi odtwarzać intensywności i kompozycji każdej przyszłej sceny. Wybieraj referencje tożsamości dla czytelnej tożsamości i odpowiednią ścieżkę dla sceny. Ani pakowanie referencji, ani trening nie określa realizowanych próśb dla dorosłych konkretnego endpointu.
Zwykłe referencje: najlepszy początek nowej serii
Zwykłe referencje przydają się, gdy ustalasz postać, garderoba często się zmienia lub chcesz hostowanego Playground bez utrzymania ComfyUI.
Ujawniają też błędy czytelnie. Widzisz dokładne dostarczone obrazy, usuwasz konfliktowy i uruchamiasz kolejne ujęcie. Prostota ma wartość przed ustaleniem postaci. Złożony zapisany pakiet może utrudniać zauważenie słabego obrazu.
Zbuduj pięć sekund z dwóch widoków tożsamości
Użyj przodu Iris jako Picture 1 i zaakceptowanego trzy czwarte jako Picture 2. W pierwszym ujęciu opisz otoczenie tekstem, aby obie referencje miały jeden cel: osobę.
Hostowane MiniMax H3 reference-to-video przyjmuje do dziewięciu referencji i daje 4–15 sekund. Zacznij od pięciu sekund w 768p i pionowego 9:16: $0.1986 z tymi dwoma obrazami. Większy wynik wybierz po uzyskaniu kierunku wartego zachowania.
Picture 1 i Picture 2 pokazują tę samą fikcyjną dorosłą kobietę Iris w wieku 32 lat. Użyj ich dla tożsamości twarzy, krótkiego kasztanowego boba i proporcji. Iris nosi grafitową satynową suknię wieczorową. Siedzi obok ciepłej lampki nocnej w spokojnym mieszkaniu, potem powoli obraca twarz z trzy czwarte ku aparatowi. Średnie zbliżenie, aparat na wysokości oczu, delikatny wyraz, stabilny kadr. Twarz wyraźnie czytelna przez cały obrót. Audio: delikatne odgłosy pokoju.
Opis daje referencjom jedno zadanie, tekstowi drugie. Nie wymaga jednocześnie zachowania starego tła, starego stroju i wymyślenia pokoju. Powściągliwy obrót daje też jasne działanie bez kilku póz.
Jeśli źródła już pokazują grafitową suknię do zachowania, powiedz to. Jeśli jedno ma marynarkę, opisz docelową suknię jako garderobę wyniku. Gdy marynarka powraca, wymień lub przytnij referencję, zamiast dodawać akapit sukni.
Użyj pierwszej klatki, gdy scena jest właściwa
Załóżmy, że już stworzyłeś zamierzoną kompozycję: Iris w kremowym domowym zestawie przy lampie, z właściwą miną i pokojem. Image-to-video jest bezpośrednim krokiem. Zaczyna z zaakceptowanego obrazu; reference-to-video buduje nowe ujęcie ze składników.
Odpowiedni opis ruchu:
Iris, fikcyjna dorosła kobieta z pierwszej klatki, delikatnie podnosi wzrok ku aparatowi i lekko, swobodnie się uśmiecha. Ramiona pozostają w tej samej pozycji. Aparat wykonuje powolne małe zbliżenie. Lampa pozostaje stabilna. Audio: ciche odgłosy wnętrza.
Praktyczna różnica to miejsce wysiłku. Używaj referencji, gdy kompozycja jest jeszcze potrzebna. Używaj pierwszej klatki, gdy jest gotowa i pozostał ruch. Trening LoRA wyłącznie dla animowania jednego gotowego obrazu dodaje osobny projekt przed natychmiastowym zadaniem.
Pierwsza klatka nie obiecuje idealnej dalszej każdej klatki. Jeśli długi obrót odsłania nieznany profil, skróć obrót lub przygotuj lepszy kąt startu. Warto rozwiązać projekt ujęcia przed uznaniem całej metody tożsamości za nieudaną.
RefMods: przydatne przy powtarzanym przygotowaniu referencji
RefMods stają się atrakcyjne, gdy lubisz postać, już używasz ComfyUI i ciągle odbudowujesz kolekcję. Oszczędność jest organizacyjna i obliczeniowa: nazwany zasób zastępuje wybór i przygotowanie źródeł.
Zapisany plik różni się od korzystającego procesu. Różne węzły H3 mogą inaczej prezentować referencje. Dobry wynik grafu jednego twórcy nie dowodzi tej samej postaci z każdego loadera RefMod.
Fantastic H3 Prompt Builder Adudeguyman dodaje menedżer referencji i edytor promptu. Mapa referencji pokazuje etykiety rzeczywistych wejść. Nowsze wersje mogą zapisywać klatki encodera i eksperymentalnie wybierać liczbę zdjęć widzianych przez encoder tekstu. Więcej zdjęć może zwiększać pamięć i czas. To kontrolki procesu, a nie gwarancja tożsamości.
Stwórz wielorazowy zasób Iris
Poradnik RefMod projektu podaje instalację i instrukcje węzłów. Dla postaci przydatna sekwencja:
- Zacznij od działającego procesu referencji H3 i zgodnego VAE.
- Otwórz tworzenie w bibliotece RefMod i dodaj zatwierdzone obrazy Iris.
- Sprawdź podglądy przycięcia. Pierwszy obraz ustala kształt połączonego zestawu; popraw źródła tracące twarz lub włosy.
- Wybierz Full jako bazę tożsamości, nazwij postać i utwórz pakiet.
- Dodaj zapisany zasób do stosu. Odczytaj mapę referencji przed napisaniem roli osoby w prompcie.
Zachowaj oryginały. Zapisana referencja jest wygodna, lecz folder źródeł pozwala usunąć zły widok, zrobić inny kadr lub przejść później do innej aplikacji.
Nie zapisuj każdego zdjęcia historii Iris w jeden główny zasób. Przydatny zasób powinien być łatwy do wyjaśnienia: „zatwierdzone widoki Iris”. Nie powinien oznaczać też „trzy pokoje, cztery stroje, stara fryzura i druga postać obecna raz”.
Odczytaj zapisany wynik przed obwinieniem generowania
Kadrowanie i kompresja mogą usuwać właśnie cechę do zachowania. Miniatura portretu w przeglądarce plików nie dowodzi zawartości pełnego portretu z oczekiwanymi detalami.
Jeśli oryginał ma wyraźną twarz, ale zapisany podgląd miękką, wąską lub przyciętą, najpierw popraw zasób. Dla serii portretów mniejsza kolekcja wyraźnych widoków jest rozsądniejsza niż ogromny pakiet ze zmniejszonymi ważnymi detalami.
Full i Compressed są przydatne, lecz „mniejszy plik” nie jest „bezpłatnym warunkowaniem”. Mały zapisany plik nadal wnosi informacje podczas generowania. Z kolei więcej detali może zachować niechciany pokój lub strój obok twarzy. Wybierz pożądane informacje przed regulowaniem siły.
Dla Iris zachowaj zasób tożsamości i osobny opcjonalny pokój. Ładuj tylko potrzebne. Jeśli scena jest w innym mieszkaniu, całkowicie pomiń stary pokój. Obniżanie jego siły jest pośrednią naprawą, gdy nie ma roli w nowym klipie.
Dlaczego wyniki społeczności wydają się sprzeczne
W dyskusji treningu postaci H3 autor zgłaszał około pięciu godzin treningu na RTX 5090 bez zadowalającego podobieństwa. Odpowiedzi chwaliły RefMods, inni zgłaszali gorsze podobieństwo lub dłuższe generowanie niż przy zwykłych referencjach. Dyskusja kwestionowała też pomysł, że pakowanie wielu obrazów tworzy nowo trenowaną tożsamość.
Relacje wspierają użyteczne rozróżnienie: wygoda, szybkość i podobieństwo są osobnymi korzyściami. RefMod może być wygodny bez szybkości w twoim grafie. Może oszczędzać przygotowanie bez poprawy twarzy. Udany przykład może zależeć od checkpointu, kadrów, prezentacji referencji i promptu oraz zasobu.
Aktualizacja autora Prompt Builder zgłaszała mniej mieszania postaci po zmianie przekazywania referencji do encodera tekstu, z dodatkowym czasem i pamięcią. Ten sam post nadal opisywał zamienianie głosów. To wynik konkretnej implementacji z problemami, a nie dowód zastąpienia LoRA postaci przez RefMods dla wszystkich.
Zmieniaj stroje bez zmiany postaci
Powracające dorosłe persony często potrzebują rozpoznania i nowości. Twarz jest znajoma, a stylizacja zmienia się między portretami, salonem i ubraną sekwencją wieczorową. Wtedy wygodny pakiet może stać się zbyt szeroki.
Jeśli każda referencja Iris pokazuje tę samą ciemną satynową suknię, może być mocną częścią instrukcji. Pięć obrazów niepowiązanych kostiumów daje więcej informacji, ale też konkurujące dowody garderoby.
Praktyczna organizacja:
| Zasób | Co należy do niego | Kiedy używać |
|---|---|---|
| Tożsamość Iris | Zatwierdzone widoki spójnych cech twarzy | Każde ujęcie ustalonej osoby |
| Garderoba wieczorowa | Wyraźny widok docelowej sukni i stylizacji | Sekwencja wieczorowa |
| Garderoba domowa | Wyraźny widok kremowego stroju | Sekwencja domowa |
| Scena mieszkania | Pokój bez konkurujących postaci | Ujęcia tego konkretnego pokoju |
| Zatwierdzona pierwsza klatka | Iris, wybrany strój i finalna kompozycja razem | Image-to-video dokładnej konfiguracji |
To mogą być zwykłe pliki. Twórz RefMods tylko dla stale używanych części zgodnego procesu lokalnego. Stały pakiet jednorazowego rekwizytu nie ma korzyści.
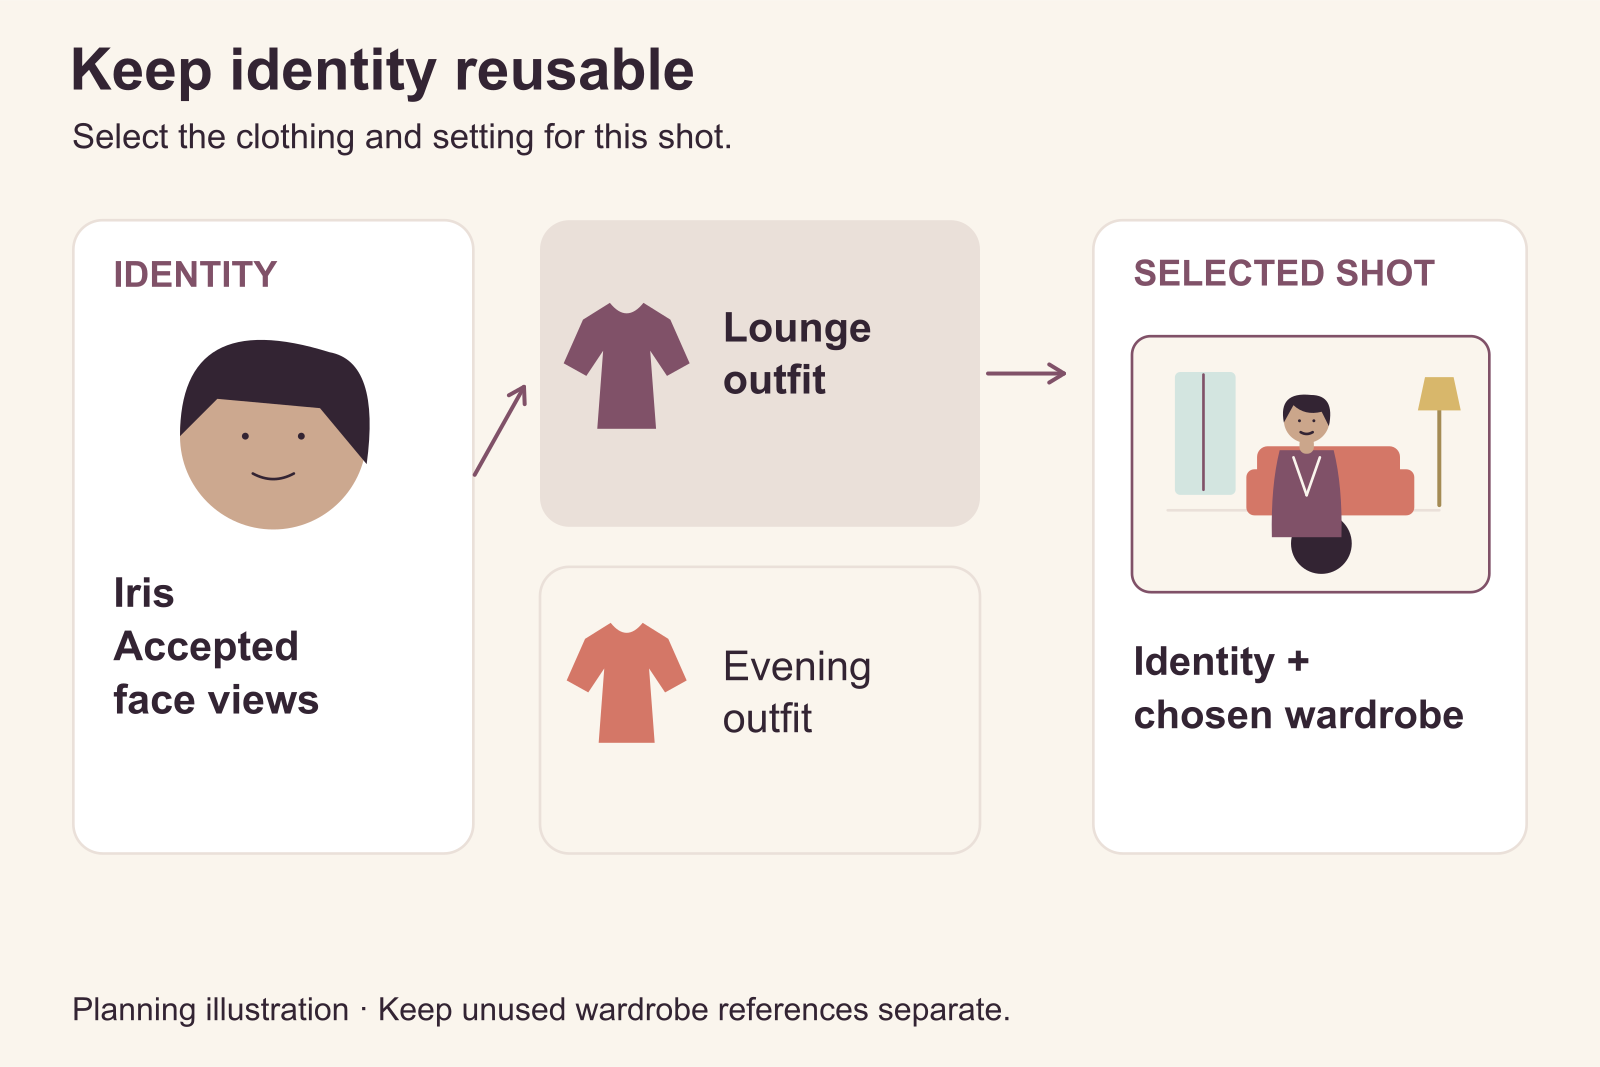
Ilustracja: pozostaw powracającą tożsamość wielorazową, wybierając strój i otoczenie dla ujęcia.
Daj nowemu strojowi jasne źródło
Dla nowej garderoby zachowaj te same dwa obrazy referencyjne tożsamości i dodaj strój jako Picture 3. Preferuj źródło samego ubrania lub kadr czytelnego stroju bez twarzy innej osoby jako konkurencji.
Picture 1 i Picture 2 definiują Iris, tę samą fikcyjną dorosłą kobietę w wieku 32 lat. Picture 3 definiuje kremowy strój domowy tej sceny. Pokaż Iris siedzącą w fotelu obok ciepłej lampy w tym stroju. Zachowaj twarz z Pictures 1 i 2. Opiera jedną dłoń na podłokietniku i powoli patrzy ku oknu. Średnie ujęcie z widoczną twarzą. Audio: ciche odgłosy pokoju.
Jeśli obraz stroju ma inną osobę, szczególnie wyraźnie określ cel. Jeszcze lepiej usuń jej twarz z referencji, gdy nie tracisz przydatnych detali ubrania.
Gdy stary kostium powraca, najpierw zrób edytowany obraz w nowym. Po poprawnej twarzy i garderobie razem animuj zaakceptowany obraz. Przenosi sporną decyzję ubrania do bezpośrednio sprawdzalnego statycznego wyniku.
Może to być szybsze w zarządzaniu niż ciągłe żądanie rozwiązania tożsamości, konstrukcji kostiumu i ruchu w pięciu sekundach. Daje też wielorazową pierwszą klatkę kilku krótkich klipów tej garderoby.
Trwałe przeprojektowanie postaci wymaga nowego zatwierdzonego zestawu; oddziel od starego dla wcześniejszych odcinków. Zmieniona tożsamość może uzasadniać ponowny trening LoRA. Nowa suknia zwykle najpierw potrzebuje referencji garderoby lub pierwszej klatki.
Dwie postacie potrzebują jawnych ról
Dwa RefMods nie tworzą automatycznie dwóch niezależnie sterowanych osób. Dwie LoRA też nie rezerwują automatycznie połowy kadru dla każdej tożsamości.
Model musi ustalić obecność, przypisanie informacji i działanie każdej osoby. Utrudniają to podobne fryzury, ubrania i opisy twarzy oraz niejasne „ona obraca się ku niej”.
Wprowadź drugą fikcyjną dorosłą postać Alexa w wieku 35 lat. Daj wyraźnie inną krótką fryzurę i osobną referencję. Różnice pomagają opisać ujęcie; nie zastępują prawidłowego źródła tożsamości.
Prosty pierwszy układ zwykłych referencji:
- Pictures 1 i 2: przód i trzy czwarte Iris.
- Pictures 3 i 4: odpowiadające widoki Alexa.
- Pokój i ubranie: opisane tekstem, chyba że osobna referencja potrzebna.
Napisz relację referencji do sceny:
Pictures 1 i 2 pokazują Iris, fikcyjną dorosłą kobietę w wieku 32 lat. Pictures 3 i 4 pokazują Alexa, fikcyjnego dorosłego mężczyznę w wieku 35 lat. Iris stoi po lewej w grafitowej sukni wieczorowej; Alex po prawej w ciemnej koszuli z otwartym kołnierzem. Wymieniają spokojny uśmiech obok okna mieszkania. Iris obraca się ku Alexowi, a Alex nadal patrzy na Iris. Średnie ujęcie dwóch osób, obie twarze widoczne, aparat nieruchomy. Audio: delikatne wieczorne odgłosy pokoju.
Pozycje lewo/prawo zmniejszają niejasność prostego układu. Imiona zastępują zaimki działania. Nieruchomy aparat unika w pierwszym ujęciu przecinania ruchu, zamiany stron ekranu i wspólnego odwrócenia.
Dla lokalnych RefMods używaj etykiet bieżącej mapy referencji. Wieloobrazowy RefMod może pojawiać się jako referencja wideo, a nie obrazu; nie zgaduj numeru z nazwy pliku i nie kopiuj starych numerów po zmianie stosu.
Oficjalny poradnik referencji H3 oddziela widoczne osoby od dostarczających je mediów. To pomaga: Iris jest osobą; obraz lub wideo źródłem informacji. Opiszesz miejsce w nowym ujęciu bez odtwarzania całej sceny źródłowej.
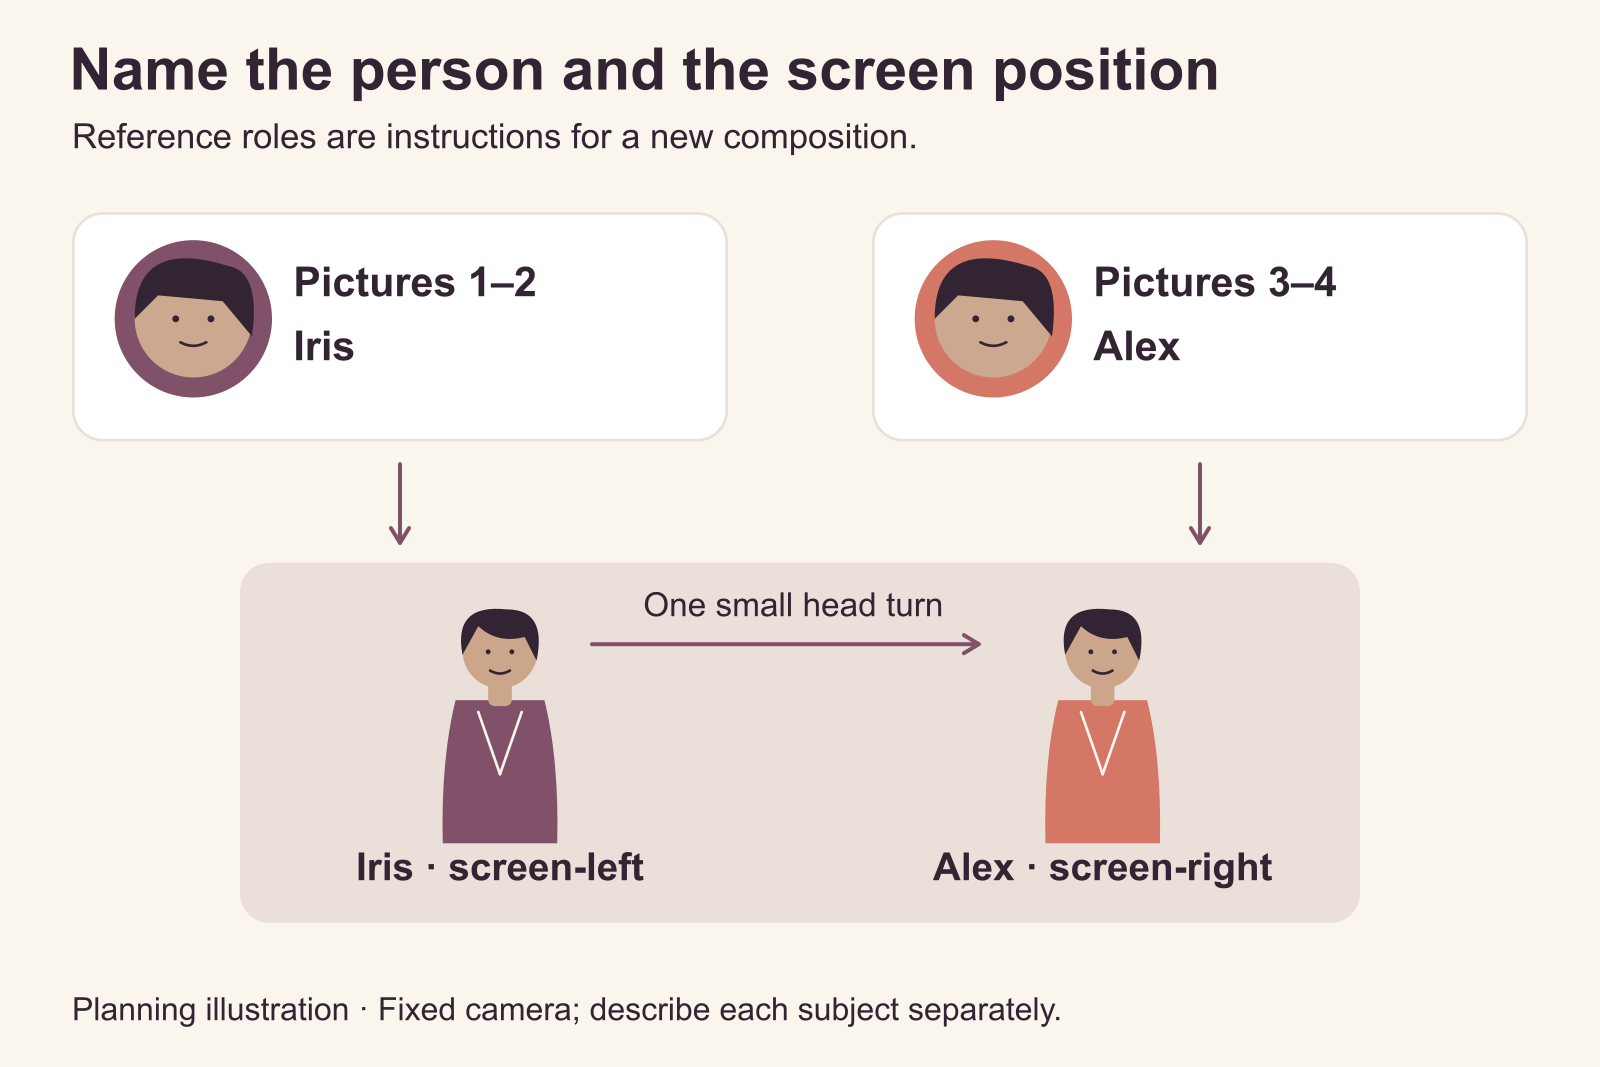
Ilustracja: osobno przypisz źródła, osobę i pozycję ekranową.
Jeśli twarze się mieszają, najpierw uprość kompozycję
Gdy Alex dziedziczy włosy Iris lub Iris kształt twarzy Alexa, najpierw sprawdź zgodność źródeł i etykiet. Źle przypisany obraz może wyglądać jak błąd jakości tożsamości.
Jeśli etykiety są dobre, uprość role wizualne: obie twarze widoczne, osobne pozycje, bez przecinania ruchu w pierwszym wspólnym ujęciu. Usuń referencję garderoby z trzecią rozpoznawalną twarzą. Jeśli para działa osobno, ale stale miesza się razem, przygotuj pierwszą klatkę dwóch zaakceptowanych tożsamości i animuj spokojną interakcję.
Możesz też zmienić montaż. Przeplataj pojedyncze i ujęcia przez ramię, zamiast każdego momentu historii w ruchomym dwuosobowym ujęciu. To praktyczny wybór, gdy wiarygodna ciągłość znaczy więcej niż stała widoczność obu twarzy.
Żadna zmiana nie gwarantuje trudnej interakcji. Rozwiązują konkretne niejasności przed budową kolejnych zasobów tożsamości.
Oddziel tożsamość głosu od wizualnej
Postać wyglądająca spójnie, lecz mówiąca innym głosem w każdym odcinku nadal wydaje się inna. Zapisanie audio obok wizualnego RefMod nie ustanawia jednak niezawodnego związku głosu i twarzy.
Notatki walidacji projektu RefMod odnotowują nieudany transfer tożsamości mówcy i niepełne pokrycie generowania. Traktuj audio jako osobną możliwość do oceny rzeczywiście używanego procesu.
Dla pierwszej wizualnej sekwencji Iris wystarcza otoczenie. Jeśli stabilny mówiony głos jest konieczny, zaplanuj osobny proces głosu i dialogu zamiast założenia rozwiązania przez łączony plik RefMod. Trenowana wizualna LoRA postaci też nie dowodzi trenowanego głosu.
Kiedy trening LoRA postaci zasługuje na miejsce
Trening ma sens, gdy tożsamość jest ustalona i potrzebujesz czegoś konkretniejszego niż łatwy wybór referencji.
Trzy sytuacje uzasadniają poważne rozważenie:
- Chcesz postaci przez text-to-video ze zgodnym adapterem zamiast dużego zestawu do każdego ujęcia.
- Potrzebujesz powracającego wyuczonego stylu lub zachowania niedostatecznie wyrażonego zwykłymi referencjami.
- Masz już działającą produkcję LoRA i chcesz w niej tej postaci.
Samo „robię serię” nie wystarcza. Dziesięć starannie skomponowanych portretów może dobrze działać z pierwszymi klatkami. Znacznie większa seria może uzasadniać trening, ale tylko jeśli adapter redukuje realną pracę lub dodaje potrzebną możliwość.
Trenuj dla procesu, w którym adapter będzie działać
H3 nie jest jednym zamiennym plikiem wag. Ścieżki FL2VA i Ref2VA potrzebują świadomej kompatybilności. Dokumentacja Ref2VA AI Toolkit wskazuje osobne wagi Ref2VA i odpowiadający adapter treningowy. Nazwa H3 nie dowodzi zgodności z każdym zadaniem hostowanym lub lokalnym checkpointem.
Przed treningiem ustal główny wynik: text-to-video, animację pierwszej klatki czy wideo warunkowane referencją. Przekaż zadanie osobie konfigurującej trener. Imponująca konfiguracja w jednym grafie inferencji nie jest automatycznie zasobem do innego.
Używaj aktualnych instrukcji H3 trenera zamiast learning rate i kroków z udanego poradnika Wan lub modelu obrazu. Bieżąca dokumentacja Musubi H3 wspiera kilka zadań treningowych i osobne metody zachowania zachowania modelu bazowego. Wybory wpływają na uczenie adaptera i możliwe zaburzenia.
Przygotuj zbiór uczący postaci, a nie jednego zdjęcia
Przydatny zbiór Iris pokazuje tożsamość w zmienności wymaganej przez serię. Powinien zawierać czytelne twarze pod właściwymi kątami, szersze kadry dla proporcji i więcej niż jeden strój i światło.
Nie twórz różnorodności z niespójnych Iris. Dwadzieścia obrazów tej samej zaakceptowanej osoby jest spójniejsze niż dwadzieścia pięknych stopniowo zmieniających nos i szczękę. Dziesiątki prawie identycznych kadrów jednego portretu też nie dają brakującego profilu.
Opisuj zmiany: strój, kadr, minę i scenę. Zachowuj nazewnictwo tożsamości zgodne z metodą trenera. Dla konfiguracji ze słowem aktywującym podpis może być prosty:
irisvale, fikcyjna dorosła kobieta w wieku 32 lat, portret trzy czwarte, kremowy dzianinowy top, swobodny wyraz, miękkie światło okna, proste wnętrze w tle.
To przykład podpisu, a nie uniwersalne polecenie treningu H3. Niektóre metody świadomie inaczej obsługują tożsamość. Postępuj według wybranej metody zamiast łączenia niezgodnych instrukcji.
Jeśli celem jest tożsamość twarzy, nie dodawaj niepowiązanych klipów ruchu tylko dlatego, że trener przyjmuje wideo. Jeśli ważny jest charakterystyczny ruch, wybierz klipy wyraźnie pokazujące go i rozpoznawalną osobę. Obrazy i wideo dostarczają różnych informacji; wideo dodaje też przygotowanie i trening.
Uważaj na niewłaściwy rodzaj sukcesu
Próbka może przypominać Iris i nadal być słabym adapterem produkcji. Ostrzeżenia obejmują to samo tło w innych promptach, powrót starego kostiumu przy większej sile, sztywny ruch lub ignorowanie nowego kierunku aparatu.
Naprawą nie zawsze jest więcej treningu. Jeśli późniejsze checkpointy zwiększają rozpoznanie, ale tracą elastyczność, wcześniejszy może być przydatniejszy. Jeśli wszystkie odtwarzają tło treningu, zbiór może być zbyt specyficzny. Jeśli adapter nie zmienia nic przy rozsądnej sile, zbadaj zgodność i ładowanie przed kolejną nocą podpisów.
Osobna dyskusja społeczności treningu postaci H3 opisuje ten kompromis: część znalazła słabe podobieństwo, inny użytkownik silniejsze podobieństwo z gorszym ruchem, artefaktami lub wykonywaniem instrukcji. Są też pozytywne RefMod i rozczarowujące referencje. Relacje nie mają uczciwego uniwersalnego zwycięzcy.
Możesz połączyć zgodną LoRA ze zwykłymi referencjami. Adapter dostarcza wyuczoną tendencję, zaakceptowany obraz obecną twarz, strój lub kompozycję. Przydaje się, gdy komponenty mają jasne zadania; nie uzasadnia zwiększania każdej dostępnej siły.
Czas przygotowania i rzeczywiste opłaty
Zwykłe referencje mają najmniejszy wysiłek konfiguracji przy istniejących źródłach. Wybierasz spójne pliki i role. RefMods dodają instalację i ekstrakcję, potem redukują obsługę. LoRA dodaje zbiór, trening, wybór checkpointów i kompatybilność.
Czas zależy od sprzętu, liczby źródeł, rozdzielczości i metody. Pięciogodzinna próba społeczności opisuje konkretne uruchomienie; budżetuj sesję według docelowego trenera i sprzętu.
| Koszt | Zwykłe referencje | RefMod | Trenowana LoRA |
|---|---|---|---|
| Początkowa praca kreatywna | Obrazy tożsamości i przydatne widoki | To samo przygotowanie źródeł | Kuratorowany zbiór, często bardziej różnorodny |
| Dodatkowe przygotowanie | Wybór i kolejność | Instalacja, kodowanie i przegląd zasobu | Konfiguracja i trening; wybór użytecznego checkpointu |
| Powtarzana praca | Wczytanie plików lub presetu | Wczytanie pakietu | Wczytanie zgodnych wag i aktywacji/ustawień |
| Koszt generowania | Endpoint i opłaty referencji | Lokalny lub wynajęty compute; referencje nadal kosztują | Generowanie i polityka adaptera hosta |
| Koszt poprawki | Wymiana źródła | Aktualizacja zasobu | Możliwy ponowny trening zmienianej tożsamości |
Ceny hostowane są osobne od lokalnych kosztów RefMod
Obecne strony H3 SpicyAPI przyjmują zwykłe media referencyjne; LoRA również zgodne wagi. Nie udostępniają pola uploadu RefMod. Plik RefMod .safetensors nie zastępuje LoRA w loras. Zachowaj źródła, jeśli chcesz tej samej postaci hostowanej.
Dla zatwierdzonej pierwszej klatki H3 LoRA image-to-video kosztuje $0.05 za sekundę w 480p i $0.10 w 768p. Pięć sekund to $0.25 lub $0.50. Ładowanie LoRA nie dodaje opłaty tego zadania. Cztery generowania pięciu sekund kosztują $1.00 lub $2.00; to cztery wyniki, a nie gwarantowane cztery użyteczne ujęcia.
Reference-to-video ma inny rachunek. Zwykłe H3 nalicza $0.0068 za referencję ponad sekundy. H3 LoRA reference-to-video $0.02 za obraz. Pełne szacunki pięciu sekund tylko z referencjami zdjęć. Zwykłe H3 nie oferuje już 480p, więc te komórki mają myślnik:
| Żądanie pięciu sekund | 480p | 768p |
|---|---|---|
| H3, dwa obrazy tożsamości | — | $0.1986 |
| H3, dwa obrazy tożsamości i jeden garderoby | — | $0.2054 |
| H3 LoRA, dwa obrazy tożsamości | $0.34 | $0.715 |
| H3 LoRA, dwa obrazy tożsamości i jeden garderoby | $0.36 | $0.735 |
Na przykład zwykłe H3 768p z dwoma zdjęciami to 5 × $0.037 + 2 × $0.0068 = $0.1986. Dziesięć daje $1.986. Odpowiadające żądania referencji H3 LoRA w 768p to $7.15. Wybieraj według konkretnego zapisu treści dla dorosłych, wymaganych wejść i zgodnych wag. Postać w wielu odcinkach sama nie wymaga ścieżki LoRA.
W referencyjnym zadaniu LoRA sekundy wideo wejściowego też liczą się do naliczanych, a referencje audio dodają własną opłatę. Zapisany lokalny RefMod nie omija hostowanych typów i cen. Skracaj referencję ruchu i używaj tylko dla wkładu nieobecnego w obrazach i prompcie.
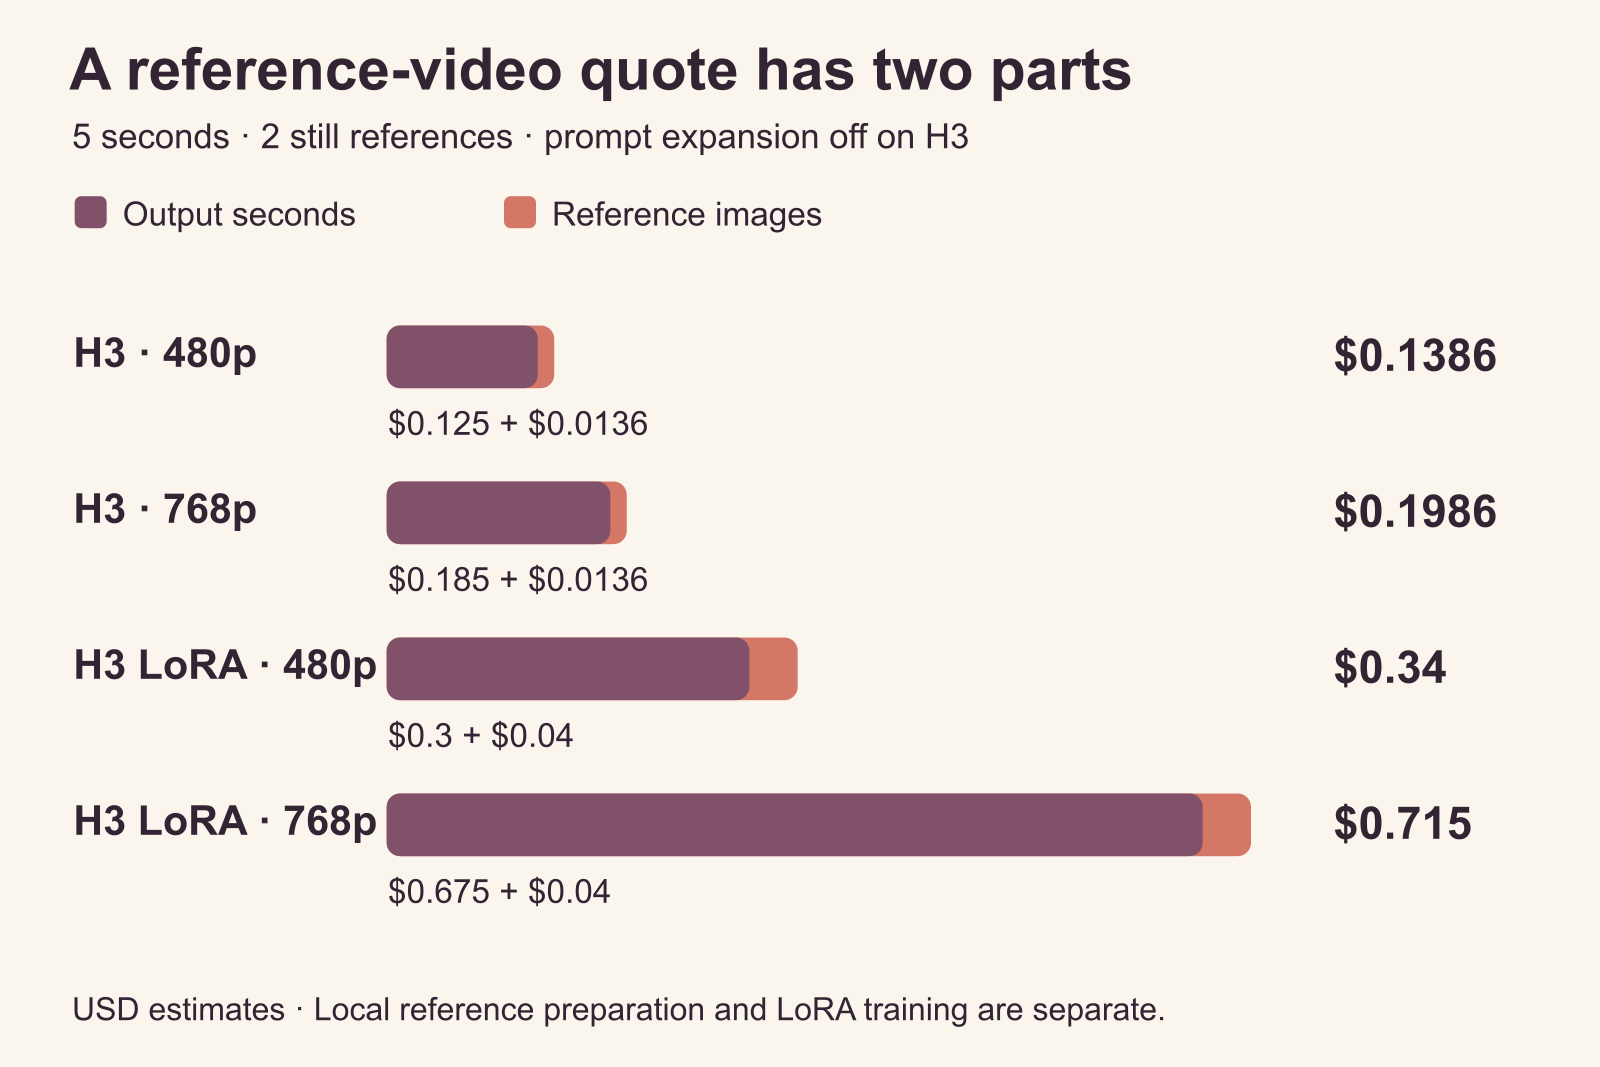
Szacunki generowania pięciu sekund obejmują obie referencje obrazów. Przygotowanie i trening LoRA to osobne koszty.
Ustal, czy trening oszczędza dość powtarzanej pracy
Rachunek treningu jest tylko częścią decyzji. Dodaj źródła, wynajem GPU, próbki pośrednie i czas naprawy niezgodnych wyników. Niska cena GPU nie jest okazją, jeśli adapter nigdy nie daje użytecznej postaci.
Dla kilku klipów zostań przy referencjach, chyba że masz odpowiedni adapter. Dla częstych wyników nazwij redukowany wydatek: powtarzany wybór, opłaty obrazów, wolna inferencja z wieloma referencjami lub brak konkretnego wyuczonego wyglądu.
RefMods głównie rozwiązują powtarzany wybór i przygotowanie. LoRA może rozwiązać inne, ale dopiero po faktycznym działaniu w docelowej ścieżce. Nie kupuj treningu dla problemu organizacji już rozwiązanego presetem referencji.
Licz też uczciwie wyniki. Jeśli płacisz za sześć ukończonych i używasz dwóch, wydatek generowania użytecznego wyniku jest trzy razy większy od stawki. Arytmetyka dotyczy trzech metod. Lepsze źródła lub prostsze ujęcie mogą znaczyć więcej niż najtańsza reklamowana sekunda.
Częste błędy i następna przydatna zmiana
| Co widzisz | Co sprawdzić najpierw | Co zmienić |
|---|---|---|
| Przód rozpoznawalny, obrót daje inną osobę | Czy źródła pokazują ujawniony kąt | Dodaj zatwierdzony profil lub zmniejsz obrót |
| Pierwotny strój powraca | Czy każde źródło tożsamości go ma | Wymień źródło, oddziel strój lub przygotuj początek |
| RefMod ma dobrą miniaturę, słabą twarz | Zapisany kadr i reprezentację | Odbuduj wyraźniejszy kadr i bazę Full |
| Zapisana postać ignoruje imię | Czy prompt wskazuje rzeczywistą etykietę mediów | Przypisz osobę do etykiety bieżącej mapy |
| Dwie postacie się mieszają | Kolejność, role i dodatkowe twarze | Popraw etykiety, usuń konkurencję, zacznij statycznym ujęciem dwóch osób |
| LoRA ładuje się bez przydatnej różnicy | Zgodność bazy, zadania i loadera | Potwierdź inferencję przed ponownym treningiem |
| Podobieństwo rośnie, ruch się załamuje | Siłę i checkpoint | Obniż wpływ lub użyj wcześniejszego przydatnego checkpointu |
| Nowy pokój staje się starym | Czy stare informacje pokoju nadal są wczytane | Całkowicie usuń starą referencję |
| Twarz stabilna, głos zmienia się | Czy istnieje osobne rozwiązanie głosu | Traktuj tożsamość dialogu osobno |
Zmieniaj wejście bezpośrednio związane z niechcianą cechą. Niechciany strój uzasadnia zmianę garderoby przed checkpointem, samplerem i całym zestawem.
Dalszą pracę opisuje poradnik H3 LoRA API z ładowaniem adaptera i zadaniem. Porównanie wersji H3 wyjaśnia warianty produktu. To osobne decyzje od potrzeby treningu powracającej postaci.
Wybierz dla następnego odcinka
Dla następnego odcinka Iris wybierz zatwierdzony portret i potrzebny inny widok, zadanie odpowiednie dla sceny dla dorosłych i jeden klip pięciu sekund. Zapisz RefMod, gdy problemem staje się przygotowanie źródeł. Trenuj zgodną LoRA, gdy seria potrzebuje wyuczonej możliwości lub wdrożenia niedostarczanego przez referencje. Niech następna realna potrzeba produkcji wyznacza inwestycję.