Постоянный взрослый персонаж должен быть узнаваем в следующем эпизоде, а не только в первом портрете. Когда лицо выбрано, решение MiniMax H3 RefMods или LoRA касается объёма работы, который придётся повторять при смене одежды, угла камеры или второго человека.
Начните с обычных референсов изображений. Сохраните RefMod, если уже работаете в ComfyUI и часто используете те же картинки. Рассмотрите обучение LoRA, когда нужна усвоенная моделью внешность или стиль, которые референсный процесс не даёт эффективно. RefMod упаковывает информацию референса, а не обучает H3 персонажу. LoRA требует обучения, и эти вложения не гарантируют лучшего сходства.
Для новой вымышленной взрослой персоны первая полезная инвестиция — несколько согласованных видов. Для устоявшейся еженедельной серии библиотека референсов экономит повторную настройку. Обучение становится разумнее, когда персонаж стабилен и можно назвать конкретное ограничение для решения.
В NSFW-серии идентичность шире совпадающего портрета: пропорции, тон кожи и характерные отметины должны быть узнаваемы в личных крупных планах и широких взрослых сценах. У рассматриваемых reference-to-video задач разные опубликованные проверки: обычный H3 записывает выполненные умеренные NSFW-изображения, H3 LoRA — более интенсивные взрослые сцены. Эти наблюдения конкретных задач не сравнивают RefMods и не гарантируют каждую сцену; выбирайте работу с внешностью и возможности контента отдельно.
| Ситуация | С чего начать | Причина |
|---|---|---|
| Есть готовая сцена и нужен короткий ролик | Image-to-video | Композиция и одежда уже в первом кадре |
| Тот же персонаж нужен в новой комнате или одежде | Обычный reference-to-video | Состав можно менять без пересборки сохранённого материала |
| Постоянно загружаете те же референсы ComfyUI | RefMod | Повторное использование организованного набора |
| Нужен персонаж из текста в совместимом H3-процессе | Обученная LoRA персонажа | Обучение может вложить усвоенную внешность в адаптер |
| Два названных персонажа в кадре | Отдельные референсы каждого | Явно задайте внешность и экранные позиции до усложнения |
| Особый повторяемый стиль или движение | Подходящая LoRA или референс | Выбор под задачу; адаптер персонажа не автоматически адаптер движения |
Примеры используют Ирис — вымышленного персонажа 32 лет в портретной и видеосерии для взрослых. Это практические стартовые задания, а не новые сгенерированные результаты сравнения.
Что каждый метод действительно сохраняет
Обычный референс — изображение или другой принимаемый материал для генерации. При следующем кадре вы выбираете его снова или загружаете через сохранённый workflow инструмента. Он не становится постоянным знанием модели. Имя «Ирис» в десяти промптах также не создаёт постоянной внешности.
RefMod превращает референсные медиа в повторно используемый файл для совместимых процессов H3. Исходный проект RefMod объясняет: извлечение сохраняет VAE-представления референсов без обучения весов H3. Full сохраняет больше информации; Compressed обменивает детали на меньше токенов референса. Историческое внутреннее имя training означает уточнение сжатого latent, а не обучение LoRA. Одежда, внешность и фон всё ещё могут переноситься вместе.
LoRA — обученный адаптер, набор усвоенных изменений рядом с базовой моделью. Исходная статья LoRA описывает принцип low-rank adaptation. Для H3 практический смысл — подготовить обучающие примеры и получить веса, которые процесс генерации действительно загружает. Сохранение фотографий в RefMod и обучение LoRA решают разные задачи, даже при общем расширении .safetensors.
| Вопрос | Обычные референсы | RefMod | Обученная LoRA |
|---|---|---|---|
| Что готовить? | Выбранные изображения или принимаемые медиа | Выбранные медиа и совместимый процесс извлечения | Отобранный датасет и trainer |
| Что использовать снова? | Оригиналы и их роли в промпте | Сохранённые представления референса | Усвоенные веса адаптера |
| Можно заменить плохой источник? | Заменить картинку | Пересобрать или изменить набор | Изменить датасет и обучить снова, если проблема усвоена |
| Независима ли генерация от референсов? | Нет | Нет, сохранённые референсы продолжают обусловливать генерацию | Потенциально, в зависимости от адаптера и задачи |
| Гарантирует того же человека? | Нет | Нет | Нет |
| Универсальный формат загрузки H3? | Только медиа, принимаемые эндпоинтом | Нет | Только совместимые веса LoRA, принимаемые загрузчиком |
Это важно при неудачном материале. Если RefMod содержит несогласованный профиль, красивое имя файла не исправит лицо. Если LoRA усвоила Ирис с одним костюмом, новый костюм может конкурировать с этой связью. Подготовка влияет на результат обоих, но исправления происходят на разных этапах.
Может встретиться и RefLoRA. Проект RefLoRA упаковывает обученные веса LoRA и RefMod-референсы в один файл. Обычный загрузчик LoRA использует веса, совместимый комбинированный — обе части. Упаковка не отменяет обучение LoRA, размещённый сервис не автоматически читает референсную половину. Определяйте содержимое и нужный загрузчик, а не выбирайте по расширению.
Сначала решите, что должно оставаться тем же
Для Ирис определите постоянную внешность узко: взрослая женщина 32 лет, короткое рыжевато-каштановое каре, широкие брови, прямой нос и узнаваемая форма лица. Это константы серии. Чёрный вечерний наряд, кремовый домашний комплект, свет спальни и расстояние камеры — выбор кадра.
Это предотвращает дорогую ошибку сохранения всего первого изображения, когда серия требует изменений. Референсная фотография — полная сцена: человек, одежда, поза, свет и комната. Человек понимает «сохраняй Ирис», но входы должны ясно показывать, какие части принадлежат Ирис, а какие эпизоду.
Для взрослой серии используйте разные референсы разных задач узнавания:
| Что узнаёт аудитория | Полезный источник | Что меняется со сценой |
|---|---|---|
| Лицо, форма бровей и линия волос | Чёткий портрет и утверждённый угол поворота | Выражение, взгляд и макияж |
| Телосложение и относительные пропорции | Принятый широкий вид с ясными плечами, талией и стойкой | Поза, расстояние камеры, одежда |
| Небольшая постоянная татуировка плеча | Чёткий вид рисунка и его расположения | Свет и присутствие в кадре |
| Стилизация конкретного набора | Выбранный наряд и укладка | Стиль следующего эпизода |
Обрезка лица не задаёт пропорции широкой сцены. Дальний полный рост показывает стойку, но мало лица. Если татуировка меняет форму, дайте ясный источник детали вместо силы всех референсов. При обязательном точном размещении решите его в первом кадре до анимации. Разделение подходит портретному набору, гостиной и более взрослой сцене; кадр определяет нужную видимую информацию.
Подготовьте небольшую папку трёх видов материалов:
- Виды внешности: чёткий портрет, три четверти и профиль, принятые как один человек.
- Гардероб: изображения постоянных нарядов, по возможности отдельно от выбора внешности.
- Сцены: пустая комната или утверждённый первый кадр конкретного плана.
Это организация работы, а не обязательный размер датасета. Спокойному портретному ролику может хватить первого изображения. Повороту полезен утверждённый вид открывающихся черт. Комната не нужна крупному референсу лица, если место меняется каждую неделю.
При выборе внешности сравнивайте челюсть, нос, брови и линию волос до красоты. Более привлекательный портрет всё равно может быть другим человеком. Отклонить сейчас дешевле по усилиям, чем построить набор противоречащих лиц.
Отличайте постоянную черту от стилизации. Если Ирис иногда закалывает волосы, набор должен сохранять узнаваемость без полной зависимости от каре. Если аксессуар меняется с нарядом, не делайте его единственным отличием от другого персонажа.
Логика та же для взрослой визуальной сцены. Источник не должен повторять интенсивность и композицию каждой будущей сцены. Внешность выбирайте по читаемости, маршрут генерации — под сцену. Ни упаковка, ни обучение персонажа не устанавливают, какие взрослые запросы эндпоинт выполнит.
Обычные референсы: лучший старт новой серии
Обычные референсы полезны при ещё выбираемом персонаже, частой смене гардероба или работе в размещённом Playground без поддержки ComfyUI.
Ошибки видны ясно. Вы видите точные отправленные картинки, убираете конфликтующую и запускаете следующий кадр. Простота ценна до окончательного персонажа. Сложный сохранённый набор может скрывать слабую картинку.
Постройте пятисекундный кадр из двух видов внешности
Возьмите передний портрет Ирис как Picture 1, принятые три четверти как Picture 2. Место первого кадра опишите текстом, чтобы оба референса служили только человеку.
Размещённый MiniMax H3 reference-to-video принимает до девяти референсных изображений и создаёт 4–15 секунд. Начните с пяти секунд, 768p, портретного 9:16: $0.1986 с двумя картинками. После удачного направления можно перейти к большему результату.
Picture 1 и Picture 2 показывают одну вымышленную взрослую женщину Ирис 32 лет. Используй их для лица, короткого рыжевато-каштанового каре и пропорций. Ирис в атласном вечернем платье цвета тёмного графита. Она сидит возле тёплой прикроватной лампы в тихой квартире, медленно поворачивает лицо из трёх четвертей к камере. Средний крупный план, камера на уровне глаз, нежное выражение, стабильное кадрирование. Сохраняй лицо читаемым на всём повороте. Аудио: мягкая атмосфера комнаты.
Референсы имеют одну задачу, текст другую. Не требуется одновременно сохранять старые фон и одежду и придумывать новую комнату. Сдержанный поворот даёт ясное действие без нескольких поз.
Если портреты уже в нужном платье и оно должно сохраниться, скажите. Если источник в жакете, явно назовите платье одеждой результата. При постоянном возврате жакета полезно заменить или обрезать референс, а не добавить абзац о платье.
Используйте первый кадр, когда сцена уже правильная
Допустим, уже создан нужный портрет: Ирис в кремовом домашнем комплекте у лампы с правильным выражением и комнатой. Прямой следующий шаг — image-to-video из принятого изображения; reference-to-video просит новую сборку сцены.
Подходящее движение:
Ирис, вымышленная взрослая женщина в первом кадре, мягко поднимает взгляд к камере и слегка расслабленно улыбается. Плечи остаются на месте. Камера медленно немного приближается. Лампа стабильна. Аудио: тихая комнатная атмосфера.
Разница — где тратить усилия. Референсы нужны, когда сцена ещё составляется. Первый кадр — когда она составлена и осталось движение. Обучение LoRA лишь для оживления одной картинки добавляет отдельный проект перед немедленной задачей.
Первый кадр не обещает идеальной последующей картинки. Если длинный поворот открывает чужой профиль, сократите или подготовьте лучший начальный угол. Решите постановку кадра до признания всего метода внешности неудачным.
RefMods: когда подготовка референсов повторяется
RefMods привлекательны при выбранном персонаже, использовании ComfyUI и повторной сборке той же коллекции. Экономия организационная и вычислительная: названный материал заменяет повторный выбор и подготовку источников.
Сохранённый файл отличается от использующего его процесса. Разные узлы H3 представляют референсы по-разному. Удачный граф одного автора не доказывает такого же персонажа в каждом загрузчике RefMod.
Fantastic H3 Prompt Builder Adudeguyman добавляет менеджер референсов и редактор промптов. Карта показывает метки фактических входов. Новые версии хранят кадры encoder и предлагают экспериментальный выбор количества картинок для text encoder. Больше картинок может увеличивать память и время. Это настройки процесса, не гарантия внешности.
Сделайте многоразовый материал Ирис
Руководство RefMod проекта даёт установку и инструкции узлов. Для персонажа полезна последовательность:
- Начните с работающего reference-процесса H3 и соответствующего VAE.
- Откройте создание в библиотеке RefMod и добавьте утверждённые изображения Ирис.
- Проверьте превью обрезок. Первое изображение определяет форму набора; исправьте источники, теряющие лицо или волосы.
- Выберите Full для исходной проверки внешности, назовите персонажа и создайте набор.
- Добавьте сохранённый материал в стек. Прочитайте карту референсов до написания роли персонажа.
Храните исходники тоже. Сохранённый референс удобен, но папка источников позволяет убрать плохой вид, сделать новую обрезку и перейти в другое приложение.
Не сохраняйте всю историю Ирис в один мастер. Постоянный материал должен легко объясняться: «утверждённые виды Ирис». Не «три комнаты, четыре костюма, старая стрижка и второй персонаж однажды».
Проверьте сохранённое до обвинения генерации
Обрезка и сжатие могут удалить нужную черту. Портретная миниатюра файлового браузера не доказывает сохранение полного портрета с ожидаемыми деталями.
Если оригинальное лицо ясное, а сохранённое превью мягкое, узкое или обрезано, сначала улучшите материал. Для портретной серии малый набор чётких видов разумнее огромного с уменьшенными важными деталями.
Full и Compressed полезны, но «малый файл» не значит «бесплатное обусловливание». Малый сохранённый файл всё равно добавляет информацию при генерации. И наоборот: больше деталей может сохранить нежелательную комнату или одежду вместе с лицом. Выберите нужную информацию до настройки силы.
Для Ирис храните внешность и отдельный необязательный материал комнаты. Загружайте лишь нужное кадру. Для другой квартиры уберите старую комнату полностью. Ослабление её силы — косвенное исправление, если комната вообще не нужна.
Почему результаты сообщества противоречат
В обсуждении обучения персонажа H3 автор сообщил примерно о пяти часах на RTX 5090 без удовлетворительного сходства. Ответы хвалили RefMods, другие описывали худшее сходство или большее время, чем с обычными референсами. Тема также оспаривала идею новой обученной внешности от упаковки многих картинок в файл.
Это поддерживает различие удобства, скорости и сходства. RefMod удобен, но не обязательно быстрее в вашем графе. Он экономит подготовку без улучшения конкретного лица. Удача зависит также от checkpoint, обрезок, представления референсов и промпта.
Обновление автора Prompt Builder сообщало о меньшем смешении персонажей после смены подачи референсов text encoder с дополнительным временем и памятью. Тот же пост сохранял описание обмена голосами. Это результат конкретной реализации с оставшимися проблемами, не доказательство всеобщей замены LoRA персонажей на RefMods.
Меняйте наряды, не меняя персонажа
Постоянным взрослым персонажам нужны узнаваемость и новизна. Лицо знакомо, стиль меняется между портретами, гостиной и вечерней сценой в одежде. Здесь удобный набор может стать слишком широким.
Если каждый референс Ирис в одном тёмном атласном платье, платье становится сильной частью визуальной инструкции. Пять картинок в разных костюмах добавляют информации, но и конкурирующие свидетельства одежды.
Практичная организация:
| Материал | Что входит | Когда использовать |
|---|---|---|
| Внешность Ирис | Утверждённые виды с одинаковыми чертами | Каждый кадр постоянного человека |
| Вечерний гардероб | Один ясный вид нужного платья и стиля | Вечерняя последовательность |
| Домашний гардероб | Один ясный вид кремового комплекта | Последовательность гостиной |
| Квартира | Комната без конкурирующих персонажей | Кадры конкретной комнаты |
| Утверждённый первый кадр | Ирис, наряд и финальная композиция вместе | Image-to-video именно этой постановки |
Это могут быть обычные файлы. Создавайте RefMods лишь часто используемых частей совместимого локального процесса. Постоянный набор единичного предмета не даёт пользы.
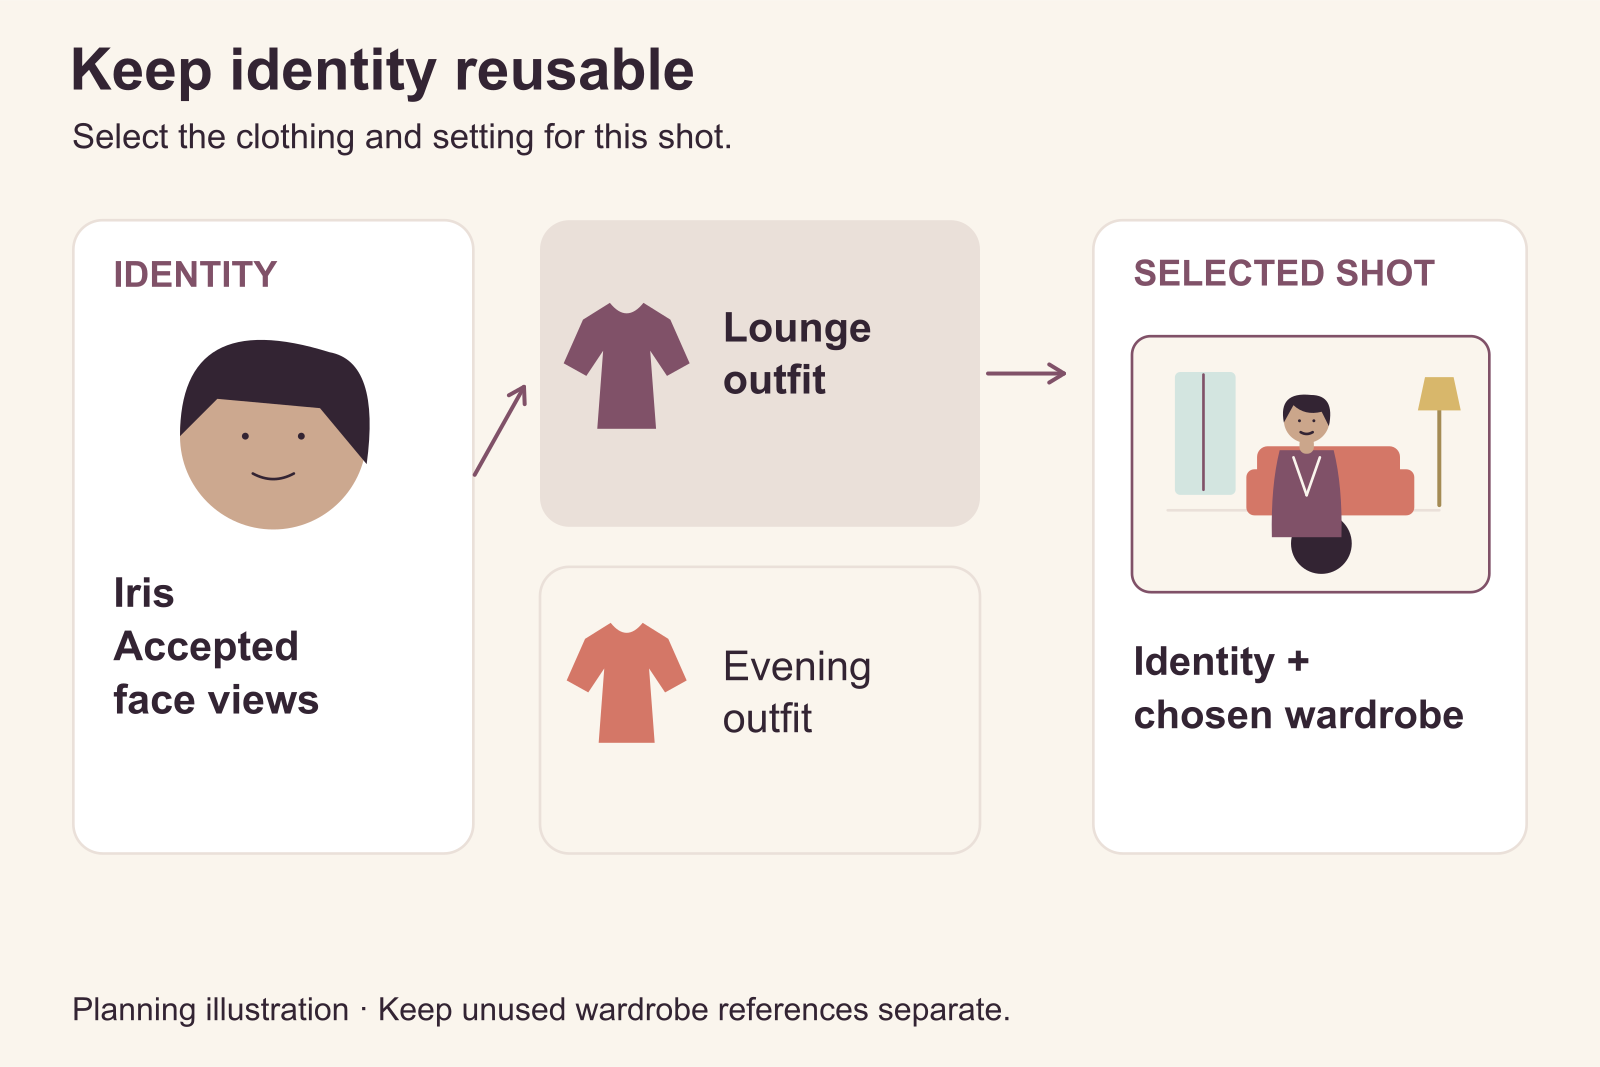
Иллюстрация: сохраняйте многоразовую внешность, выбирая одежду и место каждого кадра.
Дайте новому наряду ясный источник
Для нового гардероба оставьте два изображения внешности и добавьте одежду как Picture 3. Предпочтите предмет отдельно или обрезку с ясной одеждой без лица другого человека как конкурента.
Picture 1 и Picture 2 определяют Ирис, ту же вымышленную взрослую женщину 32 лет. Picture 3 задаёт кремовый домашний комплект этой сцены. Покажи Ирис в нём сидящей в кресле у тёплой лампы. Сохрани лицо из Pictures 1 и 2. Одна рука на подлокотнике, медленный взгляд к окну. Средний план с видимым лицом. Аудио: тихий комнатный фон.
Если на фото одежды другой человек, особенно ясно обозначьте роль. Ещё лучше убрать его лицо, не теряя полезных деталей одежды.
При возврате старого костюма сначала сделайте правку нового наряда статично. Когда лицо и одежда правильные вместе, оживите принятый кадр. Спорный выбор гардероба перенесён в изображение для прямой проверки.
Это может быть проще постоянной просьбы пятисекундному видео решить внешность, конструкцию костюма и движение сразу. Также получается повторный первый кадр нескольких коротких роликов в одной одежде.
Постоянному изменению дизайна нужен новый утверждённый набор отдельно от старого для прошлых эпизодов. Новая внешность может оправдать повторное обучение LoRA. Новое платье обычно сначала требует гардеробного референса или подготовленного первого кадра.
Двум персонажам нужны явные роли
Два RefMod не автоматически создают двух независимо управляемых людей. Две LoRA персонажа также не резервируют половины кадра каждой внешности.
Модель должна определить присутствующих, принадлежность информации и действия каждого. Это сложно при общей причёске, одежде и описании лиц либо расплывчатом «она поворачивается к ней».
Добавьте вымышленного взрослого Алекса 35 лет. Дайте заметно другую короткую стрижку и отдельный референс. Различия помогают описать кадр, не заменяя действительный источник внешности.
Для обычных референсов простой первый порядок:
- Pictures 1 и 2: перед и три четверти Ирис.
- Pictures 3 и 4: соответствующие виды Алекса.
- Комната и одежда: текстом, если отдельный референс не нужен.
Затем свяжите источники и сцену:
Pictures 1 и 2 показывают Ирис, вымышленную взрослую женщину 32 лет. Pictures 3 и 4 — Алекса, вымышленного взрослого мужчину 35 лет. Ирис слева в вечернем платье цвета тёмного графита; Алекс справа в тёмной рубашке с открытым воротом. Они тихо улыбаются друг другу возле окна квартиры. Ирис поворачивается к Алексу, Алекс продолжает смотреть на Ирис. Средний план двоих, оба лица видны, камера неподвижна. Аудио: мягкая вечерняя атмосфера комнаты.
Лево/право уменьшает неоднозначность простой композиции. Имена заменяют местоимения действий. Камера неподвижна, чтобы первый кадр не требовал также пересечения, обмена позициями и общего отворачивания.
Для локальных RefMods используйте метки текущей карты. Многоизображенческий RefMod может отображаться как video-reference, а не picture-reference; не угадывайте номер по имени и не копируйте старые номера после перестановки стека.
Официальное руководство референсных промптов H3 разделяет видимых персонажей и задающие их медиа. Это полезно: Ирис — персонаж, картинка или видео — источник сведений о ней. Так можно описать её место в новом кадре без воспроизведения всей исходной сцены.
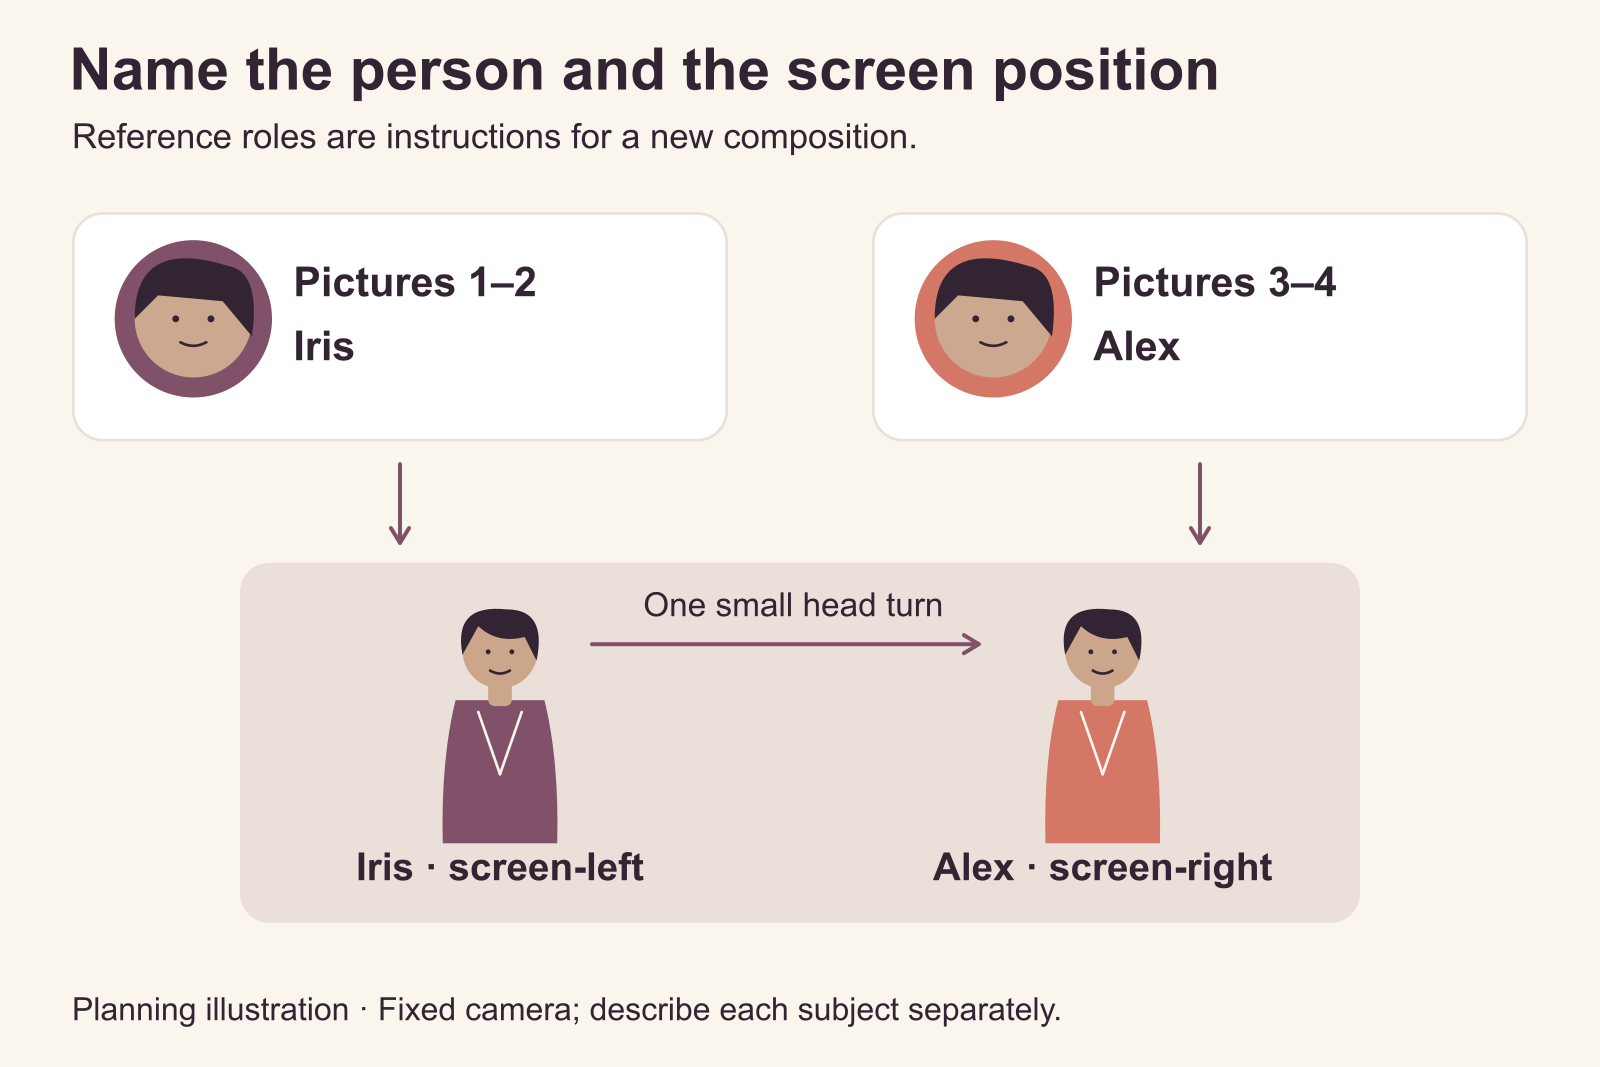
Иллюстрация: отдельно назначайте изображения, человека и экранное положение.
Если лица смешиваются, сначала упростите композицию
Если Алекс получает волосы Ирис или Ирис форму лица Алекса, проверьте соответствие источников и меток промпта. Неверная картинка может выглядеть ошибкой качества внешности.
При правильных метках упростите визуальные роли: оба лица видны, разные позиции, без пересечения в первом общем кадре. Уберите референс одежды с третьим узнаваемым лицом. Если отдельно пара работает, вместе постоянно смешивается, подготовьте принятый первый кадр двоих и оживите сдержанное взаимодействие.
Можно менять и монтаж. Чередуйте одиночные планы и виды через плечо вместо каждого сюжетного момента в движущемся плане двоих. Это практично, когда правдоподобная непрерывность важнее постоянной видимости обоих лиц.
Ни одно изменение не гарантирует сложного взаимодействия. Они устраняют конкретную неоднозначность до времени на новые материалы внешности.
Отделяйте голос от визуальной внешности
Постоянно выглядящий персонаж с новым голосом в каждом эпизоде всё равно ощущается другим. Но аудио рядом с визуальным RefMod не устанавливает надёжную связь голоса и лица.
Заметки валидации RefMod записывают неудачный перенос личности говорящего и неполное покрытие генерации. Аудиореференсы — отдельная возможность для проверки именно используемого процесса.
В первой визуальной серии Ирис достаточно атмосферы. Если постоянный голос обязателен, планируйте отдельный процесс голоса и диалогов, не выбирайте RefMods с предположением, что совмещённый файл это решил. Обученная визуальная LoRA не доказывает обученного голоса.
Когда обучение LoRA персонажа оправдано
Обучение имеет смысл при определённой внешности и нужде конкретнее удобного выбора референсов.
Три ситуации заслуживают серьёзного рассмотрения:
- Создавать персонажа через text-to-video с совместимым адаптером без большого набора референсов каждого кадра.
- Нужны усвоенные повторяемые стиль или поведение, недостаточно выраженные обычными референсами.
- Уже есть работающая LoRA-постановка, и персонаж нужен в ней.
«Делаю серию» само по себе недостаточно. Десять тщательно составленных портретных роликов могут хорошо обслуживаться первыми кадрами. Большая серия может оправдать обучение, только если адаптер уменьшает реальную работу или добавляет нужную возможность.
Обучайте для процесса использования адаптера
H3 — не один взаимозаменяемый файл весов. FL2VA и Ref2VA требуют осознанной совместимости. Документация AI Toolkit Ref2VA указывает отдельные веса Ref2VA и соответствующий обучающий адаптер. Имя H3 не доказывает совместимости каждой размещённой задачи или локального checkpoint.
До обучения решите основной результат: text-to-video, анимация первого кадра или обусловленное референсами видео. Передайте задачу настройщику trainer. Впечатляющий рецепт одного inference-графа не автоматически готовый материал другого.
Используйте текущие H3-инструкции trainer, а не learning rate и число шагов удачного урока Wan или изображения. Текущая документация Musubi H3 поддерживает несколько задач обучения и разные подходы сохранения поведения базы. Выбор меняет усвоенное и возможные нарушения.
Готовьте датасет персонажа, а не одной фотографии
Полезная коллекция Ирис показывает внешность при нужной серии вариации: ясные лица нужных углов, шире кадры при важных пропорциях, больше одного гардероба и света.
Не создавайте разнообразие несовместимыми версиями Ирис. Двадцать изображений принятого человека согласованнее двадцати красивых, постепенно меняющих нос и челюсть. Десятки близких обрезок одного портрета не дают недостающий профиль.
Подписывайте меняющееся: одежду, кадрирование, выражение, сцену. Имя внешности сохраняйте по методу trainer. Для trigger-рецепта подпись может быть простой:
irisvale, вымышленная взрослая женщина 32 лет, портрет в три четверти, кремовый вязаный топ, расслабленное выражение, мягкий оконный свет, простой интерьерный фон.
Это пример подписи, не универсальная команда обучения H3. Некоторые методы намеренно иначе обращаются с внешностью. Следуйте выбранному, не смешивайте несовместимые советы.
Если цель — лицо, не добавляйте несвязанные ролики лишь из-за поддержки trainer. Для характерного движения выбирайте явно показывающие его клипы с узнаваемым человеком. Изображения и видео дают разную информацию; видео добавляет подготовку и обучение.
Следите за неправильным успехом
Пример может напоминать Ирис и быть плохим производственным адаптером. Признаки: один фон в несвязанных запросах, старый костюм при повышении силы, жёсткое движение или игнорирование новой камеры.
Не всегда помогает больше обучения. Если поздние checkpoint узнаваемее, но менее гибкие, ранний полезнее. Если всё повторяет фон, датасет слишком узок. Если адаптер ничего не меняет на разумной силе, изучите совместимость и загрузку до новой ночи подписей.
Другое обсуждение обучения персонажа H3 описывает этот обмен: слабое сходство у одних, сильное с худшим движением, артефактами и выполнением инструкций у другого. Есть и хорошие RefMod-отзывы, и неудачные референсы. Честного универсального победителя эти рассказы не дают.
Можно сочетать совместимую LoRA с обычными референсами. Адаптер задаёт усвоенную тенденцию, принятое изображение — текущие лицо, наряд или композицию. Комбинация полезна при ясной роли каждой части, а не как причина поднять все силы на максимум.
Время подготовки и за что действительно платят
Обычные референсы требуют минимальной настройки при готовых источниках: выбрать согласованные файлы и роли. RefMods добавляют установку и извлечение, затем уменьшают повторное обращение. LoRA добавляет датасет, обучение, выбор сохранённого checkpoint и совместимость.
Время зависит от оборудования, количества источников, разрешения и метода. Пять часов сообщества — один запуск; планируйте с вашим trainer и оборудованием.
| Расход | Обычные референсы | RefMod | Обученная LoRA |
|---|---|---|---|
| Первичная творческая работа | Изображения внешности и полезные углы | Та же подготовка источников | Отобранный датасет, часто больше вариаций |
| Дополнительная подготовка | Выбор и порядок входов | Установка, кодирование, просмотр материала | Настройка и обучение, выбор пригодного checkpoint |
| Повторная работа | Перезагрузка файлов или preset | Загрузка набора | Совместимые веса и trigger/настройки |
| Цена генерации | Эндпоинт и референсные сборы | Локальные/арендованные вычисления; сохранённые референсы всё ещё стоят ресурсов | Генерация и политика хоста по адаптерам |
| Цена изменений | Замена источника | Обновление материала | Возможное переобучение усвоенной внешности |
Размещённые цены отдельно от локальных расходов RefMod
Текущие страницы H3 SpicyAPI принимают обычные референсные медиа; LoRA также совместимые веса. Поля загрузки RefMod нет. RefMod .safetensors не заменяет LoRA в loras. Сохраняйте картинки для того же персонажа на размещённом маршруте.
Для утверждённого первого кадра H3 LoRA image-to-video стоит $0.05 за секунду при 480p и $0.10 при 768p. Пять секунд — $0.25 или $0.50. Отдельной платы загрузки LoRA нет. Четыре пятисекундные генерации — $1.00 или $2.00; это четыре результата, не четыре гарантированно пригодных.
У reference-to-video другой счёт. Обычный H3 добавляет $0.0068 за референс к секундам результата; H3 LoRA — $0.02 за изображение. Полные пятисекундные расчёты только со статичными референсами. Обычный H3 больше не предлагает 480p, поэтому в этих ячейках прочерк:
| Пятисекундный запрос | 480p | 768p |
|---|---|---|
| H3, два изображения внешности | — | $0.1986 |
| H3, два изображения внешности и одно одежды | — | $0.2054 |
| H3 LoRA, два изображения внешности | $0.34 | $0.715 |
| H3 LoRA, два изображения внешности и одно одежды | $0.36 | $0.735 |
Например, обычный H3 768p с двумя картинками — 5 × $0.037 + 2 × $0.0068 = $0.1986. Десять — $1.986. Соответствующие reference-запросы H3 LoRA — $7.15 при 768p. Выбирайте по взрослым тестам конкретной задачи, входам и весам. Несколько эпизодов персонажа сами не требуют LoRA-маршрута.
В reference-задаче LoRA секунды входного видео также входят в оплачиваемые секунды, аудио имеет свою плату за референс. Локальный сохранённый RefMod не обходит типы входа или цены сервиса. Движение-референс держите коротким и используйте лишь для информации, которой нет в картинках и тексте.
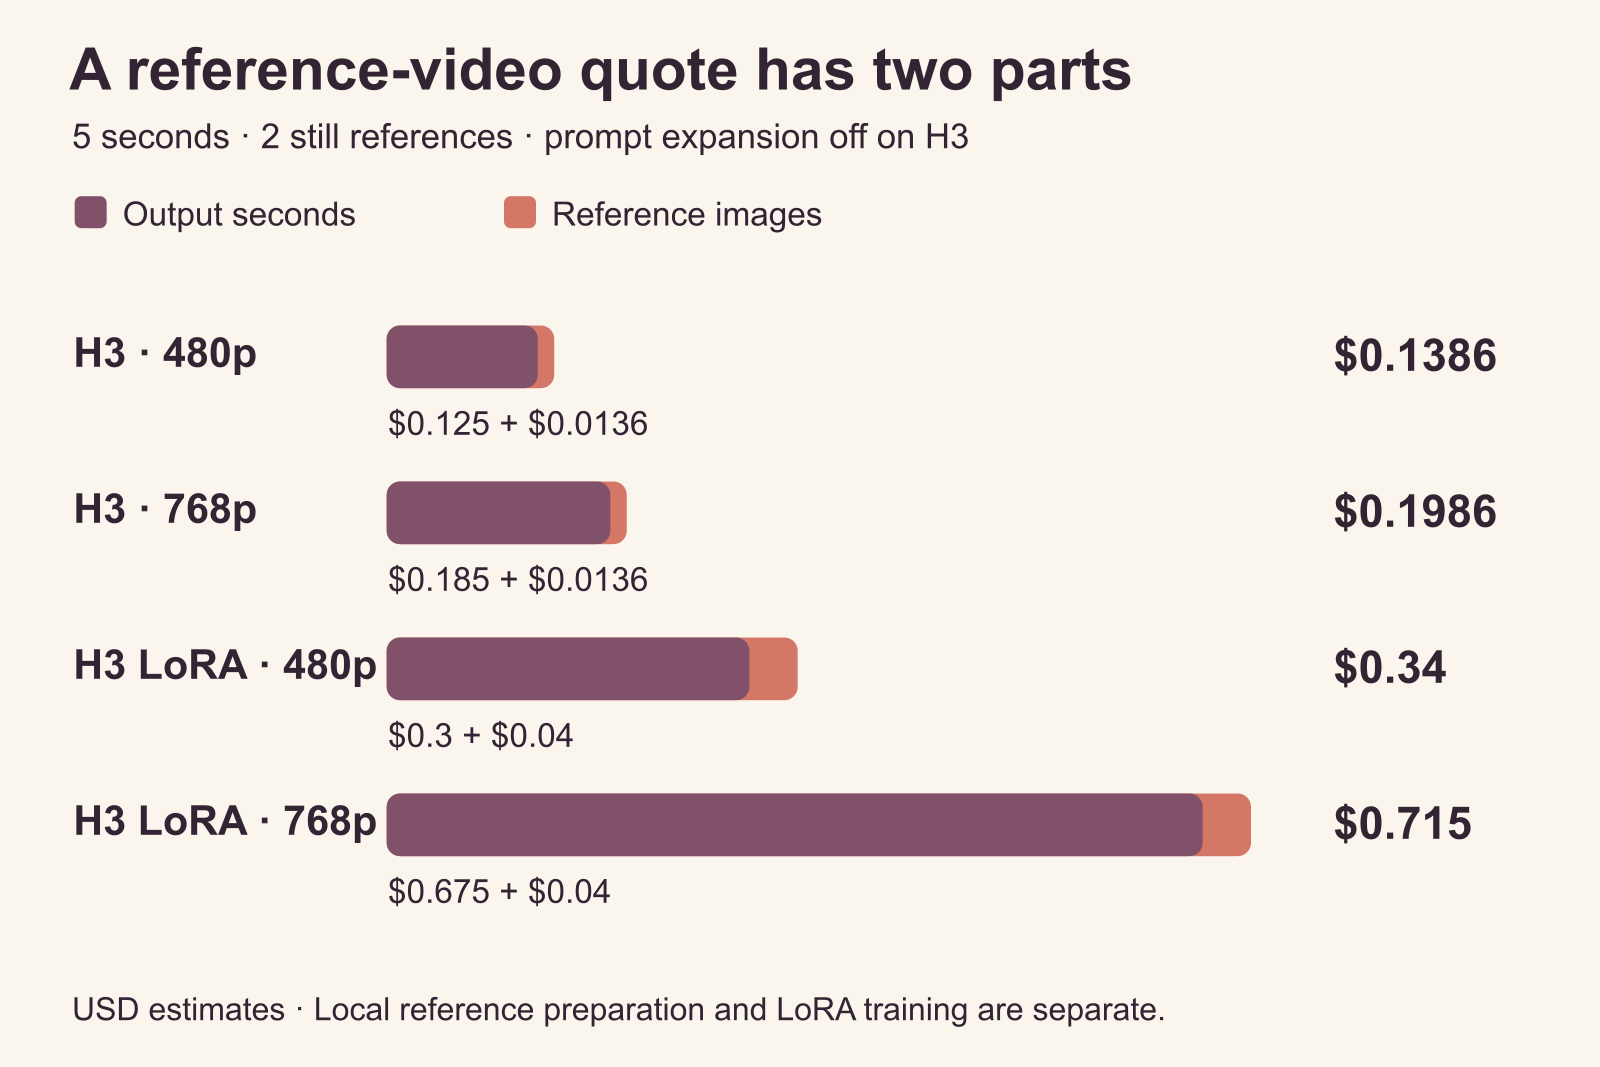
Расчёты пяти секунд включают оба статичных референса. Подготовка и обучение LoRA — отдельные расходы.
Решите, экономит ли обучение достаточно повторной работы
Счёт обучения — только часть решения. Добавьте подготовку источников, аренду GPU, промежуточные примеры и время исправления несовместимых результатов. Низкая цена GPU не выгодна, если адаптер не даёт пригодного персонажа.
Для нескольких роликов оставайтесь с референсами, если подходящего адаптера нет. Для частых результатов назовите нужную экономию: повторный выбор, плата изображений, медленный референсный inference или недостижимый усвоенный вид.
RefMods прежде всего решают повторные выбор и подготовку. LoRA может решать остальное, но только после работы в нужном маршруте. Не покупайте обучение ради организации, уже решённой сохранённым preset.
Честно считайте результаты. Оплатили шесть завершённых генераций, использовали две — цена генерации пригодного результата втрое больше ставки за результат. Арифметика всех трёх методов одинакова. Лучшая подготовка или простой кадр важнее самого дешёвого рекламируемого секундного тарифа.
Частые ошибки и полезное следующее изменение
| Что видно | Что проверить сначала | Что изменить |
|---|---|---|
| Перед узнаваем, при повороте другой человек | Показан ли открываемый угол | Добавьте принятый профиль или уменьшите поворот |
| Возвращается исходный наряд | Нет ли его на каждом источнике внешности | Замените источник, отделите одежду или подготовьте новое начало |
| Миниатюра RefMod правильная, лицо слабое | Сохранённая обрезка и представление | Пересоберите яснее с Full как базой |
| Персонаж игнорирует имя | Ссылка промпта на фактическую метку медиа | Назначьте персонажа метке текущей карты |
| Два персонажа сливаются | Порядок, роли, дополнительные лица | Исправьте метки, уберите конкурентов, начните статичным планом двоих |
| LoRA загружается без полезного изменения | Совместимость базы, задачи, загрузчика | Подтвердите маршрут до переобучения |
| Сходство лучше, движение рушится | Сила адаптера и checkpoint | Ослабьте влияние или возьмите ранний пригодный checkpoint |
| Новая комната становится старой | Не загружена ли старая информация | Уберите старый референс полностью |
| Лицо стабильно, голос меняется | Есть ли отдельное решение голоса | Сделайте личность диалога отдельной производственной задачей |
Меняйте вход, напрямую связанный с нежелательным признаком. Неверный наряд — причина изменить гардеробный источник до checkpoint, sampler и всей коллекции.
Для продолжения руководство H3 LoRA API описывает загрузку адаптера и задачу. Сравнение версий H3 объясняет варианты продукта. Это отдельные решения от необходимости обучения постоянного персонажа.
Выбирайте для следующего эпизода
Для следующего эпизода Ирис возьмите утверждённый портрет и нужный альтернативный вид, задачу под взрослую сцену и создайте один пятисекундный ролик. Сохраните RefMod, когда проблемой становится повторная подготовка. Обучите совместимую LoRA, когда серии нужна усвоенная возможность или путь использования, не предоставляемые референсами. Пусть инвестицию определяет следующая реальная производственная потребность.