Un personaggio adulto ricorrente deve essere riconoscibile nell'episodio successivo, non soltanto nel ritratto di presentazione. Quando hai scelto un volto, la decisione MiniMax H3 RefMods vs LoRA riguarda quanto lavoro vuoi ripetere cambiando outfit, angolo della fotocamera o altra persona.
Parti da normali immagini di riferimento. Salva un RefMod se lavori già in ComfyUI e riusi spesso quelle immagini. Valuta l'addestramento di una LoRA quando ti serve un personaggio o stile appreso che il workflow con riferimenti non fornisce in modo efficiente. Un RefMod organizza informazioni di riferimento; non addestra il personaggio dentro H3. Una LoRA richiede addestramento e quell'investimento non produce automaticamente una somiglianza migliore.
Per una nuova persona adulta di fantasia, preparare poche viste coerenti è solitamente il primo investimento utile. Per una serie settimanale consolidata, una libreria di riferimenti può risparmiare configurazioni ripetute. Addestrare diventa più sensato quando il personaggio è stabile e sai nominare il limite specifico da risolvere.
In una serie NSFW l'identità supera un ritratto corrispondente: proporzioni, carnagione e segni distintivi possono dover rimanere riconoscibili nei primi piani intimi e nelle scene adulte più ampie. I task con riferimenti qui discussi hanno registri pubblicati diversi: H3 ordinario registra immagini NSFW moderate prodotte, mentre H3 LoRA registra scene adulte di maggiore intensità prodotte. Queste osservazioni specifiche dei task non confrontano RefMods né garantiscono ogni scena; scegli gestione dell'identità e capacità dei contenuti separatamente.
| La tua situazione | Parti da qui | Motivo |
|---|---|---|
| Hai una scena finita e vuoi una clip corta | Da immagine a video | Composizione e outfit esistono già nel primo fotogramma |
| Ti serve lo stesso personaggio in una nuova stanza o outfit | Normale generazione da riferimenti a video | Cambi gli ingredienti senza ricostruire una risorsa salvata |
| Carichi ripetutamente gli stessi riferimenti in ComfyUI | RefMod | Riusi un pacchetto ordinato di riferimenti |
| Vuoi il personaggio da prompt testuale in un workflow H3 compatibile | LoRA del personaggio addestrata | L'addestramento può inserire l'identità appresa in un adapter |
| Servono due personaggi nominati nella stessa ripresa | Riferimenti separati per ciascuno | Assegna esplicitamente identità e posizioni prima della complessità |
| Serve uno stile o movimento ricorrente distintivo | LoRA appropriata o riferimento pertinente | Scegli per quel compito; un adapter del personaggio non è automaticamente uno del movimento |
Gli esempi usano Iris, personaggio di fantasia di 32 anni in una serie di ritratti e video per adulti. Sono brief iniziali pratici, non risultati di confronto appena generati.
Cosa risparmia davvero ogni metodo
Un riferimento ordinario è un'immagine o altro media accettato fornito a una generazione. Lo scegli di nuovo o lo ricarichi tramite un workflow salvato per la prossima ripresa. Non diventa conoscenza permanente del modello. Neppure chiamare «Iris» un personaggio in dieci prompt crea un'identità persistente.
Un RefMod trasforma media di riferimento in un file riutilizzabile per workflow H3 compatibili. Il progetto originale RefMod spiega che l'estrazione salva rappresentazioni VAE dei riferimenti senza addestrare i pesi H3. Full mantiene più informazioni; Compressed scambia dettaglio con meno token di riferimento. Il nome storico della modalità interna training indica il raffinamento di un latente compresso, non l'addestramento LoRA. Abbigliamento, identità e sfondo possono ancora essere trasferiti insieme.
Una LoRA è un adapter addestrato: cambiamenti appresi usati insieme al modello base. Il paper originale LoRA descrive il principio di adattamento a basso rango. Per H3 la conseguenza pratica è preparare esempi di addestramento e produrre pesi caricabili dal workflow di generazione. Salvare fotografie in RefMod e adattare una LoRA risolvono problemi diversi anche se i file terminano entrambi in .safetensors.
| Domanda | Riferimenti ordinari | RefMod | LoRA addestrata |
|---|---|---|---|
| Cosa prepari? | Immagini selezionate o media accettati | Media selezionati e workflow di estrazione compatibile | Dataset curato e trainer |
| Cosa riusi? | File originali e ruoli nei prompt | Rappresentazioni salvate dei riferimenti | Pesi appresi dell'adapter |
| Puoi sostituire una fonte sbagliata? | Sostituisci l'immagine | Ricostruisci o modifica il pacchetto | Rivedi il dataset e riaddestra se il problema è appreso |
| La generazione è indipendente dai riferimenti? | No | No; quelli salvati condizionano ancora | Potenzialmente, secondo adapter e task |
| Garantisce la stessa persona? | No | No | No |
| È un formato universale di upload H3? | Solo media accettati dall'endpoint | No | Solo pesi LoRA compatibili accettati dal loader |
La distinzione conta quando una risorsa delude. Se un RefMod contiene un profilo incoerente, un nome migliore del file non corregge il volto. Se una LoRA ha appreso Iris insieme a un costume particolare, scriverne uno nuovo può competere con l'associazione. In entrambi i casi la preparazione influenza il risultato; la correzione avviene in una fase diversa.
Puoi incontrare anche RefLoRA. Il progetto RefLoRA unisce pesi LoRA addestrati e riferimenti RefMod in un file. Un loader LoRA normale usa i pesi; uno combinato compatibile può usare entrambi. Unirli non elimina l'addestramento che ha prodotto la LoRA, e un servizio ospitato non legge automaticamente la metà dei riferimenti. Identifica contenuto del file e loader che lo userà invece di scegliere dall'estensione.
Decidi prima cosa deve restare uguale
Per Iris, definisci in modo circoscritto l'identità ricorrente: donna adulta di 32 anni, caschetto corto castano ramato, sopracciglia ampie, naso dritto e forma del volto riconoscibile. Sono le costanti della serie. Outfit nero da sera, completo da casa crema, luce della camera e distanza della fotocamera sono scelte della ripresa.
La separazione evita un errore costoso: cercare di conservare tutta la prima immagine quando la serie richiede cambiamenti. Una fotografia di riferimento è una scena completa. Contiene persona, vestiti, posa, luce e stanza. «Mantieni Iris coerente» è chiaro per un umano, ma gli input devono ancora specificare quali parti appartengano a Iris e quali a questo episodio.
Per la serie adulta di Iris, usa riferimenti diversi per problemi diversi di riconoscimento:
| Cosa riconosce il pubblico | Fonte utile | Cosa può cambiare con la scena |
|---|---|---|
| Volto, sopracciglia e attaccatura dei capelli | Ritratto chiaro e angolo di rotazione approvato | Espressione, sguardo e trucco |
| Corporatura e proporzioni relative | Vista ampia approvata con spalle, vita e postura leggibili | Posa, distanza della fotocamera e outfit |
| Piccolo tatuaggio ricorrente sulla spalla | Vista chiara del design reale e della posizione | Luce e presenza nella cornice |
| Styling di un set specifico | Outfit e disposizione dei capelli scelti | Styling dell'episodio successivo |
Un volto ritagliato non definisce le proporzioni di Iris in una scena ampia. Viceversa, una figura intera distante può mostrare la postura ma poco dettaglio del volto. Se il tatuaggio cambia forma, aggiungi una fonte chiara di quel dettaglio anziché aumentare la forza di ogni riferimento. Quando la posizione esatta è essenziale, risolvila nell'immagine iniziale prima dell'animazione. La stessa divisione delle risorse vale per ritratti adulti, sequenza in salotto o scena più matura; la ripresa determina le informazioni visibili necessarie.
Prepara una piccola cartella con tre tipi di materiali:
- Viste d'identità: ritratto chiaro, vista di tre quarti e profilo accettati come stessa persona.
- Esempi d'abbigliamento: un'immagine per ogni outfit ricorrente, separata dall'identità quando possibile.
- Immagini delle scene: stanza vuota o primo fotogramma approvato per una ripresa specifica.
È un'organizzazione di lavoro, non una dimensione obbligatoria del dataset. Una clip ritratto tranquilla può richiedere soltanto la prima immagine. Una rotazione beneficia di una vista reale approvata dei tratti rivelati. Una stanza non ha un ruolo utile nel riferimento ravvicinato del volto se cambia ogni settimana.
Scegliendo identità, confronta mascella, naso, sopracciglia e attaccatura prima della bellezza. Un ritratto generato più attraente può essere comunque la persona sbagliata. Scartarlo ora richiede meno fatica che costruire un pacchetto attorno a volti contraddittori.
Distingui inoltre una caratteristica permanente dallo styling. Se Iris porta talvolta i capelli raccolti, i riferimenti devono rendere riconoscibile il volto senza dipendere interamente dalla silhouette del caschetto. Se un accessorio cambia con l'outfit, non farne l'unico elemento che distingue Iris da un altro personaggio.
Lo stesso vale per immagini adulte. Una fonte non deve riprodurre intensità o composizione di ogni scena futura. Scegli riferimenti d'identità leggibili. Scegli il percorso generativo adatto alla scena stessa. Né organizzazione dei riferimenti né addestramento del personaggio stabiliscono quali richieste adulte soddisfi un endpoint.
Riferimenti ordinari: il punto di partenza migliore per una nuova serie
Sono utili quando stai ancora decidendo il personaggio, cambi spesso abbigliamento o vuoi lavorare nel Playground ospitato senza mantenere ComfyUI.
Rendono anche chiari gli errori. Vedi esattamente le immagini fornite, rimuovi quella in conflitto e provi la prossima ripresa. La semplicità ha valore prima che il personaggio sia definito. Un pacchetto elaborato salvato può rendere meno evidente una fonte debole.
Costruisci una ripresa di cinque secondi da due viste d'identità
Usa il ritratto frontale di Iris come Picture 1 e la vista di tre quarti approvata come Picture 2. Tieni l'ambiente nel brief scritto per la prima ripresa così entrambi i riferimenti hanno un solo scopo: la persona.
Nel task MiniMax H3 con riferimenti ospitato puoi fornire fino a nove immagini e produrre 4–15 secondi. Parti da cinque secondi a 768p, verticale 9:16: $0.1986 con queste due immagini. Passa a output maggiore quando la direzione della ripresa merita di essere conservata.
Picture 1 e Picture 2 mostrano la stessa donna adulta di fantasia, Iris, di 32 anni. Usale per identità del volto, caschetto corto ramato e proporzioni. Iris indossa un abito da sera di satin antracite. Siede vicino a una lampada calda accanto al letto in un appartamento tranquillo, poi gira lentamente il volto dai tre quarti verso la fotocamera. Primo piano medio, fotocamera all'altezza degli occhi, espressione delicata, inquadratura stabile. Mantieni il volto chiaramente leggibile per tutta la rotazione. Audio: ambienza morbida della stanza.
Il brief assegna un compito ai riferimenti e un altro al testo. Non chiede contemporaneamente di conservare vecchio sfondo, vecchio outfit e inventare nuova stanza. La rotazione contenuta offre anche un'azione chiara senza diverse pose.
Se i ritratti sorgenti mostrano già l'abito antracite e vuoi conservarlo, dillo. Se uno indossa una giacca, descrivi esplicitamente l'abito come abbigliamento dell'output. Quando la giacca continua a tornare, il cambiamento utile è sostituire o ritagliare quel riferimento, non aggiungere un altro paragrafo sull'abito.
Usa il primo fotogramma quando la scena è già corretta
Supponi di avere già la composizione desiderata: Iris nel completo da casa crema, seduta accanto alla lampada, con espressione e stanza giuste. Da immagine a video è il passo diretto. Parte dall'immagine accettata; da riferimenti a video chiede di costruire una nuova ripresa dagli ingredienti.
Un brief di movimento adatto è:
Iris, donna adulta di fantasia nel primo fotogramma, alza delicatamente lo sguardo verso la fotocamera e accenna un sorriso rilassato. Le spalle restano nella stessa posizione. La fotocamera si avvicina lentamente e leggermente. La lampada resta stabile. Audio: atmosfera sonora interna tranquilla.
La differenza pratica è dove investi lo sforzo. Usa riferimenti quando devi ancora comporre la scena. Usa un'immagine iniziale quando la scena è già composta e manca il movimento. Addestrare una LoRA del personaggio solo per animare una foto finita aggiunge un progetto prima di risolvere il bisogno immediato.
Il primo fotogramma non promette che tutti i successivi restino perfetti. Se una lunga rotazione rivela un profilo sconosciuto, accorciala o prepara un angolo iniziale migliore. È un problema di progettazione della ripresa da risolvere prima di considerare fallito l'intero metodo d'identità.
RefMods: utili quando la preparazione diventa ripetitiva
Diventano interessanti quando ti piace il personaggio, usi già ComfyUI e ricostruisci spesso la stessa raccolta. Il risparmio è organizzativo oltre che di calcolo: una risorsa nominata può sostituire selezione e preparazione ripetute.
C'è una differenza importante fra file salvato e workflow che lo usa. Nodi H3 diversi possono presentare i riferimenti diversamente. Un risultato favorevole nel grafo di un creator non dimostra che ogni loader RefMod produca lo stesso personaggio.
Fantastic H3 Prompt Builder di Adudeguyman aggiunge un gestore dei riferimenti e un editor dei prompt. La mappa mostra le etichette associate agli input reali. Versioni nuove possono conservare fotogrammi per l'encoder e offrire una scelta sperimentale di quante immagini vede il text encoder. Più immagini possono aumentare memoria e tempi. Sono controlli del workflow, non una garanzia d'identità migliore.
Crea una risorsa Iris riutilizzabile
La guida RefMod del progetto fornisce installazione e istruzioni dei nodi. Per il personaggio, la sequenza utile è:
- Parti da un workflow H3 con riferimenti funzionante e VAE corrispondente.
- Apri la vista di creazione della libreria RefMod e aggiungi le immagini Iris approvate.
- Esamina le anteprime dei ritagli. La prima immagine determina la forma del set combinato; correggi le fonti che perdono volto o capelli.
- Scegli Full per la base d'identità, assegna il nome e crea il pacchetto.
- Aggiungi la risorsa allo stack. Leggi la mappa dei riferimenti prima di scrivere il ruolo del soggetto nel prompt.
Conserva anche gli originali. Il riferimento salvato è comodo, ma la cartella sorgente consente di eliminare una vista sbagliata, preparare un altro ritaglio o passare a un'altra applicazione.
Non salvare ogni immagine della storia di Iris in una risorsa principale. Un asset utile deve essere facile da spiegare: «queste sono le viste approvate di Iris». Non deve significare anche «tre stanze, quattro costumi, un vecchio taglio e un secondo personaggio apparso una volta».
Leggi il risultato salvato prima di incolpare la generazione
Ritaglio e compressione possono eliminare proprio il tratto da conservare. Una miniatura ritratto nel file browser non dimostra che il riferimento salvato contenga il ritratto completo al dettaglio atteso.
Se l'originale ha un volto chiaro ma l'anteprima memorizzata è morbida, stretta o tagliata, migliora prima la risorsa. Per una serie di ritratti, poche viste chiare sono un punto iniziale più sensato di un pacchetto enorme con dettagli importanti ridotti.
Full e Compressed sono scelte utili, ma «file più piccolo» non equivale a «condizionamento gratuito». Un piccolo file contribuisce ancora informazioni durante la generazione. Viceversa, conservare più dettaglio può mantenere stanza o capo indesiderati insieme al volto. Seleziona le informazioni desiderate prima di regolarne la forza.
Per Iris, conserva un asset d'identità e uno separato facoltativo della stanza. Carica solo ciò che serve alla ripresa. Se la scena è in un altro appartamento, escludi del tutto il vecchio asset della stanza. Abbassarne la forza è una correzione indiretta quando non ha alcun ruolo nella nuova clip.
Perché i risultati della community sembrano contraddittori
In una discussione sull'addestramento di personaggi H3, l'autore segnalava circa cinque ore di addestramento su RTX 5090 senza somiglianza soddisfacente. Le risposte lodavano RefMods, mentre altri riportavano somiglianza peggiore o tempi maggiori delle configurazioni con riferimenti ordinari. La discussione contestava anche l'idea che unire molte immagini in un file crei un'identità appena addestrata.
Quei resoconti supportano una distinzione utile: comodità, velocità e somiglianza sono benefici separati. Un RefMod può essere comodo senza essere più veloce nel tuo grafo. Può risparmiare preparazione senza migliorare un volto specifico. Un esempio riuscito può dipendere da checkpoint, ritagli, presentazione e prompt oltre che dalla risorsa salvata.
L'aggiornamento dell'autore di Prompt Builder riportava meno mescolanza dei personaggi cambiando come i riferimenti raggiungevano il text encoder, con costi aggiuntivi di tempo e memoria. Lo stesso post descriveva ancora voci scambiate. È un risultato d'implementazione specifico con problemi restanti, non prova che RefMods abbia sostituito LoRA per tutti.
Cambiare outfit senza cambiare personaggio
Personaggi adulti ricorrenti richiedono spesso riconoscibilità e novità. Il volto resta familiare mentre lo styling cambia fra ritratti, salotto e sequenza serale vestita. Qui un pacchetto comodo può diventare troppo ampio.
Se ogni riferimento Iris mostra lo stesso abito scuro di satin, quel capo può diventare una forte parte dell'istruzione visiva. Aggiungere cinque immagini con costumi estranei offre più informazioni ma anche prove concorrenti di abbigliamento.
Un'organizzazione pratica è:
| Risorsa | Cosa contiene | Quando usarla |
|---|---|---|
| Identità Iris | Viste approvate con tratti facciali coerenti | Ogni ripresa che richiede la persona definita |
| Abbigliamento da sera | Vista chiara dell'abito e dello styling desiderati | Sequenza serale |
| Abbigliamento da casa | Vista chiara dell'outfit crema | Sequenza in salotto |
| Scena dell'appartamento | Stanza senza personaggi concorrenti | Riprese in quella stanza |
| Primo fotogramma approvato | Iris, outfit e composizione finale insieme | Da immagine a video per quell'allestimento esatto |
Possono essere file ordinari. Crea RefMods soltanto per parti riusate spesso in un workflow locale compatibile. Non c'è vantaggio in un pacchetto permanente per un oggetto occasionale.
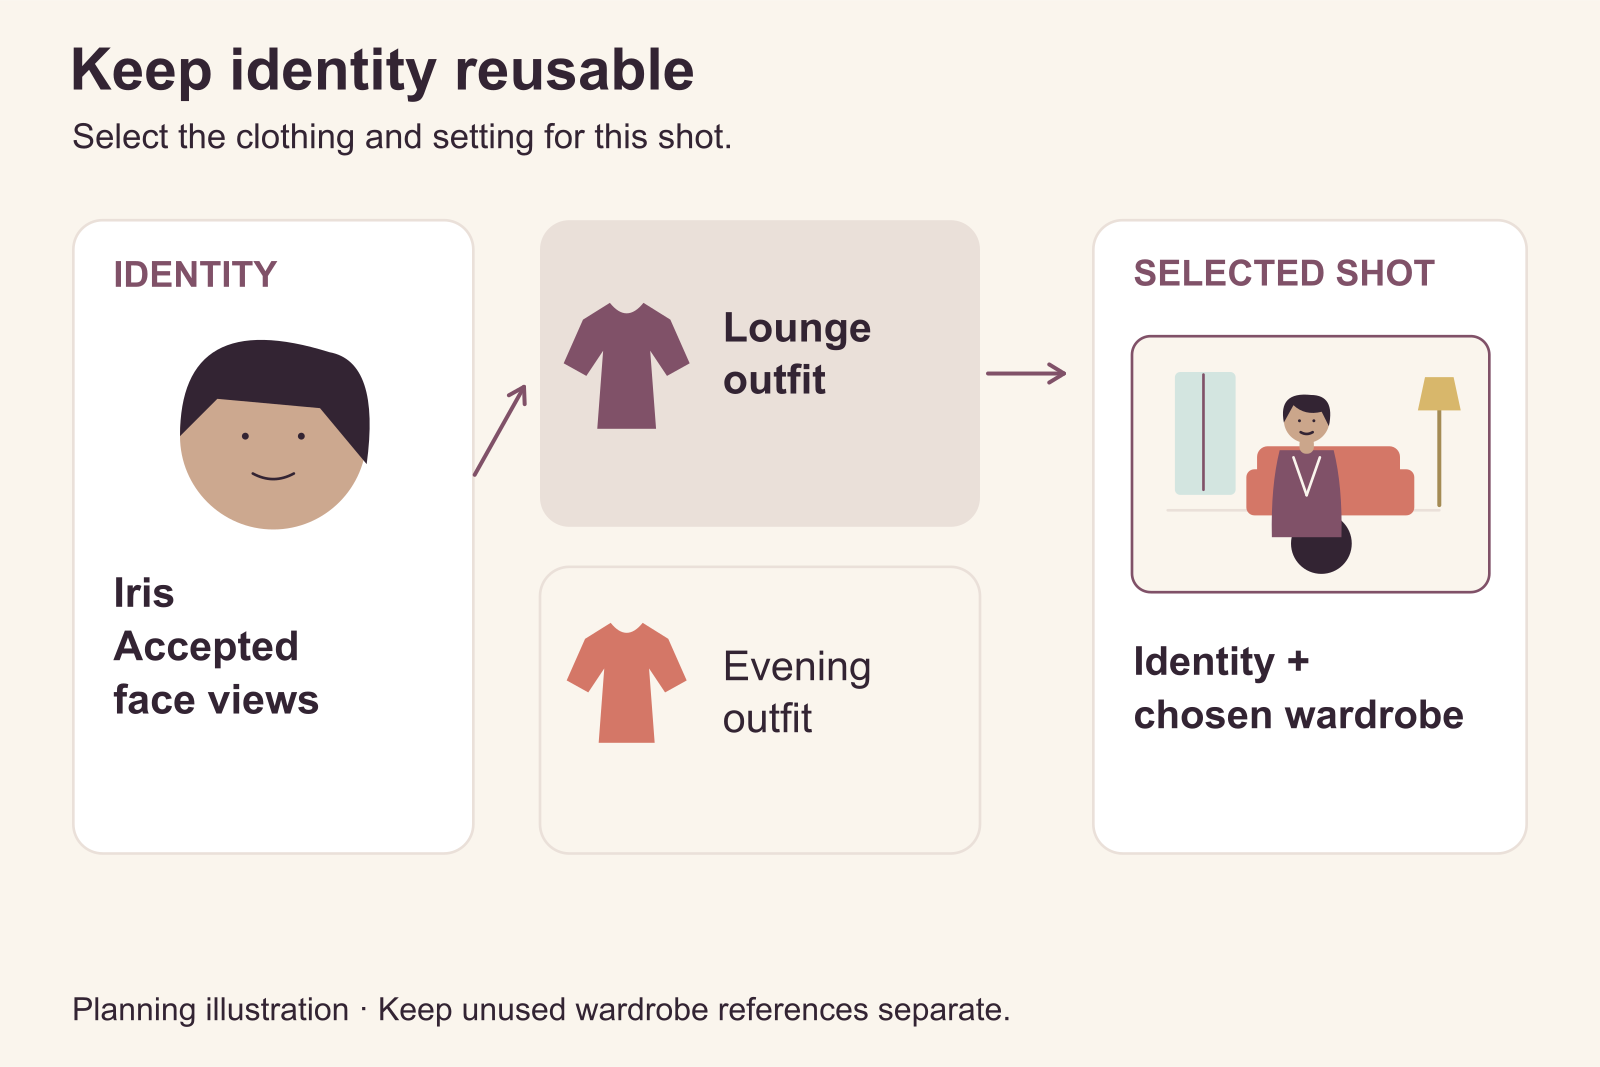
Illustrazione: conserva l'identità riutilizzabile scegliendo abbigliamento e ambiente per ogni ripresa.
Dai al nuovo outfit una fonte chiara
Per un nuovo abbigliamento, mantieni i due riferimenti d'identità e aggiungi il capo come Picture 3. Preferisci una fonte del solo capo o un ritaglio che lo renda chiaro senza presentare il volto di un'altra persona come identità concorrente.
Picture 1 e Picture 2 definiscono Iris, la stessa donna adulta di fantasia di 32 anni. Picture 3 definisce l'outfit da casa crema di questa scena. Mostra Iris seduta su una poltrona accanto a una lampada calda con quell'outfit. Conserva il volto da Pictures 1 e 2. Appoggia una mano sul bracciolo e guarda lentamente verso la finestra. Inquadratura media con volto visibile. Audio: ambiente tranquillo della stanza.
Se il riferimento del capo contiene un'altra persona, specifica molto chiaramente il ruolo. Meglio ancora, rimuovi il suo volto quando puoi farlo senza perdere dettagli utili del capo.
Quando torna il vecchio costume, crea prima un'immagine modificata nel nuovo outfit. Quando volto e abbigliamento sono corretti insieme, anima quell'immagine accettata. Sposti la decisione contestata in un'immagine statica direttamente esaminabile.
Può essere più rapido da gestire che chiedere ripetutamente a un video di cinque secondi identità, costruzione del costume e movimento insieme. Produce anche un primo fotogramma riutilizzabile per brevi clip della stessa sequenza.
Un redesign permanente del personaggio richiede un nuovo set approvato; tienilo distinto da quello vecchio per riprodurre gli episodi precedenti. Un'identità rivista può giustificare riaddestramento LoRA. Un nuovo abito richiede solitamente prima riferimento d'abbigliamento o immagine iniziale preparata.
Due personaggi richiedono ruoli espliciti
Due RefMods non creano automaticamente due persone controllate indipendentemente. Nemmeno due LoRA riservano automaticamente una metà dell'inquadratura a ogni identità.
Il modello deve risolvere chi è presente, quali informazioni appartengano a ciascuno e cosa faccia. Diventa difficile se condividono acconciatura, vestiti e descrizione facciale o se il prompt usa frasi vaghe come «lei si gira verso di lei».
Introduci Alex, secondo personaggio adulto di fantasia di 35 anni. Assegnagli un taglio corto visibilmente diverso e un riferimento separato. Le differenze aiutano a descrivere la ripresa; non sostituiscono una fonte d'identità valida.
Per riferimenti ordinari, una prima disposizione semplice è:
- Pictures 1 e 2: Iris frontale e di tre quarti.
- Pictures 3 e 4: viste corrispondenti di Alex.
- Stanza e abbigliamento: descritti nel testo salvo serva un riferimento separato.
Poi scrivi il rapporto fra riferimenti e scena:
Pictures 1 e 2 mostrano Iris, donna adulta di fantasia di 32 anni. Pictures 3 e 4 mostrano Alex, uomo adulto di fantasia di 35 anni. Iris sta a sinistra nell'abito da sera antracite; Alex a destra con camicia scura a collo aperto. Si scambiano un sorriso tranquillo accanto a una finestra dell'appartamento. Iris si gira verso Alex mentre Alex continua a guardare Iris. Inquadratura media a due, entrambi i volti visibili, fotocamera ferma. Audio: atmosfera sonora serale morbida della stanza.
Destra e sinistra riducono l'ambiguità di questa composizione semplice. I nomi sostituiscono i pronomi nell'azione. La fotocamera resta ferma così la prima ripresa non deve anche farli attraversare, scambiare posizione e girarsi insieme.
Per RefMods locali, usa le etichette della mappa attuale. Un RefMod multi-immagine può apparire come riferimento video anziché immagine; non indovinarne il numero dal file né copiare quelli di un vecchio prompt dopo aver riordinato lo stack.
La guida ufficiale H3 ai prompt con riferimenti distingue soggetti visibili dai media che li forniscono. È utile qui: Iris è il soggetto; immagine o video sono la fonte delle informazioni. Puoi descriverne il posto nella nuova ripresa senza chiedere di riprodurre tutta la scena sorgente.
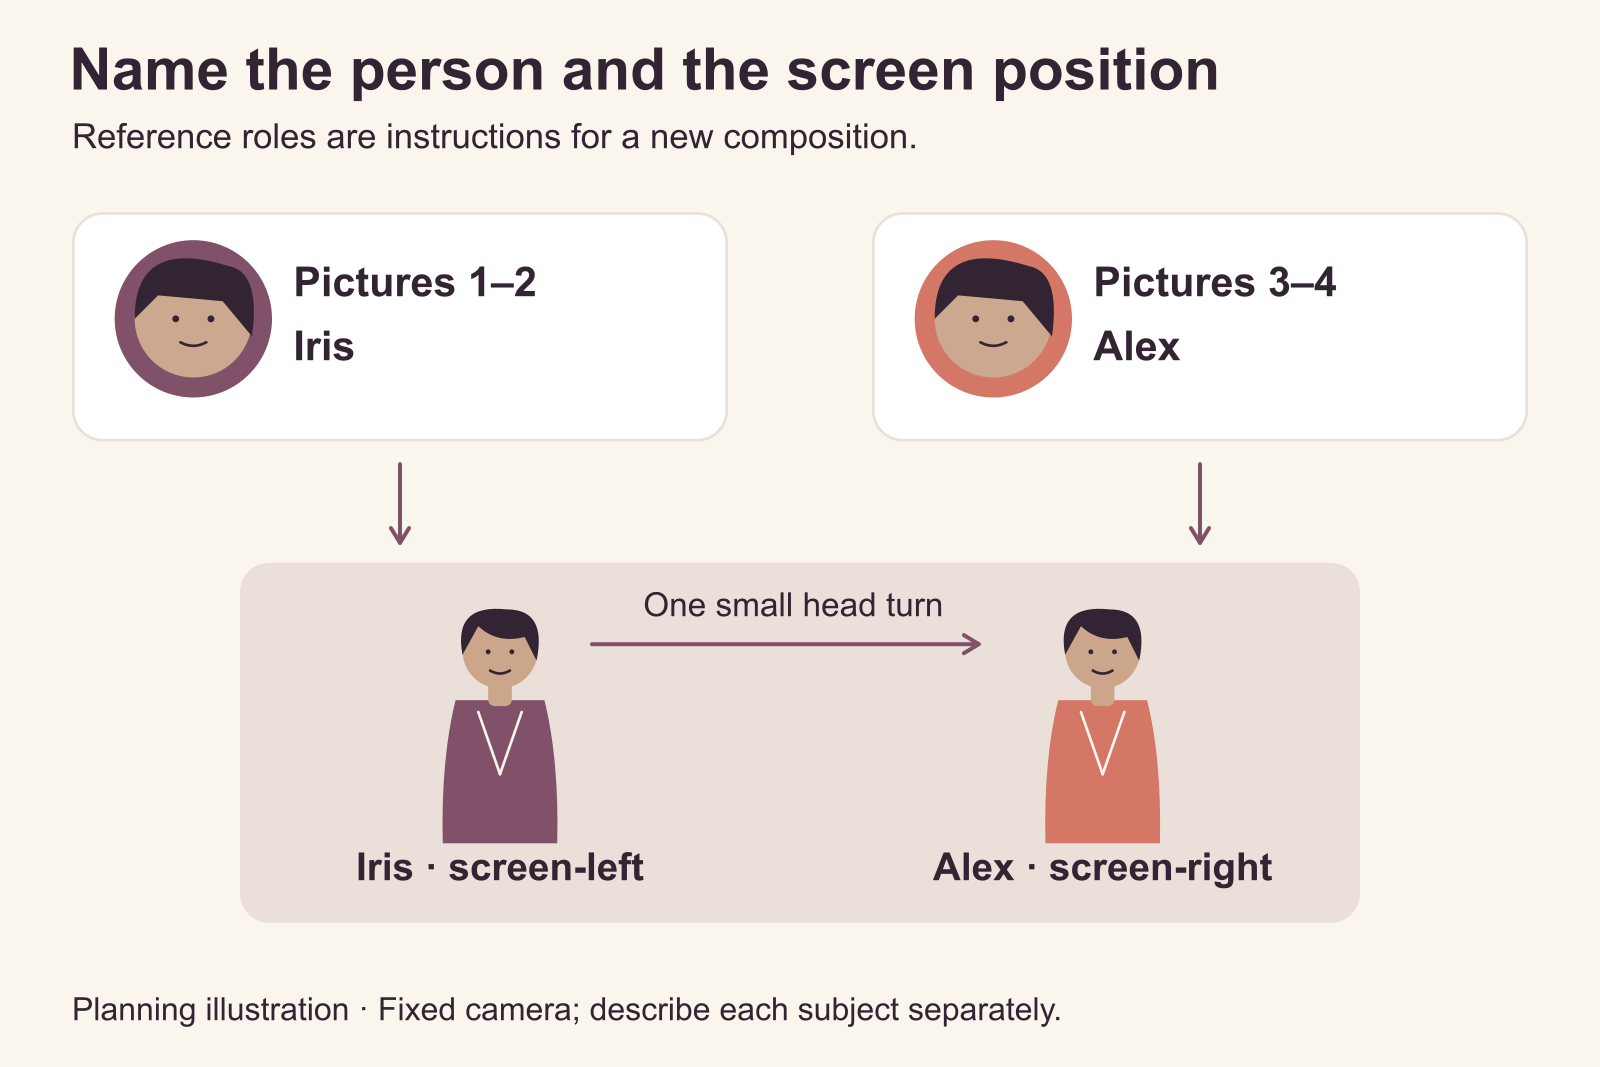
Illustrazione: assegna separatamente immagini sorgenti, persona e posizione sullo schermo.
Se i volti si mescolano, semplifica prima la composizione
Quando Alex eredita i capelli di Iris o Iris la forma del volto di Alex, controlla prima corrispondenza fra fonti ed etichette. Un'immagine assegnata male può sembrare un problema di qualità d'identità.
Se le etichette sono corrette, rendi i ruoli visivi più semplici: entrambi i volti visibili, posizioni separate e nessun attraversamento nella prima ripresa condivisa. Rimuovi un riferimento d'abbigliamento con un terzo volto riconoscibile. Se funzionano da soli ma insieme si fondono spesso, prepara un primo fotogramma a due con identità accettate e anima un'interazione contenuta.
Puoi anche cambiare il montaggio. Alterna riprese singole e sopra la spalla anziché forzare ogni momento narrativo in un'inquadratura mobile a due. È una scelta pratica quando la scena richiede continuità credibile più della visibilità continua di entrambi i volti.
Nessuna modifica garantisce un'interazione difficile. Affrontano fonti specifiche di ambiguità prima di spendere tempo in altre risorse d'identità.
Separa identità vocale e visiva
Un personaggio visivamente coerente che parla con una voce diversa a ogni episodio sembra comunque diverso. Salvare audio accanto a un RefMod visivo non stabilisce però un collegamento affidabile fra voce e volto.
Le note di validazione del progetto RefMod registrano trasferimento fallito dell'identità del parlante e copertura incompleta della generazione. Valuta i riferimenti audio come capacità separata nel workflow effettivo.
Per la prima sequenza visiva di Iris basta l'ambienza. Se una voce stabile è essenziale, pianifica un workflow separato di voce e dialogo invece di scegliere RefMods supponendo che un file combinato lo risolva già. Una LoRA visiva del personaggio addestrata non dimostra nemmeno una voce addestrata.
Quando l'addestramento di una LoRA del personaggio merita spazio
Addestrare ha senso quando l'identità è definita e ti serve qualcosa di più specifico che selezionare riferimenti più facilmente.
Tre situazioni meritano seria considerazione:
- Vuoi produrre il personaggio da testo a video con un adapter compatibile invece di fornire una vasta raccolta a ogni ripresa.
- Ti serve uno stile o comportamento appreso ricorrente che i normali riferimenti non esprimono adeguatamente.
- Hai già una produzione LoRA funzionante e vuoi quel personaggio disponibile in quella configurazione.
«Sto facendo una serie» da solo non basta. Dieci clip ritratto composte con cura possono funzionare bene da primi fotogrammi accettati. Una serie molto più grande può giustificare addestramento, ma solo se l'adapter riduce lavoro reale o aggiunge una capacità necessaria.
Addestra per il workflow che userà l'adapter
H3 non è un unico file di pesi intercambiabile. I percorsi FL2VA e Ref2VA richiedono scelte deliberate di compatibilità. La documentazione AI Toolkit Ref2VA identifica pesi Ref2VA separati e un adapter d'addestramento corrispondente. Non presumere che il nome H3 dimostri compatibilità con ogni task ospitato o checkpoint locale.
Prima di addestrare, decidi se l'output principale sarà da testo a video, animazione del primo fotogramma o video condizionato da riferimenti. Comunica il task a chi configura il trainer. Una ricetta impressionante in un grafo d'inferenza non è automaticamente un asset immediatamente utilizzabile in un altro.
Usa le istruzioni H3 attuali del trainer invece di copiare learning rate e passi da un tutorial riuscito Wan o di immagini. La documentazione H3 attuale di Musubi supporta diversi task e approcci distinti per conservare il comportamento base. Influenzano ciò che l'adapter apprende e ciò che può disturbare.
Prepara un dataset che insegni il personaggio, non una fotografia
Per Iris, la raccolta utile mostra l'identità nella variazione richiesta dalla serie. Deve includere volti leggibili agli angoli pertinenti, inquadrature più ampie se contano le proporzioni e più di una configurazione di abbigliamento e luce.
Non creare varietà includendo versioni incoerenti. Venti immagini della stessa persona accettata sono più coerenti di venti belle immagini che cambiano gradualmente naso e mascella. Analogamente, decine di ritagli quasi uguali di un ritratto non forniscono il profilo mancante.
Descrivi nelle caption ciò che cambia: outfit, inquadratura, espressione e scena. Mantieni il nome d'identità coerente con il metodo del trainer. Per una ricetta a trigger, una caption semplice può essere:
irisvale, donna adulta di fantasia di 32 anni, ritratto di tre quarti, top di maglia crema, espressione rilassata, luce morbida della finestra, sfondo interno semplice.
È un esempio di caption, non un comando universale d'addestramento H3. Alcuni metodi gestiscono deliberatamente l'identità diversamente. Segui quello scelto invece di unire consigli incompatibili.
Se il bersaglio è il volto, non aggiungere clip di movimento estranee solo perché il trainer accetta video. Se conta un movimento distintivo, scegli clip che lo mostrano chiaramente con persona riconoscibile. Immagini fisse e video forniscono informazioni diverse; aggiungere video aggiunge anche preparazione e addestramento.
Attenzione al tipo sbagliato di successo
Un campione può somigliare a Iris ed essere comunque un cattivo adapter produttivo. Segnali includono stesso sfondo in prompt estranei, vecchio costume che ritorna aumentando la forza, movimento rigido o incapacità di seguire una nuova direzione della fotocamera.
La soluzione non è sempre altro addestramento. Se checkpoint successivi sono più riconoscibili ma meno flessibili, uno precedente può essere più utile. Se tutti riproducono lo sfondo di addestramento, il dataset può essere troppo specifico. Se l'adapter non cambia nulla a forze ragionevoli, controlla compatibilità e caricamento prima di spendere un'altra notte sulle caption.
Una discussione separata sull'addestramento dei personaggi H3 descrive proprio il compromesso: alcuni trovavano somiglianza debole, un altro maggiore somiglianza con movimento, artefatti o adesione alle istruzioni peggiori. Include anche resoconti RefMod positivi e riferimenti deludenti. Non emerge un vincitore universale onesto.
Puoi combinare una LoRA compatibile con normali riferimenti. L'adapter fornisce una tendenza appresa; un'immagine accettata fornisce volto attuale, outfit o composizione. La combinazione è utile con ruoli chiari, non è un motivo per alzare ogni controllo di forza disponibile.
Tempo di preparazione e cosa paghi davvero
I riferimenti ordinari hanno il minimo impegno iniziale se le fonti esistono già. Il lavoro è selezionare file coerenti e assegnare ruoli. RefMods aggiunge installazione ed estrazione, poi riduce gestione ripetuta. LoRA aggiunge dataset, addestramento, selezione dei checkpoint e verifiche di compatibilità.
Il tempo dipende da hardware, quantità delle fonti, risoluzione e metodo. Il tentativo di cinque ore della community descrive quella singola esecuzione; usa trainer e hardware previsti per stimare la tua sessione.
| Costo | Riferimenti ordinari | RefMod | LoRA addestrata |
|---|---|---|---|
| Lavoro creativo iniziale | Immagini d'identità e viste utili | Stessa preparazione delle fonti | Dataset curato, spesso con più variazione |
| Preparazione aggiuntiva | Seleziona e ordina input | Installa, codifica ed esamina la risorsa | Configura e addestra; scegli un checkpoint utile |
| Lavoro ripetuto | Ricarica file o preset salvato | Carica il pacchetto | Carica pesi compatibili con trigger/impostazioni |
| Costo di generazione | Dipende da endpoint e riferimenti | Calcolo locale o noleggiato; i riferimenti mantenuti hanno ancora un costo | Generazione più eventuale policy host degli adapter |
| Costo di revisione | Cambia una fonte | Aggiorna l'asset | Possibile riaddestramento dell'identità appresa |
I prezzi ospitati sono separati dai costi RefMod locali
Le pagine H3 attuali di SpicyAPI accettano normali media di riferimento; quelle LoRA accettano anche pesi compatibili. Non espongono un campo di upload RefMod. Un file RefMod .safetensors non sostituisce una LoRA nel campo loras. Mantieni le fonti per usare lo stesso personaggio su un servizio ospitato.
Per un primo fotogramma approvato, H3 LoRA da immagine a video costa $0.05 per secondo a 480p e $0.10 a 768p. Cinque secondi costano $0.25 o $0.50. Caricare LoRA non aggiunge una tariffa separata in quel task. Quattro generazioni di cinque secondi costano rispettivamente $1.00 o $2.00: sono quattro output, non quattro risultati utili promessi.
Da riferimenti a video ha un conto diverso. H3 ordinario aggiunge $0.0068 per immagine ai secondi di output. H3 LoRA aggiunge $0.02 per immagine. Ecco stime complete di cinque secondi con soli riferimenti fissi. H3 ordinario non offre più il 480p, quindi quelle celle riportano un trattino:
| Richiesta di cinque secondi | 480p | 768p |
|---|---|---|
| H3, due immagini d'identità | — | $0.1986 |
| H3, due immagini d'identità più un'immagine di riferimento dell'abbigliamento | — | $0.2054 |
| H3 LoRA, due immagini d'identità | $0.34 | $0.715 |
| H3 LoRA, due immagini d'identità più un'immagine di riferimento dell'abbigliamento | $0.36 | $0.735 |
Per esempio, H3 ordinario 768p con due immagini è 5 × $0.037 + 2 × $0.0068 = $0.1986. Dieci generazioni totalizzano $1.986. Le richieste corrispondenti H3 LoRA totalizzano $7.15 a 768p. Scegli per il registro adulto del task specifico, input necessari e pesi compatibili. Un personaggio in più episodi non richiede di per sé LoRA.
Nel task LoRA con riferimenti, i secondi dei video sorgenti contano anche nei secondi fatturati e i riferimenti audio aggiungono una tariffa propria. Un RefMod locale non evita input o prezzi ospitati. Mantieni breve un riferimento del movimento e usalo solo quando contribuisce qualcosa assente in immagini e prompt.
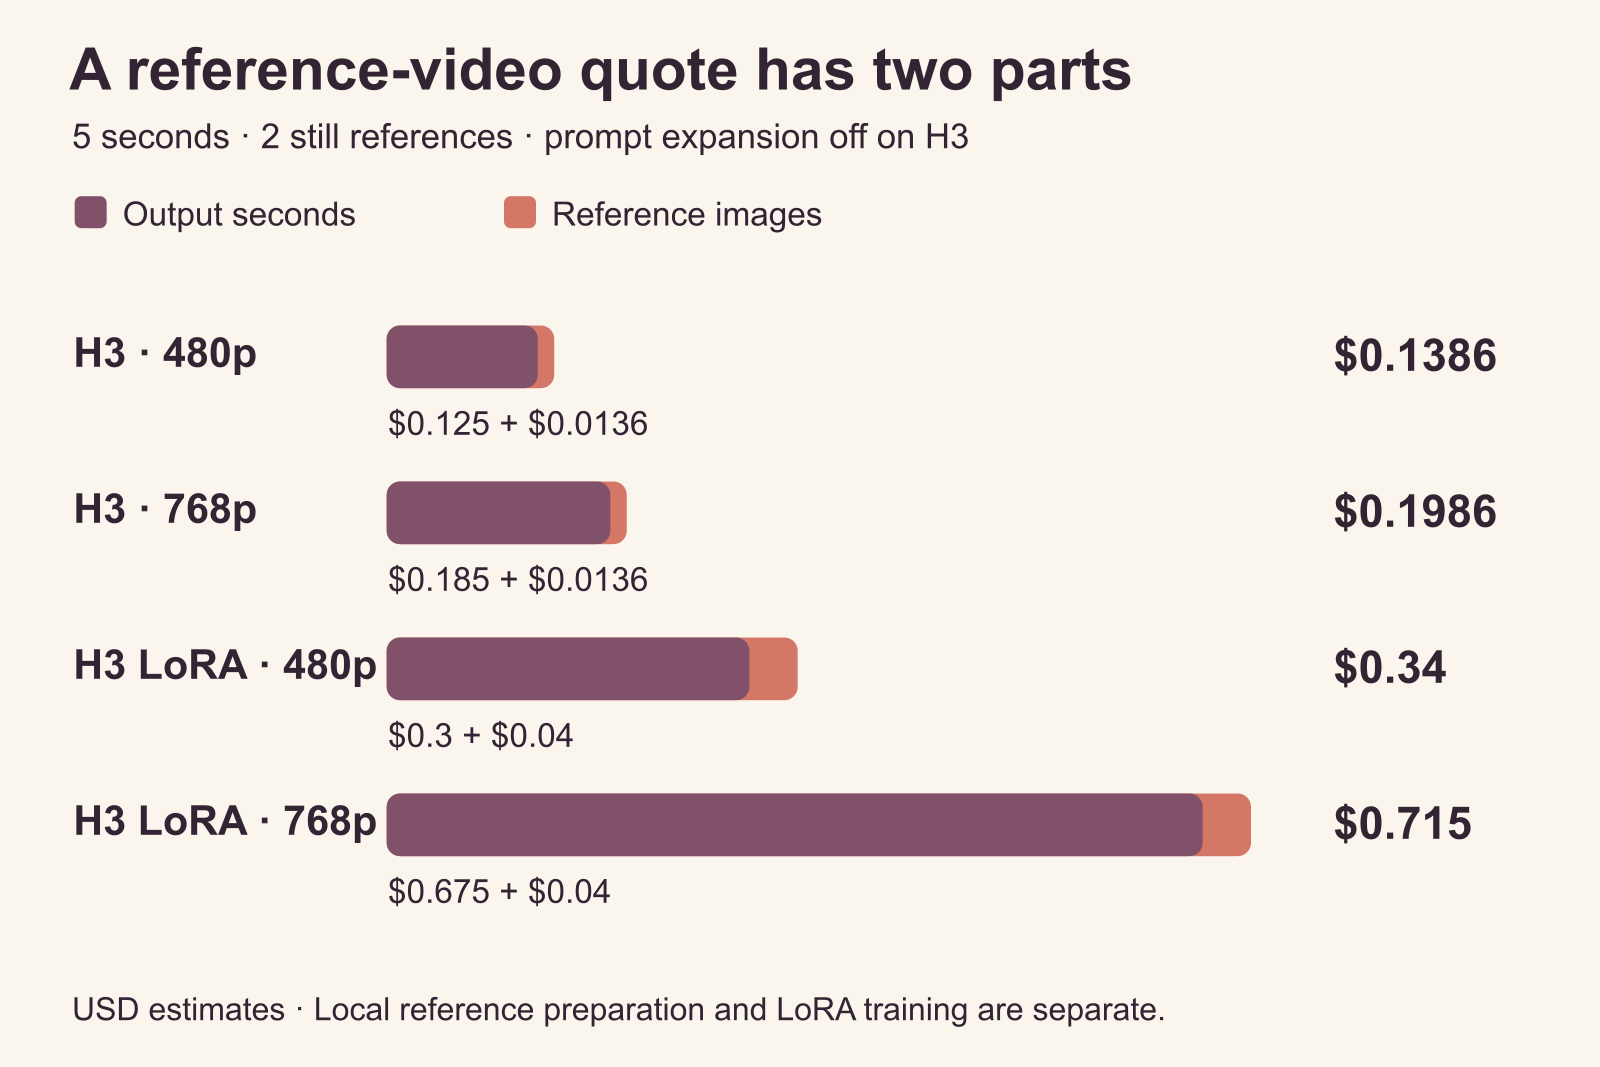
Stime di cinque secondi con entrambi i riferimenti fissi. Preparazione dei riferimenti e addestramento LoRA sono costi separati.
Decidi se l'addestramento risparmia abbastanza lavoro ripetuto
Il conto dell'addestramento è solo parte della decisione. Includi preparazione, noleggio GPU, campioni intermedi e tempo speso su output incompatibili. Una GPU economica non è un affare se l'adapter non produce mai un personaggio utilizzabile.
Per poche clip, resta sui riferimenti salvo possiedi già un adapter adatto. Per produzione frequente, identifica la spesa da ridurre: selezione ripetuta, tariffe ripetute delle immagini, inferenza lenta ricca di riferimenti o impossibilità di raggiungere un aspetto appreso specifico.
RefMods affronta principalmente selezione e preparazione ripetute. LoRA può affrontare gli altri problemi, ma solo dopo che funziona davvero nel percorso previsto. Non acquistare addestramento per un problema organizzativo già risolto da un preset di riferimenti salvato.
Conta anche onestamente gli output riusciti. Se paghi sei generazioni completate e ne usi due, la spesa per risultato utile è tre volte il costo per output. Vale per tutti e tre i metodi. Fonti migliori o ripresa più semplice possono contare più della tariffa pubblicizzata più bassa al secondo.
Errori comuni e modifica successiva utile
| Cosa vedi | Cosa controllare prima | Modifica |
|---|---|---|
| Davanti riconoscibile, nella rotazione cambia persona | Se i riferimenti mostrano l'angolo rivelato | Aggiungi un profilo accettato o riduci la rotazione |
| Torna l'outfit originale | Se è presente in ogni fonte d'identità | Sostituisci una fonte, separa l'outfit o prepara un nuovo inizio |
| RefMod con miniatura giusta ma volto debole | Ritaglio e rappresentazione salvati | Ricostruisci con ritaglio chiaro e base d'identità Full |
| Il personaggio salvato ignora il nome | Se il prompt usa l'etichetta reale del media | Assegna il soggetto all'etichetta della mappa attuale |
| Due personaggi si fondono | Ordine, ruoli e volti aggiuntivi | Correggi etichette, elimina volti concorrenti, parti da una ripresa statica a due |
| LoRA si carica ma non produce effetto utile | Compatibilità fra base, task e loader | Conferma l'inferenza prevista prima di riaddestrare |
| Somiglianza migliore ma movimento compromesso | Forza dell'adapter e checkpoint | Riduci influenza o usa un checkpoint precedente utile |
| La nuova stanza diventa quella vecchia | Se restano informazioni del vecchio luogo | Elimina completamente il vecchio riferimento |
| Volto stabile ma voce diversa | Se esiste una soluzione vocale separata | Tratta identità del dialogo come task produttivo proprio |
Cambia l'input più direttamente collegato al tratto indesiderato. Un outfit indesiderato richiede di rivedere la sua fonte prima di cambiare checkpoint, sampler e tutto il set.
Per proseguire, la guida API H3 LoRA tratta caricamento di un adapter esistente e scelta del task. Il confronto delle versioni H3 spiega le varianti del prodotto. Sono decisioni separate dal bisogno di addestrare il personaggio ricorrente.
Scegli per il prossimo episodio
Per il prossimo episodio di Iris, seleziona ritratto approvato e vista alternativa necessaria, scegli il task adatto alla scena adulta e crea una clip di cinque secondi. Salva un RefMod quando ripetere la preparazione diventa il problema. Addestra una LoRA compatibile quando la serie richiede una capacità appresa o un percorso di distribuzione che i riferimenti non forniscono. Lascia che il bisogno produttivo successivo determini l'investimento.