반복 성인 캐릭터는 소개한 인물 사진만이 아니라 다음 에피소드에서도 알아볼 수 있어야 합니다. 원하는 얼굴을 얻은 뒤 MiniMax H3 RefMod와 LoRA를 고르는 문제는 의상, 각도, 함께 나오는 인물이 바뀔 때 얼마나 많은 작업을 반복할지에 관한 것입니다.
일반 참조 이미지부터 시작하세요. 이미 ComfyUI를 쓰며 같은 이미지를 반복 재사용한다면 RefMod를 저장하세요. 참조 워크플로가 효율적으로 제공하지 못하는 학습된 캐릭터나 스타일이 필요하면 LoRA 학습을 고려하세요. RefMod는 참조 정보를 포장하지 캐릭터를 H3에 학습하지 않습니다. LoRA는 학습이 필요하며 추가 투자가 더 좋은 닮음을 자동으로 만들지는 않습니다.
새 가상 성인 페르소나에는 일관된 시점 몇 개가 보통 첫 유용한 투자입니다. 안정된 주간 시리즈에는 참조 라이브러리가 반복 준비를 줄입니다. 학습은 캐릭터가 정해지고 해결할 한계를 구체적으로 말할 수 있을 때 합리적인 비용이 됩니다.
NSFW 시리즈의 정체성은 얼굴 일치 이상입니다. 가까운 장면과 넓은 성인 대상 장면에서도 체형, 피부색, 특징적 표식이 이어져야 할 수 있습니다. 여기의 참조 영상 작업은 공개 콘텐츠 테스트 이력이 다릅니다. 일반 H3는 중간 강도의 NSFW 이미지 생성 기록이, H3 LoRA는 더 높은 강도 성인 장면 기록이 있습니다. 작업별 관찰은 RefMod 비교나 모든 장면 보장이 아니므로 정체성 처리와 콘텐츠 능력을 따로 고르세요.
| 상황 | 시작점 | 이유 |
|---|---|---|
| 완성 장면 이미지 하나로 짧은 클립이 필요함 | 이미지 영상 변환 | 구도와 의상이 첫 프레임에 이미 있음 |
| 같은 캐릭터를 새 방·의상에 배치해야 함 | 일반 참조 영상 생성 | 저장 자산을 다시 만들지 않고 재료 변경 가능 |
| ComfyUI에서 같은 참조를 반복 로드함 | RefMod | 정리된 참조 묶음 재사용 |
| 호환 H3에서 텍스트로 캐릭터를 생성하고 싶음 | 학습한 캐릭터 LoRA | 학습 정체성을 어댑터에 넣을 수 있음 |
| 이름 있는 캐릭터 둘이 한 숏에 필요함 | 인물별 별도 참조 | 복잡하게 만들기 전에 정체성과 화면 위치 배정 |
| 반복되는 특징적 스타일·동작이 필요함 | 적합한 LoRA 또는 관련 참조 | 작업에 맞게 선택. 캐릭터 어댑터가 자동으로 동작 어댑터는 아님 |
아래는 성인 대상 인물·영상 시리즈의 가상 32세 Iris 예시입니다. 실용적인 시작 지시이며 새로 생성한 비교 결과는 아닙니다.
각 방식이 실제로 줄이는 작업
일반 참조는 생성에 넣는 이미지 또는 지원 미디어입니다. 다음 숏에서 다시 선택하거나 도구의 저장 워크플로로 불러옵니다. 모델의 영구 지식이 되지는 않습니다. 열 프롬프트에서 ‘Iris’라고 불러도 지속 정체성이 생기지는 않습니다.
RefMod는 참조 미디어를 호환 H3 워크플로용 재사용 파일로 바꿉니다. 원래 RefMod 프로젝트는 H3 가중치 학습 없이 VAE 참조 표현을 저장한다고 설명합니다. Full은 정보를 더 유지하고 Compressed는 디테일을 줄여 참조 토큰을 적게 씁니다. 과거 내부 모드명 training은 압축 잠재값 정제이지 LoRA 학습이 아닙니다. 옷, 정체성, 배경이 함께 전달될 수 있습니다.
LoRA는 기본 모델과 함께 쓰는 학습된 변경 집합인 어댑터입니다. 원래 LoRA 논문은 저랭크 적응 원리를 설명합니다. H3에서는 학습 예시를 준비해 생성 워크플로가 실제로 로드할 가중치를 만들어야 한다는 뜻입니다. 둘 다 .safetensors로 끝나도 사진을 RefMod로 저장하는 것과 LoRA를 학습하는 것은 다른 문제를 풉니다.
| 질문 | 일반 참조 | RefMod | 학습 LoRA |
|---|---|---|---|
| 준비할 것 | 선택 이미지 또는 지원 미디어 | 미디어와 호환 추출 워크플로 | 정제 학습 데이터와 학습기 |
| 재사용할 것 | 원본과 프롬프트 역할 | 저장 참조 표현 | 학습 어댑터 가중치 |
| 잘못된 원본 하나를 바꿀 수 있나 | 이미지 교체 | 묶음 재구성·편집 | 학습된 문제라면 데이터 수정·재학습 |
| 참조 없이 생성 가능한가 | 아니요 | 아니요. 저장 참조가 조건화 | 어댑터와 작업에 따라 가능 |
| 같은 인물 보장인가 | 아니요 | 아니요 | 아니요 |
| 범용 H3 업로드인가 | 엔드포인트 지원 미디어만 | 아니요 | 로더가 지원하는 호환 LoRA만 |
자산이 기대에 못 미치면 이 구분이 중요합니다. RefMod에 일치하지 않는 옆면이 있으면 이름을 잘 붙여도 얼굴은 고쳐지지 않습니다. LoRA가 Iris와 특정 의상을 함께 배웠다면 새 의상은 학습 연관과 경쟁할 수 있습니다. 둘 다 준비가 결과에 영향을 주지만 고칠 단계는 다릅니다.
RefLoRA도 볼 수 있습니다. RefLoRA 프로젝트는 학습 LoRA와 RefMod를 한 파일에 포장합니다. 일반 LoRA 로더는 가중치, 호환 결합 로더는 둘 다 씁니다. 포장이 LoRA 학습을 없애지 않고 호스팅 서비스가 참조 절반을 자동으로 읽지도 않습니다. 확장자보다 파일 내용과 사용할 로더를 확인하세요.
먼저 무엇을 같게 유지할지 정하세요
Iris의 반복 정체성을 좁게 정합니다. 32세 성인 여성, 짧은 적갈색 단발, 넓은 눈썹, 곧은 코, 알아볼 얼굴 형태입니다. 검은 이브닝 의상, 크림색 라운지 세트, 침실 조명, 카메라 거리는 숏 선택입니다.
이렇게 분리하면 시리즈에서 바꿔야 하는데 첫 이미지 전체를 보존하려는 비싼 실수를 막습니다. 참조 사진은 사람, 옷, 포즈, 빛, 방을 가진 완전한 장면입니다. 사람은 ‘Iris를 일관되게’ 이해하지만 입력은 어떤 부분이 Iris이고 어떤 부분이 에피소드인지 밝혀야 합니다.
성인 시리즈에서 다른 인식 문제는 다른 참조로 정하세요.
| 관객이 알아보는 것 | 유용한 원본 | 장면에 따라 바뀌어도 되는 것 |
|---|---|---|
| 얼굴, 눈썹 형태, 헤어라인 | 선명한 인물 사진과 승인 회전 각도 | 표정, 시선, 화장 |
| 체형과 상대 비율 | 어깨·허리·자세가 읽히는 승인 넓은 시점 | 포즈, 거리, 의상 |
| 반복되는 작은 어깨 문신 | 실제 디자인과 위치가 선명한 시점 | 조명과 프레임에 보이는지 여부 |
| 특정 세트 스타일 | 선택 의상과 머리 정리 | 다음 에피소드 스타일 |
얼굴 크롭은 넓은 장면의 비율을 정하지 못하고 먼 전신은 자세를 보여도 얼굴 정보가 적습니다. 어깨 문신이 바뀌면 모든 참조 강도를 높이기보다 그 디테일 원본을 더하세요. 정확한 위치가 필수면 시작 정지 이미지에서 정한 뒤 움직입니다. 같은 분리는 성인 인물 세트, 라운지 시퀀스, 더 성숙한 장면에 맞으며 숏이 보일 정보를 정합니다.
작은 원본 폴더를 세 종류로 준비하세요.
- 정체성 시점: 같은 사람으로 승인한 선명한 인물 사진, 3/4, 옆면.
- 의상 예시: 가능하면 정체성 선택과 분리한 반복 의상별 이미지.
- 장면 이미지: 빈 방 또는 특정 숏의 승인 시작 프레임.
작업 정리이지 필수 데이터 수가 아닙니다. 조용한 인물 클립에는 첫 사진만 필요할 수 있습니다. 회전 숏에는 드러낼 특징의 승인 시점이 유용합니다. 방이 매주 바뀐다면 가까운 얼굴 참조에 방 이미지의 역할은 없습니다.
정체성 사진은 아름다움 전에 턱, 코, 눈썹, 헤어라인을 비교하세요. 더 예쁜 생성 인물도 다른 사람일 수 있습니다. 지금 제외하는 편이 모순 얼굴로 묶음을 만드는 것보다 수고가 적습니다.
영구 특징과 스타일도 구분하세요. 머리를 묶을 때도 단발 실루엣만으로 인식하지 않게 얼굴을 보여 줘야 합니다. 의상과 함께 바뀌는 액세서리를 다른 캐릭터와 구별하는 유일한 특징으로 삼지 마세요.
성숙한 이미지도 같습니다. 원본이 모든 미래 장면의 강도·구도를 재현할 필요는 없습니다. 정체성 참조는 읽기 쉬운 정체성으로, 생성 경로는 장면에 맞게 고르세요. 참조 포장과 캐릭터 학습 어느 것도 엔드포인트의 성인 요청 충족 범위를 정하지 않습니다.
일반 참조: 새 시리즈의 가장 좋은 시작점
캐릭터를 아직 정하는 중이거나 의상이 자주 바뀌거나 ComfyUI 관리 없이 호스팅 Playground를 쓰고 싶으면 일반 참조가 유용합니다.
오류도 명확하게 드러납니다. 제공한 정확한 이미지를 보고 충돌 원본을 제거해 다음 숏을 실행할 수 있습니다. 캐릭터가 정해지기 전 이런 단순함은 가치 있습니다. 복잡한 저장 묶음은 약한 이미지를 알아보기 어렵게 할 수 있습니다.
두 정체성 시점으로 5초 숏 만들기
Iris 정면을 Picture 1, 승인 3/4를 Picture 2로 쓰세요. 첫 숏 배경은 글로 설명해 두 참조를 인물 전용으로 합니다.
호스팅 H3 참조 영상은 최대 아홉 이미지와 4~15초를 지원합니다. 5초, 768p, 세로 9:16으로 시작하면 이 두 이미지에서 $0.1986입니다. 방향을 남길 가치가 생긴 뒤 큰 출력으로 옮길 수 있습니다.
Picture 1과 Picture 2는 같은 가상의 32세 성인 여성 Iris다. 얼굴 정체성, 짧은 적갈색 단발, 비율에 사용한다. Iris는 차콜 새틴 이브닝 드레스를 입는다. 조용한 아파트의 따뜻한 침대 옆 램프 옆에 앉아 3/4에서 카메라 쪽으로 천천히 얼굴을 돌린다. 중간 클로즈업, 눈높이 카메라, 부드러운 표정, 안정된 프레임. 회전 내내 얼굴이 명확하게 읽힌다. 오디오: 부드러운 실내 배경음.
참조와 텍스트에 각각 역할을 줍니다. 예전 배경·옷 보존과 새 방 생성을 동시에 요구하지 않습니다. 작은 회전은 여러 포즈 없이 명확한 행동을 줍니다.
원본도 차콜 드레스이고 지키고 싶으면 말하세요. 한 원본이 재킷이라면 출력 의상은 드레스라고 명시합니다. 재킷이 계속 돌아오면 드레스 문단을 더하기보다 해당 참조 교체·크롭이 유용합니다.
장면이 이미 맞으면 첫 프레임을 쓰세요
Iris가 크림색 라운지 의상으로 램프 옆에 앉고 표정·방도 맞는 사진을 이미 만들었다면 다음은 이미지 영상입니다. 승인 이미지에서 시작하고 참조 영상은 재료로 새 숏을 구성합니다.
동작 지시는 다음처럼 쓸 수 있습니다.
첫 프레임의 가상 성인 여성 Iris가 카메라 쪽으로 부드럽게 시선을 들고 편안한 작은 미소를 짓는다. 어깨는 같은 위치에 둔다. 카메라는 천천히 조금 가까워진다. 램프는 일정하다. 오디오: 조용한 실내 배경음.
차이는 수고를 쓰는 곳입니다. 장면 구성에는 참조, 구성 뒤 움직임에는 첫 프레임을 씁니다. 완성 이미지 하나를 움직이려고 캐릭터 LoRA를 학습하면 당장 작업 전에 별도 프로젝트가 생깁니다.
첫 프레임도 이후 모든 프레임의 완벽함을 약속하지 않습니다. 긴 회전에서 낯선 옆얼굴이 보이면 회전을 줄이거나 좋은 시작 각도를 준비하세요. 정체성 방식 전체를 실패로 판단하기 전에 해결할 숏 설계 문제입니다.
RefMod: 참조 준비가 반복될 때 유용합니다
캐릭터가 마음에 들고 ComfyUI를 이미 쓰며 같은 모음을 계속 만들 때 RefMod가 매력적입니다. 이름 있는 자산이 반복 선택·준비를 대체하므로 연산과 정리 모두 절약할 수 있습니다.
저장 파일과 이를 사용하는 워크플로는 다릅니다. 다른 H3 노드는 참조를 다르게 전달할 수 있습니다. 한 제작자 그래프의 좋은 결과가 모든 RefMod 로더에서 같은 캐릭터를 증명하지 않습니다.
Adudeguyman Fantastic H3 Prompt Builder는 참조 관리자와 프롬프트 편집기를 더합니다. 참조 맵은 실제 입력 라벨을 보여 줍니다. 최신 버전은 인코더 프레임 저장과 텍스트 인코더에 보이는 사진 수의 실험 선택을 제공합니다. 사진이 늘면 메모리와 생성 시간도 늘 수 있습니다. 워크플로 제어이지 정체성 향상 보장은 아닙니다.
재사용 Iris 자산 만들기
RefMod 사용 안내는 설치와 노드별 지시를 제공합니다. 이 작업의 순서는 다음과 같습니다.
- 작동하는 H3 참조 워크플로와 맞는 VAE로 시작합니다.
- RefMod 라이브러리 생성 화면에서 승인 Iris 이미지를 넣습니다.
- 크롭 미리보기를 봅니다. 첫 이미지가 합친 세트 형태를 정하므로 얼굴·머리가 잘리는 원본을 조정합니다.
- 정체성 기준에는 Full을 선택하고 캐릭터 이름을 붙여 묶음을 만듭니다.
- 저장 자산을 스택에 더하고 프롬프트의 인물 역할을 쓰기 전에 참조 맵을 읽습니다.
원본도 남기세요. 저장 참조는 편리하지만 잘못된 시점 제거, 새 크롭 준비, 다른 앱 이동에는 원본 폴더가 필요합니다.
Iris의 모든 과거 사진을 마스터 하나에 넣지 마세요. 좋은 반복 캐릭터 자산은 ‘Iris의 승인 시점’으로 쉽게 설명됩니다. ‘방 셋, 의상 넷, 예전 머리, 한 번 나왔던 둘째 캐릭터’까지 뜻해서는 안 됩니다.
생성을 탓하기 전에 저장 결과를 보세요
크롭과 압축이 지키려던 특징을 없앨 수 있습니다. 파일 브라우저 썸네일만으로 원하는 디테일의 전체 인물 사진이 저장됐는지 증명할 수는 없습니다.
원본 얼굴은 선명한데 저장 미리보기가 흐리거나 좁거나 잘리면 자산부터 개선하세요. 중요한 디테일이 줄어든 큰 묶음보다 선명한 소수 시점이 인물 시리즈의 합리적인 시작입니다.
Full과 Compressed는 유용하지만 작은 파일이 ‘무료 조건화’를 뜻하지는 않습니다. 작은 저장 파일도 생성에 참조 정보를 더합니다. 반대로 디테일을 많이 남기면 원치 않는 방·옷도 얼굴과 남을 수 있습니다. 강도 조정보다 먼저 필요한 정보를 선택하세요.
Iris에는 정체성 자산과 선택적 방 자산을 분리하세요. 숏에 필요한 것만 로드합니다. 다른 아파트이면 예전 방은 빼세요. 역할 없는 방의 강도를 낮추는 것은 간접 해결입니다.
커뮤니티 결과가 모순처럼 보이는 이유
한 H3 캐릭터 학습 토론의 작성자는 RTX 5090에서 약 5시간 학습해도 닮음이 만족스럽지 않았다고 했습니다. 답변은 RefMod를 칭찬했지만 일부는 일반 참조보다 닮음이 나쁘거나 시간이 길다고 했습니다. 여러 이미지를 한 파일로 포장하면 새로 학습한 정체성이 된다는 생각도 지적했습니다.
편의, 속도, 닮음은 별개 이점입니다. RefMod가 편리해도 사용자 그래프에서 빠르지 않을 수 있습니다. 준비를 줄여도 특정 얼굴은 개선되지 않을 수 있습니다. 성공 예시는 자산 외에도 체크포인트, 크롭, 참조 전달, 프롬프트에 의존할 수 있습니다.
Prompt Builder 제작자 업데이트는 텍스트 인코더로 참조를 전달하는 방식을 바꿔 캐릭터 혼합을 줄였고 시간·메모리 비용이 더 들었다고 보고했습니다. 같은 게시물에는 목소리 바뀜도 남았습니다. 특정 구현의 결과와 남은 문제이지 모두에게 RefMod가 캐릭터 LoRA를 대체했다는 근거는 아닙니다.
캐릭터를 바꾸지 않고 의상 바꾸기
반복 성인 페르소나는 인식과 새로움이 함께 필요합니다. 얼굴은 익숙하고 인물 세트, 라운지, 이브닝 시퀀스 사이 스타일은 바뀝니다. 이때 편리한 묶음이 너무 넓어질 수 있습니다.
모든 Iris 참조가 같은 짙은 새틴 드레스이면 옷이 강한 시각 지시가 될 수 있습니다. 다른 의상 다섯 장을 더하면 정보와 경쟁 의상 근거가 함께 늘어납니다.
실용적인 정리는 다음과 같습니다.
| 자산 | 들어갈 것 | 쓸 때 |
|---|---|---|
| Iris 정체성 | 일관된 얼굴 특징의 승인 시점 | 기존 인물이 필요한 모든 숏 |
| 이브닝 의상 | 드레스와 스타일의 선명한 시점 하나 | 저녁 시퀀스 |
| 라운지 의상 | 크림색 의상 시점 하나 | 라운지 시퀀스 |
| 아파트 장면 | 경쟁 인물 없는 방 | 특정 방이 필요한 숏 |
| 승인 첫 프레임 | Iris, 선택 의상, 최종 구도가 함께 있는 이미지 | 정확한 설정의 이미지 영상 |
일반 파일로 충분합니다. 호환 로컬에서 반복 재사용할 부분만 RefMod로 만드세요. 일회 소품에 영구 묶음의 이점은 없습니다.
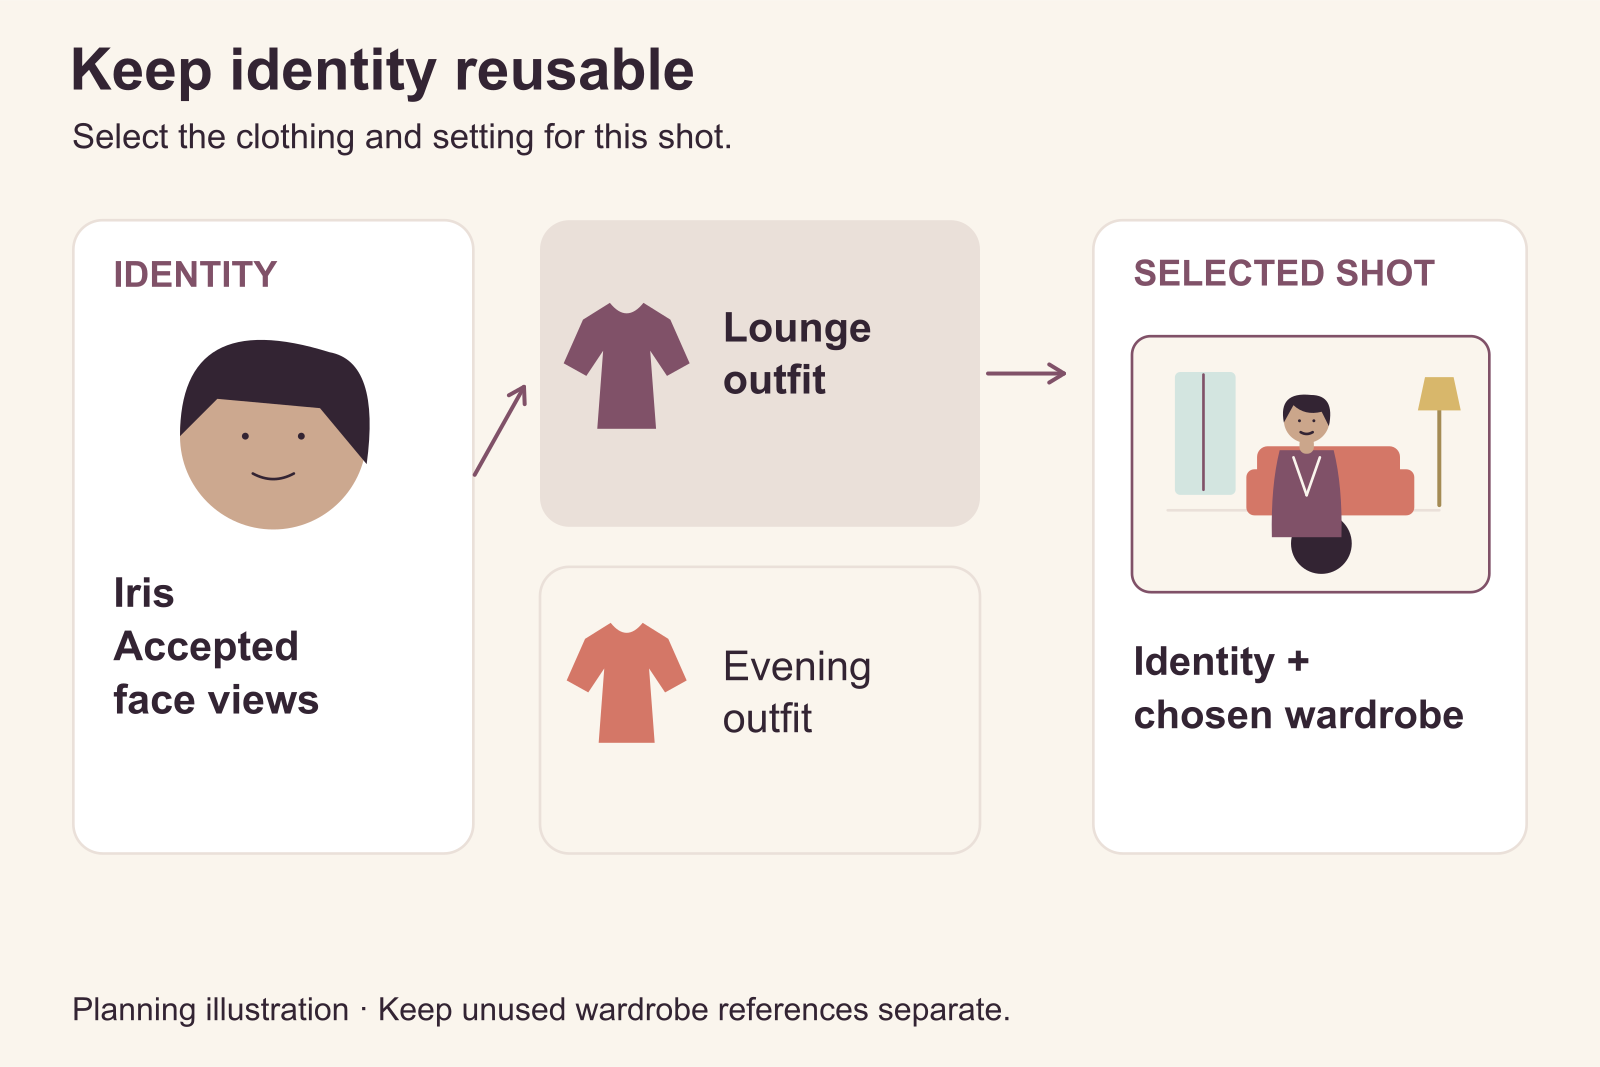
의상 구성 예시: 정체성은 재사용하고 옷과 배경은 숏마다 고르세요.
새 의상에 명확한 원본을 주세요
같은 정체성 두 장에 의상을 Picture 3로 더하세요. 경쟁하는 얼굴 없이 옷이 명확한 의상 단독 원본이나 크롭이 좋습니다.
Picture 1과 Picture 2는 같은 가상의 32세 성인 여성 Iris를 정한다. Picture 3는 이 장면의 크림색 라운지 의상이다. Iris가 그 옷을 입고 따뜻한 램프 옆 안락의자에 앉아 있다. Pictures 1과 2의 얼굴을 지킨다. 한 손을 팔걸이에 두고 창문 쪽으로 천천히 바라본다. 얼굴이 보이는 중간 숏. 오디오: 조용한 실내 배경음.
옷 사진에 다른 사람이 있으면 역할을 특히 분명히 하세요. 가능하면 유용한 옷 디테일을 잃지 않고 얼굴을 제거하는 편이 더 좋습니다.
이전 옷이 계속 돌아오면 새 의상으로 정지 이미지 편집부터 하세요. 얼굴·옷이 함께 맞으면 승인 이미지를 움직입니다. 논쟁 의상 선택을 직접 검토 가능한 정지 단계로 옮깁니다.
5초 영상에 정체성, 옷 구조, 동작을 반복 해결하게 하는 것보다 관리가 빠를 수 있습니다. 같은 의상 시퀀스의 짧은 여러 클립용 첫 프레임도 생깁니다.
영구 캐릭터 재설계에는 새 승인 참조가 필요하며 이전 에피소드를 재현하려면 구버전과 분리하세요. 정체성 수정은 LoRA 재학습을 정당화할 수 있습니다. 새 드레스는 대체로 의상 참조나 첫 프레임부터입니다.
두 캐릭터에는 명확한 역할이 필요합니다
RefMod 두 개가 독립 제어 인물 둘을 자동으로 만들지 않습니다. 캐릭터 LoRA 두 개도 각 정체성에 화면 절반을 자동 예약하지 않습니다.
모델은 누가 있고 어느 정보가 누구 것이며 각자 무엇을 하는지 풀어야 합니다. 같은 머리, 옷, 얼굴 설명이 있거나 ‘그녀가 그녀 쪽으로 돈다’는 모호한 말이면 어렵습니다.
둘째 가상 성인 Alex를 35세로 소개합니다. 다른 짧은 머리와 별도 참조를 줍니다. 차이는 설명에 유용하지만 유효한 정체성 원본 대안은 아닙니다.
일반 참조의 첫 배치는 다음처럼 단순하게 합니다.
- Pictures 1, 2: Iris 정면과 3/4.
- Pictures 3, 4: Alex의 같은 시점.
- 방·의상: 별도 참조가 필요하지 않으면 텍스트 설명.
참조와 장면 관계를 씁니다.
Pictures 1과 2는 가상의 32세 성인 여성 Iris, Pictures 3과 4는 가상의 35세 성인 남성 Alex다. Iris는 차콜 이브닝 드레스로 왼쪽에, Alex는 목깃을 연 짙은 셔츠로 오른쪽에 선다. 아파트 창문 옆에서 조용한 미소를 나눈다. Iris는 Alex 쪽으로 돌고 Alex는 Iris를 계속 본다. 중간 투숏, 두 얼굴이 보이고 카메라는 고정한다. 오디오: 부드러운 저녁 실내 배경음.
좌우가 단순 구도의 모호함을 줄이고 행동에는 대명사 대신 이름을 씁니다. 첫 숏에 교차 이동, 화면 위치 교환, 함께 돌아서기까지 필요하지 않게 카메라는 고정합니다.
로컬 RefMod는 현재 참조 맵의 라벨을 쓰세요. 다중 이미지 RefMod가 사진 대신 영상 참조로 보일 수 있습니다. 파일명으로 번호를 추측하거나 스택 재정렬 뒤 예전 번호를 복사하지 마세요.
공식 H3 참조 프롬프트 가이드는 보이는 주체와 이를 제공하는 미디어를 구분합니다. Iris는 주체이고 사진·영상은 정보 원본입니다. 원본 장면 전체 재현을 요구하지 않고 새 숏의 위치를 설명하게 합니다.
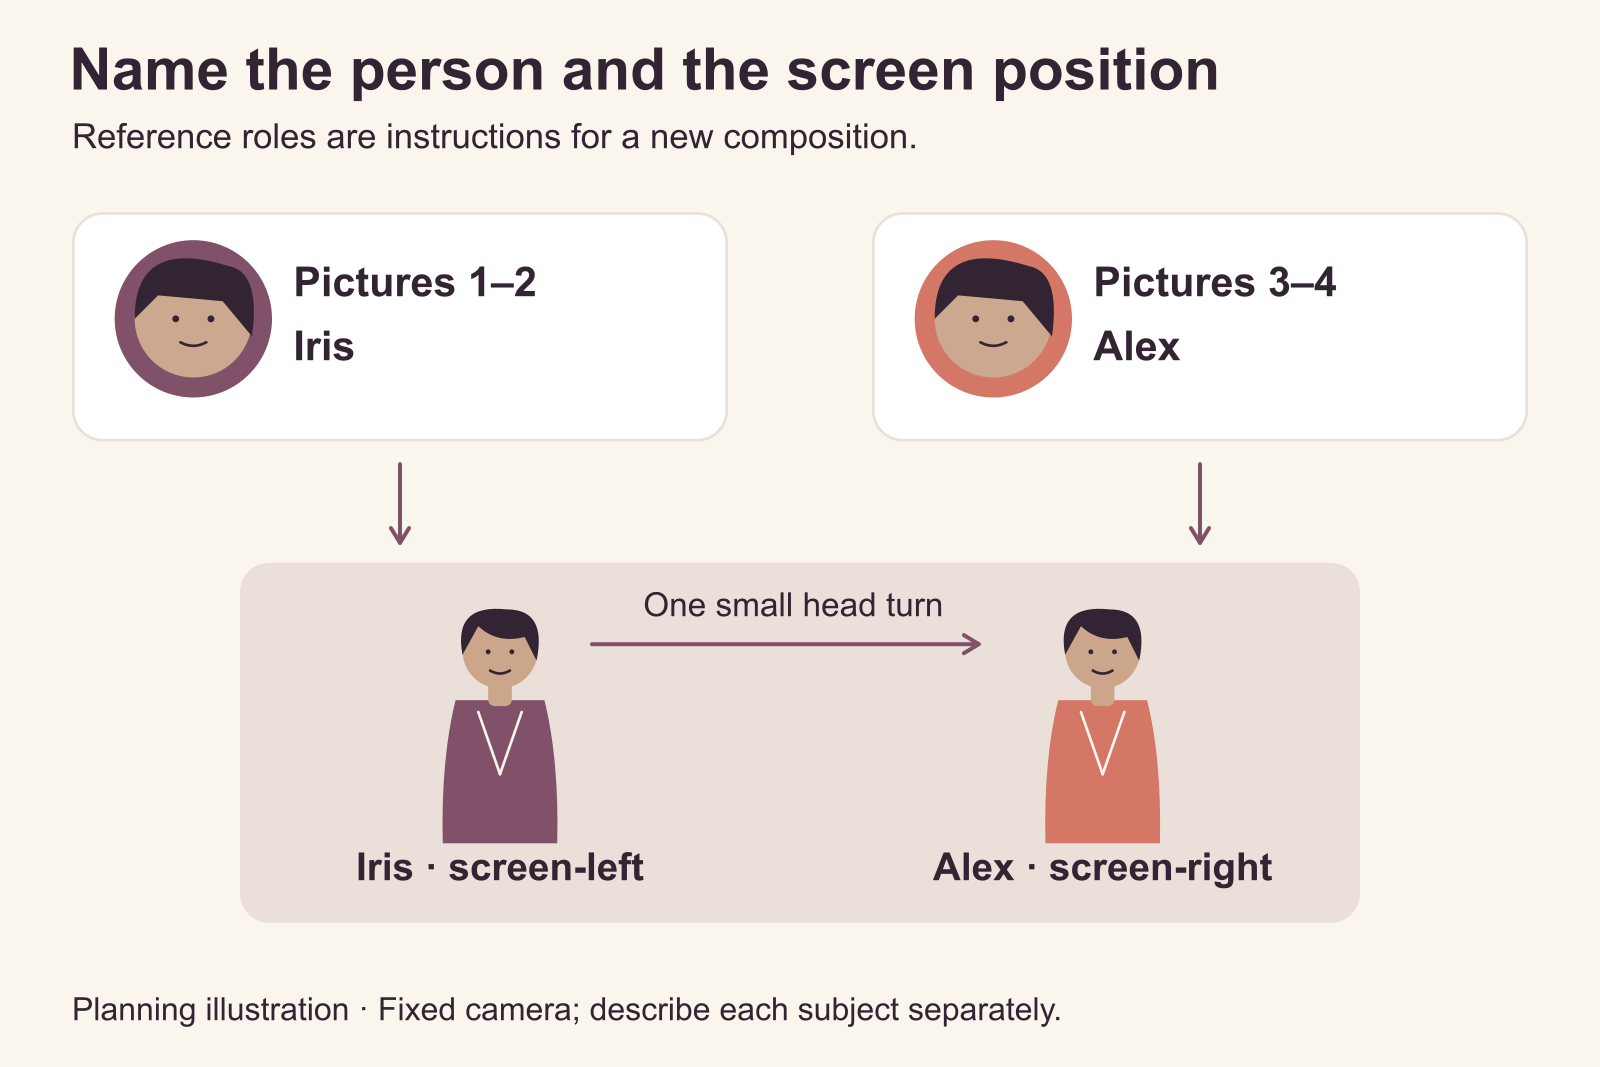
역할 배정 예시: 원본 이미지, 인물, 화면 위치를 각각 지정하세요.
얼굴이 섞이면 구도부터 단순화하세요
Alex가 Iris 머리를 얻거나 Iris가 Alex 얼굴을 얻으면 원본·프롬프트 라벨이 맞는지 보세요. 잘못 배정한 사진이 정체성 품질 실패처럼 보일 수 있습니다.
맞으면 시각 역할을 쉽게 하세요. 두 얼굴과 별도 위치를 유지하고 첫 공동 숏의 교차를 피합니다. 셋째 얼굴 있는 의상 참조를 제거하세요. 따로는 되지만 함께 반복 혼합되면 승인된 두 정체성의 첫 프레임을 준비해 작은 상호작용으로 움직입니다.
편집도 바꿀 수 있습니다. 모든 이야기 순간을 움직이는 투숏에 넣기보다 싱글과 어깨 너머 숏을 번갈아 씁니다. 두 얼굴의 계속 등장보다 믿을 만한 연속성이 중요할 때 실용적입니다.
어느 변경도 어려운 상호작용을 보장하지 않습니다. 자산을 더 만들기 전에 특정 모호함을 다룹니다.
목소리 정체성과 시각 정체성을 분리하세요
외형이 같아도 매 에피소드 목소리가 다르면 다른 인물처럼 느껴집니다. 하지만 시각 RefMod 옆 오디오 저장이 그 목소리와 얼굴의 안정 연결을 정하지는 않습니다.
RefMod 검증 메모는 화자 정체성 전달 실패와 불완전한 생성 범위를 기록합니다. 실제 쓸 워크플로에서 따로 평가할 능력으로 보세요.
Iris 첫 시각 시퀀스에는 주변음으로 충분합니다. 안정된 말하는 목소리가 필수면 결합 파일이 해결했다고 가정해 RefMod를 고르기보다 별도 음성·대화 흐름을 계획하세요. 시각 캐릭터 LoRA도 목소리 학습의 증명은 아닙니다.
캐릭터 LoRA 학습이 가치 있는 경우
정체성이 정해졌고 참조 선택 편의 이상의 구체적 요구가 있을 때 학습이 맞습니다.
진지하게 고려할 세 경우입니다.
- 매 숏 큰 참조 모음 대신 호환 어댑터의 텍스트 영상으로 캐릭터를 만들고 싶습니다.
- 일반 참조가 충분히 표현하지 못한 반복 학습 스타일·행동이 필요합니다.
- 이미 작동하는 LoRA 제작 구성이 있고 거기에 캐릭터를 넣고 싶습니다.
‘시리즈를 만든다’만으로는 부족합니다. 신중한 인물 클립 열 개는 승인 첫 프레임으로 충분할 수 있습니다. 큰 시리즈는 학습을 정당화해도 실제 작업을 줄이거나 필요한 능력을 추가해야 합니다.
어댑터를 실행할 워크플로에 맞게 학습하세요
H3는 교체 가능한 가중치 하나가 아닙니다. FL2VA·Ref2VA는 의도적인 호환 선택이 필요합니다. AI Toolkit Ref2VA 문서는 별도 가중치와 해당 학습 어댑터를 식별합니다. H3 파일명이 모든 호스팅 작업·로컬 체크포인트의 호환 증명은 아닙니다.
학습 전에 주 출력이 텍스트 영상, 첫 프레임 애니메이션, 참조 조건 영상 중 무엇인지 정해 학습기 설정자에게 알려 주세요. 한 추론 그래프의 멋진 레시피가 다른 곳에 바로 쓰이는 자산은 아닙니다.
성공한 Wan·이미지 튜토리얼의 학습률과 스텝을 복사하지 말고 학습기의 현재 H3 지시를 쓰세요. 현재 Musubi H3 문서는 여러 작업과 기본 모델 동작 보존 방식을 지원합니다. 선택은 학습 내용과 방해할 내용에 영향을 줍니다.
사진 하나가 아닌 캐릭터를 가르치는 데이터를 준비하세요
Iris 학습에는 시리즈에 필요한 변화 속 정체성을 보여 주세요. 관련 각도의 읽기 쉬운 얼굴, 비율이 중요하면 넓은 프레이밍, 의상·조명 여러 구성이 있어야 합니다.
모순 Iris 버전을 넣어 다양성을 만들지 마세요. 같은 승인 인물 스무 장이 코와 턱이 점점 달라지는 예쁜 스무 장보다 일관됩니다. 한 사진의 비슷한 크롭 수십 개도 누락 옆면을 주지 않습니다.
바뀌는 의상, 프레이밍, 표정, 장면을 캡션에 쓰고 정체성 이름은 학습 방식에 맞게 유지하세요. 트리거 방식이면 다음처럼 단순할 수 있습니다.
irisvale, 가상의 32세 성인 여성, 3/4 인물 사진, 크림색 니트 상의, 편안한 표정, 부드러운 창문 빛, 단순한 실내 배경.
캡션 예시이지 보편적인 H3 학습 명령은 아닙니다. 정체성을 다르게 처리하는 방식도 있습니다. 호환되지 않는 조언을 결합하지 말고 선택한 방법을 따르세요.
얼굴 정체성이 목표이면 학습기가 영상을 받는다는 이유로 관계없는 동작 클립을 더하지 마세요. 특징 동작이 중요하면 인물을 알아볼 수 있고 동작이 명확한 클립을 고릅니다. 이미지·영상은 다른 정보를 주며 영상은 준비·학습 작업도 더합니다.
잘못된 종류의 성공을 살피세요
표본이 Iris와 닮아도 나쁜 제작 어댑터일 수 있습니다. 관계없는 프롬프트의 같은 배경, 강도를 높일 때 돌아오는 옛 의상, 굳은 움직임, 새 카메라 방향 불이행이 경고입니다.
답이 항상 추가 학습은 아닙니다. 후기 체크포인트가 더 닮지만 덜 유연하면 초기 것이 더 유용할 수 있습니다. 모두 학습 배경이면 데이터가 너무 특정적일 수 있습니다. 합리적 강도 모두에서 변화가 없으면 캡션에 또 밤을 쓰기 전에 호환·로딩을 보세요.
다른 H3 캐릭터 학습 토론도 절충을 설명합니다. 일부는 닮음이 약했고 다른 사람은 닮음을 강화하면 움직임, 아티팩트, 지시 이행이 나빠졌다고 했습니다. 긍정 RefMod와 실망 참조 보고도 있습니다. 이런 기록에 정직한 보편 승자는 없습니다.
호환 LoRA와 일반 참조를 결합할 수 있습니다. 어댑터는 학습 경향, 승인 이미지는 현재 얼굴·옷·구도를 줍니다. 각 역할이 분명할 때 유용하며 가능한 모든 강도를 올릴 이유는 아닙니다.
준비 시간과 실제 구매하는 것
원본이 있으면 일반 참조의 준비가 가장 작습니다. 일관된 파일 선택과 역할 배정입니다. RefMod는 설치·추출을 추가하고 반복 관리를 줄입니다. LoRA는 데이터 준비, 학습, 체크포인트 선택, 호환 검사를 더합니다.
시간은 하드웨어, 원본 수, 해상도, 학습 방식에 따라 다릅니다. 앞의 5시간은 그 실행이며 자신의 학습기와 하드웨어로 예산을 잡으세요.
| 비용 | 일반 참조 | RefMod | 학습 LoRA |
|---|---|---|---|
| 초기 창작 | 정체성 이미지·유용한 시점 | 같은 원본 준비 | 정제 데이터, 대체로 더 많은 변화 |
| 추가 준비 | 입력 선택·순서 정리 | 설치·인코딩·저장 자산 검토 | 학습 구성·실행·쓸 체크포인트 선택 |
| 반복 작업 | 파일·저장 프리셋 로드 | 저장 묶음 로드 | 호환 가중치·트리거·설정 로드 |
| 생성 비용 | 엔드포인트·참조 요금별 | 로컬·임대 연산, 유지 참조도 비용 있음 | 생성 비용과 호스트별 어댑터 정책 |
| 수정 비용 | 원본 교체 | 자산 갱신 | 학습 정체성 변경이면 재학습 가능 |
호스팅 가격과 로컬 RefMod 비용은 별개입니다
SpicyAPI 현재 H3는 일반 참조 미디어, LoRA 페이지는 호환 가중치도 받습니다. RefMod 업로드 필드는 없습니다. RefMod .safetensors를 loras의 LoRA 대신 넣을 수 없습니다. 같은 캐릭터를 호스팅에 쓰려면 원본 이미지를 남기세요.
승인 첫 프레임의 H3 LoRA 이미지 영상은 출력 초당 480p $0.05, 768p $0.10입니다. 5초는 $0.25·$0.50이고 LoRA 로딩 추가 요금은 없습니다. 네 번 생성은 $1.00·$2.00이며 출력 넷이지 채택 넷 보장이 아닙니다.
참조 영상은 다르게 과금합니다. 일반 H3는 출력 초에 이미지당 $0.0068, H3 LoRA 참조는 이미지당 $0.02입니다. 정지 참조만 쓴 전체 5초 예상은 다음과 같습니다. 일반 H3는 480p를 더 이상 제공하지 않아 해당 칸은 대시로 표시합니다.
| 5초 요청 | 480p | 768p |
|---|---|---|
| H3, 정체성 두 장 | — | $0.1986 |
| H3, 정체성 두 장+의상 한 장 | — | $0.2054 |
| H3 LoRA, 정체성 두 장 | $0.34 | $0.715 |
| H3 LoRA, 정체성 두 장+의상 한 장 | $0.36 | $0.735 |
예를 들어 일반 H3 768p 두 사진은 5 × $0.037 + 2 × $0.0068 = $0.1986, 열 번 $1.986입니다. 768p의 대응 LoRA 참조는 $7.15입니다. 해당 작업의 성인 콘텐츠 기록, 입력, 호환 가중치로 고르세요. 여러 에피소드 등장만으로 LoRA가 필요한 것은 아닙니다.
LoRA 참조 작업에서는 참조 영상 초도 과금 초에 들어가며 오디오는 참조당 자체 요금이 더해집니다. 저장 로컬 RefMod가 호스팅 입력·가격을 우회하지 않습니다. 동작 참조는 짧게 하고 정지 이미지·프롬프트에 없는 기여가 있을 때만 쓰세요.
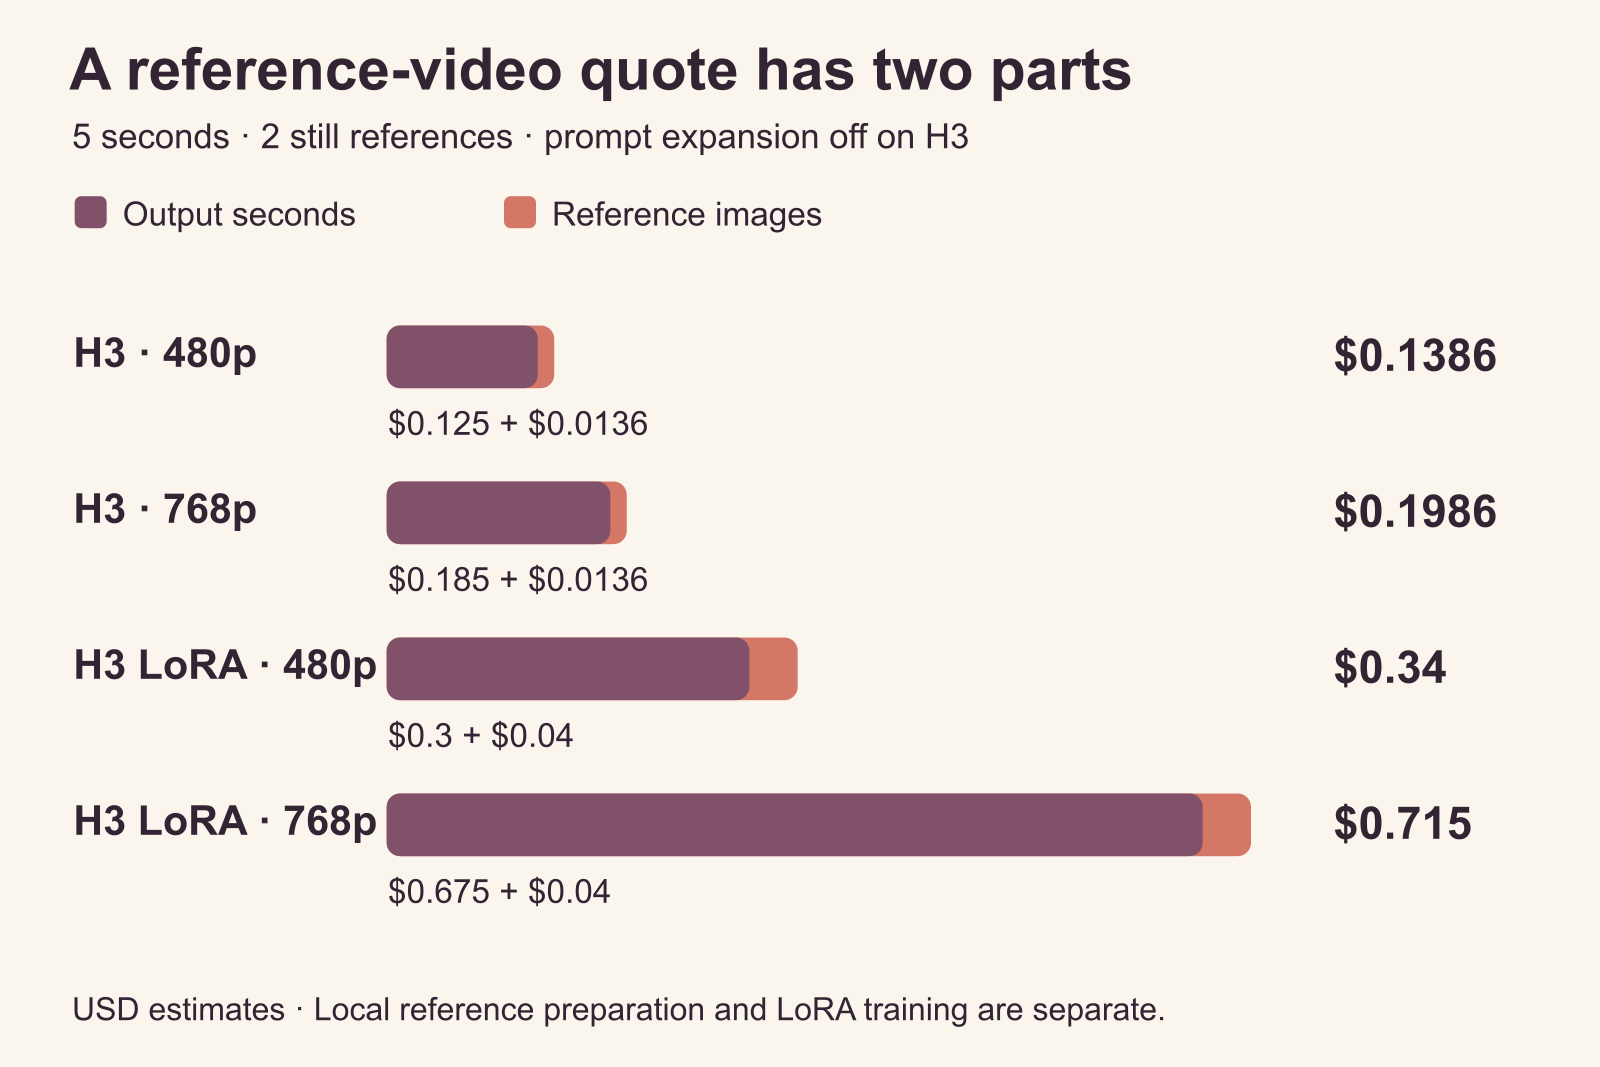
5초 예상 비용에 정지 참조 두 장이 포함되며 참조 준비와 LoRA 학습은 별도입니다.
학습이 반복 수고를 충분히 줄이는지 정하세요
학습 청구액은 판단의 일부입니다. 원본 준비, GPU 임대, 중간 표본, 호환되지 않는 출력 수정 시간도 포함하세요. 어댑터가 쓸 만한 캐릭터를 못 주면 낮은 GPU 가격도 좋은 거래는 아닙니다.
클립 소수에는 적합 어댑터가 이미 있지 않으면 참조를 유지하세요. 자주 생성한다면 줄일 비용을 정하세요. 반복 선택, 이미지 요금, 느린 참조 추론, 특정 학습 외형에 도달하지 못함입니다.
RefMod는 주로 반복 선택·준비를 다룹니다. LoRA는 다른 문제를 다룰 수 있지만 실제 목표 경로에서 작동한 뒤입니다. 저장 참조 프리셋으로 해결되는 정리 문제에 학습을 구매하지 마세요.
성공 출력도 정직하게 세세요. 완료 여섯 번 중 둘을 쓰면 채택당 지출은 출력당의 세 배입니다. 세 방식 모두 같습니다. 좋은 준비나 단순한 숏이 가장 저렴하게 광고된 영상 초보다 중요할 수 있습니다.
흔한 실수와 유용한 다음 변경
| 보이는 문제 | 먼저 확인 | 변경 |
|---|---|---|
| 정면은 맞지만 회전에서 다른 인물 | 드러날 각도를 참조가 보이는지 | 승인 옆면 추가 또는 회전 축소 |
| 원래 의상이 계속 돌아옴 | 정체성 원본 모두에 그 옷이 있는지 | 원본 교체, 의상 분리, 새 첫 프레임 |
| RefMod 썸네일은 맞지만 얼굴이 약함 | 저장 크롭·표현 | 선명한 크롭과 Full 정체성 기준으로 재구성 |
| 저장 캐릭터가 이름을 무시 | 실제 미디어 라벨을 프롬프트가 참조하는지 | 현재 맵 라벨에 주체 배정 |
| 둘이 혼합됨 | 순서·역할·추가 얼굴 | 라벨 수정, 경쟁 얼굴 제거, 고정 투숏부터 |
| LoRA는 로드되나 쓸 변화가 없음 | 기본 모델·작업·로더 호환 | 재학습 전 목표 추론 경로 확인 |
| 닮음은 좋아지나 움직임이 무너짐 | 강도·체크포인트 | 영향력 감소 또는 이전 쓸 버전 |
| 새 방이 계속 옛 방이 됨 | 방 정보가 로드됐는지 | 옛 방 참조 전체 제거 |
| 얼굴은 안정적이나 목소리가 바뀜 | 별도 음성 해법 유무 | 대화 정체성을 자체 제작 작업으로 |
원치 않는 특징과 가장 직접 연결된 입력을 바꾸세요. 옛 옷이 나오면 체크포인트, 샘플러, 전체 세트 전에 의상 원본부터 수정합니다.
이후 작업은 H3 LoRA API 가이드의 기존 어댑터 로딩·작업 선택과 H3 버전 비교의 제품 차이를 참고하세요. 반복 캐릭터 학습 필요성과 별개의 결정입니다.
다음 에피소드에 맞게 고르세요
Iris 다음 에피소드에는 승인 얼굴과 숏에 필요한 다른 시점을 고르고 의도한 성인 장면에 맞는 작업으로 5초 하나를 만드세요. 원본 준비 반복이 문제면 RefMod를 저장합니다. 참조가 못 주는 학습 능력이나 배포 경로가 필요하면 호환 LoRA를 학습합니다. 다음 실제 제작 요구가 투자를 정하게 하세요.