Eine wiederkehrende erwachsene Figur muss auch in der nächsten Folge erkennbar sein, nicht nur auf dem Porträt, mit dem sie vorgestellt wurde. Sobald Sie ein Gesicht gefunden haben, das Ihnen gefällt, geht es bei MiniMax H3 RefMods vs LoRA darum, wie viel Arbeit Sie bei einem neuen Outfit, Kamerawinkel oder Gegenüber wiederholen möchten.
Beginnen Sie mit gewöhnlichen Referenzbildern. Speichern Sie einen RefMod, wenn Sie bereits mit ComfyUI arbeiten und dieselben Bilder regelmäßig wiederverwenden. Ziehen Sie das Training einer LoRA in Betracht, wenn Sie eine erlernte Figur oder einen Stil benötigen, den Ihr Referenzworkflow nicht effizient liefert. Ein RefMod bündelt Referenzinformationen; er trainiert keine Figur in H3 hinein. Eine LoRA erfordert Training, und dieser zusätzliche Aufwand führt nicht automatisch zu einer besseren Ähnlichkeit.
Für eine neue fiktive erwachsene Persona lohnt es sich meist zuerst, einige konsistente Ansichten vorzubereiten. Bei einer etablierten wöchentlichen Serie kann eine Referenzbibliothek wiederholte Einrichtungsschritte sparen. Training wird dann zu einer sinnvolleren Ausgabe, wenn die Figur feststeht und Sie die konkrete Einschränkung benennen können, die es beseitigen soll.
In einer NSFW-Serie reicht Identität über ein passendes Porträt hinaus: Proportionen, Teint und charakteristische Merkmale müssen womöglich in intimen Nahaufnahmen und weiteren Aufnahmen für ein erwachsenes Publikum erkennbar bleiben. Für die hier besprochenen Aufgaben zur Videoerstellung aus Referenzen gibt es unterschiedliche veröffentlichte Inhaltstests: reguläres H3 dokumentiert erzeugte moderate NSFW-Bilder, H3 LoRA dagegen erzeugte Szenen mit höherer Intensität. Diese auf die jeweilige Aufgabe bezogenen Beobachtungen vergleichen keine RefMods und garantieren nicht jede Szene; wählen Sie den Umgang mit der Identität und die Inhaltsfähigkeit getrennt.
| Ihre Situation | Hier beginnen | Grund |
|---|---|---|
| Sie haben ein fertiges Szenenbild und möchten einen kurzen Clip | Image-to-Video | Komposition und Outfit sind bereits im Startbild vorhanden |
| Sie brauchen dieselbe Figur in einem neuen Raum oder Outfit | Gewöhnliches Reference-to-Video | Sie können die Bestandteile wechseln, ohne ein gespeichertes Asset neu aufzubauen |
| Sie laden in ComfyUI immer wieder dieselben Referenzen | RefMod | Ein geordnetes Referenzpaket wiederverwenden |
| Die Figur soll in einem kompatiblen H3-Workflow allein über einen Textprompt verfügbar sein | Trainierte Figuren-LoRA | Training kann die erlernte Identität in einem Adapter ablegen |
| Sie brauchen zwei benannte Figuren in einer Aufnahme | Separate Referenzen für jede Person | Identitäten und Bildpositionen ausdrücklich zuweisen, bevor die Szene komplexer wird |
| Sie brauchen einen unverwechselbaren wiederkehrenden Stil oder eine Bewegung | Eine passende LoRA oder eine relevante Referenz | Nach der Aufgabe wählen; ein Figurenadapter ist nicht automatisch ein Bewegungsadapter |
Die folgenden Beispiele verwenden Iris, eine fiktive 32-jährige Figur aus einer Porträt- und Videoserie für Erwachsene. Es sind praktische Ausgangsbriefings, keine neu erzeugten Vergleichsergebnisse.
Was die einzelnen Methoden tatsächlich speichern
Eine gewöhnliche Referenz ist ein Bild oder ein anderes akzeptiertes Medium, das Sie für eine Generierung bereitstellen. Für die nächste Aufnahme wählen Sie es erneut aus oder laden es über den gespeicherten Workflow Ihres Tools. Eine Referenz wird nicht zu dauerhaftem Wissen des Modells. Auch wenn Sie die Figur in zehn Prompts „Iris“ nennen, entsteht dadurch keine beständige Identität.
Ein RefMod wandelt Referenzmedien in eine wiederverwendbare Datei für kompatible H3-Workflows um. Das ursprüngliche RefMod-Projekt erklärt, dass die Extraktion VAE-Repräsentationen der Referenzen speichert, ohne die Gewichte von H3 zu trainieren. Der Modus Full erhält mehr Informationen; Compressed tauscht Detail gegen weniger Referenztokens. Der historische interne Modusname training bezeichnet die Verfeinerung eines komprimierten Latents, nicht das Training einer LoRA. Kleidung, Identität und Hintergrund können weiterhin gemeinsam übertragen werden.
Eine LoRA ist ein trainierter Adapter: erlernte Änderungen, die zusammen mit dem Basismodell verwendet werden. Die ursprüngliche LoRA-Veröffentlichung beschreibt das Prinzip der Anpassung mit niedrigem Rang. Für H3 bedeutet das praktisch, dass Sie Trainingsbeispiele vorbereiten und Gewichte erzeugen müssen, die Ihr Generierungsworkflow tatsächlich laden kann. Fotos in einem RefMod zu speichern und eine LoRA zu trainieren lösen unterschiedliche Probleme, auch wenn beide Dateien auf .safetensors enden.
| Frage | Gewöhnliche Referenzen | RefMod | Trainierte LoRA |
|---|---|---|---|
| Was bereiten Sie vor? | Ausgewählte Bilder oder akzeptierte Medien | Ausgewählte Medien und einen kompatiblen Extraktionsworkflow | Einen kuratierten Trainingsdatensatz und einen Trainer |
| Was verwenden Sie erneut? | Originaldateien und ihre Rollen im Prompt | Gespeicherte Referenzrepräsentationen | Erlernte Adaptergewichte |
| Können Sie eine schlechte Quelle ersetzen? | Das Bild ersetzen | Das Referenzpaket neu erstellen oder bearbeiten | Den Datensatz überarbeiten und erneut trainieren, falls das Problem erlernt wurde |
| Ist die Generierung unabhängig von Referenzen? | Nein | Nein; gespeicherte Referenzen beeinflussen die Generierung weiterhin | Möglicherweise, abhängig von Adapter und Aufgabe |
| Garantiert die Methode dieselbe Person? | Nein | Nein | Nein |
| Ist sie ein universelles Uploadformat für H3? | Nur vom Endpunkt akzeptierte Medientypen | Nein | Nur kompatible LoRA-Gewichte, die der Loader akzeptiert |
Dieser Unterschied ist wichtig, wenn ein Asset enttäuscht. Enthält ein gespeicherter RefMod ein inkonsistentes Seitenprofil, korrigiert ein besserer Dateiname das Gesicht nicht. Hat eine LoRA Iris zusammen mit einem bestimmten Kostüm erlernt, kann die Beschreibung eines neuen Kostüms mit dieser erlernten Verbindung konkurrieren. In beiden Fällen beeinflusst die Vorbereitung das Ergebnis; die Korrektur erfolgt jedoch an unterschiedlichen Stellen.
Möglicherweise begegnet Ihnen auch RefLoRA. Das RefLoRA-Projekt bündelt trainierte LoRA-Gewichte und RefMod-Referenzen in einer Datei. Ein normaler LoRA-Loader nutzt die Gewichte; ein kompatibler kombinierter Loader kann beides verwenden. Die gemeinsame Verpackung ersetzt nicht das Training, aus dem die LoRA entstand, und ein gehosteter Dienst kann nicht automatisch den Referenzteil lesen. Prüfen Sie, was eine Datei enthält und welcher Loader sie verarbeitet, statt nur nach der Dateiendung zu wählen.
Entscheiden Sie zuerst, was gleich bleiben muss
Definieren Sie Iris' wiederkehrende Identität eng: eine erwachsene Frau im Alter von 32 Jahren, kurzer kastanienroter Bob, breite Augenbrauen, gerade Nase und eine erkennbare Gesichtsform. Das sind die Konstanten der Serie. Ihr schwarzes Abendoutfit, das cremefarbene Lounge-Set, die Schlafzimmerbeleuchtung und der Kameraabstand gehören dagegen zur jeweiligen Aufnahme.
Diese Trennung verhindert einen teuren Fehler: das gesamte erste Bild erhalten zu wollen, obwohl die Serie Veränderungen braucht. Ein Referenzfoto ist eine vollständige visuelle Szene. Es enthält die Person, Kleidung, Pose, Beleuchtung und Raum. „Iris konsistent halten“ versteht ein Mensch leicht; Ihre Eingaben müssen dennoch deutlich machen, welche Teile zu Iris gehören und welche zu dieser Folge.
Verwenden Sie für Iris' Serie für Erwachsene unterschiedliche Referenzen für unterschiedliche Wiedererkennungsmerkmale:
| Was das Publikum wiedererkennt | Hilfreiche Quelle | Was sich mit der Szene ändern darf |
|---|---|---|
| Gesicht, Augenbrauenform und Haaransatz | Klares Porträt und eine freigegebene gedrehte Ansicht | Ausdruck, Blickrichtung und Make-up |
| Körperbau und relative Proportionen | Eine freigegebene weitere Ansicht mit erkennbaren Schultern, Taille und Haltung | Pose, Kameraabstand und Outfit |
| Ein kleines wiederkehrendes Schultertattoo | Eine klare Ansicht des tatsächlichen Motivs und seiner Platzierung | Beleuchtung und ob der Bildausschnitt es zeigt |
| Styling für ein bestimmtes Set | Gewähltes Outfit und gewählte Frisur | Das Styling der nächsten Folge |
Ein Gesichtsausschnitt kann Iris' Proportionen in einer weiteren Szene nicht festlegen. Umgekehrt kann eine entfernte Ganzkörperaufnahme ihre Haltung zeigen, aber wenig brauchbare Gesichtsdetails liefern. Verändert das Schultertattoo seine Form, ergänzen Sie eine klare Quelle für dieses Detail, statt die Stärke sämtlicher Referenzen zu erhöhen. Wenn die genaue Platzierung entscheidend ist, legen Sie sie im Startbild fest, bevor Sie animieren. Dieselbe Aufteilung der Assets funktioniert für ein Porträtset für Erwachsene, eine Lounge-Sequenz oder eine intensivere Szene; die Aufnahme bestimmt, welche Informationen sichtbar sein müssen.
Bereiten Sie einen kleinen Quellordner mit drei Arten von Material vor:
- Identitätsansichten: ein klares Porträt, eine Dreiviertelansicht und ein Profil, die Sie als dieselbe Person akzeptiert haben.
- Kleidungsbeispiele: ein Bild jedes wiederkehrenden Outfits, möglichst getrennt von der Identitätsauswahl.
- Szenenbilder: ein leerer Raum oder ein freigegebenes Startbild für eine bestimmte Aufnahme.
Das ist eine praktische Ordnung, keine vorgeschriebene Datensatzgröße. Ein ruhiger Porträtclip braucht möglicherweise nur das erste Bild. Für eine Drehung hilft eine tatsächlich freigegebene Ansicht der Merkmale, die dabei sichtbar werden. Ein Raumbild hat in einer Nahreferenz des Gesichts keinen sinnvollen Zweck, wenn der Raum jede Woche wechselt.
Vergleichen Sie bei Identitätsbildern zunächst Kiefer, Nase, Augenbrauenform und Haaransatz, bevor Sie die Schönheit beurteilen. Ein attraktiveres generiertes Porträt kann trotzdem die falsche Person zeigen. Dieses Porträt jetzt auszusortieren kostet weniger Aufwand, als ein Referenzpaket aus widersprüchlichen Gesichtern aufzubauen.
Unterscheiden Sie außerdem zwischen dauerhaften Merkmalen und Styling. Wenn Iris ihre Haare manchmal hochsteckt, sollte der Referenzsatz ihr Gesicht trotzdem erkennbar machen, ohne vollständig von der Bob-Silhouette abzuhängen. Wechselt ein charakteristisches Accessoire mit dem Outfit, machen Sie es nicht zum einzigen Merkmal, das Iris von einer anderen Figur unterscheidet.
Dasselbe gilt für Bilder erwachsener Figuren. Eine Quelle muss nicht Intensität oder Komposition jeder zukünftigen Szene vorwegnehmen. Wählen Sie Identitätsreferenzen für eine klar erkennbare Identität. Wählen Sie einen geeigneten Generierungsweg für die Szene selbst. Weder Referenzbündel noch Figurentraining legen fest, welche Inhalte für Erwachsene ein bestimmter Endpunkt umsetzt.
Gewöhnliche Referenzen: der beste Einstieg in eine neue Serie
Gewöhnliche Referenzen sind hilfreich, wenn Sie noch entscheiden, wer die Figur ist, wenn die Kleidung häufig wechselt oder wenn Sie in einem gehosteten Playground arbeiten möchten, ohne ComfyUI zu pflegen.
Sie machen Fehler außerdem gut sichtbar. Sie sehen genau, welche Bilder Sie bereitgestellt haben, können das konfliktverursachende entfernen und die nächste Aufnahme starten. Diese Einfachheit ist wertvoll, solange die Figur noch nicht feststeht. Ein aufwendiges gespeichertes Paket kann es erschweren, ein schwaches Bild zu bemerken.
Erstellen Sie eine fünfsekündige Aufnahme aus zwei Identitätsansichten
Verwenden Sie Iris' frontales Porträt als Bild 1 und ihre akzeptierte Dreiviertelansicht als Bild 2. Beschreiben Sie die Umgebung für diese erste Aufnahme im Text, damit beide Referenzen nur einem Zweck dienen: der Person.
MiniMax H3 Reference-to-Video akzeptiert in der gehosteten Aufgabe bis zu neun Referenzbilder und erzeugt 4–15 Sekunden Video. Beginnen Sie mit fünf Sekunden in 768p und Hochformat 9:16: $0.1986 mit diesen zwei Bildern. Eine größere Ausgabe lohnt sich, sobald die Richtung der Aufnahme erhaltenswert ist.
Bild 1 und Bild 2 zeigen dieselbe fiktive erwachsene Frau, Iris, im Alter von 32 Jahren. Verwenden Sie sie für ihre Gesichtsidentität, ihren kurzen kastanienroten Bob und ihre Proportionen. Iris trägt ein anthrazitfarbenes Abendkleid aus Satin. Sie sitzt neben einer warm leuchtenden Nachttischlampe in einer ruhigen Wohnung und dreht ihr Gesicht langsam aus der Dreiviertelansicht zur Kamera. Halbnahe Aufnahme, Kamera auf Augenhöhe, sanfter Ausdruck, ruhiger Bildausschnitt. Ihr Gesicht bleibt während der gesamten Drehung klar erkennbar. Audio: leise Raumgeräusche.
Dieses Briefing gibt den Referenzen eine Aufgabe und dem Text eine andere. Es verlangt nicht gleichzeitig den alten Hintergrund zu erhalten, das alte Outfit zu erhalten und einen neuen Raum zu erfinden. Die zurückhaltende Drehung gibt der Aufnahme zudem eine klare Handlung, ohne mehrere unterschiedliche Posen zu benötigen.
Zeigen die Quellporträts bereits das anthrazitfarbene Kleid und soll es erhalten bleiben, sagen Sie das. Trägt die Figur in einer Quelle eine Jacke, beschreiben Sie ausdrücklich das gewünschte Kleid als Kleidung der Ausgabe. Taucht die Jacke immer wieder auf, ist es sinnvoller, diese Referenz zu ersetzen oder zuzuschneiden, als einen weiteren Absatz über das Kleid hinzuzufügen.
Verwenden Sie ein Startbild, wenn die Szene bereits stimmt
Angenommen, Sie haben die gewünschte Porträtkomposition bereits erstellt: Iris im cremefarbenen Lounge-Set neben der Lampe, mit passendem Ausdruck und Raum. Image-to-Video ist dann der direkte nächste Schritt. Es beginnt mit diesem akzeptierten Bild; Reference-to-Video soll aus einzelnen Bestandteilen eine neue Aufnahme konstruieren.
Ein geeignetes Bewegungsbriefing lautet:
Iris, die fiktive erwachsene Frau im Startbild, hebt sanft ihren Blick zur Kamera und lächelt leicht und entspannt. Ihre Schultern bleiben in derselben Position. Die Kamera bewegt sich langsam ein kleines Stück näher. Die Lampe bleibt unverändert. Audio: ruhige Innenraumgeräusche.
Der praktische Unterschied liegt darin, wo Sie Ihre Arbeit investieren. Verwenden Sie Referenzen, wenn Sie die Szene noch gestalten müssen. Verwenden Sie ein Startbild, wenn die Szene bereits gestaltet ist und nur noch Bewegung fehlt. Eine Figuren-LoRA allein zur Animation eines fertigen Bildes zu trainieren schafft ein weiteres Projekt, bevor Sie die unmittelbare Aufgabe lösen.
Ein Startbild verspricht nicht, dass jedes spätere Bild perfekt bleibt. Zeigt eine lange Drehung ein ungewohntes Profil, verkürzen Sie die Drehung oder bereiten Sie einen besseren Ausgangswinkel vor. Das ist eine Frage der Aufnahmegestaltung, die Sie klären sollten, bevor Sie die gesamte Identitätsmethode als gescheitert betrachten.
RefMods: hilfreich, wenn die Referenzvorbereitung sich wiederholt
RefMods werden interessant, wenn Ihnen die Figur gefällt, Sie bereits ComfyUI nutzen und dieselbe Sammlung ständig neu zusammenstellen. Die Einsparung ist organisatorisch ebenso wie rechnerisch: Ein benanntes Asset kann die wiederholte Auswahl und Vorbereitung der Quellen ersetzen.
Zwischen der gespeicherten Datei und dem verarbeitenden Workflow besteht ein wichtiger Unterschied. Verschiedene H3-Nodes können diese Referenzen unterschiedlich präsentieren. Ein gutes Ergebnis im Graph eines Creators beweist nicht, dass jeder RefMod-Loader dieselbe Figur erzeugt.
Adudeguymans Fantastic H3 Prompt Builder ergänzt die Aufgabe um einen Referenzmanager und Prompteditor. Seine Referenzzuordnung zeigt die Bezeichnungen der tatsächlichen Eingaben. Neuere Versionen können Encoderframes speichern und bieten eine experimentelle Auswahl, wie viele Bilder der Textencoder sieht. Mehr Bilder können Speicherbedarf und Generierungszeit erhöhen. Das sind Workfloweinstellungen, keine Garantie für eine bessere Identität.
Erstellen Sie ein wiederverwendbares Iris-Asset
Die RefMod-Anleitung des Projekts enthält die Installation und die nodespezifischen Schritte. Für diese Figurenaufgabe ist folgende Abfolge sinnvoll:
- Beginnen Sie mit einem funktionierenden H3-Referenzworkflow und dessen passender VAE.
- Öffnen Sie die Erstellungsansicht der RefMod-Bibliothek und fügen Sie die freigegebenen Iris-Bilder hinzu.
- Prüfen Sie die Ausschnittvorschauen. Das erste Bild bestimmt die Form des kombinierten Satzes; passen Sie Quellen an, bei denen Gesicht oder Haare verloren gehen.
- Wählen Sie Full für die Identitätsgrundlage, benennen Sie die Figur und erstellen Sie das Paket.
- Fügen Sie das gespeicherte Asset zum Stack hinzu. Lesen Sie die Referenzzuordnung, bevor Sie die Rolle der Person im Prompt formulieren.
Bewahren Sie auch die ursprünglichen Quellbilder auf. Eine gespeicherte Referenz ist praktisch, aber mit dem Quellordner können Sie eine schlechte Ansicht entfernen, einen anderen Ausschnitt vorbereiten oder später in eine andere Anwendung wechseln.
Speichern Sie nicht jedes Bild aus Iris' Geschichte in einem einzigen Hauptasset. Ein gutes Asset für eine wiederkehrende Figur sollte sich leicht erklären lassen: „Das sind die freigegebenen Ansichten von Iris.“ Es sollte nicht zugleich „drei Räume, vier Kostüme, einen alten Haarschnitt und eine zweite Figur, die einmal vorkam“ bedeuten.
Prüfen Sie das gespeicherte Ergebnis, bevor Sie der Generierung die Schuld geben
Zuschnitt und Kompression können genau das Merkmal entfernen, das Sie erhalten wollten. Eine Porträtminiatur im Dateibrowser beweist nicht, dass die gespeicherte Referenz das vollständige Porträt mit dem erwarteten Detail enthält.
Ist das Gesicht im Original klar, in der gespeicherten Vorschau aber weich, schmal oder teilweise abgeschnitten, verbessern Sie zuerst das Asset. Für eine Porträtserie ist eine kleinere Sammlung klarer Ansichten ein sinnvollerer Ausgangspunkt als ein übergroßes Paket, dessen wichtige Details reduziert wurden.
Full und Compressed sind nützliche Optionen, aber „kleinere Datei“ bedeutet nicht „kostenfreie Konditionierung“. Auch eine kleine gespeicherte Datei liefert während der Generierung Referenzinformationen. Umgekehrt kann mehr Detail neben dem Gesicht auch einen unerwünschten Raum oder ein Kleidungsstück erhalten. Wählen Sie zuerst die gewünschten Informationen aus, bevor Sie deren Stärke abstimmen.
Halten Sie für Iris ein Identitätsasset und ein separates optionales Raumasset vor. Laden Sie nur, was die Aufnahme benötigt. Spielt die Szene in einer anderen Wohnung, lassen Sie das alte Raumasset vollständig weg. Seine Stärke zu reduzieren ist ein Umweg, wenn der Raum im neuen Clip überhaupt keine Rolle spielt.
Warum Community-Ergebnisse widersprüchlich wirken
In einer Diskussion über H3-Figurentraining berichtete der ursprüngliche Verfasser von ungefähr fünf Stunden Training auf einer RTX 5090 ohne zufriedenstellende Ähnlichkeit. Antworten lobten RefMods, während andere Nutzer schlechtere Ähnlichkeit oder längere Generierungszeiten als mit ihren gewöhnlichen Referenzsetups meldeten. Die Diskussion widersprach außerdem der Vorstellung, viele Bilder in einer Datei würden eine neu trainierte Identität ergeben.
Diese Berichte zeigen eine hilfreiche Unterscheidung: Komfort, Geschwindigkeit und Ähnlichkeit sind separate Vorteile. Ein RefMod kann bequem sein, ohne in Ihrem Graph schneller zu sein. Er kann Quellvorbereitung sparen, ohne ein bestimmtes Gesicht zu verbessern. Ein gelungenes Beispiel kann ebenso vom Checkpoint, den Ausschnitten, der Präsentation der Referenzen und dem Prompt wie vom gespeicherten Asset abhängen.
Das Update des Prompt-Builder-Autors berichtete von weniger Vermischung zwischen Figuren, nachdem geändert wurde, wie Referenzen zum Textencoder gelangen, bei zusätzlichen Zeit- und Speicherkosten. Derselbe Beitrag beschrieb weiterhin vertauschte Stimmen. Das ist ein konkretes Implementierungsergebnis mit verbleibenden Problemen, kein Beleg dafür, dass RefMods Figuren-LoRAs für alle ersetzt haben.
Outfits wechseln, ohne die Figur zu verändern
Wiederkehrende erwachsene Personas brauchen häufig Wiedererkennung und Abwechslung zugleich. Das Gesicht bleibt vertraut, während das Styling zwischen einem Porträtset, einer Lounge-Szene und einer bekleideten Abendsequenz wechselt. Hier kann ein bequemes Paket zu umfassend werden.
Zeigt jede Iris-Referenz dasselbe dunkle Satinkleid, kann dieses Kleid zu einem starken Bestandteil der visuellen Anweisung werden. Fügen Sie anschließend fünf Bilder in verschiedenen Kostümen hinzu, erhält das Modell zwar mehr Informationen, aber auch mehr konkurrierende Hinweise zur Kleidung.
Eine praktische Ordnung ist:
| Asset | Was hineingehört | Wann verwenden |
|---|---|---|
| Iris-Identität | Freigegebene Ansichten mit konsistenten Gesichtszügen | Jede Aufnahme, die die etablierte Person benötigt |
| Abendgarderobe | Eine klare Ansicht des vorgesehenen Kleides und Stylings | Abendsequenz |
| Lounge-Kleidung | Eine klare Ansicht des cremefarbenen Outfits | Lounge-Sequenz |
| Wohnungsszene | Der Raum ohne konkurrierende Figuren | Aufnahmen, die genau diesen Raum benötigen |
| Freigegebenes Startbild | Iris, das gewählte Outfit und die fertige Komposition zusammen | Image-to-Video für genau diese Anordnung |
Das können gewöhnliche Dateien sein. Erstellen Sie RefMods nur für die Teile, die Sie in einem kompatiblen lokalen Workflow regelmäßig wiederverwenden. Ein dauerhaftes Paket für eine einmalige Requisite bringt keinen Vorteil.
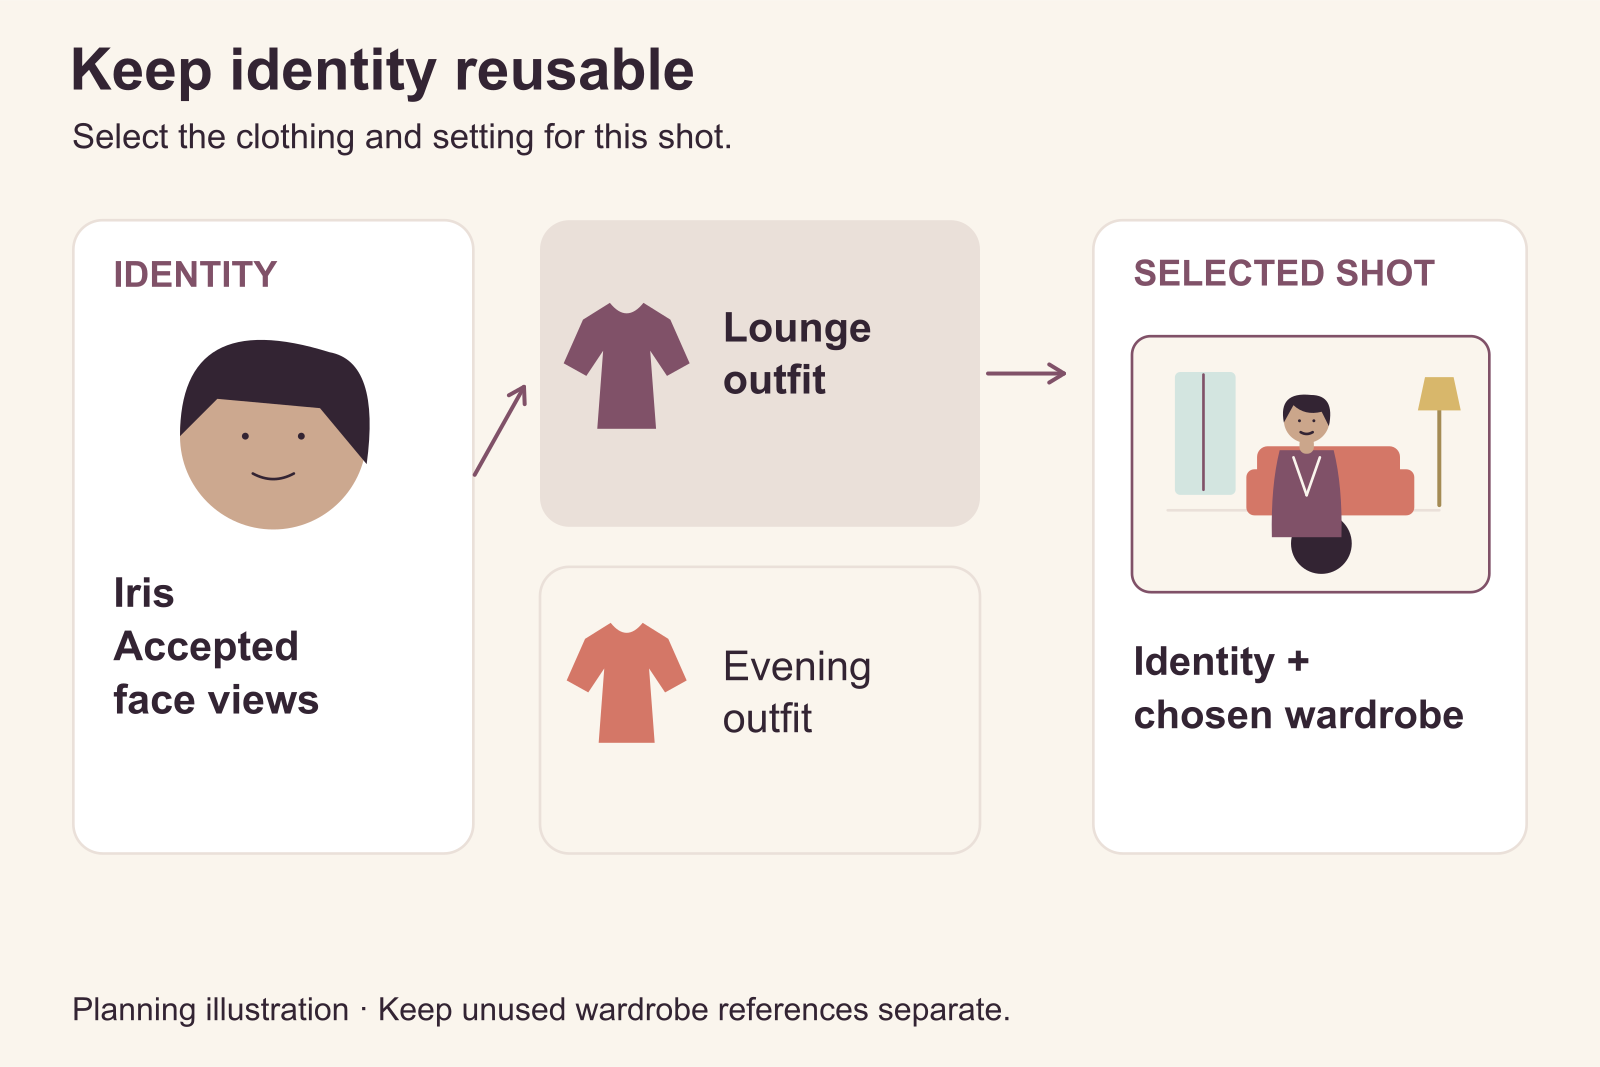
Illustration: Halten Sie die wiederkehrende Identität wiederverwendbar und wählen Sie Kleidung und Umgebung für jede Aufnahme aus.
Geben Sie dem neuen Outfit eine klare Quelle
Behalten Sie für eine Szene mit neuer Kleidung dieselben zwei Identitätsbilder bei und ergänzen Sie das Outfit als Bild 3. Bevorzugen Sie eine Quelle, die nur das Kleidungsstück zeigt, oder einen Ausschnitt, der die Kleidung deutlich macht, ohne das Gesicht einer anderen Person als konkurrierende Identität einzuführen.
Bild 1 und Bild 2 definieren Iris, dieselbe fiktive erwachsene Frau im Alter von 32 Jahren. Bild 3 definiert das cremefarbene Lounge-Outfit für diese Szene. Zeigen Sie Iris in diesem Outfit in einem Sessel neben einer warm leuchtenden Lampe. Bewahren Sie das Gesicht aus Bildern 1 und 2. Sie legt eine Hand auf die Armlehne und blickt langsam zum Fenster. Halbnahe Aufnahme mit sichtbarem Gesicht. Audio: ruhiger Raumton.
Enthält das Outfitbild eine andere Person, beschreiben Sie seinen Zweck besonders deutlich. Noch besser ist es, deren Gesicht aus der Kleidungsreferenz zu entfernen, sofern die nützlichen Details des Kleidungsstücks dabei erhalten bleiben.
Kehrt das alte Kostüm immer wieder zurück, erstellen Sie zuerst ein bearbeitetes Standbild mit dem neuen Outfit. Sobald Gesicht und Kleidung gemeinsam stimmen, animieren Sie dieses akzeptierte Bild. So verlagern Sie die strittige Kleidungsentscheidung in ein statisches Bild, das Sie direkt prüfen können.
Das lässt sich möglicherweise schneller handhaben, als ein fünfsekündiges Video wiederholt Identität, Kleidungskonstruktion und Bewegung zugleich lösen zu lassen. Zudem entsteht ein wiederverwendbares Startbild für mehrere kurze Clips innerhalb derselben Kleidungssequenz.
Eine dauerhafte Neugestaltung der Figur braucht einen neuen freigegebenen Referenzsatz; bewahren Sie ihn getrennt von der alten Version auf, damit Sie frühere Folgen weiterhin reproduzieren können. Eine überarbeitete Identität kann ein erneutes LoRA-Training rechtfertigen. Ein neues Kleid verlangt üblicherweise zuerst nach einer Kleidungsreferenz oder einem vorbereiteten Startbild.
Zwei Figuren brauchen ausdrückliche Rollen
Zwei RefMods erzeugen nicht automatisch zwei unabhängig gesteuerte Personen. Zwei Figuren-LoRAs reservieren ebenfalls nicht automatisch je eine Hälfte des Bildes für jede Identität.
Das Modell muss klären, wer anwesend ist, welche Informationen zu welcher Person gehören und was jede Person tut. Das wird schwierig, wenn beide Referenzen dieselbe Frisur, Kleidung und Gesichtsbeschreibung teilen oder der Prompt unklare Formulierungen wie „sie dreht sich zu ihr“ verwendet.
Führen Sie eine zweite fiktive erwachsene Figur ein, Alex, im Alter von 35 Jahren. Geben Sie Alex einen sichtbar anderen kurzen Haarschnitt und eine separate Referenz. Diese Unterschiede helfen bei der Beschreibung der Aufnahme; sie ersetzen keine gültige Identitätsquelle.
Für gewöhnliche Referenzen ist folgende erste Anordnung unkompliziert:
- Bilder 1 und 2: Iris' frontale Ansicht und Dreiviertelansicht.
- Bilder 3 und 4: die entsprechenden Ansichten von Alex.
- Raum und Kleidung: im Text beschreiben, sofern keine separate Referenz nötig ist.
Formulieren Sie anschließend die Beziehung zwischen Referenzen und Szene:
Bilder 1 und 2 zeigen Iris, eine fiktive erwachsene Frau im Alter von 32 Jahren. Bilder 3 und 4 zeigen Alex, einen fiktiven erwachsenen Mann im Alter von 35 Jahren. Iris steht links im anthrazitfarbenen Abendkleid; Alex steht rechts in einem dunklen Hemd mit offenem Kragen. Sie lächeln einander ruhig neben einem Wohnungsfenster an. Iris dreht sich zu Alex, während Alex weiterhin Iris ansieht. Halbnahe Zweieraufnahme, beide Gesichter sichtbar, Kamera unbewegt. Audio: leise abendliche Raumgeräusche.
Die Links-rechts-Positionen reduzieren die Mehrdeutigkeit in dieser einfachen Komposition. Bei der Handlungsbeschreibung ersetzen Namen die Pronomen. Die Kamera bleibt ruhig, damit die erste Aufnahme nicht zusätzlich verlangt, dass die Personen einander kreuzen, ihre Bildpositionen tauschen und sich gemeinsam abwenden.
Verwenden Sie bei lokalen RefMods die Bezeichnungen aus der aktuellen Referenzzuordnung. Ein RefMod mit mehreren Bildern kann als Videoreferenz statt als Bildreferenz erscheinen; erraten Sie seine Nummer nicht anhand des Dateinamens und übernehmen Sie keine Nummern aus einem alten Prompt, nachdem Sie den Stack umgeordnet haben.
Der offizielle H3-Leitfaden für Referenzprompts unterscheidet sichtbare Personen von den Medienassets, die sie bereitstellen. Diese Unterscheidung ist hier hilfreich: Iris ist die Person; ein Bild oder Video liefert Informationen über Iris. So können Sie ihren Platz in der neuen Aufnahme beschreiben, ohne das Modell die gesamte Quellszene reproduzieren zu lassen.
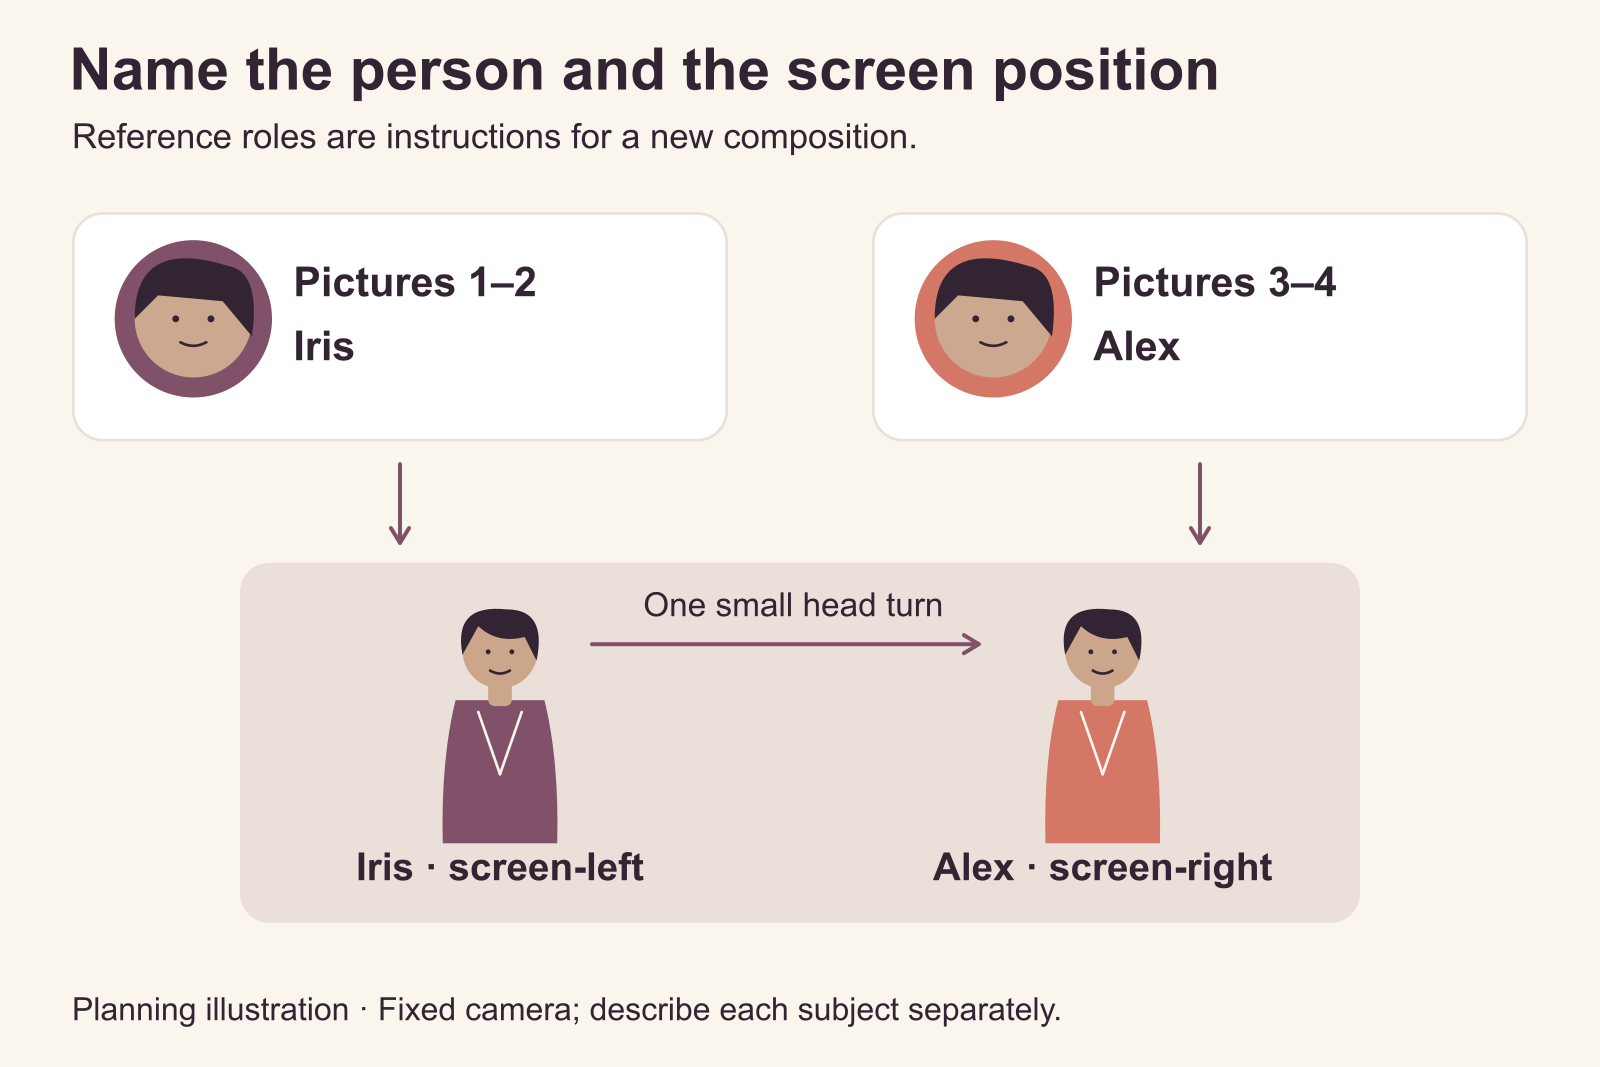
Illustration: Weisen Sie Quellbilder, Person und Bildposition getrennt zu.
Wenn sich Gesichter vermischen, vereinfachen Sie zuerst die Komposition
Wenn Alex Iris' Haare übernimmt oder Iris Alex' Gesichtsform annimmt, prüfen Sie zuerst, ob Quellen und Promptbezeichnungen übereinstimmen. Ein falsch zugeordnetes Bild kann wie ein Qualitätsproblem der Identität wirken.
Sind die Bezeichnungen korrekt, machen Sie die visuellen Rollen klarer: Halten Sie beide Gesichter sichtbar, nutzen Sie getrennte Bildpositionen und vermeiden Sie kreuzende Bewegung in der ersten gemeinsamen Aufnahme. Entfernen Sie eine Kleidungsreferenz, die ein drittes erkennbares Gesicht enthält. Funktionieren beide Personen einzeln, verschmelzen aber wiederholt miteinander, bereiten Sie ein Zweipersonen-Startbild mit beiden akzeptierten Identitäten vor und animieren Sie daraus eine zurückhaltende Interaktion.
Sie können auch den Schnitt ändern. Wechseln Sie zwischen Einzelaufnahmen und Aufnahmen über die Schulter, statt jeden Handlungsschritt in eine bewegte Zweieraufnahme zu zwängen. Das ist eine praktische Produktionsentscheidung, wenn die Szene glaubwürdige Kontinuität stärker braucht als die dauernde Sichtbarkeit beider Gesichter.
Keine dieser Änderungen garantiert eine schwierige Interaktion. Sie beseitigen konkrete Mehrdeutigkeiten, bevor Sie Zeit in weitere Identitätsassets investieren.
Trennen Sie die Stimmidentität von der visuellen Identität
Eine Figur, die gleich aussieht, aber in jeder Folge mit einer anderen Stimme spricht, wirkt trotzdem anders. Audio neben einem visuellen RefMod zu speichern stellt jedoch keine zuverlässige Verbindung zwischen dieser Stimme und diesem Gesicht her.
Die Validierungsnotizen des RefMod-Projekts dokumentieren fehlgeschlagene Übertragung der Sprecheridentität und eine unvollständige Abdeckung der Generierung. Betrachten Sie Audioreferenzen als separate Fähigkeit, die Sie für Ihren tatsächlich verwendeten Workflow prüfen müssen.
Für Iris' erste visuelle Sequenz reichen Umgebungsgeräusche aus. Ist eine beständige Sprechstimme für die Serie entscheidend, planen Sie einen separaten Sprach- und Dialogworkflow, statt RefMods in der Annahme zu wählen, eine kombinierte Datei hätte das bereits gelöst. Eine trainierte visuelle Figuren-LoRA ist ebenfalls kein Beleg für eine trainierte Stimme.
Wann das Training einer Figuren-LoRA sinnvoll wird
Training ist sinnvoll, wenn die Identität feststeht und Sie etwas Konkreteres benötigen als eine bequemere Referenzauswahl.
Drei Situationen rechtfertigen eine ernsthafte Prüfung:
- Sie möchten die Figur in Text-to-Video mit einem kompatiblen Adapter erzeugen, statt für jede Aufnahme eine große Referenzsammlung bereitzustellen.
- Sie brauchen einen wiederkehrenden erlernten Stil oder ein Verhalten, das gewöhnliche Referenzen nicht ausreichend ausdrücken.
- Sie haben bereits ein funktionierendes LoRA-basiertes Produktionssetup und möchten diese Figur darin verfügbar machen.
„Ich mache eine Serie“ allein reicht als Grund nicht aus. Eine Serie aus zehn sorgfältig komponierten Porträtclips kann mit akzeptierten Startbildern gut funktionieren. Eine wesentlich größere Serie kann Training rechtfertigen, aber nur, wenn der entstandene Adapter tatsächliche Arbeit reduziert oder eine benötigte Fähigkeit hinzufügt.
Trainieren Sie für den Workflow, in dem der Adapter eingesetzt wird
H3 ist nicht eine einzige beliebig austauschbare Gewichtsdatei. Die FL2VA- und Ref2VA-Wege erfordern bewusste Kompatibilitätsentscheidungen. Die Ref2VA-Dokumentation von AI Toolkit nennt separate Ref2VA-Gewichte und einen zugehörigen Trainingsadapter. Gehen Sie nicht davon aus, dass ein H3-Dateiname die Kompatibilität mit jeder gehosteten Aufgabe oder jedem lokalen Checkpoint beweist.
Entscheiden Sie vor dem Training, ob Ihre Hauptausgabe Text-to-Video, die Animation eines Startbildes oder referenzkonditioniertes Video sein wird. Geben Sie diese gewünschte Aufgabe an die Person weiter, die den Trainer konfiguriert. Ein Trainingsrezept, das in einem Inferenzgraph beeindruckt, ist nicht automatisch direkt in einem anderen einsetzbar.
Verwenden Sie die aktuellen H3-Anweisungen des Trainers, statt Lernrate und Schrittzahl aus einem erfolgreichen Wan- oder Bildmodell-Tutorial zu kopieren. Die aktuelle H3-Dokumentation von Musubi unterstützt mehrere Trainingsaufgaben und unterschiedliche Ansätze zum Erhalt des Verhaltens des Basismodells. Diese Entscheidungen beeinflussen, was der Adapter lernt und was er möglicherweise beeinträchtigt.
Bereiten Sie einen Datensatz vor, der die Figur vermittelt, nicht ein einzelnes Foto
Für Iris zeigt eine hilfreiche Trainingssammlung ihre Identität über die Variationen hinweg, die die Serie benötigt. Sie sollte erkennbare Gesichter in relevanten Winkeln, einige weitere Bildausschnitte bei wichtigen Proportionen und mehr als ein Kleidungs- und Beleuchtungssetup enthalten.
Erzeugen Sie keine scheinbare Vielfalt durch inkonsistente Versionen von Iris. Zwanzig Bilder derselben akzeptierten Person sind kohärenteres Trainingsmaterial als zwanzig schöne Bilder, auf denen sich Nase und Kiefer allmählich verändern. Ebenso liefern Dutzende fast identischer Ausschnitte eines Porträts nicht das fehlende Profil.
Beschreiben Sie in den Captions, was sich ändert: Kleidung, Bildausschnitt, Ausdruck und Szene. Benennen Sie die Identität konsistent nach der Methode des Trainers. Bei einem Rezept mit Trigger kann eine Caption so schlicht sein:
irisvale, fiktive erwachsene Frau im Alter von 32 Jahren, Dreiviertelporträt, cremefarbenes Strickoberteil, entspannter Ausdruck, weiches Fensterlicht, schlichter Innenraumhintergrund.
Das ist ein Beispiel für eine Caption, kein universeller H3-Trainingsbefehl. Einige Trainingsmethoden behandeln Identitätsinformationen bewusst anders. Folgen Sie Ihrer gewählten Methode, statt Hinweise aus inkompatiblen Rezepten zu kombinieren.
Geht es um die Gesichtsidentität, ergänzen Sie keine unpassenden Bewegungsclips, nur weil der Trainer Videos akzeptiert. Ist eine charakteristische Bewegung wichtig, wählen Sie Clips, die sie deutlich zeigen und die Person erkennbar halten. Standbilder und Video liefern unterschiedliche Informationen; Video erhöht außerdem Vorbereitungs- und Trainingsaufwand.
Achten Sie auf die falsche Art von Erfolg
Ein Beispiel kann Iris ähneln und dennoch ein schlechter Produktionsadapter sein. Warnzeichen sind derselbe Hintergrund in unpassenden Prompts, das alte Kostüm bei jeder Stärkeerhöhung, steife Bewegung oder die Missachtung einer neuen Kamerarichtung.
Mehr Training ist nicht immer die Lösung. Werden spätere Checkpoints ähnlicher, aber weniger flexibel, kann ein früherer nützlicher sein. Reproduzieren alle Beispiele den Trainingshintergrund, ist der Datensatz womöglich zu spezifisch. Verändert der Adapter bei keiner sinnvollen Stärke etwas, prüfen Sie Kompatibilität und Laden, bevor Sie eine weitere Nacht in Captions investieren.
Eine separate Community-Diskussion über H3-Figurentraining beschreibt genau diesen Kompromiss: Einige Nutzer fanden die Ähnlichkeit schwach, während ein anderer berichtete, dass stärkere Ähnlichkeit mit schlechterer Bewegung, Artefakten oder schlechterer Befolgung von Anweisungen einherging. Sie enthält auch positive RefMod-Berichte und enttäuschende Referenzergebnisse. Diese Berichte liefern keinen seriösen universellen Sieger.
Sie können eine kompatible LoRA mit gewöhnlichen Referenzen kombinieren. Der Adapter liefert eine erlernte Tendenz, ein akzeptiertes Bild das aktuelle Gesicht, Outfit oder die Komposition. Diese Kombination ist nützlich, wenn jede Komponente eine klare Aufgabe hat; sie ist kein Anlass, sämtliche verfügbaren Stärkeregler hochzudrehen.
Vorbereitungszeit und wofür Sie tatsächlich bezahlen
Gewöhnliche Referenzen verursachen den geringsten Einrichtungsaufwand, wenn die Quellbilder bereits existieren. Sie wählen konsistente Dateien aus und weisen ihnen Rollen zu. RefMods ergänzen Installation und Extraktion und reduzieren anschließend die wiederholte Handhabung. LoRAs ergänzen Datensatzvorbereitung, Training, Auswahl gespeicherter Checkpoints und Kompatibilitätsprüfungen.
Die Vorbereitungszeit hängt von Hardware, Quellenanzahl, Auflösung und Trainingsmethode ab. Der fünfstündige Community-Versuch oben beschreibt genau diesen Lauf; planen Sie Ihre Trainingssitzung anhand Ihres Trainers und Ihrer Hardware.
| Kostenpunkt | Gewöhnliche Referenzen | RefMod | Trainierte LoRA |
|---|---|---|---|
| Erste kreative Arbeit | Identitätsbilder und nützliche Ansichten | Dieselbe Quellvorbereitung | Kuratierter Datensatz, häufig mit mehr Variation |
| Zusätzliche Vorbereitung | Eingaben auswählen und ordnen | Installieren, kodieren und gespeichertes Asset prüfen | Training konfigurieren und ausführen; brauchbaren Checkpoint wählen |
| Wiederholte Arbeit | Dateien oder gespeichertes Preset laden | Gespeichertes Paket laden | Kompatible Gewichte mit Trigger und Einstellungen laden |
| Generierungskosten | Abhängig von Endpunkt und Referenzgebühren | Lokale oder gemietete Rechenleistung; erhaltene Referenzen verursachen weiterhin Kosten | Generierungskosten plus eventuelle adapterspezifische Regeln des Hosts |
| Änderungskosten | Quelle austauschen | Asset aktualisieren | Möglicherweise erneutes Training, wenn die erlernte Identität geändert werden muss |
Gehostete Preise sind von lokalen RefMod-Kosten getrennt
Die aktuellen H3-Seiten von SpicyAPI akzeptieren gewöhnliche Referenzmedien; die LoRA-Seiten zusätzlich kompatible LoRA-Gewichte. Sie bieten kein Uploadfeld für RefMods. Eine RefMod-Datei im Format .safetensors ersetzt keine LoRA im Feld loras. Bewahren Sie die Quellbilder auf, wenn Sie dieselbe Figur über einen gehosteten Weg nutzen möchten.
Für ein bereits freigegebenes Startbild kostet H3 LoRA Image-to-Video $0.05 pro Ausgabesekunde bei 480p und $0.10 bei 768p. Ein fünfsekündiger Clip kostet somit $0.25 oder $0.50. Das Laden einer LoRA verursacht bei dieser Aufgabe keine separate Gebühr. Vier fünfsekündige Generierungen kosten entsprechend $1.00 oder $2.00; das sind vier Ausgaben, kein Versprechen von vier verwendbaren Ergebnissen.
Reference-to-Video wird anders berechnet. Die reguläre H3-Aufgabe berechnet zusätzlich zu den Ausgabesekunden $0.0068 pro Referenzbild. H3 LoRA Reference-to-Video berechnet $0.02 pro Bild. Hier stehen vollständige Schätzungen für fünf Sekunden mit ausschließlich Standbildreferenzen. Reguläres H3 bietet 480p nicht mehr an, daher zeigen diese Zellen einen Strich:
| Fünfsekündige Anfrage | 480p | 768p |
|---|---|---|
| H3, zwei Identitätsbilder | — | $0.1986 |
| H3, zwei Identitätsbilder plus ein Kleidungsbild | — | $0.2054 |
| H3 LoRA, zwei Identitätsbilder | $0.34 | $0.715 |
| H3 LoRA, zwei Identitätsbilder plus ein Kleidungsbild | $0.36 | $0.735 |
Reguläres H3 in 768p mit zwei Bildern kostet beispielsweise 5 × $0.037 + 2 × $0.0068 = $0.1986. Zehn solche Generierungen ergeben $1.986. Die entsprechenden H3-LoRA-Referenzanfragen ergeben in 768p $7.15. Wählen Sie anhand der dokumentierten Inhalte für Erwachsene der konkreten Aufgabe, der erforderlichen Eingaben und kompatiblen Gewichte. Dass eine Figur in mehreren Folgen vorkommt, erfordert für sich genommen keinen LoRA-Weg.
Bei der LoRA-Referenzaufgabe zählen auch Sekunden eines Referenzvideos zu den abgerechneten Sekunden; Audioreferenzen verursachen zudem eigene Gebühren pro Referenz. Ein gespeicherter lokaler RefMod umgeht diese gehosteten Eingabetypen oder Preise nicht. Halten Sie eine Bewegungsreferenz kurz und verwenden Sie sie nur, wenn sie etwas beiträgt, das Standbilder und Prompt nicht liefern.
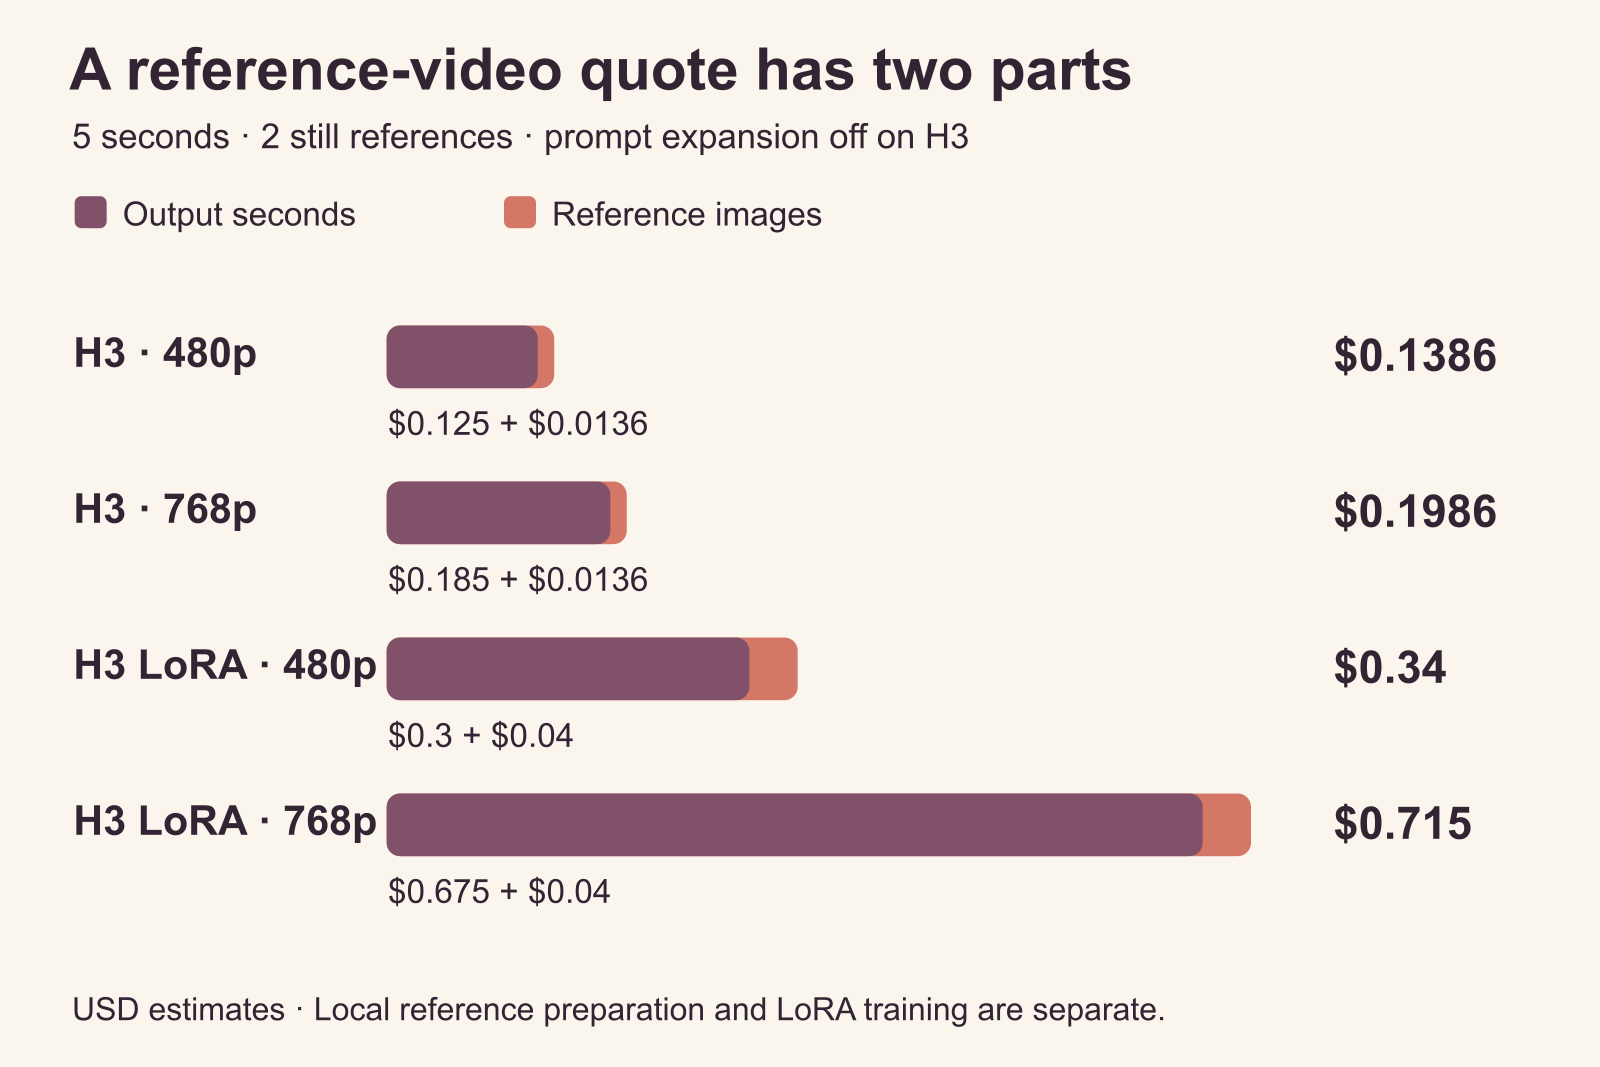
Die Schätzungen für fünfsekündige Generierungen enthalten beide Standbildreferenzen. Referenzvorbereitung und LoRA-Training sind separate Kosten.
Entscheiden Sie, ob Training genug wiederholte Arbeit spart
Die Trainingsrechnung ist nur ein Teil der Entscheidung. Rechnen Sie Quellvorbereitung, GPU-Miete, Zwischenbeispiele und die Zeit zum Beheben inkompatibler Ausgaben hinzu. Ein niedriger GPU-Preis ist kein Schnäppchen, wenn der entstandene Adapter nie eine brauchbare Figur liefert.
Bleiben Sie für eine Handvoll Clips bei Referenzen, sofern Sie nicht bereits einen geeigneten Adapter besitzen. Benennen Sie bei häufigen Ausgaben den Aufwand, den Training verringern soll: wiederholte Auswahl, wiederholte Bildgebühren, langsame referenzlastige Inferenz oder die Schwierigkeit, einen bestimmten erlernten Look zu erreichen.
RefMods helfen vor allem gegen wiederholte Auswahl und Vorbereitung. Eine LoRA kann die anderen Probleme angehen, aber erst, wenn sie im vorgesehenen Generierungsweg tatsächlich funktioniert. Bezahlen Sie nicht für Training, um ein Ordnungsproblem zu lösen, das ein gespeichertes Referenzpreset bereits löst.
Zählen Sie erfolgreiche Ausgaben außerdem ehrlich. Bezahlen Sie sechs abgeschlossene Generierungen und verwenden zwei, sind Ihre Generierungskosten pro behaltenem Ergebnis dreimal so hoch wie die Gebühr pro Ausgabe. Diese Rechnung gilt für alle drei Methoden. Eine bessere Quellvorbereitung oder einfachere Aufnahme kann wichtiger sein als die günstigste beworbene Videosekunde.
Häufige Fehler und die nächste sinnvolle Änderung
| Was Sie sehen | Was zuerst prüfen | Sinnvolle Änderung |
|---|---|---|
| Die Vorderansicht ist erkennbar; während der Drehung entsteht eine neue Person | Ob die Referenzen den sichtbar werdenden Winkel zeigen | Akzeptiertes Profil ergänzen oder Drehung reduzieren |
| Das ursprüngliche Outfit kehrt immer wieder zurück | Ob jede Identitätsquelle dieses Outfit enthält | Quelle ersetzen, Outfit trennen oder neues Startbild vorbereiten |
| Ein RefMod hat die richtige Miniatur, aber schwache Gesichtsdetails | Gespeicherten Ausschnitt und Repräsentation | Mit klarerem Ausschnitt und Full-Identitätsgrundlage neu aufbauen |
| Eine gespeicherte Figur ignoriert ihren Namen | Ob der Prompt auf die tatsächliche Medienbezeichnung verweist | Person der Bezeichnung aus der aktuellen Zuordnung zuweisen |
| Zwei Figuren verschmelzen | Eingabereihenfolge, Rollenzuweisung und zusätzliche Gesichter | Bezeichnungen korrigieren, konkurrierende Gesichter entfernen, mit statischer Zweieraufnahme beginnen |
| Eine LoRA lädt, bewirkt aber keinen nützlichen Unterschied | Kompatibilität von Basis, Aufgabe und Loader | Vorgesehenen Inferenzweg bestätigen, bevor Sie erneut trainieren |
| Ähnlichkeit steigt, aber Bewegung bricht ein | Adapterstärke und Checkpointauswahl | Einfluss verringern oder früheren brauchbaren Checkpoint nutzen |
| Ein neuer Raum wird immer wieder zum alten | Ob Rauminformationen noch geladen werden | Alte Raumreferenz vollständig entfernen |
| Das Gesicht bleibt stabil, aber die Stimme wechselt | Ob eine separate Sprachlösung existiert | Dialogidentität als eigene Produktionsaufgabe behandeln |
Ändern Sie die Eingabe, die am unmittelbarsten mit dem unerwünschten Merkmal verbunden ist. Ein unerwünschtes Outfit ist ein Grund, zuerst die Kleidungsquelle zu überarbeiten, bevor Sie Checkpoint, Sampler und gesamten Referenzsatz ändern.
Für die Weiterarbeit erklärt der H3-LoRA-API-Leitfaden, wie Sie einen vorhandenen Adapter laden und seine Aufgabe wählen. Der H3-Versionsvergleich erklärt die Produktvarianten. Das sind andere Entscheidungen als die Frage, ob Ihre wiederkehrende Figur Training braucht.
Wählen Sie für die nächste Folge
Wählen Sie für Iris' nächste Folge das freigegebene Porträt und die zusätzliche Ansicht, die die Aufnahme benötigt, wählen Sie eine für die beabsichtigte Szene für Erwachsene geeignete Aufgabe und erstellen Sie einen fünfsekündigen Clip. Speichern Sie einen RefMod, wenn die wiederholte Quellvorbereitung zum Problem wird. Trainieren Sie eine kompatible LoRA, wenn die Serie eine erlernte Fähigkeit oder einen Einsatzweg braucht, den diese Referenzen nicht liefern. Lassen Sie den nächsten tatsächlichen Produktionsbedarf über die Investition entscheiden.