Un personaje adulto recurrente debe ser reconocible en el siguiente episodio, no solo en el retrato que lo presentó. Una vez elegido el rostro, decidir entre RefMods y LoRA de MiniMax H3 consiste en determinar cuánto trabajo quieres repetir cuando cambien conjunto, ángulo de cámara u otra persona.
Empieza con referencias de imagen normales. Guarda un RefMod si ya trabajas en ComfyUI y reutilizas repetidamente esas imágenes. Considera entrenar un LoRA cuando necesites un personaje o estilo aprendido que tu flujo de referencias no consiga con eficiencia. RefMod reúne información de referencia; no entrena el personaje dentro de H3. LoRA requiere entrenamiento y esa inversión extra no mejora automáticamente el parecido.
Para una nueva personalidad adulta ficticia, preparar unas vistas coherentes suele ser la primera inversión útil. En una serie semanal establecida, una biblioteca ahorra configuración repetida. Entrenar tiene más sentido cuando el personaje es estable y puedes nombrar la limitación concreta que quieres resolver.
En una serie NSFW, la identidad va más allá del retrato: proporciones, tez y marcas distintivas quizá deban seguir reconocibles entre planos íntimos cercanos y escenas adultas amplias. Las tareas de referencia a video tienen registros públicos distintos: H3 normal registra imágenes NSFW moderadas representadas; H3 LoRA, escenas adultas de mayor intensidad. Son observaciones de tareas concretas, no comparan RefMods ni garantizan cada escena; elige manejo de identidad y capacidad de contenido por separado.
| Tu situación | Empieza aquí | Motivo |
|---|---|---|
| Tienes una escena terminada y quieres un clip breve | Imagen a video | Composición y vestuario ya están en el primer fotograma |
| Necesitas al mismo personaje en otra habitación o conjunto | Referencia a video normal | Puedes cambiar ingredientes sin reconstruir un recurso guardado |
| Cargas repetidamente las mismas referencias en ComfyUI | RefMod | Reutiliza un paquete organizado de referencias |
| Quieres obtener al personaje desde texto en un flujo H3 compatible | LoRA de personaje entrenado | El entrenamiento puede incorporar identidad aprendida en un adaptador |
| Necesitas dos personajes identificados en un plano | Referencias separadas para cada persona | Asigna identidades y posiciones explícitas antes de añadir complejidad |
| Necesitas estilo o movimiento distintivo recurrente | LoRA apropiado o referencia pertinente | Elige para esa tarea; adaptador de personaje no equivale automáticamente a movimiento |
Los ejemplos usan a Iris, personaje ficticio de 32 años en una serie adulta de retratos y videos. Son encargos iniciales prácticos, no resultados nuevos de comparación.
Qué ahorra realmente cada método
Una referencia normal es una imagen u otro medio admitido aportado a una generación. La eliges otra vez o recargas mediante un flujo guardado al crear el próximo plano. No se vuelve conocimiento permanente del modelo. Llamar «Iris» al personaje en diez prompts tampoco crea una identidad persistente.
RefMod convierte medios en un archivo reutilizable para flujos H3 compatibles. El proyecto original explica que la extracción guarda representaciones VAE sin entrenar pesos de H3. Full conserva más información; Compressed sacrifica detalle para usar menos tokens de referencia. El nombre interno histórico training se refiere a refinar un latente comprimido, no a entrenar LoRA. Ropa, identidad y fondo aún pueden viajar juntos.
LoRA es un adaptador entrenado: cambios aprendidos que acompañan al modelo base. El artículo original de LoRA describe la adaptación de bajo rango. En H3 implica preparar ejemplos y producir pesos que tu flujo pueda cargar realmente. Guardar fotos en RefMod y ajustar LoRA resuelve problemas distintos, aunque ambos terminen en .safetensors.
| Pregunta | Referencias normales | RefMod | LoRA entrenado |
|---|---|---|---|
| ¿Qué preparas? | Imágenes seleccionadas o medios admitidos | Medios seleccionados y flujo de extracción compatible | Dataset depurado y entrenador |
| ¿Qué reutilizas? | Originales y funciones en el prompt | Representaciones guardadas | Pesos aprendidos |
| ¿Puedes reemplazar un origen malo? | Sustituye la imagen | Reconstruye o edita el paquete | Revisa dataset y vuelve a entrenar si aprendió el problema |
| ¿Genera sin referencias? | No | No; las guardadas siguen condicionando | Potencialmente, según adaptador y tarea |
| ¿Garantiza la misma persona? | No | No | No |
| ¿Es formato universal de subida H3? | Solo medios que acepte el endpoint | No | Solo pesos compatibles admitidos por el cargador |
Importa cuando decepciona un recurso. Si RefMod guarda un perfil inconsistente, un nombre mejor no corrige el rostro. Si LoRA aprendió Iris asociada a un traje, pedir otro puede competir con esa asociación. En ambos la preparación influye; la reparación ocurre en fases distintas.
También puedes encontrar RefLoRA. El proyecto RefLoRA reúne pesos LoRA entrenados y referencias RefMod en un archivo. Un cargador LoRA normal usa los pesos; uno combinado compatible puede usar ambos. Empaquetarlos no elimina el entrenamiento previo y un servicio alojado no lee automáticamente la mitad de referencias. Identifica contenido y cargador en vez de elegir por extensión.
Decide primero qué debe mantenerse
Para Iris, define la identidad recurrente de forma acotada: mujer adulta de 32 años, corte bob corto castaño rojizo, cejas anchas, nariz recta y rostro reconocible. Son constantes de la serie. Conjunto negro de noche, ropa de descanso crema, luz de dormitorio y distancia de cámara dependen del plano.
Esta separación evita un error caro: conservar toda la primera imagen cuando la serie exige cambios. Una fotografía contiene persona, ropa, postura, luz y habitación. «Mantén consistente a Iris» se entiende fácilmente, pero las entradas deben aclarar qué pertenece a Iris y qué a este episodio.
En la serie adulta de Iris, usa referencias distintas para problemas de reconocimiento distintos:
| Qué reconoce el público | Fuente útil | Qué puede cambiar en la escena |
|---|---|---|
| Rostro, cejas y línea del pelo | Retrato claro y ángulo de giro aprobado | Expresión, mirada y maquillaje |
| Complexión y proporciones relativas | Vista amplia aprobada con hombros, cintura y postura legibles | Postura, distancia y ropa |
| Tatuaje pequeño recurrente del hombro | Vista clara del diseño y ubicación reales | Luz y si aparece en encuadre |
| Estilo de una colección | Vestuario y peinado elegidos | Estilo del siguiente episodio |
Un rostro recortado no define proporciones de una escena amplia. Una imagen lejana puede mostrar postura sin mucho detalle facial. Si cambia el tatuaje, añade fuente clara en vez de aumentar toda fuerza de referencia. Cuando la ubicación exacta sea esencial, resuélvela en la imagen inicial. La separación sirve para retratos adultos, escenas de salón o contenido más intenso; el plano determina qué información debe verse.
Prepara una carpeta pequeña con tres materiales:
- Vistas de identidad: retrato claro, tres cuartos y perfil aceptados como la misma persona.
- Ejemplos de vestuario: una imagen por conjunto recurrente, separada de identidad cuando puedas.
- Imágenes de escena: habitación vacía o inicio aprobado de un plano concreto.
Es organización práctica, no tamaño obligatorio de dataset. Un retrato tranquilo quizá solo necesite la primera. Un giro se beneficia de una vista aprobada de lo que revelará. Una habitación no aporta nada útil en una referencia facial si el entorno cambia cada semana.
Al elegir identidad, compara mandíbula, nariz, cejas y línea del pelo antes que belleza. Otro retrato más atractivo puede ser otra persona. Descartarlo ahora cuesta menos que construir un paquete de rostros contradictorios.
Distingue rasgo permanente y estilo. Si Iris a veces recoge el pelo, el conjunto debe mantenerla reconocible sin depender completamente de la silueta bob. Si cambia un accesorio con la ropa, no lo conviertas en su único rasgo diferenciador.
La misma lógica sirve para imágenes adultas. Un origen no tiene que reproducir intensidad ni composición de todas las escenas futuras. Elige identidad por legibilidad y la ruta adecuada para la escena. Empaquetar referencias o entrenar personajes no establece qué solicitudes adultas cumplirá un endpoint.
Referencias normales: el mejor inicio para una serie nueva
Son útiles si aún decides quién es el personaje, si cambia mucho el vestuario o si quieres Playground alojado sin mantener ComfyUI.
También muestran errores con claridad. Ves las imágenes exactas, quitas la conflictiva y haces el próximo plano. Esa sencillez tiene valor antes de fijar personaje. Un paquete elaborado puede ocultar una fuente débil.
Construye cinco segundos desde dos vistas de identidad
Usa retrato frontal de Iris como Picture 1 y tres cuartos aceptado como Picture 2. Define entorno en texto en este primer plano para que ambas aporten persona.
La tarea alojada MiniMax H3 referencia a video admite hasta nueve imágenes y produce 4–15 segundos. Empieza con cinco a 768p, vertical 9:16: $0.1986 con dos imágenes. Aumenta salida cuando la dirección merezca conservarse.
Picture 1 y Picture 2 muestran a Iris, la misma mujer adulta ficticia de 32 años. Úsalas para identidad facial, bob corto castaño rojizo y proporciones. Iris lleva vestido de noche de satén gris carbón. Se sienta junto a lámpara cálida de cabecera en apartamento tranquilo y gira lentamente el rostro desde tres cuartos hacia cámara. Plano medio cercano, cámara a altura de ojos, expresión suave y encuadre estable. Mantén rostro legible durante el giro. Audio: ambiente suave de habitación.
Asigna una función a referencias y otra al texto. No pide mantener fondo antiguo, ropa antigua e inventar habitación nueva simultáneamente. El giro moderado aporta acción clara sin varias posturas.
Si ya llevan el vestido y quieres conservarlo, dilo. Si una fuente lleva chaqueta, describe explícitamente vestido como ropa de salida. Si vuelve la chaqueta, sustituye o recorta esa referencia antes de añadir otro párrafo sobre vestido.
Usa imagen inicial cuando la escena ya sea correcta
Supón que ya creaste la composición: Iris con ropa crema sentada junto a lámpara, expresión y habitación correctas. Imagen a video es el siguiente paso directo. Parte de lo aceptado; referencia a video construye otro plano con ingredientes.
Un encargo adecuado sería:
Iris, mujer adulta ficticia del fotograma inicial, levanta suavemente la mirada hacia cámara y esboza una sonrisa relajada. Sus hombros mantienen posición. La cámara se acerca lenta y ligeramente. La lámpara permanece estable. Audio: ambiente interior tranquilo.
La diferencia es dónde inviertes esfuerzo. Usa referencias para componer y un inicio cuando solo falta movimiento. Entrenar LoRA únicamente para animar una imagen terminada añade otro proyecto antes de resolver la necesidad inmediata.
Un inicio no garantiza perfección de todos los fotogramas. Si un giro largo revela perfil desconocido, acórtalo o prepara mejor ángulo. Resuelve ese diseño del plano antes de declarar fallido todo el método de identidad.
RefMods: cuando preparar referencias se vuelve repetitivo
Son atractivos si te gusta el personaje, ya usas ComfyUI y reconstruyes continuamente la misma colección. Ahorran organización y cálculo: un recurso identificado sustituye selección y preparación repetidas.
Hay diferencia importante entre archivo y flujo que lo consume. Los nodos H3 pueden presentar referencias de manera distinta. Un buen resultado en el grafo de un creador no demuestra la misma persona con todos los cargadores.
Fantastic H3 Prompt Builder de Adudeguyman añade gestor de referencias y editor de prompts. Su mapa muestra etiquetas asociadas a entradas reales. Versiones nuevas guardan fotogramas del codificador y ofrecen experimentalmente elegir cuántas imágenes ve el codificador de texto. Más imágenes pueden aumentar memoria y tiempo. Son controles del flujo, no garantía de identidad mejor.
Crea un recurso Iris reutilizable
La guía RefMod del proyecto da instalación e instrucciones de nodos. Para este personaje:
- Empieza con flujo H3 de referencias funcional y VAE correspondiente.
- Abre creación en la biblioteca y añade imágenes aprobadas de Iris.
- Revisa recortes. La primera determina la forma del conjunto combinado; ajusta fuentes que pierdan rostro o pelo.
- Elige Full para la base de identidad, nombra personaje y crea paquete.
- Añádelo a la pila y lee el mapa antes de redactar su función en el prompt.
Conserva originales. La referencia guardada es cómoda, pero la carpeta permite quitar vista mala, recortar distinto o cambiar de aplicación.
No guardes toda la historia de Iris en un recurso maestro. Debe ser fácil de explicar: «vistas aprobadas de Iris». No debería significar también tres habitaciones, cuatro trajes, peinado antiguo y otro personaje que apareció una vez.
Examina lo guardado antes de culpar a la generación
Recorte y compresión pueden borrar justo el rasgo importante. Una miniatura en el explorador no demuestra que lo guardado contenga retrato completo con el detalle previsto.
Si el original tiene cara clara pero la vista guardada es suave, estrecha o recortada, mejora primero el recurso. Para retratos, pocas vistas claras son un inicio más sensato que un paquete enorme con detalles importantes reducidos.
Full y Compressed sirven, pero «archivo menor» no significa «condicionamiento gratis». Sigue aportando referencias durante generación. Conservar más detalle también puede mantener habitación o ropa no deseadas junto al rostro. Selecciona información antes de ajustar fuerza.
Para Iris, separa identidad y habitación opcional. Carga lo necesario. Si la escena usa otro apartamento, omite completamente el antiguo. Bajar su fuerza es una solución indirecta cuando no tiene función en el clip.
Por qué parecen contradictorios los resultados comunitarios
En una conversación de entrenamiento de personajes H3, el autor contó unas cinco horas en RTX 5090 sin parecido satisfactorio. Respuestas elogiaban RefMods; otras describían peor parecido o más tiempo que referencias normales. También cuestionaban que empaquetar muchas imágenes crease identidad recién entrenada.
Distinguen comodidad, velocidad y parecido como beneficios separados. RefMod puede ser cómodo sin acelerar tu grafo. Puede ahorrar preparación sin mejorar un rostro. Un buen ejemplo depende de checkpoint, recortes, presentación y prompt además del archivo.
La actualización del autor de Prompt Builder describió menos mezcla de personajes al cambiar cómo llegaban referencias al codificador de texto, con tiempo y memoria adicionales. Aún señalaba intercambio de voces. Es un resultado concreto de implementación con problemas pendientes, no prueba de que RefMod sustituya LoRA para todos.
Cambia vestuario sin cambiar personaje
Las personalidades adultas necesitan reconocimiento y novedad. Rostro familiar, estilo distinto entre retratos, salón y secuencia nocturna. Aquí un paquete cómodo puede volverse demasiado amplio.
Si todas las referencias llevan el mismo vestido oscuro, puede dominar la instrucción visual. Añadir cinco imágenes de trajes distintos aporta información y también competencia de vestuario.
Una organización práctica:
| Recurso | Qué contiene | Cuándo usarlo |
|---|---|---|
| Identidad Iris | Vistas aprobadas con rasgos coherentes | Cada plano con esa persona |
| Vestuario de noche | Vista clara del vestido y estilo previstos | Secuencia nocturna |
| Vestuario de descanso | Vista clara del conjunto crema | Secuencia de salón |
| Escena de apartamento | Habitación sin personajes competidores | Planos de esa habitación |
| Fotograma inicial aprobado | Iris, conjunto y composición final juntos | Imagen a video de esa configuración |
Pueden ser archivos normales. Haz RefMod solo de lo que reutilizas en local compatible. No aporta crear paquete permanente para un accesorio de una vez.
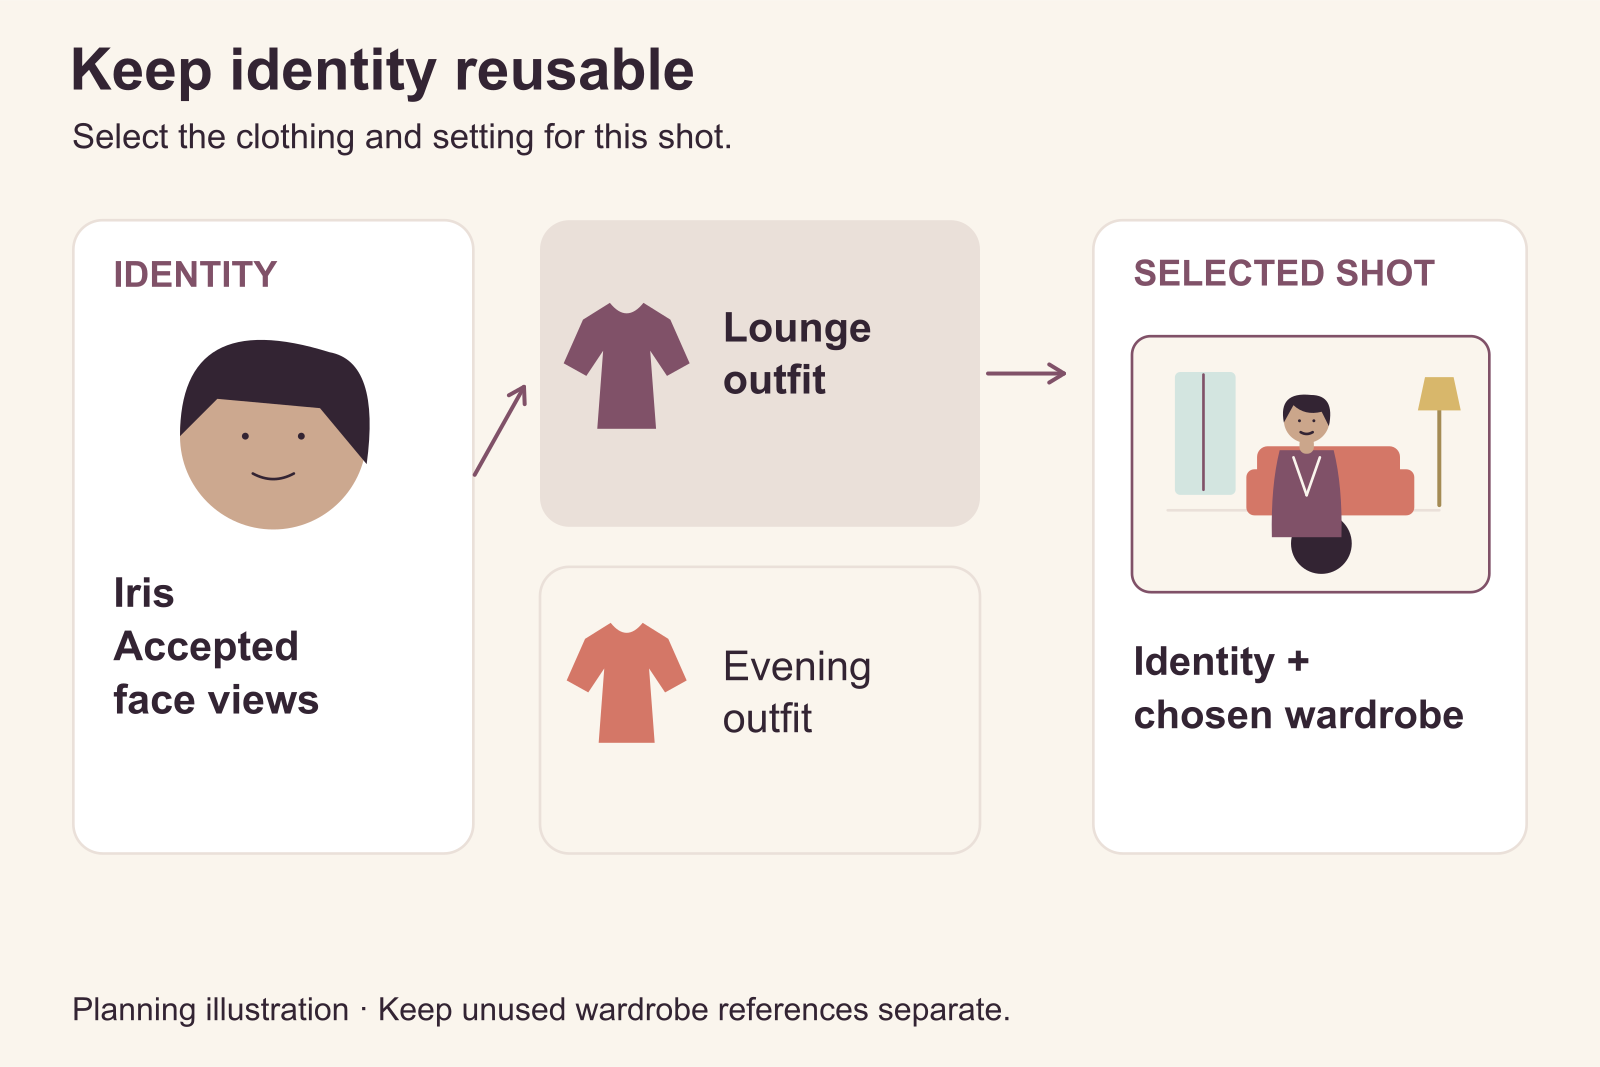
Ilustración: conserva identidad reutilizable y elige ropa y entorno por plano.
Aporta un origen claro para el conjunto nuevo
Mantén las dos vistas de identidad y añade ropa como Picture 3. Prefiere prenda sola o recorte que la muestre sin otro rostro competidor.
Picture 1 y Picture 2 definen a Iris, la misma mujer adulta ficticia de 32 años. Picture 3 define ropa de descanso crema para esta escena. Muestra a Iris sentada en sillón junto a lámpara cálida con ese conjunto. Conserva rostro de Pictures 1 y 2. Apoya mano en brazo del sillón y mira lentamente hacia ventana. Plano medio con rostro visible. Audio: ambiente tranquilo.
Si contiene otra persona, aclara especialmente su función. Mejor aún, retira su rostro si puedes sin perder detalle de ropa.
Si reaparece el traje antiguo, prepara una imagen editada con el nuevo. Cuando rostro y ropa sean correctos juntos, anímala. Trasladas la decisión discutida a una imagen estática revisable.
Puede ser más fácil que pedir a cinco segundos resolver identidad, construcción de ropa y movimiento a la vez. También aporta inicio reutilizable para varios clips del mismo conjunto.
Rediseñar permanentemente personaje necesita fuentes nuevas aprobadas; sepáralas de las antiguas para reproducir episodios anteriores. Otra identidad quizá justifique reentrenar LoRA. Un vestido nuevo suele pedir primero referencia de ropa o inicio preparado.
Dos personajes necesitan funciones explícitas
Dos RefMod no crean automáticamente dos personas controladas por separado. Dos LoRA tampoco reservan media pantalla para cada identidad.
El modelo debe resolver quién aparece, qué información pertenece a cada cual y qué hace. Se complica con mismo pelo, ropa y descripción facial o frases vagas como «ella gira hacia ella».
Introduce a Alex, otro adulto ficticio de 35 años. Dale corte corto visiblemente diferente y referencia propia. Ayuda a describir plano, no sustituye una fuente válida de identidad.
Para referencias normales, una disposición sencilla:
- Pictures 1 y 2: frente y tres cuartos de Iris.
- Pictures 3 y 4: vistas correspondientes de Alex.
- Habitación y ropa: en texto salvo necesidad de otra referencia.
Escribe su relación con la escena:
Pictures 1 y 2 muestran a Iris, mujer adulta ficticia de 32 años. Pictures 3 y 4 muestran a Alex, hombre adulto ficticio de 35. Iris está a izquierda con vestido gris carbón; Alex a derecha con camisa oscura de cuello abierto. Intercambian una sonrisa tranquila junto a ventana de apartamento. Iris gira hacia Alex mientras Alex sigue mirando a Iris. Plano medio de ambos con caras visibles y cámara fija. Audio: ambiente suave de tarde.
Las posiciones reducen ambigüedad. Nombres sustituyen pronombres en la acción. La cámara quieta evita pedir además cruzarse, intercambiar posiciones y girar alejándose juntos.
En RefMod local, usa etiquetas del mapa actual. Uno de varias imágenes puede aparecer como referencia de video, no de imagen; no adivines números desde archivo ni copies un prompt antiguo tras reordenar la pila.
La guía oficial de referencias H3 separa sujetos visibles y medios que los aportan. Iris es el sujeto; foto o video es información de Iris. Permite describir su lugar nuevo sin reproducir toda la escena fuente.
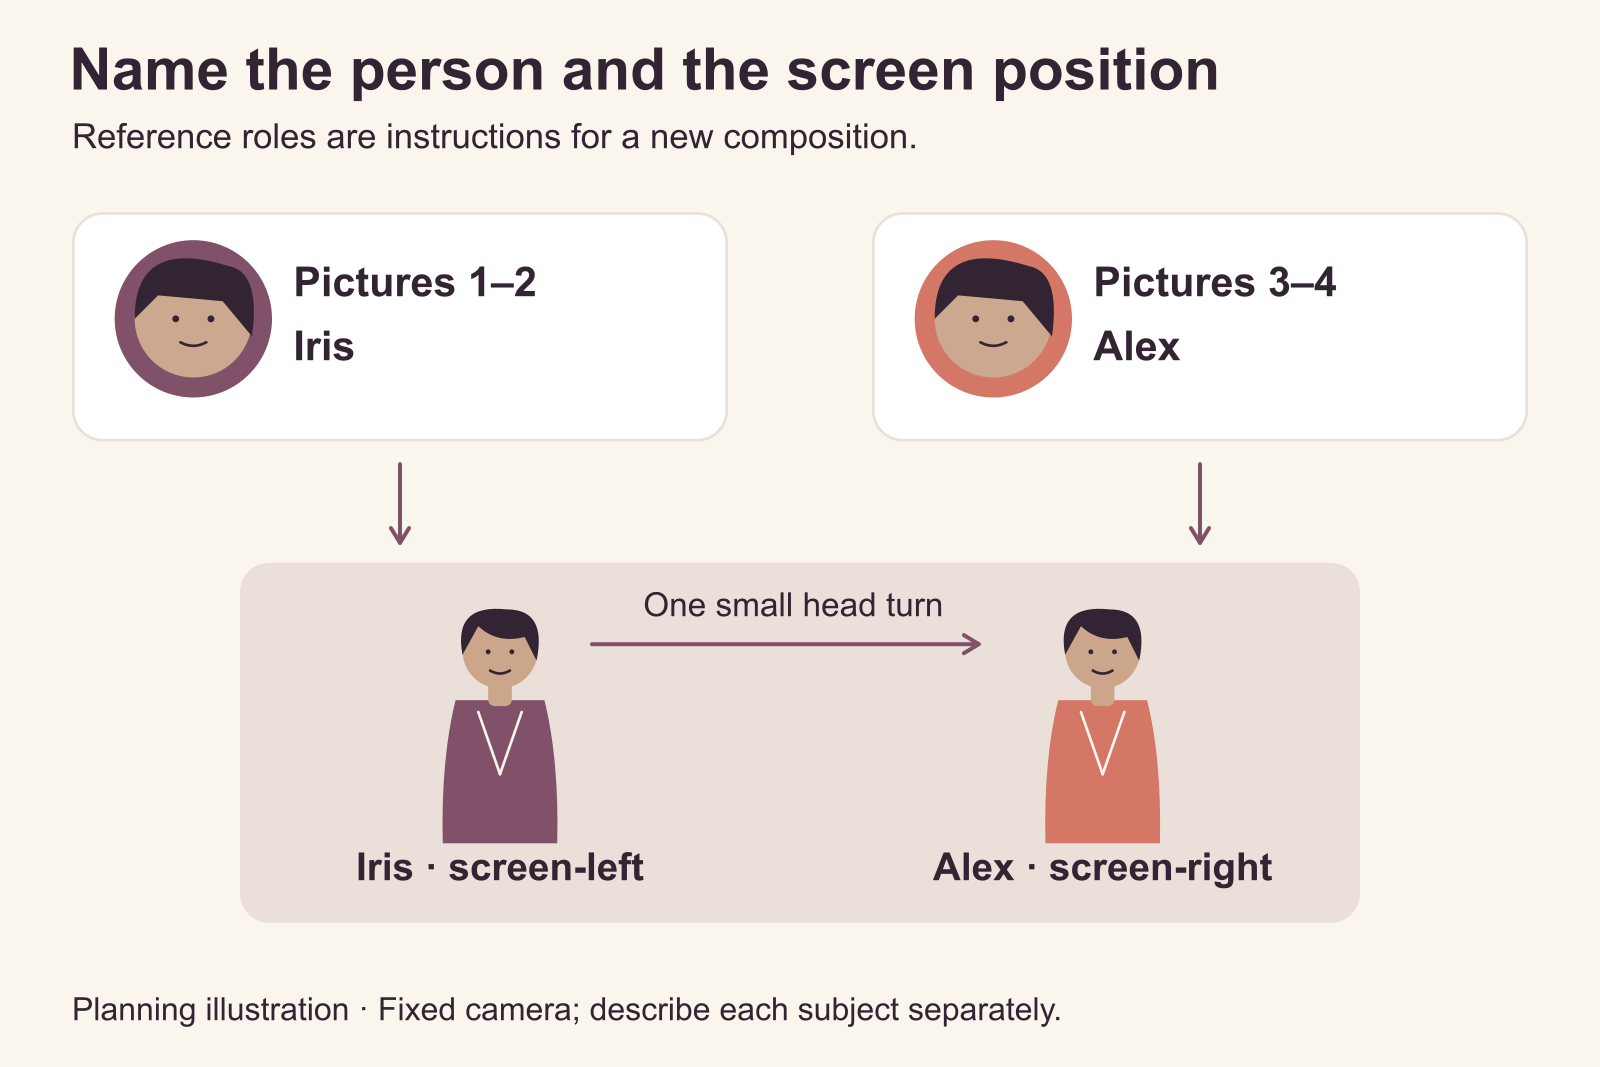
Ilustración: asigna por separado fuentes, persona y posición en pantalla.
Si se mezclan rostros, simplifica primero la composición
Si Alex hereda pelo de Iris o Iris rostro de Alex, comprueba fuentes y etiquetas. Una imagen mal asignada parece fallo de calidad de identidad.
Si son correctas, facilita papeles visuales: caras visibles, posiciones separadas y sin cruces en el primer plano conjunto. Quita ropa que tenga un tercer rostro. Si separados funcionan y juntos se mezclan, prepara inicio de dos personas aceptadas y anima interacción moderada.
También puedes cambiar edición: alterna planos individuales y sobre hombro en lugar de encajar cada momento en plano conjunto móvil. Es una decisión práctica cuando importa más continuidad creíble que ver siempre ambas caras.
Nada garantiza una interacción difícil. Abordan ambigüedades concretas antes de construir más recursos de identidad.
Separa identidad vocal y visual
Un personaje visualmente consistente con otra voz en cada episodio sigue sintiéndose distinto. Guardar audio junto al RefMod visual no establece un enlace fiable entre voz y cara.
Las notas de validación del proyecto registran transferencia de identidad de hablante fallida y cobertura incompleta. Evalúa referencias sonoras como capacidad independiente del flujo real.
En la primera secuencia Iris basta ambiente. Si una voz estable es esencial, planifica voz y diálogo aparte, no elijas RefMod suponiendo que el archivo combinado lo resolvió. Un LoRA visual entrenado tampoco prueba voz entrenada.
Cuándo compensa entrenar un LoRA de personaje
Tiene sentido con identidad definida y necesidad más concreta que seleccionar referencias fácilmente.
Tres situaciones justifican considerarlo:
- Quieres producir desde texto a video con adaptador compatible, sin aportar una colección grande en cada plano.
- Necesitas estilo o comportamiento recurrente aprendido que las referencias no expresan suficientemente.
- Ya tienes producción LoRA funcional y quieres incluir este personaje.
«Hago una serie» no basta. Diez retratos bien compuestos pueden resolverse con inicios aprobados. Una serie mayor puede justificar entrenamiento solo si reduce trabajo real o añade capacidad necesaria.
Entrena para el flujo donde correrá el adaptador
H3 no es un archivo intercambiable único. FL2VA y Ref2VA requieren compatibilidad deliberada. La documentación Ref2VA de AI Toolkit identifica pesos y adaptador de entrenamiento separados. No supongas compatibilidad con toda tarea o checkpoint por el nombre H3.
Antes decide si producirás principalmente texto a video, animación inicial o video condicionado por referencias. Comunícalo a quien configure el entrenador. Una receta impresionante en un grafo no es automáticamente un recurso listo para otro.
Sigue instrucciones H3 actuales del entrenador en lugar de copiar tasa de aprendizaje y pasos de un tutorial Wan o de imagen. La documentación H3 actual de Musubi admite varias tareas y maneras distintas de conservar comportamiento base. Afectan a lo aprendido y a lo que puede alterar.
Prepara un dataset que enseñe al personaje, no una fotografía
Para Iris, la colección debe mostrar identidad con variación necesaria: rostros legibles en ángulos pertinentes, encuadres amplios si importan proporciones y varios vestuarios y luces.
No fabriques variedad con versiones inconsistentes. Veinte imágenes de la misma persona aceptada son más coherentes que veinte bellas que cambian gradualmente nariz y mandíbula. Decenas de recortes casi iguales de un retrato no aportan el perfil ausente.
Describe lo variable: conjunto, encuadre, expresión y escena. Mantén nombres de identidad según el método. En receta con activador, una descripción puede ser:
irisvale, mujer adulta ficticia de 32 años, retrato tres cuartos, top de punto crema, expresión relajada, luz suave de ventana, fondo interior liso.
Es ejemplo de descripción, no comando universal de entrenamiento H3. Algunos métodos manejan identidad de otro modo. Sigue el elegido en vez de mezclar recetas incompatibles.
Si buscas identidad facial, no añadas movimiento ajeno solo porque acepte video. Si importa un movimiento distintivo, elige clips claros con persona reconocible. Imagen fija y video aportan información diferente; añadir video también suma preparación y entrenamiento.
Detecta el éxito equivocado
Una muestra puede parecer Iris y ser un mal adaptador de producción. Alertas: mismo fondo en prompts ajenos, traje antiguo al subir fuerza, movimiento rígido o ignorar nueva dirección de cámara.
La solución no siempre es entrenar más. Si checkpoints posteriores son más reconocibles y menos flexibles, uno anterior puede servir mejor. Si todas las muestras copian fondo, dataset demasiado específico. Si no cambia nada a fuerzas sensatas, revisa compatibilidad y carga antes de otra noche de descripciones.
Otra conversación comunitaria de entrenamiento H3 describe esa contrapartida: parecido débil para algunos y mayor semejanza con peor movimiento, artefactos o instrucciones para otro. Incluye experiencias RefMod positivas y referencias decepcionantes. No hay ganador universal honesto en esos relatos.
Puedes combinar LoRA compatible y referencias normales. El adaptador aporta tendencia aprendida; la imagen aceptada, cara, ropa o composición actuales. Ayuda si cada componente tiene función clara, no justifica subir todas las fuerzas al máximo.
Tiempo de preparación y qué pagas
Referencias normales tienen menor configuración si ya existen. El trabajo es seleccionar fuentes coherentes y funciones. RefMod añade instalación y extracción y reduce manejo repetido. LoRA añade dataset, entrenamiento, selección de checkpoint y comprobación compatible.
El tiempo depende de hardware, número, resolución y método. Las cinco horas anteriores describen aquella ejecución; presupuesta con tu entrenador y equipo previstos.
| Costo | Referencias normales | RefMod | LoRA entrenado |
|---|---|---|---|
| Creación inicial | Imágenes de identidad y vistas útiles | Misma preparación de fuentes | Dataset depurado, a menudo más variado |
| Preparación extra | Seleccionar y ordenar | Instalar, codificar y revisar recurso | Configurar y entrenar; elegir checkpoint útil |
| Trabajo repetido | Recargar archivos o preset | Cargar paquete | Cargar pesos compatibles y activador/ajustes |
| Generación | Endpoint y cargos de referencias | Cómputo local o alquilado; referencias retenidas aún cuestan | Generación más política de adaptadores del alojamiento |
| Revisión | Sustituir fuente | Actualizar recurso | Posible reentrenamiento si cambia identidad aprendida |
Precios alojados y costos RefMod locales son separados
Las páginas H3 SpicyAPI aceptan referencias normales; LoRA también acepta pesos compatibles. No exponen campo de subida RefMod. Un .safetensors RefMod no sustituye LoRA en loras. Conserva imágenes para usar personaje alojado.
Con un inicio aprobado, H3 LoRA imagen a video cuesta $0.05 por segundo a 480p y $0.10 a 768p. Cinco segundos cuestan $0.25 o $0.50. Cargar LoRA no añade tarifa. Cuatro generaciones cuestan $1.00 o $2.00; son cuatro salidas, no promesa de cuatro clips aprovechables.
Referencia a video factura distinto. H3 normal añade $0.0068 por imagen a segundos de salida; H3 LoRA, $0.02. Estimaciones completas de cinco segundos solo con imágenes fijas. H3 normal ya no ofrece 480p, por eso esas celdas llevan un guion:
| Solicitud de cinco segundos | 480p | 768p |
|---|---|---|
| H3, dos imágenes de identidad | — | $0.1986 |
| H3, dos de identidad y una de vestuario | — | $0.2054 |
| H3 LoRA, dos de identidad | $0.34 | $0.715 |
| H3 LoRA, dos de identidad y una de vestuario | $0.36 | $0.735 |
Por ejemplo, H3 normal 768p y dos fotos: 5 × $0.037 + 2 × $0.0068 = $0.1986. Diez suman $1.986. LoRA equivalente suma $7.15 a 768p. Elige por registro adulto de la tarea, entradas y pesos compatibles. Aparecer en varios episodios no exige por sí solo LoRA.
En referencia LoRA, los segundos de videos de referencia también se facturan y audio añade cargo por referencia. RefMod local no evita tipos o precios alojados. Mantén referencia de movimiento corta y úsala solo cuando aporte algo que no dan imagen y prompt.
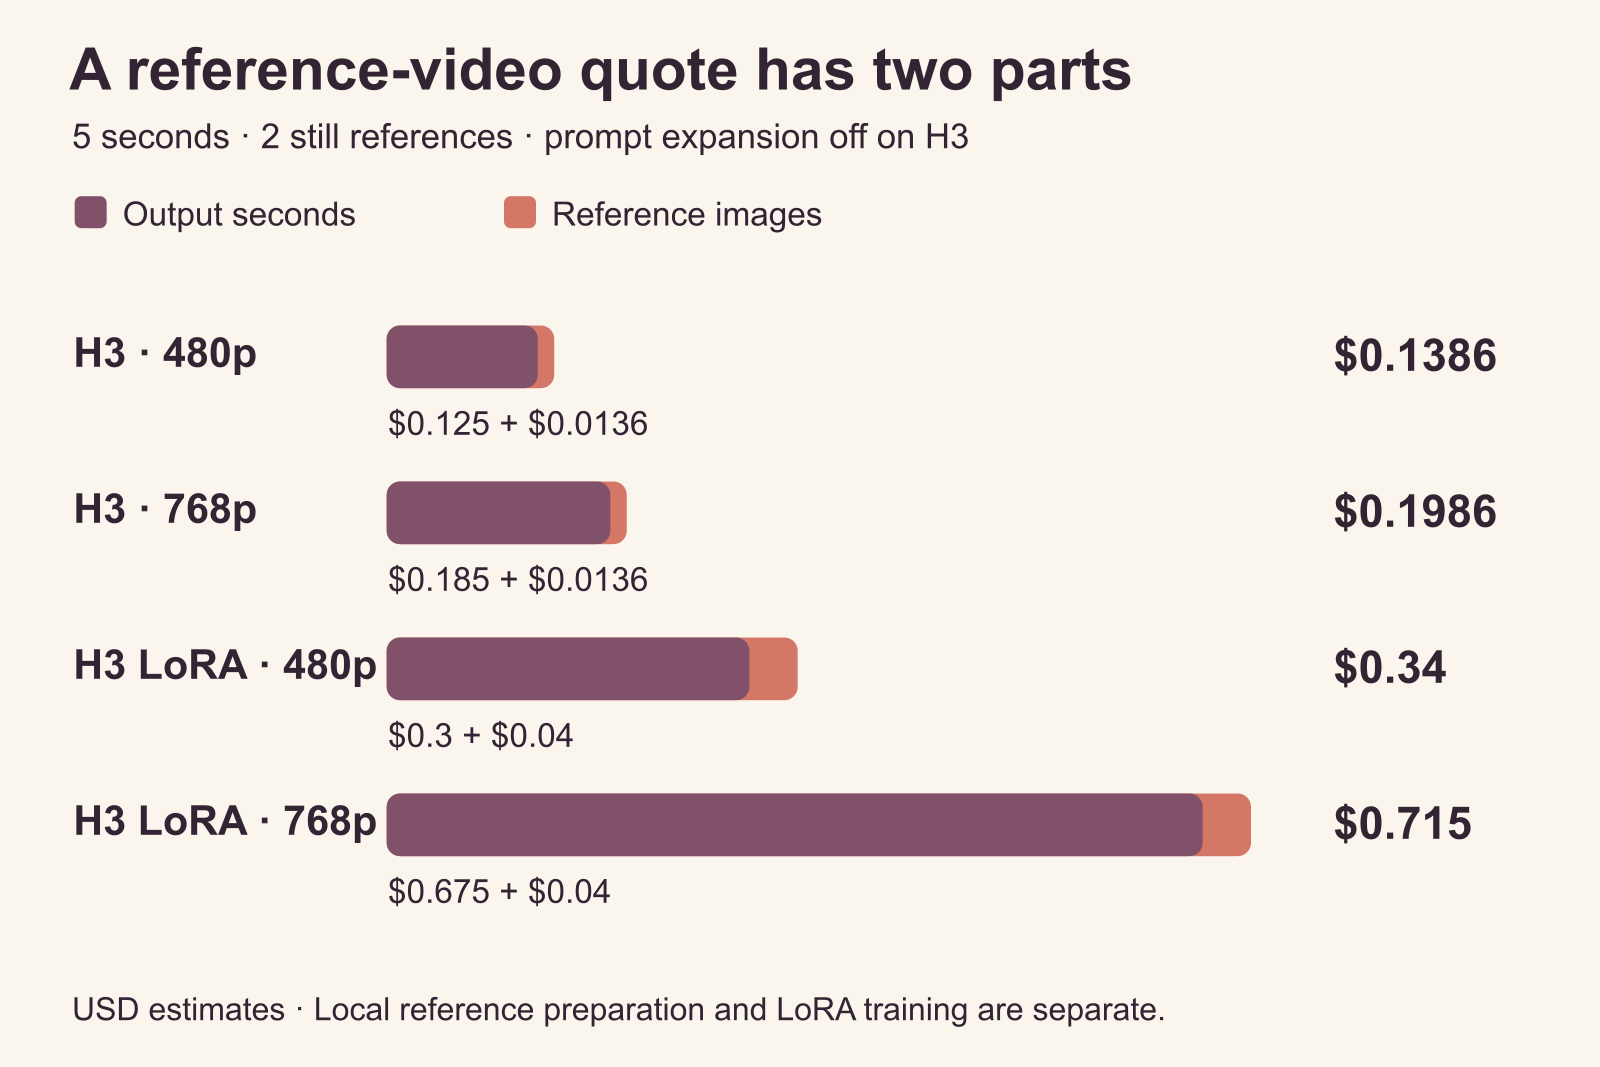
Estimaciones de cinco segundos con ambas referencias fijas. Preparación y entrenamiento LoRA son costos separados.
Decide si entrenar ahorra suficiente trabajo repetido
La factura de entrenamiento es solo una parte. Incluye preparación, alquiler GPU, muestras intermedias y tiempo de corregir incompatibilidad. Una GPU barata no compensa si nunca obtienes personaje útil.
Para pocos clips conserva referencias salvo adaptador adecuado existente. Para producción frecuente identifica gasto que quieres reducir: selección repetida, cargos de imágenes, inferencia lenta con muchas referencias o no alcanzar cierto aspecto aprendido.
RefMod aborda principalmente selección y preparación. LoRA puede resolver los otros solo cuando funcione en la ruta prevista. No compres entrenamiento para una organización resuelta con preset de referencias guardado.
Cuenta resultados útiles honestamente. Si pagas seis generaciones completadas y usas dos, el gasto por clip aprovechable es tres veces el cargo por salida. Aplica a los tres métodos. Mejores fuentes o plano sencillo pueden importar más que el segundo anunciado más barato.
Errores comunes y siguiente cambio útil
| Qué ves | Qué comprobar primero | Cambio |
|---|---|---|
| Frente reconocible y otra persona al girar | Si muestran el ángulo revelado | Añade perfil aprobado o reduce giro |
| Vuelve conjunto original | Si todas las fuentes lo contienen | Reemplaza fuente, separa ropa o prepara inicio nuevo |
| Miniatura RefMod correcta y cara débil | Recorte y representación guardados | Reconstruye con recorte claro y base Full |
| Personaje guardado ignora nombre | Si el prompt usa etiqueta real | Asigna sujeto a etiqueta del mapa actual |
| Dos personajes mezclados | Orden, funciones y caras extra | Corrige etiquetas, quita caras y empieza con plano estático de dos |
| LoRA carga sin diferencia útil | Compatibilidad de base, tarea y cargador | Confirma ruta antes de reentrenar |
| Mejora parecido y se deteriora movimiento | Fuerza y checkpoint | Reduce influencia o usa checkpoint anterior útil |
| Otra habitación vuelve a antigua | Si aún cargas información anterior | Elimina esa referencia completamente |
| Cara estable y voz cambiante | Si existe solución vocal separada | Trata identidad de diálogo como producción propia |
Cambia la entrada más ligada al rasgo indeseado. Otra ropa justifica revisar vestuario antes de checkpoint, sampler y conjunto entero.
Para continuar, la guía de API H3 LoRA explica cargar un adaptador y elegir tarea. La comparación de versiones H3 explica variantes de producto. Son decisiones separadas de si tu personaje necesita entrenamiento.
Elige para el siguiente episodio
Para el próximo episodio Iris, selecciona retrato y vista alternativa necesarios, tarea adecuada a la escena adulta y crea cinco segundos. Guarda RefMod cuando repetir preparación sea el problema. Entrena LoRA compatible cuando necesites una capacidad aprendida o ruta de despliegue que esas referencias no aporten. Deja que la siguiente necesidad real determine la inversión.