Um personagem adulto recorrente precisa ser reconhecível no próximo episódio, não só no retrato que o apresentou. Depois de escolher um rosto, a decisão entre MiniMax H3 RefMods e LoRA trata de quanto trabalho você quer repetir quando roupa, ângulo de câmera ou outra pessoa mudam.
Comece com imagens comuns de referência. Salve um RefMod se já trabalha no ComfyUI e reutiliza essas imagens repetidamente. Considere treinar um LoRA quando precisar de um personagem ou estilo aprendido que seu fluxo de referências não consiga entregar com eficiência. Um RefMod reúne informações de referência; não treina um personagem no H3. Um LoRA exige treinamento, e esse investimento extra não produz automaticamente semelhança melhor.
Para uma nova persona adulta fictícia, preparar algumas vistas consistentes costuma ser o primeiro investimento útil. Numa série semanal estabelecida, uma biblioteca de referências pode economizar configuração repetida. Treinar passa a ser uma despesa mais sensata quando a identidade já é estável e você consegue nomear a limitação específica que precisa resolver.
Numa série NSFW, identidade vai além de um retrato semelhante: proporções, tom da pele e marcas distintivas podem precisar continuar reconhecíveis em closes íntimos e cenas mais amplas de temática adulta. As tarefas de referência para vídeo discutidas aqui têm registros públicos distintos de testes de conteúdo: H3 comum registra imagens NSFW moderadas geradas, enquanto H3 LoRA registra cenas adultas de intensidade maior geradas. Essas observações específicas das tarefas não comparam RefMods nem garantem toda cena; escolha tratamento de identidade e capacidade de conteúdo separadamente.
| Sua situação | Comece aqui | Motivo |
|---|---|---|
| Você tem uma imagem de cena finalizada e quer um clipe curto | Imagem para vídeo | Composição e roupa já existem no quadro inicial |
| Precisa da mesma personagem em outro cômodo ou roupa | Referência para vídeo comum | Pode trocar ingredientes sem reconstruir um recurso salvo |
| Carrega repetidamente as mesmas referências no ComfyUI | RefMod | Reutilize um conjunto organizado de referências |
| Quer a personagem disponível por prompt de texto num fluxo H3 compatível | LoRA de personagem treinado | O treinamento pode colocar a identidade aprendida num adaptador |
| Precisa de dois personagens nomeados numa tomada | Referências separadas para cada pessoa | Atribua identidades e posições na tela explicitamente antes de complicar |
| Precisa de estilo ou movimento recorrente marcante | LoRA apropriado ou referência relevante | Escolha pela tarefa; um adaptador de personagem não é automaticamente de movimento |
Os exemplos abaixo usam Iris, uma personagem fictícia de 32 anos numa série de retratos e vídeos voltada ao público adulto. São briefings iniciais práticos, não resultados novos de comparação gerados.
O que cada método realmente poupa
Uma referência comum é uma imagem ou outra mídia aceita fornecida para uma geração. Você a escolhe de novo ou a recarrega pelo fluxo salvo da ferramenta na próxima tomada. A referência não vira conhecimento permanente do modelo. Chamar uma personagem de “Iris” em dez prompts também não cria identidade persistente.
Um RefMod transforma mídia de referência num arquivo reutilizável para fluxos H3 compatíveis. O projeto original RefMod explica que a extração armazena representações de referência VAE sem treinar os pesos H3. O modo Full retém mais informação; Compressed troca detalhes por menos tokens de referência. O nome histórico interno training se refere a refinar um latente comprimido, não a treinar LoRA. Roupa, identidade e fundo ainda podem viajar juntos.
Um LoRA é um adaptador treinado: um conjunto de alterações aprendidas usado junto ao modelo-base. O artigo original de LoRA descreve o princípio de adaptação de baixo posto. No H3, a consequência prática é preparar exemplos de treinamento e produzir pesos que seu fluxo de geração realmente consiga carregar. Salvar fotos num RefMod e ajustar um LoRA resolvem problemas distintos, mesmo se ambos os arquivos terminarem em .safetensors.
| Pergunta | Referências comuns | RefMod | LoRA treinado |
|---|---|---|---|
| O que prepara? | Imagens selecionadas ou mídia aceita | Mídia selecionada e fluxo de extração compatível | Dataset de treinamento selecionado e ferramenta de treinamento |
| O que reutiliza? | Arquivos originais e suas funções no prompt | Representações salvas de referências | Pesos de adaptador aprendidos |
| Pode substituir uma fonte ruim? | Substitua a imagem | Reconstrua ou edite o conjunto de referências | Revise o dataset e treine novamente se o problema foi aprendido |
| A geração independe de referências? | Não | Não; referências salvas ainda condicionam a geração | Potencialmente, conforme adaptador e tarefa |
| Garante a mesma pessoa? | Não | Não | Não |
| É um formato universal de upload H3? | Apenas tipos de mídia aceitos pelo endpoint | Não | Apenas pesos LoRA compatíveis aceitos pelo carregador |
Essa diferença importa quando um recurso decepciona. Se um RefMod salvo contém um perfil lateral inconsistente, melhorar seu nome não corrige o rosto. Se um LoRA aprendeu Iris junto de uma roupa específica, pedir uma roupa nova pode competir com a associação aprendida. Nos dois casos, a preparação afeta o resultado; o reparo acontece em etapas diferentes.
Você também pode encontrar RefLoRA. O projeto RefLoRA reúne pesos LoRA treinados e referências RefMod num arquivo. Um carregador normal de LoRA usa os pesos; um carregador combinado compatível pode usar ambos. Reuni-los não remove o treinamento que produziu o LoRA, e um serviço hospedado não consegue automaticamente ler a parte de referência. Identifique o conteúdo do arquivo e qual carregador o consumirá, em vez de escolher pela extensão.
Primeiro decida o que precisa permanecer igual
Para Iris, defina a identidade recorrente de forma restrita: mulher adulta de 32 anos, bob curto ruivo, sobrancelhas largas, nariz reto e formato de rosto reconhecível. São constantes da série. Roupa preta de noite, conjunto creme de ficar em casa, luz do quarto e distância da câmera são escolhas da tomada.
Essa separação evita um erro caro: tentar preservar toda a primeira imagem quando a série exige mudança. Uma fotografia de referência é uma cena visual completa. Contém pessoa, roupas, pose, luz e cômodo. “Mantenha Iris consistente” é fácil para um humano entender, mas as entradas ainda precisam esclarecer o que pertence a Iris e o que pertence ao episódio.
Para a série adulta de Iris, use referências distintas para resolver problemas distintos de reconhecimento:
| O que o público reconhece | Fonte útil | O que pode mudar na cena |
|---|---|---|
| Rosto, formato das sobrancelhas e linha do cabelo | Retrato claro e ângulo de virada aprovado | Expressão, olhar e maquiagem |
| Constituição corporal e proporções relativas | Vista ampla aprovada com ombros, cintura e postura legíveis | Pose, distância da câmera e roupa |
| Uma pequena tatuagem recorrente no ombro | Vista clara do desenho real e de sua posição | Luz e se o enquadramento a mostra |
| Estilo de um conjunto específico | Roupa e penteado escolhidos | Estilo do próximo episódio |
Um recorte de rosto não estabelece as proporções de Iris numa cena ampla. Uma imagem distante de corpo inteiro pode mostrar postura, mas fornecer poucos detalhes faciais úteis. Se a tatuagem do ombro mudar de formato, adicione uma fonte clara desse detalhe, em vez de aumentar a intensidade de todas as referências. Quando a posição exata for essencial, resolva-a na imagem inicial antes de animar. A mesma divisão de recursos funciona para retratos adultos, sequência na sala ou uma cena mais adulta; a tomada determina qual informação precisa estar visível.
Prepare uma pequena pasta de fontes com três tipos de material:
- Vistas de identidade: retrato claro, vista de três quartos e perfil que você tenha aprovado como a mesma pessoa.
- Exemplos de roupa: imagem de cada roupa recorrente, separada da seleção de identidade quando possível.
- Imagens de cena: cômodo vazio ou quadro inicial aprovado de uma tomada específica.
É uma organização de trabalho, não um tamanho obrigatório de dataset. Um clipe tranquilo de retrato pode precisar só da primeira imagem. Uma virada se beneficia de uma vista aprovada real dos traços que revelará. Uma imagem de cômodo não tem função útil numa referência facial próxima se o cômodo muda toda semana.
Ao escolher imagens de identidade, compare mandíbula, nariz, sobrancelhas e linha do cabelo antes de julgar beleza. Um retrato gerado mais atraente ainda pode ser a pessoa errada. Rejeitá-lo agora exige menos esforço que montar um conjunto de referências com rostos contraditórios.
Distinga também característica permanente de estilo. Se Iris às vezes prende o cabelo, as referências ainda devem tornar o rosto reconhecível sem depender totalmente da silhueta do bob. Se um acessório marcante muda com a roupa, não o transforme no único traço que diferencia Iris de outra personagem.
A lógica também vale para imagens de personagens adultos. Uma fonte não precisa reproduzir intensidade ou composição de toda cena futura. Escolha referências de identidade pela legibilidade da identidade. Escolha uma rota de geração adequada para a cena em si. Nem reunir referências nem treinar personagens estabelece quais solicitações adultas um endpoint atenderá.
Referências comuns: o melhor começo para uma série nova
Referências comuns são úteis quando você ainda decide quem é a personagem, quando a roupa muda com frequência ou quando quer usar um Playground hospedado sem manter ComfyUI.
Também deixam erros claros. Você vê as imagens exatas fornecidas, remove a que causou conflito e executa a próxima tomada. A simplicidade tem valor antes de fixar a personagem. Um conjunto salvo elaborado pode dificultar perceber uma imagem fraca.
Monte uma tomada de cinco segundos com duas vistas de identidade
Use o retrato frontal de Iris como Picture 1 e a vista de três quartos aprovada como Picture 2. Deixe o ambiente no briefing escrito desta primeira tomada para ambas as referências terem uma única função: a pessoa.
No MiniMax H3 de referência para vídeo, a tarefa hospedada aceita até nove imagens de referência e produz vídeo de 4–15 segundos. Comece com cinco segundos em 768p, vertical 9:16: $0.1986 com estas duas imagens. Pode passar a uma saída maior quando valer a pena manter a direção da tomada.
Picture 1 e Picture 2 mostram a mesma mulher adulta fictícia, Iris, de 32 anos. Use-as para identidade facial, bob curto ruivo e proporções. Iris usa vestido de noite de cetim cinza-chumbo. Está sentada junto de uma luminária de cabeceira quente num apartamento tranquilo e vira lentamente o rosto de três quartos para a câmera. Plano médio próximo, câmera na altura dos olhos, expressão suave, enquadramento estável. Mantenha o rosto claramente legível durante toda a virada. Áudio: ambiente suave do cômodo.
O briefing dá uma função às referências e outra ao texto. Não pede preservar fundo antigo, preservar roupa antiga e inventar outro cômodo ao mesmo tempo. A virada contida também dá uma ação clara sem precisar de várias poses diferentes.
Se os retratos de origem já mostram o vestido cinza-chumbo e você quer preservá-lo, diga isso. Se uma fonte mostra jaqueta, descreva explicitamente o vestido pretendido como roupa da saída. Quando a jaqueta continuar reaparecendo, a próxima mudança útil é substituir ou recortar a referência, não adicionar outro parágrafo sobre o vestido.
Use um quadro inicial quando a cena já estiver certa
Suponha que você já criou a composição de retrato desejada: Iris no conjunto creme, sentada junto à luminária, com expressão e cômodo certos. Imagem para vídeo é o próximo passo direto. Começa na imagem aprovada; referência para vídeo pede que o modelo construa outra tomada com ingredientes.
Um briefing adequado de movimento seria:
Iris, a mulher adulta fictícia do quadro inicial, ergue suavemente o olhar para a câmera e dá um pequeno sorriso relaxado. Os ombros permanecem na mesma posição. A câmera faz uma aproximação lenta e discreta. A luminária permanece estável. Áudio: ambiente interno tranquilo.
A diferença prática é onde você investe esforço. Use referências quando ainda precisa compor a cena. Use quadro inicial quando a cena já está composta e resta movimento. Treinar um LoRA de personagem só para animar uma imagem finalizada acrescenta outro projeto antes de resolver a tarefa imediata.
Um quadro inicial não promete perfeição de todo quadro posterior. Se uma virada longa revelar um perfil desconhecido, encurte-a ou prepare um ângulo inicial melhor. É um problema de desenho da tomada a resolver antes de considerar fracassado todo o método de identidade.
RefMods: úteis quando preparar referências fica repetitivo
RefMods ficam atraentes quando você gosta da personagem, já usa ComfyUI e continua reconstruindo a mesma coleção. A economia é organizacional e computacional: um recurso nomeado pode substituir seleção e preparação repetidas de fontes.
Há uma diferença importante entre o arquivo salvo e o fluxo que o consome. Nós H3 diferentes podem apresentar essas referências de formas diferentes. Um bom resultado do grafo de um criador não comprova que todo carregador RefMod produza a mesma personagem.
Fantastic H3 Prompt Builder de Adudeguyman acrescenta gerenciador de referências e editor de prompts à tarefa. Seu mapa de referências mostra os rótulos associados às entradas reais. Versões mais recentes podem armazenar quadros do encoder e oferecer uma escolha experimental de quantas imagens o encoder de texto vê. Mais imagens podem aumentar memória e tempo de geração. São controles de fluxo, não garantia de identidade melhor.
Crie um recurso Iris reutilizável
O guia de uso de RefMod do projeto fornece instalação e instruções específicas dos nós. Para esta tarefa de personagem, a sequência útil é:
- Comece com um fluxo H3 de referência funcional e seu VAE correspondente.
- Abra a tela de criação da biblioteca RefMod e adicione as imagens aprovadas de Iris.
- Examine as prévias de recorte. A primeira imagem determina o formato do conjunto combinado; ajuste fontes que percam rosto ou cabelo.
- Escolha Full como base de identidade, nomeie a personagem e crie o conjunto.
- Adicione o recurso salvo à pilha. Leia o mapa de referências antes de escrever a função do sujeito no prompt.
Guarde também as imagens de origem. A referência salva é conveniente, mas a pasta de fontes permite remover uma vista ruim, preparar outro recorte ou mudar de aplicativo depois.
Não salve toda imagem da história de Iris num recurso-mestre. Um recurso útil de personagem recorrente deve ser fácil de explicar: “estas são as vistas aprovadas de Iris”. Não deve também significar “três cômodos, quatro roupas, cabelo antigo e outro personagem que apareceu uma vez”.
Examine o resultado armazenado antes de culpar a geração
Recorte e compressão podem remover exatamente o traço que queria preservar. Uma miniatura de retrato no navegador de arquivos não comprova que a referência armazenada contenha o retrato completo no detalhe esperado.
Se a imagem original tem rosto claro, mas a prévia armazenada tem rosto suave, estreito ou parcialmente cortado, melhore o recurso primeiro. Numa série de retratos, uma coleção menor de vistas claras é um ponto de partida mais sensato que um conjunto enorme cujos detalhes importantes foram reduzidos.
Full e Compressed são escolhas úteis, mas “arquivo menor” não é igual a “condicionamento gratuito”. Um arquivo salvo pequeno ainda contribui com informação de referência durante a geração. Manter mais detalhes, por outro lado, pode preservar cômodo ou roupa indesejados junto ao rosto. Selecione a informação desejada antes de tentar ajustar sua intensidade.
Para Iris, guarde um recurso de identidade e um recurso opcional separado do cômodo. Carregue só o necessário à tomada. Se a cena for em outro apartamento, deixe de fora o recurso do cômodo antigo. Reduzir sua intensidade é uma correção indireta quando ele não tem função no novo clipe.
Por que os resultados da comunidade parecem contraditórios
Numa discussão de treinamento de personagem H3, o autor relatou cerca de cinco horas de treinamento numa RTX 5090 sem semelhança satisfatória. Respostas elogiaram RefMods, enquanto outros usuários relataram semelhança pior ou geração mais longa que em suas configurações de referência comum. A discussão também questionou a ideia de que reunir muitas imagens num arquivo crie uma identidade recém-treinada.
Esses relatos sustentam uma diferença útil: conveniência, velocidade e semelhança são benefícios separados. Um RefMod pode ser conveniente sem ser mais rápido no seu grafo. Pode poupar preparação sem melhorar um rosto específico. Um exemplo bem-sucedido pode depender de checkpoint, recortes, apresentação de referências e prompts, além do recurso salvo.
A atualização do autor do Prompt Builder relatou menos mistura de personagens após mudar como referências chegavam ao encoder de texto, com custos adicionais de tempo e memória. A mesma publicação ainda descrevia troca de vozes. É um resultado específico de implementação com problemas restantes, não evidência de que RefMods substituíram LoRAs de personagem para todos.
Mude a roupa sem mudar a personagem
Personas adultas recorrentes costumam precisar de reconhecimento e novidade. O rosto permanece familiar enquanto o estilo muda entre conjunto de retratos, cena na sala e sequência de noite vestida. É onde um conjunto conveniente pode ficar amplo demais.
Se toda referência de Iris mostra o mesmo vestido escuro de cetim, esse vestido pode virar parte forte da instrução visual. Adicionar depois cinco imagens com roupas sem relação fornece mais informação, mas também mais evidências concorrentes de figurino.
Uma organização prática é:
| Recurso | O que pertence a ele | Quando usar |
|---|---|---|
| Identidade de Iris | Vistas aprovadas com traços faciais consistentes | Toda tomada que precisa da pessoa estabelecida |
| Roupa de noite | Uma vista clara do vestido e estilo pretendidos | Sequência noturna |
| Roupa de ficar em casa | Uma vista clara do conjunto creme | Sequência na sala |
| Cena do apartamento | Cômodo sem personagens concorrentes | Tomadas que precisam daquele ambiente |
| Quadro inicial aprovado | Iris, roupa escolhida e composição final juntas | Imagem para vídeo naquela configuração exata |
Podem ser arquivos comuns. Faça RefMods apenas das partes reutilizadas repetidamente num fluxo local compatível. Não há benefício em criar um conjunto permanente para um objeto usado uma só vez.
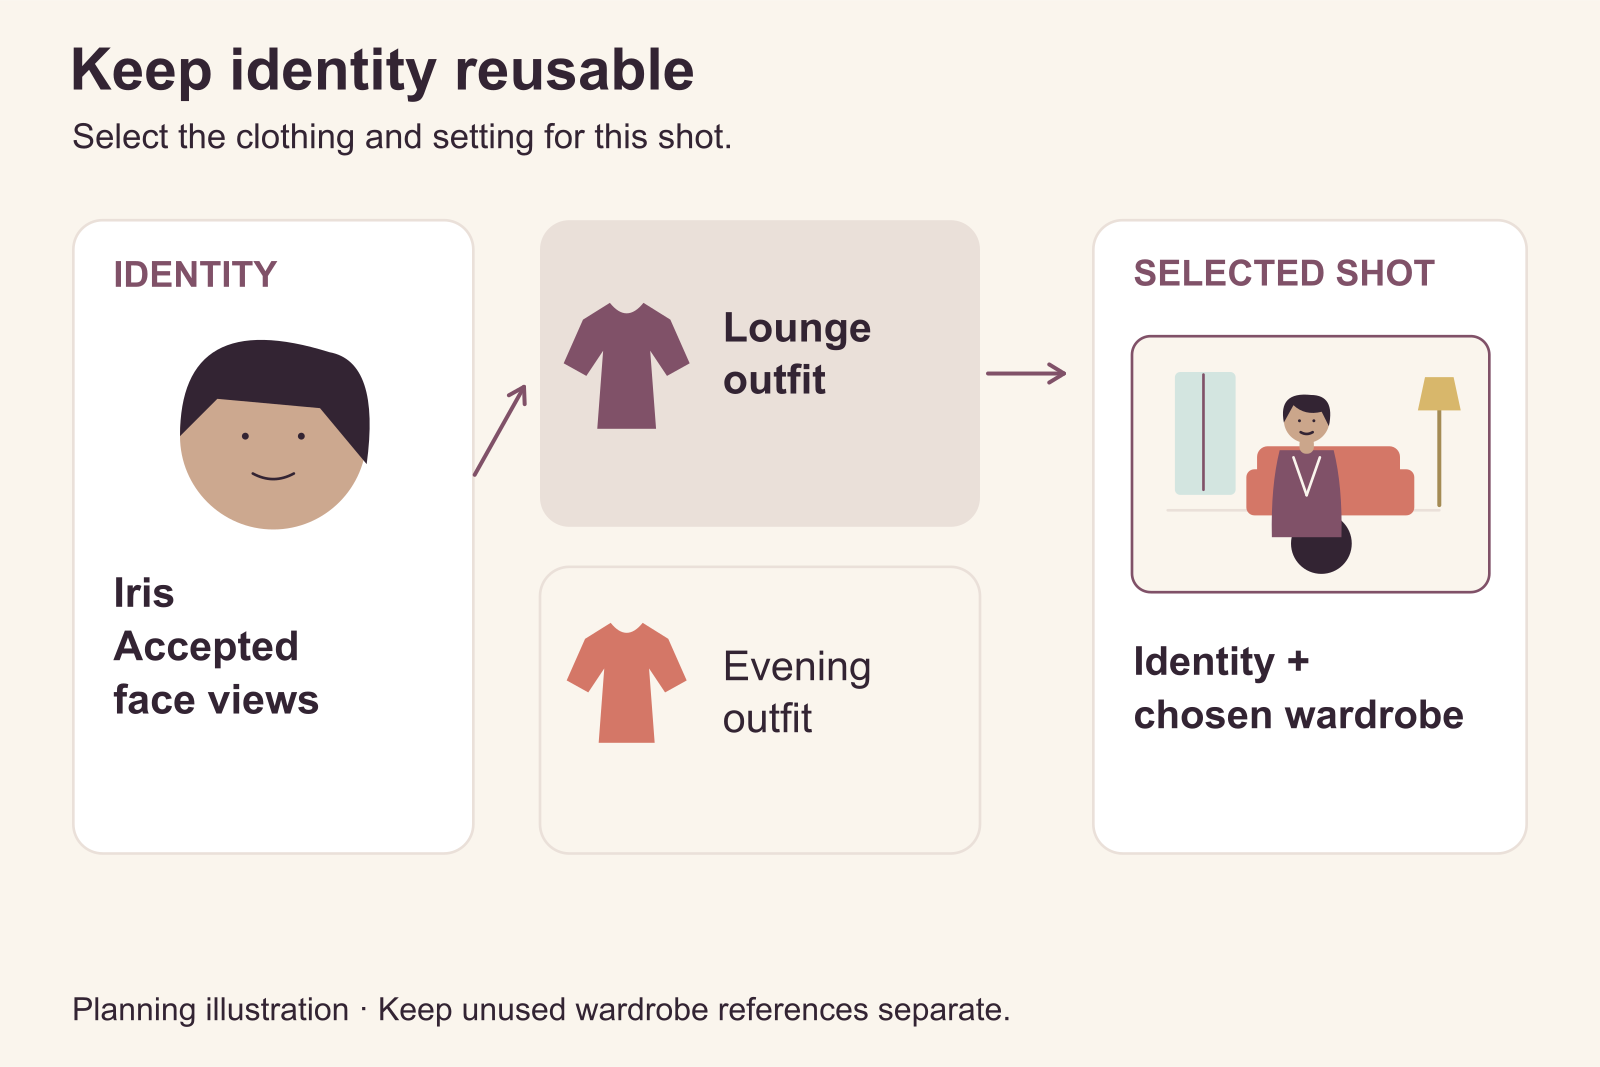
Ilustração: mantenha a identidade recorrente reutilizável e escolha roupa e ambiente por tomada.
Dê à roupa nova uma fonte clara
Para uma cena com roupa nova, mantenha as mesmas duas imagens de identidade e adicione a roupa como Picture 3. Prefira uma fonte só da peça ou recorte que mostre a roupa claramente sem apresentar outro rosto como identidade concorrente.
Picture 1 e Picture 2 definem Iris, a mesma mulher adulta fictícia de 32 anos. Picture 3 define a roupa creme de ficar em casa para esta cena. Mostre Iris sentada numa poltrona junto a uma luminária quente, usando essa roupa. Preserve o rosto de Pictures 1 e 2. Ela apoia uma mão no braço da cadeira e olha lentamente para a janela. Plano médio com rosto visível. Áudio: ambiente discreto do cômodo.
Se a imagem de roupa inclui outra pessoa, identifique sua função com especial clareza. Melhor ainda, remova o rosto dessa pessoa da referência de roupa quando puder fazer isso sem perder detalhes úteis da peça.
Quando a roupa antiga continuar voltando, faça primeiro uma imagem editada com a nova. Depois que rosto e roupa estiverem certos juntos, anime a imagem aprovada. Isso transfere a decisão disputada de figurino para uma imagem estática que pode examinar diretamente.
Essa abordagem pode ser mais fácil de gerenciar que pedir repetidamente a um vídeo de cinco segundos para resolver identidade, construção da roupa e movimento de uma vez. Também produz um quadro inicial reutilizável para vários clipes curtos da mesma sequência de roupa.
Um redesenho permanente de personagem precisa de um novo conjunto de referências aprovado; mantenha-o separado da versão antiga para ainda reproduzir episódios anteriores. Uma identidade revisada pode justificar treinar LoRA novamente. Um vestido novo costuma pedir primeiro referência de roupa ou quadro inicial preparado.
Dois personagens precisam de funções explícitas
Dois RefMods não criam automaticamente duas pessoas controladas independentemente. Dois LoRAs de personagem também não reservam automaticamente metade do quadro para cada identidade.
O modelo precisa resolver quem está presente, qual informação pertence a cada pessoa e o que cada uma faz. Isso fica difícil quando ambas as referências compartilham penteado, roupa e descrição facial ou quando o prompt usa frases vagas como “ela se vira para ela”.
Introduza outro personagem adulto fictício, Alex, de 35 anos. Dê a Alex um cabelo curto visivelmente diferente e uma referência separada. Essas diferenças ajudam a descrever a tomada; não substituem uma fonte válida de identidade.
Para referências comuns, uma primeira disposição simples é:
- Pictures 1 e 2: frente e três quartos de Iris.
- Pictures 3 e 4: vistas correspondentes de Alex.
- Cômodo e roupa: descritos em texto, a menos que uma referência separada seja necessária.
Depois escreva a relação entre referências e cena:
Pictures 1 e 2 mostram Iris, uma mulher adulta fictícia de 32 anos. Pictures 3 e 4 mostram Alex, um homem adulto fictício de 35 anos. Iris fica à esquerda com vestido de noite cinza-chumbo; Alex fica à direita com camisa escura de gola aberta. Trocam um sorriso discreto junto a uma janela do apartamento. Iris se vira para Alex enquanto Alex continua olhando para Iris. Plano médio dos dois, ambos os rostos visíveis, câmera parada. Áudio: ambiente suave de noite no cômodo.
As posições esquerda/direita reduzem ambiguidade nesta composição simples. Nomes substituem pronomes ao descrever a ação. A câmera fica parada para a primeira tomada não exigir também que as pessoas cruzem, troquem posições na tela e virem juntas.
Para RefMods locais, use os rótulos mostrados no mapa atual de referências. Um RefMod de múltiplas imagens pode aparecer como referência de vídeo, não de imagem; não adivinhe o número pelo nome do arquivo nem copie números de um prompt antigo depois de reordenar a pilha.
O guia oficial de prompts de referência H3 separa sujeitos visíveis dos recursos de mídia que os fornecem. A diferença é útil aqui: Iris é o sujeito; imagem ou vídeo é a fonte de informações sobre Iris. Permite descrever seu lugar na nova tomada sem pedir ao modelo que reproduza a cena inteira da fonte.
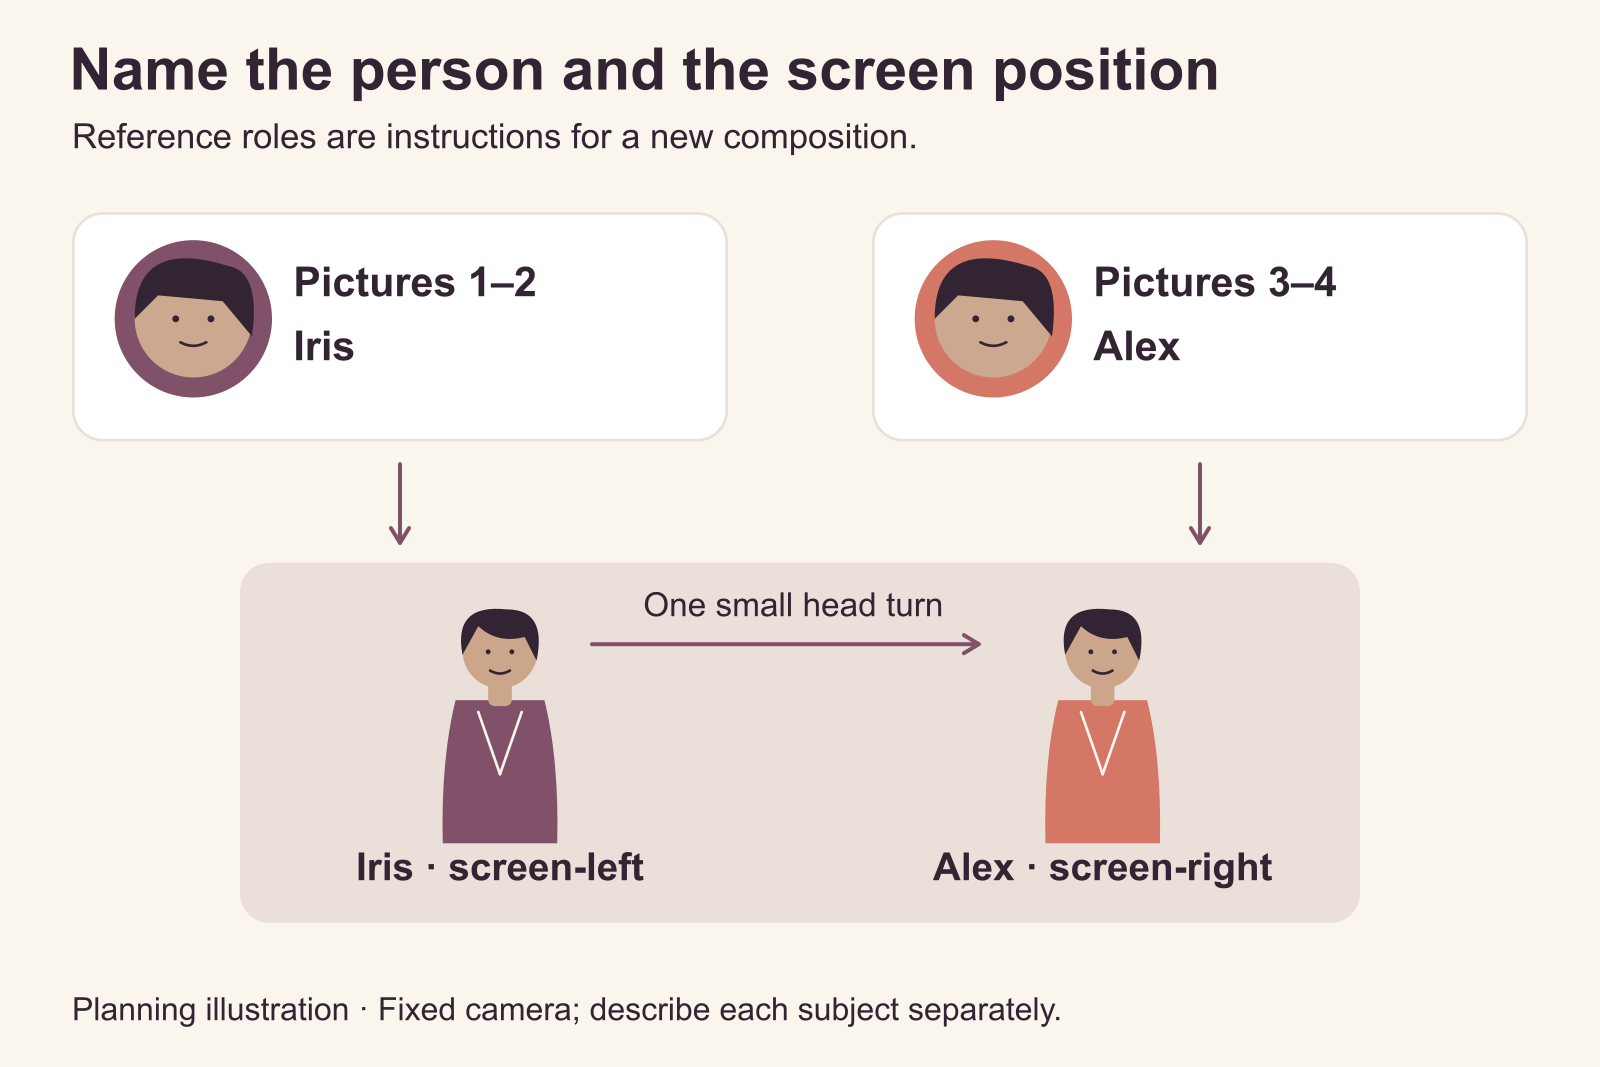
Ilustração: atribua separadamente imagens de origem, pessoa e posição na tela.
Se os rostos se misturarem, simplifique a composição primeiro
Quando Alex herda o cabelo de Iris ou Iris ganha o formato facial de Alex, comece verificando se fontes e rótulos do prompt correspondem. Uma imagem atribuída incorretamente pode parecer falha de qualidade de identidade.
Se os rótulos estiverem certos, facilite os papéis visuais: mantenha ambos os rostos visíveis, use posições separadas e evite cruzamentos na primeira tomada conjunta. Remova uma referência de roupa que contenha um terceiro rosto reconhecível. Se o par funcionar separadamente, mas se misturar repetidamente, prepare um quadro inicial a dois com as duas identidades aprovadas e anime uma interação contida.
Você também pode mudar a edição. Alterne tomadas individuais e planos sobre o ombro, em vez de forçar cada momento narrativo numa tomada móvel a dois. É uma escolha prática de produção quando a cena precisa mais de continuidade convincente que da presença contínua dos dois rostos.
Nenhuma mudança garante uma interação difícil. Elas tratam fontes específicas de ambiguidade antes de investir tempo na criação de mais recursos de identidade.
Separe identidade vocal de identidade visual
Uma personagem consistente visualmente, mas com voz diferente em cada episódio, ainda parece diferente. Porém, salvar áudio junto a um RefMod visual não estabelece uma ligação confiável entre voz e rosto.
As notas de validação do projeto RefMod registram transferência malsucedida de identidade de falante e cobertura incompleta de geração. Trate referências de áudio como capacidade separada a avaliar no fluxo realmente usado.
Para a primeira sequência visual de Iris, som ambiente basta. Se uma voz falada estável for essencial à série, planeje um fluxo separado de voz e diálogo, em vez de escolher RefMods supondo que um arquivo combinado já resolva isso. Um LoRA treinado de personagem visual tampouco comprova uma voz treinada.
Quando treinar um LoRA de personagem justifica o investimento
Treinar faz sentido quando a identidade está definida e você precisa de algo mais específico que selecionar referências com facilidade.
Três situações justificam considerar seriamente:
- Você quer produzir a personagem por texto para vídeo com adaptador compatível, em vez de fornecer uma coleção grande de referências em toda tomada.
- Precisa de estilo ou comportamento recorrente aprendido que referências comuns não expressaram adequadamente.
- Já tem uma configuração de produção baseada em LoRA funcionando e quer a personagem disponível nela.
“Estou fazendo uma série” sozinho não basta. Dez clipes de retrato cuidadosamente compostos podem ser bem atendidos por quadros iniciais aprovados. Uma série muito maior pode justificar treinamento, mas apenas se o adaptador resultante reduzir trabalho real ou acrescentar uma capacidade necessária.
Treine para o fluxo em que o adaptador será executado
H3 não é um único arquivo de pesos intercambiável. Os caminhos FL2VA e Ref2VA precisam de escolhas deliberadas de compatibilidade. A documentação Ref2VA do AI Toolkit identifica pesos Ref2VA separados e um adaptador de treinamento correspondente. Não suponha que um nome H3 no arquivo comprove compatibilidade com toda tarefa hospedada ou checkpoint local.
Antes de preparar o treinamento, decida se a saída principal será texto para vídeo, animação com quadro inicial ou vídeo condicionado por referências. Informe a tarefa pretendida a quem configura o treinador. Uma receita impressionante num grafo de inferência não vira automaticamente um recurso pronto para outro.
Use as instruções H3 atuais do treinador, em vez de copiar taxa de aprendizado e passos de um tutorial bem-sucedido de Wan ou modelo de imagem. A documentação H3 atual do Musubi suporta várias tarefas de treinamento e abordagens distintas de preservação do comportamento-base. Essas escolhas afetam o que o adaptador aprende e o que pode perturbar.
Prepare um dataset que ensine a personagem, não uma fotografia
Para Iris, a coleção útil mostra sua identidade na variação exigida pela série. Deve incluir rostos legíveis em ângulos relevantes, algum enquadramento mais amplo se proporções importarem e mais de uma roupa e configuração de luz.
Não fabrique variedade incluindo versões inconsistentes de Iris. Vinte imagens da mesma pessoa aprovada são material mais coerente que vinte imagens bonitas que gradualmente mudam nariz e mandíbula. Da mesma forma, dezenas de recortes quase iguais de um retrato não fornecem o perfil ausente.
Descreva nas legendas o que muda: roupa, enquadramento, expressão e cena. Mantenha a nomeação de identidade consistente com o método do treinador. Numa receita com palavra de ativação, uma legenda pode ser tão simples quanto:
irisvale, mulher adulta fictícia de 32 anos, retrato de três quartos, blusa de malha creme, expressão relaxada, luz suave da janela, fundo interno simples.
É um exemplo de legenda, não um comando universal de treinamento H3. Alguns métodos tratam deliberadamente a informação de identidade de outra forma. Siga o método escolhido, em vez de combinar orientações de receitas incompatíveis.
Se o alvo é identidade facial, não acrescente clipes de movimento sem relação só porque o treinador aceita vídeo. Se um movimento marcante importa, escolha clipes que o mostrem claramente mantendo a pessoa reconhecível. Imagens estáticas e vídeo fornecem informações diferentes; adicionar vídeo também acrescenta preparação e treinamento.
Observe o tipo errado de sucesso
Uma amostra pode se parecer com Iris e ainda ser um adaptador ruim para produção. Alertas incluem o mesmo fundo em prompts sem relação, roupa antiga que retorna ao aumentar intensidade, movimento rígido ou falha em seguir uma nova direção de câmera.
A correção nem sempre é mais treinamento. Se checkpoints posteriores ficarem mais reconhecíveis, mas menos flexíveis, um anterior pode ser mais útil. Se todas as amostras reproduzirem o fundo de treinamento, o dataset pode ser específico demais. Se o adaptador não mudar nada em nenhuma intensidade sensata, investigue compatibilidade e carregamento antes de gastar outra noite com legendas.
Uma outra discussão da comunidade sobre treinamento de personagem H3 descreve essa troca exata: alguns encontraram semelhança fraca, enquanto outro relatou semelhança mais forte acompanhada de pior movimento, artefatos ou seguimento de instruções. Também inclui relatos positivos de RefMod e referências decepcionantes. Não há um vencedor universal honesto nesses relatos.
Você pode combinar um LoRA compatível com referências comuns. O adaptador fornece uma tendência aprendida; a imagem aprovada fornece rosto, roupa ou composição atuais. A combinação é útil quando cada componente tem função clara; não é motivo para aumentar todos os controles de intensidade disponíveis.
Tempo de preparação e pelo que você realmente paga
Referências comuns têm menor esforço inicial quando as fontes já existem. O trabalho é escolher arquivos consistentes e atribuir funções. RefMods acrescentam instalação e extração, depois reduzem manuseio repetido. LoRAs acrescentam preparação de dataset, treinamento, seleção de checkpoint salvo e verificações de compatibilidade.
O tempo de preparação depende de hardware, quantidade de fontes, resolução e método de treinamento. A tentativa comunitária de cinco horas acima descreve aquela execução específica; use treinador e hardware pretendidos para estimar uma sessão.
| Custo | Referências comuns | RefMod | LoRA treinado |
|---|---|---|---|
| Trabalho criativo inicial | Imagens de identidade e vistas úteis | A mesma preparação de fontes | Dataset selecionado, muitas vezes com mais variação |
| Preparação extra | Selecionar e ordenar entradas | Instalar, codificar e examinar o recurso salvo | Configurar e executar treinamento; escolher checkpoint utilizável |
| Trabalho repetido | Recarregar arquivos ou preset salvo | Carregar o conjunto salvo | Carregar pesos compatíveis e sua ativação/configurações |
| Custo de geração | Depende do endpoint e das cobranças de referência | Computação local ou alugada; referências retidas ainda têm custo | Custo de geração e política de adaptador específica do host |
| Custo de revisão | Trocar uma fonte | Atualizar o recurso | Possível novo treinamento se a identidade aprendida precisar mudar |
Preços hospedados são separados dos custos locais de RefMod
As páginas H3 atuais da SpicyAPI aceitam mídia comum de referência; suas páginas LoRA também aceitam pesos LoRA compatíveis. Não expõem campo de upload RefMod. Um arquivo RefMod .safetensors não substitui um LoRA no campo loras. Guarde as fontes se quiser usar a mesma personagem numa rota hospedada.
Para um quadro inicial já aprovado, H3 LoRA de imagem para vídeo custa $0.05 por segundo de saída em 480p e $0.10 em 768p. Um clipe de cinco segundos custa, portanto, $0.25 ou $0.50. Carregar LoRA não acrescenta tarifa separada nessa tarefa. Quatro gerações de cinco segundos custam $1.00 ou $2.00, respectivamente; são quatro saídas, não promessa de quatro clipes aproveitáveis.
Referência para vídeo tem outra cobrança. A tarefa H3 comum cobra $0.0068 por referência de imagem, além dos segundos de saída. H3 LoRA de referência para vídeo cobra $0.02 por imagem. Aqui estão estimativas completas de cinco segundos com apenas referências de imagem estática. O H3 comum não oferece mais 480p, por isso essas células mostram um traço:
| Solicitação de cinco segundos | 480p | 768p |
|---|---|---|
| H3, duas imagens de identidade | — | $0.1986 |
| H3, duas imagens de identidade e uma de roupa | — | $0.2054 |
| H3 LoRA, duas imagens de identidade | $0.34 | $0.715 |
| H3 LoRA, duas imagens de identidade e uma de roupa | $0.36 | $0.735 |
Por exemplo, H3 comum em 768p com duas imagens custa 5 × $0.037 + 2 × $0.0068 = $0.1986. Dez gerações totalizam $1.986. As solicitações correspondentes de referência H3 LoRA totalizam $7.15 em 768p. Escolha entre elas pelo registro de conteúdo adulto da tarefa específica, entradas necessárias e pesos compatíveis. Uma personagem aparecer em vários episódios não exige por si só a rota LoRA.
Na tarefa LoRA de referência, segundos dos vídeos de referência também entram nos segundos cobrados, e referências de áudio acrescentam uma tarifa própria por referência. Um RefMod local salvo não contorna esses tipos ou preços de entrada hospedada. Mantenha curta a referência de movimento e use-a apenas quando contribuir com algo ausente das imagens e do prompt.
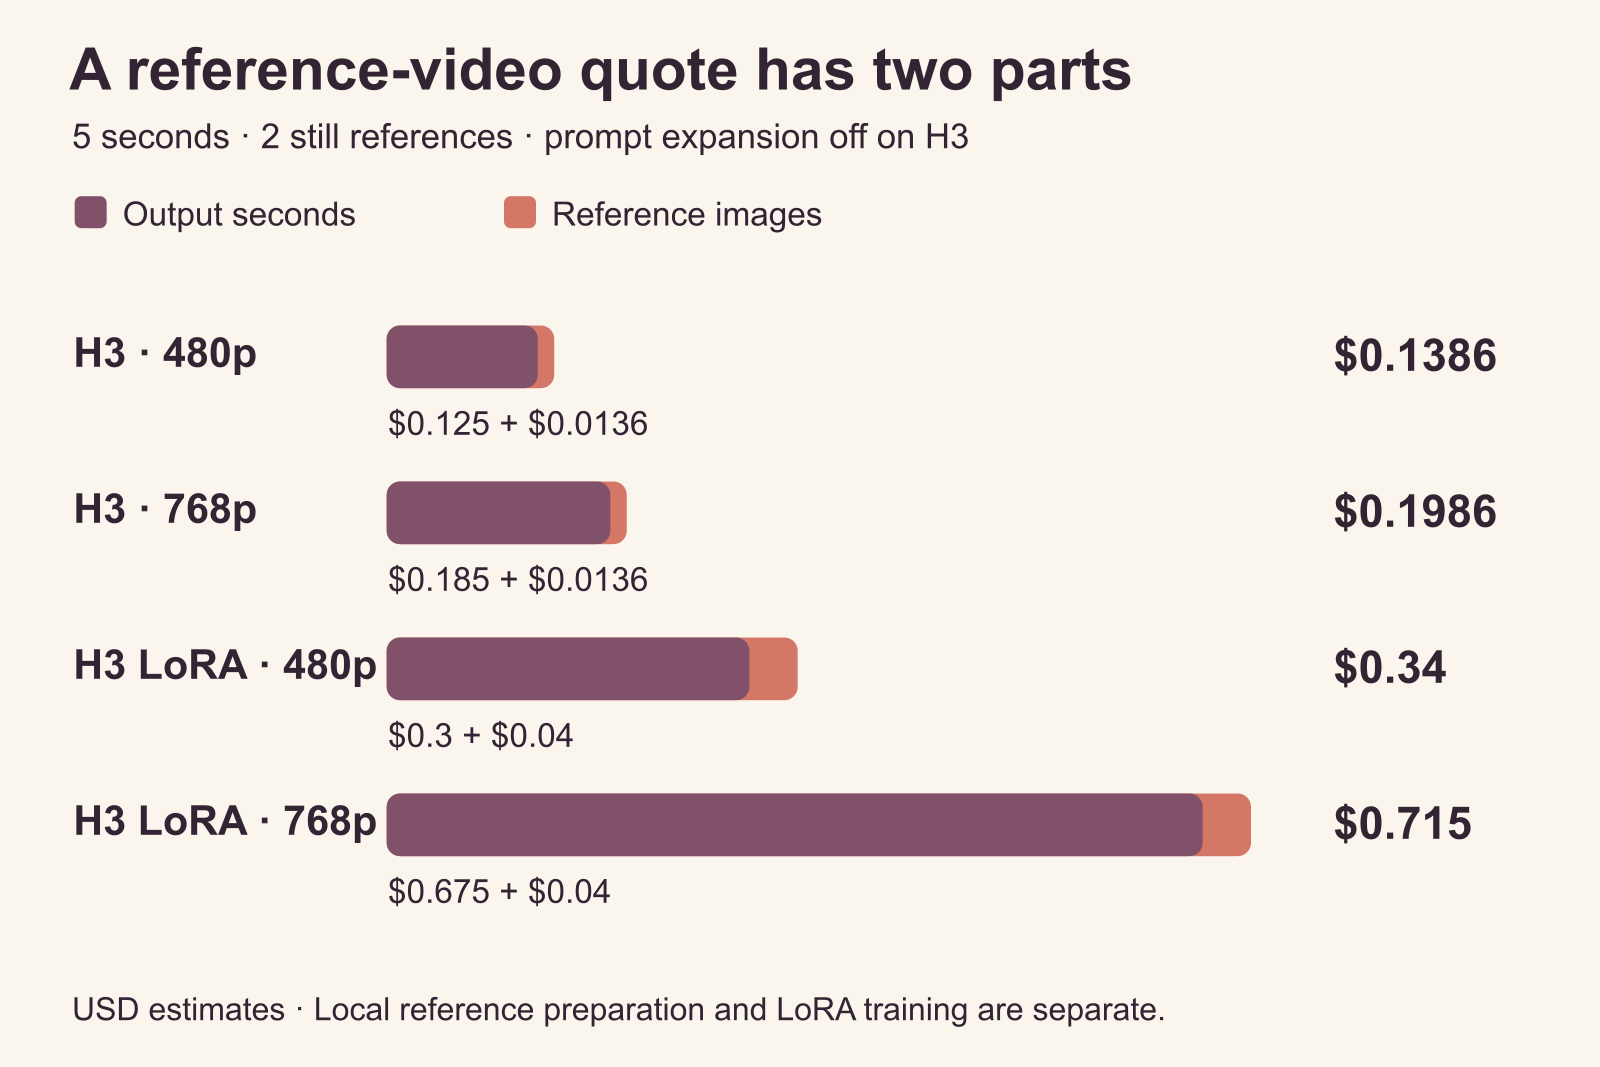
As estimativas de geração de cinco segundos incluem as duas referências estáticas. Preparação de referências e treinamento LoRA são custos separados.
Decida se treinar poupa trabalho repetido suficiente
A conta de treinamento é apenas parte da decisão. Inclua preparação das fontes, aluguel de GPU, amostras intermediárias e tempo gasto corrigindo saídas incompatíveis. Um preço baixo de GPU não é bom negócio se o adaptador nunca entregar uma personagem utilizável.
Para poucos clipes, mantenha referências, a menos que já tenha um adaptador adequado. Para produção frequente, identifique a despesa que o treinamento deve reduzir: seleção repetida, cobranças repetidas de imagem, inferência lenta com muitas referências ou incapacidade de alcançar uma aparência aprendida específica.
RefMods tratam principalmente seleção e preparação repetidas. Um LoRA pode tratar outros problemas, mas só depois de funcionar na rota pretendida de geração. Não compre treinamento para resolver um problema de organização já resolvido por um preset salvo de referências.
Conte também as saídas bem-sucedidas honestamente. Se pagar por seis gerações concluídas e usar duas, o gasto por resultado aproveitável é três vezes a cobrança por saída. A conta se aplica aos três métodos. Preparação melhor de fontes ou tomada mais simples pode importar mais que escolher o segundo de vídeo anunciado mais barato.
Erros comuns e a próxima mudança útil
| O que você vê | O que conferir primeiro | Mudança a fazer |
|---|---|---|
| Frente reconhecível; a virada revela outra pessoa | Referências mostram o ângulo revelado? | Adicione perfil aprovado ou reduza a virada |
| Roupa original continua voltando | Toda fonte de identidade a inclui? | Substitua uma fonte, separe a roupa ou prepare outro quadro inicial |
| RefMod tem miniatura certa, mas pouco detalhe facial | Recorte e representação armazenados | Reconstrua com recorte mais claro e base Full de identidade |
| Personagem salvo ignora o próprio nome | Prompt aponta ao rótulo real de mídia? | Atribua o sujeito ao rótulo mostrado no mapa atual |
| Dois personagens se misturam | Ordem das entradas, funções e rostos extras | Corrija rótulos, remova rostos concorrentes e comece com plano estático a dois |
| LoRA carrega, mas não faz diferença útil | Compatibilidade de base, tarefa e carregador | Confirme a rota pretendida de inferência antes de treinar novamente |
| Semelhança melhora, mas movimento desaba | Intensidade do adaptador e checkpoint | Reduza influência ou use um checkpoint anterior utilizável |
| Cômodo novo continua virando o antigo | Informação do cômodo ainda está carregada? | Remova totalmente a referência do cômodo antigo |
| Rosto permanece estável, mas voz muda | Existe solução separada de voz? | Trate identidade de diálogo como tarefa própria de produção |
Altere a entrada mais diretamente ligada ao traço indesejado. Roupa indesejada é motivo para revisar a fonte de roupa antes de mudar checkpoint, amostrador e conjunto inteiro de referências.
Para continuar, o guia de API H3 LoRA cobre carregamento de um adaptador existente e escolha da tarefa. A comparação de versões H3 explica as variantes do produto. São decisões separadas da necessidade de treinar seu personagem recorrente.
Escolha para o próximo episódio
Para o próximo episódio de Iris, selecione o retrato aprovado e a vista alternativa necessária à tomada, escolha uma tarefa adequada à cena adulta pretendida e faça um clipe de cinco segundos. Salve um RefMod quando repetir a preparação das fontes virar o problema. Treine um LoRA compatível quando a série precisar de uma capacidade aprendida ou rota de execução que as referências não forneçam. Deixe a próxima necessidade real de produção determinar o investimento.