Un personnage adulte récurrent doit être reconnaissable dans l’épisode suivant, pas seulement dans son portrait de présentation. Une fois le visage choisi, la décision MiniMax H3 RefMods ou LoRA concerne le travail à répéter lorsque tenue, angle de caméra ou autre personne change.
Commencez par des images de référence ordinaires. Enregistrez un RefMod si vous travaillez déjà dans ComfyUI et réutilisez souvent ces images. Envisagez une LoRA si vous avez besoin d’un personnage ou style appris que votre workflow de références ne fournit pas efficacement. Un RefMod regroupe les informations de référence ; il n’entraîne pas le personnage dans H3. Une LoRA demande un entraînement, sans produire automatiquement une meilleure ressemblance.
Pour une nouvelle identité adulte fictive, préparer quelques vues cohérentes est généralement le premier investissement utile. Pour une série hebdomadaire établie, une bibliothèque évite de répéter la préparation. L’entraînement devient plus raisonnable lorsque le personnage est stable et que vous pouvez nommer la limite précise à résoudre.
Pour une série NSFW, l’identité dépasse le portrait : proportions, teint et marques distinctives peuvent devoir rester reconnaissables entre gros plans intimes et scènes adultes plus larges. Les tâches de référence-vidéo présentées ont des relevés de contenu différents : H3 ordinaire documente le rendu d’imagerie NSFW modérée, tandis que H3 LoRA documente des scènes adultes plus intenses. Ces observations propres aux tâches ne comparent pas RefMods et ne garantissent pas chaque scène ; choisissez séparément gestion d’identité et capacité de contenu.
| Votre situation | Point de départ | Raison |
|---|---|---|
| Une scène terminée à transformer en court clip | Image-vidéo | Composition et tenue existent dans la première image |
| Même personnage dans une nouvelle pièce ou tenue | Référence-vidéo ordinaire | Changer les ingrédients sans reconstruire une ressource enregistrée |
| Mêmes références chargées souvent dans ComfyUI | RefMod | Réutiliser un ensemble organisé |
| Personnage disponible depuis le texte dans un workflow H3 compatible | LoRA de personnage entraînée | L’identité apprise peut être intégrée à un adaptateur |
| Deux personnages nommés dans un plan | Références séparées pour chacun | Attribuer explicitement identités et places avant la complexité |
| Style ou mouvement récurrent distinctif | LoRA adaptée ou référence pertinente | Choisir pour cette tâche ; adaptateur de personnage n’est pas automatiquement adaptateur de mouvement |
Les exemples utilisent Iris, personnage fictif de 32 ans dans une série adulte de portraits et vidéos. Ce sont des briefs pratiques initiaux, pas de nouveaux résultats de comparaison.
Ce que chaque méthode économise réellement
Une référence ordinaire est une image ou un média accepté fourni pour générer. Vous le choisissez à nouveau ou le rechargez via le workflow enregistré pour le plan suivant. Elle ne devient pas une connaissance permanente du modèle. Nommer « Iris » dans dix prompts ne crée pas non plus d’identité persistante.
Un RefMod transforme les références en fichier réutilisable pour des workflows H3 compatibles. Le projet RefMod original explique que l’extraction stocke les représentations VAE sans entraîner les poids H3. Le mode Full conserve davantage ; Compressed échange des détails contre moins de tokens de référence. Le nom interne historique training désigne le raffinement d’un latent compressé, pas l’entraînement LoRA. Vêtements, identité et fond peuvent encore voyager ensemble.
Une LoRA est un adaptateur entraîné : des modifications apprises utilisées avec le modèle de base. L’article LoRA original décrit le principe d’adaptation de faible rang. Pour H3, vous devez préparer des exemples et produire des poids réellement chargeables par votre workflow. Enregistrer des photos en RefMod et ajuster une LoRA résout des problèmes distincts, même si les deux fichiers finissent en .safetensors.
| Question | Références ordinaires | RefMod | LoRA entraînée |
|---|---|---|---|
| Que préparer ? | Images ou médias choisis | Médias choisis et workflow d’extraction compatible | Dataset sélectionné et entraîneur |
| Que réutiliser ? | Originaux et rôles de prompt | Représentations de références enregistrées | Poids appris de l’adaptateur |
| Remplacer une mauvaise source ? | Remplacer l’image | Reconstruire ou modifier l’ensemble | Revoir le dataset et réentraîner si le défaut a été appris |
| Générer sans références ? | Non | Non ; elles conditionnent toujours la génération | Potentiellement, selon adaptateur et tâche |
| Même personne garantie ? | Non | Non | Non |
| Format universel de téléversement H3 ? | Seulement les médias acceptés par l’endpoint | Non | Seulement des poids LoRA compatibles avec le chargeur |
Cette distinction compte si la ressource déçoit. Renommer un RefMod contenant un profil incohérent ne corrige pas le visage. Si une LoRA apprend Iris avec un costume précis, une nouvelle tenue peut entrer en concurrence avec cette association. La préparation influence les deux résultats ; la réparation intervient à une autre étape.
Vous pouvez aussi rencontrer RefLoRA. Le projet RefLoRA regroupe poids LoRA entraînés et références RefMod dans un fichier. Un chargeur normal utilise les poids ; un chargeur combiné compatible peut utiliser les deux. Ce regroupement ne supprime pas l’entraînement préalable et un service hébergé ne lit pas automatiquement la partie références. Identifiez contenu et chargeur plutôt que choisir selon l’extension.
Définissez d’abord ce qui reste identique
Pour Iris, limitez l’identité récurrente : femme adulte de 32 ans, carré auburn court, sourcils larges, nez droit et forme de visage reconnaissable. Ce sont les constantes. Tenue de soirée noire, ensemble crème, lumière de chambre et distance caméra sont des choix de plan.
Cette séparation évite une erreur coûteuse : préserver toute la première image alors que la série demande des changements. Une photo de référence contient personne, vêtements, pose, lumière et pièce. « Gardez Iris cohérente » est clair pour un humain, mais les entrées doivent préciser ce qui appartient à Iris ou à l’épisode.
Pour sa série adulte, utilisez différentes références pour différents besoins de reconnaissance :
| Ce que reconnaît le public | Source utile | Ce qui peut changer |
|---|---|---|
| Visage, sourcils et ligne de cheveux | Portrait clair et angle de rotation validé | Expression, regard, maquillage |
| Carrure et proportions relatives | Vue plus large validée avec épaules, taille et posture lisibles | Pose, distance caméra, tenue |
| Petit tatouage récurrent sur l’épaule | Vue claire du design réel et de sa place | Éclairage et visibilité dans le cadrage |
| Style d’un ensemble précis | Tenue et coiffure choisies | Style de l’épisode suivant |
Un visage recadré ne définit pas les proportions dans une scène large. Une vue lointaine en pied peut montrer la posture mais peu de détails faciaux. Si le tatouage change, ajoutez une source claire de ce détail plutôt qu’augmenter toutes les forces. Si sa place exacte est essentielle, fixez-la dans l’image initiale avant animation. La même division sert aux portraits, séquences de salon ou scènes plus matures ; le plan détermine les informations visibles nécessaires.
Préparez un petit dossier à trois types de matériaux :
- Vues d’identité : portrait clair, trois-quarts et profil acceptés comme même personne.
- Exemples de tenue : image de chaque tenue récurrente, séparée si possible de l’identité.
- Images de scène : pièce vide ou début accepté pour un plan précis.
C’est une organisation de travail, pas une taille obligatoire de dataset. Un portrait calme peut nécessiter seulement la première image. Une rotation bénéficie d’une vue acceptée des traits révélés. Une pièce n’a pas de rôle utile dans une référence faciale proche si elle change chaque semaine.
Pour choisir l’identité, comparez mâchoire, nez, sourcils et ligne de cheveux avant la beauté. Un portrait généré plus séduisant peut représenter la mauvaise personne. Le rejeter maintenant coûte moins d’effort que construire un ensemble autour de visages contradictoires.
Distinguez aussi trait permanent et style. Si Iris attache parfois ses cheveux, son visage doit rester reconnaissable sans dépendre entièrement du carré. Si un accessoire change avec la tenue, n’en faites pas l’unique différence avec un autre personnage.
La même logique vaut pour les images matures. Une source n’a pas à reproduire l’intensité ou la composition de toutes les scènes futures. Choisissez les références pour une identité lisible et une route adaptée pour la scène. Ni regroupement ni entraînement ne définit les demandes adultes qu’un endpoint satisfera.
Références ordinaires : le meilleur départ d’une série
Elles servent quand le personnage est encore en cours de définition, la tenue change souvent ou vous voulez un Playground hébergé sans maintenir ComfyUI.
Elles rendent aussi les erreurs visibles. Vous voyez les images exactes, retirez celle qui crée un conflit et lancez le plan suivant. Cette simplicité vaut avant stabilisation. Un ensemble enregistré complexe peut cacher une image faible.
Construisez cinq secondes depuis deux vues d’identité
Utilisez le portrait de face d’Iris comme Picture 1 et le trois-quarts accepté comme Picture 2. Décrivez le lieu dans le brief écrit pour ce premier plan ; les deux références n’ont qu’un rôle : la personne.
La tâche hébergée MiniMax H3 référence-vidéo accepte jusqu’à neuf références et produit 4–15 secondes. Commencez par cinq secondes en 768p, portrait 9:16 : $0.1986 avec ces deux images. Passez à plus grand lorsque la direction mérite d’être gardée.
Picture 1 et Picture 2 montrent la même femme adulte fictive, Iris, âgée de 32 ans. Utilisez-les pour identité faciale, carré auburn court et proportions. Iris porte une robe de soirée en satin anthracite. Elle est assise près d’une lampe de chevet chaude dans un appartement calme, puis tourne lentement le visage depuis un trois-quarts vers la caméra. Plan moyen rapproché, caméra à hauteur des yeux, expression douce, cadre stable. Gardez le visage clairement lisible pendant la rotation. Audio : douce ambiance de pièce.
Les références ont une tâche et le texte une autre. Vous ne demandez pas de garder ancien fond et ancienne tenue tout en inventant une pièce. La petite rotation définit aussi une action sans plusieurs poses.
Si les sources portent déjà la robe anthracite et vous voulez la garder, dites-le. Si l’une porte une veste, précisez la robe de sortie. Si la veste revient, remplacez ou recadrez cette source plutôt qu’ajouter un paragraphe sur la robe.
Utilisez une image initiale si la scène est déjà correcte
Supposons une composition déjà créée : Iris en ensemble crème, près de la lampe, avec bonne expression et pièce. Image-vidéo est la suite directe. Elle part de cette image acceptée ; référence-vidéo reconstruit un plan depuis des ingrédients.
Une consigne adaptée est :
Iris, la femme adulte fictive de l’image initiale, lève doucement le regard vers la caméra et sourit légèrement et naturellement. Ses épaules restent à la même place. La caméra se rapproche très légèrement et lentement. La lampe reste stable. Audio : ambiance intérieure calme.
La différence pratique concerne où placer l’effort. Utilisez les références pour composer, l’image initiale lorsque seule l’animation reste. Entraîner une LoRA simplement pour animer une image finie ajoute un autre projet avant le besoin immédiat.
Une image initiale ne garantit pas la perfection des suivantes. Si une grande rotation révèle un profil inconnu, raccourcissez-la ou préparez un meilleur angle. Résolvez ce choix de plan avant de considérer la méthode d’identité entière comme un échec.
RefMods : quand la préparation devient répétitive
Ils deviennent intéressants lorsque le personnage vous convient, ComfyUI est déjà utilisé et vous reconstruisez sans cesse la même collection. L’économie est organisationnelle autant que computationnelle : une ressource nommée remplace sélection et préparation répétées.
Le fichier enregistré et le workflow qui le consomme sont distincts. Différents nœuds H3 présentent les références différemment. Une réussite dans un graphe ne prouve pas le même personnage pour tous les chargeurs.
Le Fantastic H3 Prompt Builder d’Adudeguyman ajoute gestionnaire de références et éditeur de prompt. Sa carte montre les étiquettes des entrées réelles. Les versions récentes stockent des images d’encodeur et proposent expérimentalement le nombre d’images vues par l’encodeur textuel. Davantage peut augmenter mémoire et temps. Ce sont des contrôles de workflow, pas une garantie d’identité.
Créez une ressource Iris réutilisable
Le guide RefMod du projet fournit installation et instructions des nœuds. La séquence utile est :
- Partir d’un workflow H3 de références fonctionnel avec son VAE correspondant.
- Ouvrir la création dans la bibliothèque RefMod et ajouter les images Iris validées.
- Inspecter les aperçus de recadrage. La première image détermine la forme de l’ensemble ; ajuster les sources perdant visage ou cheveux.
- Choisir Full comme base d’identité, nommer le personnage et créer l’ensemble.
- Ajouter la ressource enregistrée à la pile. Lire la carte de références avant de rédiger le rôle du sujet.
Gardez aussi les sources originales. La référence sauvegardée est pratique, mais le dossier permet de retirer une vue incorrecte, préparer un autre cadre ou changer d’application.
Ne regroupez pas toute l’histoire d’Iris dans une ressource maître. L’ensemble utile doit s’expliquer simplement : « les vues validées d’Iris ». Pas « trois pièces, quatre costumes, ancienne coupe et deuxième personnage apparu une fois ».
Inspectez le stockage avant d’accuser la génération
Recadrage et compression peuvent retirer le trait à conserver. Une miniature dans un navigateur de fichiers ne prouve pas que la référence stockée contient tout le portrait au détail attendu.
Si l’original a un visage clair mais l’aperçu un visage doux, étroit ou coupé, améliorez la ressource d’abord. Pour des portraits, un petit ensemble clair est un meilleur départ qu’un gros dont les détails importants ont été réduits.
Full et Compressed sont utiles, mais « petit fichier » ne signifie pas « conditionnement gratuit ». Il contribue encore à la génération. Inversement, garder plus de détails peut conserver une pièce ou tenue indésirable avec le visage. Sélectionnez l’information avant de régler la force.
Pour Iris, gardez une identité et une pièce facultative séparées. Chargez seulement ce que le plan nécessite. Dans un autre appartement, retirez entièrement l’ancien lieu. Baisser sa force est indirect s’il n’a aucun rôle.
Pourquoi les expériences communautaires se contredisent
Dans une discussion d’entraînement H3 de personnage, l’auteur rapportait environ cinq heures d’entraînement sur RTX 5090 sans ressemblance satisfaisante. Des réponses louaient RefMods ; d’autres signalaient moins de ressemblance ou plus de temps que leurs références ordinaires. Le fil contestait aussi l’idée qu’un fichier contenant beaucoup d’images crée une identité entraînée.
Ces récits distinguent commodité, vitesse et ressemblance. Un RefMod peut être pratique sans être plus rapide dans votre graphe. Il peut économiser la préparation sans améliorer un visage. Une réussite peut dépendre du checkpoint, des recadrages, de la présentation des références et du prompt autant que du fichier.
La mise à jour de l’auteur du Prompt Builder rapportait moins de mélange de personnages après modification de l’accès à l’encodeur textuel, avec davantage de temps et mémoire. Le post décrivait encore des échanges de voix. C’est un résultat d’implémentation précis avec problèmes restants, pas la preuve que RefMods remplace les LoRA pour tous.
Changer de tenue sans changer de personnage
Les identités adultes récurrentes demandent reconnaissance et nouveauté. Le visage reste familier entre portraits, salon et soirée habillée. Un ensemble pratique peut alors devenir trop large.
Si toutes les références Iris montrent la même robe sombre en satin, elle peut devenir une instruction visuelle forte. Ajouter cinq images en costumes différents fournit plus d’informations, mais plus de contradictions vestimentaires.
Une organisation pratique est :
| Ressource | Contenu | Utilisation |
|---|---|---|
| Identité Iris | Vues validées aux traits cohérents | Chaque plan de la personne établie |
| Tenue de soirée | Vue claire de la robe et du style | Séquence du soir |
| Tenue de détente | Vue claire de l’ensemble crème | Séquence de détente |
| Appartement | Pièce sans personnages concurrents | Plans de ce lieu précis |
| Image initiale acceptée | Iris, tenue choisie et composition finale | Image-vidéo de ce décor exact |
Ce peuvent être des fichiers ordinaires. Créez des RefMods seulement pour les parties souvent réutilisées dans un workflow compatible. Aucun avantage à créer un ensemble permanent pour un accessoire ponctuel.
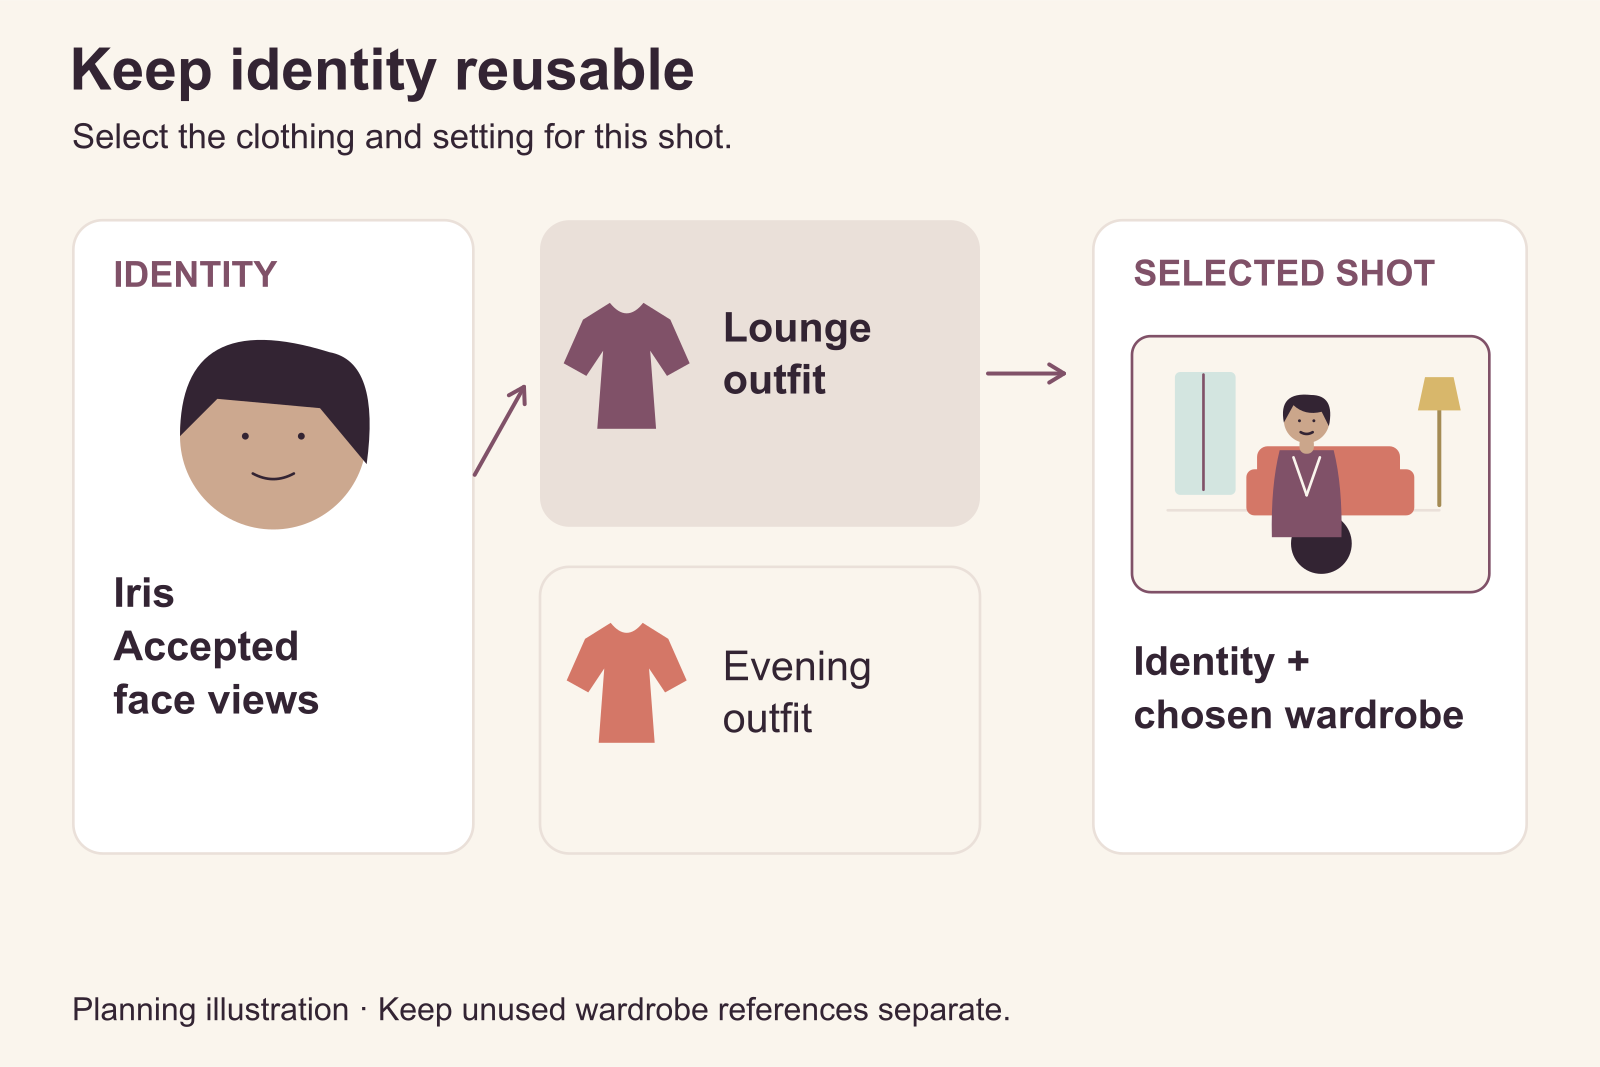
Illustration : gardez l’identité réutilisable en choisissant vêtements et lieu par plan.
Donnez une source claire à la nouvelle tenue
Gardez les deux mêmes images de référence d’identité et ajoutez la tenue comme Picture 3. Préférez un vêtement seul ou un cadrage clair sans autre visage concurrent.
Picture 1 et Picture 2 définissent Iris, la même femme adulte fictive de 32 ans. Picture 3 définit l’ensemble crème de cette scène. Montrez Iris assise dans un fauteuil près d’une lampe chaude, portant cet ensemble. Préservez le visage de Pictures 1 et 2. Elle repose une main sur l’accoudoir et regarde lentement la fenêtre. Plan moyen, visage visible. Audio : ambiance calme de pièce.
Si l’image de vêtement contient une autre personne, précisez particulièrement son rôle. Mieux, retirez ce visage si possible sans perdre le détail utile du vêtement.
Si l’ancien costume revient, créez d’abord une image éditée dans la nouvelle tenue. Une fois visage et garde-robe corrects ensemble, animez-la. Vous déplacez le choix vestimentaire contesté vers une image directement inspectable.
Cela peut être plus facile à gérer que demander plusieurs fois à cinq secondes de vidéo identité, construction du costume et mouvement simultanément. Vous obtenez aussi un début réutilisable pour plusieurs clips de la même séquence.
Une refonte permanente demande de nouvelles références validées ; séparez-les de l’ancienne version pour reproduire les anciens épisodes. Une identité revue peut justifier un réentraînement LoRA. Une nouvelle robe appelle généralement d’abord une référence de tenue ou un début préparé.
Deux personnages nécessitent des rôles explicites
Deux RefMods ne créent pas automatiquement deux personnes indépendamment contrôlées. Deux LoRA ne réservent pas automatiquement une moitié de cadre à chacune.
Le modèle doit déterminer qui est présent, quelles informations appartiennent à chacun et qui fait quoi. Cela se complique si coiffure, tenue et description sont proches ou si le prompt dit vaguement « elle se tourne vers elle ».
Introduisez Alex, autre adulte fictif de 35 ans, avec coupe courte visiblement différente et référence séparée. Ces différences aident la description ; elles ne remplacent pas une identité valide.
Pour des références ordinaires, un premier arrangement simple est :
- Pictures 1 et 2 : face et trois-quarts d’Iris.
- Pictures 3 et 4 : vues correspondantes d’Alex.
- Pièce et vêtements : décrits en texte sauf besoin d’une source séparée.
Écrivez ensuite la relation références-scène :
Pictures 1 et 2 montrent Iris, femme adulte fictive de 32 ans. Pictures 3 et 4 montrent Alex, homme adulte fictif de 35 ans. Iris se tient à gauche en robe de soirée anthracite ; Alex à droite en chemise sombre à col ouvert. Ils échangent un sourire calme près d’une fenêtre d’appartement. Iris se tourne vers Alex pendant qu’Alex regarde Iris. Plan moyen à deux, deux visages visibles, caméra fixe. Audio : douce ambiance de soirée.
Gauche et droite limitent l’ambiguïté de cette composition simple. Les noms remplacent les pronoms pour l’action. La caméra fixe évite d’imposer dès le premier plan croisement, échange de places et rotations simultanés.
Pour les RefMods locaux, utilisez les étiquettes de la carte actuelle. Un RefMod multi-images peut apparaître comme référence vidéo plutôt que photo ; ne devinez pas le numéro depuis le nom et ne copiez pas l’ancien après réorganisation.
Le guide officiel H3 de prompts de références sépare les sujets visibles des médias sources. Iris est le sujet ; photo ou vidéo fournit des informations sur Iris. Vous pouvez ainsi définir sa place dans le nouveau plan sans demander toute la scène source.
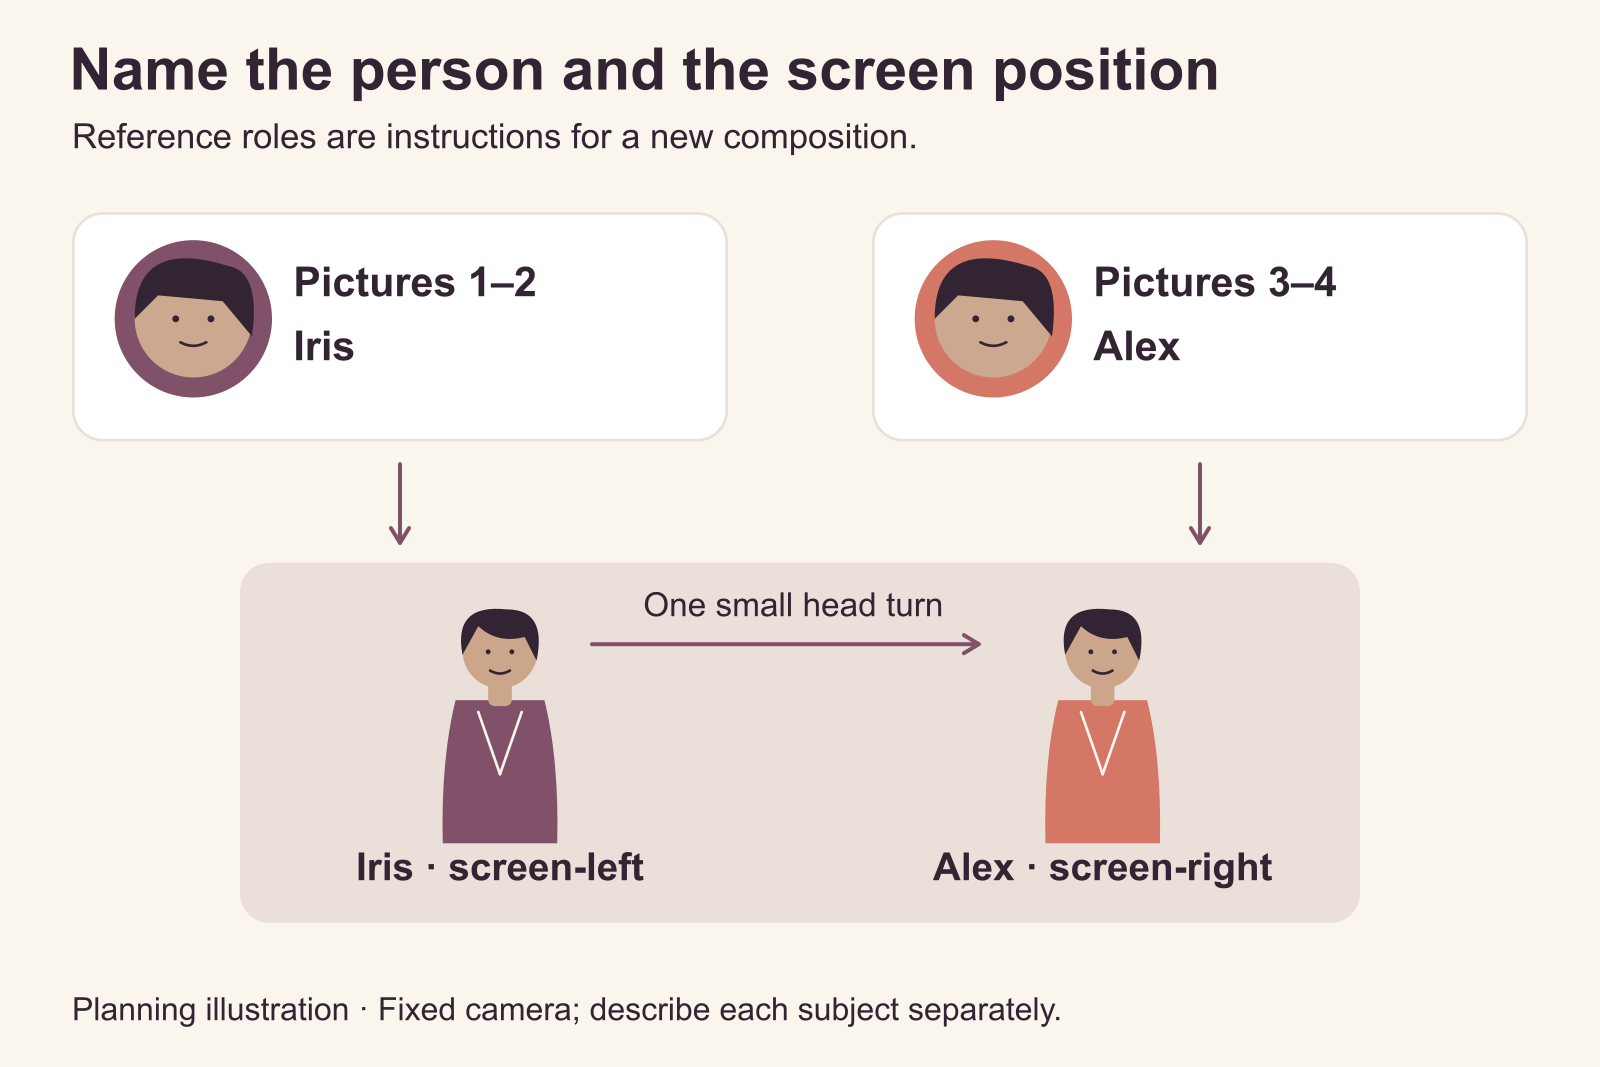
Illustration : attribuez séparément images sources, personne et position à l’écran.
Si les visages se mélangent, simplifiez d’abord la composition
Si Alex hérite des cheveux d’Iris ou Iris de sa forme de visage, vérifiez sources et étiquettes. Une mauvaise attribution peut ressembler à un échec de qualité d’identité.
Si elles sont correctes, clarifiez les rôles : deux visages visibles, places distinctes, pas de croisement initial. Retirez une référence de tenue avec un troisième visage. Si les personnages fonctionnent seuls mais se mélangent ensemble, préparez un début à deux avec identités acceptées et animez une interaction mesurée.
Vous pouvez aussi changer le montage. Alternez plans individuels et par-dessus l’épaule plutôt que tout raconter dans un plan mobile à deux. C’est pratique quand la continuité crédible compte plus que voir les deux visages continuellement.
Ces changements ne garantissent pas une interaction difficile. Ils traitent des ambiguïtés précises avant de construire davantage de ressources d’identité.
Séparez identité vocale et visuelle
Un personnage visuellement stable mais parlant d’une autre voix chaque épisode semble encore différent. Enregistrer un audio avec un RefMod visuel n’établit pas pour autant une liaison fiable voix-visage.
Les notes de validation du projet RefMod enregistrent un transfert d’identité vocale échoué et une couverture de génération incomplète. Évaluez séparément les références audio pour votre workflow réel.
Pour la première séquence visuelle d’Iris, l’ambiance suffit. Si une voix stable est essentielle, prévoyez une chaîne distincte de voix et dialogue au lieu de supposer qu’un fichier combiné l’a résolue. Une LoRA visuelle entraînée ne prouve pas non plus une voix entraînée.
Quand l’entraînement d’une LoRA mérite l’investissement
Il a du sens si l’identité est fixée et vous avez besoin de plus qu’une sélection de références facile.
Trois situations justifient de l’envisager sérieusement :
- Produire le personnage en texte-vidéo avec un adaptateur compatible plutôt qu’une grande collection à chaque plan.
- Obtenir un style ou comportement récurrent appris que les références n’expriment pas assez.
- Disposer déjà d’une production LoRA fonctionnelle et y rendre ce personnage disponible.
« Je fais une série » ne suffit pas. Dix clips de portraits composés soigneusement peuvent convenir aux images initiales acceptées. Une série bien plus grande peut justifier l’entraînement si l’adaptateur réduit un vrai travail ou ajoute une capacité nécessaire.
Entraînez pour le workflow de destination
H3 n’est pas un fichier de poids interchangeable. FL2VA et Ref2VA demandent un choix de compatibilité. La documentation AI Toolkit Ref2VA identifie poids distincts et adaptateur d’entraînement correspondant. Un nom de fichier H3 ne prouve pas la compatibilité avec toutes les tâches hébergées ou checkpoints locaux.
Avant l’entraînement, choisissez la sortie principale : texte-vidéo, animation d’image initiale ou vidéo conditionnée par références. Indiquez cette tâche à la personne configurant l’entraîneur. Une recette impressionnante dans un graphe n’est pas automatiquement utilisable ailleurs.
Suivez les instructions H3 actuelles plutôt que taux d’apprentissage et étapes d’un tutoriel Wan ou image. La documentation H3 Musubi actuelle accepte plusieurs tâches et approches distinctes de conservation du comportement de base. Cela affecte l’apprentissage et les perturbations possibles.
Préparez un dataset qui apprend le personnage, pas une photo
Pour Iris, la collection utile montre l’identité dans les variations nécessaires : visages lisibles aux angles pertinents, cadres plus larges si les proportions comptent, plusieurs tenues et éclairages.
Ne fabriquez pas de variété avec des versions incohérentes. Vingt images de la même personne acceptée sont plus cohérentes que vingt belles images modifiant progressivement nez et mâchoire. Des dizaines de recadrages quasi identiques ne fournissent pas le profil manquant.
Légendez les changements : tenue, cadrage, expression et scène. Gardez le nom d’identité cohérent avec la méthode. Pour une recette à déclencheur, la légende peut être simple :
irisvale, femme adulte fictive de 32 ans, portrait trois-quarts, haut crème en maille, expression détendue, douce lumière de fenêtre, fond intérieur simple.
C’est un exemple de légende, pas une commande universelle H3. Certaines méthodes gèrent différemment l’identité. Suivez celle choisie plutôt que combiner des conseils incompatibles.
Si la cible est le visage, n’ajoutez pas de clips de mouvement sans rapport simplement parce que l’entraîneur accepte la vidéo. Pour un mouvement signature, choisissez des clips le montrant clairement avec personne reconnaissable. Images fixes et vidéo apportent des informations différentes ; la vidéo ajoute aussi préparation et entraînement.
Surveillez les faux succès
Un échantillon peut ressembler à Iris mais être un mauvais adaptateur de production. Signaux : même fond dans des prompts sans rapport, ancien costume revenant avec plus de force, mouvement raide ou nouveau cadrage mal suivi.
Le correctif n’est pas toujours plus d’entraînement. Si les checkpoints tardifs gagnent en ressemblance mais perdent en flexibilité, un plus ancien peut mieux servir. Si tous reproduisent le fond, le dataset peut être trop spécifique. Si l’adaptateur ne change rien à une force raisonnable, vérifiez compatibilité et chargement avant une autre nuit de légendes.
Une autre discussion communautaire d’entraînement H3 décrit ce compromis : ressemblance faible pour certains, plus forte mais avec mouvement, artefacts ou suivi d’instructions dégradés pour un autre. Elle comprend aussi réussites RefMod et références décevantes. Aucun gagnant universel honnête n’en ressort.
Vous pouvez combiner LoRA compatible et références. L’adaptateur fournit une tendance apprise ; une image acceptée fournit visage, tenue ou composition actuelle. La combinaison sert si chaque partie a un rôle clair, pas à monter tous les contrôles de force au maximum.
Temps de préparation et dépenses réelles
Les références ordinaires exigent le moins de préparation si les sources existent. Le travail est la sélection et l’attribution. RefMods ajoute installation et extraction puis réduit la manipulation répétée. LoRA ajoute dataset, entraînement, sélection de checkpoint et vérification de compatibilité.
Le temps dépend du matériel, du nombre de sources, de la résolution et de la méthode. Les cinq heures communautaires concernent cette exécution ; budgétez avec votre entraîneur et votre matériel.
| Coût | Références ordinaires | RefMod | LoRA entraînée |
|---|---|---|---|
| Création initiale | Images d’identité et vues utiles | Même préparation de sources | Dataset sélectionné, souvent plus varié |
| Préparation supplémentaire | Choisir et ordonner | Installer, encoder et inspecter | Configurer, entraîner et choisir le checkpoint |
| Travail répété | Recharger fichiers ou préréglage | Charger l’ensemble | Charger poids compatibles et déclencheur/réglages |
| Génération | Endpoint et frais de références | Calcul local ou loué ; références conservées ont encore un coût | Génération et politique spécifique de l’hôte pour adaptateurs |
| Révision | Remplacer une source | Actualiser la ressource | Réentraînement possible si l’identité apprise change |
Prix hébergés et coûts locaux RefMod sont séparés
Les pages H3 SpicyAPI acceptent les médias ordinaires ; les pages LoRA acceptent aussi les poids compatibles. Aucun champ de téléversement RefMod n’est exposé. Un fichier RefMod .safetensors ne remplace pas une LoRA dans loras. Gardez les sources pour le même personnage sur une route hébergée.
Pour un début déjà validé, H3 LoRA image-vidéo coûte $0.05 par seconde en 480p et $0.10 en 768p. Cinq secondes coûtent $0.25 ou $0.50. Charger une LoRA n’ajoute pas de frais distincts sur cette tâche. Quatre générations coûtent $1.00 ou $2.00 ; quatre sorties, pas quatre images ou clips garantis à conserver.
La référence-vidéo a une autre facture. H3 ordinaire ajoute $0.0068 par image aux secondes de sortie. H3 LoRA ajoute $0.02 par image. Voici les estimations complètes de cinq secondes avec images fixes seules. H3 ordinaire n’offre plus le 480p, ces cellules affichent donc un tiret :
| Demande de cinq secondes | 480p | 768p |
|---|---|---|
| H3, deux images d’identité | — | $0.1986 |
| H3, deux images d’identité et une image de tenue | — | $0.2054 |
| H3 LoRA, deux images d’identité | $0.34 | $0.715 |
| H3 LoRA, deux images d’identité et une image de tenue | $0.36 | $0.735 |
Par exemple, H3 ordinaire 768p avec deux images : 5 × $0.037 + 2 × $0.0068 = $0.1986. Dix générations totalisent $1.986. Les demandes LoRA correspondantes totalisent $7.15 en 768p. Choisissez selon preuves adultes de la tâche, entrées nécessaires et poids compatibles. Plusieurs épisodes n’exigent pas à eux seuls la route LoRA.
Sur la référence LoRA, les secondes vidéo d’entrée comptent aussi dans les secondes facturées et les références audio ajoutent leur supplément. Un RefMod local n’évite pas ces types ou tarifs hébergés. Gardez une référence de mouvement courte et utilisez-la seulement si elle apporte autre chose que photos et prompt.
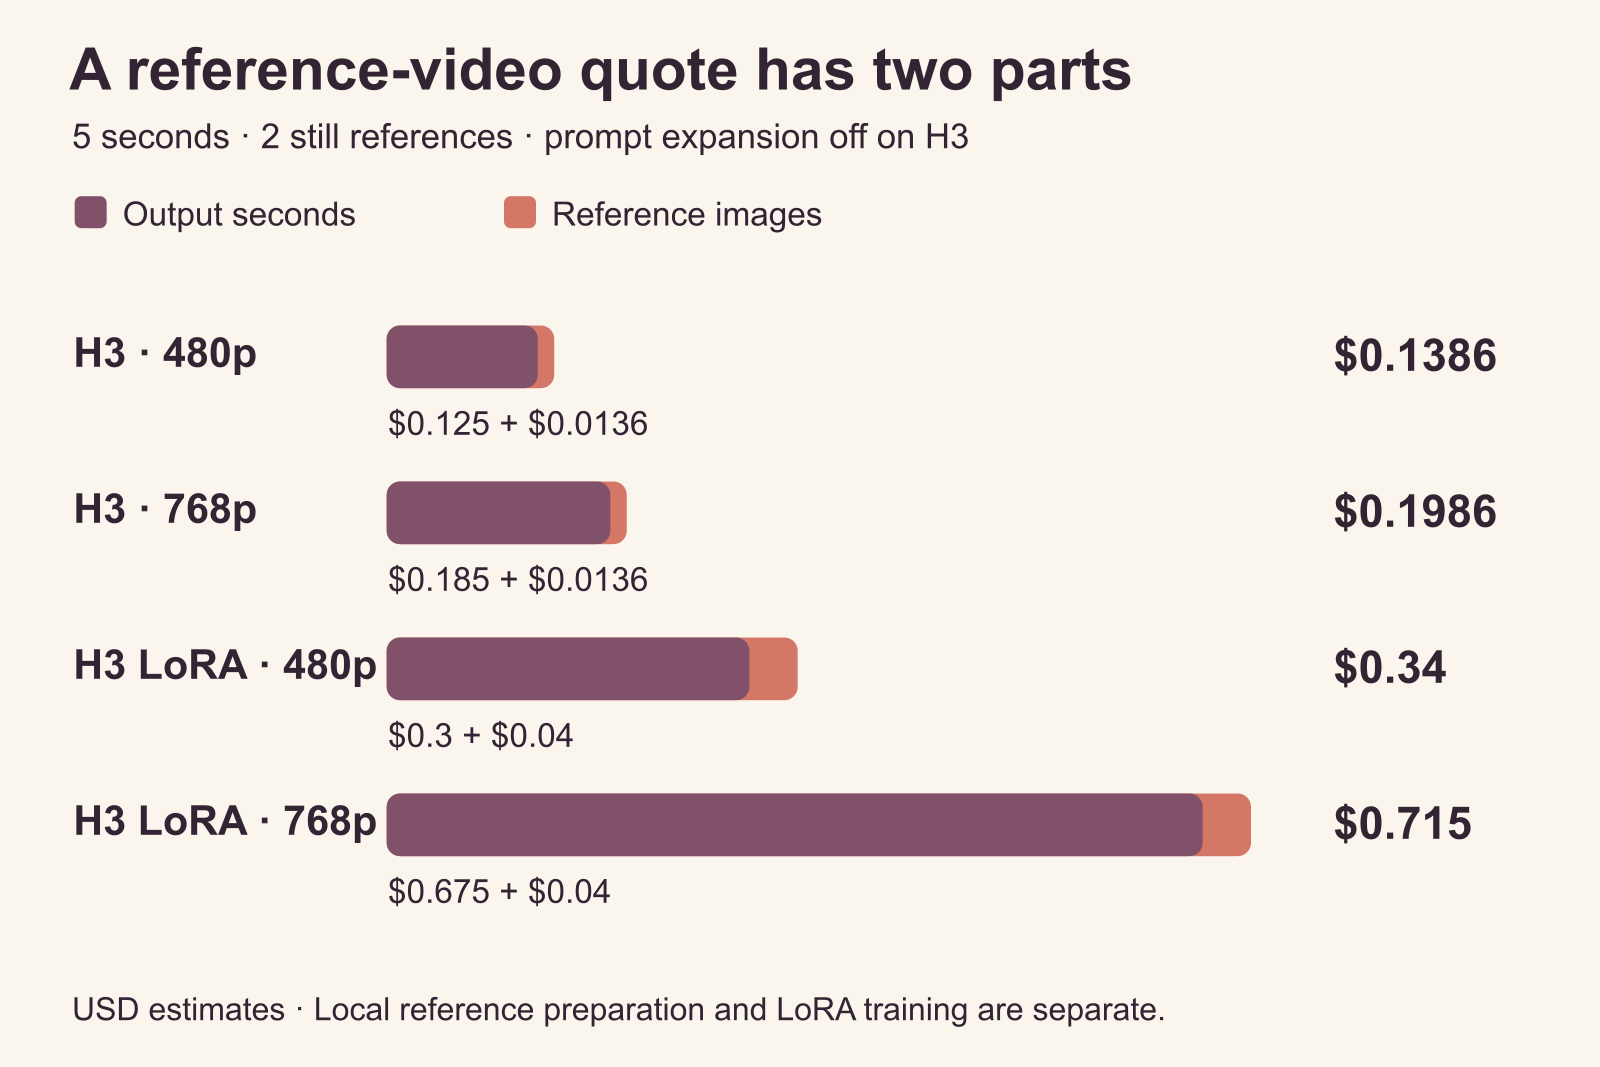
Les estimations de cinq secondes incluent les deux images. Préparation des références et entraînement LoRA sont des coûts séparés.
Déterminez si l’entraînement économise assez de répétitions
La facture d’entraînement n’est qu’un élément. Incluez préparation, location GPU, échantillons intermédiaires et correction des sorties incompatibles. Un GPU bon marché n’est pas une affaire si l’adaptateur ne produit jamais de personnage utilisable.
Pour quelques clips, gardez les références sauf adaptateur adapté déjà possédé. Pour des sorties fréquentes, nommez la dépense à réduire : sélection répétée, frais d’image répétés, inférence lourde en références ou impossibilité d’un rendu appris précis.
RefMods vise surtout sélection et préparation répétées. Une LoRA peut traiter les autres problèmes, après avoir réellement fonctionné sur la route prévue. N’achetez pas un entraînement pour un problème d’organisation déjà résolu par un préréglage enregistré.
Comptez honnêtement les résultats utilisables. Six générations terminées dont deux utilisées donnent un coût par résultat gardé triple du prix unitaire. Ce calcul vaut pour les trois méthodes. De meilleures sources ou un plan simple comptent parfois plus que la seconde vidéo affichée la moins chère.
Erreurs courantes et prochain changement utile
| Ce que vous voyez | Première vérification | Changement |
|---|---|---|
| Face reconnaissable, rotation vers autre personne | Références montrant l’angle révélé | Ajouter profil accepté ou réduire la rotation |
| Ancienne tenue revenant | Toutes les identités la portent-elles ? | Remplacer source, séparer tenue ou préparer début |
| Bonne miniature RefMod, faible détail facial | Recadrage et représentation stockés | Reconstruire avec cadre clair et base Full |
| Personnage enregistré ignorant son nom | Prompt utilisant-il l’étiquette média réelle ? | Attribuer au label de la carte actuelle |
| Deux personnages mélangés | Ordre, rôles et visages supplémentaires | Corriger labels, retirer concurrents, commencer par plan fixe à deux |
| LoRA chargée sans changement utile | Compatibilité base, tâche et chargeur | Confirmer la route avant réentraînement |
| Ressemblance accrue mais mouvement effondré | Force et checkpoint | Réduire l’influence ou utiliser un checkpoint antérieur utile |
| Nouvelle pièce devenant ancienne | Ancienne pièce encore chargée ? | Retirer entièrement la référence |
| Visage stable, voix changeante | Solution vocale distincte existante ? | Traiter le dialogue comme tâche propre |
Changez l’entrée la plus directement liée au trait indésirable. Une mauvaise tenue justifie de revoir sa source avant checkpoint, sampler et toutes les références.
Le guide API H3 LoRA explique chargement et tâche d’un adaptateur existant. Le comparatif H3 explique les variantes. Ce sont des décisions séparées du besoin d’entraîner le personnage.
Choisissez pour le prochain épisode
Pour Iris, sélectionnez le portrait validé et l’autre angle nécessaire, choisissez une tâche adaptée à la scène adulte et produisez un clip de cinq secondes. Enregistrez un RefMod quand répéter la préparation devient le problème. Entraînez une LoRA compatible lorsque la série exige une capacité apprise ou une route de déploiement absente des références. Laissez le prochain besoin réel déterminer l’investissement.